


































Requests ve BeautifulSoup ile yazdığınız betik yüz sayfada sorunsuz çalışır. On bin sayfaya çıktığınızda işin kendisi değişir: hangi adresin tarandığını, hangisinin hata verip yeniden deneneceğini, aynı siteye aynı anda kaç istek gittiğini ve verinin nereye yazılacağını sizin yönetmeniz gerekir. Scrapy bu işlerin hepsini hazır getiren bir Python çatısıdır. Proxy ayarı da bu yapının içinde, isteğin geçtiği katmanlardan birinde durur.
Bu yazıda önce Scrapy'nin ne olduğunu ve nasıl kurulduğunu kısaca gösteriyoruz. Ardından asıl konuya geçiyoruz: proxy'nin üç tanımlama yolu, kimlik doğrulama, tek uç noktalı rotating gateway ile kendi proxy listeniz arasındaki fark, DOWNLOAD_DELAY ve AutoThrottle ile hız ayarı, 429 ve 503 yanıtlarında Scrapy'nin davranışı. Bütün örnekleri Scrapy 2.19 ve Python 3.13 ile, alıştırma için kurulmuş toscrape.com siteleri ve yerel bir test proxy'si üzerinde çalıştırdık.
Scrapy nedir, ne işe yarar?
Scrapy, web sitelerini taramak ve sayfalardan yapılandırılmış veri çıkarmak için yazılmış bir Python çatısıdır. Bir kütüphaneden farkı şudur: Requests size tek bir istek gönderme aracı verir, döngüyü siz kurarsınız. Scrapy'de ise döngü çatının kendisidir. Siz yalnızca hangi adresten başlanacağını ve gelen sayfadan neyin alınacağını anlatan bir sınıf yazarsınız; bu sınıfa spider denir.
Spider'ın dışında kalan her şey hazırdır: istekleri sıraya koyan zamanlayıcı, aynı adresi ikinci kez istemeyen yineleme filtresi, asenkron indirici, yeniden deneme, robots.txt denetimi, hız sınırlama ve JSON ya da CSV'ye dışa aktarma. Seçiciler için CSS ve XPath birlikte kullanılır; ikisinin farkını CSS Selector ve XPath yazımızda anlattık. Python ve JavaScript tarafındaki araçların genel haritası ise Web Kazıma: JavaScript mi Python mu? yazımızda.
Scrapy kurulumu nasıl yapılır?
Scrapy'yi sistem Python'una değil, projeye özel bir sanal ortama kurun. Windows'ta komutlar şöyle:
python -m venv venv
venv\Scripts\activate
pip install scrapy
scrapy startproject kitaplik
cd kitaplik
scrapy genspider kitaplar books.toscrape.com
macOS ve Linux'ta ikinci satır source venv/bin/activate olur. startproject komutu settings.py, middlewares.py ve spiders/ klasörünü içeren bir iskelet üretir. Güncel şablonun settings.py dosyası üç ayarı hazır getirir: ROBOTSTXT_OBEY = True, CONCURRENT_REQUESTS_PER_DOMAIN = 1 ve DOWNLOAD_DELAY = 1. Yani yeni bir proje varsayılan olarak robots.txt'ye uyar ve aynı siteye saniyede yaklaşık bir istek gönderir. Bu satırları silmeyin, ayarlarınızı bunların üzerine kurun.
genspider ile oluşan dosyayı aşağıdaki gibi doldurun. Spider, kitap kartlarını okur ve "sonraki sayfa" bağlantısını izler:
import scrapy


class KitaplarSpider(scrapy.Spider):
    name = "kitaplar"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/"]

    def parse(self, response):
        for kart in response.css("article.product_pod"):
            yield {
                "baslik": kart.css("h3 a::attr(title)").get(),
                "fiyat": kart.css("p.price_color::text").get(),
                "adres": response.urljoin(kart.css("h3 a::attr(href)").get()),
            }

        sonraki = response.css("li.next a::attr(href)").get()
        if sonraki:
            yield response.follow(sonraki, callback=self.parse)
scrapy crawl kitaplar -O kitaplar.json komutu spider'ı çalıştırır ve sonucu dosyaya yazar. Denemede ilk iki sayfadan 40 kayıt geldi. Türkçe karakterlerin ve para birimi simgelerinin dosyada bozulmaması için şablondaki FEED_EXPORT_ENCODING = "utf-8" satırını koruyun.
Scrapy bir isteği nasıl işler?
Proxy ayarının nereye yazılacağını anlamak için isteğin izlediği yolu bilmek gerekir:
- Spider bir
Requestnesnesi üretir (start_urlsya daresponse.follow). - Motor isteği zamanlayıcıya verir; yineleme filtresi daha önce istenmiş adresi eler.
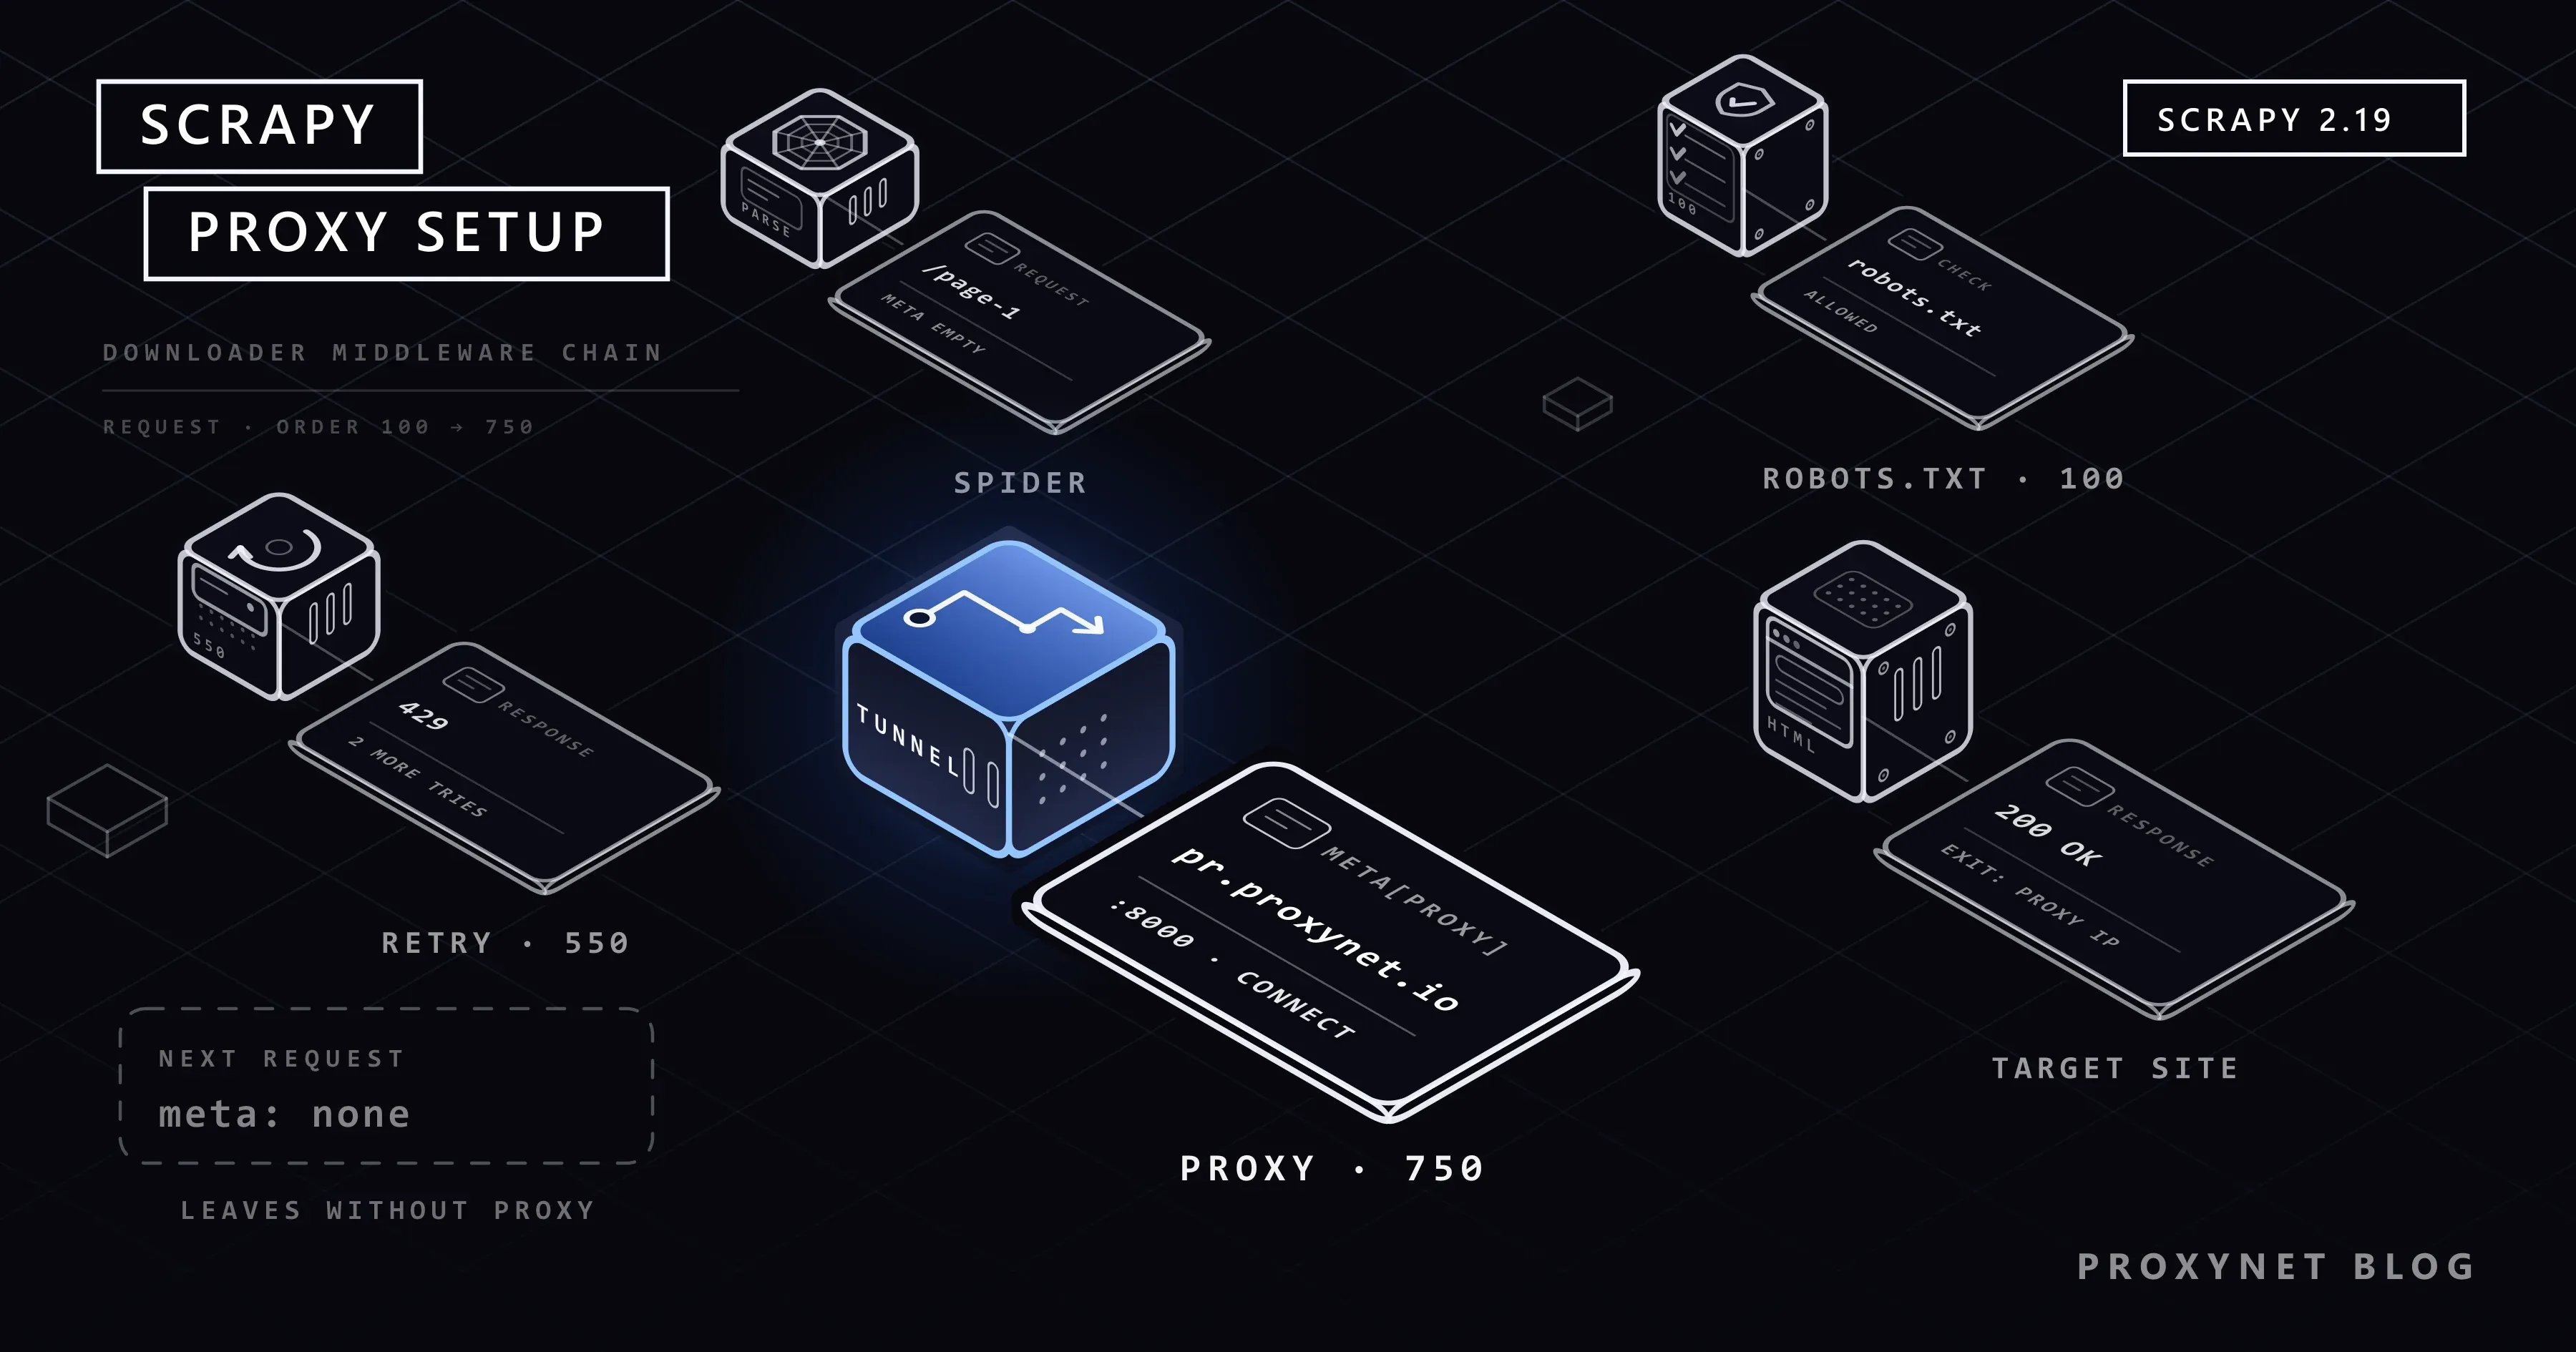
- Sırası gelen istek downloader middleware zincirinden geçer. Her middleware bir sıra numarası taşır ve istek küçük numaradan büyüğe doğru ilerler: robots.txt denetimi 100, yeniden deneme 550,
HttpProxyMiddleware750. - İndirici isteği ağa gönderir. İstekte
meta["proxy"]varsa bağlantı hedefe değil proxy'ye açılır; HTTPS adreslerde proxy üzerinden birCONNECTtüneli kurulur. - Yanıt aynı zincirden ters sırayla geri döner ve spider'ın geri çağrı fonksiyonuna (
parse) ulaşır. - Fonksiyonun ürettiği kayıtlar item pipeline'a, yeni istekler yeniden zamanlayıcıya gider.
Buradan çıkan sonuç: proxy, spider'ın ayrıştırma koduna değil üçüncü adıma aittir. meta["proxy"] alanını kim doldurursa doldursun, işi yapan HttpProxyMiddleware'dir. Bu middleware varsayılan olarak açıktır; Scrapy belgelerindeki HttpProxyMiddleware bölümü davranışını tanımlar.
Scrapy'de proxy nasıl tanımlanır?
Üç yol var ve üçü de sonunda aynı meta["proxy"] alanını doldurur.
| Yöntem | Nereye yazılır | Kapsam | Ne zaman uygun |
|---|---|---|---|
meta["proxy"] | Spider'da, her Request içinde | Yalnızca o istek | Birkaç isteği farklı bir çıkıştan göndermek |
| Ortam değişkeni | Kabukta http_proxy / https_proxy | Bütün istekler, robots.txt dahil | Hızlı deneme, kod değiştirmeden çalıştırma |
| Downloader middleware | middlewares.py + settings.py | Bütün istekler, robots.txt dahil | Kalıcı proje kurulumu, rotasyon |
İstek başına: meta alanı
import scrapy

PROXY = "http://user:pass@pr.proxynet.io:8000"


class KitaplarMetaSpider(scrapy.Spider):
    name = "kitaplar_meta"
    allowed_domains = ["books.toscrape.com"]

    async def start(self):
        yield scrapy.Request("https://books.toscrape.com/", meta={"proxy": PROXY})

    def parse(self, response):
        for kart in response.css("article.product_pod"):
            yield {"baslik": kart.css("h3 a::attr(title)").get()}

        sonraki = response.css("li.next a::attr(href)").get()
        if sonraki:
            # meta yeni isteğe kendiliğinden geçmez, elle taşınır
            yield response.follow(sonraki, callback=self.parse, meta={"proxy": PROXY})
Bu yöntemin gözden kaçan iki sonucu var ve ikisini de testte gördük. Birincisi, meta bir sonraki isteğe kendiliğinden aktarılmaz. response.follow çağrısına meta eklemediğimiz denemede ilk sayfa proxy'den, ikinci sayfa doğrudan kendi IP adresimizden gitti. İkincisi, Scrapy'nin robots.txt isteği sizin yazdığınız bir istek olmadığı için meta taşımaz ve o da proxy'siz çıkar. Bütün trafiğin aynı çıkıştan gitmesini istiyorsanız aşağıdaki iki yoldan birini kullanın.
Ortam değişkeni
HttpProxyMiddleware, Python'un standart kütüphanesi gibi http_proxy, https_proxy ve no_proxy değişkenlerini okur. Kodda hiçbir şey değiştirmeden:
export https_proxy="http://user:pass@pr.proxynet.io:8000"
export http_proxy="$https_proxy"
scrapy crawl kitaplar
Bir istekte meta["proxy"] de varsa o değer ortam değişkeninin önüne geçer ve no_proxy listesini yok sayar. Değişkenlerin Windows, macOS ve Linux'ta nasıl tanımlandığını ve büyük-küçük harf farkını wget ile Proxy Kullanımı yazımızda anlattık; burada tekrar etmiyoruz.
Bütün proje için: küçük bir middleware
Kalıcı kurulumda adresi koda gömmek yerine ortamdan okuyan birkaç satırlık bir middleware yeterlidir:
# kitaplik/middlewares.py
from scrapy.exceptions import NotConfigured


class TekProxyMiddleware:
    """Ayarlardaki tek proxy adresini bütün isteklere uygular."""

    def __init__(self, adres):
        self.adres = adres

    @classmethod
    def from_crawler(cls, crawler):
        adres = crawler.settings.get("PROXY_ADRESI")
        if not adres:
            raise NotConfigured
        return cls(adres)

    def process_request(self, request):
        request.meta.setdefault("proxy", self.adres)
return None# kitaplik/settings.py
import os
PROXY_ADRESI = os.environ.get("PROXY_ADRESI")
DOWNLOADER_MIDDLEWARES = {
"kitaplik.middlewares.TekProxyMiddleware": 610,
}setdefault sayesinde bir isteğe elle yazdığınız meta["proxy"] korunur. PROXY_ADRESI tanımlı değilse middleware kendini kapatır ve spider proxy'siz çalışır. Sıra numarasının 750'den küçük olması gerekir; böylece adresi önce siz yazarsınız, kimlik bilgisini HttpProxyMiddleware ayrıştırır. Eski sürümlerle yazılmış örneklerde imzayı process_request(self, request, spider) biçiminde görürsünüz; güncel belgede spider parametresi yoktur ve örnek bu haliyle Scrapy 2.19'da çalışır.
Kimlik doğrulama nasıl çalışır?
Adresin içindeki user:pass kısmını HttpProxyMiddleware ayırır, Base64 ile kodlar ve isteğe Proxy-Authorization: Basic … başlığı olarak ekler. meta["proxy"] alanında geriye kimlik bilgisi içermeyen adres kalır; günlükte parolanızı görmezsiniz. Parolada @, : ya da / varsa yüzde kodlamasıyla yazın (@ yerine %40); middleware değeri göndermeden önce çözer.
Yanlış parolayla yaptığımız denemede Scrapy şu satırı yazdı:
TunnelError: Could not open CONNECT tunnel with proxy 127.0.0.1:8120 [{'status': 407, 'reason': b'Proxy Authentication Required'}]HTTPS adreslerde 407 bir yanıt olarak değil, tünel kurulamadığı için bir istisna olarak gelir. Dikkat edilecek nokta: yeniden deneme middleware'i bu istisnayı geçici hata sayar ve aynı isteği iki kez daha dener. Yanlış parola tekrarla düzelmez; günlükte TunnelError ve 407 görüyorsanız taramayı durdurup kimlik bilgisini düzeltin. Kullanıcı adı ve parola yerine IP whitelist kullanıyorsanız adres http://pr.proxynet.io:8000 biçiminde, kimlik bilgisi olmadan yazılır. İki yöntemin farkı Proxy Kimlik Doğrulama: User:Pass ve IP Whitelist yazımızda.
Rotasyon için middleware gerekir mi?
Bu sorunun cevabı elinizdeki proxy'nin türüne bağlıdır.
Rotating gateway kullanıyorsanız gerekmez. Rotating proxy hizmetinde tek bir uç noktaya bağlanırsınız ve çıkış IP'sini ağ geçidi değiştirir. Scrapy tarafında yukarıdaki TekProxyMiddleware ya da tek bir ortam değişkeni yeter; liste tutmak, sıradaki adresi seçmek ve bozuk adresi ayıklamak sizin işiniz olmaz. Residential Proxy ile yapılan taramalarda tipik kurulum budur. Rotasyon modlarının nasıl çalıştığını IP Rotasyonu Nedir ve Nasıl Çalışır? yazımızda anlattık.
Elinizde sabit adreslerden oluşan bir liste varsa (örneğin birkaç Datacenter Proxy ya da ISP Proxy adresi) dağıtımı bir middleware yapar. Aşağıdaki örnek adresleri sırayla kullanır, art arda hata veren adresi bir süre dinlendirir ve sayıları Scrapy istatistiklerine yazar:
# kitaplik/middlewares.py
import time
from urllib.parse import urlsplit

from scrapy.exceptions import IgnoreRequest, NotConfigured


def anahtar(proxy_adresi):
    parca = urlsplit(proxy_adresi)
    return f"{parca.hostname}:{parca.port}"


class ProxyHavuzuMiddleware:
    """Her isteğe listeden sıradaki proxy'yi atar, art arda hata vereni dinlendirir."""

    def __init__(self, adresler, hata_siniri, dinlenme, stats):
        self.adresler = adresler
        self.hata_siniri = hata_siniri
        self.dinlenme = dinlenme
        self.stats = stats
        self.sira = 0
        self.hatalar = {anahtar(a): 0 for a in adresler}
        self.kapali = {}  # anahtar -> yeniden açılacağı an

    @classmethod
    def from_crawler(cls, crawler):
        adresler = crawler.settings.getlist("PROXY_LISTESI")
        if not adresler:
            raise NotConfigured
        return cls(
            adresler,
            crawler.settings.getint("PROXY_HATA_SINIRI", 3),
            crawler.settings.getfloat("PROXY_DINLENME", 60.0),
            crawler.stats,
        )

    def sec(self):
        simdi = time.monotonic()
        for _ in self.adresler:
            adres = self.adresler[self.sira % len(self.adresler)]
            self.sira += 1
            if self.kapali.get(anahtar(adres), 0) <= simdi:
                return adres
        return None

    def process_request(self, request):
        adres = self.sec()
        if adres is None:
            self.stats.inc_value("proxy_havuzu/hepsi_dinleniyor")
            raise IgnoreRequest("Listedeki bütün proxy'ler dinleniyor")
        request.meta["proxy"] = adres
        request.meta["proxy_anahtari"] = anahtar(adres)
        return None

    def process_response(self, request, response):
        kim = request.meta.get("proxy_anahtari")
        if kim:
            self.hatalar[kim] = 0
            self.stats.inc_value(f"proxy_havuzu/yanit/{kim}")
        return response

    def process_exception(self, request, exception):
        kim = request.meta.get("proxy_anahtari")
        if not kim:
            return None
        self.hatalar[kim] += 1
        self.stats.inc_value(f"proxy_havuzu/hata/{kim}")
        if self.hatalar[kim] >= self.hata_siniri:
            self.kapali[kim] = time.monotonic() + self.dinlenme
            self.hatalar[kim] = 0
return None# kitaplik/settings.py
PROXY_LISTESI = [
"http://user:pass@203.0.113.10:8000",
"http://user:pass@203.0.113.11:8000",
"http://user:pass@203.0.113.12:8000",
]
DOWNLOADER_MIDDLEWARES = {
"kitaplik.middlewares.ProxyHavuzuMiddleware": 610,
}Örneği ikisi çalışan, biri kapalı üç yerel proxy ile denedik. Yüz kayıt eksiksiz geldi; istekler iki çalışan adrese 6 ve 5 olarak dağıldı, kapalı adres üç bağlantı hatasından sonra devreden çıktı ve hata alan istekleri Scrapy öbür adreslerden yeniden denedi.
Sıra numarası burada keyfî değildir. İlk denemede middleware'i 350'ye koyduk ve hata sayacı hiç çalışmadı: istisnalar zincirde ters sırayla dolaşır, 550'deki yeniden deneme middleware'i istisnayı yakalayıp yeni bir istek döndürdüğünde daha küçük numaralı middleware'ler haberdar olmaz. 550 ile 750 arasında bir değer (örnekte 610) iki koşulu birden sağlar: hatayı yeniden denemeden önce siz görürsünüz, kimlik bilgisini ise sizden sonra HttpProxyMiddleware işler. Aynı işi Requests ile elle yapmanın yolu Python'da Proxy'ler Nasıl Döndürülür? yazımızda.
DOWNLOAD_DELAY ve AutoThrottle nasıl ayarlanır?
Proxy, isteğin nereden çıktığını değiştirir; hedef sunucuya binen yükü değiştirmez. Yükü belirleyen ayarlar şunlardır:
# kitaplik/settings.py
USER_AGENT = "kitaplik-bot/1.0 (+https://ornek.com/bot)"
ROBOTSTXT_OBEY = True

CONCURRENT_REQUESTS = 8
CONCURRENT_REQUESTS_PER_DOMAIN = 2
DOWNLOAD_DELAY = 1
DOWNLOAD_TIMEOUT = 30

AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 2
AUTOTHROTTLE_MAX_DELAY = 30
AUTOTHROTTLE_TARGET_CONCURRENCY = 1.0
AUTOTHROTTLE_DEBUG = False

RETRY_ENABLED = True
RETRY_TIMES = 2
RETRY_HTTP_CODES = [429, 500, 502, 503, 504, 408]CONCURRENT_REQUESTS_PER_DOMAINaynı alan adına aynı anda açık olabilecek istek sayısıdır. Çatının varsayılanı 8'dir, proje şablonu bunu 1'e indirir. Eşzamanlılığın ne olduğunu Concurrency ve Parallelism yazımızda anlattık.DOWNLOAD_DELAYaynı alan adına giden iki istek arasındaki beklemedir (saniye). Scrapy bu değere varsayılan olarak rastgele bir oynama ekler; istekler saat gibi eşit aralıklarla gitmez.- AutoThrottle beklemeyi sunucunun yanıt süresine göre ayarlar. Belgedeki algoritmaya göre hedef bekleme, yanıt gecikmesinin
AUTOTHROTTLE_TARGET_CONCURRENCYdeğerine bölümüdür; yeni bekleme, önceki beklemeyle hedefin ortalamasıdır.200dışındaki yanıtlar beklemeyi düşüremez. Bekleme hiçbir zamanDOWNLOAD_DELAY'in altına inmez,AUTOTHROTTLE_MAX_DELAY'in üstüne çıkmaz. DOWNLOAD_TIMEOUTvarsayılanı 180 saniyedir. Proxy üzerinden çalışırken yanıt vermeyen bir bağlantının üç dakika asılı kalmaması için kısaltın.
AUTOTHROTTLE_DEBUG = True yaptığınızda her yanıtta bir satır görürsünüz. Bizim denememizde bekleme 2.000 ms ile başladı, sunucu 145 ms'de yanıt verdikçe 1.072 ms'ye, sonra DOWNLOAD_DELAY tabanı olan 1.000 ms'ye indi ve orada kaldı:
slot: books.toscrape.com | conc: 1 | delay: 2000 ms (+0)   | latency: 446 ms
slot: books.toscrape.com | conc: 1 | delay: 1072 ms (-927) | latency: 145 ms
slot: books.toscrape.com | conc: 1 | delay: 1000 ms (-72)  | latency: 144 ms
ROBOTSTXT_OBEY açıkken Scrapy her alan adı için önce /robots.txt dosyasını indirir ve izin verilmeyen adresleri istemeden eler. Dosyanın nasıl okunduğu robots.txt Dosyası Nedir, Nasıl Okunur? yazımızda, taramanın hukuki çerçevesi Web Scraping (Web Kazıma) Yasal mı? yazımızda. USER_AGENT alanına size ulaşılabilecek bir adres yazmak, site yöneticisinin sorun gördüğünde sizi engellemek yerine size yazabilmesini sağlar.
Scrapy 429 ve 503 yanıtlarında ne yapar?
Yeniden deneme middleware'i varsayılan olarak 500, 502, 503, 504, 522, 524, 408 ve 429 kodlarını ve bağlantı hatalarını yeniden dener; RETRY_TIMES = 2 ilk istekle birlikte toplam üç deneme demektir. Yeniden denenen istek kuyruğa daha düşük öncelikle geri döner.
İki sınırı bilmek gerekir. Scrapy'nin yeniden denemesi Retry-After başlığını okumaz ve denemeler arasında üstel bekleme uygulamaz; aradaki süreyi yine DOWNLOAD_DELAY ve AutoThrottle belirler. AutoThrottle 200 dışındaki yanıtlarda beklemeyi düşürmediği için 429 dalgasında hız kendiliğinden artmaz, ama otomatik olarak yeterince düşmeyebilir de. Günlükte 429 oranı yükseliyorsa doğru tepki CONCURRENT_REQUESTS_PER_DOMAIN değerini indirmek ve DOWNLOAD_DELAY'i büyütmektir. Hız sınırını daha çok IP ile aşmaya çalışmak sorunu çözmez, siteye binen yükü artırır. Kodların anlamı ve Retry-After ile doğru bekleme Scraping'de HTTP Hata Kodları yazımızda, hız sınırının site tarafındaki mantığı 429 Too Many Requests yazımızda.
Scrapy'de SOCKS5 proxy kullanılabilir mi?
Varsayılan indiriciyle hayır. meta["proxy"] alanına socks5:// adresi yazdığımız denemede istek hiçbir yanıt almadan zaman aşımına kadar bekledi. Scrapy'nin httpx tabanlı ikinci indiricisi HttpxDownloadHandler ise 2.17 sürümünden beri SOCKS5'i destekler. Kurulum için pip install "scrapy[httpx]" komutunu çalıştırıp ayarlara şunu ekleyin:
DOWNLOAD_HANDLERS = {
    "http": "scrapy.core.downloader.handlers._httpx.HttpxDownloadHandler",
    "https": "scrapy.core.downloader.handlers._httpx.HttpxDownloadHandler",
}
Bu ayarla socks5://user:pass@… adresi testimizde kimlik doğrulamayla birlikte çalıştı. Scrapy belgeleri bu indiriciyi deneysel olarak işaretliyor ve üretimde kullanılmasını henüz önermiyor; her proxy adresi için ayrı bağlantı havuzu açtığını da not ediyor. Zorunlu değilseniz HTTP proxy ile kalın. Protokol farkları SOCKS ve HTTP Proxy Farkı yazımızda.
JavaScript ile yüklenen sayfalarda ne yapılır?
Scrapy sayfanın HTML'ini indirir, JavaScript çalıştırmaz. Veri tarayıcıda sonradan yükleniyorsa önce sayfanın arka planda çağırdığı JSON uç noktasına bakın; çoğu zaman Scrapy ile doğrudan o adres istenebilir. Bu mümkün değilse scrapy-playwright eklentisi seçtiğiniz istekleri gerçek bir tarayıcıda açar. Dikkat: bu eklentide proxy meta["proxy"] ile değil, tarayıcı başlatma ya da bağlam (context) seçenekleriyle verilir. Ayrıntısı Playwright Nedir ve Proxy ile Nasıl Kullanılır? yazımızda, sayfa türlerini ayırt etmenin yolu Statik ve Dinamik Sayfalar yazımızda.
Scrapy mi, BeautifulSoup mu, Selenium mu?
Üçü aynı işin farklı parçalarıdır; karşılaştırma bu yüzden çoğu zaman yanlış kurulur.
| Scrapy | Requests + BeautifulSoup | Selenium | |
|---|---|---|---|
| Ne olduğu | Tarama çatısı | HTTP istemcisi + HTML ayrıştırıcı | Tarayıcı otomasyonu |
| İstek kuyruğu ve eşzamanlılık | Hazır | Siz yazarsınız | Siz yazarsınız |
| Yeniden deneme, hız sınırı, robots.txt | Ayarla açılır | Siz yazarsınız | Siz yazarsınız |
| JavaScript çalıştırma | Yok (eklentiyle) | Yok | Var |
| Proxy tanımı | meta["proxy"] ya da middleware | proxies= parametresi | Tarayıcı başlatma seçeneği |
| Öğrenme eşiği | Orta | Düşük | Orta |
| Uygun iş | Çok sayfalı, tekrarlanan tarama | Tek seferlik, birkaç sayfa | Giriş, tıklama, dinamik içerik |
BeautifulSoup yalnızca bir ayrıştırıcıdır ve Scrapy'nin içinde de kullanılabilir. Selenium ise her sayfa için tam bir tarayıcı açtığından aynı donanımda çok daha az sayfa işler; yalnızca gerçekten tarayıcı gereken adımlarda kullanılması mantıklıdır. Selenium tarafındaki proxy kurulumu Selenium Proxy Entegrasyonu yazımızda, iki tarayıcı aracının karşılaştırması Playwright ve Selenium Farkı yazımızda.
Kullanım alanları
- Fiyat ve stok takibi: Aynı ürün listesi her gün taranır; Scrapy'nin zamanlanmış çalıştırmaya uygun yapısı bu işe oturur. Kurgu fiyat takibi çözümü sayfamızda, çalışan bir örnek E-Ticarette Rakip Fiyat Takibi Nasıl Yapılır? yazımızda.
- Site içi tarama ve dizin çıkarma: Bağlantıları izleyerek bütün sayfaları dolaşan
CrawlSpidersınıfı, web crawler işleri için hazır bir başlangıçtır. - Çok siteli katalog toplama: Her site için ayrı spider, ortak pipeline ve ortak proxy ayarı. Genel mimari veri kazıma çözümü sayfamızda.
- Sayfalanmış listeler: "Sonraki" bağlantısı, sayfa numarası ve imleç (cursor) kalıpları Sayfalama (Pagination) yazımızda.
Sık yapılan hatalar
- Proxy'yi yalnızca ilk isteğe yazmak.
metasonraki isteklere aktarılmaz; tarama ikinci sayfadan itibaren kendi IP adresinizden devam eder ve bunu günlükten fark etmezsiniz. - Middleware sıra numarasını rastgele seçmek. 750'den büyük numarada kimlik bilgisi ayrıştırılmaz ve istek
invalid hostnamehatasıyla düşer, 550'den küçük numarada bağlantı hatalarını göremezsiniz. - Şablondaki
ROBOTSTXT_OBEY,DOWNLOAD_DELAYve eşzamanlılık satırlarını silmek. Çatının çıplak varsayılanları (robots.txt kapalı, bekleme yok, alan adı başına 8 istek) küçük bir siteyi zorlayacak kadar hızlıdır. 407alırken taramayı sürdürmek. Her istek üç kez denenir, hiçbiri başarılı olmaz; önce kimlik bilgisini düzeltin.- Rotating gateway'in üstüne ayrıca rotasyon middleware'i kurmak. Ağ geçidi bu işi zaten yapar; ikinci katman yalnızca hata ayıklamayı zorlaştırır.
DOWNLOAD_TIMEOUT'u varsayılanda bırakmak. Yanıt vermeyen tek bir bağlantı bir yuvayı üç dakika meşgul eder.- Parolayı
settings.pyiçine yazıp depoya göndermek. Adresi ortam değişkeninden okuyun.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Birkaç sayfalık tek seferlik iş | Requests + BeautifulSoup yeterli, Scrapy şart değil |
| Binlerce sayfa, düzenli tekrar | Scrapy projesi, şablon ayarları korunarak |
| Bütün trafiğin proxy'den geçmesi | TekProxyMiddleware ya da https_proxy ortam değişkeni |
| Yalnızca belirli isteklerin farklı çıkıştan gitmesi | O isteklerde meta["proxy"] |
| Çok sayıda IP'ye yük dağıtma | Rotating gateway, tek adres, middleware yok |
| Elinizde sabit proxy listesi var | ProxyHavuzuMiddleware, sıra numarası 550-750 arası |
| Oturum boyunca aynı IP | Sticky Proxy ve tek adres |
Günlükte 429 artıyor | Eşzamanlılığı düşürün, DOWNLOAD_DELAY'i büyütün, AutoThrottle'ı açın |
| SOCKS5 zorunlu | HttpxDownloadHandler (deneysel) |
| Veri JavaScript ile geliyor | Önce JSON uç noktası, olmazsa scrapy-playwright |
Sıkça sorulan sorular
Scrapy spider nedir?
Spider, scrapy.Spider sınıfından türeyen ve iki şeyi tanımlayan bir Python sınıfıdır: taramanın hangi adreslerden başlayacağı ve gelen yanıttan hangi verinin, hangi yeni bağlantıların çıkarılacağı. Kuyruk, indirme ve hata yönetimi spider'ın değil çatının işidir.
Scrapy kullanımı için Python bilmek şart mı?
Evet. Spider bir Python sınıfıdır ve seçicileri, döngüleri, sözlükleri kullanırsınız. Temel Python bilen biri ilk spider'ını yazabilir; middleware ve pipeline tarafı için sınıf yapısına aşina olmak gerekir.
Proxy'nin gerçekten kullanıldığını nasıl anlarım?
IP adresinizi JSON olarak döndüren bir servise Scrapy ile istek gönderin ve yanıttaki adresi kendi IP'nizle karşılaştırın. parse içinde response.meta.get("proxy") değerini günlüğe yazmak da hangi isteğin hangi proxy'den gittiğini gösterir. Genel yöntemler Proxy Nasıl Test Edilir? yazımızda.
Scrapy mi Selenium mu daha hızlı?
Aynı donanımda Scrapy belirgin biçimde daha çok sayfa işler, çünkü tarayıcı açmaz ve istekleri asenkron gönderir. Hız ancak sayfa JavaScript gerektirmiyorsa anlamlıdır; veri tarayıcıda oluşuyorsa Scrapy tek başına o veriyi göremez.
AutoThrottle açıkken DOWNLOAD_DELAY gereksiz mi olur?
Hayır, tabanı o belirler. AutoThrottle beklemeyi hiçbir zaman DOWNLOAD_DELAY'in altına indirmez. Hızlı yanıt veren bir sunucuda bekleme bu tabana iner ve orada kalır; bu yüzden DOWNLOAD_DELAY = 0 ile AutoThrottle'a güvenmek, hızlı sunucularda neredeyse beklemesiz istek göndermek demektir.
Her istekte farklı IP kullanmak engellenmeyi önler mi?
Tek başına önlemez. Siteler hızı yalnızca IP'ye göre değil, oturuma, çereze ve davranışa göre de sayar. Rotasyon yükü birçok çıkışa dağıtır; robots.txt'ye uymak, düşük eşzamanlılık ve dürüst bir User-Agent ile birlikte anlam kazanır. Meşru yöntemleri Web Scraping'de Engellenmeden Veri Toplama Yöntemleri yazımızda topladık.
Özetle
Scrapy'de proxy, isteğin meta["proxy"] alanıdır ve bu alanı üç yoldan doldurabilirsiniz: istek başına elle, ortam değişkeniyle ya da bir downloader middleware ile. Bütün trafiğin, robots.txt dahil, aynı çıkıştan gitmesi için son iki yoldan biri gerekir. Rotating gateway kullanıyorsanız tek adres yeter; sabit bir listeniz varsa 550-750 arasında numaralanmış bir middleware dağıtımı ve hata sayımını üstlenir. Hızı proxy değil DOWNLOAD_DELAY, alan adı başına eşzamanlılık ve AutoThrottle belirler; şablonun getirdiği temkinli ayarları koruyun. Tarama işlerinize uygun proxy türlerini proxy hizmetlerimizde bulabilirsiniz.


