


































Estás recopilando datos de una tienda que carga sus precios con JavaScript. El HTML que llega con Requests viene vacío, así que pasas a Playwright y la página se abre sin problemas. Cuando el trabajo crece hay que pasar el tráfico por un proxy, y el primer intento termina con net::ERR_TUNNEL_CONNECTION_FAILED o con "Browser does not support socks5 proxy authentication". La mayoría de los tutoriales presentan Playwright como una herramienta de automatización de pruebas, así que la parte del proxy suele reconstruirse a partir de hilos de foros y gestores de incidencias.
En este artículo definimos brevemente qué es Playwright, damos la instalación en Python y en Node.js una junto a la otra y después pasamos al proxy: la diferencia entre proxy a nivel de navegador y a nivel de contexto, la autenticación con usuario y contraseña, el comportamiento de Chromium con SOCKS5, la elección entre rotativo y sticky, el ahorro de tráfico al cortar las peticiones de imágenes y fuentes, la verificación de la IP y una tabla de errores. Ejecutamos todos los ejemplos del artículo con Playwright 1.63 y Chromium a través de un proxy local de prueba con autenticación.
¿Qué es Playwright?
Playwright es una biblioteca de código abierto para automatizar navegadores desarrollada por Microsoft. Abre un navegador real desde el código, va a una dirección, hace clic, rellena formularios y lee los elementos de la página. Controla los motores Chromium, Firefox y WebKit con la misma API y tiene versiones oficiales para Node.js, Python, Java y .NET.
La herramienta nació para las pruebas de extremo a extremo y la mayoría de las guías la presentan desde ese lado. Para los equipos de datos su valor está en otra parte: ejecuta en un navegador real la página generada con JavaScript, espera por sí sola hasta que aparece un elemento y te permite escuchar las llamadas a la API que la página hace en segundo plano y cortar las peticiones innecesarias. Para saber si una página necesita de verdad un navegador, consulta antes nuestro artículo Páginas estáticas y dinámicas en web scraping; si los datos están en el código fuente de la página o en un endpoint JSON, abrir un navegador es un coste innecesario.
Los trabajos que se hacen con Playwright se agrupan, a grandes rasgos, en cuatro apartados:
- Recopilar datos de páginas dinámicas (listados de productos, precios, stock, número de reseñas).
- Probar cómo se ve tu propio sitio o tu aplicación desde distintos países.
- Generar capturas de pantalla y PDF.
- Hacer que agentes de IA usen un navegador. Los detalles de este último punto están en nuestro artículo sobre Playwright MCP, su instalación y los ajustes de proxy.
Las diferencias de arquitectura con Selenium y cuál elegir en cada proyecto las tratamos en un artículo aparte: diferencias entre Playwright y Selenium.
¿Cómo se instala Playwright?
La instalación tiene dos pasos: primero la biblioteca y después los binarios de los navegadores. Playwright no usa el Chrome instalado en el sistema, sino navegadores que descarga él mismo y cuya versión fija. El error de "instalé la biblioteca pero no encuentra el navegador" se debe a haberse saltado el segundo paso.
En Python, crea un entorno virtual e instala la biblioteca. La documentación oficial de la biblioteca de Python da los mismos pasos también para poetry y uv.
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install playwright
playwright install chromium
En Node.js:
npm init -y
npm install playwright
npx playwright install chromium
Si no le indicas un navegador al comando install, se descargan los tres motores. En trabajos de scraping suele bastar con Chromium. Si vas a escribir pruebas, se recomienda el paquete pytest-playwright en Python y @playwright/test en Node.js; para la recopilación de datos basta con la instalación sencilla de la biblioteca que aparece arriba.
En Python hay dos API: sync_api y async_api. En scripts que abren páginas de una en una, la versión síncrona se lee mejor. Si vas a procesar varias páginas a la vez, usa la versión basada en asyncio; el ejemplo completo del final del artículo está escrito así.
¿Cómo se define un proxy en Playwright?
La sección HTTP Proxy de la documentación de red de Playwright define dos niveles: el proxy se indica para todo el navegador o por separado para cada contexto. En ambos casos se usa el mismo objeto:
| Campo | ¿Obligatorio? | Significado |
|---|---|---|
server | Sí | http://pr.proxynet.io:8000 o socks5://host:puerto. Si no se escribe el esquema, se considera un proxy HTTP |
username | No | Usuario para la autenticación del proxy HTTP |
password | No | Contraseña para la autenticación del proxy HTTP |
bypass | No | Dominios que no pasan por el proxy, separados por comas (.ejemplo.com, api.tuempresa.com) |
En Python, la definición a nivel de navegador tiene este aspecto:
from playwright.sync_api import sync_playwright

PROXY = {
    "server": "http://pr.proxynet.io:8000",
    "username": "user",
    "password": "pass",
}

with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    page = browser.new_page()
    page.goto("https://httpbin.org/ip")
    print(page.inner_text("body"))  # IP de salida del proxy
    browser.close()
El equivalente en Node.js:
import { chromium } from "playwright";

const browser = await chromium.launch({
  proxy: {
    server: "http://pr.proxynet.io:8000",
    username: "user",
    password: "pass",
  },
});
const page = await browser.newPage();
await page.goto("https://httpbin.org/ip");
console.log(await page.innerText("body")); // IP de salida del proxy
await browser.close();
El punto al que hay que prestar atención es dónde van las credenciales. Escribir http://user:pass@pr.proxynet.io:8000 por costumbre de cURL o Requests aquí no sirve: Playwright toma del valor server solo el esquema, el host y el puerto, y no transmite al navegador el usuario y la contraseña incluidos en la dirección. Las credenciales se escriben siempre en los campos username y password. Esto tiene una ventaja añadida: si la contraseña contiene caracteres como @ o :, no tienes que ocuparte de la codificación de URL. La lógica general de los dos métodos está en Autenticación de proxy: user:pass o lista blanca de IP.
¿Qué diferencia hay entre el proxy a nivel de navegador y a nivel de contexto?
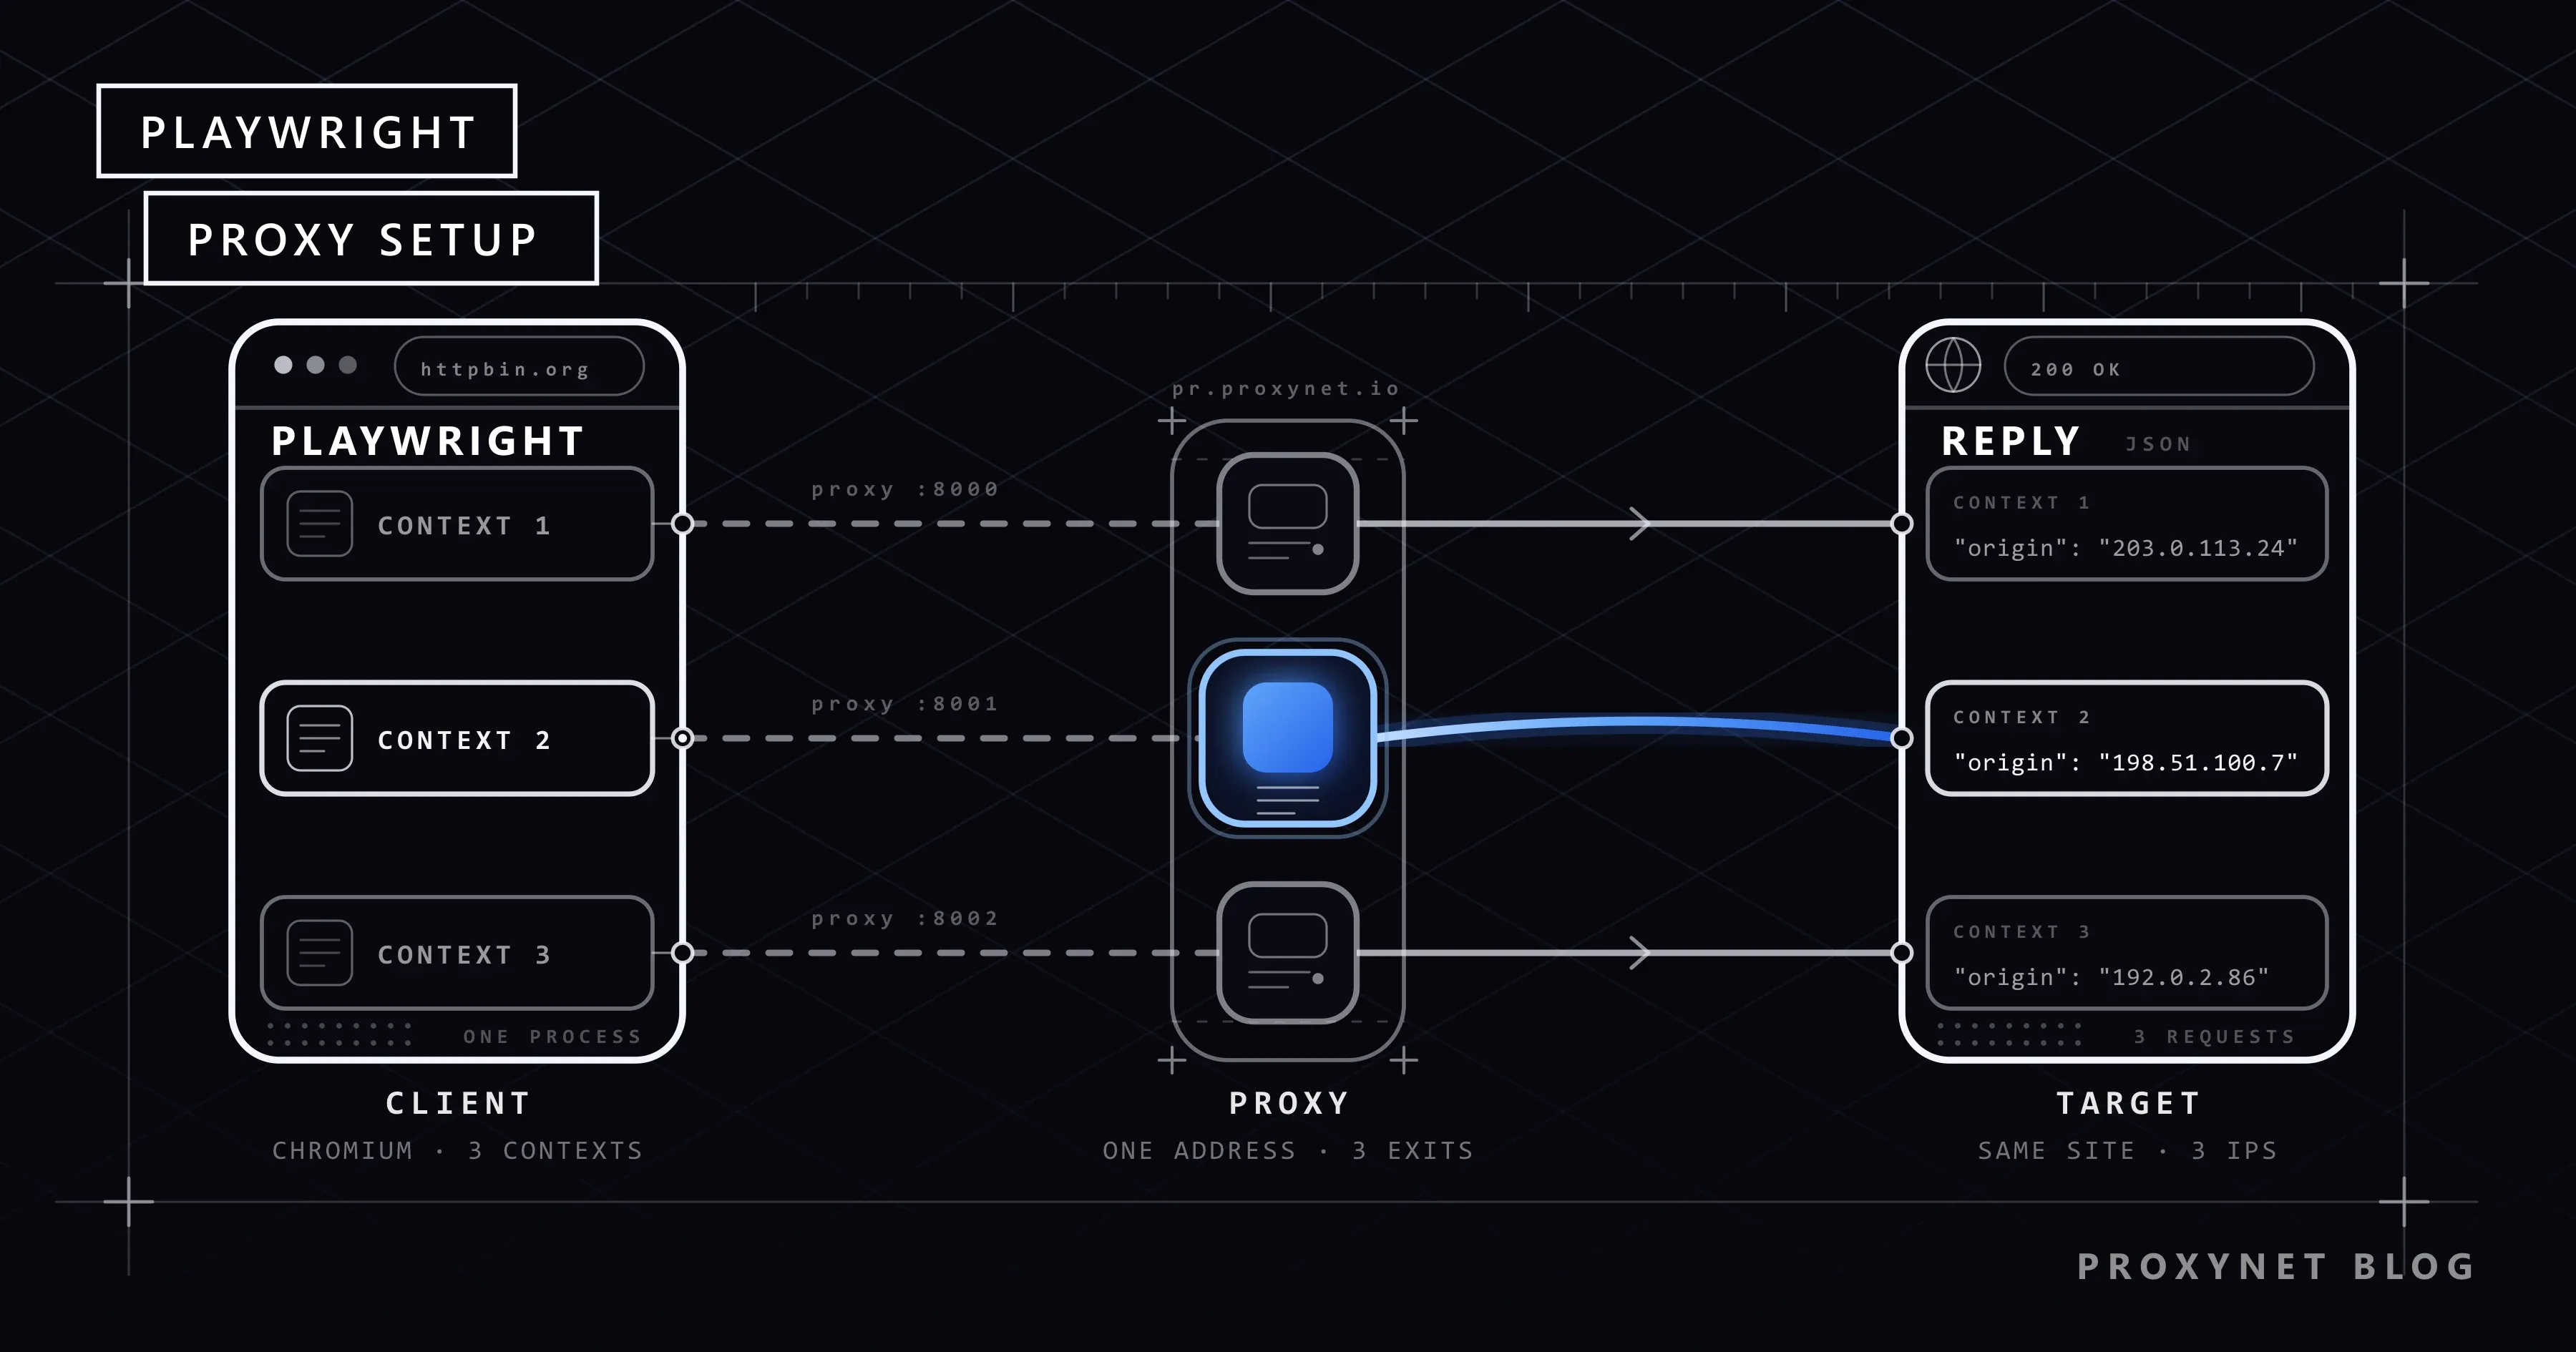
En Playwright, un contexto es una sesión de navegador aislada de las demás: tiene sus propias cookies, su propia caché y su propio almacenamiento local. Se parece a una ventana de incógnito, pero en un solo proceso de navegador pueden abrirse decenas a la vez, y abrir uno cuesta mucho menos que iniciar un navegador nuevo.
Cuando pasas el proxy a la llamada new_context() en lugar de a launch(), el ajuste solo afecta a ese contexto:
from playwright.sync_api import sync_playwright

PROXIES = [
    {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"},
    {"server": "http://pr.proxynet.io:8001", "username": "user", "password": "pass"},
]

with sync_playwright() as p:
    browser = p.chromium.launch()  # el navegador se abre una vez, sin proxy
    for proxy in PROXIES:
        context = browser.new_context(proxy=proxy)  # cada contexto con su propio proxy
        page = context.new_page()
        page.goto("https://httpbin.org/ip")
        print(proxy["server"], page.inner_text("body"))
        context.close()  # las cookies y la caché se borran junto con el contexto
    browser.close()
Al ejecutar este ejemplo con dos proxies locales distintos, la petición de cada contexto quedó registrada en el log de su propio proxy, y un tercer contexto sin proxy se conectó directamente. Las guías antiguas dicen que en Windows, para Chromium, hay que escribir en la llamada launch() un proxy de relleno como http://per-context. Era una limitación de versiones antiguas de Playwright y se eliminó del código en agosto de 2024; la documentación actual tampoco incluye ya esa nota. Con Playwright 1.63 en Windows 11 el ejemplo funcionó sin proxy de relleno.
Nivel de navegador (launch) | Nivel de contexto (new_context) | |
|---|---|---|
| Alcance | Todos los contextos y páginas | Solo ese contexto |
| IP distintas en un solo navegador | No | Sí, un proxy por contexto |
| Para cambiar de proxy | Cierras el navegador y lo vuelves a abrir | Cierras el contexto y abres uno nuevo |
| Cookies y sesión | Los contextos siguen separados | Se aíslan junto con el proxy |
| Adecuado para | Scripts y pruebas a los que les basta un punto de salida | Muchas sesiones independientes, comparación entre países |
La regla práctica es esta: una sesión, un contexto, una IP. No hay forma de cambiar el proxy dentro del mismo contexto, y está bien que sea así; una sesión cuyas cookies se mantienen mientras su IP cambia es, para el sitio de destino, un visitante incoherente.
¿Funciona Playwright con un proxy SOCKS5?
Funciona, pero sin usuario ni contraseña. Si das a server una dirección con el esquema socks5:// y añades username, Playwright devuelve este error sin llegar a iniciar el navegador:
BrowserType.launch: Browser does not support socks5 proxy authenticationLa misma comprobación se aplica a new_context(). La causa es el propio Chromium: la documentación de proxy de Chromium indica de forma expresa que no se admite ningún método de autenticación para SOCKSv5. Lo probamos el día de la redacción con un servidor SOCKS5 local. El único método que Chromium ofreció en su mensaje de negociación fue 0x00, es decir, "sin autenticación"; el método de usuario y contraseña (0x02) de la RFC 1929 no estaba en la lista. Incrustar las credenciales en la dirección (socks5://user:pass@...) tampoco cambió el resultado: Playwright descartó esa parte y, como el servidor exigía autenticación, la conexión se cerró con net::ERR_SOCKS_CONNECTION_FAILED. En un servidor SOCKS5 que no pedía autenticación la página se abrió sin problemas.
La solución es acreditar tu identidad con tu dirección IP y no con una contraseña. Añades la IP de salida del servidor donde se ejecuta el script a la lista de IP autorizadas en el panel del proxy y pasas solo el campo server:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    # Sin usuario ni contraseña: tu IP de salida debe estar en la lista de IP autorizadas del panel
    browser = p.chromium.launch(proxy={"server": "socks5://pr.proxynet.io:1080"})
    page = browser.new_page()
    page.goto("https://httpbin.org/ip")
    print(page.inner_text("body"))
    browser.close()
En nuestros registros de prueba Chromium envió al servidor SOCKS5 el nombre de dominio y no una dirección IP; es decir, la resolución DNS se hace en el lado del proxy y aquí no hace falta la distinción socks5h:// que se conoce de cURL. Para abrir páginas casi siempre basta un proxy HTTP, porque el tráfico HTTPS ya viaja por un túnel CONNECT. Cuándo conviene SOCKS5 lo explicamos en Diferencia entre SOCKS y HTTP: ¿cuál elegir?; el producto está en la página de Proxies SOCKS5.
¿Rotativo o sticky? Cuál para cada trabajo
Un navegador no se comporta como un script que envía una sola petición HTTP. Mientras se carga una página se abren conexiones separadas a distintos dominios para el documento principal, los scripts, las hojas de estilo, las imágenes y las llamadas a la API. En un gateway que cambia la IP de salida en cada conexión, esas conexiones pueden salir por IP distintas. Al rastrear páginas independientes entre sí esto no supone un problema. En cambio, en flujos con inicio de sesión, carrito o formulario de varios pasos, que la IP cambie en mitad de la sesión puede hacer que el sitio la cierre.
- Páginas independientes (listado de productos, categoría, resultados de búsqueda): Proxies rotativos encaja bien. La rotación la hace el gateway y no guardas una lista de proxies en tu código. Cómo funciona la rotación lo contamos en nuestro artículo sobre la rotación de IP.
- Flujos que necesitan sesión (iniciar sesión con tu propia cuenta, operaciones de varios pasos): con Proxies de sesión fija se mantiene la misma IP durante toda la vida del contexto. Tomas los datos de la sesión fija en el panel y los escribes en el campo
proxydel contexto. - Contenido que cambia según el país: abres un contexto por país y le das el punto de salida de ese país; un solo navegador y comparación lado a lado.
Dar un proxy por contexto es en sí mismo un esquema de rotación: al cerrar el contexto y abrir uno nuevo, las cookies y la IP se renuevan juntas.
¿Cómo se reduce el tráfico bloqueando imágenes y fuentes?
El tráfico de Proxies residenciales se factura por GB, y un navegador descarga todo lo que un cliente HTTP sencillo no descarga: imágenes de producto, fuentes web, vídeos. Si lo que necesitas es el precio y el título, no tiene sentido pagar por esos bytes. El mecanismo route de Playwright captura la petición antes de que salga a la red y puedes cancelarla según el tipo de recurso.
from playwright.sync_api import sync_playwright

BLOCKED = {"image", "media", "font"}


def filter_resources(route):
    if route.request.resource_type in BLOCKED:
        route.abort()
    else:
        route.continue_()


with sync_playwright() as p:
    browser = p.chromium.launch(proxy={
        "server": "http://pr.proxynet.io:8000",
        "username": "user",
        "password": "pass",
    })
    page = browser.new_page()
    page.route("**/*", filter_resources)
    page.goto("https://books.toscrape.com/")
    print(page.locator("article.product_pod h3 a").first.get_attribute("title"))
    browser.close()
La magnitud del ahorro depende de la página; dar un porcentaje general sería engañoso. Para medirlo en tu propio destino, abre la misma página con filtro y sin filtro y compara el contador de tráfico del panel del proxy. Dos advertencias: bloquear las hojas de estilo (stylesheet) y los scripts (script) puede impedir que la página genere su contenido, así que limita la lista a imágenes, medios y fuentes. Esta técnica es un método de ahorro; no se usa para eliminar los scripts de protección de un sitio.
El ahorro mayor suele estar dentro del tráfico que el navegador escucha. Las páginas dinámicas normalmente obtienen los datos de un endpoint JSON, y Playwright te permite leer esa respuesta directamente:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(proxy={
        "server": "http://pr.proxynet.io:8000",
        "username": "user",
        "password": "pass",
    })
    page = browser.new_page()
    with page.expect_response("**/api/quotes?page=1") as info:
        page.goto("https://quotes.toscrape.com/scroll")
    data = info.value.json()
    for quote in data["quotes"][:3]:
        print(quote["author"]["name"], "-", quote["text"][:60])
    browser.close()
En lugar de analizar el HTML con selectores, recibes datos estructurados. Si el endpoint no exige credenciales, el paso siguiente puede ser dejar el navegador por completo y llamar a esa dirección con un cliente HTTP sencillo.
¿Cómo se comprueba que el proxy funciona?
Bastan tres comprobaciones:
- Abre
https://httpbin.org/ipcon Playwright y compara la IP devuelta con la tuya. Si es distinta, el tráfico pasa por el proxy. - Abre la misma dirección con un contexto sin proxy. Si los dos resultados coinciden, el objeto
proxyse pasó a la llamada equivocada o el dominio entró en la listabypass. - Si apuntas a un país, comprueba la ubicación de la IP en un servicio de geolocalización. Por qué las bases de datos difieren entre sí lo explicamos en ¿Por qué mi IP muestra otra ubicación? Qué revela una IP.
Probar el proxy al margen de Playwright permite saber si el problema está en el código o en la red. Las pruebas desde la línea de comandos están en ¿Funciona tu proxy? Cómo probar un proxy.
Ejemplo completo: contextos concurrentes, reintentos y bloqueo de recursos
El script siguiente rastrea seis páginas generadas con JavaScript. Mantiene como máximo tres contextos abiertos a la vez, usa un contexto y una conexión al proxy limpios en cada intento, bloquea imágenes y fuentes, y reintenta los errores transitorios con espera exponencial y un componente aleatorio. En los errores que indican que no se llega al proxy en absoluto no reintenta, porque lo que arregla esa situación no es esperar, sino la configuración.
import asyncio
import random

from playwright.async_api import Error, async_playwright

PROXY = {
    "server": "http://pr.proxynet.io:8000",
    "username": "user",
    "password": "pass",
}
URLS = [f"https://quotes.toscrape.com/js/page/{n}/" for n in range(1, 7)]
BLOCKED = {"image", "media", "font"}
CONCURRENCY = 3  # contextos abiertos a la vez
ATTEMPTS = 3
# Errores en los que reintentar no cambia el resultado: primero se corrige la configuración
FATAL = ("ERR_PROXY_CONNECTION_FAILED", "ERR_TUNNEL_CONNECTION_FAILED", "ERR_SOCKS_CONNECTION_FAILED")


async def filter_resources(route):
    if route.request.resource_type in BLOCKED:
        await route.abort()
    else:
        await route.continue_()


async def scrape(browser, url, limit):
    async with limit:
        for attempt in range(ATTEMPTS):
            context = await browser.new_context(proxy=PROXY)  # sesión limpia en cada intento
            try:
                page = await context.new_page()
                await page.route("**/*", filter_resources)
                response = await page.goto(url, timeout=30_000)
                if response is None or response.status >= 400:
                    raise Error(f"HTTP {response.status if response else 'sin respuesta'}")
                quotes = page.locator("div.quote span.text")
                await quotes.first.wait_for(timeout=10_000)  # espera a que JavaScript genere el contenido
                return url, await quotes.all_inner_texts()
            except Error as exc:  # TimeoutError también deriva de Error
                if any(code in str(exc) for code in FATAL):
                    raise
                if attempt == ATTEMPTS - 1:
                    raise
                await asyncio.sleep(2**attempt + random.random())
            finally:
                await context.close()


async def main():
    async with async_playwright() as p:
        browser = await p.chromium.launch()
        limit = asyncio.Semaphore(CONCURRENCY)
        results = await asyncio.gather(
            *(scrape(browser, url, limit) for url in URLS), return_exceptions=True
        )
        await browser.close()
    for url, result in zip(URLS, results):
        if isinstance(result, Exception):
            print(url, "ERROR:", str(result).splitlines()[0])
        else:
            print(url, len(result[1]), "citas")


asyncio.run(main())
En nuestro proxy local de prueba las seis páginas volvieron con diez citas cada una; cuando escribimos mal el puerto del proxy a propósito, el script se detuvo con ERR_PROXY_CONNECTION_FAILED sin reintentar. En un trabajo real, añade dos cosas. La lógica de reintento que respeta la cabecera Retry-After en las respuestas 429 y 503 tómala del ejemplo de Códigos de estado HTTP en web scraping: 403, 407, 429, 503; aquí no la repetimos. Ajusta también la concurrencia a la memoria: cada contexto y cada página consumen memoria, así que empieza con un valor bajo de CONCURRENCY y súbelo mientras vigilas tu servidor. El detalle de las estrategias de espera (por qué se espera a un elemento y no a networkidle) está en el artículo sobre páginas estáticas y dinámicas que citamos arriba.
Tabla de errores: ERR_PROXY_CONNECTION_FAILED, ERR_TUNNEL_CONNECTION_FAILED, 407
Provocamos a propósito cada una de las filas siguientes en el proxy local de prueba.
| Lo que ves | Qué significa | Qué hacer |
|---|---|---|
net::ERR_PROXY_CONNECTION_FAILED | No se pudo establecer la conexión TCP con el servidor proxy: la dirección o el puerto son incorrectos, o un cortafuegos corta la salida | Revisa el valor de server y el puerto, prueba la misma dirección con cURL |
net::ERR_TUNNEL_CONNECTION_FAILED | Se llegó al proxy, pero la petición CONNECT recibió una respuesta distinta de 200: se rechazó la autenticación (407) o el proxy no alcanzó el destino (502) | Revisa primero las credenciales y después la dirección de destino |
Tiempo de espera agotado en goto con una dirección HTTPS, 407 en el log del proxy | El usuario o la contraseña son incorrectos o no se indicaron. En nuestra prueba el evento requestfailed informó de ERR_TUNNEL_CONNECTION_FAILED, pero goto esperó hasta agotar el tiempo en lugar de lanzar un error | Mira el error real con page.on("requestfailed") y corrige los campos username y password |
Código de respuesta 407 en una dirección HTTP (sin cifrar) | La misma causa; como no hay túnel, la respuesta del proxy llega como respuesta de la página | Revisa response.status y corrige las credenciales |
Browser does not support socks5 proxy authentication | Se indicó username junto con una dirección socks5:// | Quita las credenciales y usa la lista de IP autorizadas, o pasa a un proxy HTTP |
net::ERR_SOCKS_CONNECTION_FAILED | El servidor SOCKS5 exige autenticación o tu IP no está en la lista de IP autorizadas | Añade tu IP de salida a la lista en el panel |
| La página se abre pero la IP es la tuya | El objeto proxy no llegó a aplicarse o el dominio está en la lista bypass | Confirma que pasaste el objeto a la llamada launch o new_context |
La tercera fila es la que más tiempo hace perder: el script no da error, solo espera treinta segundos hasta agotar el tiempo, y el problema se atribuye a la lentitud del sitio de destino. Añadir estas dos líneas durante el desarrollo acorta el diagnóstico:
page.on("requestfailed", lambda r: print("FALLIDA:", r.url, r.failure))
page.on("response", lambda r: print(r.status, r.url) if r.status >= 400 else None)
El significado general del código 407 y cómo se ve en otras bibliotecas está en nuestro artículo sobre códigos de estado HTTP; para los errores del tipo "el servidor proxy no responde" fuera de la automatización de navegadores, consulta nuestro artículo sobre los errores de proxy y el mensaje "el servidor proxy no responde".
Casos de uso
- Páginas dinámicas de tiendas y catálogos: datos de precio y stock cargados con JavaScript. El planteamiento general está en nuestra página de la solución de extracción de datos.
- Rastreo periódico de muchas páginas: el descubrimiento de páginas y la gestión de colas están en la página de la solución de rastreador web; los patrones de paginación, en nuestro artículo sobre la paginación en web scraping.
- Pruebas de tu aplicación desde distintos países: un contexto por país, cada uno con el punto de salida de ese país. Más detalles en la página de pruebas de aplicaciones.
- Seguimiento de precios de la competencia: un rastreo diario con bloqueo de recursos y que respeta los límites de frecuencia. La parte de negocio está en nuestro artículo sobre el seguimiento de precios de la competencia en e-commerce.
Sea cual sea el trabajo, el marco es el mismo: respeta las reglas de robots.txt y las condiciones de uso del sitio, prefiere la API oficial si existe y mantén tu ritmo de peticiones en un nivel que el sitio pueda soportar. Cómo se lee un archivo robots.txt lo explicamos en Qué es robots.txt y cómo leerlo.
Errores frecuentes
- Incrustar las credenciales en la dirección de
server. Playwright ignora esa parte; el resultado es un407o un tiempo de espera agotado. - Probar usuario y contraseña con SOCKS5. Chromium no lo admite; usa la lista de IP autorizadas o un proxy HTTP.
- Iniciar un navegador nuevo para cada página. El navegador se abre una vez; el aislamiento y el cambio de proxy se hacen con contextos.
- Pasar un flujo con sesión por un gateway rotativo. Las conexiones salen por IP distintas y la sesión se cae. Usa sticky.
- No cerrar los contextos. Cada contexto abierto retiene memoria; ciérralo en el bloque
finally. - Bloquear scripts y hojas de estilo. La página no puede generar su contenido y tu selector vuelve vacío.
- Atribuir al sitio de destino un tiempo de espera agotado en
goto. Mira antes el eventorequestfailedy las credenciales del proxy. - Dar por buena una respuesta
200sin mirar el contenido. Confirma que el elemento que esperas está en la página; las pantallas de verificación también pueden devolver200.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Script o prueba a los que les basta un punto de salida | launch(proxy=...), proxy HTTP |
| Varias sesiones independientes en un solo navegador | new_context(proxy=...), un proxy por contexto |
| Rastreo masivo de páginas independientes | Proxy rotativo, una única dirección de gateway |
| Flujo de varios pasos con inicio de sesión | Proxy sticky, un contexto una IP |
| SOCKS5 es obligatorio | Lista de IP autorizadas, sin username ni password |
| Tráfico facturado por GB | Bloquea las peticiones de imágenes, medios y fuentes con route; si es posible, lee la respuesta JSON |
| Datos en el código fuente de la página o en un endpoint JSON | Cliente HTTP sencillo en lugar de Playwright |
| Hacer que un agente de IA use un navegador | Playwright MCP |
Preguntas frecuentes
¿Playwright es gratuito?
Sí. Es un proyecto de código abierto con licencia Apache 2.0; no se paga por la biblioteca ni por los binarios de navegador que descarga. El coste viene de los recursos de servidor que consumen los navegadores y del tráfico de proxy que uses.
¿Conviene usar Playwright con Python o con Node.js?
El ajuste del proxy y el comportamiento del navegador son iguales en los dos lenguajes, porque ambos hablan con el mismo controlador. Lo que debe decidir es el lenguaje de tu equipo y de tu flujo de procesamiento de datos. La comparación de los dos lenguajes desde el punto de vista del scraping está en Web scraping: ¿JavaScript o Python?.
¿Puedo usar un proxy distinto para cada página?
El proxy se asocia al contexto, no a la página. Si quieres una IP distinta para cada página, abre cada página en su propio contexto. Si usas un gateway rotativo tampoco hace falta; la rotación la hace el gateway.
¿Funciona la autenticación SOCKS5 con Firefox o WebKit?
Cuando se indica un usuario junto con una dirección socks5://, Playwright lanza el error en su propio paso de validación, antes de iniciar el navegador, y esa comprobación no mira el tipo de navegador. Nosotros solo lo probamos con Chromium; para los otros motores da por hecho también la lista de IP autorizadas.
¿El proxy se comporta de otra forma en modo headless?
No. El objeto proxy se aplica igual con ventana y sin ventana. Si quieres ver el problema con tus propios ojos, puedes abrir la ventana con launch(headless=False) y ejecutar el mismo script.
¿Usar un proxy hace desaparecer las pantallas de verificación?
No. El proxy solo cambia por qué IP sale la petición; el ritmo de peticiones, las señales del navegador y la coherencia de la sesión siguen igual. Por qué aparecen esas pantallas lo explicamos en Puppeteer y CAPTCHA: por qué aparece y cómo reducirlo; lo que se cuenta allí vale también para Playwright. No recomendamos complementos para evadir la detección: el camino duradero es un ritmo razonable, una sesión coherente y, si existe, la API oficial.
En resumen
En Playwright el proxy es un único objeto: server, username, password. Si lo pasas a la llamada launch(), todo el navegador sale por el proxy; si lo pasas a new_context(), solo esa sesión. El segundo camino significa una IP distinta por contexto en un solo navegador. Las credenciales no se escriben dentro de la dirección, con SOCKS5 se usa la lista de IP autorizadas en lugar de la contraseña, en los flujos con sesión se elige sticky y en las páginas independientes, rotativo. Si pagas el tráfico por GB, bloquea imágenes y fuentes; si ves tiempos de espera agotados, mira primero el evento requestfailed. Los tipos de proxy adecuados para tu trabajo los encuentras en nuestros servicios de proxy.


