Un panel de control de precios muestra que un competidor bajó los precios de 300 productos de la noche a la mañana, y el director comercial quiere una respuesta para el lunes. El viernes, un analista abre las filas en bruto. Un tercio de las «rebajas» son precios en euros en una columna que el informe lee como libras, porque el trabajo de recopilación se ejecutó desde un servidor de otro país, y cuarenta filas llevan el título de una página de verificación en lugar del nombre de un producto. Todos los trabajos terminaron con éxito y, aun así, los datos no podían sostener la decisión para la que se recopilaron. De esa brecha trata la calidad de los datos.
Este artículo explica qué significa la calidad de los datos, las seis dimensiones que se usan para describirla, cómo convertirlas en métricas y comprobaciones automáticas, en qué se diferencia la calidad de la limpieza, el gobierno y la integridad de los datos, cómo fallan los datos web sin dar ningún error y quién responde de ella.
¿Qué es la calidad de los datos?
La calidad de los datos es lo bien que un conjunto de datos sirve a un propósito concreto, así que los mismos datos pueden bastar para un trabajo y quedarse cortos para otro. El Data Quality Framework (marco de calidad de datos) del Gobierno del Reino Unido la define como «adecuación al propósito» y la resume en una pregunta: ¿son estos datos lo bastante buenos para lo que quiero hacer con ellos?
Piensa en una tabla de precios de la competencia que se recopila una vez al día. Para un informe mensual sobre niveles de precios funciona, aunque falten algunos productos algunos días. Para una regla de reajuste automático de precios que reacciona en menos de una hora, la misma tabla se queda corta: un precio de ayer está desfasado y un solo valor erróneo mueve tu propio precio. La calidad nunca es una propiedad de los datos por sí solos; es la medida de los datos frente a un uso.
¿Cuáles son las seis dimensiones de la calidad de los datos?
Las seis dimensiones más usadas son exactitud, completitud, coherencia, actualidad, validez y unicidad. Las definió DAMA UK, una asociación de gestión de datos, y el Gobierno del Reino Unido las recomienda en un breve texto explicativo sobre las seis dimensiones:
- Exactitud: los datos coinciden con la realidad. Un producto guardado a 19,99 cuesta de verdad 19,99 en la página de la tienda.
- Completitud: están todos los valores que el trabajo necesita. Un precio sin moneda está incompleto.
- Coherencia: los valores no se contradicen, ni dentro de un registro ni entre conjuntos de datos. «Agotado» junto a unas existencias de 40 unidades es incoherente.
- Actualidad: los datos están al día cuando se necesitan. El precio de ayer sirve para un informe semanal y llega tarde para una alerta del mismo día.
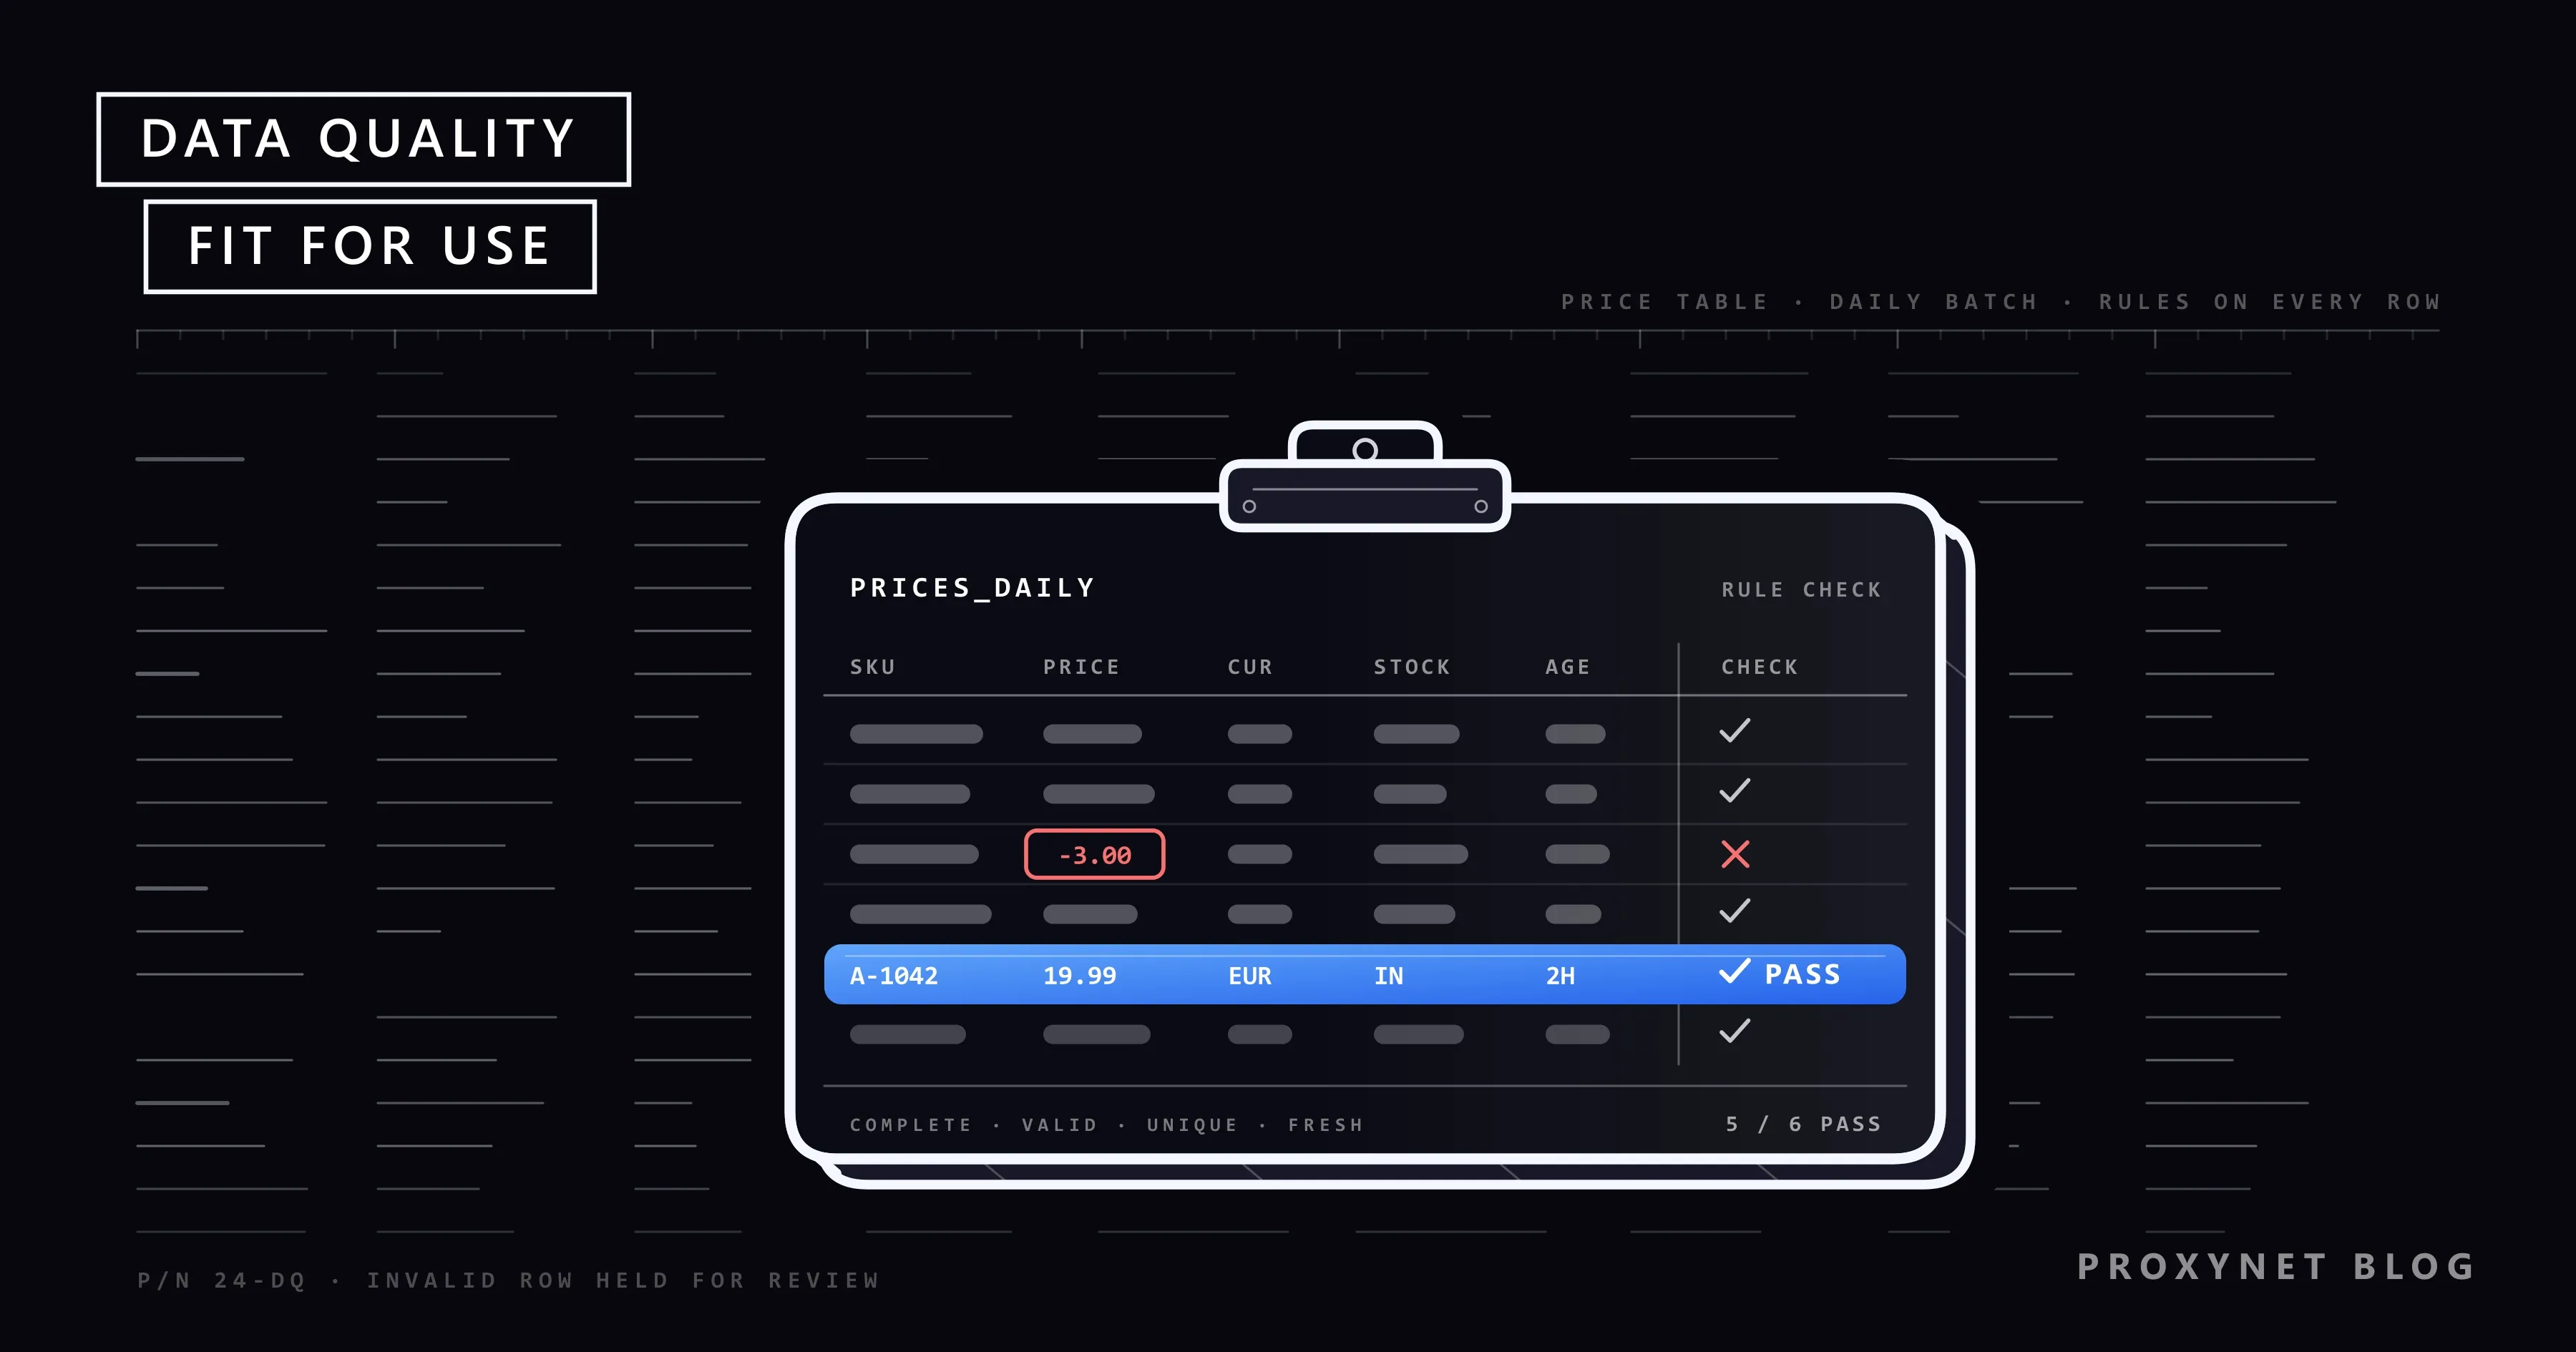
- Validez: los valores siguen el formato, el tipo y el rango esperados. Un precio de -3 o el código de moneda «EURO» no pasan.
- Unicidad: cada elemento del mundo real aparece una vez. Un producto recopilado desde dos direcciones cuenta dos veces en cada promedio.
Las dimensiones se solapan, pero ninguna sustituye a otra. Un valor puede ser válido y aun así erróneo: «EUR» es un código de moneda válido, pero inexacto si la tienda cobraba en libras. Por eso eliges las dimensiones de las que depende tu propósito y las compruebas juntas; la guía británica trata la lista como un punto de partida, no como una regla fija.
| Dimensión | Pregunta que responde | Comprobación de ejemplo | Métrica típica |
|---|---|---|---|
| Exactitud | ¿Coincide con la realidad? | Comparar una muestra con la fuente | % de aciertos en la muestra |
| Completitud | ¿Está todo lo necesario? | Precio y moneda no vacíos | % de filas completas |
| Coherencia | ¿Concuerdan los valores? | Agotado significa existencias 0 | % de filas coherentes |
| Actualidad | ¿Es lo bastante reciente? | Recopilado en las últimas 24 horas | Horas desde la recopilación |
| Validez | ¿Es correcto el formato? | Precio mayor que 0, moneda conocida | % de valores válidos |
| Unicidad | ¿Aparece cada cosa una vez? | Una fila por producto y día | Tasa de duplicados |
¿Cómo se mide la calidad de los datos?
La calidad de los datos se mide convirtiendo cada dimensión relevante en una regla que un programa pueda comprobar, aplicando las reglas a los datos y siguiendo la proporción de registros que las cumplen. Seis pasos cubren la mayoría de los casos:
- Elige los campos críticos. Enumera las decisiones que alimentan los datos y los campos de los que dependen. En un seguimiento de precios: ID de producto, precio, moneda, estado de existencias y momento de la recopilación.
- Escribe las reglas. Define qué significa «bueno» en términos comprobables: «el precio es un número mayor que cero», «recopilado en las últimas 24 horas».
- Perfila los datos. Mira lo que contienen en realidad: valores vacíos, valores distintos, mínimo y máximo, formatos frecuentes. El perfilado suele revelar reglas que nadie escribió, como un precio de relleno de 0,01.
- Puntúa cada dimensión. Ejecuta las reglas y convierte los resultados en proporciones por campo.
- Fija umbrales. Acuerda puntuaciones aceptables con quienes usan los datos, por ejemplo una completitud del precio superior al 99 %. Asigna una acción a cada umbral: avisar, retener el lote o bloquearlo.
- Vigila y alerta. Ejecuta las mismas comprobaciones en cada lote, guarda las puntuaciones a lo largo del tiempo y avisa a alguien cuando una puntuación cruce su umbral o dé un salto entre dos ejecuciones.
Las métricas son proporciones sencillas. En un catálogo ficticio de 10.000 filas de productos, 9.700 filas con precio dan un 97 % de completitud, y 150 filas que repiten un producto ya listado dan una tasa de duplicados del 1,5 %. La validez es la proporción de valores que cumplen las reglas de formato y rango, y la antigüedad de los datos (freshness lag) es el tiempo transcurrido desde que se recopiló cada registro. La exactitud es la proporción de valores correctos en una muestra comparada a mano con la fuente, la única dimensión que ninguna regla puede comprobar del todo.
Algunos equipos lo combinan todo en una sola puntuación de calidad de datos, a menudo la proporción de comprobaciones superadas. Resulta práctica en un panel de control, pero oculta detalles: un 98 % global puede significar que el campo de precio falló en todas las filas de un mercado.
¿Cómo son las comprobaciones de calidad de datos en la práctica?
Las comprobaciones de calidad de datos son pequeñas pruebas automáticas que se ejecutan donde los datos entran en un sistema, cambian o salen de él, y cada una deja pasar el lote, avisa o lo detiene. Los tipos habituales:
- Comprobaciones de esquema y tipo: existen las columnas esperadas y contienen el tipo correcto.
- Comprobaciones de formato y rango: las fechas se pueden interpretar, los códigos de moneda salen de una lista conocida y los precios se mantienen en un rango plausible.
- Comprobaciones referenciales: un valor que apunta a otro sitio encuentra su destino, como el ID de producto de cada fila de precios en la tabla de productos.
- Comprobaciones entre campos: los campos de un registro concuerdan, por ejemplo un precio de oferta no superior al precio normal.
- Comprobaciones de volumen y actualidad: el lote tiene el número habitual de filas y llegó a tiempo; 200 filas en lugar de 20.000 son un problema aunque las 200 estén impecables.
- Alertas de anomalías: una estadística se aleja mucho de su historial reciente, como el precio medio de una categoría que se reduce a la mitad de la noche a la mañana.
Ejecuta las comprobaciones estrictas donde entran los datos, para que las filas erróneas queden en cuarentena (apartadas para revisión en lugar de cargarse o borrarse), y las de anomalías después de cada lote. Después corrige las causas en el origen; el marco británico recomienda el análisis de causa raíz frente a los arreglos temporales.
¿En qué se diferencia la calidad de los datos de la limpieza, el gobierno y la integridad?
La calidad de los datos mide si los datos sirven para un uso; la limpieza es una forma de mejorarla, el gobierno de datos es el conjunto de reglas y funciones que la rodean, y la integridad significa que los datos no se han modificado ni perdido sin autorización. Estos términos se confunden a menudo:
| Término | Qué es | Pregunta que responde |
|---|---|---|
| Calidad de los datos | Lo adecuados que son los datos para un uso | ¿Podemos fiarnos de ellos para esta decisión? |
| Limpieza de datos | Reparar valores que ya tienes | ¿Cómo corregimos lo que está mal? |
| Validación de datos | Comprobación de reglas al entrar o antes del uso | ¿Cumple este registro las reglas? |
| Gobierno de datos | Políticas, funciones y propiedad | ¿Quién decide y con qué reglas? |
| Integridad de los datos | Protección frente a cambios no autorizados | ¿Siguen los datos tal como se guardaron? |
| Enriquecimiento de datos | Añadir campos que faltan desde otras fuentes | ¿Qué más necesitamos saber? |
La limpieza es el paso de reparación: quitar espacios, convertir en números los precios que llegan como texto, fusionar duplicados. Mejora la calidad, pero no la define, y limpiar sin comprobar puede dar datos ordenados que siguen siendo erróneos. Tienes un script completo y probado en Cómo limpiar datos de scraping con pandas.
La integridad viene del campo de la seguridad. El NIST, el instituto de normas de Estados Unidos, define la integridad de los datos como la propiedad de que los datos no se han alterado de forma no autorizada desde que se crearon, transmitieron o almacenaron. Una base de datos puede conservar intacta su integridad mientras guarda un precio que era erróneo desde el principio.
El enriquecimiento eleva la completitud y puede reducir la exactitud cuando un registro se empareja con la fuente equivocada; ¿Qué es el enriquecimiento de datos? explica cómo medir las tasas de emparejamiento y de relleno. La observabilidad de datos (data observability), un término de las herramientas de supervisión, consiste en vigilar de forma continua la actualidad, el volumen y el esquema en muchos flujos de datos.
¿Cómo fallan los datos web sin dar ningún error?
Los datos web fallan en silencio porque un scraper lee páginas hechas para personas, y cuando una página cambia o no es la esperada, el trabajo devuelve algo de todos modos. Cinco modos de fallo causan la mayoría de los problemas:
- Un cambio de diseño vacía un campo. El sitio rehace parte de su página, el extractor no encuentra nada y la columna de precios se llena de vacíos mientras el trabajo informa de éxito. Controla la completitud por campo en cada ejecución: una caída del 99 % al 0 % es un extractor roto, no un movimiento del mercado.
- Una página de bloqueo o de verificación se guarda como datos. El sitio devuelve una página de «acceso denegado» o de verificación, a veces con un código de estado normal, y el analizador (parser) toma su título por el nombre de un producto. Exige una marca que solo tenga la página real, como el ID del producto, y trata todo lo demás como una descarga fallida. Vuelve a intentarlo más tarde a un ritmo más lento; si el sitio sigue rechazando las solicitudes, busca un feed oficial o una API.
- El precio llega del país equivocado. Muchas tiendas muestran precios, moneda y existencias según la ubicación del visitante, así que un trabajo que se ejecuta desde un país recopila la versión de ese país para todos los mercados. Guarda el código de moneda con cada precio y compruébalo con el mercado que describe la fila; ¿Por qué los precios varían por país? explica a qué se deben esas diferencias.
- Una copia en caché oculta un cambio. Una caché, la tuya o una situada entre tú y el sitio, puede seguir sirviendo el precio de ayer. Guarda la hora de descarga de cada página y marca los precios que siguen sin cambios mucho más tiempo de lo habitual.
- El mismo producto aparece en dos URL. Las rutas de categoría y los parámetros de seguimiento crean varias direcciones para una misma página. Deduplica con una clave estable como el ID de producto o el GTIN (el número bajo el código de barras) y lee el enlace
rel="canonical"de la página, que la RFC 6596 define como la dirección preferida de un sitio entre duplicados.
Dos de estos fallos dependen de dónde sale la solicitud. Los Proxies residenciales con segmentación por país y ciudad permiten que una comprobación de precios o existencias se ejecute como un visitante local del mercado que mides. Una sesión fija mantiene la misma dirección IP durante una comprobación de varias páginas (de 1 a 60 minutos en nuestros proxies residenciales y móviles), así que la página de producto y el carrito ven la misma versión de la tienda. Un proxy no hace que los datos sean correctos: cada registro sigue pasando por las comprobaciones, y las condiciones del sitio y sus límites de solicitudes siguen vigentes.
Los equipos que prefieran no encargarse de la recopilación pueden usar la extracción gestionada de páginas de nuestra Web Scraping API, disponible a través de nuestro equipo de ventas.
¿Quién responde de la calidad de los datos?
La responsabilidad es compartida, pero cada conjunto de datos necesita un propietario con nombre y apellidos que decida qué significa «suficientemente bueno» y un data steward (administrador de datos) que lo mantenga en ese nivel:
- Propietario de los datos (data owner): un directivo de negocio, como el jefe de precios, que rinde cuentas por el conjunto de datos, fija sus umbrales y decide qué pasa cuando no se alcanzan.
- Data steward: cuida el conjunto de datos en el día a día, mantiene las reglas, revisa los registros en cuarentena y rastrea los problemas hasta su causa.
- Productores de datos: los equipos y sistemas que crean o recopilan los datos. Aquí es donde la mayoría de los problemas cuesta menos arreglar.
- Consumidores de datos: analistas, científicos de datos y aplicaciones que usan los datos. Suelen detectar los problemas primero y necesitan una forma sencilla de comunicarlos.
Un analista o ingeniero de calidad de datos puede crear las comprobaciones y los paneles, pero no puede sustituir al propietario: sin alguien capaz de detener un informe que no alcanza sus umbrales, esos umbrales se quedan en sugerencias.
¿Cuánto cuesta una mala calidad de los datos?
Una mala calidad de los datos cuesta dinero por las decisiones equivocadas y el trabajo repetido, y crea riesgo legal cuando hay datos personales o sistemas de IA de por medio. La cifra que merece la pena conocer es la tuya: horas dedicadas a corregir informes, campañas enviadas a direcciones equivocadas, precios fijados con datos de entrada erróneos. Un modelo entrenado con registros duplicados o mal etiquetados aprende los errores.
Con datos personales, la exactitud es una obligación legal. El Reglamento General de Protección de Datos (RGPD) exige que los datos personales sean exactos y, si fuera necesario, actualizados, y que los datos inexactos se supriman o rectifiquen sin dilación (artículo 5, apartado 1, letra d: principio de «exactitud»). En Türkiye, la KVKK (Ley n.º 6698 de Protección de Datos Personales) recoge el mismo principio en su artículo 4. El Reglamento de Inteligencia Artificial de la UE exige a los proveedores de sistemas de IA de alto riesgo que los conjuntos de datos de entrenamiento, validación y prueba sean pertinentes, suficientemente representativos y, en la mayor medida posible, carezcan de errores y estén completos en vista de su finalidad prevista (artículo 10, apartado 3).
¿Dónde importa más la calidad de los datos?
- Precios y comercio electrónico: precios, existencias y promociones de la competencia que alimentan el reajuste automático de precios.
- Investigación de mercado: respuestas de encuestas, datos de paneles y datos web públicos en los que se basa el cálculo del tamaño del mercado.
- Aprendizaje automático: datos de entrenamiento y de prueba, donde los duplicados y las etiquetas erróneas pasan directamente al modelo.
- Finanzas e informes: cifras que acaban en informes de dirección y en declaraciones oficiales.
- CRM y marketing: registros de clientes y cuentas que se usan para segmentar y contactar.
- Operaciones: direcciones, dimensiones de productos y niveles de existencias que guían las entregas.
Errores frecuentes
- Comprobar solo el formato. Los datos válidos también pueden ser erróneos; compara una muestra con la fuente.
- Informar de una sola puntuación global. Un promedio del 98 % puede esconder un campo que falla por completo en un mercado.
- Umbrales sin acciones. Una puntuación que cruza su límite y no cambia nada es decoración.
- Parchear aguas abajo. Arreglar el informe en lugar del trabajo de recopilación obliga a repetir el mismo arreglo la semana siguiente.
- Tomar una ejecución correcta por datos buenos. Devolver filas no es lo mismo que devolver las filas correctas.
- No guardar la hora de recopilación de cada registro. Sin ella no se puede medir la actualidad.
- Borrar filas erróneas en silencio. Ponlas en cuarentena y cuéntalas, o no sabrás si la calidad mejora.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Empezar desde cero | Elige de 5 a 10 campos críticos; comprueba primero completitud, validez y unicidad |
| Un informe en el que nadie confía | Perfila los datos; compara una muestra con la fuente |
| Datos de scraping que fallan en silencio | Comprobaciones de completitud por campo y de número de filas en cada ejecución |
| Precios o existencias en varios mercados | Recopila desde cada mercado; guarda moneda y ubicación por fila |
| Duplicados que inflan los promedios | Deduplica con una clave de producto estable, no por URL |
| Datos personales en el conjunto | Un proceso de exactitud y rectificación conforme al RGPD o a la ley local |
| Datos de entrenamiento para un modelo | Deduplica, revisa las etiquetas en una muestra, registra las fuentes |
| Muchos conjuntos de datos, muchos equipos | Nombra un propietario y un data steward por conjunto; publica los umbrales |
Preguntas frecuentes
¿Cuáles son las 6 dimensiones de la calidad de los datos?
Las seis dimensiones son exactitud, completitud, coherencia, actualidad, validez y unicidad, tal como las define DAMA UK. Preguntan si los datos coinciden con la realidad, están completos, concuerdan entre sí, están al día, siguen el formato y el rango esperados y recogen cada elemento una sola vez.
¿Qué diferencia hay entre calidad e integridad de los datos?
La calidad de los datos pregunta si los datos sirven para un uso: si son correctos, completos, actuales y coherentes. La integridad pregunta si los datos siguen tal como se guardaron, sin cambios ni pérdidas no autorizados o accidentales. Un registro puede conservar intacta su integridad y aun así ser erróneo si ya lo era cuando se guardó por primera vez.
¿Cómo se mide la calidad de los datos?
Elige los campos que importan, escribe una regla comprobable para cada dimensión relevante y calcula la proporción de registros que la cumplen: porcentaje de completitud, porcentaje de validez, tasa de duplicados, antigüedad de los datos y exactitud en una muestra revisada a mano. Fija un umbral para cada métrica y sigue las puntuaciones en cada lote nuevo.
¿Quién responde de la calidad de los datos?
Un propietario de los datos, normalmente un directivo de negocio, rinde cuentas por un conjunto de datos y fija sus umbrales, mientras que un data steward mantiene las reglas y rastrea los problemas hasta su causa. Los equipos que producen los datos corrigen los problemas en el origen, y quienes los usan comunican lo que parece incorrecto.
¿Qué diferencia hay entre calidad y limpieza de datos?
La calidad de los datos es la medida; la limpieza de datos es una forma de mejorarla. Las comprobaciones de calidad muestran qué valores faltan, no son válidos, están duplicados o están desactualizados, y la limpieza los repara. Limpiar sin comprobar puede producir datos ordenados que siguen siendo erróneos.
¿Con qué frecuencia se debe comprobar la calidad de los datos?
Comprueba la calidad de los datos de forma automática cada vez que lleguen datos nuevos, siempre con las mismas reglas. Revisa las reglas y los umbrales cuando cambie el uso o se añada una fuente nueva, y vuelve a revisar a mano una muestra para la exactitud con un calendario fijo, por ejemplo una vez al mes.
En resumen
La calidad de los datos es la adecuación a un propósito, no una propiedad que los datos tengan por sí solos. Descríbela con las seis dimensiones, convierte en reglas las que importan para tu uso, puntúa cada lote y actúa cuando una puntuación cruce su umbral. En los datos web, comprueba también los fallos que no generan ningún error, nombra un propietario para cada conjunto de datos y recopila los datos de cada mercado desde ese mercado; nuestra página de seguimiento de precios relaciona cada tipo de comprobación de precios con el tipo de proxy que necesita.