


































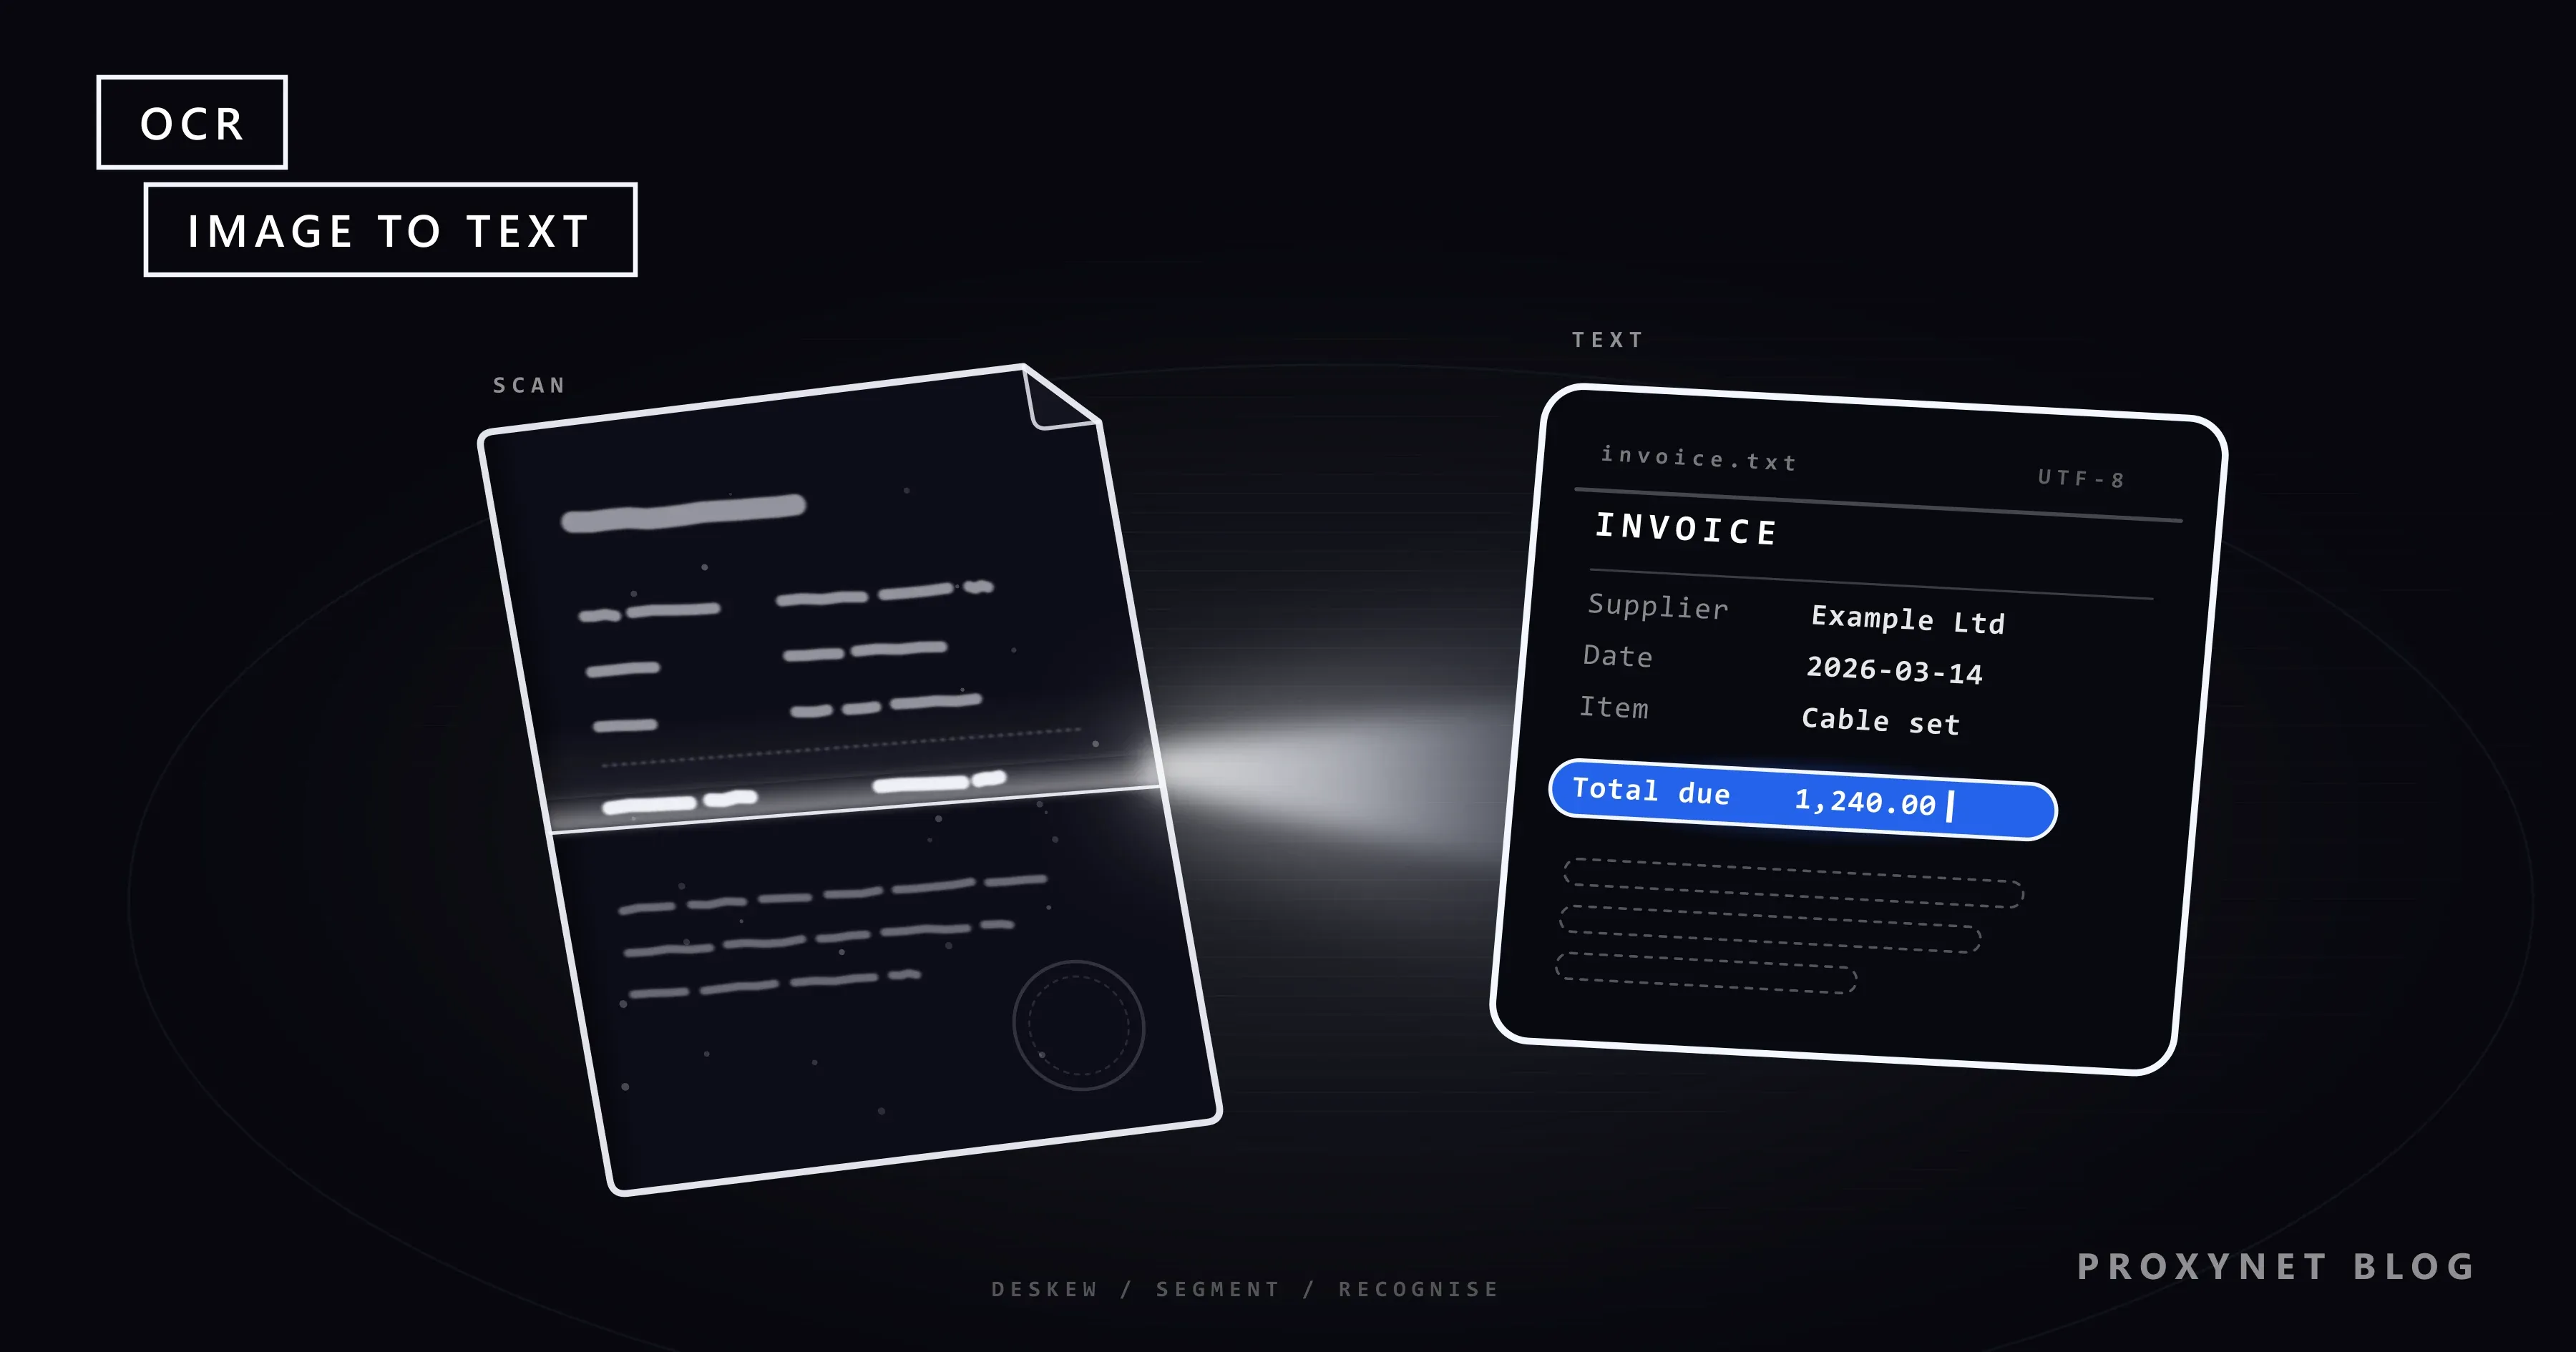
Un equipo de contabilidad escanea cinco años de facturas en papel a PDF y luego intenta encontrar todas las facturas de un proveedor. Ctrl+F no encuentra nada, porque cada página es una imagen del papel, no texto. Una viajera apunta con el móvil a un menú en otro idioma; un estudiante quiere pegar en sus apuntes un párrafo de un libro de texto que fotografió. Los tres necesitan un software que averigüe qué letras muestran los píxeles: el OCR.
Este artículo explica cómo funciona un motor de OCR, en qué se diferencian sus tipos principales y sus parientes ICR y OMR, qué determina la precisión, cómo usar el OCR en el móvil, en el ordenador y en un PDF, y qué normas de privacidad se aplican a los documentos escaneados.
¿Qué es el OCR?
OCR, siglas en inglés de reconocimiento óptico de caracteres, es un software que reconoce las letras, los dígitos y los símbolos de una imagen y los guarda como caracteres de texto. Para un ordenador, una página escaneada es una cuadrícula de puntos de color; la palabra «Factura» que aparece en ella no es más texto que el dibujo de un gato. El OCR convierte esos puntos en caracteres que un programa puede buscar, editar, traducir o leer en voz alta.
La entrada puede ser un escaneo, la foto de un recibo, una captura de pantalla o un cartel de la calle visto por la cámara. La salida es texto, a menudo con la posición de cada palabra y una puntuación que indica lo seguro que está el motor. «Escaneo OCR» significa escanear el papel y aplicar OCR en un solo paso, como hacen muchas apps de escaneo.
¿Cómo funciona el OCR?
El OCR funciona como una cadena de procesamiento: el motor prepara la imagen, localiza dónde está el texto, lo reconoce y limpia el resultado, en seis etapas:
- Captura. Un escáner, una cámara o una captura de pantalla produce la imagen. La documentación de Tesseract recomienda al menos 300 DPI para los escaneos; una foto hecha con el móvil debe ser nítida, con luz uniforme y tomada de frente.
- Preprocesamiento. El motor endereza una página inclinada (deskewing), la convierte en texto oscuro sobre fondo claro (binarización), elimina manchas y bordes del escáner y amplía el texto pequeño.
- Análisis del diseño de página. La página se divide en bloques, columnas, líneas y palabras, y se decide el orden de lectura. Si una página a dos columnas se lee de lado a lado, las frases se mezclan; las tablas fallan sobre todo en este paso.
- Reconocimiento. Los motores antiguos comparaban cada carácter con formas almacenadas. Los actuales pasan la imagen de una línea entera a una red neuronal, que devuelve los caracteres más probables.
- Corrección lingüística. Un diccionario o un modelo de lenguaje convierte «c1ient» en «client». También puede «corregir» por error un código de producto o un apellido, por eso algunas herramientas permiten desactivar este paso.
- Salida. Texto plano, texto con la posición de cada palabra (formatos como hOCR y ALTO) o un PDF con texto buscable, normalmente con una puntuación de confianza por palabra que indica a quien revisa dónde mirar.
Tesseract, un motor de código abierto muy utilizado, muestra bien el cambio. Se desarrolló en Hewlett-Packard entre 1985 y 1994 y se publicó como código abierto en 2005; la versión 4 añadió un motor de redes neuronales (LSTM, un tipo de red pensado para secuencias) que reconoce líneas enteras en lugar de caracteres sueltos.
¿Cuáles son los principales tipos de tecnología OCR?
La tecnología OCR se divide en tres familias: los motores clásicos, que comparan la forma de los caracteres; el OCR con aprendizaje profundo, que lee líneas enteras con redes neuronales, y los modelos de visión y lenguaje, que leen e interpretan una página en un solo modelo.
| Enfoque | Cómo lee | Puntos fuertes | Punto débil |
|---|---|---|---|
| OCR clásico | Compara la forma de cada carácter | Páginas impresas limpias, fuentes comunes | Ruido, fuentes poco habituales, escritura a mano |
| OCR con aprendizaje profundo | Una red neuronal lee líneas enteras | Fuentes variadas, fotos, muchos idiomas | Tablas y diseños complejos |
| Modelo de visión y lenguaje | Lee la página y responde sobre ella | Diseños desordenados, preguntas sobre un documento | Puede reformular o inventar texto; más caro |
El OCR con aprendizaje profundo ha combinado normalmente una red convolucional, que extrae rasgos visuales de la imagen de la línea, con una red recurrente que los convierte en caracteres, además de un modelo de lenguaje aparte. El artículo de TrOCR, de investigadores de Microsoft, usa Transformers, la arquitectura en la que se basan los modelos de lenguaje grandes, para ambas partes. Así, un solo modelo lee la imagen y escribe el texto sin necesidad de un modelo de lenguaje aparte.
¿Conviene usar OCR o un modelo de visión y lenguaje?
Usa OCR cuando necesites una copia exacta del texto con posiciones y puntuaciones de confianza, y un modelo de visión y lenguaje cuando te importe más el significado de un documento desordenado que una copia fiel carácter por carácter. Un modelo de visión y lenguaje (VLM) es un modelo multimodal, es decir, uno que recibe una imagen y texto juntos como entrada, como explica ¿Qué es la IA multimodal?.
Un motor de OCR copia: cada carácter sale de una región de la imagen, y el motor puede decir de cuál y con qué seguridad. Un modelo de visión y lenguaje, en cambio, genera la respuesta más probable. Eso le permite manejar un recibo arrugado o un formulario desconocido, pero también puede corregir una errata que de verdad estaba en la página, saltarse una línea o escribir una cifra verosímil que no aparece en ella.
Muchos flujos de trabajo usan ambos: OCR para el texto y las posiciones, un modelo de lenguaje para asignarlo a campos como proveedor y total, y una persona para los casos de baja confianza.
OCR, ICR y OMR: ¿en qué se diferencian?
El OCR lee texto impreso a máquina, el ICR lee caracteres escritos a mano en letra de imprenta y el OMR detecta marcas como casillas marcadas y círculos rellenados. Los nombres vienen de los formularios en papel, donde una sola hoja suele necesitar los tres.
- OCR (reconocimiento óptico de caracteres) es el término general y el nombre habitual para leer texto mecanografiado e impreso.
- ICR (reconocimiento inteligente de caracteres) suele referirse a la lectura de caracteres escritos a mano en letra de imprenta, normalmente mayúsculas, una por casilla. El término se usa de forma imprecisa y muchos productos ya lo incluyen dentro del OCR.
- OMR (reconocimiento óptico de marcas) no lee ningún carácter: comprueba si una casilla o un círculo está marcado, como en las hojas de examen y los formularios del censo, cuyas respuestas manuscritas se procesan aparte.
- HTR (reconocimiento de texto manuscrito) abarca la escritura a mano libre y cursiva, como cartas y manuscritos históricos, el caso más difícil.
¿Qué afecta a la precisión del OCR?
La entrada decide la precisión del OCR más que el motor: un escaneo nítido a 300 DPI de una página impresa y la foto de un recibo arrugado dan resultados muy distintos con el mismo software. Los factores principales:
- Resolución y enfoque. Los caracteres borrosos pierden el detalle que separa la «e» de la «c» y «rn» de «m».
- Inclinación y perspectiva. Las páginas fotografiadas en ángulo tienen las líneas torcidas; los libros gruesos se curvan cerca del lomo.
- Contraste y fondo. La tinta desvaída, el papel de color, los sellos y las sombras añaden ruido.
- Fuentes y escritura a mano. Las letras decorativas o diminutas cuestan más, y la letra cursiva mucho más que las mayúsculas de imprenta.
- Diseño de página. Las tablas, las columnas y el texto sobre imágenes confunden el orden de lectura.
- Datos del idioma. El motor tiene que conocer el alfabeto del idioma de la página y, a ser posible, también sus palabras.
La precisión suele medirse con la tasa de error de caracteres (CER, por sus siglas en inglés): los caracteres que hay que insertar, borrar o sustituir para llegar al texto correcto, divididos entre su longitud. Una tasa baja puede esconder el único dígito erróneo de un total, así que usa las puntuaciones de confianza para decidir qué revisar y verifica siempre los campos clave.
¿El OCR funciona en todos los idiomas?
El OCR solo funciona en un idioma si el motor se ha entrenado con sus caracteres, y funciona mejor si además conoce sus palabras. Tesseract reconoce más de 100 idiomas con un archivo de datos para cada uno, y su lista de archivos de datos de idiomas incluye el turco con el código tur, junto al inglés (eng).
Una configuración errónea provoca errores que parecen menores y estropean las búsquedas. Un motor configurado en inglés puede leer la i sin punto del turco (ı) como una i normal y la g con breve (ğ) como una g simple, y una búsqueda posterior con la grafía correcta no encuentra nada. En documentos mixtos, selecciona los dos idiomas (Tesseract acepta tur+eng). Escrituras como la árabe o la china necesitan sus propios modelos, así que comprueba que el que necesitas está instalado antes de procesar un lote.
¿Cómo se usa el OCR en el móvil o el ordenador?
La mayoría de los móviles ya incluyen OCR: Google Lens en Android y Texto en vivo en el iPhone te permiten seleccionar texto en una foto o en la vista de la cámara y copiarlo o traducirlo.
En Android, abre la aplicación de Google, toca el icono de Google Lens en la barra de búsqueda y haz una foto o elige una captura de pantalla. Toca el texto y luego Seleccionar texto; el menú permite copiar, escuchar, traducir o buscar. La página de ayuda de Lens de Google recuerda también la condición más importante: una imagen clara y bien iluminada.
En un iPhone XS, un iPhone XR o un modelo posterior con iOS 15 o versiones posteriores, abre una foto, mantén pulsada una palabra, mueve los puntos de agarre y toca Copiar o Seleccionar todo. Si no ocurre nada, activa Ajustes > General > Idioma y región > Texto en vivo. Las instrucciones de Apple también explican la traducción; Texto en vivo no está disponible en todas las regiones ni en todos los idiomas.
En el ordenador, muchas apps de escaneo y editores de PDF pueden reconocer el texto de un escaneo y guardar un PDF con texto buscable. Para trabajos más grandes, Tesseract se ejecuta desde la línea de comandos o desde Python; Cómo extraer datos de un PDF incluye código probado para páginas escaneadas.
¿Qué es el OCR en un PDF?
Aplicar OCR a un PDF significa añadir una capa de texto a un PDF escaneado: la página sigue viéndose como el escaneo, pero encima hay texto invisible, cada palabra sobre su imagen. Hay tres tipos de PDF:
- PDF de texto. Exportado desde un programa; el texto ya está guardado como caracteres, así que el OCR solo puede añadir errores.
- PDF solo de imagen. Un escaneo sin OCR; cada página es una imagen y la búsqueda no encuentra nada.
- PDF con texto buscable. El escaneo más el texto OCR oculto; la búsqueda, la copia y los lectores de pantalla funcionan, en la medida en que el OCR acertó.
La capa de texto también importa para la accesibilidad. La técnica PDF7 del W3C considera que las imágenes escaneadas de texto son inaccesibles por naturaleza y recomienda aplicar OCR y comprobar después que el texto está completo y en el orden de lectura correcto. Conserva los escaneos originales para que un OCR mejor pueda partir de la imagen más adelante.
¿Dónde se usa el OCR?
El OCR se usa allí donde el texto llega en papel, en imágenes o escaneado y tiene que acabar en un sistema:
- Facturas y recibos. El proveedor, la fecha y el total pasan al software de contabilidad sin volver a teclearlos.
- Formularios. Solicitudes, reclamaciones y notas de entrega, a menudo leídas con OCR, ICR y OMR a la vez.
- Archivos y bibliotecas. Libros, periódicos y registros pasan a poder buscarse por palabra.
- Accesibilidad. El texto impreso se lee en voz alta y los escaneos funcionan con lectores de pantalla.
- Traducción sobre la marcha. Carteles, menús y etiquetas en un idioma desconocido.
- Logística. Etiquetas de envío, códigos de contenedor y números de serie; el reconocimiento de matrículas es una forma especializada de OCR con sus propias normas legales.
El OCR solo te da texto. Convertir «Total a pagar: 1.240,00» en un campo llamado total con el número 1240 es un paso aparte llamado parsing (análisis sintáctico), que se explica en ¿Qué es el parsing de datos?. Los productos que combinan el OCR con la clasificación de documentos, la extracción de campos y la validación suelen venderse como procesamiento inteligente de documentos (IDP, por sus siglas en inglés).
¿Qué normas de privacidad se aplican al OCR de documentos?
El OCR no cambia quién puede leer un documento: si no puedes tratar los datos personales de un archivo, aplicarle OCR no lo hace legítimo, y además hace que esos datos sean más fáciles de buscar y copiar. Los documentos de identidad, las nóminas y los historiales médicos son los ejemplos habituales.
Según el RGPD en la UE y la KVKK de Türkiye (Ley n.º 6698 de Protección de Datos Personales), los datos de salud y los datos biométricos usados para identificar a una persona son categorías especiales de datos personales, sujetas a condiciones más estrictas. En la práctica:
- Aplica OCR solo a documentos que tengas derecho a tratar, nunca al documento de identidad de otra persona.
- Para archivos sensibles, prefiere el OCR en tu propio dispositivo o en tus propios servidores; si usas un servicio en la nube, comprueba dónde se guardan los archivos, durante cuánto tiempo y si se usan para entrenar modelos.
- Extrae los campos que necesitas, oculta el resto y borra los resultados que ya no uses.
¿Qué papel tienen los proxies?
Los proxies no tienen nada que ver con el OCR en sí; importan un paso antes, cuando los documentos que necesitas son archivos públicos en sitios web de otros países. Catálogos, avisos públicos, listas de precios y menús se publican a menudo como imágenes o PDF escaneados, y algunos sitios sirven una versión distinta según el país del visitante.
Con los Proxies residenciales, las solicitudes salen por conexiones domésticas del país y la ciudad que elijas, así que descargas lo mismo que reciben los visitantes locales. Recopila solo archivos públicos, respeta robots.txt y los términos del sitio, mantén bajo el ritmo de solicitudes y usa una descarga oficial o una API cuando exista.
Si prefieres no encargarte tú de la recopilación, puedes consultar a nuestro equipo de ventas sobre la extracción gestionada de páginas con nuestra Web Scraping API.
Errores frecuentes
- Aplicar OCR a un PDF que ya tiene texto. Los caracteres exactos se sustituyen por suposiciones.
- Escanear con poca resolución o fotografiar en ángulo. Los segundos que se ahorran al capturar cuestan mucho más en correcciones.
- Dejar el idioma en inglés. Las letras acentuadas y los demás alfabetos salen mal.
- Fiarse de los números sin comprobarlos. Los totales y las fechas necesitan una comprobación de sumas o una segunda mirada.
- Esperar que las tablas salgan como tablas. El OCR devuelve líneas; las columnas hay que reconstruirlas.
- Tirar las imágenes originales. Un OCR mejor las necesitará más adelante.
- Subir documentos de identidad a un conversor gratuito desconocido. Usa OCR local o un servicio con condiciones claras.
- Dar por exacta la transcripción de un chatbot. Compara los valores clave con la imagen.
Guía de decisión
| Necesidad | Qué usar |
|---|---|
| Copiar unas líneas de una foto o una captura | Google Lens o Texto en vivo en el móvil |
| Hacer buscables escaneos antiguos | OCR a un PDF con texto buscable, conservando los originales |
| Texto de cientos de páginas escaneadas | Un motor de OCR como Tesseract en un proceso por lotes |
| Campos de facturas o formularios | OCR más parsing y validación, con revisión humana |
| Preguntas sobre un documento desordenado | Un modelo de visión y lenguaje, revisando los valores clave |
| Casillas marcadas en formularios en papel | OMR |
| Letra cursiva o manuscritos antiguos | Un modelo de reconocimiento de escritura a mano, con revisión |
| Documentos de identidad o de salud | OCR local, una base jurídica y minimización de datos |
Preguntas frecuentes
¿El OCR es inteligencia artificial?
El OCR moderno es una forma de IA: su paso de reconocimiento es una red neuronal entrenada con grandes conjuntos de imágenes de texto etiquetadas. Los motores antiguos se basaban en reglas hechas a mano y en la comparación de formas. Pero el OCR no es IA generativa: copia lo que hay en la página, mientras que un modelo generativo escribe texto nuevo, así que cada uno comete un tipo de error distinto.
¿El OCR es gratis?
Sí, es fácil encontrar OCR gratuito. Tesseract es de código abierto con licencia Apache 2.0, Google Lens y Texto en vivo no cuestan nada en el móvil y muchas apps de escaneo incluyen OCR. Las herramientas de pago suelen añadir un mejor manejo de escaneos de mala calidad, tablas y escritura a mano, plantillas de formularios y procesamiento de grandes volúmenes.
¿Qué precisión tiene el OCR?
En páginas impresas nítidas, el OCR moderno comete pocos errores; en fotos borrosas, escritura a mano y tablas comete muchos más. No hay una cifra única, porque el resultado depende de la entrada, así que mide la tasa de error de caracteres en una muestra de tus propios documentos.
¿Puede el OCR leer escritura a mano?
En parte. Las mayúsculas escritas a mano en las casillas de los formularios se leen automáticamente desde hace tiempo, y los modelos neuronales ya leen también la letra cursiva cuidada. La escritura desordenada y los documentos históricos necesitan un modelo entrenado para ese tipo de escritura y una persona que revise el resultado.
¿Qué es un PDF con texto buscable?
Un PDF con texto buscable es un PDF escaneado con una capa de texto OCR invisible detrás de la imagen de la página. Se ve exactamente igual que el escaneo, pero puedes buscar en él, copiar su texto y hacer que un lector de pantalla lo lea en voz alta.
¿Puede el OCR leer los caracteres turcos?
Sí, si el motor tiene datos del idioma turco. Tesseract tiene un modelo para el turco (tur), y Apple incluye el turco entre los idiomas de Texto en vivo. Si solo está seleccionado el inglés, las letras turcas pueden salir como letras latinas simples, así que selecciona el turco, o el turco y el inglés en documentos mixtos.
En resumen
El OCR convierte el texto de las imágenes en texto real: el motor limpia la imagen, localiza las líneas, reconoce los caracteres con una red neuronal y corrige el resultado con datos del idioma. Funciona mejor con escaneos nítidos y rectos en un idioma que conoce. Usa el móvil para copias rápidas, los PDF con texto buscable para los archivos y el OCR con parsing y revisión humana para los documentos de empresa; conserva los originales y trata los documentos de identidad y de salud según las normas del RGPD o de la KVKK.


