


































En la mayoría de los ejemplos de C# para extraer datos sigue apareciendo WebClient y quince líneas que descargan una sola página. Ese ejemplo funciona a la primera y luego se rompe por tres sitios distintos cuando crece el trabajo: los sockets se agotan porque en cada petición se crea un objeto cliente nuevo, el sitio empieza a devolver 429 cuando ve decenas de peticiones por segundo desde la misma dirección, y el código de análisis revienta con una referencia nula en cuanto cambia la estructura de la página. Ninguno de los tres problemas viene de la biblioteca elegida: los tres vienen de cómo se montó el cliente.
En este artículo montamos un trabajo de extracción sobre .NET actual: el ciclo de vida de la instancia de HttpClient, la elección entre HtmlAgilityPack y AngleSharp para analizar el HTML, la definición del proxy mediante HttpClientHandler o SocketsHttpHandler, la autenticación con usuario y contraseña, las direcciones SOCKS5, el tiempo de espera y la cancelación, el límite de concurrencia y los reintentos. El objetivo de ejemplo es books.toscrape.com, un sitio de práctica publicado justo para este tipo de trabajo.
¿De qué pasos se compone un trabajo de scraping en C#?
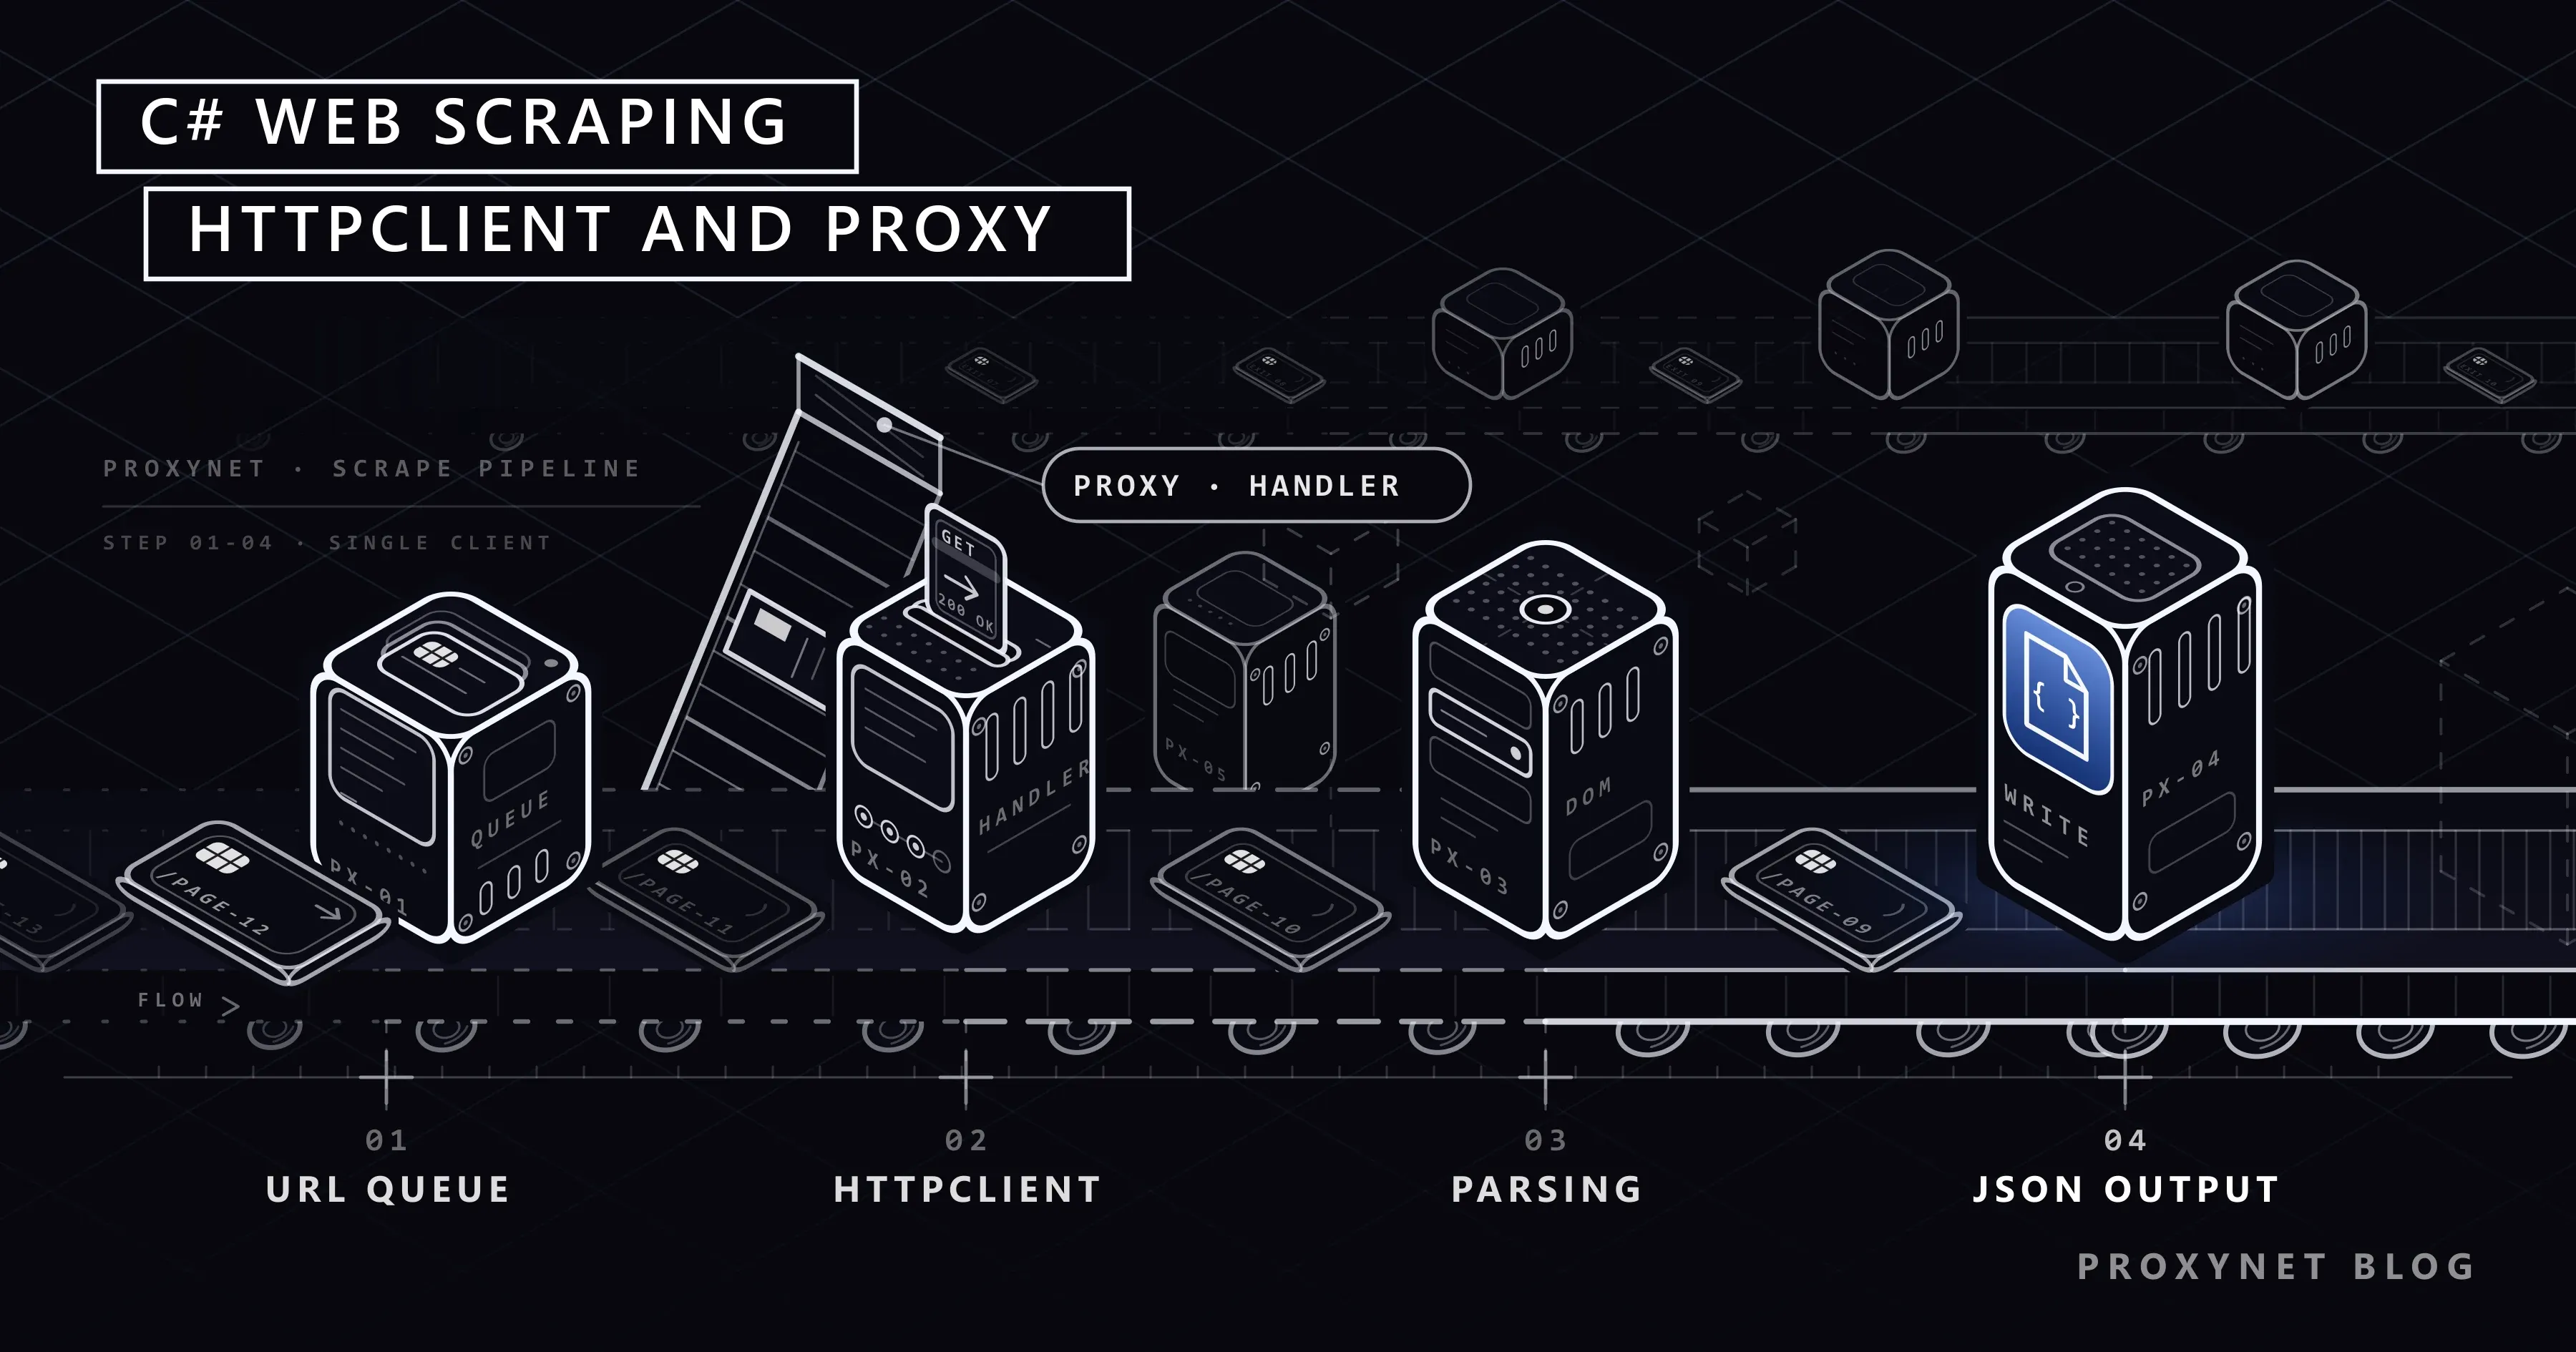
Sea cual sea el lenguaje, todo trabajo de scraping sigue los mismos cinco pasos. En C# cada paso se traduce así:
- Generar la lista de direcciones. Páginas de categoría, enlaces de paginación o el sitemap. Guarda la lista como una cola, así un trabajo interrumpido puede continuar donde se quedó.
- Enviar la petición.
GetAsyncsobreHttpClient. Se comprueba el código de estado de la respuesta y el cuerpo se lee como texto. - Analizar el HTML. El texto entrante se convierte en un objeto de documento y los campos que buscas se localizan con un selector XPath o CSS.
- Normalizar los datos. El símbolo de moneda del precio, los espacios sobrantes de una fila y los campos vacíos se limpian aquí.
- Guardar. JSON, CSV o una tabla de base de datos. Si el paso de guardado va aparte, no tienes que volver a descargar los datos cada vez que cambies el código de análisis.
Entre esos pasos se cuelan dos cosas más: la espera entre peticiones y qué hacer ante un error. Ninguna de las dos es un adorno que se añade después: las dos deben estar en la primera versión del trabajo. Las secciones siguientes las montan una a una.
Antes de empezar: robots.txt, ritmo y una identidad de cliente honesta
Antes de enviar una petición a cualquier sitio, mira su archivo robots.txt. El formato del archivo y las reglas para interpretarlo se estandarizaron en el RFC 9309. El estándar dice que, si el archivo no se puede obtener del servidor, el rastreador puede acceder a los recursos; es decir, una dirección que devuelve 404 no significa prohibición. El objetivo de ejemplo de este artículo es un caso típico: books.toscrape.com es un sitio escaparate publicado para practicar, así que no tiene archivo robots.txt y la dirección devuelve 404. Explicamos cómo leer las reglas en Qué es robots.txt y cómo leerlo.
robots.txt no es un permiso, solo es lo que el sitio les dice a los clientes automáticos. Por encima hay dos responsabilidades más. La primera es el ritmo: pedir una misma página varias veces por segundo te pone en la misma cola que las peticiones de usuarios reales en el servidor del sitio. Pon una espera deliberada entre peticiones y limita cuántas peticiones tienes abiertas a la vez. La segunda es la identidad: el valor de User-Agent que envías es la única pista para un administrador que quiera ponerse en contacto contigo. Escribir el nombre de tu propia aplicación y una dirección de contacto es más honesto y más práctico que copiar la cadena de un navegador popular. Contamos para qué sirve esa cabecera en ¿Qué es el User-Agent? Cómo verlo y cambiarlo.
Hay un tercer límite y es legal. Las páginas con datos personales, el contenido tras un inicio de sesión y los usos que las condiciones del sitio prohíben de forma expresa no son una cuestión técnica. Reunimos ese marco en ¿El web scraping es legal? Una visión general.
¿Por qué no se crea un HttpClient nuevo en cada petición?
Aquí está el error más común en C#. Como el objeto HttpClient es IDisposable, muchos ejemplos lo crean dentro de un bloque using y lo cierran en cada petición. La guía de uso de HttpClient de Microsoft dice sin rodeos por qué eso está mal: el pool de conexiones vive dentro del objeto handler que hay debajo del cliente, y crear y desechar el cliente en cada petición se lleva por delante el pool. Como los puertos de las conexiones TCP cerradas no se liberan de inmediato, al subir el ritmo de peticiones chocas con el límite de puertos disponibles del sistema operativo. El síntoma se parece más a una avería de red que a un fallo del código: el trabajo va bien un rato y después empiezan a llegar errores de conexión uno detrás de otro.
Lo correcto es usar un único cliente que viva tanto como la aplicación. La única desventaja de un cliente de larga vida es el DNS: HttpClient resuelve el nombre de dominio solo al crear la conexión y no sigue los cambios del registro DNS. La guía también da la solución: cuando asignas una duración a la propiedad PooledConnectionLifetime de un objeto SocketsHttpHandler, la conexión del pool se cierra al terminar ese plazo y, al crear la nueva, se vuelve a consultar el DNS. En el ejemplo de código de la guía ese valor es de quince minutos, pero el texto aclara que se eligió solo a modo de ilustración y que la duración debe fijarse según la frecuencia esperada de cambios de DNS; el intervalo que aparece en la sección de uso recomendado es de dos minutos.
La otra vía es IHttpClientFactory. La fábrica mantiene los objetos handler en su propio pool y entrega a los clientes nuevos un handler cuya vida útil no ha vencido, así que el problema de sockets tampoco aparece. Si trabajas en una aplicación ASP.NET Core o dentro de un host genérico con inyección de dependencias, la fábrica encaja mejor. En un script de consola independiente basta con un cliente único static más PooledConnectionLifetime, y tiene menos piezas.
Un apunte más: los ajustes de conexión del handler no se pueden cambiar después de enviar la primera petición. Si necesitas trabajar con proxies distintos o con contenedores de cookies distintos, montas un objeto cliente separado para cada configuración. La regla del «cliente único» no significa «un objeto en la aplicación», significa «ningún objeto nuevo por petición».
¿Cómo se elige entre HtmlAgilityPack y AngleSharp?
En .NET hay dos opciones asentadas para analizar HTML. Las dos son paquetes de NuGet, las dos se las arreglan con HTML roto, y la diferencia está en el lenguaje de selectores y en el modelo de trabajo.
| HtmlAgilityPack | AngleSharp | |
|---|---|---|
| Lenguaje de selectores | XPath (SelectNodes, SelectSingleNode) | Selectores CSS (QuerySelector, QuerySelectorAll) |
| Modelo DOM | Su propio modelo de árbol | Cercano a la API DOM del W3C |
| Analizar texto directamente | HtmlDocument.LoadHtml(html) | A través de un contexto de navegación |
| Descargar la página por sí mismo | No, el HTML lo aportas tú | Sí, con el cargador predeterminado |
| Uso típico | Analizar el HTML descargado con HttpClient | Abrir la página y recorrerla con selectores CSS |
El ejemplo de carga desde una cadena de la documentación de HtmlAgilityPack muestra el patrón: se crea un HtmlDocument, se le entrega la cadena HTML con LoadHtml y se ejecuta una consulta XPath sobre DocumentNode (la llamada de la documentación es SelectSingleNode; su equivalente para varios nodos es SelectNodes). AngleSharp, en el ejemplo de su propio repositorio, abre la dirección por sí mismo mediante un contexto montado con el cargador predeterminado y aplica un selector CSS con QuerySelectorAll.
La elección suele ser cuestión de costumbre. Si ya envías la petición con HttpClient, tienes una cadena HTML en la mano y la vía de LoadHtml de HtmlAgilityPack es la más corta; los ejemplos de este artículo la usan. Si quieres llevar al código tal cual el selector CSS que probaste en la consola del navegador, AngleSharp resulta más cómodo. Comparamos los dos lenguajes de selectores en Selector CSS o XPath: ¿cuál usar en web scraping? y aquí no lo repetimos.
Ninguna de las dos bibliotecas ejecuta JavaScript. Si los datos solo llegan mediante un script que corre en el navegador, no necesitas un analizador sino automatización de navegador: Páginas estáticas y dinámicas explica la diferencia y Playwright y Selenium comparados pone las dos herramientas una al lado de la otra.
Primer ejemplo: descargar y analizar una sola página
El ejemplo siguiente descarga una sola página de catálogo e imprime los títulos de los libros con sus precios. El código sigue la plantilla de consola de .NET 8 y posteriores, con instrucciones de nivel superior y directivas using implícitas; por eso no aparecen System, System.Linq ni System.Net.Http.
using HtmlAgilityPack;

// El pool de conexiones vive dentro del handler; montamos el cliente una vez y lo reutilizamos.
var handler = new SocketsHttpHandler
{
    PooledConnectionLifetime = TimeSpan.FromMinutes(2) // vida de la conexión, por los cambios de DNS
};

using var client = new HttpClient(handler)
{
    Timeout = TimeSpan.FromSeconds(30)
};

// Una identidad honesta: quiénes somos y cómo contactarnos.
client.DefaultRequestHeaders.UserAgent.ParseAdd("BookTracker/1.0 (+https://ornek.com/bot)");

var url = "https://books.toscrape.com/catalogue/page-1.html";

using var response = await client.GetAsync(url);
response.EnsureSuccessStatusCode(); // lanza HttpRequestException con códigos fuera de 2xx

var html = await response.Content.ReadAsStringAsync();

var document = new HtmlDocument();
document.LoadHtml(html);

// SelectNodes devuelve null si no coincide ningún nodo, por eso comprobamos antes.
var cards = document.DocumentNode.SelectNodes("//article[contains(@class,'product_pod')]");
if (cards is null)
{
    Console.WriteLine("La estructura de la página no es la esperada: no hay ficha de producto.");
    return;
}

foreach (var card in cards)
{
    var title = card.SelectSingleNode(".//h3/a")?.GetAttributeValue("title", "");
    var price = card.SelectSingleNode(".//p[@class='price_color']")?.InnerText.Trim();
    Console.WriteLine($"{title} | {price}");
}
Fíjate en tres detalles. EnsureSuccessStatusCode lanza una HttpRequestException cuando el código de estado queda fuera del rango 200-299; si prefieres leer el código tú, mira la propiedad IsSuccessStatusCode. SelectNodes no devuelve una colección vacía cuando no encuentra coincidencias, sino null, y ese comportamiento vuelve como NullReferenceException en el código que mete el resultado directamente en un foreach. Por último, el signo ? al final de las llamadas a SelectSingleNode evita que un campo ausente en una sola ficha tumbe todo el trabajo.
¿Cómo se añade un proxy a HttpClient?
El ajuste de proxy no está sobre el cliente, sino sobre el handler que hay debajo. La propiedad HttpClientHandler.Proxy recibe un objeto de tipo IWebProxy y su valor predeterminado es null; es decir, si no le das nada, .NET usa el ajuste de proxy del sistema operativo o de las variables de entorno. Para un proxy que funciona con usuario y contraseña se monta un objeto WebProxy y las credenciales se pasan a la propiedad Credentials de ese objeto como un NetworkCredential.
using System.Net;

var proxy = new WebProxy("http://pr.proxynet.io:8000")
{
    // Usuario y contraseña del panel; no los dejes fijos en el código, léelos de la configuración.
    Credentials = new NetworkCredential("user", "pass")
};

var handler = new SocketsHttpHandler
{
    Proxy = proxy,
    UseProxy = true,
    PooledConnectionLifetime = TimeSpan.FromMinutes(2),
    MaxConnectionsPerServer = 4 // conexiones simultáneas que se abren al mismo servidor
};

using var client = new HttpClient(handler) { Timeout = TimeSpan.FromSeconds(30) };

using var response = await client.GetAsync("https://books.toscrape.com/");
Console.WriteLine((int)response.StatusCode);
Además de Proxy y UseProxy, la clase SocketsHttpHandler lleva ajustes como PooledConnectionLifetime, MaxConnectionsPerServer, ConnectTimeout y AutomaticDecompression; por eso el código que quiere configurar juntos el proxy y el pool de conexiones suele elegirla a ella y no a HttpClientHandler.
Dos avisos. El primero: si la contraseña tiene caracteres como @ o :, no los incrustes dentro de la cadena de la dirección; entregados a NetworkCredential como campos separados, el problema de codificación desaparece. El segundo: cuando falla la autenticación del proxy, la respuesta 407 no llega del sitio de destino sino del proxy, así que el problema no está en las reglas del sitio sino en tu configuración. Contamos los dos métodos de autenticación y el diagnóstico de este error en Autenticación de proxy: user:pass o lista blanca de IP.
Con qué tipo de proxy trabajas depende del propio trabajo. En trabajos de gran volumen contra tu entorno de pruebas o contra fuentes sin restricción de acceso, Proxies de centro de datos lleva ventaja en velocidad. En objetivos cerrados a los rangos de centros de datos se prefiere Proxies residenciales, cuyo punto de salida pertenece a un proveedor de internet; explicamos la diferencia entre ambos grupos a nivel de ASN en Proxy ISP o residencial: diferencias y cuál elegir.
¿Cómo se indica un proxy SOCKS5 en C#?
Junto al proxy HTTP también se puede usar SOCKS. La documentación de HttpClient.DefaultProxy de Microsoft enumera uno a uno los esquemas admitidos: http, https, socks4, socks4a y socks5. Esa misma página da también los formatos de dirección; el patrón de socks5 es socks5://[usuario:contraseña@]host[:puerto]. En las filas de socks4 y socks4a se indica que la contraseña se ignora, porque esos protocolos no admiten autenticación con contraseña.
DefaultProxy es la propiedad estática que rige para todos los clientes cuyo handler no recibió un proxy explícito. Su instancia predeterminada se construye primero a partir de las variables de entorno; si no están definidas, Windows y macOS recurren al ajuste de proxy del sistema operativo, mientras que en Linux se obtiene una instancia que no usa proxy. Las variables de la documentación son HTTP_PROXY, HTTPS_PROXY, ALL_PROXY y NO_PROXY, que guarda los dominios que quedan fuera. Así que es posible ejecutar el código sin cambiarlo en absoluto:
# Antes de arrancar la aplicación (Windows PowerShell)
$env:ALL_PROXY = "socks5://user:pass@pr.proxynet.io:1080"
dotnet run
Reunimos los detalles de indicar el proxy con variables de entorno, y sus equivalentes en otras herramientas, en Proxy con wget. El protocolo en sí, sus diferencias con el proxy HTTP y qué trabajo encaja con cada uno se explican en nuestra página de Proxies SOCKS5.
¿Cómo se montan el tiempo de espera, la cancelación y el reintento?
El valor predeterminado de la propiedad HttpClient.Timeout es de 100 segundos y se aplica a todas las peticiones que salen de ese cliente. Para un trabajo de scraping ese plazo es demasiado largo: una sola dirección que no responde retiene el flujo del trabajo durante un minuto y medio. Un valor cercano a treinta segundos basta para casi todas las páginas.
Si alguna petición concreta necesita otra duración, se usa un CancellationTokenSource. La documentación de Microsoft dice que los dos mecanismos funcionan juntos y que se aplica el más corto de los dos. El mismo token sirve además para poner un tope al trabajo completo: cuando el usuario lo detiene o se supera el tiempo total, todas las peticiones pendientes se cancelan desde un único punto.
No tienes que escribir la lógica de reintento desde cero. El paquete de NuGet Microsoft.Extensions.Http.Resilience de Microsoft ofrece un handler de resiliencia listo para HttpClient; al llamar a AddStandardResilienceHandler sobre un IHttpClientBuilder entran en juego, en este orden, las capas de limitador de ritmo, tiempo de espera total, reintento, cortacircuitos y tiempo de espera por intento. La estrategia de reintento predeterminada hace como mucho tres reintentos y usa retroceso exponencial con un componente aleatorio; entre las respuestas que atiende están 408, 429 y los códigos de 500 en adelante. Cómo montar el paquete con clientes únicos que no usan inyección de dependencias también se muestra con un ejemplo en la guía de uso.
Con qué código de estado tiene sentido reintentar es otro asunto, y la decisión no la toma la biblioteca sino tú: 429 y 503 mejoran esperando, 403 y 407 no. La lectura de la cabecera Retry-After, el montaje correcto del retroceso exponencial y un ejemplo completo de un bucle que decide según el código están en Códigos de estado HTTP en web scraping; ese código no lo repetimos aquí.
Ejemplo completo: un trabajo que recorre las páginas en orden
El ejemplo siguiente recorre las diez primeras páginas del catálogo a través de un proxy, limita a dos las peticiones simultáneas, espera antes de cada petición y escribe el resultado en un archivo JSON.
using System.Collections.Concurrent;
using System.Net;
using System.Text.Json;
using HtmlAgilityPack;

var proxy = new WebProxy("http://pr.proxynet.io:8000")
{
    Credentials = new NetworkCredential("user", "pass")
};

var handler = new SocketsHttpHandler
{
    Proxy = proxy,
    UseProxy = true,
    PooledConnectionLifetime = TimeSpan.FromMinutes(2),
    MaxConnectionsPerServer = 4
};

using var client = new HttpClient(handler) { Timeout = TimeSpan.FromSeconds(30) };
client.DefaultRequestHeaders.UserAgent.ParseAdd("BookTracker/1.0 (+https://ornek.com/bot)");

// Tope para todo el trabajo: si se agota el plazo, se cancelan todas las peticiones pendientes.
using var cts = new CancellationTokenSource(TimeSpan.FromMinutes(5));
var token = cts.Token;

var gate = new SemaphoreSlim(2); // como mucho dos peticiones a la vez
var results = new ConcurrentBag<Book>();

var tasks = Enumerable.Range(1, 10).Select(async page =>
{
    await gate.WaitAsync(token);
    try
    {
        // Ponemos una espera deliberada entre peticiones.
        await Task.Delay(TimeSpan.FromMilliseconds(500), token);

        var url = $"https://books.toscrape.com/catalogue/page-{page}.html";
        using var response = await client.GetAsync(url, token);

        if (!response.IsSuccessStatusCode)
        {
            Console.WriteLine($"{url}: HTTP {(int)response.StatusCode}");
            return;
        }

        var html = await response.Content.ReadAsStringAsync(token);
        foreach (var book in ParseBooks(html, page))
        {
            results.Add(book);
        }
    }
    finally
    {
        gate.Release();
    }
}).ToList();

await Task.WhenAll(tasks);

var options = new JsonSerializerOptions { WriteIndented = true };
var json = JsonSerializer.Serialize(results.OrderBy(book => book.Page), options);
await File.WriteAllTextAsync("books.json", json, token);

Console.WriteLine($"{results.Count} registros escritos.");

// El análisis va en una función aparte: si cambia la estructura de la página, solo cambia esto.
static IEnumerable<Book> ParseBooks(string html, int page)
{
    var document = new HtmlDocument();
    document.LoadHtml(html);

    var cards = document.DocumentNode.SelectNodes("//article[contains(@class,'product_pod')]");
    if (cards is null)
    {
        yield break;
    }

    foreach (var card in cards)
    {
        var title = card.SelectSingleNode(".//h3/a")?.GetAttributeValue("title", "") ?? "";
        var price = card.SelectSingleNode(".//p[@class='price_color']")?.InnerText.Trim() ?? "";
        yield return new Book(title, price, page);
    }
}

record Book(string Title, string Price, int Page);
SemaphoreSlim decide cuántas peticiones vuelan a la vez; aunque Task.WhenAll arranque todas las tareas de la lista, el semáforo no deja avanzar a más de dos al mismo tiempo. No lo confundas con el ajuste MaxConnectionsPerServer del handler: uno limita el número de conexiones TCP que se abrirán y el otro el número de tareas simultáneas que produce tu código. Tratamos la diferencia conceptual entre ambos en Concurrencia y paralelismo.
El ejemplo recorre un rango fijo de páginas. En un trabajo real el número de páginas no se conoce de antemano, se sigue el enlace «siguiente» y las direcciones recorridas se guardan en una cola. Montamos ese esquema en Paginación en web scraping.
Casos de uso
- Seguimiento de precios y stock. Recorrido periódico de tus productos y de sus equivalentes en catálogos abiertos. El montaje general se explica en nuestra solución de seguimiento de precios.
- Trabajos corporativos de recogida de datos. Los equipos de banca, seguros y ERP que trabajan con C# ya escriben lo que recogen en una base de datos del lado .NET; quedarse en la misma solución en lugar de sumar otro lenguaje baja el coste de mantenimiento. Para trabajos amplios, nuestra solución de extracción de datos es el punto de partida.
- Recorrido periódico de muchas fuentes. Para que la carga no se amontone en un único punto de salida se usa Proxies rotativos.
- Tu propio panel con sesión. Si la IP cambia en mitad de una sesión iniciada, la sesión se cae; en ese tipo de trabajo se prefiere Proxies de sesión fija.
- Control de contenido que cambia según la región. Comparar cómo se ve la misma página desde distintos países es posible cambiando la ubicación de salida.
Errores frecuentes
- Crear un
HttpClientnuevo en cada petición. La primera mitad del trabajo va sin problemas y luego empiezan los errores de conexión. Como el síntoma se parece a una avería de red, el diagnóstico se suele buscar en el sitio equivocado. - Montar el cliente único sin
PooledConnectionLifetime. En un servicio de larga duración, cuando cambia el registro DNS del destino o del proxy, el cliente sigue yendo a la dirección antigua. - No comprobar el resultado de
SelectNodes. Si no hay coincidencias el valor devuelto esnull;foreachno se salta ese valor en silencio, lanza una excepción. - Dar por buena una respuesta
200sin mirar el cuerpo. Las páginas de verificación también llegan con200. Confirma que en la página está el elemento que esperas. - Arrancar todas las direcciones a la vez sin espera.
Task.WhenAllarranca sin rechistar los cientos de tareas de la lista; el límite lo tienes que poner tú. - Escribir las credenciales dentro del código. El usuario y la contraseña del proxy se leen de un archivo de configuración o de una variable de entorno, y no entran en el repositorio.
- Incrustar la contraseña en la cadena de la dirección y olvidar la codificación. Una contraseña con
@rompe el resto de la dirección;NetworkCredentialelimina ese problema.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Trabajo de consola independiente | Un HttpClient único static más PooledConnectionLifetime |
| Aplicación con inyección de dependencias | IHttpClientFactory, preferiblemente con cliente tipado |
| Análisis con XPath | HtmlAgilityPack, LoadHtml más SelectNodes |
| Selector CSS probado en el navegador | AngleSharp, QuerySelectorAll |
| Contenido que llega con JavaScript | Automatización de navegador, no un analizador |
| Proxy con usuario y contraseña | WebProxy más NetworkCredential |
| Salida SOCKS5 | Dirección socks5://, variable de entorno o DefaultProxy |
| Reintento y cortacircuitos | Microsoft.Extensions.Http.Resilience |
| Límite de concurrencia | SemaphoreSlim más MaxConnectionsPerServer |
Preguntas frecuentes
¿Qué paquetes necesito instalar para extraer datos con C#?
Del lado HTTP no hace falta ningún paquete extra, System.Net.Http forma parte del tiempo de ejecución. Para analizar HTML añades un paquete de NuGet: HtmlAgilityPack si vas a trabajar con XPath, AngleSharp si vas a trabajar con selectores CSS. Si quieres reintento y cortacircuitos, se añade Microsoft.Extensions.Http.Resilience. Para escribir los datos como JSON, System.Text.Json ya viene incluido.
¿Por qué no debo usar el objeto HttpClient dentro de un bloque using?
Porque el pool de conexiones está dentro del handler que hay bajo el cliente. Crear y cerrar un cliente nuevo en cada petición cierra también el pool y, como los puertos de las conexiones TCP cerradas no se liberan de inmediato, en un trabajo intenso chocas con el límite de puertos disponibles. Lo correcto es usar un único cliente que viva tanto como la aplicación, o gestionarlo con IHttpClientFactory.
He configurado el proxy pero recibo el error 407, ¿dónde busco?
El 407 no llega del sitio de destino sino del servidor proxy, y dice que tu identidad no se ha verificado. Comprueba primero que la propiedad Credentials del objeto WebProxy está rellena y después que el usuario y la contraseña están bien escritos. Si trabajas con autorización por IP, la IP pública desde la que sale la petición tiene que estar en la lista. Reintentar no resuelve este error.
¿Se puede usar un proxy SOCKS5 en C#?
Sí. La documentación de HttpClient.DefaultProxy de Microsoft lista http, https, socks4, socks4a y socks5 como formatos de dirección admitidos. El patrón de socks5 es socks5://usuario:contraseña@host:puerto. En esa misma página se indica que la contraseña que se dé con socks4 o socks4a se ignora, porque esos protocolos no tienen autenticación con contraseña.
Mi código se rompe cuando cambia la estructura de la página, ¿qué hago?
No puedes evitar la rotura, pero sí detectarla pronto. Mantén el análisis en una función aparte, registra como error que SelectNodes devuelva null y anota en cada ejecución cuántos registros se han encontrado. Que salgan muchos menos registros de los esperados es la primera señal de que la estructura ha cambiado. Mantener los selectores lo más cortos y significativos posible también reduce la fragilidad.
¿Cuándo debo pasarme a Selenium o Playwright?
Cuando en el HTML que descargas no está en absoluto el dato que buscas. Abre la página en las herramientas de desarrollo del navegador y mira el código fuente: si el dato está en el fuente, HttpClient basta y la automatización de navegador solo añade lentitud. Si el dato llega después con otra petición, casi siempre lo más limpio es llamar directamente a la dirección de esa petición. Si no funciona ninguna de las dos, se pasa a la vía de Selenium con proxy.
En resumen
Lo difícil de extraer datos con C# no es el análisis, sino el montaje del cliente. Una única instancia de HttpClient que viva tanto como la aplicación, una vida de conexión acotada con PooledConnectionLifetime y un tiempo de espera cercano a treinta segundos mantienen el trabajo en pie mientras crece. El proxy se lo das a la propiedad Proxy del handler como un WebProxy y las credenciales las mantienes en campos separados con NetworkCredential. El límite de ritmo lo montas con SemaphoreSlim en tu propio código y el reintento se lo dejas a un handler de resiliencia ya hecho. Mantener el análisis en una función aparte hace que, cuando cambie la estructura de la página, solo tengas que tocar un sitio. Puedes encontrar los tipos de proxy adecuados para tus trabajos de recogida de datos en nuestros servicios de proxy.


