


































Bir betik, Türkiye'deki eski bir belediye sitesinden ihale ilanlarını topluyor. Tarayıcıda başlık Çankırı İhale İlanı diye görünüyor, betik ise Çankýrý Ýhale Ýlaný yazdırıyor. Betiğin bir Windows dizüstü bilgisayarda kaydettiği liste de Linux sunucuda açılırken 'utf-8' codec can't decode byte 0xc7 in position 0: invalid continuation byte hatası veriyor. İki sorunun sebebi aynı: baytlar bir kod tablosuyla yazılmış, başka bir kod tablosuyla okunmuş.
Bu yazıda sorunu göründüğü her yerde düzeltiyoruz: kaynak dosyalar, open(), Windows konsolu, Requests ve Beautiful Soup ile çekilen sayfalar ve Excel için yazılan CSV dosyaları. Bozulmuş metni nasıl okuyup onaracağınızı da gösteriyoruz. Aşağıdaki her bayt değeri ve hata mesajı, Python 3.13 ile yaptığımız kendi denemelerimizden geliyor.
Python'da str ile bytes arasındaki fark nedir?
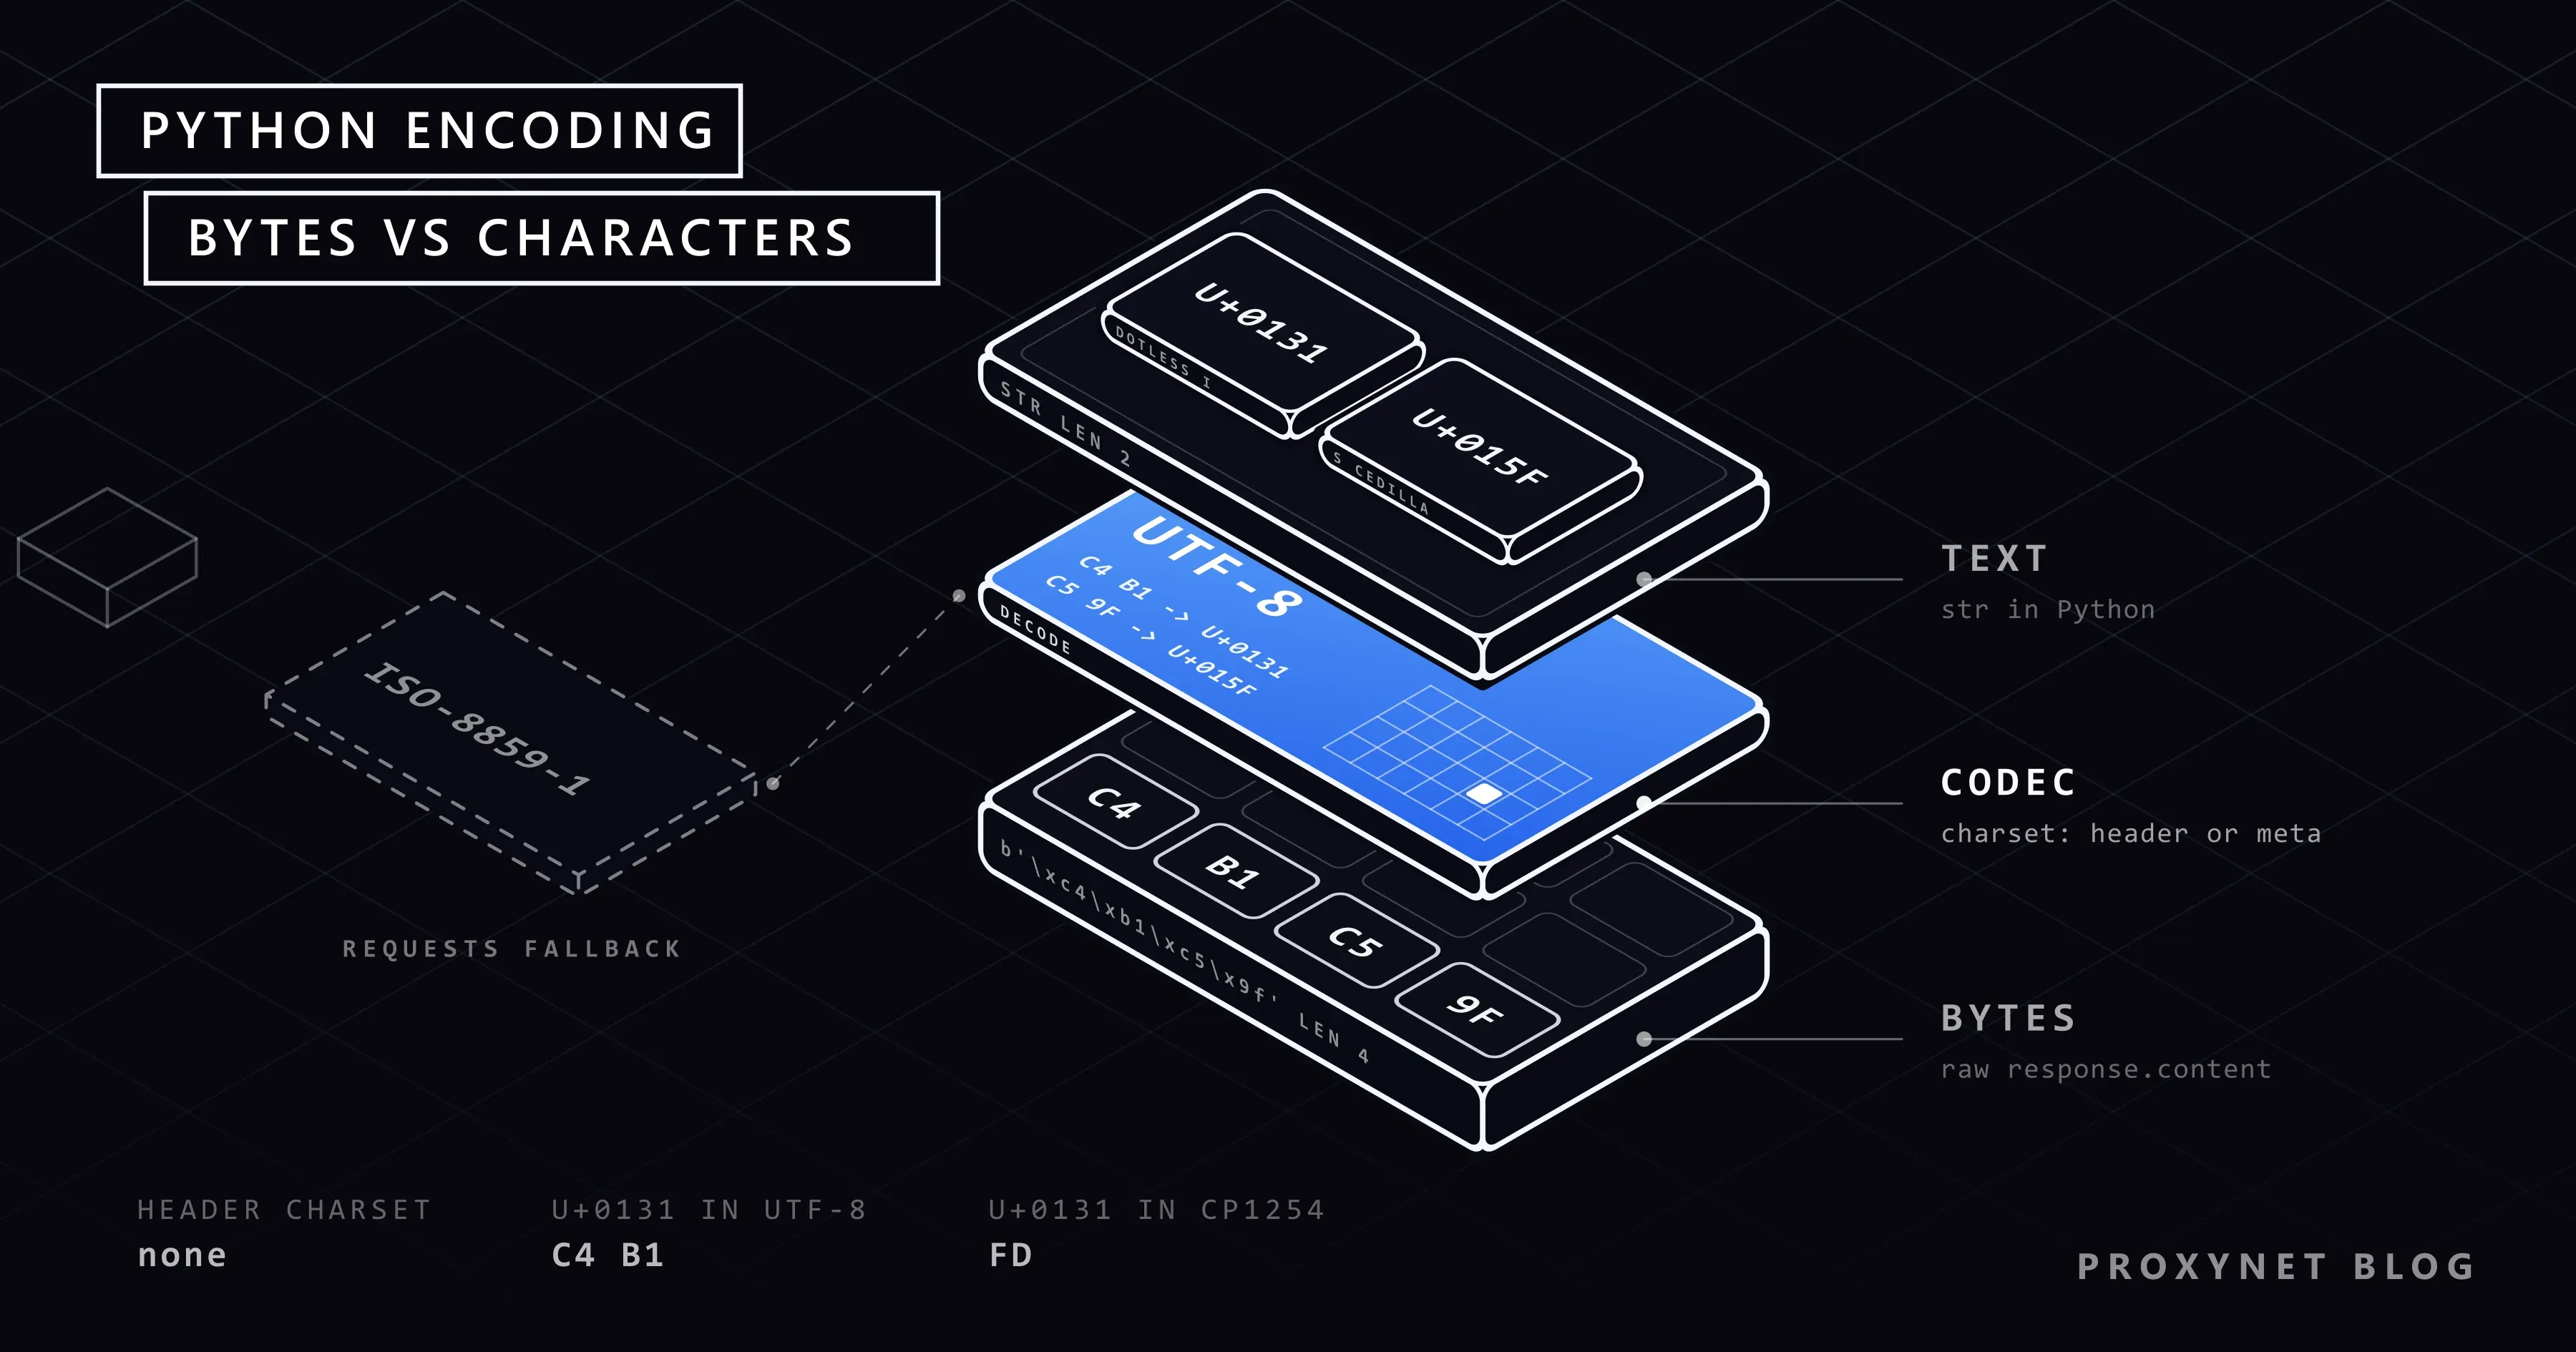
str karakterleri tutar ve her karakterin bir Unicode kod noktası vardır: Türkçedeki noktasız ı U+0131, é ise U+00E9'dur. Disk ve ağ yalnızca bayt saklar; metin dışarı çıkarken kodlanır (encode), içeri girerken çözülür (decode). Hangi baytın hangi karakteri temsil ettiğini kodlama (encoding) belirler, Python da bu eşleme tablolarına codec der. UTF-8'de ı iki bayttır: C4 B1. Eski Türkçe Windows kod sayfası windows-1254'te ise tek bayttır: FD. Batı Avrupa dilleri için kullanılan cp1252'de ve ISO-8859-1'de ı hiç yoktur.
Yazan ile okuyan farklı kodlama kullandığında baytlar sağlam kalır ama harfler değişir. Buna mojibake denir ve çoğu zaman geri alınabilir.
Bir karakter nasıl başka bir karaktere dönüşür?
Her kodlama hatası aynı adımları izler:
- Metniniz Unicode'dur. Python'da
"Çankırı"yedi kod noktasıdır. - A kodlamasıyla kodlanır. Türkçe Windows bu metni cp1254 ile
C7 61 6E 6B FD 72 FDolarak yazar. - Yalnızca baytlar taşınır. Bir dosya, bir HTTP gövdesi ya da bir pipe, A kodlamasını kendiliğinden bildirmez; bu bilgiyi ancak bir header, bir BOM ya da bir
<meta>etiketi ekler. - Biri B kodlamasıyla çözer. ISO-8859-1
FDbaytınıýharfine eşler ve ortayaÇankýrýçıkar. UTF-8 iseC7 61dizisini bir karakter olarak okuyamaz veUnicodeDecodeErrorfırlatır. - Çıktı yeniden kodlanır.
print()vewrite()konsolun ya da dosyanın kodlamasını kullanır; o kodlamada bulunmayan bir karakterUnicodeEncodeErrorverir.
Hangi yönün bozulduğunu traceback söyler.
Bozuk metin size ne söyler?
Bozulmanın biçimi, hangi iki kodlamanın karıştığını gösterir.
| Gördüğünüz | Gerçek metin | Ne oldu | Ne yapmalı |
|---|---|---|---|
café, ü, ı, ÅŸ | café, ü, ı, ş | UTF-8 baytları (C3 A9, C4 B1) cp1252 ya da ISO-8859-1 ile çözülmüş | Baytları UTF-8 olarak çözün ya da metni onarın (aşağıda) |
ý, þ, ð, Ý | ı, ş, ğ, İ | windows-1254 baytları (FD, FE, F0, DD), Requests'in varsayılanı olan ISO-8859-1 ile çözülmüş | r.encoding = "cp1254" ayarlayın ya da Beautiful Soup'a r.content verin |
ş yerine ţ | ş | Tahmin, Türkçe bir sayfa için windows-1250'yi seçmiş | O sitenin kodlamasını sabitleyin |
� | ASCII dışındaki herhangi bir harf | Baytlar errors="replace" ile UTF-8 olarak çözülmüş | Metinde kayboldu; ham baytları yeniden çözün |
? | Herhangi bir harf | Metin, o harfi içermeyen bir kodlamaya errors="replace" ile kodlanmış | Kayboldu; UTF-8 ile yazın |
| Boş bir kutu | Doğru harf | Fontta o harfin glifi yok (PDF, eski terminal) | Kodlamayı değil fontu değiştirin |
Python 3'te # -*- coding: utf-8 -*- satırı hâlâ gerekli mi?
Hayır. PEP 3120 Python 3.0 ile kaynak dosyaların varsayılan kodlamasını UTF-8 yaptı; bu satır Python 2'den kalmadır. .py dosyanızdaki metin sabitleri hâlâ bozuluyorsa editörünüz dosyayı eski bir kod sayfasıyla (Windows'ta "ANSI") kaydetmiştir; dosyayı UTF-8 olarak kaydedin. u"" öneki ve codecs.open() gibi diğer Python 2 öğütlerine de gerek yok.
Dosya okurken ve yazarken encoding nasıl belirtilir?
encoding değerini her seferinde verin: open("cities.txt", "w", encoding="utf-8"). Verilmezse Python 3.13 Windows'ta ANSI kod sayfasını kullanır. Türkçe Windows makinemizde locale.getpreferredencoding(False) cp1254 döndürdü ve düz bir open("cities.txt", "w") çağrısı Çankırı sözcüğünü C7 61 6E 6B FD 72 FD olarak yazdı. İngilizce Windows ise içinde ı olmayan cp1252'yi kullanır; aynı yazma işlemi orada 'charmap' codec can't encode character 'ı' hatasıyla durur.
Size gelen dosyalarda, dosyanın yazıldığı kodlamayı kullanın: eski Türkçe Windows ve Excel çıktıları için cp1254, Batı Avrupa dillerindekiler için cp1252, Arapça ve Farsça için cp1256. Sığmayan baytlara ne olacağına errors argümanı karar verir:
- Varsayılan
stricthata fırlatır. Doğru kodlamayı ararken istediğiniz de budur. replaceher bozuk baytın yerine�koyar, böylece hasarın nerede olduğunu görürsünüz.backslashreplacebozuk baytları\xfdbiçiminde görünür bırakır.ignoreonları sessizce siler: cp1254 ile yazılıp UTF-8 olarak okunanIğdır,Idroldu.
"Latin-1 ile deneyin" öğüdü de aynı sorunu doğurur. ISO-8859-1, 256 bayt değerinin hepsini bir karaktere eşlediği için hiç hata vermez ve Türkçe metin sessizce Çankýrý olur.
UnicodeDecodeError: 'utf-8' codec can't decode byte
Dosya UTF-8 değildir ve mesajdaki bayt bir ipucudur. Türkçe veride 0xfd, 0xfe ya da 0xf0 cp1254'ü gösterir. 0xe9 (é) Batı Avrupa verisinde cp1252'ye işaret eder; 0xfc (ü) ise iki kod sayfasında da aynı harf olduğu için tek başına ikisini ayırmaz. pandas'ta kodlamayı parametre olarak verin: pd.read_csv("export.csv", sep=";", encoding="cp1254").
Windows'ta UnicodeEncodeError: 'charmap' codec can't encode character
Etkileşimli Windows konsolu Python 3.6'dan beri (PEP 528) UTF-8 yazar, ama bir dosyaya ya da pipe'a yönlendirilen çıktı ANSI kod sayfasını kullanır. Türkçe harfler cp1254'e sığar, ok işareti sığmaz: print("Istanbul → Ankara") içeren betik python script.py > out.txt ile çalıştırıldığında 'charmap' codec can't encode character '→' hatası verdi. Üç çözüm işe yaradı:
set PYTHONUTF8=1(PowerShell'de$env:PYTHONUTF8=1) dosyalar ve standart akışlar için UTF-8 modunu açar.python -X utf8 script.pyaynısını tek bir çalıştırma için yapar.PYTHONIOENCODING=utf-8yalnızca standart akışları değiştirir,open()çağrısını değil.
UTF-8 modu, Python'un Windows rehberinde anlatılıyor. PEP 686 UTF-8 modunu Python 3.15'ten itibaren varsayılan yapıyor; 3.15'in kararlı sürümü 1 Ekim 2026 için planlanmış durumda. Her makine bu sürümü çalıştırana kadar kodunuzda encoding="utf-8" kalsın.
'latin-1' codec can't encode character biçimindeki hata genellikle bir HTTP header'ından gelir. Requests'in altta kullandığı http.client, header değerlerini Latin-1 ile kodlar; Iğdır değerini taşıyan bir header bu yüzden aynı hatayı verdi. Böyle değerleri yüzde kodlamasıyla (percent-encoding) gönderin ya da isteğin gövdesine koyun.
Bir web sayfasının kodlaması nereden gelir?
Tarayıcı bir sayfanın kodlamasına şu sırayla karar verir:
- Gövdenin başındaki bayt sırası işareti (BOM, byte order mark).
Content-Typeheader'ınıncharsetparametresi.- MDN'ye göre ilk 1024 bayt içinde yer alması gereken
<meta charset>etiketi. - Baytlara bakılarak yapılan bir tahmin.
Requests yalnızca header'ı okur. Charset belirtilmemiş bir text/* türü için Requests dokümantasyonu RFC 2616'ya uyduğunu ve ISO-8859-1 kullandığını söylüyor; oysa RFC 7231 bu varsayılanı 2014'te kaldırdı. Charset'siz bir JSON yanıtı UTF-8 olarak okunur, diğer türler için tahmin yapılır. Düz text/html olarak sunulan test sayfalarımızda r.encoding her seferinde ISO-8859-1 çıktı. Bir sayfanın tarayıcıda doğru, betiğinizde yanlış görünmesinin sebebi bu.
windows-1254 ile ISO-8859-9 aynı mı?
Neredeyse. İkisi de Türkçe harfleri 0xA0 ile 0xFF arasında aynı baytlara koyar. 0x80 ile 0x9F arasında ise windows-1254'te €, “, ” ve … bulunur, ISO-8859-9'da görünmeyen kontrol kodları vardır. WHATWG Encoding Standard tarayıcılara iso-8859-9 etiketini windows-1254, iso-8859-1 etiketini windows-1252 olarak okumalarını söyler; Python ise bunları ayrı codec'ler olarak ele alır. iso-8859-9 etiketli sayfamızda Beautiful Soup \x93Kampanya\x94 10\x80 üretti, from_encoding="cp1254" ile aynı baytlar “Kampanya” 10€ oldu. Böyle sayfaları cp1254 ya da cp1252 ile çözün.
Kendi HTML sayfanız charset'i nasıl bildirmeli?
Dosyayı UTF-8 olarak kaydedin, <head> bölümünün en başına <meta charset="utf-8"> koyun ve sunucunun Content-Type header'ının başka bir charset belirtmediğinden emin olun, çünkü header önceliklidir.
response.encoding, apparent_encoding mi, Beautiful Soup mu?
Her seçenek farklı bir sinyali okur:
r.encodingheader'dan gelir.r.encoding = "cp1254"ayarlamak bilinen tek bir siteyi düzeltir; her site için"utf-8"ayarlamak ise windows-1254 kullanan siteleri bozar (test sayfamızda�ank�r�).r.apparent_encoding, charset-normalizer'ın gövdeye bakarak yaptığı tahmindir. Türkçe sayfalarımızdan biri içinWindows-1254, diğer ikisi içinwindows-1250dedi; bu daşharfiniţyapar.BeautifulSoup(r.content, "html.parser")<meta>etiketini kendisi okur.r.textdeğil, bayt verin; ayrıştırma tarafını BeautifulSoup Nedir ve Python'da Nasıl Kullanılır? yazımız anlatıyor.
Bizim sıramız tarayıcınınkini izler: önce BOM, sonra header'daki charset, ardından <meta> etiketi, en son tahmin. Hangisini kullandığınızı da log'a yazın. HTTPX farklı davranır: 0.28.1 sürümü header'da charset yoksa UTF-8 varsayar ve cp1254 sayfamız �ank�r� olarak geldi (HTTPX, Requests ve AIOHTTP Karşılaştırması).
Sayfaları tarayıcı gibi çözen bir Python scraper
Bu scraper (web sayfalarından veri toplayan betik) her URL'yi bir kez çeker, kodlamayı yukarıdaki sırayla seçer, ISO etiketlerini tarayıcıların yaptığı gibi eşler ve başlıkları Excel için bir CSV'ye yazar. Çalışması için pip install requests beautifulsoup4 yeterli. Yeniden deneme ya da IP döndürme yapmaz; bunlar için Scraping'de HTTP Hata Kodları ve Python'da Proxy'ler Nasıl Döndürülür? yazılarımıza bakın.
"""Sayfaları çeker, her birini bir tarayıcının yapacağı gibi çözer ve başlıkları Excel için bir CSV'ye kaydeder."""
import csv
import logging
import sys
from email.message import Message

import requests
from bs4 import BeautifulSoup
from bs4.dammit import EncodingDetector

PROXY = None  # örneğin "http://user:pass@pr.proxynet.io:8000"
USER_AGENT = "heading-reader/1.0 (+https://example.com/bot)"

# Tarayıcılar bu etiketleri Windows kod sayfaları olarak okur (WHATWG Encoding Standard); Python okumaz.
BROWSER_ALIASES = {
    "iso-8859-1": "cp1252", "iso8859-1": "cp1252", "latin1": "cp1252", "latin-1": "cp1252",
    "us-ascii": "cp1252", "ascii": "cp1252",
    "iso-8859-9": "cp1254", "iso8859-9": "cp1254", "latin5": "cp1254",
}

log = logging.getLogger("headings")


def header_charset(resp):
    """Content-Type header'ındaki charset ya da None. Requests'in kendi r.encoding
    değeri, charset'siz her text/* türü için burada ISO-8859-1 derdi."""
    msg = Message()
    msg["content-type"] = resp.headers.get("Content-Type", "")
    return msg.get_param("charset")


def pick_codec(resp):
    """(codec, geldiği yer) döndürür: önce BOM, sonra header, <meta charset>, en son tahmin."""
    bom = EncodingDetector.strip_byte_order_mark(resp.content)[1]
    if bom:
        return bom, "bom"
    declared = header_charset(resp)
    source = "header"
    if not declared:
        declared = EncodingDetector.find_declared_encoding(resp.content, is_html=True)
        source = "meta"
    if not declared:
        return resp.apparent_encoding or "utf-8", "guess"
    return BROWSER_ALIASES.get(declared.lower(), declared), source


def clean(text):
    """Bölünmez boşluk U+00A0 dahil, art arda gelen boşlukları teke indirir."""
    return " ".join(text.split())


def read_headings(session, url):
    resp = session.get(url, timeout=20)
    resp.raise_for_status()
    codec, source = pick_codec(resp)
    soup = BeautifulSoup(resp.content, "html.parser", from_encoding=codec)
    level = logging.WARNING if source == "guess" else logging.INFO
    log.log(level, "%s: %s from %s", url, codec, source)
    if soup.contains_replacement_characters:
        log.warning("%s: some bytes did not fit %s and became U+FFFD", url, codec)
    return [(url, codec, source, clean(h.get_text())) for h in soup.select("h1, h2")]


def main(urls, out="headings.csv"):
    session = requests.Session()
    session.headers["User-Agent"] = USER_AGENT
    if PROXY:
        session.proxies = {"http": PROXY, "https": PROXY}
    rows = []
    for url in urls:
        try:
            rows += read_headings(session, url)
        except requests.RequestException as exc:
            log.error("%s: %s", url, exc)
    # utf-8-sig önce bir BOM yazar, böylece Excel dosyayı UTF-8 olarak tanır
    with open(out, "w", newline="", encoding="utf-8-sig") as f:
        writer = csv.writer(f)
        writer.writerow(["url", "codec", "source", "heading"])
        writer.writerows(rows)
    log.info("%d headings written to %s", len(rows), out)


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO, format="%(levelname)-7s %(message)s")
    main(sys.argv[1:] or ["https://example.com/"])
Betiği Python 3.13, Requests 2.34.2 ve Beautiful Soup 4.15.0 ile yerel bir HTTP proxy üzerinden çalıştırdık. Yerel test sayfaları, utf8hdr dışında, charset'siz text/html olarak sunuldu; son URL herkese açık bir sayfa:
INFO    http://127.0.0.1:8057/cp1254: windows-1254 from meta
INFO    http://127.0.0.1:8057/iso9: cp1254 from meta
INFO    http://127.0.0.1:8057/utf8meta: utf-8 from meta
INFO    http://127.0.0.1:8057/utf8hdr: utf-8 from header
INFO    http://127.0.0.1:8057/latin1: cp1252 from meta
WARNING http://127.0.0.1:8057/nometa: windows-1250 from guess
WARNING https://example.com/: ascii from guess
INFO    12 headings written to headings.csv
Header'da charset ya da <meta> etiketi olan her sayfa doğru çıktı; ISO-8859-1 etiketli sayfadaki “quoted” 5€ da buna dahil. İkisi de olmayan sayfa zayıf nokta: tahmin windows-1250 dedi ve CSV'ye Çankýrý ile ţubat yazıldı.
Aynı ülkedeki çok sayıda siteyi düzenli aralıklarla okuyorsanız, o ülkeden bir Residential Proxy yerel ziyaretçilerin gördüğü sayfaları getirir; kodlama mantığı aynı kalır.
"can't decode byte 0x8b" ve "0xa0" hataları ne anlama gelir?
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x8b in position 1
Bir gzip akışı 1F 8B ile başlar (RFC 1952); bu yüzden 1. konumdaki 0x8b, sıkıştırılmış verinin metin olarak çözüldüğünü gösterir. gzip.compress(...).decode("utf-8") bize tam olarak bu mesajı verdi. Scraping'de bu hata, r.raw verisini doğrudan okuduğunuzda ya da sıkıştırılmış yanıtı hiçbir zaman açmayan urllib.request ile kopyalanmış bir Accept-Encoding header'ı gönderdiğinizde çıkar. Requests gzip'i kendisi açar; kopyalanmış header'ı kaldırın ve r.content kullanın. urllib3'te isteğe bağlı Brotli ya da Zstandard paketi yüklü değilse kopyalanmış br ya da zstd değerleri de aynı sonuca götürür.
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xa0
cp1252, cp1254 ve ISO-8859-1'de bölünmez boşluk (U+00A0) tek bir A0 baytıdır; UTF-8'de ise hiçbir karakter bu baytla başlamaz. Dosyayı gerçek kodlamasıyla okuyun. Karakter zaten metninizdeyse "10\xa0kg".split() onu kaldırır, .split(" ") kaldırmaz; unicodedata.normalize("NFKC", s) ise onu düz bir boşluğa çevirir (NFKC, ² gibi karakterleri de 2 yapar).
Bozulmuş metin nasıl onarılır?
Hiçbir bayt kaybolmadıysa yanlış adımı tersine çevirin:
- Ekrandan ya da bir hesap tablosundan kopyalanmış
ışğgibi bir metin:s.encode("cp1252").decode("utf-8")ışğverir. - Aynı bozulma Requests'in
r.textçıktısından geliyorsa içinde cp1252'nin kodlayamadığı bir kontrol karakteri (\x9f) saklıdır; bu durumdas.encode("latin-1").decode("utf-8")kullanın. cp1252 bu karakterde'charmap' codec can't encode character '\x9f'hatasıyla durdu. - ISO-8859-1 olarak okunmuş windows-1254 metni, örneğin
Çankýrý:s.encode("latin-1").decode("cp1254")Çankırıverir.
Büyük ya da karışık veride ftfy 6.3.1 UTF-8 kaynaklı mojibake'yi onarır: ftfy.fix_text("ışğ") ışğ döndürdü. Çankýrý metnine ise dokunmadı, çünkü bu geçerli bir Latin metni gibi görünür; kod sayfası karışıklıklarını elle düzeltin. Harflerin yerinde ? ya da � olan metin onarılamaz; kaynağı yeniden çekin.
UTF-8 CSV dosyası Excel'de neden bozuk karakterlerle açılır?
Excel, çift tıklamayla açılan bir UTF-8 CSV'yi, dosya bir bayt sırası işaretiyle (BOM) başlıyorsa doğru gösterir; Microsoft'un destek sayfası da bunu belirtiyor. encoding="utf-8-sig" başa üç baytlık EF BB BF işaretini ekler; pandas'ta karşılığı df.to_csv("out.csv", encoding="utf-8-sig"). Bu dosyaları geri okurken de utf-8-sig kullanın: düz utf-8 ile csv modülü bize ilk sütun adı olarak şehir verdi, pandas ise BOM'u iki durumda da kaldırdı. Siteden Excel'e uzanan akışın tamamı Web Sitesinden Veri Çekme yazımızda.
"I".lower() neden "ı" döndürmez?
str.lower() Unicode'un dilden bağımsız varsayılan eşlemesini kullanır. Türkçe için bu iki yerde yanlış sonuç verir: "ISPARTA".lower() ısparta yerine isparta döndürür, "İ".lower() ise i harfiyle birlikte bir birleşik nokta (U+0307) döndürür. casefold() da aynı eksikliği taşır. Önce iki özel harfi eşleyin:
TR_LOWER = str.maketrans({"I": "ı", "İ": "i"})
TR_UPPER = str.maketrans({"i": "İ", "ı": "I"})

print("ISPARTA İZMİR".translate(TR_LOWER).lower())  # ısparta izmir
print("istanbul ışık".translate(TR_UPPER).upper())  # İSTANBUL IŞIK
Sayılar ve tarihler de yerel kurallara uyar. 1.299,90 gibi bir Türkçe fiyat, s.replace(".", "").replace(",", ".") ile float() fonksiyonunun okuyabileceği hâle gelir; pandas'ta da bunun için decimal="," ve thousands="." parametreleri var. Scraper'da locale.setlocale() kullanmaktan kaçının, çünkü bu çağrı bütün süreci etkiler. Fiyat temizlemenin tamamı E-Ticarette Rakip Fiyat Takibi Nasıl Yapılır? yazımızda.
Kullanım alanları
- Fiyat takibi: hâlâ eski kod sayfalarıyla sayfa sunan mağazalar (rakip fiyat takibi).
- Tabloları Excel'e aktarma: doğru harflerle açılan bir CSV (web sitesinden veri çekme).
- PHP scraper'ları:
DOMDocument'ın kendine özgü bir çözümü var (PHP ile siteden veri çekme). - Scrapy dışa aktarımları: çıktı kodlamasını
FEED_EXPORT_ENCODINGbelirler (Scrapy ile proxy kullanımı). - .NET işleri:
HttpClientcharset'i kendi yöntemiyle ele alır (C# ile web sitesinden veri çekme). - Çok sayıda sitede tarama: her sayfanın kodlamasını log'a yazın (web crawler).
Sık yapılan hatalar
- Hatayı
errors="ignore"ya da latin-1 ile susturmak. Betik çalışır, harfler kaybolur ya da değişir. - Her site için
r.encoding = "utf-8"yazmak. Bazı sayfaları düzeltir, windows-1254 kullananları bozar. - İki kez çözmek. Zaten doğru çözülmüş metne
.encode().decode()uygulamak, sağlam metne yeni bir hata ekler. iso-8859-9ya daiso-8859-1etiketini olduğu gibi kullanmak. Tarayıcılar windows-1254 ve windows-1252 kullanır; farkı tırnak işaretleri ve euro simgesi ortaya çıkarır.utf-8-sigdosyasınıutf-8olarak okumak. İlk sütun adı görünmez bir karakterle başlar ve o sütunu adıyla arayan kod başarısız olur.- Karakter kodlamasını URL kodlamasıyla karıştırmak. Proxy şifresindeki
%40yüzde kodlamasıdır ve ayrı bir konudur (Node.js'te proxy şifresindeki özel karakterler).
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
Kendi .py dosyanızda ASCII dışı metin | UTF-8 olarak kaydedin; coding satırına gerek yok |
| Dosya okuma ya da yazma | encoding="utf-8"; eski kod sayfası yalnızca onunla yazılmış dosyalar için |
Windows'ta yönlendirilmiş çıktıda 'charmap' hatası | PYTHONUTF8=1 ya da python -X utf8; Python 3.15'ten itibaren varsayılan |
| Header'ında charset olmayan HTML | Beautiful Soup'a r.content verin, kodlamayı log'a yazın |
Header'da charset yok, <meta> etiketi de yok | Sitenin kodlamasını sabitleyin; apparent_encoding son çare |
Sayfa iso-8859-9 ya da iso-8859-1 diyor | Tarayıcı gibi cp1254 ya da cp1252 ile çözün |
Metin zaten é ya da ı gibi görünüyor | .encode("cp1252").decode("utf-8") ya da ftfy.fix_text |
| Sonuç Excel'de açılacak | CSV'yi utf-8-sig ile yazın |
Sıkça sorulan sorular
Python'da Türkçe karakterler için bir kütüphane gerekir mi?
Hayır. Python 3'te str Unicode'dur ve standart kütüphane yaygın kod sayfalarının codec'leriyle birlikte gelir (standart kodlamalar). Requests ile birlikte kurulan charset-normalizer bilinmeyen kodlamaları tahmin eder, ftfy ise mojibake'yi onarır.
cp1252 ya da cp1254 bir dosya UTF-8'e nasıl çevrilir?
Dosyayı eski kodlamasıyla okuyun, yenisiyle yazın: Path("new.txt").write_text(Path("old.txt").read_text(encoding="cp1254"), encoding="utf-8"). Path sınıfı pathlib modülünden gelir. Orijinali silmeden önce birkaç ismi kontrol edin.
errors="ignore" UnicodeDecodeError'ı çözer mi?
Hatayı gizler. Sığmayan baytlar uyarı verilmeden silinir ve isimler harf kaybeder. Bunun yerine doğru kodlamayı bulun.
Bir dosyanın hangi kodlamayı kullandığını nasıl anlarım?
BOM ile başlamıyorsa bir metin dosyası kendi kodlamasını kaydetmez, bu yüzden her araç tahmin yürütür. charset_normalizer.from_path("old.txt").best().encoding Türkçe test dosyamız için cp1254 döndürdü. Tahmini doğrulamak için dosyayı bu kodlamayla çözün ve Türkçe harf içeren birkaç sözcüğü okuyun.
utf-8 ile utf-8-sig arasındaki fark nedir?
utf-8-sig yazarken başa bir BOM (EF BB BF) ekler, okurken onu atlar. Excel'de açılacak CSV dosyaları için bunu kullanın.
pandas read_csv'de UnicodeDecodeError nasıl giderilir?
Dosyanın kodlamasını verin: Türkçe Windows çıktısı için encoding="cp1254", Batı Avrupa çıktısı için cp1252, dosyada BOM varsa utf-8-sig. encoding_errors="replace" hatayı durdurur ama harfleri kaybettirir.
Özet
Python'da Türkçe karakter sorunu tek bir kurala dayanır: baytları yazıldıkları kodlamayla çözün, kendi çıktınızı UTF-8 ile yazın. Hangi iki kodlamanın karıştığını bozuk metinden okuyun, her open() çağrısında encoding belirtin, Python 3.15 bunu sizin yerinize yapana kadar Windows'ta UTF-8 modunu kullanın ve web sayfalarını Beautiful Soup'a bayt olarak verin. Pek çok yerel siteden temiz metin toplaması gereken scraping işleri için veri kazıma çözümümüze göz atın.


