


































Um script coleta editais de licitação do site antigo de uma prefeitura na Türkiye. No navegador, um título aparece como Çankırı İhale İlanı, mas o script imprime Çankýrý Ýhale Ýlaný. Depois, a lista que ele salvou em um notebook com Windows não abre em um servidor Linux e dá 'utf-8' codec can't decode byte 0xc7 in position 0: invalid continuation byte. Os dois problemas têm a mesma causa: os bytes foram gravados com uma tabela de códigos e lidos com outra.
Este guia corrige essa causa onde quer que ela apareça: arquivos de código-fonte, open(), o console do Windows, páginas baixadas com Requests e Beautiful Soup e arquivos CSV para o Excel. Também mostra como ler e reparar texto corrompido. Todos os valores de bytes e mensagens de erro abaixo vêm das nossas próprias execuções com Python 3.13.
Qual é a diferença entre str e bytes no Python?
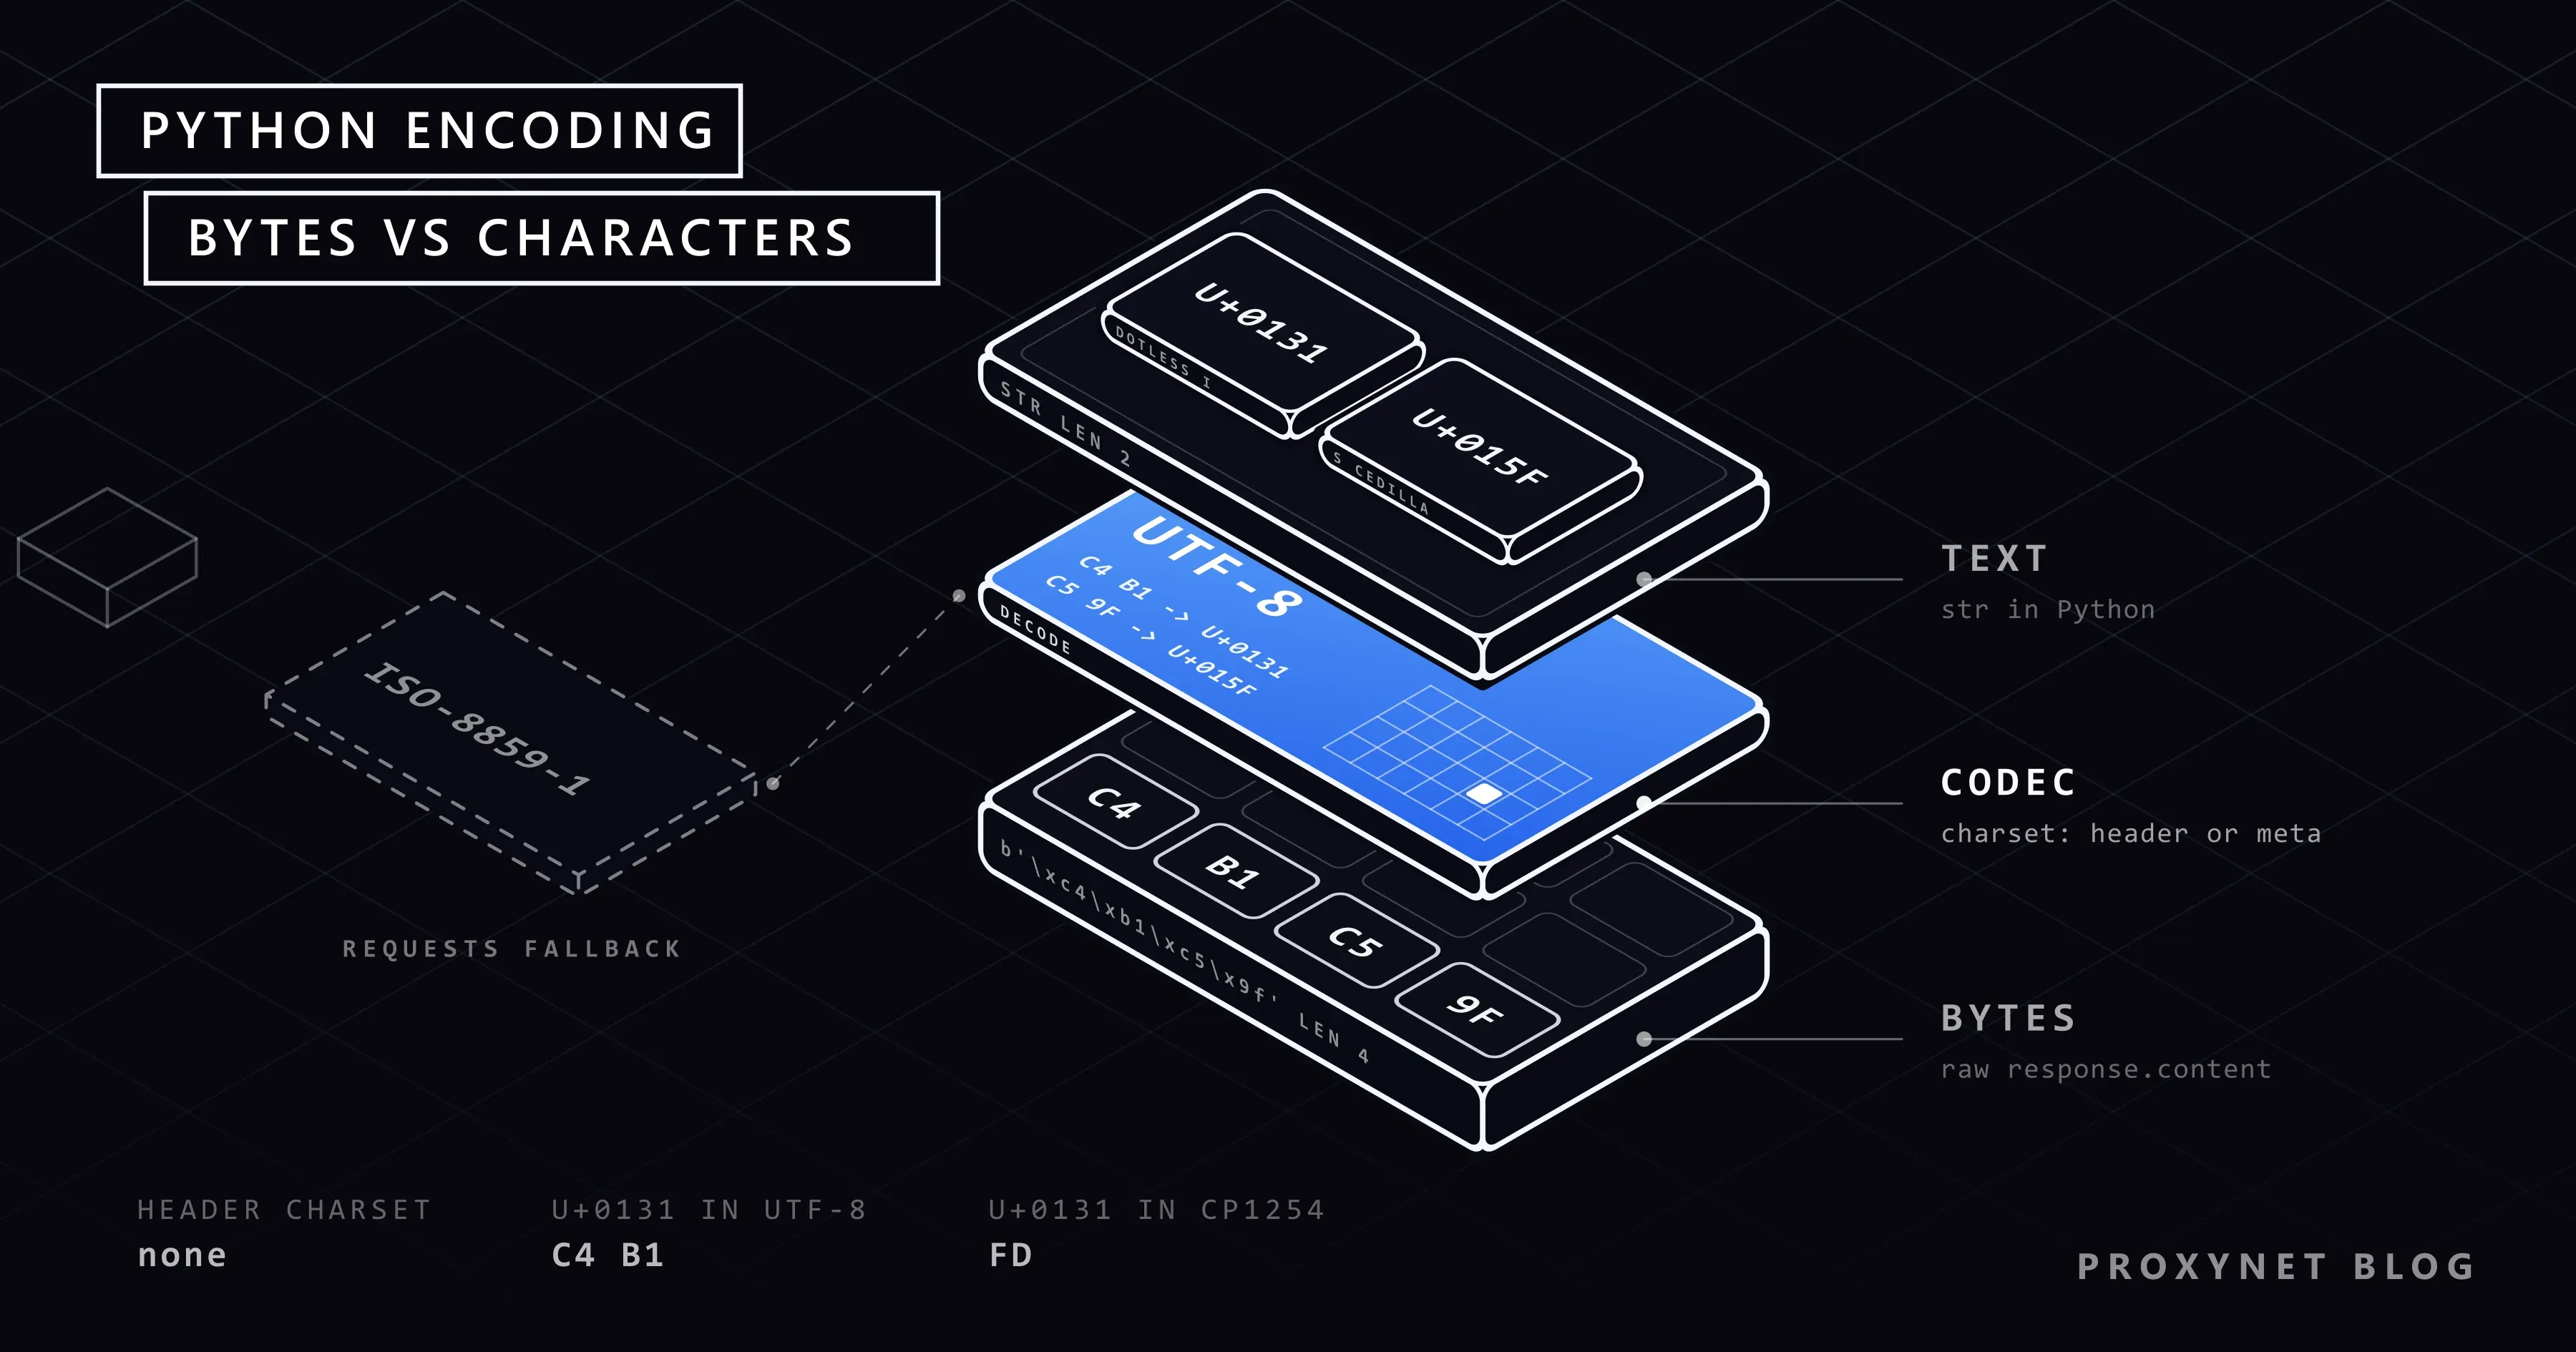
Uma str guarda caracteres, cada um com um ponto de código Unicode: o ı sem ponto do turco é U+0131 e o ã é U+00E3. Discos e redes armazenam apenas bytes, então o texto é codificado na saída e decodificado na entrada. O codec decide quais bytes representam qual caractere. Em UTF-8, o ı ocupa dois bytes, C4 B1. Na windows-1254, a antiga página de código turca do Windows, ocupa um byte, FD. A cp1252 da Europa Ocidental e a ISO-8859-1 não têm nenhum ı; o ã do português existe nas duas, como o byte E3.
Quando quem grava e quem lê usam codecs diferentes, os bytes sobrevivem, mas as letras mudam. Isso se chama mojibake e muitas vezes pode ser desfeito.
Como um caractere vira outro?
Todo bug de codificação segue os mesmos passos:
- Seu texto é Unicode.
"Çankırı"no Python são sete pontos de código. - Ele é codificado com o codec A. O Windows em turco grava
C7 61 6E 6B FD 72 FDem cp1254. - Só os bytes viajam. Um arquivo, um corpo HTTP ou um pipe não diz nada sobre o codec A, a menos que um cabeçalho, um BOM ou uma tag
<meta>o informe. - Alguém decodifica com o codec B. A ISO-8859-1 mapeia
FDparaý, o que dáÇankýrý. O UTF-8 não consegue lerC7 61como um caractere, então lançaUnicodeDecodeError. - A saída é codificada de novo.
print()ewrite()usam o codec do console ou do arquivo, e um caractere que não existe nele lançaUnicodeEncodeError.
O traceback diz qual direção falhou.
O que o texto corrompido revela?
O formato do estrago aponta para o par de codecs.
| O que você vê | Texto real | O que aconteceu | O que fazer |
|---|---|---|---|
café, ação, ü, ı, ÅŸ | café, ação, ü, ı, ş | Bytes UTF-8 (C3 A9, C4 B1) decodificados como cp1252 ou ISO-8859-1 | Decodifique os bytes como UTF-8 ou repare o texto (veja abaixo) |
ý, þ, ð, Ý | ı, ş, ğ, İ | Bytes windows-1254 (FD, FE, F0, DD) decodificados como ISO-8859-1, o padrão do Requests | Defina r.encoding = "cp1254" ou passe r.content ao Beautiful Soup |
ţ no lugar de ş | ş | Um palpite escolheu windows-1250 para uma página em turco | Fixe o codec para esse site |
� | Qualquer letra não ASCII | Bytes decodificados como UTF-8 com errors="replace" | Perdida no texto; decodifique de novo os bytes originais |
? | Qualquer letra | Texto codificado com errors="replace" em um codec que não tem a letra | Perdida; grave com UTF-8 |
| Um quadrado vazio | A letra certa | A fonte não tem o glifo (PDF, terminal antigo) | Troque a fonte, não a codificação |
Ainda é preciso # -*- coding: utf-8 -*- no Python 3?
Não. A PEP 3120 tornou o UTF-8 a codificação padrão dos arquivos de código-fonte no Python 3.0, então essa linha é uma sobra do Python 2. Se as strings literais do seu arquivo .py ainda quebram, o seu editor o salvou em uma página de código legada ("ANSI" no Windows); salve-o como UTF-8. Outros conselhos do Python 2, como os prefixos u"" e o codecs.open(), também não são mais necessários.
Como definir a codificação ao ler e gravar arquivos?
Passe-a sempre: open("cities.txt", "w", encoding="utf-8"). Sem ela, o Python 3.13 no Windows usa a página de código ANSI. Na nossa máquina com Windows em turco, locale.getpreferredencoding(False) retornou cp1254, e um simples open("cities.txt", "w") gravou Çankırı como C7 61 6E 6B FD 72 FD. O Windows em inglês ou em português do Brasil usa cp1252, que não tem ı, então a mesma gravação falha com 'charmap' codec can't encode character 'ı'.
Para arquivos que você recebe, use o codec com que eles foram gravados: cp1254 para exportações antigas do Windows e do Excel em turco, cp1252 para as da Europa Ocidental e do Brasil, cp1256 para árabe e persa. O argumento errors decide o que acontece com os bytes que não se encaixam:
strict, o padrão, lança um erro, que é o que você quer enquanto procura o codec certo.replacecoloca�no lugar de cada byte inválido, para você ver onde está o estrago.backslashreplacemantém os bytes inválidos visíveis como\xfd.ignoreos apaga em silêncio:Iğdırgravado em cp1254 e lido como UTF-8 virouIdr.
"É só tentar latin-1" falha do mesmo jeito. A ISO-8859-1 mapeia todos os 256 valores de byte para caracteres, então nunca lança erro, e o texto em turco vira Çankýrý sem nenhum aviso.
UnicodeDecodeError: 'utf-8' codec can't decode byte
O arquivo não é UTF-8, e o byte da mensagem é uma pista: 0xfd, 0xfe ou 0xf0 em dados turcos apontam para cp1254, enquanto 0xe7 (ç), 0xe3 (ã), 0xe9 (é) ou 0xfc (ü) sugerem cp1252. No pandas, passe o codec: pd.read_csv("export.csv", sep=";", encoding="cp1254").
UnicodeEncodeError: 'charmap' codec can't encode character no Windows
O console interativo do Windows escreve em UTF-8 desde o Python 3.6 (PEP 528), mas a saída redirecionada para um arquivo ou pipe usa a página de código ANSI. As letras turcas cabem na cp1254, uma seta não: python script.py > out.txt com print("Istanbul → Ankara") falhou com 'charmap' codec can't encode character '→'. Três soluções funcionaram:
set PYTHONUTF8=1($env:PYTHONUTF8=1no PowerShell) ativa o modo UTF-8 para arquivos e fluxos padrão.python -X utf8 script.pyfaz o mesmo para uma única execução.PYTHONIOENCODING=utf-8muda só os fluxos padrão, não oopen().
O guia do Python no Windows documenta o modo UTF-8. A PEP 686 torna o modo UTF-8 o padrão a partir do Python 3.15, cujo lançamento final está previsto para 1º de outubro de 2026. Mantenha encoding="utf-8" no seu código até que todas as máquinas usem essa versão.
A variante 'latin-1' codec can't encode character costuma vir de um cabeçalho HTTP. O http.client, que o Requests usa por baixo, codifica os valores de cabeçalho como Latin-1, então um valor de cabeçalho Iğdır falhou dessa forma. Aplique percent-encoding a esses valores ou envie-os no corpo.
De onde vem a codificação de uma página web?
Um navegador decide a codificação de uma página nesta ordem:
- Uma marca de ordem de byte (BOM) no início do corpo.
- O parâmetro
charsetdo cabeçalhoContent-Type. - Uma tag
<meta charset>, que segundo o MDN precisa estar nos primeiros 1024 bytes. - Um palpite a partir dos bytes.
O Requests lê só o cabeçalho. Para um tipo text/* sem charset, a documentação do Requests diz que ele segue a RFC 2616 e usa ISO-8859-1, embora a RFC 7231 tenha removido esse padrão em 2014. Uma resposta JSON sem charset é lida como UTF-8, e os outros tipos são adivinhados. Nas nossas páginas de teste servidas como text/html simples, r.encoding foi ISO-8859-1 todas as vezes. É por isso que uma página pode aparecer certa no navegador e errada no seu script.
A windows-1254 e a ISO-8859-9 são iguais?
Quase. As duas colocam as letras turcas nos mesmos bytes, de 0xA0 a 0xFF. De 0x80 a 0x9F, a windows-1254 tem €, “, ” e …, enquanto a ISO-8859-9 tem códigos de controle invisíveis. O WHATWG Encoding Standard manda os navegadores lerem iso-8859-9 como windows-1254 e iso-8859-1 como windows-1252; o Python trata esses rótulos como codecs separados. Na nossa página rotulada iso-8859-9, o Beautiful Soup produziu \x93Kampanya\x94 10\x80, e com from_encoding="cp1254" os mesmos bytes viraram “Kampanya” 10€. Decodifique essas páginas como cp1254 ou cp1252.
Como a sua própria página HTML deve declarar o charset?
Salve o arquivo como UTF-8, coloque <meta charset="utf-8"> no topo do <head> e confira se o cabeçalho Content-Type do servidor não informa outro charset, porque o cabeçalho tem prioridade.
response.encoding, apparent_encoding ou Beautiful Soup?
Cada opção lê um sinal diferente:
r.encodingvem do cabeçalho. Definirr.encoding = "cp1254"resolve um site conhecido; definir"utf-8"para todos os sites quebra os que usam windows-1254 (�ank�r�na nossa página de teste).r.apparent_encodingé o palpite do charset-normalizer a partir do corpo. Ele indicouWindows-1254para uma das nossas páginas em turco ewindows-1250para outras duas, o que transformaşemţ.BeautifulSoup(r.content, "html.parser")lê a própria tag<meta>. Passe bytes, nãor.text; o tutorial de Beautiful Soup cobre a parte do parsing.
A nossa ordem segue a do navegador: um BOM, um charset no cabeçalho, a tag <meta> e depois o palpite, registrando no log qual deles foi usado. O HTTPX é diferente: a versão 0.28.1 assume UTF-8 quando o cabeçalho não tem charset, e a nossa página em cp1254 saiu como �ank�r� (HTTPX, Requests ou AIOHTTP).
Um scraper em Python que decodifica páginas como um navegador
O script baixa cada URL uma vez, escolhe o codec nessa ordem, mapeia os rótulos ISO como os navegadores fazem e grava os títulos em um CSV para o Excel. Ele precisa de pip install requests beautifulsoup4. Não faz novas tentativas nem rotaciona IPs; para isso, veja códigos de status HTTP no web scraping e como rotacionar proxies em Python.
"""Baixa páginas, decodifica cada uma como um navegador faria e salva os títulos em um CSV para o Excel."""
import csv
import logging
import sys
from email.message import Message

import requests
from bs4 import BeautifulSoup
from bs4.dammit import EncodingDetector

PROXY = None  # por exemplo "http://user:pass@pr.proxynet.io:8000"
USER_AGENT = "heading-reader/1.0 (+https://example.com/bot)"

# Os navegadores leem estes rótulos como páginas de código do Windows (WHATWG Encoding Standard); o Python não.
BROWSER_ALIASES = {
    "iso-8859-1": "cp1252", "iso8859-1": "cp1252", "latin1": "cp1252", "latin-1": "cp1252",
    "us-ascii": "cp1252", "ascii": "cp1252",
    "iso-8859-9": "cp1254", "iso8859-9": "cp1254", "latin5": "cp1254",
}

log = logging.getLogger("headings")


def header_charset(resp):
    """O charset do cabeçalho Content-Type, ou None. O próprio r.encoding do Requests
    diria ISO-8859-1 aqui para qualquer tipo text/* sem charset."""
    msg = Message()
    msg["content-type"] = resp.headers.get("Content-Type", "")
    return msg.get_param("charset")


def pick_codec(resp):
    """Retorna (codec, de onde veio): um BOM, o cabeçalho, <meta charset> e, por fim, um palpite."""
    bom = EncodingDetector.strip_byte_order_mark(resp.content)[1]
    if bom:
        return bom, "bom"
    declared = header_charset(resp)
    source = "header"
    if not declared:
        declared = EncodingDetector.find_declared_encoding(resp.content, is_html=True)
        source = "meta"
    if not declared:
        return resp.apparent_encoding or "utf-8", "guess"
    return BROWSER_ALIASES.get(declared.lower(), declared), source


def clean(text):
    """Junta sequências de espaços em branco, incluindo o espaço sem quebra U+00A0."""
    return " ".join(text.split())


def read_headings(session, url):
    resp = session.get(url, timeout=20)
    resp.raise_for_status()
    codec, source = pick_codec(resp)
    soup = BeautifulSoup(resp.content, "html.parser", from_encoding=codec)
    level = logging.WARNING if source == "guess" else logging.INFO
    log.log(level, "%s: %s from %s", url, codec, source)
    if soup.contains_replacement_characters:
        log.warning("%s: some bytes did not fit %s and became U+FFFD", url, codec)
    return [(url, codec, source, clean(h.get_text())) for h in soup.select("h1, h2")]


def main(urls, out="headings.csv"):
    session = requests.Session()
    session.headers["User-Agent"] = USER_AGENT
    if PROXY:
        session.proxies = {"http": PROXY, "https": PROXY}
    rows = []
    for url in urls:
        try:
            rows += read_headings(session, url)
        except requests.RequestException as exc:
            log.error("%s: %s", url, exc)
    # utf-8-sig grava um BOM primeiro, assim o Excel reconhece o arquivo como UTF-8
    with open(out, "w", newline="", encoding="utf-8-sig") as f:
        writer = csv.writer(f)
        writer.writerow(["url", "codec", "source", "heading"])
        writer.writerows(rows)
    log.info("%d headings written to %s", len(rows), out)


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO, format="%(levelname)-7s %(message)s")
    main(sys.argv[1:] or ["https://example.com/"])
Nós o executamos com Python 3.13, Requests 2.34.2 e Beautiful Soup 4.15.0 através de um proxy HTTP local. As páginas de teste locais foram servidas como text/html sem charset, exceto utf8hdr, e a última URL é uma página pública:
INFO    http://127.0.0.1:8057/cp1254: windows-1254 from meta
INFO    http://127.0.0.1:8057/iso9: cp1254 from meta
INFO    http://127.0.0.1:8057/utf8meta: utf-8 from meta
INFO    http://127.0.0.1:8057/utf8hdr: utf-8 from header
INFO    http://127.0.0.1:8057/latin1: cp1252 from meta
WARNING http://127.0.0.1:8057/nometa: windows-1250 from guess
WARNING https://example.com/: ascii from guess
INFO    12 headings written to headings.csv
Todas as páginas com charset no cabeçalho ou com tag <meta> saíram certas, inclusive “quoted” 5€ na página rotulada ISO-8859-1. A página sem nenhum dos dois é o ponto fraco: o palpite indicou windows-1250 e o CSV recebeu Çankýrý e ţubat.
Se você lê muitos sites de um mesmo país em execuções agendadas, um Proxies residenciais nesse país retorna as páginas que os visitantes locais veem; a lógica do codec continua a mesma.
O que significam "can't decode byte 0x8b" e "0xa0"?
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x8b in position 1
Um fluxo gzip começa com 1F 8B (RFC 1952), então 0x8b na posição 1 significa que dados comprimidos estão sendo decodificados como texto; gzip.compress(...).decode("utf-8") nos deu exatamente essa mensagem. No scraping, isso acontece quando você lê r.raw diretamente ou envia um cabeçalho Accept-Encoding copiado com urllib.request, que nunca descomprime. O Requests descomprime o gzip sozinho, então remova o cabeçalho copiado e use r.content. Valores br ou zstd copiados também falham, a menos que o urllib3 tenha o pacote opcional Brotli ou Zstandard.
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xa0
Na cp1252, na cp1254 e na ISO-8859-1, o espaço sem quebra U+00A0 é o byte único A0, com o qual o UTF-8 nunca começa um caractere. Leia o arquivo com o codec real dele. Se o caractere já está no seu texto, "10\xa0kg".split() o remove, .split(" ") não, e unicodedata.normalize("NFKC", s) o transforma em um espaço comum (a NFKC também muda caracteres como ² para 2).
Como reparar um texto que já está corrompido?
Se nenhum byte foi perdido, desfaça o passo errado:
- Texto como
ışğouaçãocopiado de uma tela ou planilha:s.encode("cp1252").decode("utf-8")dáışğeação. - O mesmo estrago vindo do
r.textdo Requests esconde um caractere de controle (\x9f) que a cp1252 não consegue codificar, então uses.encode("latin-1").decode("utf-8"). A cp1252 falhou nele com'charmap' codec can't encode character '\x9f'. - Texto windows-1254 lido como ISO-8859-1, como
Çankýrý:s.encode("latin-1").decode("cp1254")dáÇankırı.
Para dados grandes ou mistos, o ftfy 6.3.1 repara mojibake de UTF-8: ftfy.fix_text("ışğ") retornou ışğ. Ele deixou Çankýrý como estava porque parece texto latino válido, então corrija as trocas de página de código à mão. Texto com ? ou � no lugar das letras não tem conserto; baixe o original de novo.
Por que o Excel mostra caracteres corrompidos em um CSV UTF-8?
O Excel abre corretamente um CSV UTF-8 com um clique duplo quando o arquivo começa com uma marca de ordem de byte, como observa a página de suporte da Microsoft. encoding="utf-8-sig" adiciona os três bytes EF BB BF; no pandas, df.to_csv("out.csv", encoding="utf-8-sig"). Leia esses arquivos também com utf-8-sig: com utf-8 simples, o módulo csv nos deu uma primeira coluna chamada şehir, enquanto o pandas removeu o BOM nos dois casos. Um fluxo completo do scraping ao Excel está em como extrair dados de um site.
Por que "I".lower() não retorna "ı"?
O str.lower() usa o mapeamento padrão do Unicode, que ignora o idioma. Para o turco, isso dá errado duas vezes: "ISPARTA".lower() retorna isparta em vez de ısparta, e "İ".lower() retorna i mais um ponto combinante (U+0307). O casefold() tem a mesma lacuna. Mapeie primeiro as duas letras especiais:
TR_LOWER = str.maketrans({"I": "ı", "İ": "i"})
TR_UPPER = str.maketrans({"i": "İ", "ı": "I"})

print("ISPARTA İZMİR".translate(TR_LOWER).lower())  # ısparta izmir
print("istanbul ışık".translate(TR_UPPER).upper())  # İSTANBUL IŞIK
Números e datas também seguem regras locais. Um preço turco ou brasileiro como 1.299,90 vira float depois de s.replace(".", "").replace(",", "."), e o pandas tem decimal="," e thousands=".". Evite locale.setlocale() em um scraper, porque ele muda o processo inteiro. A limpeza completa de preços está em monitoramento de preços da concorrência.
Casos de uso
- Monitoramento de preços: lojas que ainda usam páginas de código legadas (monitoramento de preços da concorrência).
- Tabelas para o Excel: um CSV que abre com as letras certas (como extrair dados de um site).
- Scrapers em PHP: o
DOMDocumenttem a sua própria solução (web scraping com PHP). - Exportações do Scrapy:
FEED_EXPORT_ENCODINGdefine o codec de saída (Scrapy com proxy). - Tarefas em .NET: o
HttpClienttrata charsets do seu próprio jeito (web scraping com C#). - Rastreamentos em muitos sites: registre o codec de cada página (web crawler).
Erros comuns
- Silenciar o erro com
errors="ignore"ou latin-1. O script roda e as letras somem ou mudam. - Fixar
r.encoding = "utf-8"para todos os sites. Resolve algumas páginas e quebra as que usam windows-1254. - Decodificar duas vezes. Chamar
.encode().decode()em um texto que já foi decodificado corretamente cria um erro novo em um texto que estava bom. - Usar
iso-8859-9ouiso-8859-1como declarados. Os navegadores usam windows-1254 e windows-1252, e as aspas e o símbolo do euro mostram a diferença. - Ler um arquivo
utf-8-sigcomoutf-8. O nome da primeira coluna começa com um caractere invisível e as buscas por ele falham. - Confundir codificação de caracteres com codificação de URL.
%40em uma senha de proxy é percent-encoding, um assunto à parte (caracteres especiais em senhas de proxy).
Guia de decisão
| Necessidade | Recomendação |
|---|---|
Texto não ASCII no seu próprio arquivo .py | Salve-o como UTF-8; sem linha de coding |
| Ler ou gravar um arquivo | encoding="utf-8"; uma página de código legada só para arquivos gravados com ela |
Erro 'charmap' na saída redirecionada no Windows | PYTHONUTF8=1 ou python -X utf8; padrão a partir do Python 3.15 |
| HTML sem charset no cabeçalho | Passe r.content ao Beautiful Soup e registre o codec no log |
Sem charset no cabeçalho e sem tag <meta> | Fixe o codec do site; apparent_encoding como último recurso |
A página diz iso-8859-9 ou iso-8859-1 | Decodifique como cp1254 ou cp1252, como um navegador |
O texto já aparece como é ou ı | .encode("cp1252").decode("utf-8") ou ftfy.fix_text |
| O resultado vai ser aberto no Excel | Grave o CSV com utf-8-sig |
Perguntas frequentes
Preciso de uma biblioteca para lidar com acentos no Python?
Não. Uma str do Python 3 é Unicode, e a biblioteca padrão traz codecs para as páginas de código mais comuns (codificações padrão). O charset-normalizer, instalado junto com o Requests, adivinha codecs desconhecidos, e o ftfy repara mojibake.
Como converter um arquivo cp1252 ou cp1254 para UTF-8?
Leia-o com o codec antigo e grave-o com o novo: Path("new.txt").write_text(Path("old.txt").read_text(encoding="cp1254"), encoding="utf-8"), com Path vindo de pathlib. Confira alguns nomes antes de apagar o original.
errors="ignore" resolve o UnicodeDecodeError?
Ele esconde o erro. Os bytes que não se encaixam são apagados sem aviso, e os nomes perdem letras. Em vez disso, encontre o codec certo.
Como descobrir qual codificação um arquivo usa?
A menos que comece com um BOM, um arquivo de texto não registra o seu codec, então toda ferramenta adivinha. charset_normalizer.from_path("old.txt").best().encoding retornou cp1254 para o nosso arquivo de teste em turco. Confirme o palpite decodificando o arquivo e lendo algumas palavras que tenham letras locais.
Qual é a diferença entre utf-8 e utf-8-sig?
utf-8-sig grava um BOM (EF BB BF) e o pula na leitura. Use-o para arquivos CSV que as pessoas abrem no Excel.
Como corrigir o UnicodeDecodeError no read_csv do pandas?
Passe o codec do arquivo: encoding="cp1254" para uma exportação do Windows em turco, cp1252 para uma da Europa Ocidental ou do Brasil, utf-8-sig se ele tiver BOM. encoding_errors="replace" faz o erro parar, mas perde letras.
Em resumo
Os erros de codificação no Python se resumem a uma regra: decodifique os bytes com o codec em que foram gravados e grave a sua própria saída em UTF-8. Leia o texto corrompido para achar o par de codecs, defina encoding em todo open(), use o modo UTF-8 no Windows até que o Python 3.15 faça isso por você e passe as páginas web ao Beautiful Soup como bytes. Para trabalhos de scraping que precisam de texto limpo de muitos sites locais, veja a nossa solução de extração de dados.


