Bir tedarikçinin fiyat listesini, bir kitap sitesindeki iki yüz ürünün adını ve fiyatını ya da bir kurumun her hafta güncellediği tabloyu kendi dosyanıza almak istiyorsunuz. İlk akla gelen kopyala yapıştırdır. On satırda işe yarar, bin satırda bir öğleden sonranızı alır. "Web sitesinden veri çekme" diye arayan herkesin aradığı şey aynıdır: bu işi elle yapmamanın yolu.
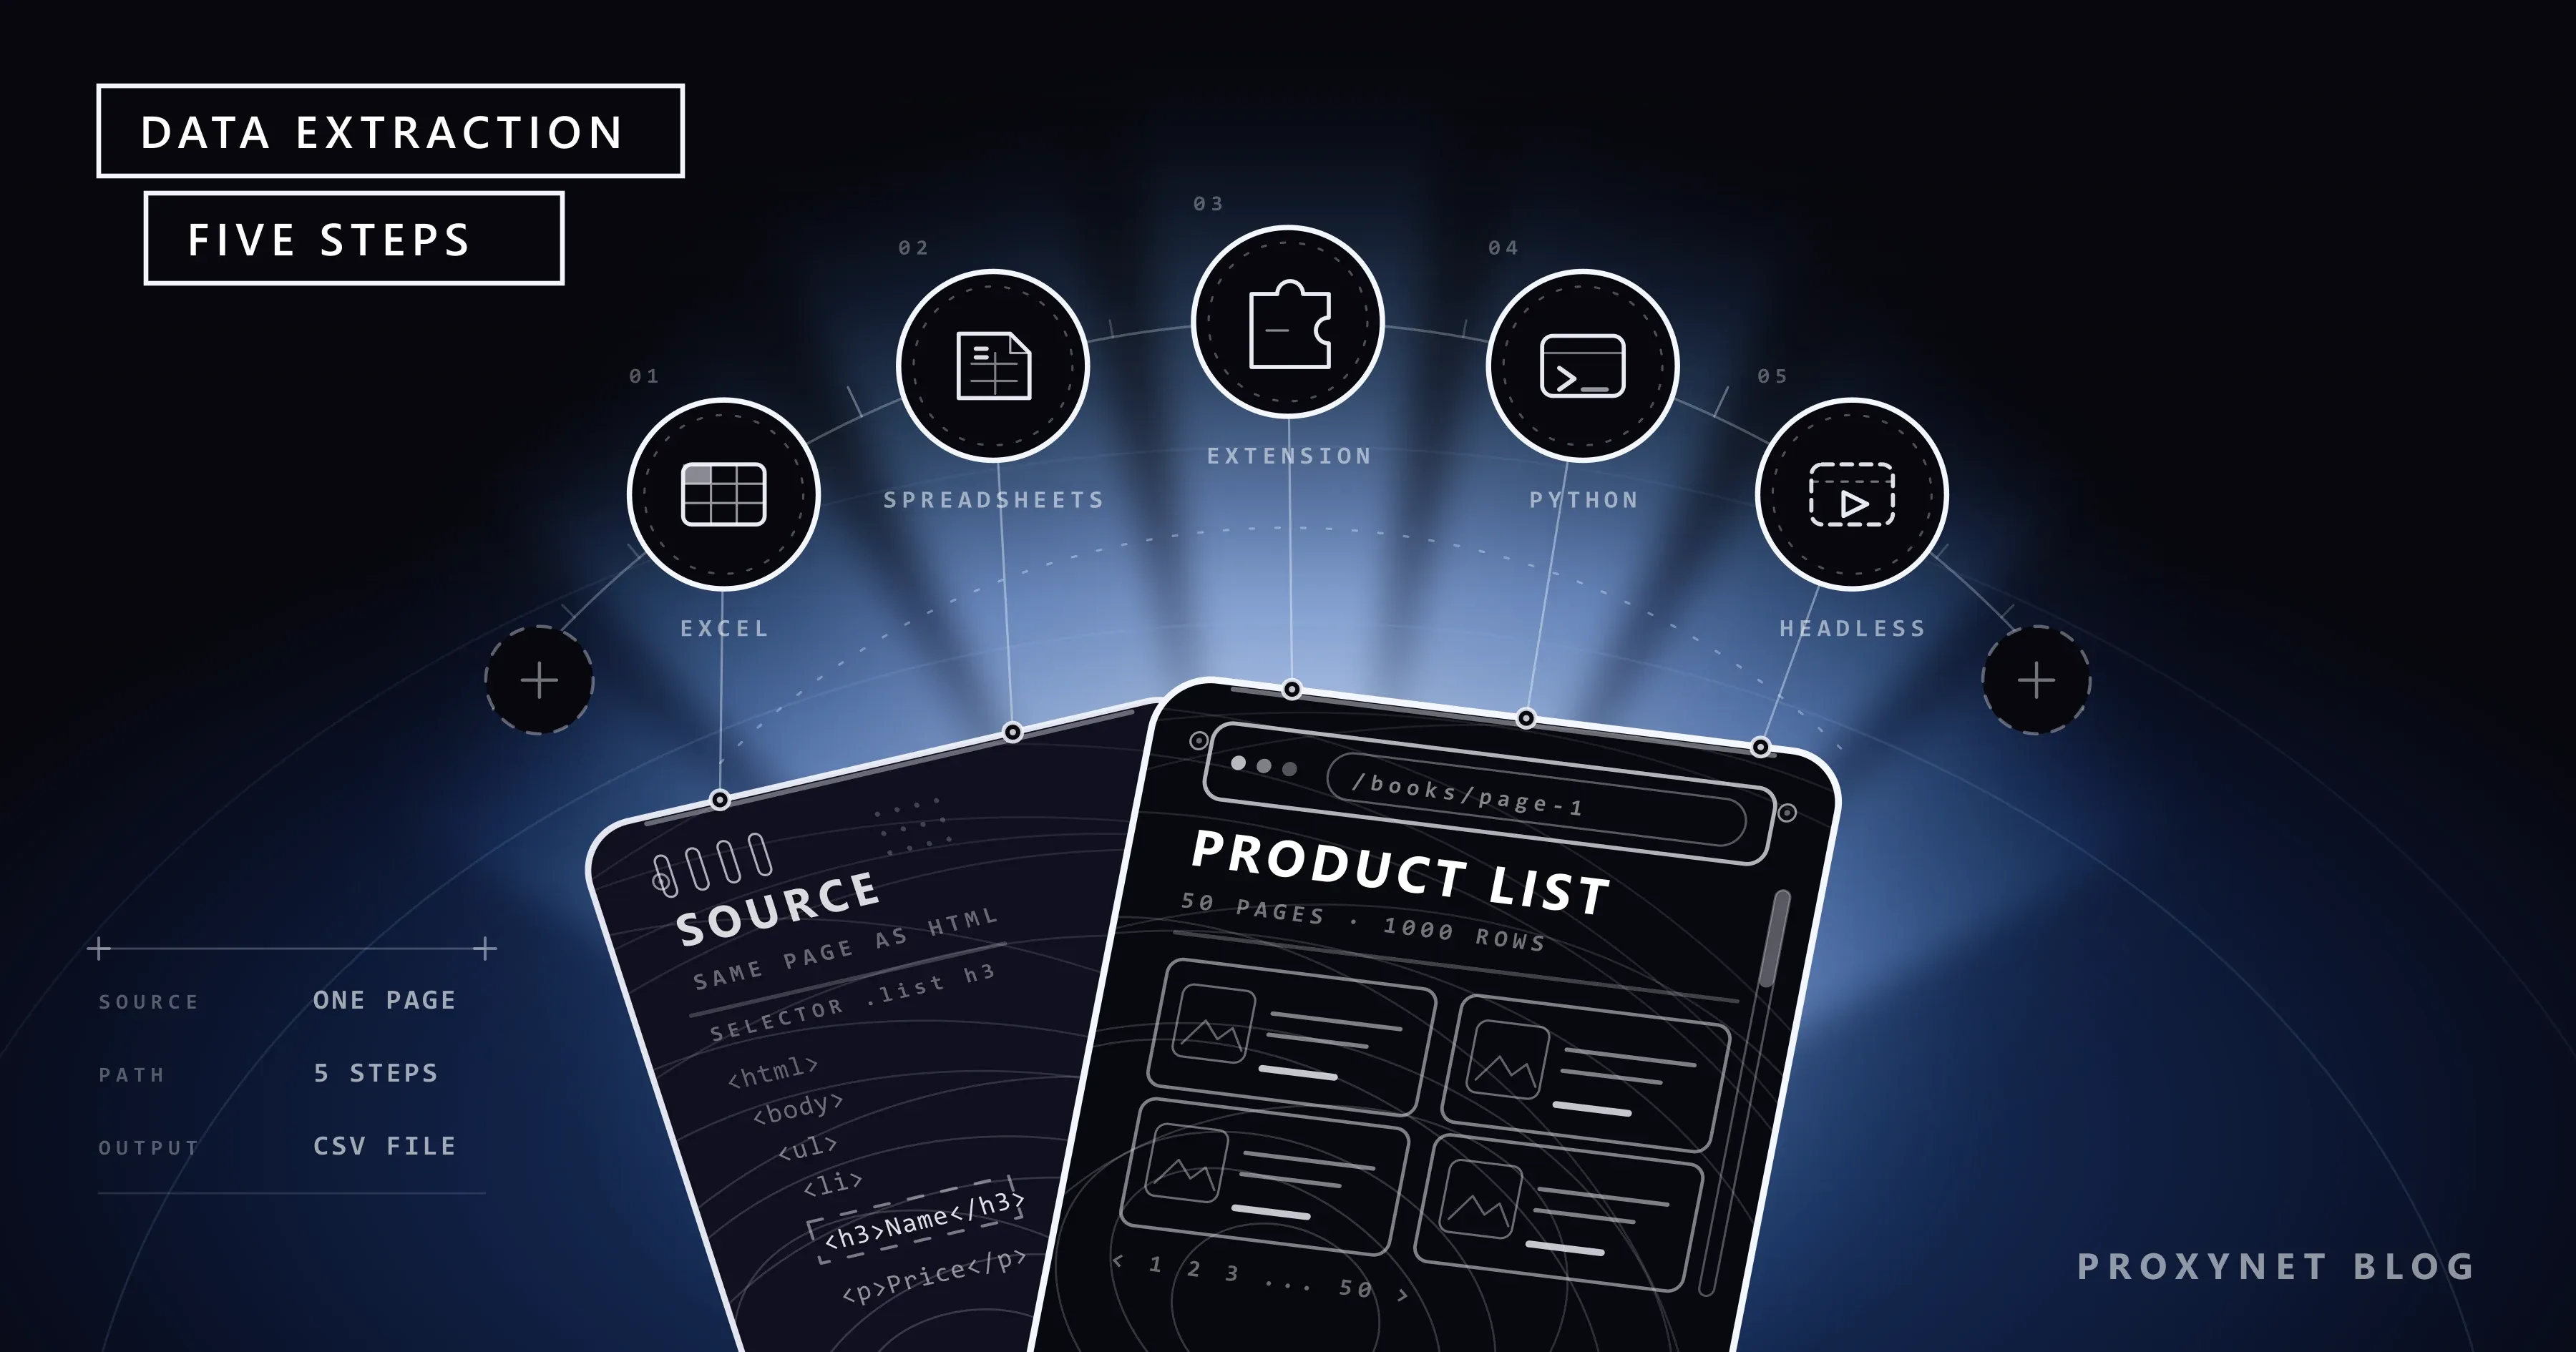
Tek bir yol yok, çünkü doğru yöntem kaç sayfa çekeceğinize, sayfanın nasıl kurulduğuna ve işi ne sıklıkla tekrarlayacağınıza bağlı. Bu yazıda yöntemleri bir merdiven gibi sıralıyoruz: Excel'in Web'den özelliği, Google E-Tablolar formülleri, tarayıcı eklentileri ve kodsuz araçlar, Python ile Requests ve BeautifulSoup, en üstte de headless tarayıcı. Her basamakta neyin yettiğini, nerede tıkandığını ve proxy'nin hangi basamakta gündeme geldiğini anlatıyoruz. Yazıdaki Python örneklerini bir alıştırma sitesi üzerinde çalıştırdık.
Web sitesinden veri çekme ne demek?
Web sitesinden veri çekme, bir sayfada insan gözü için dizilmiş bilgiyi (ürün adı, fiyat, tarih, adres) satır ve sütunlardan oluşan bir dosyaya dönüştürmektir. İşin teknik adı web scraping (veri kazıma); yazının geri kalanında kısaca "scraping" ya da "veri çekme" diyeceğiz. Tanımın ayrıntısını ve hangi iş türünde hangi proxy'nin kullanıldığını veri kazıma çözümü sayfamızda anlattık. Bu yazı tanımla değil, yöntem seçimiyle ilgileniyor.
Sık karıştırılan üç kavramı baştan ayıralım:
- Tarama (crawling): Bir sitede hangi sayfaların olduğunu bulmak, yani adres listesini çıkarmak. Arama motorlarının yaptığı iş budur. Ayrıntısı web crawler sayfamızda.
- Veri çekme (scraping): Adresi bilinen sayfadan belirli alanları ayıklamak. Tarama adresleri verir, veri çekme o adreslerin içindeki bilgiyi.
- API: Sitenin veriyi zaten yapılandırılmış biçimde (çoğunlukla JSON) sunduğu resmî kapı. API varsa sayfayı ayrıştırmaya gerek kalmaz.
Veri çekmeden önce: API ya da indirme düğmesi var mı?
En ucuz veri çekme işi, hiç yapılmayandır. Yönteme karar vermeden önce şu üç yere bakın:
- Resmî API. Pazaryerleri satıcılarına, kamu kurumları araştırmacılara API sunar. Örneğin Türkiye Cumhuriyet Merkez Bankası döviz kurlarını ve diğer serileri EVDS üzerinden hem arayüzle hem web servisiyle verir. Kur tablosu için bir haber sitesini ayrıştırmak yerine kaynağın kendisine gidin.
- İndirme düğmesi. Tablonun altında "Excel'e aktar" ya da "CSV indir" bağlantısı olan sayfa sayısı sanıldığından fazladır. İstatistik kurumlarının veri portalları bu şekilde çalışır.
- Sayfanın kendi veri isteği. Bazı sayfalar içeriği arka planda bir JSON adresinden alır. Bu adresi bulmanın yolunu Statik ve Dinamik Sayfalar yazımızda adım adım gösterdik.
Bunların hiçbiri yoksa veri çekmeye geçilir, ama dört kuralla. Yalnızca herkese açık, giriş gerektirmeyen veri toplanır. Sitenin robots.txt dosyası ve kullanım şartları okunur; şartlarında otomatik toplamayı açıkça yasaklayan ilan, skor ve sosyal medya siteleri bu yazıdaki yöntemlerin hedefi değildir. Ad, telefon, e-posta gibi kişisel veriler KVKK kapsamındadır ve "sayfada açıkta duruyordu" gerekçesi bunu değiştirmez; hukuki çerçeveyi Web Scraping Yasal mı? yazımızda topladık. Son kural hızdır: site sizin yüzünüzden yavaşlamamalı.
Bu yüzden yazıdaki bütün örnekler, scraping alıştırması için kurulmuş books.toscrape.com üzerinde çalışıyor. Site kendini "web scraping amaçlı demo site" diye tanıtır; fiyatlar ve puanlar rastgele atanmıştır.
Bir istek nasıl veriye dönüşür?
Excel de kullansanız Python da yazsanız arka planda aynı altı adım işler. Yöntemler arasındaki fark, bu adımların kaçını sizin yerinize yaptıklarıdır.
- İstek gönderilir. Araç, sayfanın adresine tarayıcının yaptığı gibi bir HTTP isteği yollar.
- Yanıt gelir. Sunucu bir durum kodu ve sayfanın HTML'ini döner.
200dışındaki kodların ne anlama geldiği HTTP hata kodları yazımızda. - HTML ayrıştırılır. Düz metin, iç içe etiketlerden oluşan bir ağaca çevrilir.
- Alanlar seçilir. "Her ürün kartının içindeki başlık ve fiyat" gibi bir kural yazılır. Bu kuralın dili CSS seçici ya da XPath'tir; farklarını CSS Selector ve XPath yazımızda karşılaştırdık.
- Satırlar kaydedilir. Seçilen alanlar bir tabloya, CSV dosyasına ya da veritabanına yazılır.
- Sonraki sayfaya geçilir. Liste birden fazla sayfaya yayılmışsa 1-5 arası adımlar her sayfa için tekrarlanır.
Excel ve E-Tablolar bu adımların hepsini tek tıkla yapar ama dördüncü adımda seçenekleri sınırlıdır. Kodsuz araçlar o adımı fareyle tarif etmenizi sağlar. Python'da altı adımın hepsi sizin elinizdedir.
Veri çekme yöntemleri yan yana
| Basamak | Yöntem | Kod gerekir mi? | Ne zaman yeter? | Nerede tıkanır? |
|---|---|---|---|---|
| 1 | Excel, Veri > Web'den | Hayır | Sayfada HTML tablosu var, veri Excel'de işlenecek | Kart düzenindeki sayfalar, form ile giriş, çok sayfalı listeler |
| 2 | Google E-Tablolar, IMPORTHTML ve IMPORTXML | Formül | Tek sayfa, paylaşılan bir tabloda güncel kalsın | JavaScript ile dolan içerik, giriş gerektiren sayfa, çok sayıda formül |
| 3 | Tarayıcı eklentisi ya da kodsuz araç | Hayır | Kart düzeni, birkaç yüz satır, tek seferlik iş | Düzenli tekrar, büyük hacim, site tasarımı değişince bozulan tarif |
| 4 | Python, Requests ve BeautifulSoup | Evet | Onlarca ya da binlerce sayfa, zamanlanmış çalışma, kendi biçiminiz | JavaScript ile sonradan dolan içerik |
| 5 | Headless tarayıcı (Playwright) | Evet | İçerik ancak tarayıcıda oluşuyor | Hız ve kaynak: her sayfa için gerçek bir tarayıcı çalışır |
Merdiveni aşağıdan yukarı çıkın. Alt basamak işinizi görüyorsa üsttekine çıkmak yalnızca bakım yükü getirir.
1. basamak: Excel ile web sitesinden veri alma
Excel'in bu iş için yerleşik bir özelliği var ve çoğu kullanıcı farkında değil. Microsoft'un destek sayfasındaki adımlar şöyle: Veri sekmesinde, "Al ve Dönüştür" bölümündeki Web'den düğmesine basılır, sayfanın adresi yapıştırılıp Tamam denir. Excel sayfadaki tabloları bulur ve Gezgin bölmesinde listeler. İstediğiniz tabloyu seçip Yükle dediğinizde veri çalışma sayfasına gelir. Bağlantı dosyada kalır; ertesi hafta aynı adımları tekrarlamaz, sorguyu yenilersiniz. Gezgin'deki "Web Görünümü" sekmesi sayfanın kendisini gösterir ve algılanan tabloları işaretler.
Tıkandığı yerler de bellidir. Özellik en rahat, HTML'de gerçekten <table> etiketiyle kurulmuş tablolarda çalışır. Alıştırma sitemizin ana sayfasında tek bir tablo etiketi yoktur, kitaplar kart olarak dizilmiştir; böyle sayfalarda Gezgin aradığınız tabloyu önermeyebilir ve geriye örnek değer yazarak sütun tarif ettiğiniz "Örnek kullanarak tablo ekle" düğmesi kalır. Microsoft Learn'deki bağlayıcı belgesine göre desteklenen kimlik doğrulama türleri anonim, Windows, temel (kullanıcı adı ve parola), Web API anahtarı ve kuruluş hesabıdır. Bir giriş formunu doldurup oturum açmak bu listede yoktur. Elli sayfalık bir listeyi sayfa sayfa gezmek de Excel'de mümkün olsa bile pratik değildir; o noktada dördüncü basamağa geçilir.
2. basamak: Google E-Tablolar ile IMPORTHTML ve IMPORTXML
Google E-Tablolar aynı işi formülle yapar. IMPORTHTML bir sayfadaki tabloyu ya da listeyi, IMPORTXML ise XPath ile tarif ettiğiniz herhangi bir öğeyi hücrelere döker. Türkiye bölge ayarlı bir tabloda bağımsız değişkenler noktalı virgülle ayrılır:
=IMPORTHTML("https://en.wikipedia.org/wiki/Demographics_of_India"; "table"; 4)
=IMPORTXML("https://books.toscrape.com/"; "//article[@class='product_pod']/h3/a/@title")
İlk formül Google'ın kendi belgesindeki örnektir: sayfadaki dördüncü tabloyu getirir, sayım 1'den başlar. İngilizce belgede ikinci bağımsız değişkenin alabileceği değerler "table" ve "list" olarak geçer; Türkçe yardım sayfasındaki örnekte bu sözcük çevrilmiş göründüğü için formül hata verirse ilk bakılacak yer burasıdır. İkinci formüldeki XPath ifadesini alıştırma sitesinin HTML'i üzerinde denedik; ana sayfadaki yirmi kitabın adını döndürüyor. Kart düzenindeki bir sayfada, tablo aramak yerine öğeyi XPath ile tarif etmek bu yüzden işe yarar.
Bu basamağın üç sınırı var. Formül Google'ın sunucularında çalışır, isteği sizin bilgisayarınız göndermez. Bu yüzden giriş yaptığınız bir sayfayı, şirket ağınızdaki bir paneli ya da tarayıcınızdaki oturumu göremez. Formül sayfanın ham HTML'ini okur; içerik JavaScript ile sonradan doluyorsa hücreye boş sonuç ya da hata gelir. Üçüncüsü ölçektir: formüllerin ne zaman yenileneceğini siz belirlemezsiniz ve bir dosyaya yüzlerce içe aktarma formülü koymak tabloyu ağırlaştırır. Tek sayfalık, ekipçe bakılan bir tablo için uygundur, bin ürünlük bir katalog için değil.
3. basamak: Veri çekme programları ve tarayıcı eklentileri
"Veri çekme programı" ya da "kod yazmadan web scraping" diye arandığında karşınıza çıkan araçlar üç gruba ayrılır:
- Tarayıcı eklentileri. Açık olan sayfada bir ürün kartına, sonra başlığa ve fiyata tıklarsınız; eklenti aynı desendeki bütün kartları bulur ve CSV ya da Excel dosyası olarak indirir. İstek sizin tarayıcınızdan çıktığı için sayfayı siz nasıl görüyorsanız eklenti de öyle görür.
- Masaüstü ve bulut tabanlı kodsuz araçlar. Aynı tıklayarak tarif mantığına sayfalama, zamanlama ve bulutta çalıştırma eklerler. Çoğunun ücretsiz katmanı vardır; sınırını aracın kendi fiyat sayfasından kontrol edin.
- İş akışı araçları. Veri çekmeyi bir zincirin halkası yaparlar: sayfayı al, alanı ayıkla, tabloya yaz, değişiklik varsa bildirim gönder. Bu grubun bir örneğini n8n ile Web Scraping yazımızda kurduk.
Tek seferlik, birkaç yüz satırlık işlerde bu araçlar Python'dan hızlı sonuç verir. Tıkandıkları yer süreklilikte ortaya çıkar. Tarif, sayfanın o günkü tasarımına göre kaydedilir; site bir sınıf adını değiştirdiğinde araç sessizce boş sütun üretir ve bunu fark etmek size kalır. Bulutta çalışan araçlarda topladığınız veri ve varsa girdiğiniz hesap bilgileri üçüncü bir şirketin sunucusundan geçer; bunu aracı seçerken hesaba katın.
4. basamak: Python ile siteden veri çekme
Python'da en yaygın ikili Requests ve BeautifulSoup kütüphaneleridir. Requests sayfayı indirir, BeautifulSoup HTML'i ayrıştırır ve CSS seçicilerle alan seçmenizi sağlar. Kurulum tek satırdır:
pip install requests beautifulsoup4Aşağıdaki betik alıştırma sitesinin ilk üç sayfasını gezer, her kitabın adını, fiyatını, stok durumunu ve adresini toplar, sonucu Excel'in doğrudan açabileceği bir CSV dosyasına yazar. Python 3.13 ile çalıştırdığımızda 60 kitaplık dosyayı sorunsuz üretti.
import csv
import os
import time
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup

START_URL = "https://books.toscrape.com/"
MAX_PAGES = 3          # alıştırma için üç sayfa yeter
DELAY = 2              # iki istek arasında saniye

# Proxy gerekiyorsa: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")

session = requests.Session()
session.headers["User-Agent"] = "kitap-fiyat-denemesi/1.0 (iletisim: siz@ornek.com)"
if proxy:
    session.proxies = {"http": proxy, "https": proxy}

rows = []
url = START_URL
for page in range(MAX_PAGES):
    response = session.get(url, timeout=20)
    response.raise_for_status()
    response.encoding = "utf-8"
    soup = BeautifulSoup(response.text, "html.parser")

    for card in soup.select("article.product_pod"):
        rows.append({
            "baslik": card.select_one("h3 a")["title"],
            "fiyat": card.select_one("p.price_color").get_text(strip=True),
            "stok": card.select_one("p.instock").get_text(strip=True),
            "adres": urljoin(url, card.select_one("h3 a")["href"]),
        })

    next_link = soup.select_one("li.next a")
    if next_link is None:
        break
    url = urljoin(url, next_link["href"])
    time.sleep(DELAY)

if not rows:
    raise SystemExit("Hiç ürün bulunamadı: seçiciler değişmiş ya da sayfa JavaScript ile doluyor olabilir.")

# utf-8-sig: Excel dosyayı açarken Türkçe karakterleri doğru gösterir
with open("kitaplar.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(f, fieldnames=rows[0].keys())
    writer.writeheader()
    writer.writerows(rows)

print(f"{len(rows)} satır kitaplar.csv dosyasına yazıldı")
Betikte kodsuz araçların size bırakmadığı dört karar var. User-Agent satırı kim olduğunuzu ve size nasıl ulaşılacağını söyler; sahte bir tarayıcı kimliği yerine dürüst bir bot adı kullanın. DELAY iki istek arasına bekleme koyar. raise_for_status() hata kodunda betiği durdurur, böylece engellenmiş bir sayfanın içeriği dosyanıza veri diye yazılmaz. Sondaki if not rows denetimi ise üçüncü basamakta anlattığımız sessiz boş sütun sorununun çaresidir: seçici tutmuyorsa betik bunu yüksek sesle söyler.
Buradan sonrası işin büyüklüğüne göre dallanır. Elli sayfayı kaldığı yerden sürdürebilen bir tarama kuyruğu için Sayfalama (Pagination) Nasıl Taranır?, kendi hesabınızla giriş gereken sayfalar için Python'da Oturum ve Çerez Yönetimi, yüzlerce sayfalık düzenli işler için Scrapy yazımıza bakın. Ekibiniz Python yazmıyorsa aynı mantığı PHP ile, C# ile ya da JavaScript ile kurabilirsiniz; yöntem dilden bağımsızdır.
Saklama tarafında tek seferlik iş için CSV yeter. İş tekrarlanıyorsa üzerine yazılan dosya değişimi kaybettirir; her satıra tarih ekleyip SQLite'a yazma kurgusu E-Ticarette Rakip Fiyat Takibi yazımızda, toplanan verinin analizi Veri Madenciliği Nedir? yazımızda.
5. basamak: Sayfa JavaScript ile doluyorsa headless tarayıcı
Aynı sitenin yapımcıları bir de JavaScript ile dolan bir alıştırma sayfası sunuyor. Bu sayfayı Requests ile indirip içinde alıntı kutularını aradığımızda sonuç sıfır çıktı: kutular HTML'de yok, tarayıcı betiği çalıştırdıktan sonra oluşuyor. İkinci ve dördüncü basamağın tıkandığı yer tam olarak burasıdır.
Headless tarayıcı, penceresi olmayan gerçek bir tarayıcıdır. Sayfayı açar, JavaScript'i çalıştırır, siz de oluşan sayfadan veriyi okursunuz. Playwright ile aynı sayfa şöyle okunur (pip install playwright ve playwright install chromium sonrasında):
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch()
    page = browser.new_page()
    page.goto("https://quotes.toscrape.com/js/")
    page.wait_for_selector("div.quote")          # öğe görünene kadar bekle
    for quote in page.locator("div.quote").all():
        text = quote.locator("span.text").inner_text()
        author = quote.locator("small.author").inner_text()
        print(author, "-", text[:60])
    browser.close()
Bu basamağın bedeli kaynaktır: her sayfa için bir tarayıcı sekmesi açılır, görseller ve betikler indirilir. Bu yüzden headless tarayıcı son basamaktır. Çoğu dinamik sayfada verinin geldiği JSON adresini bulmak daha ucuz bir çözümdür; ikisi arasındaki kararı ve bekleme stratejilerini Statik ve Dinamik Sayfalar yazımızda, tarayıcıya proxy tanımlamayı Playwright ve proxy yazımızda bulursunuz.
Proxy hangi basamakta devreye girer?
İlk üç basamakta proxy çoğunlukla konu dışıdır. E-Tablolar formülü Google'ın sunucusundan çıkar, araya sizin bir şey koymanız mümkün değildir. Excel ve tarayıcı eklentisi bilgisayarınızın kendi bağlantısını kullanır; birkaç sayfalık bir iş için başka bir şeye ihtiyaç da yoktur.
Proxy, dördüncü ve beşinci basamakta, üç somut durumda gündeme gelir:
- İçerik ülkeye göre değişiyorsa. Bir mağaza Almanya'dan bakana başka, Türkiye'den bakana başka fiyat gösteriyorsa doğru veriyi ancak o ülkeden çıkan bir bağlantı görür. Konum hedefli Residential Proxy bu iş içindir; GB başına faturalanır, güncel taban fiyat ₺74.
- İş büyüdüyse. Binlerce sayfayı makul bir sürede ve hedef siteyi yormadan almak, isteklerin tek bir adrese yığılmaması demektir. Rotating Proxy yükü havuza dağıtır. Mekanizmayı IP Rotasyonu Nedir? yazımızda anlattık.
- Oturum gerekiyorsa. Kendi hesabınızla giriş yapıp birkaç sayfa gezecekseniz oturum boyunca aynı IP'de kalmak gerekir; bunun için Sticky Proxy kullanılır.
Proxy'nin yapmadığı şeyi de söylemek gerekir. Hız sınırı bir sitenin "bu kadar yeter" deme biçimidir ve IP değiştirerek aşılacak bir engel değil, uyulacak bir sinyaldir; 429 yanıtının anlamını 429 Too Many Requests yazımızda açtık. Engellenme nedenlerinin teşhis listesi Engellenmeden Veri Toplama Yöntemleri yazımızda.
Betikte proxy kullanmak için kodu değiştirmeniz gerekmez. PROXY_URL değişkenine http://user:pass@pr.proxynet.io:8000 biçiminde bir adres verdiğinizde bütün istekler oradan geçer. Örneği yerel bir test proxy'siyle denedik: doğru kimlik bilgisiyle sayfalar geldi, yanlış parolayla Requests 407 Proxy Authentication Required içeren bir ProxyError fırlattı. Requests ayrıca HTTPS_PROXY ortam değişkenini kendiliğinden okur; bu değişkenlerin ayrıntısı wget ile Proxy Kullanımı yazımızda.
Kullanım alanları
- Fiyat ve stok takibi: Kendi ürünlerinizin pazardaki konumunu izlemek için rakip sayfalarındaki herkese açık fiyatların düzenli toplanması. Çözümün kurgusu fiyat takibi sayfamızda.
- Pazar araştırması: Bir kategorideki ürün sayısı, fiyat aralığı ve marka dağılımı gibi toplu göstergeler. Ayrıntı pazar araştırması sayfamızda.
- Katalog ve içerik denetimi: Kendi sitenizdeki binlerce sayfada eksik açıklama, kırık bağlantı ya da yanlış fiyat aramak. Kendi sitenizde izin sorunu yoktur; ilk denemeler için de en güvenli hedef orasıdır.
Sık yapılan hatalar
- API'ye bakmadan sayfayı ayrıştırmak. Resmî kaynak varken HTML ile uğraşmak, tasarım her değiştiğinde bozulan bir iş üretir.
- Merdivene en üstten başlamak. Düz bir HTML tablosu için headless tarayıcı kurmak işi yavaşlatır ve bakımını zorlaştırır.
- Boş sonucu veri sanmak. Seçici tutmadığında araçların çoğu hata vermez, boş sütun verir. Her çalıştırmada satır sayısını kontrol edin.
- Beklemesiz döngü yazmak. Saniyede onlarca istek gönderen bir betik önce
429, sonra kalıcı bir engel alır ve küçük bir siteyi gerçekten yavaşlatabilir. - Kişisel veriyi "açıkta duruyor" diye toplamak. Yorum yazarlarının adları, ilan sahiplerinin telefonları kişisel veridir. Fiyat ve ürün bilgisiyle yetinin.
Karar rehberi
| İhtiyaç | Yöntem |
|---|---|
| Sitenin API'si ya da "CSV indir" düğmesi var | Onu kullanın, veri çekmeyin |
| Tek sayfada düzgün bir tablo, veri Excel'de işlenecek | Excel, Veri > Web'den |
| Kart düzeninde birkaç yüz satır, tek seferlik | Tarayıcı eklentisi ya da IMPORTXML |
| Onlarca sayfa, zamanlanmış çalışma, kendi dosya biçiminiz | Python, Requests ve BeautifulSoup |
| Yüzlerce ya da binlerce sayfa, düzenli tarama | Scrapy ve yükü dağıtan rotating proxy |
| İçerik ancak tarayıcıda oluşuyor ve JSON adresi bulunamıyor | Headless tarayıcı (Playwright) |
| Veri ülkeye göre değişiyor | Python ya da Playwright ile konum hedefli residential proxy |
| Veri giriş arkasında ve hesap sizin değil | Çekmeyin; site sahibinden izin ya da API isteyin |
Sıkça sorulan sorular
Kod yazmadan web sitesinden veri çekilir mi?
Evet. Sayfada HTML tablosu varsa Excel'in Web'den özelliği ve E-Tablolar'ın IMPORTHTML formülü, kart düzenindeki sayfalarda tarayıcı eklentileri ve kodsuz araçlar bu işi yapar. Yüzlerce sayfa, her gün tekrar ve hata denetimi gerektiğinde kod yazmak daha az zahmetli hale gelir.
Ücretsiz veri çekme programı var mı?
Excel'iniz ya da bir Google hesabınız varsa ilk iki basamak ek ücret gerektirmez. Python ve yazıda adı geçen kütüphaneler açık kaynaklıdır. Kodsuz araçların çoğu ücretsiz bir katman sunar; sınırlarını aracın kendi sayfasından kontrol edin. Kaynağı belirsiz "program indir" bağlantılarından uzak durun; eklentiyi tarayıcınızın resmî mağazasından kurun.
Web sitesinden veri çekmek yasal mı?
Herkese açık, kişisel olmayan veriyi makul bir hızda toplamak çoğu hukuk düzeninde tek başına yasak değildir; ama sitenin kullanım şartları, telif hakkı ve kişisel verilerde KVKK sonucu değiştirir. Bu yazı hukuki tavsiye değildir. Çerçeveyi Web Scraping Yasal mı? yazımızda anlattık; ticari bir projede bir hukukçuya danışın.
Excel sayfadaki veriyi neden görmüyor?
En sık neden, verinin HTML tablosu olarak değil kart ya da liste olarak kurulmuş olmasıdır; Gezgin aradığınız tabloyu önermeyebilir. İkinci neden sayfanın giriş istemesi, üçüncüsü içeriğin JavaScript ile sonradan yüklenmesidir. İlk durumda IMPORTXML ya da bir tarayıcı eklentisi, diğerlerinde Python basamakları çözümdür.
Veri çekmek için Python öğrenmek şart mı?
Değil. Yöntem dilden bağımsızdır: istek gönder, HTML'i ayrıştır, alanı seç, kaydet. Ekibiniz hangi dili biliyorsa onunla başlayın. İki popüler dilin karşılaştırması JavaScript mi Python mu? yazımızda.
Veri çekerken ne zaman proxy gerekir?
Tek ülkeden, birkaç yüz sayfalık, düşük hızlı bir işte gerekmez. İçerik ülkeye göre değişiyorsa, iş binlerce sayfaya çıktığı için yükü dağıtmak gerekiyorsa ya da giriş yapılan bir oturumda IP'nin sabit kalması isteniyorsa gerekir. Proxy, sitenin koyduğu hız sınırını yok saymanın aracı değildir.
Özetle
Web sitesinden veri çekmenin beş basamağı var ve doğru olan, işinizi gören en alttakidir. Önce API ya da indirme düğmesi arayın. Düzgün bir tablo için Excel ya da E-Tablolar, kart düzenindeki tek seferlik işler için eklenti ve kodsuz araçlar, tekrarlanan ve büyüyen işler için Python, yalnızca tarayıcıda oluşan içerik için headless tarayıcı kullanılır. Hangi basamakta olursanız olun yalnızca herkese açık veriyi, düşük hızda ve sitenin kurallarına uyarak toplayın. İş ülke hedeflemesi ya da yük dağıtımı gerektirecek kadar büyüdüğünde uygun proxy türlerini proxy hizmetlerimizde bulabilirsiniz.