Você quer levar para o seu próprio arquivo a lista de preços de um fornecedor, o nome e o preço de duzentos produtos de uma livraria online ou a tabela que um órgão público atualiza toda semana. A primeira ideia é copiar e colar. Com dez linhas funciona, com mil consome uma tarde inteira. Quem pesquisa "extrair dados de um site" procura sempre a mesma coisa: um jeito de não fazer esse trabalho à mão.
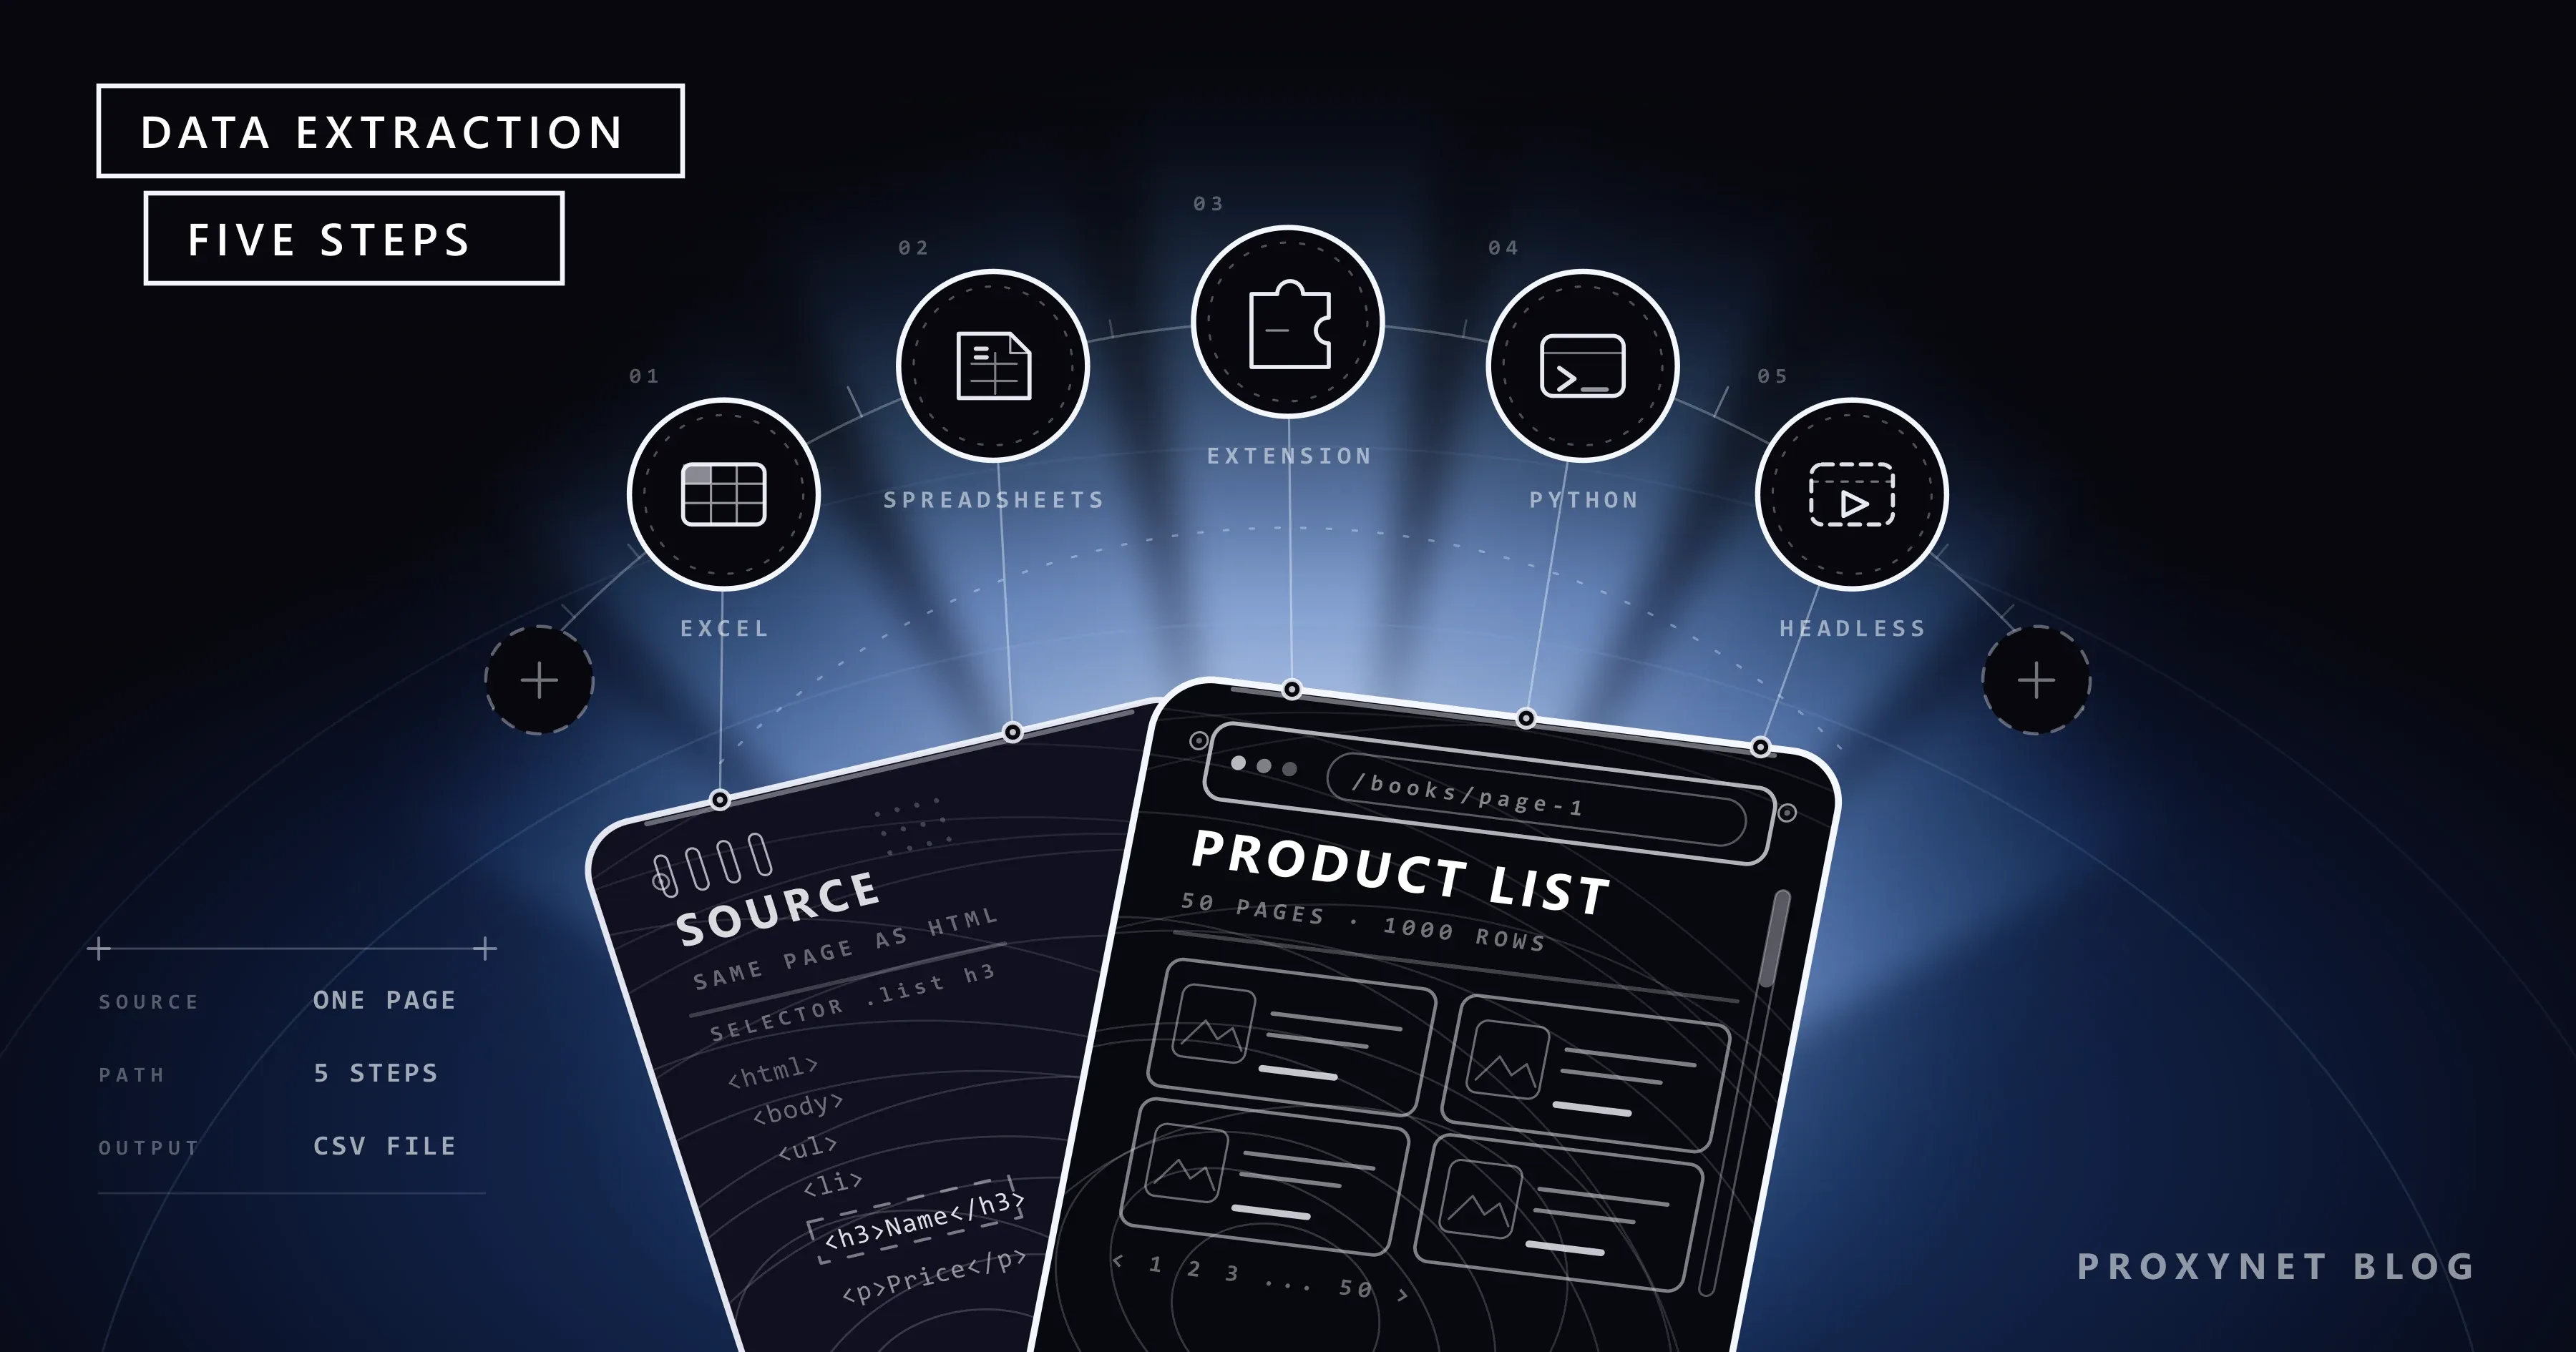
Não existe um caminho único, porque o método certo depende de quantas páginas você precisa, de como a página foi construída e de com que frequência a tarefa vai se repetir. Neste artigo organizamos os métodos como uma escada: o recurso Da Web do Excel, as fórmulas do Google Planilhas, extensões de navegador e ferramentas sem código, Python com Requests e BeautifulSoup e, no topo, o navegador headless. Em cada degrau explicamos para que ele basta, onde ele trava e em que degrau o proxy entra na história. Rodamos os exemplos em Python deste artigo em um site de treino.
O que significa extrair dados de um site?
Extrair dados de um site é transformar a informação organizada para o olho humano (nome do produto, preço, data, endereço) em um arquivo feito de linhas e colunas. O nome técnico é web scraping; no restante do artigo vamos dizer "scraping" ou "extração de dados". A definição em detalhe, e qual proxy se usa em cada tipo de trabalho, estão na nossa página da solução de extração de dados. Este artigo não trata da definição, e sim da escolha do método.
Vale separar logo de início três conceitos que costumam se confundir:
- Rastreamento (crawling): Descobrir quais páginas existem em um site, ou seja, montar a lista de endereços. É o que os buscadores fazem. Os detalhes estão na nossa página de web crawler.
- Extração (scraping): Retirar campos específicos de uma página cujo endereço você já conhece. O rastreamento entrega os endereços, a extração entrega a informação que está dentro deles.
- API: A porta oficial pela qual o site já entrega os dados de forma estruturada, quase sempre em JSON. Se existe API, não é preciso analisar a página.
Antes de extrair: existe uma API ou um botão de download?
A extração de dados mais barata é a que nem chega a ser feita. Antes de decidir o método, olhe nestes três lugares:
- API oficial. Marketplaces oferecem API aos vendedores, e órgãos públicos, aos pesquisadores. O Banco Central do Brasil, por exemplo, publica as cotações de câmbio e suas outras séries no Portal de Dados Abertos, tanto por uma interface quanto por um serviço web. Para uma tabela de câmbio, vá à própria fonte em vez de analisar um site de notícias.
- Botão de download. Há mais páginas do que parece com um link "Exportar para Excel" ou "Baixar CSV" embaixo da tabela. Os portais de dados dos institutos de estatística funcionam assim.
- A requisição de dados da própria página. Algumas páginas buscam o conteúdo em segundo plano em um endereço JSON. Mostramos passo a passo como encontrar esse endereço em Páginas estáticas e dinâmicas.
Se nada disso existir, parte-se para a extração, mas com quatro regras. Só se coletam dados públicos, que não exigem login. Leem-se o arquivo robots.txt do site e os termos de uso; sites de classificados, de placar esportivo e redes sociais cujos termos proíbem expressamente a coleta automatizada não são alvo dos métodos deste artigo. Nome, telefone e e-mail são dados pessoais cobertos pela LGPD, e o argumento "estava à vista na página" não muda isso; reunimos o quadro legal em Web scraping é legal?. A última regra é a velocidade: o site não pode ficar mais lento por sua causa.
Por isso todos os exemplos do artigo rodam em books.toscrape.com, um site montado para treinar scraping. O site se apresenta como "site de demonstração para fins de web scraping"; os preços e as avaliações são atribuídos ao acaso.
Como uma requisição vira dado?
Usando Excel ou escrevendo Python, os mesmos seis passos rodam por baixo. A diferença entre os métodos é quantos desses passos eles fazem por você.
- A requisição é enviada. A ferramenta manda uma requisição HTTP para o endereço da página, como um navegador faria.
- A resposta chega. O servidor devolve um código de status e o HTML da página. O que significam os códigos diferentes de
200está no nosso artigo sobre códigos de status HTTP. - O HTML é analisado. O texto puro vira uma árvore de tags aninhadas.
- Os campos são selecionados. Escreve-se uma regra do tipo "o título e o preço dentro de cada cartão de produto". A linguagem dessa regra é um seletor CSS ou XPath; comparamos os dois em Seletor CSS ou XPath.
- As linhas são salvas. Os campos selecionados vão para uma tabela, um arquivo CSV ou um banco de dados.
- Passa-se para a página seguinte. Se a lista ocupa várias páginas, os passos 1 a 5 se repetem em cada uma.
O Excel e o Planilhas fazem todos esses passos com um clique, mas têm opções limitadas no quarto. As ferramentas sem código deixam você descrever esse passo com o mouse. Em Python os seis passos ficam nas suas mãos.
Métodos de extração de dados lado a lado
| Degrau | Método | Precisa de código? | Quando basta? | Onde trava? |
|---|---|---|---|---|
| 1 | Excel, Dados > Da Web | Não | A página tem uma tabela HTML e os dados serão trabalhados no Excel | Páginas em layout de cartões, login por formulário, listas de muitas páginas |
| 2 | Google Planilhas, IMPORTHTML e IMPORTXML | Fórmula | Uma única página que deve ficar atualizada em uma planilha compartilhada | Conteúdo preenchido por JavaScript, página que exige login, fórmulas em grande número |
| 3 | Extensão de navegador ou ferramenta sem código | Não | Layout de cartões, algumas centenas de linhas, trabalho pontual | Repetição regular, grande volume, receitas que quebram quando o design do site muda |
| 4 | Python, Requests e BeautifulSoup | Sim | Dezenas ou milhares de páginas, execução agendada, seu próprio formato | Conteúdo preenchido depois por JavaScript |
| 5 | Navegador headless (Playwright) | Sim | O conteúdo só existe depois que o navegador o gera | Velocidade e recursos: roda um navegador de verdade para cada página |
Suba a escada de baixo para cima. Se um degrau inferior resolve o seu trabalho, subir para o próximo só traz manutenção a mais.
Degrau 1: obter dados de um site com o Excel
O Excel tem um recurso embutido para isso, e muita gente não conhece. Os passos da página de suporte da Microsoft são estes: na guia Dados, na seção "Obter e Transformar", seleciona-se Da Web, cola-se o endereço da página e confirma-se com OK. O Excel encontra as tabelas da página e as lista no painel Navegador. Quando você escolhe a tabela que quer e seleciona Carregar, os dados chegam à planilha. A conexão fica no arquivo; na semana seguinte você não repete os passos, apenas atualiza a consulta. A guia "Exibição da Web" do Navegador mostra a própria página e realça as tabelas detectadas.
Onde ele trava também é claro. O recurso funciona melhor com tabelas construídas de fato com a tag <table> no HTML. A página inicial do nosso site de treino não tem uma única tag de tabela, os livros estão dispostos em cartões; em páginas assim o Navegador pode não sugerir a tabela que você procura, e sobra o botão "Adicionar tabela usando exemplos" (em inglês, "Add table using examples"), em que você descreve as colunas digitando valores de amostra. Segundo a documentação do conector no Microsoft Learn, os tipos de autenticação aceitos são anônimo, Windows, básico (nome de usuário e senha), chave de API Web e conta organizacional. Preencher um formulário de login e entrar não está nessa lista. Percorrer página por página uma lista de cinquenta páginas até é possível no Excel, mas não é prático; nesse ponto passa-se para o quarto degrau.
Degrau 2: IMPORTHTML e IMPORTXML no Google Planilhas
O Google Planilhas faz o mesmo trabalho com fórmula. IMPORTHTML despeja nas células uma tabela ou uma lista de uma página, e IMPORTXML, qualquer elemento que você descreva com XPath. Em uma planilha com a localidade Brasil, os argumentos são separados por ponto e vírgula:
=IMPORTHTML("https://en.wikipedia.org/wiki/Demographics_of_India"; "table"; 4)
=IMPORTXML("https://books.toscrape.com/"; "//article[@class='product_pod']/h3/a/@title")
A primeira fórmula é o exemplo da própria documentação do Google: ela traz a quarta tabela da página, e a contagem começa em 1. Na documentação em inglês, os valores aceitos pelo segundo argumento são "table" e "list"; no exemplo da página de ajuda em português essa palavra aparece traduzida, então, se a fórmula der erro, este é o primeiro lugar para olhar. Testamos a expressão XPath da segunda fórmula no HTML do site de treino; ela devolve os títulos dos vinte livros da página inicial. É por isso que, em uma página com layout de cartões, descrever o elemento com XPath funciona melhor do que procurar uma tabela.
Este degrau tem três limites. A fórmula roda nos servidores do Google, a requisição não sai do seu computador. Por isso ela não enxerga uma página em que você fez login, um painel da rede da sua empresa nem a sessão do seu navegador. A fórmula lê o HTML bruto da página; se o conteúdo é preenchido depois por JavaScript, a célula recebe um resultado vazio ou um erro. O terceiro limite é a escala: não é você quem decide quando as fórmulas são atualizadas, e colocar centenas de fórmulas de importação em um arquivo deixa a planilha pesada. Serve para uma tabela de uma página só, acompanhada por uma equipe, não para um catálogo de mil produtos.
Degrau 3: programas de extração de dados e extensões de navegador
As ferramentas que aparecem quando você pesquisa "programa para extrair dados" ou "web scraping sem programar" se dividem em três grupos:
- Extensões de navegador. Na página aberta você clica em um cartão de produto, depois no título e no preço; a extensão encontra todos os cartões com o mesmo padrão e baixa tudo como arquivo CSV ou Excel. Como a requisição sai do seu navegador, a extensão vê a página do mesmo jeito que você vê.
- Ferramentas sem código, de desktop e na nuvem. Acrescentam paginação, agendamento e execução na nuvem à mesma lógica de descrever clicando. A maioria tem um plano gratuito; confira os limites na página de preços da própria ferramenta.
- Ferramentas de fluxo de trabalho. Transformam a extração em um elo de uma corrente: busque a página, separe o campo, grave na planilha, avise se houver mudança. Montamos um exemplo desse grupo no nosso artigo sobre web scraping com n8n.
Em trabalhos pontuais de algumas centenas de linhas, essas ferramentas dão resultado mais rápido do que Python. Onde elas travam aparece com o tempo. A receita é gravada de acordo com o design que a página tinha naquele dia; quando o site muda o nome de uma classe, a ferramenta produz em silêncio uma coluna vazia, e perceber isso fica por sua conta. Nas ferramentas que rodam na nuvem, os dados coletados e os dados de conta que você tenha informado passam pelos servidores de uma terceira empresa; leve isso em conta na hora de escolher.
Degrau 4: extrair dados de um site com Python
A dupla mais comum em Python são as bibliotecas Requests e BeautifulSoup. O Requests baixa a página, o BeautifulSoup analisa o HTML e deixa você selecionar campos com seletores CSS. A instalação é uma linha:
pip install requests beautifulsoup4O script abaixo percorre as três primeiras páginas do site de treino, coleta o título, o preço, a disponibilidade e o endereço de cada livro e grava o resultado em um arquivo CSV que o Excel abre direto. Quando rodamos com Python 3.13, ele gerou sem problemas o arquivo com 60 livros.
import csv
import os
import time
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup

START_URL = "https://books.toscrape.com/"
MAX_PAGES = 3          # três páginas bastam para treinar
DELAY = 2              # segundos entre duas requisições

# Se precisar de proxy: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")

session = requests.Session()
session.headers["User-Agent"] = "teste-preco-livros/1.0 (contato: voce@example.com)"
if proxy:
    session.proxies = {"http": proxy, "https": proxy}

rows = []
url = START_URL
for page in range(MAX_PAGES):
    response = session.get(url, timeout=20)
    response.raise_for_status()
    response.encoding = "utf-8"
    soup = BeautifulSoup(response.text, "html.parser")

    for card in soup.select("article.product_pod"):
        rows.append({
            "titulo": card.select_one("h3 a")["title"],
            "preco": card.select_one("p.price_color").get_text(strip=True),
            "estoque": card.select_one("p.instock").get_text(strip=True),
            "endereco": urljoin(url, card.select_one("h3 a")["href"]),
        })

    next_link = soup.select_one("li.next a")
    if next_link is None:
        break
    url = urljoin(url, next_link["href"])
    time.sleep(DELAY)

if not rows:
    raise SystemExit("Nenhum produto encontrado: os seletores mudaram ou a página é preenchida por JavaScript.")

# utf-8-sig: o Excel mostra os acentos corretamente ao abrir o arquivo
with open("livros.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(f, fieldnames=rows[0].keys())
    writer.writeheader()
    writer.writerows(rows)

print(f"{len(rows)} linhas gravadas em livros.csv")
O script traz quatro decisões que as ferramentas sem código não deixam com você. A linha User-Agent diz quem você é e como falar com você; use um nome de bot honesto em vez de uma identidade de navegador falsa. DELAY coloca uma espera entre duas requisições. raise_for_status() interrompe o script diante de um código de erro, e assim o conteúdo de uma página bloqueada não vai parar no seu arquivo como se fosse dado. A verificação if not rows no final é o remédio para o problema da coluna vazia e silenciosa do terceiro degrau: se o seletor não casa, o script avisa em voz alta.
Daqui em diante o caminho se ramifica conforme o tamanho do trabalho. Para uma fila de rastreamento capaz de retomar cinquenta páginas de onde parou, veja nosso artigo sobre como percorrer listas paginadas; para páginas que exigem login com a sua própria conta, sessão e cookies em Python; para trabalhos regulares de centenas de páginas, Scrapy. Se a sua equipe não escreve Python, dá para montar a mesma lógica com PHP, com C# ou com JavaScript; o método não depende da linguagem.
No armazenamento, um CSV basta para um trabalho pontual. Se o trabalho se repete, um arquivo sobrescrito perde o histórico de mudanças; a montagem que acrescenta a data a cada linha e grava em SQLite está no nosso artigo sobre monitoramento de preços da concorrência, e a análise dos dados coletados, em Mineração de dados.
Degrau 5: navegador headless quando a página é preenchida por JavaScript
Os autores do mesmo site também oferecem uma página de treino preenchida por JavaScript. Quando baixamos essa página com o Requests e procuramos nela as caixas de citação, o resultado foi zero: as caixas não estão no HTML, elas surgem depois que o navegador executa o script. É exatamente aqui que o segundo e o quarto degraus travam.
Um navegador headless é um navegador de verdade, sem janela. Ele abre a página, executa o JavaScript, e você lê os dados da página já montada. Com o Playwright, a mesma página é lida assim (depois de pip install playwright e playwright install chromium):
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch()
    page = browser.new_page()
    page.goto("https://quotes.toscrape.com/js/")
    page.wait_for_selector("div.quote")          # espera o elemento aparecer
    for quote in page.locator("div.quote").all():
        text = quote.locator("span.text").inner_text()
        author = quote.locator("small.author").inner_text()
        print(author, "-", text[:60])
    browser.close()
O preço deste degrau são os recursos: para cada página abre-se uma aba de navegador, e imagens e scripts são baixados. Por isso o navegador headless é o último degrau. Na maioria das páginas dinâmicas sai mais barato encontrar o endereço JSON de onde os dados vêm; a decisão entre os dois caminhos e as estratégias de espera estão em Páginas estáticas e dinâmicas, e como configurar um proxy no navegador, no nosso artigo sobre Playwright e proxy.
Em que degrau o proxy entra?
Nos três primeiros degraus o proxy quase nunca vem ao caso. A fórmula do Planilhas sai do servidor do Google, e você não tem como colocar nada no meio. O Excel e a extensão de navegador usam a conexão do seu próprio computador; para um trabalho de poucas páginas também não é preciso mais nada.
O proxy aparece no quarto e no quinto degraus, em três situações concretas:
- O conteúdo muda conforme o país. Se uma loja mostra um preço para quem acessa da Alemanha e outro para quem acessa da Türkiye, só uma conexão que sai daquele país enxerga o dado certo. Os Proxies residenciais com segmentação por localização servem para isso; a cobrança é por GB e o preço base atual é R$ 7,8.
- O trabalho cresceu. Buscar milhares de páginas em um tempo razoável e sem sobrecarregar o site de destino significa não amontoar as requisições em um único endereço. Os Proxies rotativos distribuem a carga em um pool. Explicamos o mecanismo no nosso artigo sobre rotação de IP.
- É preciso manter uma sessão. Se você vai fazer login com a sua própria conta e percorrer algumas páginas, precisa ficar no mesmo IP durante toda a sessão; para isso se usam os Proxies de sessão fixa.
Também é preciso dizer o que o proxy não faz. O limite de taxa é o jeito de um site dizer "já chega", e não é um obstáculo a vencer trocando de IP, e sim um sinal a respeitar; detalhamos o significado da resposta 429 em 429 Too Many Requests. A lista de diagnóstico das causas de bloqueio está em Como fazer web scraping sem ser bloqueado.
Para usar um proxy no script você não precisa mexer no código. Quando a variável PROXY_URL recebe um endereço no formato http://user:pass@pr.proxynet.io:8000, todas as requisições passam por ele. Testamos o exemplo com um proxy de teste local: com as credenciais certas as páginas chegaram, com a senha errada o Requests lançou um ProxyError com 407 Proxy Authentication Required. O Requests também lê sozinho a variável de ambiente HTTPS_PROXY; os detalhes dessas variáveis estão em Uso de proxy com o wget.
Casos de uso
- Monitoramento de preços e estoque: Coletar com regularidade os preços públicos das páginas da concorrência para acompanhar a posição dos seus próprios produtos no mercado. O desenho da solução está na nossa página de monitoramento de preços.
- Pesquisa de mercado: Indicadores agregados como o número de produtos de uma categoria, a faixa de preços e a distribuição por marca. Os detalhes estão na nossa página de pesquisa de mercado.
- Auditoria de catálogo e conteúdo: Procurar descrições faltando, links quebrados ou preços errados nas milhares de páginas do seu próprio site. No seu site não existe questão de permissão, e ele é também o alvo mais seguro para as primeiras tentativas.
Erros comuns
- Analisar a página sem olhar se há API. Brigar com o HTML quando existe uma fonte oficial gera um trabalho que quebra a cada mudança de design.
- Começar a escada pelo topo. Montar um navegador headless para uma tabela HTML simples deixa o trabalho mais lento e mais difícil de manter.
- Tomar resultado vazio por dado. Quando o seletor não casa, a maioria das ferramentas não dá erro, dá uma coluna vazia. Confira o número de linhas a cada execução.
- Escrever um laço sem espera. Um script que manda dezenas de requisições por segundo recebe primeiro um
429, depois um bloqueio duradouro, e pode mesmo deixar um site pequeno mais lento. - Coletar dados pessoais porque "estão à vista". Os nomes de quem escreve avaliações e os telefones dos anunciantes são dados pessoais. Fique com as informações de preço e de produto.
Guia de decisão
| Necessidade | Método |
|---|---|
| O site tem uma API ou um botão "Baixar CSV" | Use isso, não extraia |
| Uma tabela bem montada em uma única página, dados trabalhados no Excel | Excel, Dados > Da Web |
| Algumas centenas de linhas em layout de cartões, uma vez só | Extensão de navegador ou IMPORTXML |
| Dezenas de páginas, execução agendada, seu próprio formato de arquivo | Python, Requests e BeautifulSoup |
| Centenas ou milhares de páginas, rastreamento regular | Scrapy e proxies rotativos que distribuem a carga |
| O conteúdo só é gerado no navegador e o endereço JSON não aparece | Navegador headless (Playwright) |
| Os dados mudam conforme o país | Python ou Playwright com proxies residenciais segmentados por localização |
| Os dados estão atrás de um login e a conta não é sua | Não extraia; peça permissão ou uma API ao dono do site |
Perguntas frequentes
Dá para extrair dados de um site sem programar?
Sim. Se a página tem uma tabela HTML, o recurso Da Web do Excel e a fórmula IMPORTHTML do Planilhas fazem o trabalho; em páginas com layout de cartões, extensões de navegador e ferramentas sem código. Quando entram centenas de páginas, repetição diária e controle de erros, escrever código passa a dar menos trabalho.
Existe programa gratuito para extrair dados?
Se você tem o Excel ou uma conta do Google, os dois primeiros degraus não têm custo adicional. O Python e as bibliotecas citadas no artigo são de código aberto. A maioria das ferramentas sem código oferece um plano gratuito; confira os limites na página da própria ferramenta. Fique longe de links de "baixar programa" de origem duvidosa; instale a extensão pela loja oficial do seu navegador.
Extrair dados de um site é legal?
Coletar dados públicos e não pessoais em uma velocidade razoável não é proibido por si só na maioria dos ordenamentos jurídicos; mas os termos de uso do site, os direitos autorais e, nos dados pessoais, a LGPD mudam o resultado. Este artigo não é aconselhamento jurídico. Explicamos o quadro em Web scraping é legal?; em um projeto comercial, consulte um advogado.
Por que o Excel não enxerga os dados da página?
A causa mais comum é os dados não estarem montados como tabela HTML, e sim como cartões ou lista; o Navegador pode não sugerir a tabela que você procura. A segunda causa é a página pedir login, e a terceira, o conteúdo ser carregado depois por JavaScript. No primeiro caso a solução é IMPORTXML ou uma extensão de navegador; nos outros, os degraus de Python.
É obrigatório aprender Python para extrair dados?
Não. O método não depende da linguagem: envie a requisição, analise o HTML, selecione o campo, salve. Comece com a linguagem que a sua equipe já conhece. A comparação entre duas linguagens populares está em Extração de dados: JavaScript ou Python?.
Quando é preciso usar proxy para extrair dados?
Em um trabalho lento, de algumas centenas de páginas e a partir de um único país, não é preciso. É preciso quando o conteúdo muda conforme o país, quando o trabalho cresceu para milhares de páginas e a carga tem de ser distribuída, ou quando o IP precisa ficar fixo durante uma sessão com login. O proxy não é uma ferramenta para ignorar o limite de taxa que o site definiu.
Em resumo
Extrair dados de um site tem cinco degraus, e o certo é o mais baixo que resolve o seu trabalho. Procure primeiro uma API ou um botão de download. Para uma tabela bem montada usam-se o Excel ou o Planilhas; para trabalhos pontuais em layout de cartões, extensões e ferramentas sem código; para trabalhos que se repetem e crescem, Python; e só para o conteúdo gerado no navegador, o navegador headless. Em qualquer degrau, colete apenas dados públicos, em baixa velocidade e respeitando as regras do site. Quando o trabalho crescer a ponto de exigir segmentação por país ou distribuição de carga, você encontra os tipos de proxy adequados nos nossos serviços de proxy.