Sie möchten die Preisliste eines Lieferanten, Namen und Preise von zweihundert Produkten eines Buchshops oder die Tabelle, die eine Behörde jede Woche aktualisiert, in Ihre eigene Datei holen. Der erste Gedanke ist Kopieren und Einfügen. Bei zehn Zeilen funktioniert das, bei tausend kostet es einen Nachmittag. Wer nach „Daten von Website extrahieren" sucht, will immer dasselbe: diese Arbeit nicht von Hand erledigen.
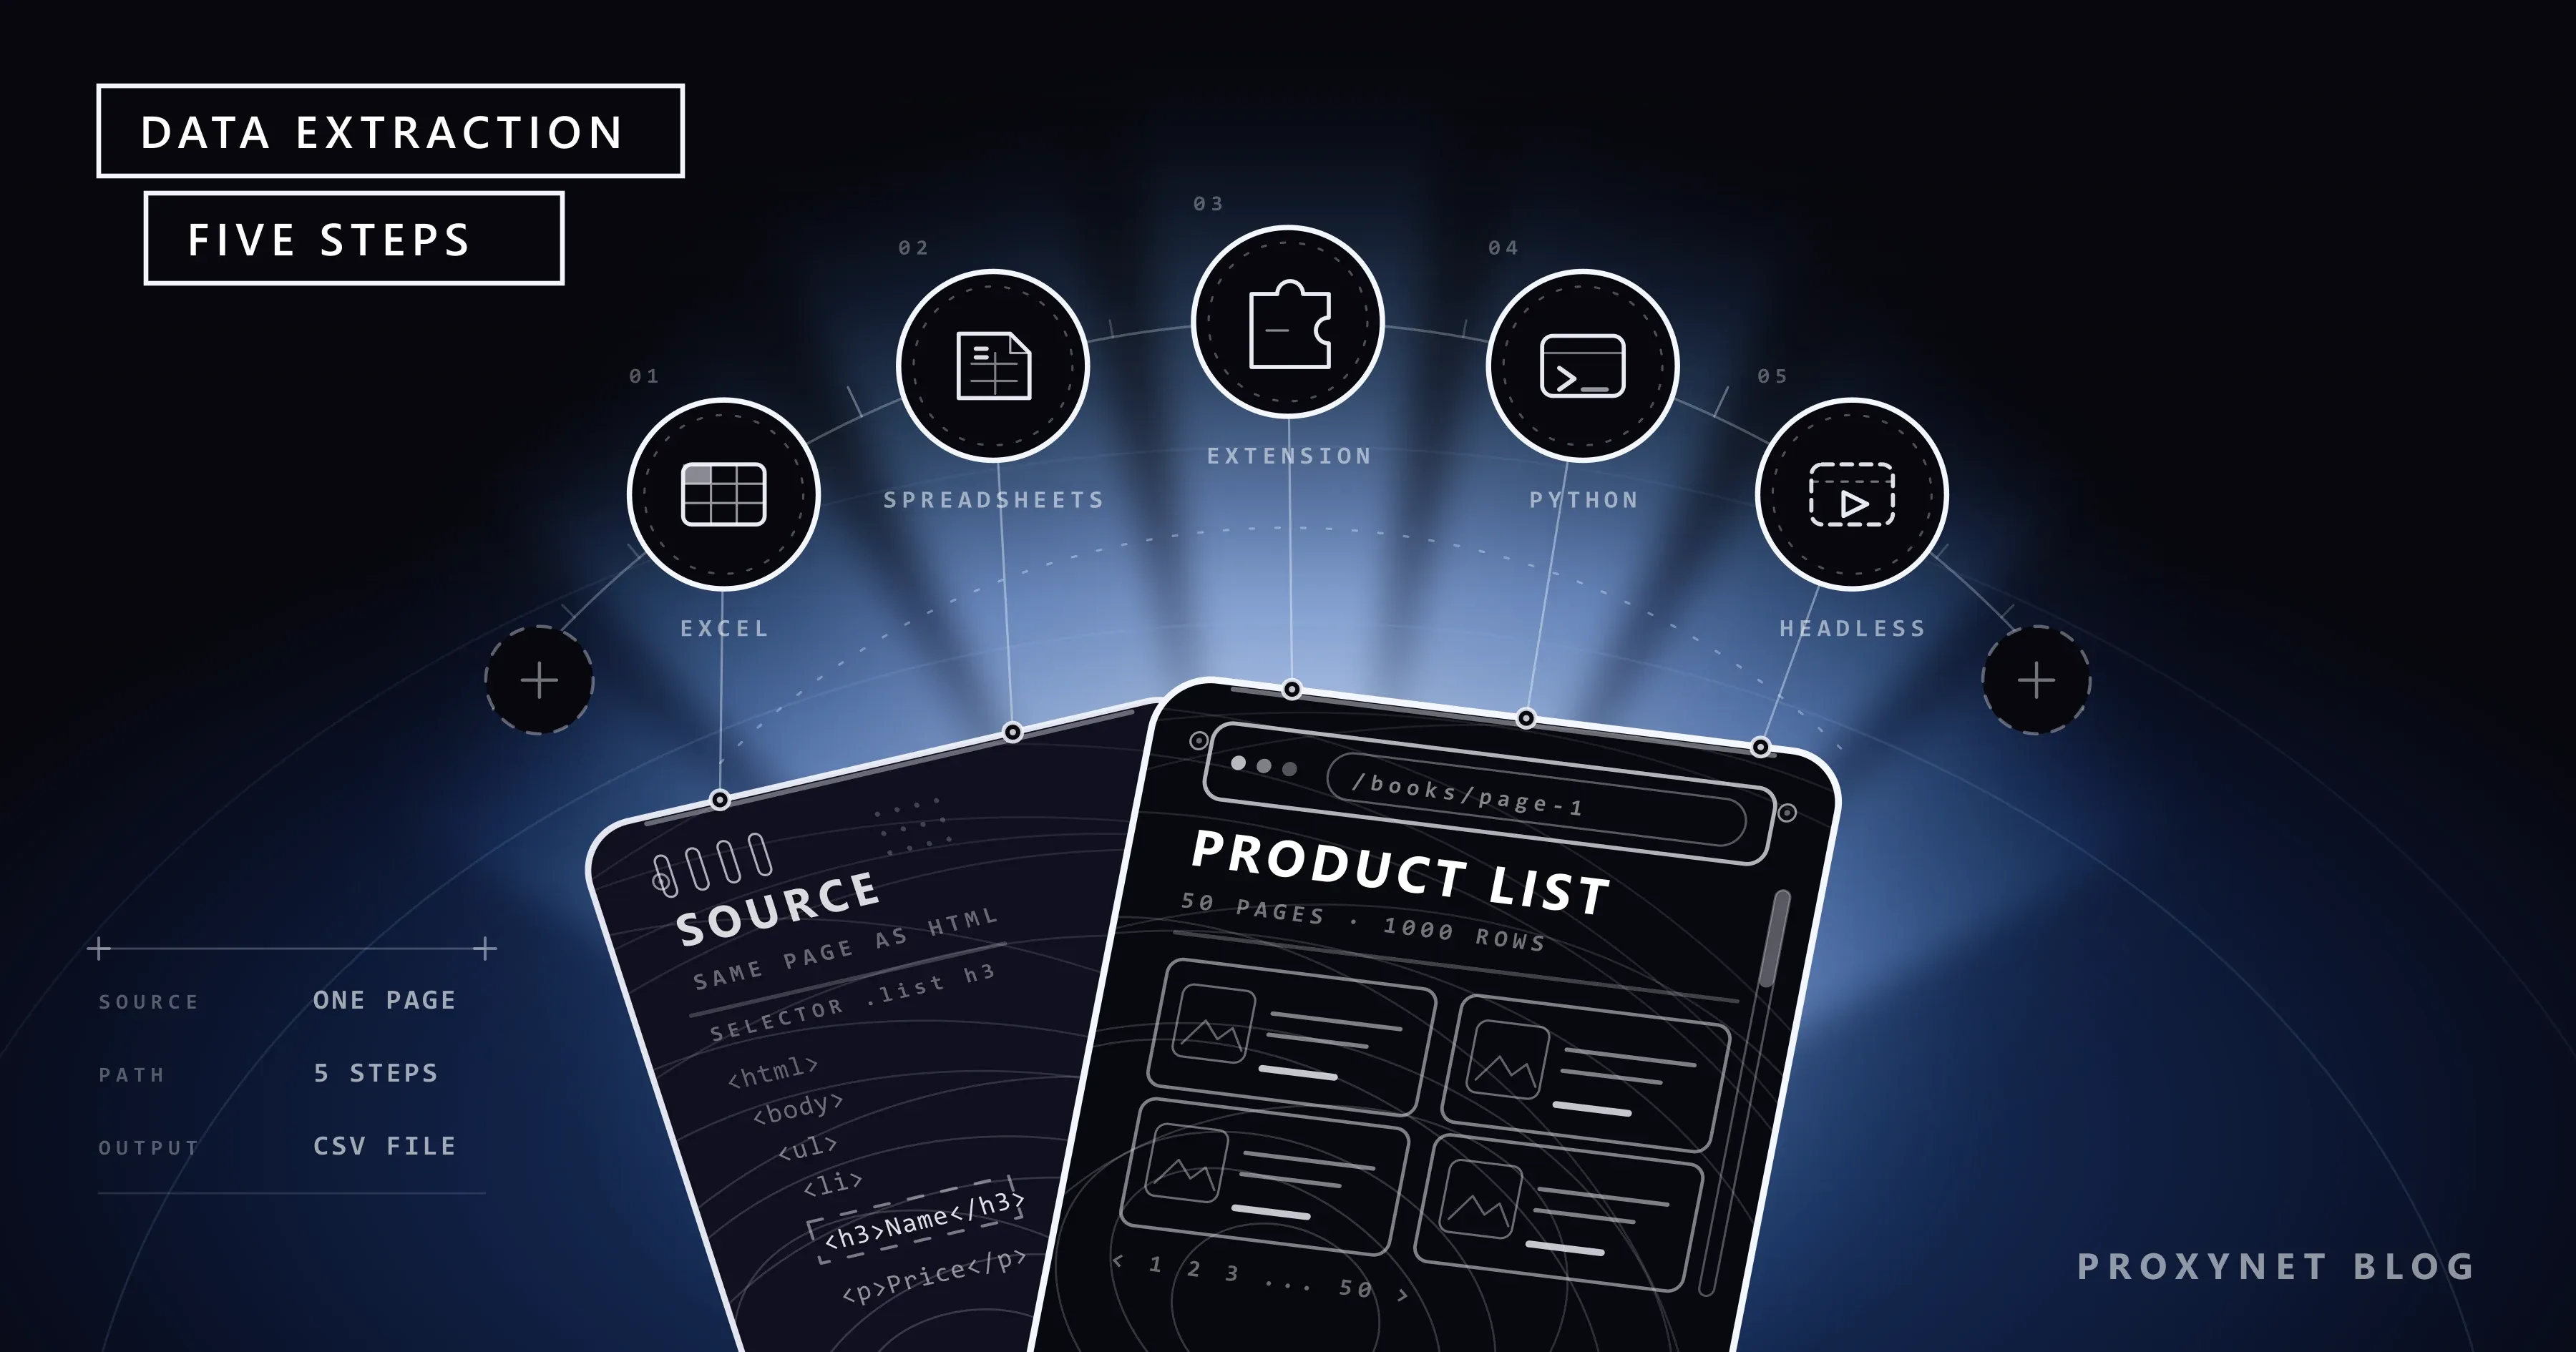
Den einen Weg gibt es nicht, denn die passende Methode hängt davon ab, wie viele Seiten Sie brauchen, wie die Seite aufgebaut ist und wie oft Sie die Aufgabe wiederholen. In diesem Beitrag ordnen wir die Methoden wie eine Leiter: die Excel-Funktion „Aus dem Web", Formeln in Google Tabellen, Browsererweiterungen und No-Code-Tools, Python mit Requests und BeautifulSoup und ganz oben der Headless-Browser. Zu jeder Stufe erklären wir, wofür sie reicht, wo sie hängen bleibt und auf welcher Stufe ein Proxy ins Spiel kommt. Die Python-Beispiele in diesem Beitrag haben wir auf einer Übungsseite ausgeführt.
Was bedeutet es, Daten von einer Website zu extrahieren?
Daten von einer Website zu extrahieren heißt, Informationen, die für das menschliche Auge angeordnet sind (Produktname, Preis, Datum, Adresse), in eine Datei aus Zeilen und Spalten zu überführen. Der Fachbegriff lautet Web Scraping; im weiteren Text sprechen wir kurz von „Scraping" oder „Datenextraktion". Die Definition im Detail und welcher Proxy zu welcher Art von Aufgabe passt, haben wir auf unserer Seite zur Data-Scraping-Lösung beschrieben. In diesem Beitrag geht es nicht um die Definition, sondern um die Wahl der Methode.
Drei Begriffe, die oft verwechselt werden, trennen wir gleich zu Beginn:
- Crawling: Herausfinden, welche Seiten es auf einer Website gibt, also die Adressliste erstellen. Das ist die Arbeit der Suchmaschinen. Details finden Sie auf unserer Seite Web Crawler.
- Scraping: Bestimmte Felder aus einer Seite herauslösen, deren Adresse bekannt ist. Crawling liefert die Adressen, Scraping die Informationen darin.
- API: Der offizielle Zugang, über den die Website ihre Daten bereits strukturiert bereitstellt, meist als JSON. Gibt es eine API, muss die Seite nicht geparst werden.
Vor dem Extrahieren: Gibt es eine API oder eine Download-Schaltfläche?
Die günstigste Datenextraktion ist die, die gar nicht stattfindet. Bevor Sie sich für eine Methode entscheiden, sehen Sie an diesen drei Stellen nach:
- Offizielle API. Marktplätze bieten ihren Händlern APIs an, öffentliche Einrichtungen den Forschenden. Die Europäische Zentralbank zum Beispiel stellt die Euro-Referenzkurse und ihre übrigen Reihen im ECB Data Portal sowohl über eine Oberfläche als auch über einen Webservice bereit. Für eine Kurstabelle gehen Sie zur Quelle selbst, statt eine Nachrichtenseite zu parsen.
- Download-Schaltfläche. Mehr Seiten als gedacht haben unter der Tabelle einen Link „Nach Excel exportieren" oder „CSV herunterladen". Die Datenportale der Statistikämter funktionieren so.
- Die eigene Datenanfrage der Seite. Manche Seiten holen ihren Inhalt im Hintergrund von einer JSON-Adresse. Wie Sie diese Adresse finden, zeigen wir Schritt für Schritt im Beitrag Statische und dynamische Seiten.
Gibt es nichts davon, beginnt die Datenextraktion, allerdings mit vier Regeln. Erfasst werden nur öffentlich zugängliche Daten, die keine Anmeldung verlangen. Die robots.txt und die Nutzungsbedingungen der Website werden gelesen; Kleinanzeigen-, Live-Score- und Social-Media-Seiten, deren Bedingungen das automatisierte Erfassen ausdrücklich verbieten, sind kein Ziel für die Methoden in diesem Beitrag. Namen, Telefonnummern und E-Mail-Adressen sind personenbezogene Daten im Sinne der DSGVO, und das Argument „es stand offen auf der Seite" ändert daran nichts; den rechtlichen Rahmen haben wir in Ist Web Scraping legal? zusammengefasst. Die letzte Regel ist das Tempo: Die Website darf Ihretwegen nicht langsamer werden.
Deshalb laufen alle Beispiele in diesem Beitrag auf books.toscrape.com, einer Seite, die für Scraping-Übungen gebaut wurde. Sie stellt sich selbst als „Demo-Website für Web-Scraping-Zwecke" vor; Preise und Bewertungen sind zufällig vergeben.
Wie wird aus einer Anfrage ein Datensatz?
Ob Sie Excel verwenden oder Python schreiben, im Hintergrund laufen dieselben sechs Schritte ab. Die Methoden unterscheiden sich darin, wie viele dieser Schritte sie Ihnen abnehmen.
- Die Anfrage wird gesendet. Das Werkzeug schickt eine HTTP-Anfrage an die Adresse der Seite, so wie es ein Browser tut.
- Die Antwort trifft ein. Der Server liefert einen Statuscode und das HTML der Seite. Was andere Codes als
200bedeuten, steht in unserem Beitrag zu den HTTP-Statuscodes. - Das HTML wird geparst. Aus reinem Text wird ein Baum aus verschachtelten Tags.
- Die Felder werden ausgewählt. Sie schreiben eine Regel wie „Titel und Preis in jeder Produktkarte". Die Sprache dieser Regel ist ein CSS-Selektor oder XPath; die Unterschiede haben wir in CSS-Selektor oder XPath verglichen.
- Die Zeilen werden gespeichert. Die ausgewählten Felder landen in einer Tabelle, einer CSV-Datei oder einer Datenbank.
- Die nächste Seite wird geöffnet. Verteilt sich die Liste auf mehrere Seiten, wiederholen sich die Schritte 1 bis 5 für jede Seite.
Excel und Google Tabellen erledigen alle diese Schritte mit einem Klick, haben beim vierten Schritt aber nur begrenzte Möglichkeiten. No-Code-Tools lassen Sie diesen Schritt mit der Maus beschreiben. In Python liegen alle sechs Schritte in Ihrer Hand.
Methoden der Datenextraktion im Vergleich
| Stufe | Methode | Code nötig? | Wann reicht sie? | Wo bleibt sie hängen? |
|---|---|---|---|---|
| 1 | Excel, Daten > Aus dem Web | Nein | Die Seite enthält eine HTML-Tabelle, die Daten werden in Excel verarbeitet | Seiten im Kartenlayout, Anmeldung per Formular, mehrseitige Listen |
| 2 | Google Tabellen, IMPORTHTML und IMPORTXML | Formel | Eine einzelne Seite, die in einer geteilten Tabelle aktuell bleiben soll | Per JavaScript gefüllte Inhalte, Seiten hinter einer Anmeldung, sehr viele Formeln |
| 3 | Browsererweiterung oder No-Code-Tool | Nein | Kartenlayout, ein paar Hundert Zeilen, einmalige Aufgabe | Regelmäßige Wiederholung, großes Volumen, Rezepte, die bei einem Redesign brechen |
| 4 | Python, Requests und BeautifulSoup | Ja | Dutzende oder Tausende Seiten, geplante Läufe, eigenes Format | Nachträglich per JavaScript gefüllte Inhalte |
| 5 | Headless-Browser (Playwright) | Ja | Der Inhalt entsteht erst im Browser | Tempo und Ressourcen: Für jede Seite läuft ein echter Browser |
Steigen Sie die Leiter von unten nach oben. Reicht eine untere Stufe für Ihre Aufgabe, bringt die höhere nur zusätzlichen Wartungsaufwand.
Stufe 1: Daten von einer Website mit Excel abrufen
Excel hat dafür eine eingebaute Funktion, die viele Nutzer nicht kennen. Die Schritte auf der Supportseite von Microsoft lauten: Auf der Registerkarte Daten wählen Sie im Abschnitt „Daten abrufen und transformieren" (englisch „Get & Transform") die Schaltfläche Aus dem Web, fügen die Adresse der Seite ein und bestätigen mit OK. Excel findet die Tabellen auf der Seite und listet sie im Bereich Navigator auf. Wenn Sie die gewünschte Tabelle auswählen und auf Laden klicken, landen die Daten im Arbeitsblatt. Die Verbindung bleibt in der Datei; in der nächsten Woche wiederholen Sie die Schritte nicht, sondern aktualisieren die Abfrage. Die Registerkarte „Webansicht" im Navigator zeigt die Seite selbst und hebt die erkannten Tabellen hervor.
Wo die Funktion hängen bleibt, ist ebenfalls klar. Am besten arbeitet sie mit Tabellen, die im HTML tatsächlich mit dem Tag <table> gebaut sind. Die Startseite unserer Übungsseite enthält kein einziges Tabellen-Tag, die Bücher sind als Karten angeordnet; auf solchen Seiten schlägt der Navigator die gesuchte Tabelle womöglich nicht vor, und es bleibt die Schaltfläche „Tabelle hinzufügen mit Beispielen" (englisch „Add table using examples"), bei der Sie Spalten durch das Eintippen von Beispielwerten beschreiben. Laut der Connector-Dokumentation auf Microsoft Learn werden die Authentifizierungsarten Anonym, Windows, Basic (Benutzername und Kennwort), Web-API-Schlüssel und Organisationskonto unterstützt. Ein Anmeldeformular auszufüllen und sich einzuloggen steht nicht auf dieser Liste. Eine fünfzigseitige Liste Seite für Seite abzulaufen ist in Excel zwar möglich, aber nicht praktikabel; an diesem Punkt wechseln Sie zur vierten Stufe.
Stufe 2: IMPORTHTML und IMPORTXML in Google Tabellen
Google Tabellen erledigt dieselbe Aufgabe per Formel. IMPORTHTML überträgt eine Tabelle oder Liste einer Seite in die Zellen, IMPORTXML jedes beliebige Element, das Sie mit XPath beschreiben. In einer Tabelle mit der Ländereinstellung Deutschland werden die Argumente durch Semikolons getrennt:
=IMPORTHTML("https://en.wikipedia.org/wiki/Demographics_of_India"; "table"; 4)
=IMPORTXML("https://books.toscrape.com/"; "//article[@class='product_pod']/h3/a/@title")
Die erste Formel ist das Beispiel aus Googles eigener Dokumentation: Sie holt die vierte Tabelle der Seite, die Zählung beginnt bei 1. Das zweite Argument bleibt auch in der deutschen Hilfe englisch: "table" oder "list". Wer dort „Tabelle" einträgt, erhält einen Fehler, und das ist die erste Stelle, an der Sie nachsehen sollten. Den XPath-Ausdruck der zweiten Formel haben wir am HTML der Übungsseite ausprobiert; er liefert die Titel der zwanzig Bücher auf der Startseite. Deshalb hilft es auf einer Seite im Kartenlayout, das Element mit XPath zu beschreiben, statt nach einer Tabelle zu suchen.
Diese Stufe hat drei Grenzen. Die Formel läuft auf den Servern von Google, die Anfrage kommt nicht von Ihrem Rechner. Sie sieht deshalb weder eine Seite, auf der Sie angemeldet sind, noch ein Dashboard in Ihrem Firmennetz oder die Sitzung in Ihrem Browser. Die Formel liest das rohe HTML der Seite; wird der Inhalt nachträglich per JavaScript gefüllt, steht in der Zelle ein leeres Ergebnis oder ein Fehler. Die dritte Grenze ist die Größenordnung: Wann die Formeln aktualisiert werden, bestimmen nicht Sie, und Hunderte Importformeln in einer Datei machen die Tabelle träge. Für eine einseitige Tabelle, auf die ein Team gemeinsam schaut, ist das passend, für einen Katalog mit tausend Produkten nicht.
Stufe 3: Programme zur Datenextraktion und Browsererweiterungen
Die Werkzeuge, auf die Sie bei der Suche nach „Programm zur Datenextraktion" oder „Web Scraping ohne Programmieren" stoßen, lassen sich in drei Gruppen einteilen:
- Browsererweiterungen. Auf der geöffneten Seite klicken Sie auf eine Produktkarte, dann auf Titel und Preis; die Erweiterung findet alle Karten mit demselben Muster und lädt sie als CSV- oder Excel-Datei herunter. Da die Anfrage von Ihrem eigenen Browser ausgeht, sieht die Erweiterung die Seite genau so wie Sie.
- No-Code-Tools für den Desktop und in der Cloud. Sie ergänzen dieselbe Klicklogik um Paginierung, Zeitplanung und Ausführung in der Cloud. Die meisten haben eine kostenlose Stufe; deren Grenzen prüfen Sie auf der Preisseite des jeweiligen Tools.
- Workflow-Tools. Sie machen die Datenextraktion zu einem Glied einer Kette: Seite abrufen, Feld herauslösen, in die Tabelle schreiben, bei einer Änderung benachrichtigen. Ein Beispiel aus dieser Gruppe haben wir im Beitrag Web Scraping mit n8n aufgebaut.
Bei einmaligen Aufgaben mit ein paar Hundert Zeilen liefern diese Tools schneller ein Ergebnis als Python. Wo sie hängen bleiben, zeigt sich im Dauerbetrieb. Das Rezept wird nach dem Seitendesign des jeweiligen Tages aufgezeichnet; benennt die Website eine Klasse um, erzeugt das Tool stillschweigend eine leere Spalte, und das zu bemerken bleibt Ihnen überlassen. Bei Cloud-Tools laufen die erfassten Daten und gegebenenfalls eingegebene Kontodaten über die Server eines dritten Unternehmens; berücksichtigen Sie das bei der Auswahl.
Stufe 4: Daten von einer Website mit Python extrahieren
Das gängigste Duo in Python sind die Bibliotheken Requests und BeautifulSoup. Requests lädt die Seite herunter, BeautifulSoup parst das HTML und lässt Sie Felder mit CSS-Selektoren auswählen. Die Installation ist eine Zeile:
pip install requests beautifulsoup4Das folgende Skript läuft die ersten drei Seiten der Übungsseite ab, sammelt zu jedem Buch Titel, Preis, Lagerstatus und Adresse und schreibt das Ergebnis in eine CSV-Datei, die Excel direkt öffnen kann. Mit Python 3.13 ausgeführt, hat es die Datei mit 60 Büchern ohne Probleme erzeugt.
import csv
import os
import time
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup

START_URL = "https://books.toscrape.com/"
MAX_PAGES = 3          # drei Seiten reichen zum Üben
DELAY = 2              # Sekunden zwischen zwei Anfragen

# Falls ein Proxy nötig ist: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")

session = requests.Session()
session.headers["User-Agent"] = "buchpreis-test/1.0 (kontakt: sie@example.com)"
if proxy:
    session.proxies = {"http": proxy, "https": proxy}

rows = []
url = START_URL
for page in range(MAX_PAGES):
    response = session.get(url, timeout=20)
    response.raise_for_status()
    response.encoding = "utf-8"
    soup = BeautifulSoup(response.text, "html.parser")

    for card in soup.select("article.product_pod"):
        rows.append({
            "titel": card.select_one("h3 a")["title"],
            "preis": card.select_one("p.price_color").get_text(strip=True),
            "bestand": card.select_one("p.instock").get_text(strip=True),
            "adresse": urljoin(url, card.select_one("h3 a")["href"]),
        })

    next_link = soup.select_one("li.next a")
    if next_link is None:
        break
    url = urljoin(url, next_link["href"])
    time.sleep(DELAY)

if not rows:
    raise SystemExit("Keine Produkte gefunden: Die Selektoren haben sich geändert oder die Seite wird per JavaScript gefüllt.")

# utf-8-sig: Excel zeigt Umlaute beim Öffnen der Datei korrekt an
with open("buecher.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(f, fieldnames=rows[0].keys())
    writer.writeheader()
    writer.writerows(rows)

print(f"{len(rows)} Zeilen in buecher.csv geschrieben")
Im Skript stecken vier Entscheidungen, die No-Code-Tools Ihnen nicht überlassen. Die Zeile User-Agent sagt, wer Sie sind und wie man Sie erreicht; verwenden Sie einen ehrlichen Bot-Namen statt einer gefälschten Browserkennung. DELAY legt eine Pause zwischen zwei Anfragen. raise_for_status() hält das Skript bei einem Fehlercode an, damit der Inhalt einer gesperrten Seite nicht als Daten in Ihrer Datei landet. Die Prüfung if not rows am Ende ist das Mittel gegen das Problem der stillen leeren Spalte aus der dritten Stufe: Greift der Selektor nicht, sagt das Skript es laut.
Von hier aus verzweigt sich der Weg je nach Größe der Aufgabe. Für eine Crawl-Warteschlange, die fünfzig Seiten dort fortsetzt, wo sie stehen geblieben ist, lesen Sie unseren Beitrag zum Scraping paginierter Listen, für Seiten, die eine Anmeldung mit Ihrem eigenen Konto verlangen, Sitzungen und Cookies in Python, für regelmäßige Aufgaben mit Hunderten Seiten Scrapy. Schreibt Ihr Team kein Python, können Sie dieselbe Logik mit PHP, mit C# oder mit JavaScript aufbauen; die Methode hängt nicht von der Sprache ab.
Beim Speichern reicht für eine einmalige Aufgabe CSV. Wiederholt sich die Aufgabe, geht mit einer überschriebenen Datei der Verlauf verloren; den Aufbau, der jede Zeile mit einem Datum versieht und in SQLite schreibt, finden Sie im Beitrag zur Preisbeobachtung von Wettbewerbern, die Analyse der gesammelten Daten im Beitrag Data Mining.
Stufe 5: Headless-Browser, wenn die Seite per JavaScript gefüllt wird
Die Macher derselben Seite bieten auch eine Übungsseite an, die per JavaScript gefüllt wird. Als wir diese Seite mit Requests heruntergeladen und darin nach den Zitatboxen gesucht haben, war das Ergebnis null: Die Boxen stehen nicht im HTML, sie entstehen erst, nachdem der Browser das Skript ausgeführt hat. Genau hier bleiben die zweite und die vierte Stufe hängen.
Ein Headless-Browser ist ein echter Browser ohne Fenster. Er öffnet die Seite, führt das JavaScript aus, und Sie lesen die Daten aus der fertig aufgebauten Seite. Mit Playwright wird dieselbe Seite so gelesen (nach pip install playwright und playwright install chromium):
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch()
    page = browser.new_page()
    page.goto("https://quotes.toscrape.com/js/")
    page.wait_for_selector("div.quote")          # warten, bis das Element erscheint
    for quote in page.locator("div.quote").all():
        text = quote.locator("span.text").inner_text()
        author = quote.locator("small.author").inner_text()
        print(author, "-", text[:60])
    browser.close()
Der Preis dieser Stufe sind Ressourcen: Für jede Seite öffnet sich ein Browser-Tab, Bilder und Skripte werden heruntergeladen. Deshalb ist der Headless-Browser die letzte Stufe. Bei den meisten dynamischen Seiten ist es günstiger, die JSON-Adresse zu finden, von der die Daten kommen; die Entscheidung zwischen beiden Wegen und die Wartestrategien finden Sie in Statische und dynamische Seiten, das Einrichten eines Proxys im Browser im Beitrag Playwright und Proxy.
Auf welcher Stufe kommt der Proxy ins Spiel?
Auf den ersten drei Stufen ist ein Proxy meist kein Thema. Eine Formel in Google Tabellen geht vom Server von Google aus, dazwischen können Sie nichts schalten. Excel und die Browsererweiterung nutzen die eigene Verbindung Ihres Rechners; für eine Aufgabe mit wenigen Seiten braucht es auch nichts anderes.
Ein Proxy wird auf der vierten und fünften Stufe zum Thema, in drei konkreten Situationen:
- Der Inhalt unterscheidet sich je nach Land. Zeigt ein Shop Besuchern aus Deutschland einen anderen Preis als Besuchern aus der Türkiye, sieht nur eine Verbindung aus dem jeweiligen Land die richtigen Daten. Dafür gibt es standortgenaue Residential-Proxy; abgerechnet wird pro GB, der aktuelle Basispreis liegt bei 1,4 €.
- Die Aufgabe ist gewachsen. Tausende Seiten in vertretbarer Zeit abzurufen, ohne die Zielseite zu belasten, bedeutet, dass sich die Anfragen nicht auf eine einzige Adresse häufen dürfen. Rotierender Proxy verteilen die Last auf einen Pool. Den Mechanismus erklären wir im Beitrag zur IP-Rotation.
- Eine Sitzung ist nötig. Wenn Sie sich mit Ihrem eigenen Konto anmelden und mehrere Seiten aufrufen, müssen Sie für die Dauer der Sitzung auf derselben IP bleiben; dafür werden Sticky-Proxy eingesetzt.
Auch was ein Proxy nicht leistet, gehört gesagt. Ein Rate Limit ist die Art einer Website, „das reicht" zu sagen. Es ist kein Hindernis, das man durch IP-Wechsel überwindet, sondern ein Signal, an das man sich hält; die Bedeutung der Antwort 429 erläutern wir im Beitrag 429 Too Many Requests. Die Diagnoseliste zu den Gründen für Sperren steht in Web Scraping ohne Sperren.
Um im Skript einen Proxy zu verwenden, müssen Sie den Code nicht ändern. Wenn Sie der Variable PROXY_URL eine Adresse in der Form http://user:pass@pr.proxynet.io:8000 geben, laufen alle Anfragen darüber. Wir haben das Beispiel mit einem lokalen Test-Proxy ausprobiert: Mit den richtigen Zugangsdaten kamen die Seiten an, mit falschem Kennwort warf Requests einen ProxyError mit 407 Proxy Authentication Required. Requests liest außerdem die Umgebungsvariable HTTPS_PROXY von selbst; Einzelheiten zu diesen Variablen stehen im Beitrag Proxy-Nutzung mit wget.
Einsatzbereiche
- Preis- und Bestandsbeobachtung: Das regelmäßige Erfassen öffentlich sichtbarer Preise auf Wettbewerberseiten, um die Marktposition der eigenen Produkte zu verfolgen. Den Aufbau beschreibt unsere Seite zum Preismonitoring.
- Marktforschung: Aggregierte Kennzahlen wie die Anzahl der Produkte in einer Kategorie, die Preisspanne und die Markenverteilung. Details stehen auf unserer Seite zur Marktforschung.
- Katalog- und Inhaltsprüfung: Auf Tausenden Seiten Ihrer eigenen Website nach fehlenden Beschreibungen, defekten Links oder falschen Preisen suchen. Auf der eigenen Website stellt sich keine Erlaubnisfrage; für erste Versuche ist sie zugleich das sicherste Ziel.
Häufige Fehler
- Die Seite parsen, ohne nach einer API zu suchen. Sich mit HTML abzumühen, obwohl es eine offizielle Quelle gibt, ergibt eine Lösung, die bei jedem Redesign bricht.
- Die Leiter ganz oben beginnen. Für eine einfache HTML-Tabelle einen Headless-Browser aufzusetzen, macht die Aufgabe langsamer und die Wartung schwerer.
- Ein leeres Ergebnis für Daten halten. Greift ein Selektor nicht, melden die meisten Tools keinen Fehler, sondern liefern eine leere Spalte. Prüfen Sie bei jedem Lauf die Zeilenzahl.
- Eine Schleife ohne Pause schreiben. Ein Skript, das Dutzende Anfragen pro Sekunde sendet, erhält zuerst
429, dann eine dauerhafte Sperre und kann eine kleine Website tatsächlich ausbremsen. - Personenbezogene Daten erfassen, weil sie „offen dastehen". Die Namen von Rezensenten und die Telefonnummern von Inserenten sind personenbezogene Daten. Begnügen Sie sich mit Preis- und Produktinformationen.
Entscheidungshilfe
| Bedarf | Methode |
|---|---|
| Die Website hat eine API oder die Schaltfläche „CSV herunterladen" | Nutzen Sie diese, extrahieren Sie nichts |
| Eine saubere Tabelle auf einer einzelnen Seite, Verarbeitung in Excel | Excel, Daten > Aus dem Web |
| Ein paar Hundert Zeilen im Kartenlayout, einmalig | Browsererweiterung oder IMPORTXML |
| Dutzende Seiten, geplante Läufe, eigenes Dateiformat | Python, Requests und BeautifulSoup |
| Hunderte oder Tausende Seiten, regelmäßiges Crawling | Scrapy und rotierende Proxys, die die Last verteilen |
| Der Inhalt entsteht erst im Browser und es findet sich keine JSON-Adresse | Headless-Browser (Playwright) |
| Die Daten unterscheiden sich je nach Land | Python oder Playwright mit standortgenauen Residential-Proxys |
| Die Daten liegen hinter einer Anmeldung und das Konto gehört nicht Ihnen | Nicht extrahieren; bitten Sie den Betreiber um Erlaubnis oder eine API |
Häufige Fragen
Kann man Daten von einer Website ohne Programmieren extrahieren?
Ja. Enthält die Seite eine HTML-Tabelle, erledigen das die Excel-Funktion „Aus dem Web" und die Formel IMPORTHTML in Google Tabellen, auf Seiten im Kartenlayout Browsererweiterungen und No-Code-Tools. Sobald Hunderte Seiten, tägliche Wiederholung und Fehlerprüfung nötig sind, macht Code weniger Mühe.
Gibt es ein kostenloses Programm zur Datenextraktion?
Wenn Sie Excel oder ein Google-Konto haben, kosten die ersten beiden Stufen nichts zusätzlich. Python und die im Beitrag genannten Bibliotheken sind Open Source. Die meisten No-Code-Tools bieten eine kostenlose Stufe; deren Grenzen prüfen Sie auf der Seite des Tools. Halten Sie sich von „Programm herunterladen"-Links unklarer Herkunft fern und installieren Sie Erweiterungen aus dem offiziellen Store Ihres Browsers.
Ist es legal, Daten von einer Website zu extrahieren?
Öffentlich zugängliche, nicht personenbezogene Daten in angemessenem Tempo zu erfassen, ist in den meisten Rechtsordnungen für sich genommen nicht verboten; die Nutzungsbedingungen der Website, das Urheberrecht und bei personenbezogenen Daten die DSGVO verändern das Ergebnis jedoch. Dieser Beitrag ist keine Rechtsberatung. Den Rahmen beschreiben wir in Ist Web Scraping legal?; bei einem kommerziellen Projekt ziehen Sie eine Juristin oder einen Juristen hinzu.
Warum sieht Excel die Daten auf der Seite nicht?
Der häufigste Grund: Die Daten sind nicht als HTML-Tabelle, sondern als Karten oder Liste aufgebaut; der Navigator schlägt die gesuchte Tabelle womöglich nicht vor. Der zweite Grund ist, dass die Seite eine Anmeldung verlangt, der dritte, dass der Inhalt nachträglich per JavaScript geladen wird. Im ersten Fall helfen IMPORTXML oder eine Browsererweiterung, in den anderen die Python-Stufen.
Muss man Python lernen, um Daten zu extrahieren?
Nein. Die Methode hängt nicht von der Sprache ab: Anfrage senden, HTML parsen, Feld auswählen, speichern. Beginnen Sie mit der Sprache, die Ihr Team beherrscht. Einen Vergleich zweier verbreiteter Sprachen finden Sie in Web Scraping: JavaScript oder Python?.
Wann braucht man beim Extrahieren von Daten einen Proxy?
Bei einer langsamen Aufgabe mit ein paar Hundert Seiten aus einem einzigen Land nicht. Nötig wird er, wenn sich der Inhalt je nach Land unterscheidet, wenn die Aufgabe auf Tausende Seiten gewachsen ist und die Last verteilt werden muss oder wenn die IP während einer angemeldeten Sitzung gleich bleiben soll. Ein Proxy ist kein Mittel, um das Rate Limit einer Website zu ignorieren.
Fazit
Daten von einer Website zu extrahieren hat fünf Stufen, und richtig ist die unterste, die Ihre Aufgabe erledigt. Suchen Sie zuerst nach einer API oder einer Download-Schaltfläche. Für eine saubere Tabelle dienen Excel oder Google Tabellen, für einmalige Aufgaben im Kartenlayout Erweiterungen und No-Code-Tools, für wiederkehrende und wachsende Aufgaben Python und nur für Inhalte, die erst im Browser entstehen, der Headless-Browser. Auf welcher Stufe Sie auch stehen: Erfassen Sie nur öffentlich zugängliche Daten, mit niedrigem Tempo und im Rahmen der Regeln der Website. Wenn die Aufgabe so weit wächst, dass Länder-Targeting oder Lastverteilung nötig werden, finden Sie die passenden Proxy-Typen bei unseren Proxy-Diensten.