Tienes 200 sitios pequeños distintos y necesitas recopilar de todos ellos los mismos campos —nombre del producto, precio, disponibilidad—. Escribir un script por sitio significa cientos de selectores; meterlos todos en una sola API de scraping significa registros vacíos para la mayoría, porque su estructura no encaja. Cuando le das el mismo trabajo a un agente de IA, el cuadro cambia: el agente lee cada página por sí mismo, decide mirando esa página dónde están los datos y, si hace falta, entra en un enlace y corrige su plan a mitad de camino.
Esa es, en una frase, la definición del agentic web scraping (scraping con agentes). En este artículo explicamos qué es el scraping con agentes, con qué pasos funciona el bucle del agente en un trabajo de scraping, los bloques que componen el sistema, un esqueleto de código que funciona, el terreno de costo y fiabilidad frente a los scripts basados en reglas, y los modos de error típicos del agente. El otro lado de la pregunta de «quién elige la ruta» —el pipeline fijo donde el modelo solo trabaja en el paso de análisis— lo tratamos en nuestro artículo scraper de IA.
¿Qué es el agentic web scraping?
Hay tres niveles para recopilar datos de una página y, para usar bien el término, conviene mantenerlos separados. En el primer nivel todo está en manos del desarrollador: el script sabe en el código a qué dirección ir y de qué elemento tomar los datos. En el segundo nivel el trabajo de análisis se delega en el modelo, pero la ruta sigue fija: llega la página, el modelo extrae los campos, el flujo termina —ese era el tema de nuestro artículo scraper de IA—. En el tercer nivel el modelo entra en el bucle: a qué página ir, qué botón pulsar, cuándo parar, se decide durante la ejecución. Ese tercer nivel es el agentic web scraping.
Dicho con la distinción del artículo Building effective agents de Anthropic: los flujos cuyos pasos los traza el código son flujos de trabajo; los flujos donde el modelo gestiona su propio proceso son agentes. El scraping con agentes es esa definición aplicada a la recopilación de datos. Para condensar la diferencia en una frase: en el scraper de IA, la respuesta a «¿quién analiza la página?» es el modelo; en el scraping con agentes, la respuesta a «¿quién elige la ruta?» también pasa al modelo.
¿Cómo funciona el bucle del agente en el scraping?
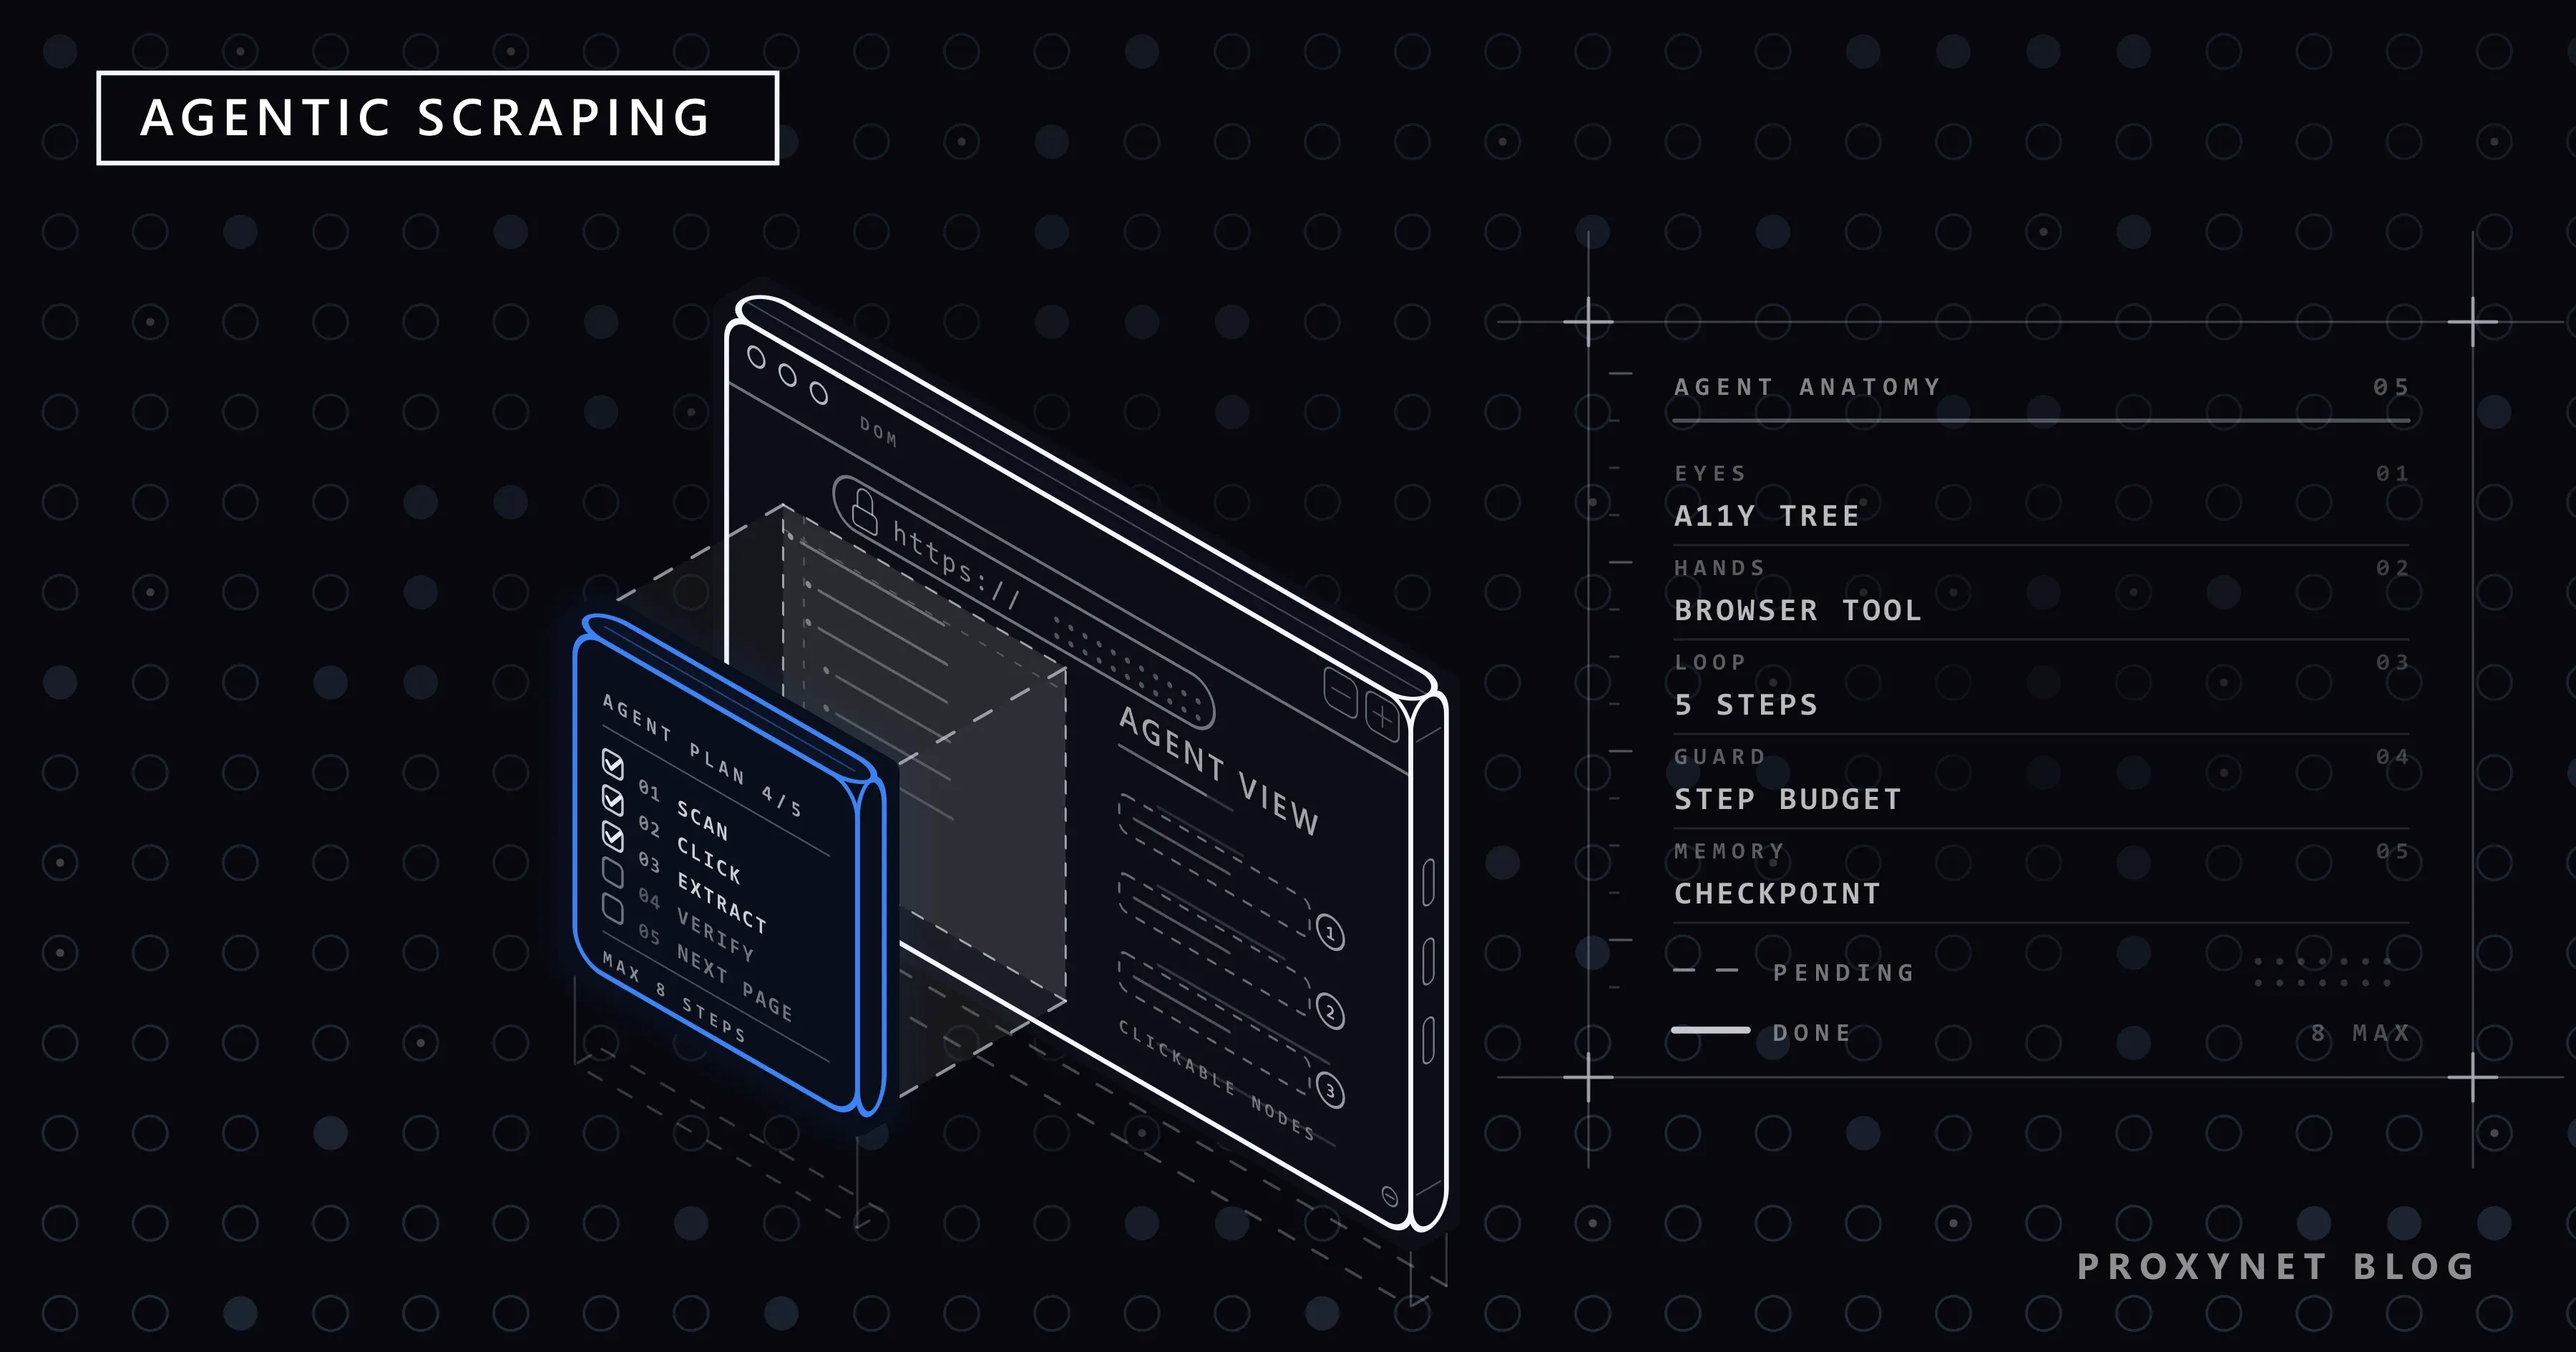
La forma general de trabajar del agente —percibir, planificar, actuar, evaluar— y la base teórica de ese bucle eran el tema de nuestro artículo Cómo funcionan los agentes de IA; en vez de repetirlo, veamos su versión aplicada al scraping. En cada vuelta se repiten cinco pasos:
- Percibir. Lo que «ve» el agente no son los píxeles de la ventana del navegador, sino el resumen estructural de la página: el árbol de accesibilidad, los encabezados, las listas de enlaces, los campos de formulario. Ese resumen entra en la ventana de contexto del modelo; el HTML en bruto no entra completo.
- Planificar. Mirando el objetivo —«extrae el precio de cada producto de esta lista»—, el modelo elige la siguiente acción: pulsar el botón de filtro, pasar a la segunda página de la paginación o decidir que los datos ya son visibles.
- Actuar. La acción que elige el modelo es una llamada a herramienta:
git(url),tıkla(betimleme),doldur(alan, değer). Quien ejecuta realmente la llamada es el navegador; el modelo solo escribe la orden. - Extraer. Cuando los datos objetivo son visibles, el modelo rellena los campos según el esquema que hayas definido. Este paso es el paso de análisis del pipeline fijo, colocado dentro del agente.
- Comprobar y repetir o terminar. Los tipos y los campos obligatorios de la salida se comprueban en el código; si falta algo, el modelo ve qué información falta y vuelve a la página correspondiente. Una condición de parada como un límite de pasos, un límite de costo o un número de páginas evita que el bucle funcione para siempre.
El cuarto y el quinto paso muestran que el scraping con agentes trabaja a la vez con dos disciplinas separadas: no confiar en las decisiones y en la salida del modelo añade de golpe dos capas de trabajo —una capa de validación y una capa de parada—. Si no están las dos, el sistema parece que «funciona» mientras produce datos erróneos en silencio.
Bloques del sistema
- Herramienta de navegador. Las manos del agente. Una biblioteca de automatización como Playwright ofrece el árbol de accesibilidad que el modelo puede ver y las acciones que puede usar; también existe un componente listo que hace este trabajo como servidor MCP. Su configuración y sus banderas de proxy las explicamos en nuestro artículo Playwright MCP; el protocolo en sí lo dejamos para nuestro artículo Qué es MCP.
- Esquema y validación. El esquema JSON de los datos pedidos ata la salida del modelo a un contrato. Las comprobaciones de tipo, obligatoriedad y rango quedan en el código; los registros sospechosos van a una cola aparte en lugar de escribirse en el almacén principal.
- Punto de control y memoria. Los trabajos largos se pueden interrumpir; las direcciones que visitó el agente, las páginas que completó y los registros que reunió se guardan fuera. La ventana de contexto es la memoria a corto plazo; la memoria de un trabajo de 200 sitios no cabe en la ventana del modelo, pero cabe en un archivo.
- Límites de seguridad. Los dominios que el agente puede abrir, el número de pasos que puede dar y las herramientas que puede llamar se restringen de antemano; el contenido de la página que extrae entra en el modelo como datos, no como instrucciones. Toda esta capa, incluidos la lista de permitidos, el límite de velocidad y la limpieza frente a la inyección, la montamos en nuestro artículo Acceso web seguro para LLM.
Un pequeño esqueleto de agente
El siguiente borrador en Python muestra el esqueleto del bucle de arriba, independiente del proveedor. El lado del navegador es Playwright; la función model_cagir se rellena con el cliente del proveedor que uses, y del modelo se espera o una acción o una salida conforme al esquema.
import json
from playwright.sync_api import sync_playwright

PROXY = {"server": "http://pr.proxynet.io:8000",
         "username": "kullanici", "password": "parola"}
HEDEF = "https://example.com/urun-listesi"
SEMA = {"urun_adi": str, "fiyat": float, "stokta": bool}

def gozlemle(sayfa):
    # El ojo del agente: no el HTML en bruto, sino el resumen estructural de la página.
    return sayfa.locator("body").aria_snapshot()

def model_cagir(gozlem, talimat):
    # Rellénalo con el cliente oficial de tu proveedor. Se envía gozlem + talimat
    # al modelo; la respuesta es o {"arac": ..., ...} o datos conformes al esquema.
    raise NotImplementedError("la llamada al modelo se hace aquí")

def dogrula(kayit):
    for alan, tur in SEMA.items():
        if not isinstance(kayit.get(alan), tur):
            raise ValueError(f"{alan} no es del tipo esperado")
    return kayit

with sync_playwright() as p:
    tarayici = p.chromium.launch(proxy=PROXY)
    sayfa = tarayici.new_page()
    sayfa.goto(HEDEF)

    for adim in range(8):                       # condición de parada: límite de pasos
        karar = json.loads(model_cagir(gozlemle(sayfa),
                                       "Extrae los productos de la lista."))
        if karar.get("arac") == "cikar":
            print(dogrula(karar["kayit"]))      # nunca confíes directamente en el modelo
            break
        if karar["arac"] == "git":
            sayfa.goto(karar["url"])
        elif karar["arac"] == "tikla":
            sayfa.get_by_role(karar["rol"], name=karar["ad"]).click()
Tres características del esqueleto resumen el resto del artículo: lo que el modelo ve en cada vuelta no es el HTML en bruto, sino un resumen estructural; el bucle tiene una condición de parada; la salida del modelo no se escribe en ningún sitio antes de pasar por dogrula. Todas las opciones de proxy de Playwright las dimos en forma de tabla en nuestro artículo proxy de Playwright.
Junto al scraping basado en reglas
Poner los tres niveles en la misma tabla aclara qué trabajo corresponde a cada nivel:
| Criterio | Script basado en reglas | Scraper de IA (pipeline fijo) | Agente (agentic) |
|---|---|---|---|
| ¿Quién elige la ruta? | El desarrollador, en el código | El desarrollador, en el código | El modelo, en tiempo de ejecución |
| Resistencia a cambios en el sitio | Baja | Alta (en el análisis) | Alta (análisis + ruta) |
| Costo unitario | Casi cero | Tokens por página | Tokens por vuelta; el número de vueltas es variable |
| Previsibilidad | Alta | Media | Baja |
| Trabajo adecuado | Páginas estables, gran volumen | Páginas de estructura variable | Trabajos de varios pasos donde la ruta no se conoce de antemano |
La fórmula del costo es sencilla: el pago total del agente es el número de vueltas multiplicado por los tokens enviados y recibidos por vuelta. En un script basado en reglas ese número está cerca de cero; en el scraper de IA el número de vueltas es uno (una sola llamada de análisis); en los trabajos con agente el número de vueltas varía según lo difícil que sea la página —la mayoría de las páginas terminan en dos vueltas, mientras que un trabajo que atraviesa menús de filtros puede tardar de seis a ocho vueltas—. Por eso el presupuesto del agente se ata a un límite de pasos y no al trabajo en sí: un sistema montado sin un techo como for adim in range(8) en el bucle puede dar vueltas durante horas en una página rota. Cómo se calculan los costos unitarios del lado del modelo lo tratamos en nuestro artículo Web scraping con GPT-6 Astra.
Los modos de error del agente
Los fallos de los sistemas con agente son distintos de los de un script; el script se rompe y se detiene, el agente puede desviarse sin romperse. Los modos principales y dónde aparecen:
- Quedarse en bucle. El agente va y viene entre las mismas dos páginas o hace clic una y otra vez en el mismo botón. Su aspecto es un número de vueltas que se hincha y la misma secuencia de acciones repetida en los registros; la cura es guardar las direcciones visitadas y las acciones, y mostrarle al modelo esa lista en cada vuelta.
- Deriva del objetivo. El modelo convierte el objetivo «extrae precios» en el objetivo «recorre el sitio»; no llegan registros, pero la vuelta se gasta. La cura es repetir el objetivo en el contexto de cada vuelta y ponerle techo al número de vueltas vacías.
- Relleno inventado. Cuando los datos no se ven, el modelo rellena los campos por probabilidad. La única cura es la capa de validación; la cola de registros sospechosos es el único lugar que atrapa este modo de error.
- Explosión de costo. El resultado combinado del bucle y la deriva: un trabajo escrito sin techo de pasos ni techo de presupuesto puede gastarse el presupuesto del día en una sola ejecución. Los dos techos viven en el código, no en la conciencia del modelo.
- Degradación silenciosa. El modo más sigiloso: el agente vuelve «con éxito» con pocos registros. Si treinta de 200 sitios vuelven vacíos y nadie mira, el error no está escondido en el registro sino en el propio informe. La cura es la alerta de por debajo de lo esperado: el trabajo que baja del número de registros esperado se marca aparte.
¿Qué cambió en el lado del bloqueo?
Ante las protecciones contra bots, el agente se ve igual que cualquier scraper que usa un navegador sin interfaz: la reputación de la IP, la velocidad de las solicitudes y las señales del navegador se miden igual; la inteligencia del modelo es invisible para esas mediciones. Además, el agente produce más solicitudes que el pipeline fijo —para cada decisión se abren páginas intermedias y se vuelve a ellas—. Por eso la continuidad de sesión gana importancia en los trabajos con agente: que la misma sesión de navegación salga siempre de la misma dirección de salida significa que las solicitudes intermedias no quedan desconectadas entre sí. Un Proxies de sesión fija que ofrece una dirección que no cambia durante la sesión encaja por eso con los trabajos con agente; en listas de objetivos amplias se usa un Proxies residenciales para ampliar el pool.
En el lado del marco legítimo tampoco se facilita nada: el agente sigue obligado a cumplir robots.txt y las condiciones del sitio, lo que queda detrás del inicio de sesión y los datos personales siguen siendo una responsabilidad aparte. A estas reglas se sumó una línea más: los sitios han empezado a separar a los agentes que se presentan con claridad al llegar (identidad de bot verificada, solicitudes firmadas) de los que no lo hacen. Por qué se bloquean los agentes y este nuevo orden lo tratamos en nuestro artículo ¿Por qué los sitios bloquean a los agentes de compra con IA?; el resumen es este: el camino legítimo no es sortear la detección, sino llevar la identidad a la vista.
Casos de uso
- Listas que atraviesan menús de filtros. En catálogos donde los pasos de categoría, filtro y paginación funcionan distinto en cada sitio, el agente reduce horas de trabajo por script a una sola instrucción; el lado del script de la lógica de paginación lo explicamos en nuestro artículo Paginación.
- Catálogos de cola larga. Reunir cientos de sitios de vendedores pequeños en un solo esquema nace de prototipar con un agente en lugar de escribir selectores por sitio; la tabla de decisión para escalar con el pipeline fijo está en el artículo scraper de IA.
- Primer montaje del seguimiento de precios y stock. En un conjunto nuevo de objetivos, el agente hace la primera exploración; si la ruta que encontró es estable, el mismo trabajo se pasa a un script basado en reglas; el montaje de extremo a extremo del seguimiento está en nuestro artículo Seguimiento de precios de la competencia.
- Datos en vivo para aplicaciones de modelos. El agente puede recopilar el contenido actual de las páginas para tu aplicación de modelo de lenguaje y entregarlo limpio; en este uso, la capa de acceso debe limitarse con las reglas de nuestro artículo Acceso web seguro para LLM.
¿Cuándo agente y cuándo script?
| Necesidad | Recomendación |
|---|---|
| Una sola página estable; gran volumen | Script basado en reglas; no hace falta modelo |
| Páginas cuya estructura cambia; ruta fija | Scraper de IA (pipeline fijo + análisis con LLM) |
| Trabajo de varios pasos con pasos desconocidos de antemano | Agente, con techos de pasos y de presupuesto |
| Prototipo y exploración, trabajo que crecerá después | Explorar con un agente y pasar la ruta encontrada al script |
| Millones de páginas al día | No un agente; pipeline basado en reglas + modelo para excepciones |
La regla de la última fila se puede resumir así: el agente pertenece a la fase de exploración del trabajo, el script a la fase de repetición. Convertir en script la ruta que el agente encontró una vez (las direcciones visitadas, los elementos pulsados, los valores de formulario enviados) es repetir el mismo trabajo de ahí en adelante sin tokens.
Marco legal y ético
El agente no cambia la legalidad del scraping: robots.txt, las condiciones del sitio, los datos personales y las reglas del contenido tras el inicio de sesión siguen aplicando igual; el marco lo explicamos en nuestro artículo ¿Es legal el web scraping?. El trabajo con agentes añade dos responsabilidades. La primera: el contenido de la página se envía a la API del modelo; en páginas con datos personales, esa transferencia entra en la normativa y hace falta limpieza antes del envío. La segunda: el agente no solo lee —hace clic y puede rellenar formularios—; los permisos que se le den deben limitarse al mínimo necesario y sus acciones deben quedar registradas.
Preguntas frecuentes
¿El agentic web scraping sustituye al scraping clásico?
No. Un agente aporta valor en trabajos donde la ruta no se conoce de antemano; en páginas estables y a gran volumen, un script basado en reglas sigue siendo más rápido, más barato y más previsible. El montaje habitual los pone lado a lado: el agente explora, el script repite.
¿Cómo se calcula el costo del scraping con agentes?
Es el número de vueltas multiplicado por el costo en tokens por vuelta. En un script basado en reglas el número de vueltas es cero, en el scraper de IA es uno; en los trabajos con agente varía según lo difícil que sea la página. Por eso el presupuesto se ata al bucle y no al trabajo: el techo de pasos y el techo de gasto se escriben en el código.
¿En qué casos tiene sentido usar un agente?
Cuando la estructura es distinta cada vez, los pasos no se pueden escribir de antemano y el volumen del trabajo cubre el costo en tokens. Los menús de filtros, las listas de varios pasos y los cientos de sitios pequeños distintos encajan en esa definición; una sola página de producto no encaja.
¿Cómo se validan los datos que recoge el agente?
No es distinto de la validación en el pipeline fijo: un esquema JSON, comprobaciones de tipo y de campos obligatorios, comprobaciones de rango y comparación manual por muestreo. Además, en los trabajos con agente se vigila el número de registros esperado; el trabajo que baja de lo esperado no pasa en silencio, se marca aparte.
Los sitios bloquean a los agentes, ¿cuál es el camino legítimo?
No ocultar la identidad del agente, sino llevarla a la vista; cumplir las condiciones del sitio y robots.txt; usar una identidad de bot verificada si se puede obtener. Por qué se producen los bloqueos y el orden de los agentes firmados lo explicamos en nuestro artículo agentes de compra con IA.
¿Con qué herramienta se empieza con el agentic web scraping?
Para el lado del navegador, Playwright y una interfaz que lo conecte con el modelo: o un servidor MCP listo o tu propio bucle. En el lado del modelo basta cualquier API con soporte de salida estructurada; para empezar, puedes usar el esqueleto de arriba junto con un techo de pasos.
En resumen
El agentic web scraping mete al modelo tanto en la ruta como en el análisis del scraping: observa la página, decide el siguiente paso y extrae los datos según el esquema. Lo que aporta es que los trabajos variables y de varios pasos quepan en una sola instrucción; el precio es un costo que crece con el número de vueltas y una imprevisibilidad que hay que contener con código. Con el techo de pasos, la capa de validación y el registro en su sitio, el agente es una herramienta potente para explorar; los trabajos estables y repetitivos se quedan en el script. Al montar tu pipeline de recopilación de datos, puedes echar un vistazo a nuestras soluciones de extracción de datos.