تیمی میخواهد دستیار داخلیاش به پرسشها از روی مستندات محصول پاسخ دهد. صفحهها را با Requests دانلود میکنند و HTML را به مدل میدهند، اما منوها، بنرهای کوکی و اسکریپتها نیمی از متن را میگیرند و صفحههایی که محتوایشان را با JavaScript بارگذاری میکنند تقریباً خالی میرسند. Crawl4AI همین صفحهها را در یک مرورگر واقعی باز میکند و متن اصلی را به شکل Markdown تمیز برمیگرداند. روز دوم مشکلها عوض میشوند: در میانه خزش 300 صفحه، سایت با 429 پاسخ میدهد و نصب Docker روی سرور build فقط «connection reset» برمیگرداند.
این راهنما توضیح میدهد Crawl4AI چگونه صفحه را به Markdown تبدیل میکند، نصب با pip و Docker چگونه است، پروکسی کجا تنظیم میشود، استفاده چرخشی و نشست ثابت چه تفاوتی دارند و کدام تنظیمات robots.txt و نرخ درخواست، خزش را مؤدبانه نگه میدارند. همه نمونههای Python را با Crawl4AI 0.9.4 و Python 3.13 و از طریق یک پروکسی آزمایشی محلی با نام کاربری و رمز عبور اجرا کردیم. Docker روی دستگاه آزمایش در دسترس نبود، پس فرمانهای Docker از راهنمای رسمی پیروی میکنند.
Crawl4AI چیست و چه کاربردی دارد؟
Crawl4AI یک کتابخانه متنباز Python است که صفحههای وب را دریافت میکند و محتوای آنها را به شکلی برمیگرداند که مدل زبانی بتواند بخواند. این کتابخانه Chromium را از طریق Playwright کنترل میکند، پس صفحههایی که با JavaScript ساخته میشوند پیش از خوانده شدن رندر میشوند (صفحههای ایستا و پویا). هر خزش صفحه را به شکل Markdown برمیگرداند، همراه با نسخه کوتاهتری به نام Markdown «fit» که منو و فوتر ندارد، فهرست پیوندها، فهرست رسانهها و در صورت درخواست، یک اسکرینشات یا PDF. با یک استراتژی استخراج (extraction strategy) میتواند یک شِمای JSON را هم پر کند.
این کتابخانه به Python 3.10 یا جدیدتر نیاز دارد؛ نسخه 0.9.4 در 23 سپتامبر 2026 روی PyPI منتشر شد. میتوانید آن را به شکل SDK در Python، به شکل سرور Docker با REST API و نقطه اتصال MCP، یا از طریق ابزار خط فرمان crwl به کار ببرید.
Crawl4AI پیش از هر چیز یک خزنده است: صفحهها را بازدید میکند و پیوندها را دنبال میکند، و اینکه چه چیزی استخراج شود با شماست (وب اسکرپینگ و خزش وب). مقایسه آن با ابزارهای اسکرپینگ هوش مصنوعی بهطور کلی در نوشته اسکرپر وب هوش مصنوعی چیست و چگونه کار میکند؟ آمده است.
Crawl4AI چگونه صفحه را به Markdown تبدیل میکند؟
هر فراخوانی arun() این گامها را طی میکند:
- مرورگر با تنظیمات
BrowserConfigاجرا میشود: حالت headless (بدون پنجره)،User-Agentو اگر آنجا تعیین شده باشد، پروکسی برای کل مرورگر. - robots.txt بررسی میشود، به شرطی که
CrawlerRunConfigمقدارcheck_robots_txt=Trueرا داشته باشد. URL غیرمجاز هرگز باز نمیشود؛ نتیجه وضعیت403و پیام «Access denied by robots.txt» را دارد. - صفحه در Chromium بارگذاری میشود، اگر اجرا پروکسی داشته باشد از طریق همان پروکسی، و JavaScript آن اجرا میشود.
- HTML پاکسازی میشود: اسکریپتها و استایلها حذف میشوند و پیوندها و رسانهها جمعآوری میشوند.
DefaultMarkdownGeneratorخروجیraw_markdownرا مینویسد.- یک
content_filterخروجیfit_markdownرا مینویسد:PruningContentFilterLXMLبلوکهای پرمتن را نگه میدارد وBM25ContentFilterبلوکهایی را که با یک پرسوجو (query) جور درمیآیند. بدون فیلتر،fit_markdownخالی است. - یک
CrawlResultبرمیگردد با فیلدهایsuccess،status_code،error_message،markdownوlinks.
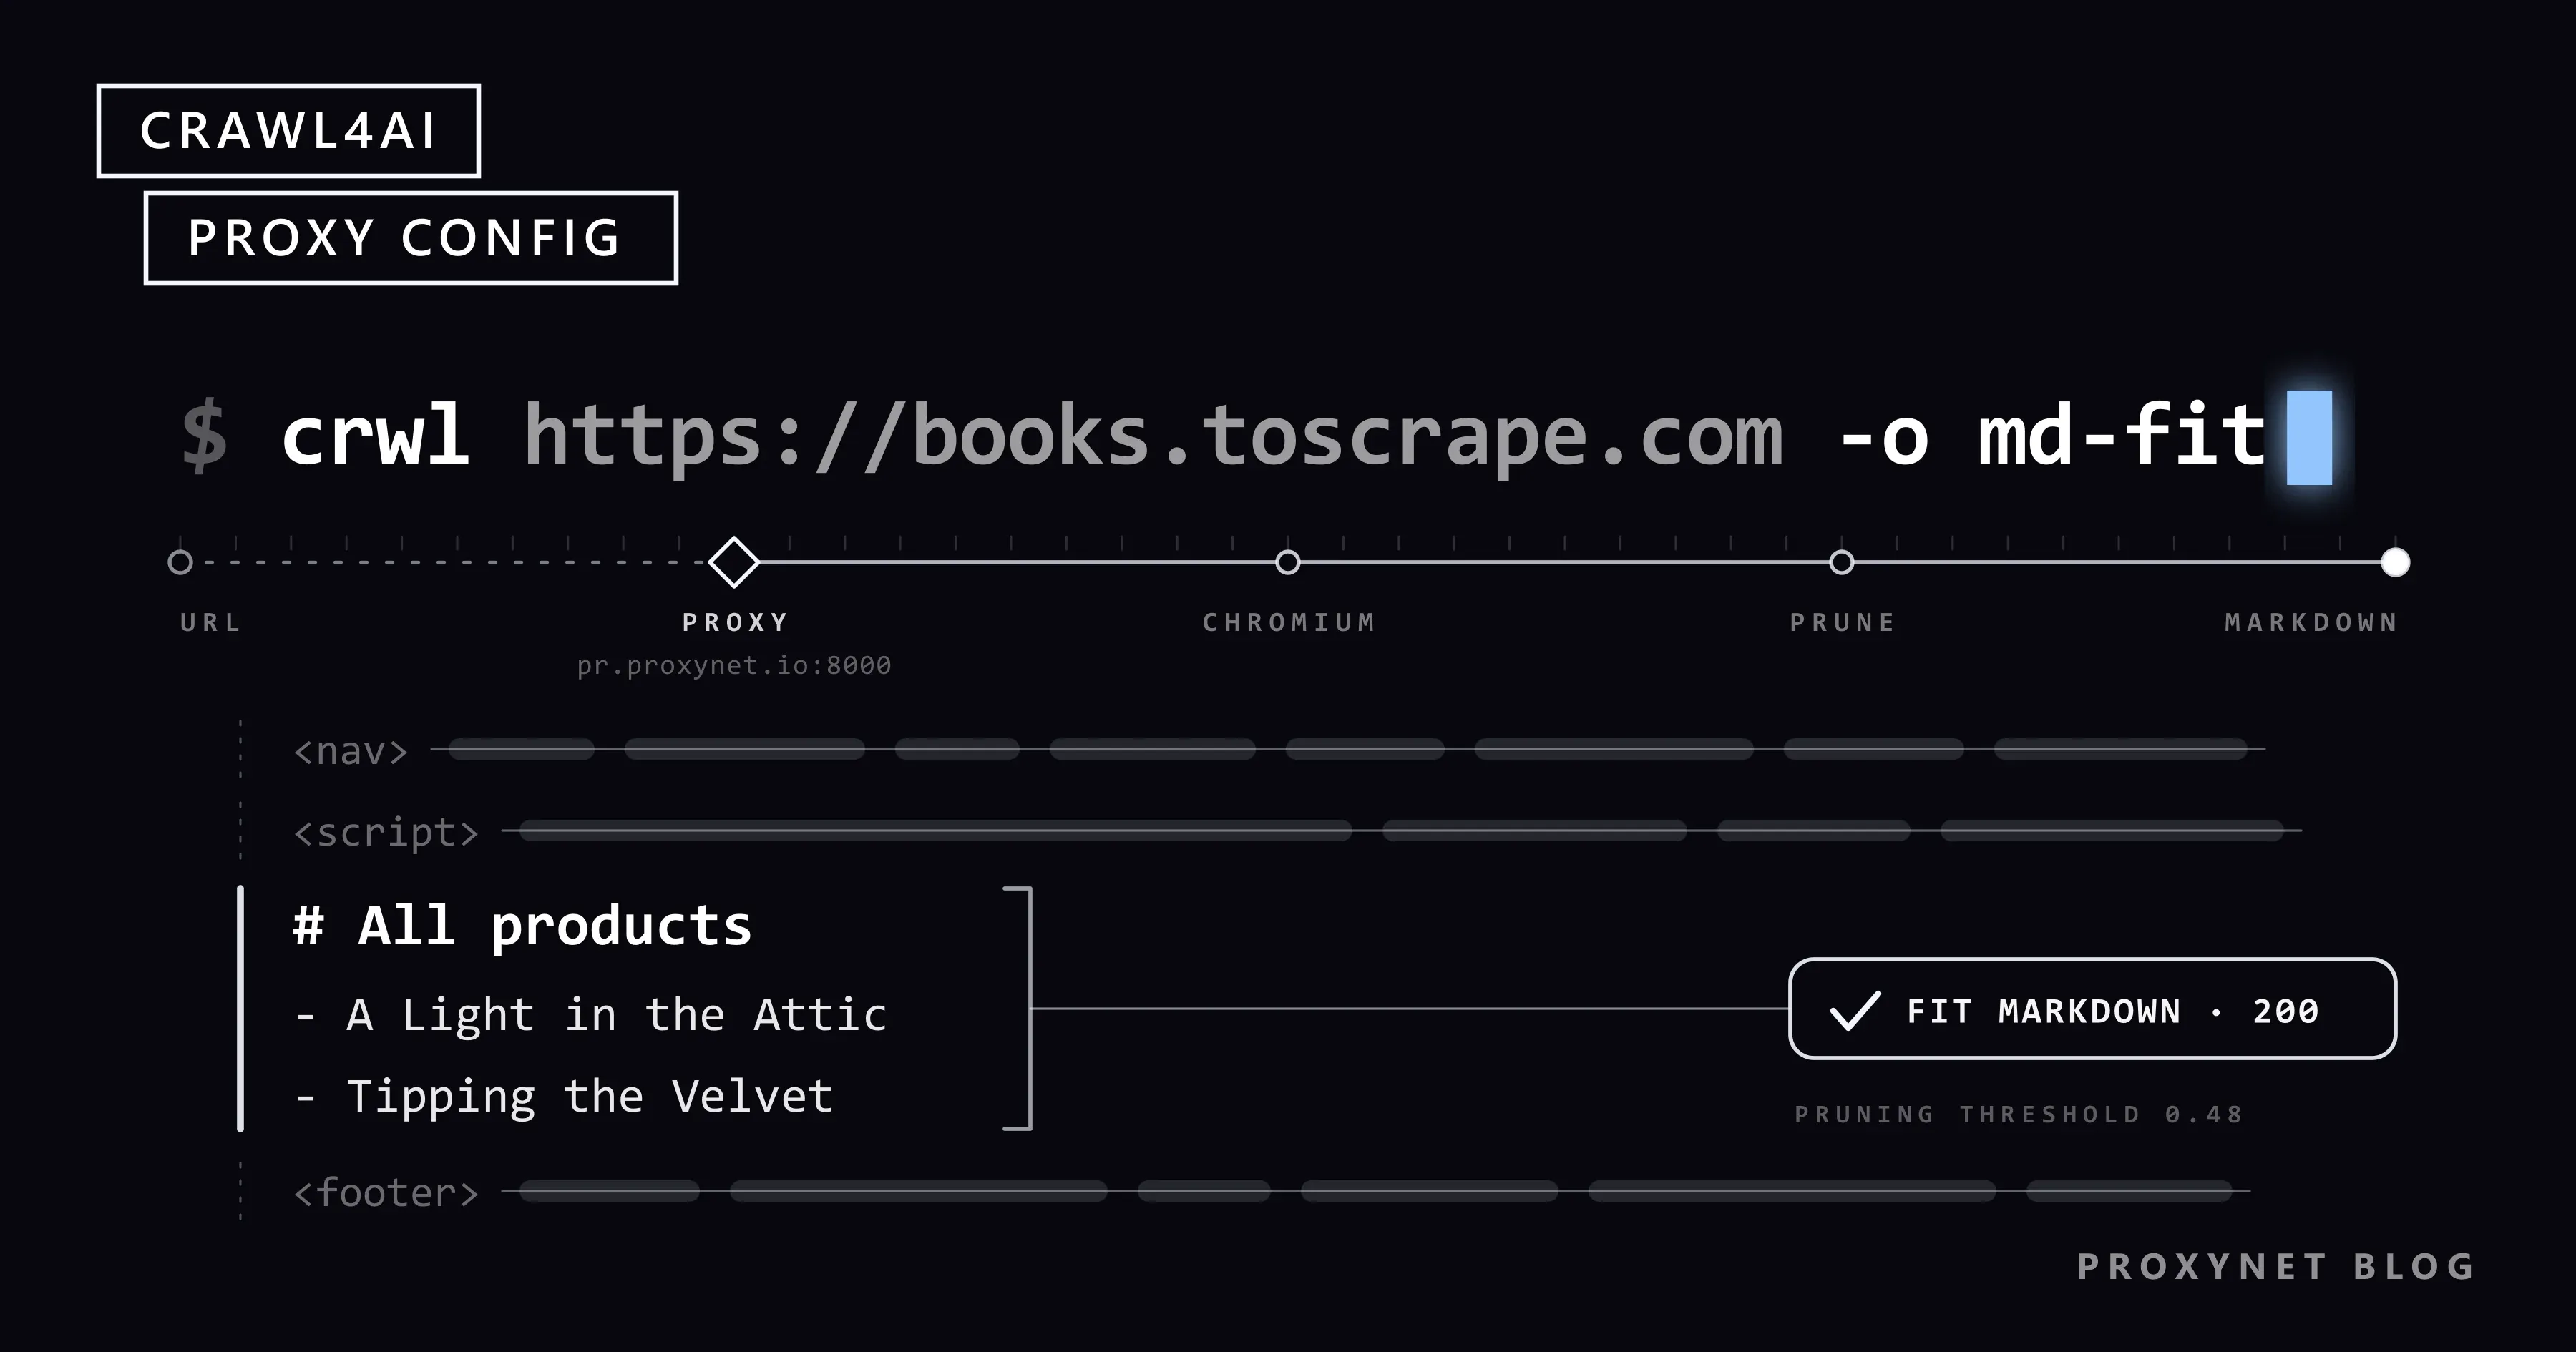
در یکی از صفحههای آزمایشی ما، Markdown خام 1,241 نویسه بود و Markdown fit برابر 712 نویسه: منو و فوتر حذف شدند و متن مقاله ماند. یک اعلان کوکی باقی ماند، چون فیلتر به چگالی متن و پیوند امتیاز میدهد، نه به معنا؛ excluded_selector=".cookie" در CrawlerRunConfig آن را حذف کرد.
Crawl4AI چگونه با pip یا Docker نصب میشود؟
مسیر pip کتابخانه و یک نسخه Chromium را نصب میکند. مسیر Docker سروری را راه میاندازد که برنامههای دیگر از طریق HTTP آن را فرا میخوانند.
# Python SDK
pip install -U crawl4ai
crawl4ai-setup      # installs the Playwright browser Crawl4AI uses
crawl4ai-doctor     # runs a test crawl to check the installation

# Docker server: 0.9.0 and later need a token
export CRAWL4AI_API_TOKEN="$(openssl rand -hex 32)"
docker run -d -p 11235:11235 --name crawl4ai --shm-size=1g \
  -e CRAWL4AI_API_TOKEN="$CRAWL4AI_API_TOKEN" \
  unclecode/crawl4ai:0.9.4

curl http://localhost:11235/health    # answers without a token
curl -X POST http://localhost:11235/md \
  -H "Authorization: Bearer $CRAWL4AI_API_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://quotes.toscrape.com/", "f": "fit"}'
راهنمای میزبانی شخصی از تگ latest استفاده میکند؛ تگ نسخهدار مانع میشود که بهروزرسانی ایمیج، بیآنکه متوجه شوید، رفتار سرور را تغییر دهد. صفحههای /playground و /dashboard در بالای صفحه فیلدی برای توکن دارند.
سه روش اجرای Crawl4AI بیشتر در این تفاوت دارند که پروکسی کجا تنظیم میشود:
| روش | نصب | جای پروکسی | robots.txt و نرخ | مناسب برای |
|---|---|---|---|---|
| Python SDK | pip install، crawl4ai-setup | proxy_config در CrawlerRunConfig یا BrowserConfig؛ proxy_rotation_strategy برای فهرست | check_robots_txt، SemaphoreDispatcher، RateLimiter | هر کاری که به پروکسی خودتان نیاز دارد |
| سرور Docker | docker run با توکن، پورت 11235 | در درخواست ممکن نیست (HTTP 400) | check_robots_txt در درخواست مجاز است | فراخوانی از زبانهای دیگر، n8n یا عاملها |
خط فرمان crwl | همراه pip نصب میشود | فایل پیکربندی مرورگر، -B | فایل پیکربندی خزنده، -C | تبدیل یک صفحه به Markdown |
چگونه از نخستین خزش در Python خروجی Markdown بگیریم؟
این اسکریپت یک صفحه را از طریق پروکسی باز میکند، پیش از آن robots.txt را بررسی میکند و اندازه هر دو نسخه Markdown را چاپ میکند. آدرس پروکسی از یک متغیر محیطی خوانده میشود تا رمز عبور درون کد نیاید.
"""Crawl one page through a proxy and print its Markdown."""
import asyncio
import os
import sys

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    DefaultMarkdownGenerator,
    ProxyConfig,
    PruningContentFilterLXML,
)

URL = sys.argv[1] if len(sys.argv) > 1 else "https://quotes.toscrape.com/"


async def main():
    # PROXY_URL=http://user:pass@pr.proxynet.io:8000, kept out of the code
    proxy = ProxyConfig.from_string(os.environ["PROXY_URL"])

    browser_config = BrowserConfig(
        headless=True,
        user_agent="NorthwindDocsBot/1.0 (+https://example.com/bot)",
    )
    run_config = CrawlerRunConfig(
        proxy_config=proxy,
        check_robots_txt=True,
        cache_mode=CacheMode.BYPASS,
        markdown_generator=DefaultMarkdownGenerator(
            content_filter=PruningContentFilterLXML(threshold=0.48)
        ),
    )

    async with AsyncWebCrawler(config=browser_config) as crawler:
        result = await crawler.arun(URL, config=run_config)

    if not result.success:
        print(f"failed: {result.status_code} {result.error_message}")
        return

    md = result.markdown
    print(f"status {result.status_code}")
    print(f"raw_markdown: {len(md.raw_markdown)} characters")
    print(f"fit_markdown: {len(md.fit_markdown)} characters")
    print(md.fit_markdown[:400])


asyncio.run(main())
روی quotes.toscrape.com، سایتی تمرینی برای اسکرپینگ، این خروجی چاپ شد:
status 200
raw_markdown: 4375 characters
fit_markdown: 3663 characters
CacheMode.BYPASS صفحه را هر بار دوباره دریافت میکند؛ بدون آن، URLهای تکراری از کش محلی خوانده میشوند. از PruningContentFilterLXML استفاده کنید: در 0.9.4 کلاس قدیمیتر PruningContentFilter هشدار منسوخ شدن (deprecation warning) چاپ میکند.
پروکسی را در Crawl4AI چگونه تنظیم کنیم؟
پروکسی یک ProxyConfig با server، username و password است و در یکی از این دو جا قرار میگیرد:
from crawl4ai import BrowserConfig, CrawlerRunConfig, ProxyConfig

proxy = ProxyConfig(server="http://pr.proxynet.io:8000", username="user", password="pass")

run_config = CrawlerRunConfig(proxy_config=proxy)    # this run only
browser_config = BrowserConfig(proxy_config=proxy)   # every page this browser opens
راهنمای رسمی پروکسی CrawlerRunConfig را توصیه میکند تا هر اجرا پروکسی خودش را داشته باشد. در آزمون ما هر دو روش کار کردند.
ProxyConfig.from_string() قالبهای http://user:pass@host:port، host:port:user:pass، host:port و socks5://host:port را میخواند. ProxyConfig.from_env("PROXIES") فهرستی جداشده با ویرگول را از یک متغیر محیطی میخواند. پارامتر قدیمی proxy= هنوز کار میکند اما هشدار منسوخ شدن چاپ میکند.
SOCKS5 با رمز عبور کار نمیکند. با socks5:// و نام کاربری، در هر دو قالب، خزش ما با خطای «Browser does not support socks5 proxy authentication» شکست خورد. این محدودیت از Chromium است (Playwright با پروکسی). از نقطه اتصال HTTP پروکسی استفاده کنید، یا IP سرور خود را در پنل پروکسی مجاز کنید (لیست سفید IP) و بدون رمز عبور وصل شوید (تفاوت پروکسی SOCKS و HTTP).
برای بررسی پروکسی، صفحهای را خزش کنید که IP بازدیدکننده را نشان میدهد.
چرخشی یا نشست ثابت: چه زمانی به RoundRobinProxyStrategy نیاز دارید؟
پاسخ به این بستگی دارد که آدرس پروکسی شما به چه چیزی اشاره میکند.
گیتوی چرخشی یک آدرس واحد است، مانند pr.proxynet.io:8000، که ارائهدهنده پشت آن IP خروجی را عوض میکند. با پروکسی چرخشی یا پروکسی مسکونی چرخشی، Crawl4AI فقط به یک ProxyConfig نیاز دارد. نمونهای که در صفحه رسمی پروکسی آمده، آدرس IP دیدهشده از سوی سایت را با ProxyConfig.ip مقایسه میکند؛ با گیتوی این بررسی همیشه ناهمخوانی گزارش میکند، چون IP خروجی هیچوقت همان آدرس گیتوی نیست.
فهرست ثابتی از IPها، برای نمونه از پلن پروکسی دیتاسنتر یا پروکسی ISP، جایی است که RoundRobinProxyStrategy به کار میآید: هر درخواست پروکسی بعدی فهرست را میگیرد. با proxy_session_id، درخواستهایی که شناسه یکسان دارند تا گذشتن proxy_session_ttl ثانیه همان پروکسی را نگه میدارند:
"""Rotate through a fixed list of proxies, or keep one of them for a whole session."""
import asyncio

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    ProxyConfig,
    RoundRobinProxyStrategy,
)

# PROXIES="http://user:pass@203.0.113.10:8000,http://user:pass@203.0.113.11:8000"
strategy = RoundRobinProxyStrategy(ProxyConfig.from_env("PROXIES"))

rotate = CrawlerRunConfig(proxy_rotation_strategy=strategy, cache_mode=CacheMode.BYPASS)
sticky = CrawlerRunConfig(
    proxy_rotation_strategy=strategy,
    proxy_session_id="catalog-1",  # every request with this id gets the same proxy
    proxy_session_ttl=600,         # seconds; after that the session picks a new one
    cache_mode=CacheMode.BYPASS,
)


async def main(base):
    async with AsyncWebCrawler(config=BrowserConfig(headless=True)) as crawler:
        for label, config in (("rotate", rotate), ("sticky", sticky)):
            for page in range(1, 4):
                result = await crawler.arun(f"{base}/catalog?page={page}", config=config)
                print(label, page, result.status_code, config.proxy_config.server)


asyncio.run(main("https://shop.example.com"))
با دو پروکسی محلی، درخواستهای rotate یکی در میان جابهجا شدند و درخواستهای sticky یک پروکسی را نگه داشتند. پارامترهای نشست در کد منبع 0.9.4 وجود دارند اما در صفحه مستندات پروکسی نیامدهاند، پس پس از هر بهروزرسانی دوباره بررسیشان کنید.
این دو لایه را از هم جدا نگه دارید. نشست ثابت Crawl4AI همان مورد را از فهرست شما انتخاب میکند؛ پشت یک گیتوی چرخشی، IP خروجی فقط وقتی ثابت میماند که ارائهدهنده آن را نگه دارد، همان کاری که پروکسی با نشست ثابت برای 1 تا 60 دقیقه انجام میدهد. این حالتها در چرخش IP و چرخش پروکسی برای کلاینتهای ساده HTTP در چرخاندن پروکسی در Python توضیح داده شدهاند.
چرا درخواست Docker نمیتواند پروکسی داشته باشد؟
از 0.9.0 سرور Docker بهطور پیشفرض امن است. بدنه درخواستی که proxy یا proxy_config داشته باشد پاسخ HTTP 400 میگیرد، و همینطور js_code، headers، cookies، magic و چند فیلد دیگر (یادداشتهای مهاجرت 0.9.0). دلیلش جعل درخواست سمت سرور (SSRF) است: در غیر این صورت فراخواننده میتوانست مرورگر سرور را از هر پروکسی دلخواه یا به سوی آدرسهای داخلی بفرستد.
این یادداشتها میگویند چنین گزینههایی را روی سرور تنظیم کنید، اما در کد منبع 0.9.4 یک محافظ ترافیک خروجی (egress guard) هر proxy_config را حذف میکند، حتی اگر در config.yml باشد، و Chromium را از پروکسی فیلترکننده خود سرور عبور میدهد. کد منبع یک پروکسی HTTP بالادستی را هم از CRAWL4AI_UPSTREAM_PROXY یا HTTPS_PROXY میخواند؛ این رفتار مستند نشده است و نتوانستیم آن را آزمایش کنیم. برای استفاده از پروکسی خودتان، SDK را در سرویس خودتان اجرا کنید.
robots.txt، نرخ و همروندی را چگونه تنظیم کنیم؟
مقدار پیشفرض check_robots_txt برابر False است. رفتار 0.9.4 را روی سایتهای محلی آزمایش کردیم:
- مسیر غیرمجاز وضعیت
403برمیگرداند و صفحه هرگز درخواست نمیشود. - فایل robots.txt که با
500پاسخ دهد به معنای «همه مجاز» شمرده میشود، و همینطور مهلت زمانی 2 ثانیهای و خطای شبکه. RFC 9309 میگوید خزنده در خطاهای سرور باید ممنوعیت کامل را فرض کند. - قاعدهها 7 روز در کش میمانند. RFC 9309 میگوید نسخه کششده نباید بیش از 24 ساعت استفاده شود؛
crawler.robots_parser.clear_cache()کش را خالی میکند. - robots.txt مستقیم از دستگاه شما دریافت میشود، نه از طریق پروکسی، و با یک User-Agent عمومی
aiohttp. - قاعدهها با
BrowserConfig.user_agentتطبیق داده میشوند. مقدار پیشفرض یک رشته Chrome است، پسDisallowبرای نام ربات شما فقط وقتی اعمال میشود کهUser-Agentشما همان نام را داشته باشد. مسیری زیر/privateبا رشته پیشفرض باز شد و باNorthwindDocsBot/1.0وضعیت403برگرداند.
برای کارهای حساس، پیش از هر چیز خودتان robots.txt را بررسی کنید (فایل robots.txt چیست؟، User-Agent چیست؟).
نرخ در dispatcher (توزیعکننده درخواستها) تنظیم میشود. SemaphoreDispatcher(semaphore_count=3) همزمان حداکثر سه صفحه را باز نگه میدارد (همروندی و موازیسازی). RateLimiter میان درخواستها به یک دامنه صبر میکند، پس از 429 یا 503 زمان انتظار را تقریباً دو برابر میکند تا به max_delay برسد، و پس از درخواستهای موفق آن را کوتاهتر میکند. این کلاس صفحه ردشده را دوباره دریافت نمیکند: نتیجه با 429 برمیگردد و تلاش دوباره بر عهده شماست. اسکریپت زیر در دستههای سهتایی خزش میکند و به صفحههای ردشده دو دور دیگر فرصت میدهد:
"""Crawl the pages of one site at a polite pace and save each one as Markdown."""
import asyncio
import os
import re
from pathlib import Path

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    DefaultMarkdownGenerator,
    ProxyConfig,
    PruningContentFilterLXML,
    RateLimiter,
    SemaphoreDispatcher,
)

BASE = os.environ.get("DOCS_BASE", "https://docs.example.com")
URLS = [f"{BASE}/docs/{n}" for n in range(1, 13)] + [f"{BASE}/private/report"]
OUT = Path("pages")
BATCH = 3                 # pages open at the same time
PAUSE = 5.0               # seconds between two batches
RETRY_CODES = {429, 503}  # worth another try later
ROUNDS = 3                # first pass plus two retry rounds
ROUND_PAUSE = 60          # seconds before a retry round; doubles each round


def file_name(url):
    return re.sub(r"[^a-z0-9]+", "-", url.lower()).strip("-") + ".md"


async def crawl_round(crawler, urls, run_config, dispatcher):
    """Crawl urls in small batches and return the ones to try again later."""
    retry = []
    for i in range(0, len(urls), BATCH):
        results = await crawler.arun_many(
            urls[i : i + BATCH], config=run_config, dispatcher=dispatcher
        )
        for r in results:
            if r.success and r.status_code == 200:
                (OUT / file_name(r.url)).write_text(r.markdown.fit_markdown, encoding="utf-8")
                print(f"saved  {r.url}")
            elif r.status_code in RETRY_CODES:
                retry.append(r.url)
                print(f"later  {r.status_code} {r.url}")
            else:
                print(f"skip   {r.status_code} {r.url}: {r.error_message}")
        await asyncio.sleep(PAUSE)
    return retry


async def main():
    OUT.mkdir(exist_ok=True)
    browser_config = BrowserConfig(
        headless=True,
        user_agent="NorthwindDocsBot/1.0 (+https://example.com/bot)",
    )
    run_config = CrawlerRunConfig(
        proxy_config=ProxyConfig.from_string(os.environ["PROXY_URL"]),
        check_robots_txt=True,
        cache_mode=CacheMode.BYPASS,
        page_timeout=30000,
        markdown_generator=DefaultMarkdownGenerator(
            content_filter=PruningContentFilterLXML(threshold=0.48)
        ),
    )
    # One dispatcher for the whole run: the RateLimiter keeps the slower pace it learns from 429s
    dispatcher = SemaphoreDispatcher(
        semaphore_count=BATCH,
        rate_limiter=RateLimiter(base_delay=(1.0, 3.0), max_delay=60.0, max_retries=3),
    )

    pending = list(URLS)
    async with AsyncWebCrawler(config=browser_config) as crawler:
        for round_no in range(ROUNDS):
            if round_no:
                wait = ROUND_PAUSE * 2 ** (round_no - 1)
                print(f"round {round_no + 1}: {len(pending)} pages again in {wait} s")
                await asyncio.sleep(wait)
            pending = await crawl_round(crawler, pending, run_config, dispatcher)
            if not pending:
                break

    print(f"done, {len(pending)} pages still refused")


asyncio.run(main())
DOCS_BASE را به یک سایت محلی نشانه رفتیم که به هر چهارمین درخواست زیر /docs/ با 429 پاسخ میدهد و /private را ممنوع کرده است، و برای آزمون ROUND_PAUSE را 5 ثانیه گذاشتیم. خروجی کوتاهشده:
saved  http://192.168.1.2:28130/docs/1
saved  http://192.168.1.2:28130/docs/2
saved  http://192.168.1.2:28130/docs/3
later  429 http://192.168.1.2:28130/docs/4
...
later  429 http://192.168.1.2:28130/docs/11
saved  http://192.168.1.2:28130/docs/12
skip   403 http://192.168.1.2:28130/private/report: Access denied by robots.txt
round 2: 3 pages again in 5 s
saved  http://192.168.1.2:28130/docs/4
saved  http://192.168.1.2:28130/docs/9
saved  http://192.168.1.2:28130/docs/11
done, 0 pages still refused
لاگ خود Crawl4AI هم برای هر صفحه ردشده پیام «Blocked by anti-bot protection: HTTP 429 Too Many Requests» را چاپ میکند. شیوه برخورد با هدر واقعی Retry-After در کدهای وضعیت HTTP در وب اسکرپینگ آمده است.
تفاوت Crawl4AI و Firecrawl چیست؟
هر دو صفحهها را برای مدلهای زبانی به Markdown تبدیل میکنند؛ تفاوتشان در شیوه اجراست.
| Crawl4AI | Firecrawl | |
|---|---|---|
| مجوز | Apache 2.0 بهعلاوه الزام ذکر نام پروژه | AGPL-3.0 |
| شکل اصلی | کتابخانه Python؛ سرور Docker اختیاری | API میزبانیشده؛ میزبانی شخصی هم ممکن است |
| اجزای میزبانی شخصی | یک کانتینر | API، ورکرها، Playwright، Redis، RabbitMQ، PostgreSQL |
| هزینه | سرور، پروکسی و هر LLM که به کار ببرید | پلن API یا سرورهای خودتان |
Firecrawl در راهنمای میزبانی شخصی خود یادآوری میکند که API در میزبانی شخصی بهطور پیشفرض احراز هویت ندارد. Crawl4AI برای تیمی مناسب است که با Python کار میکند و میخواهد خزشها و پروکسیهایش را خودش اداره کند.
Crawl4AI را چگونه با MCP و n8n به کار ببریم؟
سرور Docker پروتکل MCP را در /mcp/sse و /mcp/ws با ابزارهای md، html، screenshot، pdf، execute_js، crawl و ask در اختیار میگذارد. فرمان Claude Code در راهنما توکن ندارد، اما نقطههای اتصال MCP پشت همان بررسی توکنی قرار دارند که API دارد، پس هدر را اضافه کنید:
claude mcp add --transport sse c4ai-sse http://localhost:11235/mcp/sse \
--header "Authorization: Bearer $CRAWL4AI_API_TOKEN"کلاینتهای WebSocket که نمیتوانند هدر تنظیم کنند، میتوانند توکن را با ?token= بفرستند. خود پروتکل در پروتکل MCP چیست؟ و دادن یک مرورگر کامل به عامل در Playwright MCP چیست؟ توضیح داده شده است.
در n8n، یک نود HTTP Request درخواست POST /md را با هدر Bearer و بدنهای مانند {"url": "https://quotes.toscrape.com/", "f": "fit"} میفرستد؛ صفحه در فیلد markdown برمیگردد (وب اسکرپینگ با n8n).
کاربردها
- مستندات برای RAG: مستندات محصول به شکل Markdown برای یک نمایه بازیابی، پشت بررسیهایی که در دسترسی امن LLM به وب آمده است.
- ورودی تمیز برای عاملها: Markdown fit به جای HTML خام (اسکرپینگ وب عاملی).
- بررسی قیمت: تبدیل صفحههای محصول به JSON با یک شِمای CSS (رصد قیمت).
- فهرست صفحههای سایت خودتان: همه صفحهها و پیوندها، برای ممیزی محتوا و یافتن پیوندهای شکسته (خزنده وب).
- دادههای کاتالوگ: نام، مشخصات و قیمت از صفحههای عمومی کاتالوگ (استخراج داده).
اشتباهات رایج
- اجرای
docker runبدون توکن، یا-e CRAWL4AI_API_TOKENبدون مقدار: پاسخ «connection reset» از کانتینری که سالم به نظر میرسد. - گذاشتن
proxy_configدر درخواست REST: سرور با400پاسخ میدهد. socks5://با رمز عبور: Chromium آن را نمیپذیرد.- چند بار آوردن یک گیتوی چرخشی در
RoundRobinProxyStrategy: گیتوی خودش IP را میچرخاند. - انتظار
fit_markdownبدونcontent_filter: خالی میماند. - فرض اینکه robots.txt بررسی میشود: این بررسی بهطور پیشفرض خاموش است و فایل robots.txt که بارگذاری نشود «مجاز» شمرده میشود.
- همروندی بالا بدون
RateLimiter: ده صفحه موازی روی یک سایت کوچک مثل رگبار درخواست به نظر میرسد و پاسخهای429از پی آن میآیند. - عوض کردن IP برای فشار آوردن به سایتی که
429داده است: به جای آن سرعت را کم کنید (تشخیص بات چگونه کار میکند؟).
حالت stealth، حالت «magic» و قابلیتهای جایگزین ضدبات (anti-bot fallback) که در مستندات آمدهاند خارج از موضوع این راهنما هستند و آنها را توصیه نمیکنیم.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| چند صفحه مستندات به شکل متن تمیز برای LLM | نصب با pip و arun() همراه با PruningContentFilterLXML |
| IP خروجی متفاوت در هر درخواست | یک ProxyConfig با گیتوی مسکونی چرخشی |
| همان IP در طول یک روند چندمرحلهای | نشست ثابت ارائهدهنده، بهعلاوه proxy_session_id برای فهرست |
| فهرست ثابتی از IPها | ProxyConfig.from_env("PROXIES") همراه با RoundRobinProxyStrategy |
| خزش از n8n، زبانی دیگر یا یک عامل | سرور Docker با توکن؛ کار با پروکسی در SDK میماند |
| صدها صفحه بدون فشار آوردن به سایت | دستههای کوچک، RateLimiter، check_robots_txt=True |
| زیرساختی برای اجرا ندارید | یک API میزبانیشده مانند Firecrawl |
پرسشهای متداول
آیا Crawl4AI رایگان است؟
بله، این کتابخانه با مجوز Apache 2.0 رایگان است. فایل LICENSE آن یک الزام اضافه دارد: در استفادههای عمومی باید از پروژه نام ببرید، برای نمونه در README یا صفحه «About». هزینههای شما سرور، پروکسی و هر مدل زبانی است که فرا میخوانید.
Crawl4AI به کدام نسخه Python نیاز دارد؟
به گفته PyPI، Python 3.10 یا جدیدتر. ما نسخه 0.9.4 را با Python 3.13 آزمایش کردیم.
آیا Crawl4AI با LLM محلی مانند Ollama کار میکند؟
خروجی Markdown به هیچ مدل زبانی نیاز ندارد. برای استخراج با LLM، مستندات LLMConfig(provider="ollama/llama3.3") را برای یک مدل محلی Ollama و بدون کلید API نشان میدهد.
تفاوت Crawl4AI و Scrapy چیست؟
Scrapy درخواستهای ساده HTTP میفرستد و بهطور پیشفرض JavaScript اجرا نمیکند؛ Crawl4AI هر صفحه را در Chromium رندر میکند و Markdown برمیگرداند. Scrapy برای خزشهای بزرگ روی HTML ایستا مناسب است (Scrapy با پروکسی)؛ Crawl4AI برای صفحههایی که به مدل زبانی داده میشوند.
آیا میتوان Crawl4AI را از Node.js یا زبانی دیگر به کار برد؟
خود کتابخانه Python است. از زبانهای دیگر، REST API سرور Docker را فرا بخوانید، برای نمونه POST /md با توکن در هدر.
وقتی سایتی Crawl4AI را مسدود میکند چه باید کرد؟
اول سرعت را کم کنید: صفحههای موازی کمتر، تأخیر طولانیتر و مکث پس از هر 429. robots.txt و شرایط استفاده سایت را بررسی کنید و ببینید API یا خوراک داده رسمی وجود دارد یا نه. اگر سایت همچنان درخواستها را رد میکند، متوقف شوید؛ جنبه حقوقی در آیا اسکرپینگ وب قانونی است؟ آمده است.
خلاصه
Crawl4AI صفحهها را به Markdown تبدیل میکند که مدل زبانی میتواند بخواند. برای کار با پروکسی از SDK استفاده کنید: یک ProxyConfig برای گیتوی چرخشی، RoundRobinProxyStrategy برای فهرست ثابت و SOCKS5 بدون رمز عبور. سرور Docker به توکن نیاز دارد و پروکسی را در درخواست نمیپذیرد. check_robots_txt را روشن کنید، یک User-Agent صادقانه بفرستید و بگذارید RateLimiter سرعت را تعیین کند. برای IP خروجی در کشورهای مختلف یا یک آدرس ثابت، خدمات پروکسی ما را ببینید.