Uma equipe quer que o seu assistente interno responda a perguntas com base na documentação do produto. Ela baixa as páginas com Requests e entrega o HTML ao modelo, mas menus, banners de cookies e scripts ocupam metade do texto, e as páginas que carregam o conteúdo com JavaScript chegam quase vazias. O Crawl4AI abre as mesmas páginas em um navegador real e devolve o corpo como Markdown limpo. No segundo dia, os problemas mudam: na metade de uma coleta de 300 páginas, o site começa a responder 429, e a instalação com Docker no servidor de build devolve só "connection reset".
Este guia mostra como o Crawl4AI transforma uma página em Markdown, a instalação via pip e Docker, os proxies, o uso rotativo e sticky e as configurações de robots.txt e de ritmo que mantêm a coleta respeitosa com o site. Executamos todos os exemplos em Python com Crawl4AI 0.9.4 e Python 3.13, por meio de um proxy local de teste com usuário e senha. O Docker não estava disponível na máquina de teste, então os comandos de Docker seguem o guia oficial.
O que é o Crawl4AI e para que ele serve?
O Crawl4AI é uma biblioteca Python de código aberto que busca páginas web e devolve o conteúdo delas em uma forma que um modelo de linguagem consegue ler. Ele controla o Chromium por meio do Playwright, então as páginas montadas com JavaScript são renderizadas antes de serem lidas (páginas estáticas e dinâmicas). Uma única coleta devolve a página como Markdown, um Markdown "fit" mais curto, sem menus e rodapés, os links, a lista de mídia e, quando solicitado, uma captura de tela ou um PDF. Com uma estratégia de extração, ele também pode preencher um schema JSON.
A biblioteca exige Python 3.10 ou mais recente; a versão 0.9.4 saiu no PyPI em 23 de setembro de 2026. Você pode usá-la como SDK Python, como servidor Docker com uma API REST e um endpoint MCP, ou pela ferramenta de linha de comando crwl.
O Crawl4AI é antes de tudo um crawler: ele visita páginas e segue links, e o que você extrai fica por sua conta (web crawling e web scraping). A comparação com as ferramentas de scraping com IA em geral está em Como funciona um AI web scraper.
Como o Crawl4AI transforma uma página em Markdown?
Uma chamada a arun() passa por estas etapas:
- O navegador inicia com as configurações do
BrowserConfig: modo headless, oUser-Agente, se definido ali, um proxy para o navegador inteiro. - O robots.txt é verificado se o
CrawlerRunConfigtivercheck_robots_txt=True. Uma URL proibida nunca é aberta; o resultado vem com status403e "Access denied by robots.txt". - A página carrega no Chromium, pelo proxy da execução, se houver um, e o JavaScript dela roda.
- O HTML é limpo: scripts e estilos são descartados, links e mídia são coletados.
- O
DefaultMarkdownGeneratorescreve oraw_markdown. - Um
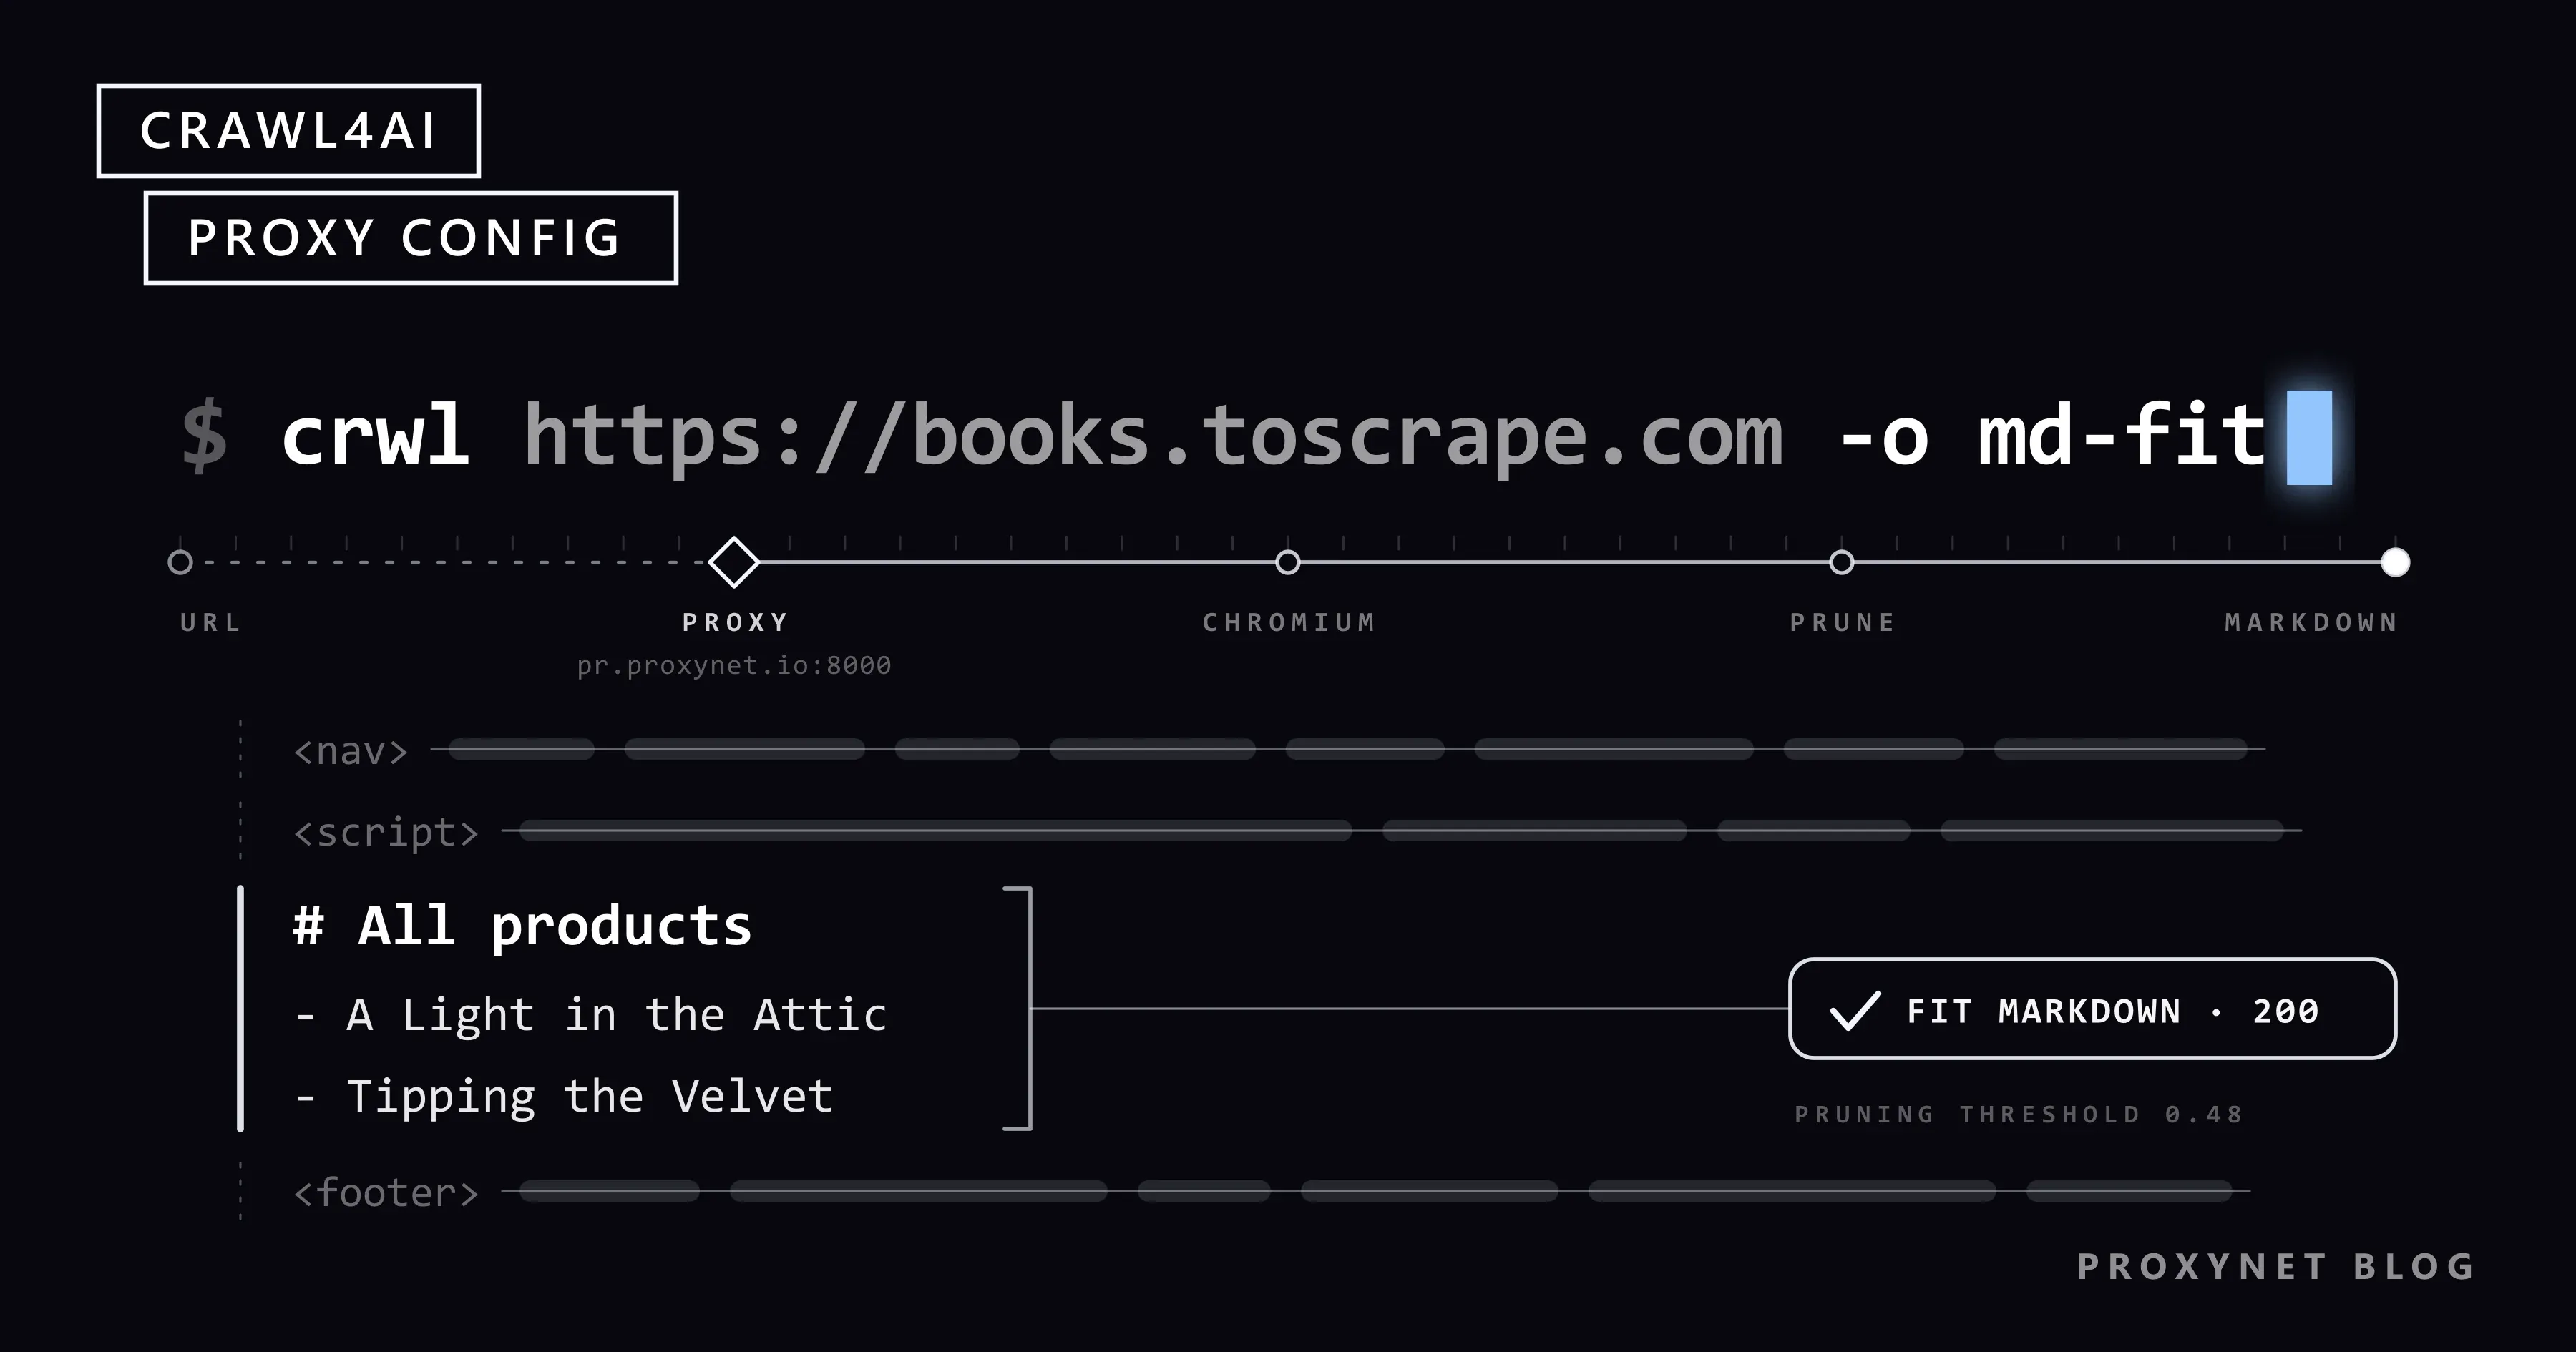
content_filterescreve ofit_markdown: oPruningContentFilterLXMLmantém os blocos com mais texto, e oBM25ContentFilter, os blocos que correspondem a uma consulta. Sem filtro, ofit_markdownfica vazio. - Um
CrawlResultvolta comsuccess,status_code,error_message,markdownelinks.
Em uma das nossas páginas de teste, o Markdown bruto tinha 1.241 caracteres e o fit Markdown, 712: o menu e o rodapé saíram, o artigo ficou. Um aviso de cookies permaneceu, porque o filtro pontua a densidade de texto e de links, não o significado; excluded_selector=".cookie" no CrawlerRunConfig o removeu.
Como instalar o Crawl4AI com pip ou Docker?
O caminho via pip instala a biblioteca e uma build do Chromium. O caminho via Docker inicia um servidor que outros programas chamam por HTTP.
# SDK Python
pip install -U crawl4ai
crawl4ai-setup      # instala o navegador do Playwright que o Crawl4AI usa
crawl4ai-doctor     # roda uma coleta de teste para verificar a instalação

# Servidor Docker: a 0.9.0 e as versões seguintes exigem um token
export CRAWL4AI_API_TOKEN="$(openssl rand -hex 32)"
docker run -d -p 11235:11235 --name crawl4ai --shm-size=1g \
  -e CRAWL4AI_API_TOKEN="$CRAWL4AI_API_TOKEN" \
  unclecode/crawl4ai:0.9.4

curl http://localhost:11235/health    # responde sem token
curl -X POST http://localhost:11235/md \
  -H "Authorization: Bearer $CRAWL4AI_API_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://quotes.toscrape.com/", "f": "fit"}'
O guia de self-hosting usa a tag latest; uma tag de versão evita que uma atualização da imagem mude o comportamento do servidor sem que você perceba. As páginas /playground e /dashboard têm um campo para o token no topo.
As três formas de rodar o Crawl4AI diferem sobretudo no lugar onde o proxy pode ficar:
| Forma | Instalação | Onde fica o proxy | robots.txt e ritmo | Indicada para |
|---|---|---|---|---|
| SDK Python | pip install, crawl4ai-setup | proxy_config no CrawlerRunConfig ou no BrowserConfig; proxy_rotation_strategy para uma lista | check_robots_txt, SemaphoreDispatcher, RateLimiter | Qualquer trabalho que precise do seu próprio proxy |
| Servidor Docker | docker run com token, porta 11235 | Não na requisição (HTTP 400) | check_robots_txt permitido na requisição | Chamadas de outras linguagens, do n8n ou de agentes |
CLI crwl | Vem com o pip | Arquivo de configuração do navegador, -B | Arquivo de configuração do crawler, -C | Uma página para Markdown |
Como obter Markdown na sua primeira coleta em Python?
O script abre uma página por um proxy, verifica o robots.txt primeiro e imprime o tamanho das duas versões de Markdown. O endereço do proxy vem de uma variável de ambiente, então a senha fica fora do código.
"""Coleta uma página por um proxy e imprime o Markdown dela."""
import asyncio
import os
import sys

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    DefaultMarkdownGenerator,
    ProxyConfig,
    PruningContentFilterLXML,
)

URL = sys.argv[1] if len(sys.argv) > 1 else "https://quotes.toscrape.com/"


async def main():
    # PROXY_URL=http://user:pass@pr.proxynet.io:8000, mantido fora do código
    proxy = ProxyConfig.from_string(os.environ["PROXY_URL"])

    browser_config = BrowserConfig(
        headless=True,
        user_agent="NorthwindDocsBot/1.0 (+https://example.com/bot)",
    )
    run_config = CrawlerRunConfig(
        proxy_config=proxy,
        check_robots_txt=True,
        cache_mode=CacheMode.BYPASS,
        markdown_generator=DefaultMarkdownGenerator(
            content_filter=PruningContentFilterLXML(threshold=0.48)
        ),
    )

    async with AsyncWebCrawler(config=browser_config) as crawler:
        result = await crawler.arun(URL, config=run_config)

    if not result.success:
        print(f"failed: {result.status_code} {result.error_message}")
        return

    md = result.markdown
    print(f"status {result.status_code}")
    print(f"raw_markdown: {len(md.raw_markdown)} characters")
    print(f"fit_markdown: {len(md.fit_markdown)} characters")
    print(md.fit_markdown[:400])


asyncio.run(main())
No quotes.toscrape.com, um site de prática para scraping, ele imprimiu:
status 200
raw_markdown: 4375 characters
fit_markdown: 3663 characters
CacheMode.BYPASS busca a página toda vez; sem ele, as URLs repetidas vêm do cache local. Use o PruningContentFilterLXML: na 0.9.4, o antigo PruningContentFilter imprime um aviso de descontinuação (deprecation warning).
Como configurar um proxy no Crawl4AI?
Um proxy é um ProxyConfig com server, username e password, e ele vai para um de dois lugares:
from crawl4ai import BrowserConfig, CrawlerRunConfig, ProxyConfig

proxy = ProxyConfig(server="http://pr.proxynet.io:8000", username="user", password="pass")

run_config = CrawlerRunConfig(proxy_config=proxy)    # só esta execução
browser_config = BrowserConfig(proxy_config=proxy)   # toda página que este navegador abre
O guia oficial de proxy recomenda o CrawlerRunConfig, para que cada execução leve o próprio proxy. As duas formas funcionaram no nosso teste.
O ProxyConfig.from_string() lê http://user:pass@host:port, host:port:user:pass, host:port e socks5://host:port. O ProxyConfig.from_env("PROXIES") lê uma lista separada por vírgulas de uma variável de ambiente. O antigo parâmetro proxy= ainda funciona, mas imprime um aviso de descontinuação.
SOCKS5 com senha não funciona. Com socks5:// e um usuário, em qualquer uma das duas formas, a nossa coleta falhou com "Browser does not support socks5 proxy authentication". O limite é do Chromium (Playwright com proxy). Use o endpoint HTTP do proxy ou libere o IP do seu servidor no painel do proxy (whitelist de IP) e conecte sem senha (SOCKS e HTTP proxy).
Para verificar o proxy, faça a coleta de uma página que mostra o IP do visitante.
Rotativo ou sticky: quando você precisa do RoundRobinProxyStrategy?
Depende de para onde aponta o endereço do seu proxy.
Um gateway rotativo é um único endereço, como pr.proxynet.io:8000, atrás do qual o provedor troca o IP de saída. Com os Proxies rotativos ou com os Proxies residenciais em modo rotativo, um único ProxyConfig é tudo de que o Crawl4AI precisa. A demonstração da página oficial de proxy compara o IP que o site viu com ProxyConfig.ip; com um gateway, essa verificação sempre acusa divergência, porque o IP de saída nunca é o endereço do gateway.
Uma lista fixa de IPs, por exemplo de um plano de Proxies de datacenter ou de Proxies ISP, é onde o RoundRobinProxyStrategy ajuda: cada requisição recebe o próximo proxy da lista. Com proxy_session_id, as requisições com o mesmo ID mantêm o mesmo proxy até passarem proxy_session_ttl segundos:
"""Alterna entre uma lista fixa de proxies ou mantém um deles durante uma sessão inteira."""
import asyncio

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    ProxyConfig,
    RoundRobinProxyStrategy,
)

# PROXIES="http://user:pass@203.0.113.10:8000,http://user:pass@203.0.113.11:8000"
strategy = RoundRobinProxyStrategy(ProxyConfig.from_env("PROXIES"))

rotate = CrawlerRunConfig(proxy_rotation_strategy=strategy, cache_mode=CacheMode.BYPASS)
sticky = CrawlerRunConfig(
    proxy_rotation_strategy=strategy,
    proxy_session_id="catalog-1",  # toda requisição com este id recebe o mesmo proxy
    proxy_session_ttl=600,         # segundos; depois disso a sessão escolhe outro
    cache_mode=CacheMode.BYPASS,
)


async def main(base):
    async with AsyncWebCrawler(config=BrowserConfig(headless=True)) as crawler:
        for label, config in (("rotate", rotate), ("sticky", sticky)):
            for page in range(1, 4):
                result = await crawler.arun(f"{base}/catalog?page={page}", config=config)
                print(label, page, result.status_code, config.proxy_config.server)


asyncio.run(main("https://shop.example.com"))
Com dois proxies locais, as requisições rotate se alternaram e as sticky mantiveram um único proxy. Os parâmetros de sessão estão no código-fonte da 0.9.4, mas não na página de documentação de proxy, então confira-os de novo depois de cada atualização.
Mantenha as duas camadas separadas. A sessão sticky do Crawl4AI escolhe a mesma entrada da sua lista; atrás de um gateway rotativo, o IP de saída só fica fixo se o provedor o segurar, como fazem os Proxies de sessão fixa por 1 a 60 minutos. Os modos estão explicados em rotação de IP, e a rotação para clientes HTTP simples, em como rotacionar proxies em Python.
Por que uma requisição ao Docker não pode levar um proxy?
Desde a 0.9.0, o servidor Docker é seguro por padrão. Um corpo de requisição com proxy ou proxy_config recebe HTTP 400, assim como js_code, headers, cookies, magic e vários outros campos (notas de migração da 0.9.0). O motivo é o server-side request forgery (SSRF): sem esse bloqueio, quem chama a API poderia mandar o navegador do servidor por qualquer proxy ou para endereços internos.
As notas dizem para configurar essas opções no servidor, mas no código-fonte da 0.9.4 um guarda de saída (egress guard) remove qualquer proxy_config, inclusive um definido no config.yml, e passa o Chromium pelo proxy de filtragem do próprio servidor. O código-fonte também lê um proxy HTTP upstream de CRAWL4AI_UPSTREAM_PROXY ou HTTPS_PROXY; isso não está documentado, e não conseguimos testar. Para usar o seu próprio proxy, rode o SDK no seu próprio serviço.
Como configurar robots.txt, ritmo e concorrência?
check_robots_txt é False por padrão. Testamos o comportamento da 0.9.4 contra sites locais:
- Um caminho proibido devolve status
403, e a página nunca é requisitada. - Um robots.txt que responde
500conta como "tudo permitido", assim como um timeout de 2 segundos e um erro de rede. A RFC 9309 diz que, em erros de servidor, o crawler deve presumir proibição total. - As regras ficam em cache por 7 dias. A RFC 9309 diz que uma cópia em cache não deve ser usada por mais de 24 horas;
crawler.robots_parser.clear_cache()esvazia o cache. - O robots.txt é buscado direto da sua máquina, não pelo proxy, com um
User-Agentgenérico doaiohttp. - As regras são comparadas com o
BrowserConfig.user_agent. O padrão é uma string do Chrome, então umDisallowpara o nome do seu bot só vale quando o seuUser-Agenttraz esse nome. Um caminho sob/privateabriu com a string padrão e devolveu403comNorthwindDocsBot/1.0.
Para trabalhos sensíveis, verifique o robots.txt você mesmo antes (robots.txt, O que é User-Agent?).
O ritmo é definido no dispatcher. SemaphoreDispatcher(semaphore_count=3) mantém no máximo três páginas abertas ao mesmo tempo (concorrência e paralelismo). O RateLimiter espera entre as requisições a um mesmo domínio, mais ou menos dobra a espera depois de um 429 ou 503, até o max_delay, e a encurta depois de sucessos. Ele não busca de novo uma página recusada: o resultado volta com 429, e a nova tentativa fica por sua conta. O script abaixo faz a coleta em lotes de três e dá às páginas recusadas mais duas rodadas:
"""Coleta as páginas de um site em ritmo respeitoso e salva cada uma como Markdown."""
import asyncio
import os
import re
from pathlib import Path

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    DefaultMarkdownGenerator,
    ProxyConfig,
    PruningContentFilterLXML,
    RateLimiter,
    SemaphoreDispatcher,
)

BASE = os.environ.get("DOCS_BASE", "https://docs.example.com")
URLS = [f"{BASE}/docs/{n}" for n in range(1, 13)] + [f"{BASE}/private/report"]
OUT = Path("pages")
BATCH = 3                 # páginas abertas ao mesmo tempo
PAUSE = 5.0               # segundos entre dois lotes
RETRY_CODES = {429, 503}  # valem outra tentativa mais tarde
ROUNDS = 3                # primeira passada mais duas rodadas de nova tentativa
ROUND_PAUSE = 60          # segundos antes de uma rodada de nova tentativa; dobra a cada rodada


def file_name(url):
    return re.sub(r"[^a-z0-9]+", "-", url.lower()).strip("-") + ".md"


async def crawl_round(crawler, urls, run_config, dispatcher):
    """Coleta as urls em lotes pequenos e devolve as que devem ser tentadas de novo depois."""
    retry = []
    for i in range(0, len(urls), BATCH):
        results = await crawler.arun_many(
            urls[i : i + BATCH], config=run_config, dispatcher=dispatcher
        )
        for r in results:
            if r.success and r.status_code == 200:
                (OUT / file_name(r.url)).write_text(r.markdown.fit_markdown, encoding="utf-8")
                print(f"saved  {r.url}")
            elif r.status_code in RETRY_CODES:
                retry.append(r.url)
                print(f"later  {r.status_code} {r.url}")
            else:
                print(f"skip   {r.status_code} {r.url}: {r.error_message}")
        await asyncio.sleep(PAUSE)
    return retry


async def main():
    OUT.mkdir(exist_ok=True)
    browser_config = BrowserConfig(
        headless=True,
        user_agent="NorthwindDocsBot/1.0 (+https://example.com/bot)",
    )
    run_config = CrawlerRunConfig(
        proxy_config=ProxyConfig.from_string(os.environ["PROXY_URL"]),
        check_robots_txt=True,
        cache_mode=CacheMode.BYPASS,
        page_timeout=30000,
        markdown_generator=DefaultMarkdownGenerator(
            content_filter=PruningContentFilterLXML(threshold=0.48)
        ),
    )
    # Um único dispatcher para a execução inteira: o RateLimiter mantém o ritmo mais lento que aprendeu com os 429
    dispatcher = SemaphoreDispatcher(
        semaphore_count=BATCH,
        rate_limiter=RateLimiter(base_delay=(1.0, 3.0), max_delay=60.0, max_retries=3),
    )

    pending = list(URLS)
    async with AsyncWebCrawler(config=browser_config) as crawler:
        for round_no in range(ROUNDS):
            if round_no:
                wait = ROUND_PAUSE * 2 ** (round_no - 1)
                print(f"round {round_no + 1}: {len(pending)} pages again in {wait} s")
                await asyncio.sleep(wait)
            pending = await crawl_round(crawler, pending, run_config, dispatcher)
            if not pending:
                break

    print(f"done, {len(pending)} pages still refused")


asyncio.run(main())
Apontamos DOCS_BASE para um site local que responde 429 a cada quarta requisição sob /docs/ e proíbe /private, e definimos ROUND_PAUSE como 5 segundos para o teste. Saída resumida:
saved  http://192.168.1.2:28130/docs/1
saved  http://192.168.1.2:28130/docs/2
saved  http://192.168.1.2:28130/docs/3
later  429 http://192.168.1.2:28130/docs/4
...
later  429 http://192.168.1.2:28130/docs/11
saved  http://192.168.1.2:28130/docs/12
skip   403 http://192.168.1.2:28130/private/report: Access denied by robots.txt
round 2: 3 pages again in 5 s
saved  http://192.168.1.2:28130/docs/4
saved  http://192.168.1.2:28130/docs/9
saved  http://192.168.1.2:28130/docs/11
done, 0 pages still refused
O próprio log do Crawl4AI também imprime "Blocked by anti-bot protection: HTTP 429 Too Many Requests" para cada página recusada. Como tratar um cabeçalho Retry-After de verdade está explicado em códigos de status HTTP no web scraping.
Qual é a diferença entre Crawl4AI e Firecrawl?
Os dois transformam páginas em Markdown para modelos de linguagem; a diferença está na forma de rodá-los.
| Crawl4AI | Firecrawl | |
|---|---|---|
| Licença | Apache 2.0 mais uma exigência de atribuição | AGPL-3.0 |
| Forma principal | Uma biblioteca Python; servidor Docker opcional | Uma API hospedada; self-hosting possível |
| Partes no self-hosting | Um contêiner | API, workers, Playwright, Redis, RabbitMQ, PostgreSQL |
| Custo | O seu servidor, o proxy e qualquer LLM | Plano da API ou os seus próprios servidores |
O guia de self-hosting do Firecrawl observa que a API self-hosted não tem autenticação por padrão. O Crawl4AI se encaixa em uma equipe Python que quer rodar as próprias coletas e os próprios proxies.
Como usar o Crawl4AI com MCP e n8n?
O servidor Docker expõe MCP em /mcp/sse e /mcp/ws, com as ferramentas md, html, screenshot, pdf, execute_js, crawl e ask. O comando do guia para o Claude Code não tem token, mas os endpoints MCP ficam atrás da mesma checagem de token que a API, então adicione o cabeçalho:
claude mcp add --transport sse c4ai-sse http://localhost:11235/mcp/sse \
  --header "Authorization: Bearer $CRAWL4AI_API_TOKEN"
Clientes WebSocket que não conseguem definir cabeçalhos podem passar ?token=. O protocolo está explicado em O que é MCP?, e como dar a um agente um navegador completo, em Playwright MCP.
No n8n, um nó HTTP Request envia POST /md com o cabeçalho Bearer e um corpo como {"url": "https://quotes.toscrape.com/", "f": "fit"}; a página volta no campo markdown (web scraping com n8n).
Casos de uso
- Documentação para RAG: a documentação do produto como Markdown para um índice de busca, atrás das checagens de acesso seguro à web para LLMs.
- Entrada limpa para agentes: fit Markdown em vez de HTML bruto (agentic web scraping).
- Checagem de preços: páginas de produto transformadas em JSON com um schema CSS (monitoramento de preços).
- Inventário do seu próprio site: todas as páginas e links, para auditorias de conteúdo e links quebrados (web crawler).
- Dados de catálogo: nomes, especificações e preços de páginas públicas de catálogo (extração de dados).
Erros comuns
docker runsem token, ou-e CRAWL4AI_API_TOKENsem valor: "connection reset" vindo de um contêiner que parece saudável.proxy_configem uma requisição REST: o servidor responde400.socks5://com senha: o Chromium recusa.- Um gateway rotativo listado várias vezes no
RoundRobinProxyStrategy: o gateway já faz a rotação. - Esperar
fit_markdownsem umcontent_filter: ele fica vazio. - Supor que o robots.txt é verificado: a verificação vem desligada por padrão, e um robots.txt que não carrega conta como "permitido".
- Concorrência alta sem
RateLimiter: dez páginas em paralelo em um site pequeno parecem uma rajada, e as respostas429vêm em seguida. - Trocar de IP para forçar um site que respondeu
429: em vez disso, reduza o ritmo (como funciona a detecção de bots).
O modo stealth, o modo "magic" e os recursos de fallback anti-bot da documentação ficam fora deste guia, e não os recomendamos.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Algumas páginas de documentação como texto limpo para um LLM | pip install, arun() com PruningContentFilterLXML |
| Um IP de saída diferente a cada requisição | Um ProxyConfig com um gateway residencial rotativo |
| O mesmo IP ao longo de um fluxo de várias etapas | Uma sessão sticky do provedor, mais proxy_session_id para uma lista |
| Uma lista fixa de IPs | ProxyConfig.from_env("PROXIES") com RoundRobinProxyStrategy |
| Coleta a partir do n8n, de outra linguagem ou de um agente | Um servidor Docker com token; o trabalho com proxy fica no SDK |
| Centenas de páginas sem sobrecarregar o site | Lotes pequenos, RateLimiter, check_robots_txt=True |
| Nenhuma infraestrutura para manter | Uma API hospedada como o Firecrawl |
Perguntas frequentes
O Crawl4AI é gratuito?
Sim, a biblioteca é gratuita sob a licença Apache 2.0. O arquivo LICENSE dela acrescenta a exigência de dar crédito ao projeto em usos públicos, por exemplo em um README ou em uma página "Sobre". Os seus custos são o servidor, o proxy e qualquer modelo de linguagem que você chamar.
Qual versão do Python o Crawl4AI exige?
Python 3.10 ou mais recente, segundo o PyPI. Testamos a versão 0.9.4 com Python 3.13.
O Crawl4AI funciona com um LLM local como o Ollama?
A saída em Markdown não precisa de modelo de linguagem. Para a extração com LLM, a documentação mostra LLMConfig(provider="ollama/llama3.3") para um modelo local do Ollama, sem chave de API.
Qual é a diferença entre Crawl4AI e Scrapy?
O Scrapy envia requisições HTTP simples e, por padrão, não executa JavaScript; o Crawl4AI renderiza cada página no Chromium e devolve Markdown. O Scrapy se encaixa em coletas grandes de HTML estático (Scrapy com proxy); o Crawl4AI, em páginas que vão para um modelo de linguagem.
Posso usar o Crawl4AI a partir do Node.js ou de outra linguagem?
A biblioteca em si é Python. De outras linguagens, chame a API REST do servidor Docker, por exemplo POST /md com o token no cabeçalho.
O que fazer quando um site bloqueia o Crawl4AI?
Primeiro, reduza o ritmo: menos páginas em paralelo, esperas mais longas e uma pausa depois de cada 429. Verifique o robots.txt e os termos do site e procure uma API ou um feed oficial. Se o site continuar recusando, pare; o lado jurídico está em Web scraping é legal?.
Em resumo
O Crawl4AI transforma páginas em Markdown que um modelo de linguagem consegue ler. Para o trabalho com proxy, use o SDK: um ProxyConfig para um gateway rotativo, RoundRobinProxyStrategy para uma lista fixa e nada de senha no SOCKS5. O servidor Docker exige um token e não aceita proxy na requisição. Ative o check_robots_txt, envie um User-Agent honesto e deixe um RateLimiter definir o ritmo. Para saídas em muitos países ou um endereço fixo, veja os nossos serviços de proxy.