Bir ekip, şirket içi asistanının soruları ürün dokümantasyonuna bakarak yanıtlamasını istiyor. Sayfaları Requests ile indirip HTML'i modele veriyorlar, ama metnin yarısını menüler, çerez bantları ve script'ler kaplıyor; içeriğini JavaScript ile yükleyen sayfalar ise neredeyse boş geliyor. Crawl4AI aynı sayfaları gerçek bir tarayıcıda açıyor ve gövdeyi temiz Markdown olarak döndürüyor. İkinci gün sorunlar değişiyor: 300 sayfalık bir taramanın ortasında site 429 yanıtı vermeye başlıyor, derleme sunucusundaki Docker kurulumu ise yalnızca "connection reset" döndürüyor.
Bu yazıda Crawl4AI'ın bir sayfayı nasıl Markdown'a çevirdiğini, pip ve Docker kurulumunu, proxy ayarını, rotating ve sticky kullanımı, taramayı ölçülü tutan robots.txt ve hız ayarlarını anlatıyoruz. Tüm Python örneklerini Crawl4AI 0.9.4 ve Python 3.13 ile, kullanıcı adı ve parola isteyen yerel bir test proxy'si üzerinden çalıştırdık. Test makinesinde Docker yoktu; bu yüzden Docker komutları resmî kılavuzu izliyor.
Crawl4AI nedir ve ne için kullanılır?
Crawl4AI, web sayfalarını indirip içeriklerini bir dil modelinin okuyabileceği biçimde döndüren açık kaynak bir Python kütüphanesidir. Chromium'u Playwright üzerinden yönetir, bu yüzden JavaScript ile oluşturulan sayfalar okunmadan önce render edilir (statik ve dinamik sayfalar). Tek bir tarama size şunları döndürür: sayfanın Markdown hâli, menü ve footer'ı atılmış daha kısa bir "fit" Markdown, bağlantılar, medya listesi ve istenirse bir ekran görüntüsü ya da PDF. Bir çıkarma stratejisi (extraction strategy) eklendiğinde bir JSON şemasını da doldurabilir.
Kütüphane Python 3.10 ya da daha yeni bir sürüm ister; 0.9.4 sürümü 23 Eylül 2026'da PyPI'da yayımlandı. Crawl4AI'ı bir Python SDK'sı olarak, REST API ve MCP endpoint'i sunan bir Docker sunucusu olarak ya da crwl komut satırı aracıyla kullanabilirsiniz.
Crawl4AI her şeyden önce bir crawler'dır: sayfaları ziyaret eder ve bağlantıları izler, sayfadan neyi çıkaracağınız size kalır (web crawling ile web scraping farkı). Yapay zekâ destekli scraping (veri kazıma) araçlarıyla genel olarak nasıl karşılaştırıldığını AI Web Scraper Nedir ve Nasıl Çalışır? yazımızda anlattık.
Crawl4AI bir sayfayı nasıl Markdown'a çevirir?
Bir arun() çağrısı şu adımlardan geçer:
- Tarayıcı
BrowserConfigayarlarıyla başlar: headless mod (pencere açmadan çalışma),User-Agentve orada tanımlandıysa tarayıcının tamamı için bir proxy. CrawlerRunConfigiçindecheck_robots_txt=Truevarsa robots.txt kontrol edilir. İzin verilmeyen URL hiç açılmaz; sonuç403durum kodu ve "Access denied by robots.txt" mesajıyla döner.- Sayfa Chromium'da yüklenir ve JavaScript'i çalışır. Çalıştırmaya (run) bir proxy verildiyse istek onun üzerinden gider.
- HTML temizlenir: script'ler ve stiller atılır, bağlantılar ve medya toplanır.
DefaultMarkdownGenerator,raw_markdownalanını yazar.- Bir
content_filter,fit_markdownalanını yazar:PruningContentFilterLXMLmetin ağırlıklı blokları,BM25ContentFilterise bir sorguyla eşleşen blokları tutar. Filtre yoksafit_markdownboş kalır. - Bir
CrawlResultdöner: içindesuccess,status_code,error_message,markdownvelinksbulunur.
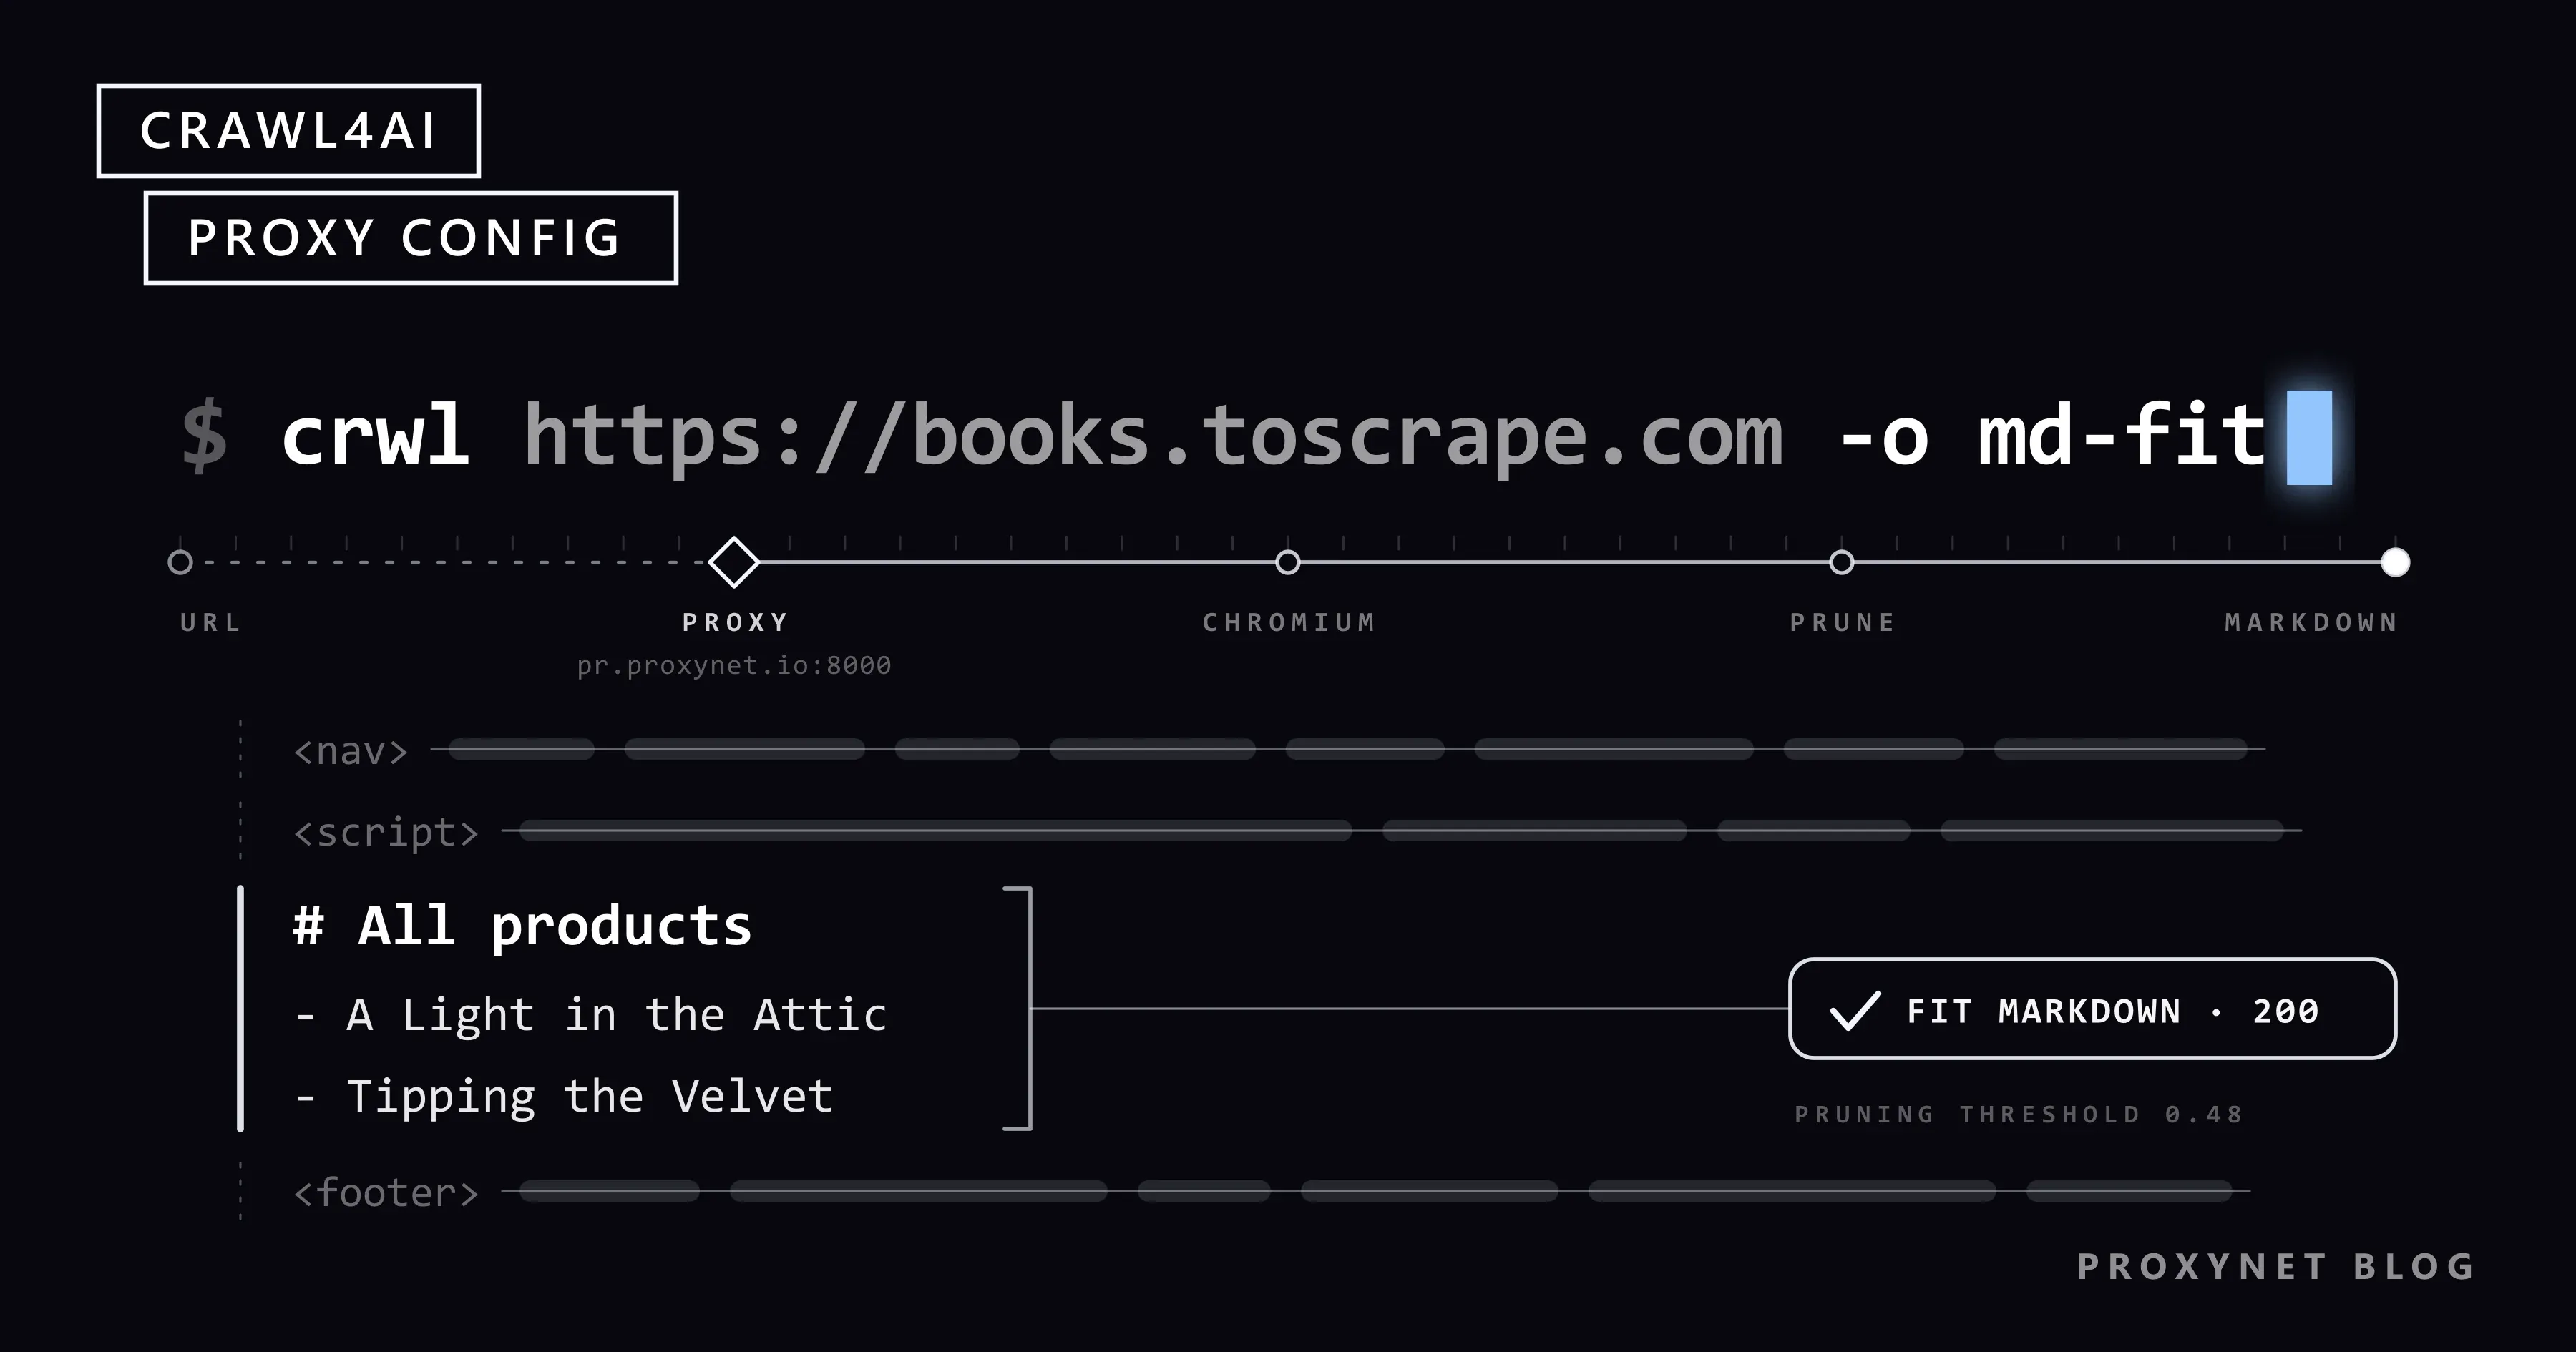
Test sayfalarımızdan birinde ham Markdown 1.241, fit Markdown 712 karakter tuttu: menü ve footer gitmiş, makale kalmıştı. Bir çerez bildirimi ise yerinde durdu, çünkü filtre anlama değil, metin ve bağlantı yoğunluğuna göre puan verir. CrawlerRunConfig içine yazdığımız excluded_selector=".cookie" onu da kaldırdı.
Crawl4AI pip ya da Docker ile nasıl kurulur?
pip yolu kütüphaneyi ve bir Chromium sürümünü kurar. Docker yolu ise başka programların HTTP üzerinden çağırdığı bir sunucu başlatır.
# Python SDK
pip install -U crawl4ai
crawl4ai-setup      # Crawl4AI'ın kullandığı Playwright tarayıcısını kurar
crawl4ai-doctor     # kurulumu kontrol etmek için bir deneme taraması yapar

# Docker sunucusu: 0.9.0 ve sonrası token ister
export CRAWL4AI_API_TOKEN="$(openssl rand -hex 32)"
docker run -d -p 11235:11235 --name crawl4ai --shm-size=1g \
  -e CRAWL4AI_API_TOKEN="$CRAWL4AI_API_TOKEN" \
  unclecode/crawl4ai:0.9.4

curl http://localhost:11235/health    # token olmadan yanıt verir
curl -X POST http://localhost:11235/md \
  -H "Authorization: Bearer $CRAWL4AI_API_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://quotes.toscrape.com/", "f": "fit"}'
Resmî self-hosting kılavuzu latest etiketini kullanıyor. Sürüm numaralı bir etiket ise imaj güncellendiğinde sunucunun davranışının siz fark etmeden değişmesini önler. /playground ve /dashboard sayfalarının en üstünde token'ı yazacağınız bir alan var.
Crawl4AI'ı çalıştırmanın üç yolu arasındaki asıl fark, proxy'nin nereye yazılabildiğidir:
| Yol | Kurulum | Proxy nereye yazılır | robots.txt ve hız | Uygun olduğu iş |
|---|---|---|---|---|
| Python SDK | pip install, crawl4ai-setup | CrawlerRunConfig ya da BrowserConfig içinde proxy_config; liste için proxy_rotation_strategy | check_robots_txt, SemaphoreDispatcher, RateLimiter | Kendi proxy'nizi gerektiren her iş |
| Docker sunucusu | Token ile docker run, port 11235 | İstekte yazılamaz (HTTP 400) | İstekte check_robots_txt kullanılabilir | Başka dillerden, n8n'den ya da ajanlardan gelen çağrılar |
crwl CLI | pip ile birlikte gelir | Tarayıcı yapılandırma dosyası, -B | Crawler yapılandırma dosyası, -C | Tek bir sayfayı Markdown'a çevirmek |
Python'da ilk taramanızdan nasıl Markdown alırsınız?
Aşağıdaki betik tek bir sayfayı proxy üzerinden açar, önce robots.txt'yi kontrol eder ve iki Markdown sürümünün boyutunu yazdırır. Proxy adresi bir ortam değişkeninden gelir; böylece parola kodun dışında kalır.
"""Tek bir sayfayı proxy üzerinden tara ve Markdown'ını yazdır."""
import asyncio
import os
import sys

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    DefaultMarkdownGenerator,
    ProxyConfig,
    PruningContentFilterLXML,
)

URL = sys.argv[1] if len(sys.argv) > 1 else "https://quotes.toscrape.com/"


async def main():
    # PROXY_URL=http://user:pass@pr.proxynet.io:8000, kodun dışında tutulur
    proxy = ProxyConfig.from_string(os.environ["PROXY_URL"])

    browser_config = BrowserConfig(
        headless=True,
        user_agent="NorthwindDocsBot/1.0 (+https://example.com/bot)",
    )
    run_config = CrawlerRunConfig(
        proxy_config=proxy,
        check_robots_txt=True,
        cache_mode=CacheMode.BYPASS,
        markdown_generator=DefaultMarkdownGenerator(
            content_filter=PruningContentFilterLXML(threshold=0.48)
        ),
    )

    async with AsyncWebCrawler(config=browser_config) as crawler:
        result = await crawler.arun(URL, config=run_config)

    if not result.success:
        print(f"failed: {result.status_code} {result.error_message}")
        return

    md = result.markdown
    print(f"status {result.status_code}")
    print(f"raw_markdown: {len(md.raw_markdown)} characters")
    print(f"fit_markdown: {len(md.fit_markdown)} characters")
    print(md.fit_markdown[:400])


asyncio.run(main())
Scraping alıştırması için hazırlanmış quotes.toscrape.com sitesinde şu çıktıyı verdi:
status 200
raw_markdown: 4375 characters
fit_markdown: 3663 characters
CacheMode.BYPASS sayfayı her seferinde yeniden indirir; bu ayar olmadan tekrarlanan URL'ler yerel önbellekten gelir. Filtre olarak PruningContentFilterLXML kullanın: 0.9.4'te eski PruningContentFilter bir kullanımdan kaldırma (deprecation) uyarısı basıyor.
Crawl4AI'da proxy nasıl tanımlanır?
Proxy, server, username ve password alanları olan bir ProxyConfig nesnesidir ve iki yerden birine yazılır:
from crawl4ai import BrowserConfig, CrawlerRunConfig, ProxyConfig

proxy = ProxyConfig(server="http://pr.proxynet.io:8000", username="user", password="pass")

run_config = CrawlerRunConfig(proxy_config=proxy)    # yalnızca bu çalıştırma
browser_config = BrowserConfig(proxy_config=proxy)   # bu tarayıcının açtığı her sayfa
Resmî proxy kılavuzu CrawlerRunConfig'i öneriyor; böylece her çalıştırma kendi proxy'sini taşır. Testimizde ikisi de çalıştı.
ProxyConfig.from_string() şu biçimleri okur: http://user:pass@host:port, host:port:user:pass, host:port ve socks5://host:port. ProxyConfig.from_env("PROXIES") bir ortam değişkenindeki virgülle ayrılmış listeyi okur. Eski proxy= parametresi hâlâ çalışıyor, ama kullanımdan kaldırma uyarısı basıyor.
Parolalı SOCKS5 çalışmaz. socks5:// adresine kullanıcı adı ve parola eklediğimizde tarama, iki biçimde de "Browser does not support socks5 proxy authentication" hatasıyla başarısız oldu. Bu sınır Chromium'dan geliyor (Playwright ile proxy kullanımı). Proxy'nin HTTP endpoint'ini kullanın ya da proxy panelinde sunucunuzun IP'sine izin verip (IP whitelist) parolasız bağlanın (SOCKS ve HTTP proxy farkı).
Proxy'nin çalıştığını görmek için ziyaretçinin IP'sini gösteren bir sayfayı tarayın.
Rotating mi sticky mi: RoundRobinProxyStrategy ne zaman gerekir?
Cevap, proxy adresinizin arkasında ne olduğuna bağlı.
Rotating ağ geçidi, pr.proxynet.io:8000 gibi tek bir adrestir; sağlayıcı bu adresin arkasında çıkış IP'sini değiştirir. Bir Rotating Proxy ya da rotating bir Residential Proxy kullanıyorsanız Crawl4AI'a tek bir ProxyConfig yeter. Resmî proxy sayfasındaki demo, sitenin gördüğü IP'yi ProxyConfig.ip ile karşılaştırıyor. Ağ geçidinde bu kontrol her zaman uyuşmazlık bildirir, çünkü çıkış IP'si hiçbir zaman ağ geçidinin adresi değildir.
Sabit bir IP listesinde ise RoundRobinProxyStrategy işe yarar: her istek listedeki bir sonraki proxy'yi alır. Böyle bir liste örneğin bir Datacenter Proxy ya da ISP Proxy paketinden gelir. proxy_session_id verildiğinde aynı kimliği taşıyan istekler, proxy_session_ttl saniye geçene kadar aynı proxy'de kalır:
"""Sabit bir proxy listesinde sırayla dön ya da bir oturum boyunca aynı proxy'de kal."""
import asyncio

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    ProxyConfig,
    RoundRobinProxyStrategy,
)

# PROXIES="http://user:pass@203.0.113.10:8000,http://user:pass@203.0.113.11:8000"
strategy = RoundRobinProxyStrategy(ProxyConfig.from_env("PROXIES"))

rotate = CrawlerRunConfig(proxy_rotation_strategy=strategy, cache_mode=CacheMode.BYPASS)
sticky = CrawlerRunConfig(
    proxy_rotation_strategy=strategy,
    proxy_session_id="catalog-1",  # bu kimliği taşıyan her istek aynı proxy'yi alır
    proxy_session_ttl=600,         # saniye; süre dolunca oturum yeni bir proxy seçer
    cache_mode=CacheMode.BYPASS,
)


async def main(base):
    async with AsyncWebCrawler(config=BrowserConfig(headless=True)) as crawler:
        for label, config in (("rotate", rotate), ("sticky", sticky)):
            for page in range(1, 4):
                result = await crawler.arun(f"{base}/catalog?page={page}", config=config)
                print(label, page, result.status_code, config.proxy_config.server)


asyncio.run(main("https://shop.example.com"))
İki yerel proxy ile denediğimizde rotate istekleri sırayla birinden ötekine geçti, sticky istekleri ise tek bir proxy'de kaldı. Oturum parametreleri 0.9.4'ün kaynak kodunda var ama proxy belge sayfasında yok; sürüm yükselttikten sonra yeniden kontrol edin.
İki katmanı birbirine karıştırmayın. Crawl4AI'ın sticky oturumu sizin listenizden hep aynı girdiyi seçer. Rotating bir ağ geçidinin arkasında ise çıkış IP'si ancak sağlayıcı onu sabit tutarsa değişmez; Sticky Proxy oturumu bunu 1 ile 60 dakika arasında yapar. Bu modların ayrıntısı IP rotasyonu yazımızda, sade HTTP istemcilerinde rotasyon ise Python'da proxy döndürme rehberinde.
Docker isteği neden proxy taşıyamaz?
0.9.0'dan beri Docker sunucusu varsayılan olarak güvenli ayarlarla gelir. Gövdesinde proxy ya da proxy_config bulunan bir istek HTTP 400 alır; js_code, headers, cookies, magic ve birkaç başka alan için de durum aynı (0.9.0 geçiş notları). Sebep sunucu taraflı istek sahteciliğidir (SSRF): bu kısıt olmasa istek gönderen herkes, sunucunun tarayıcısını istediği bir proxy üzerinden ya da iç ağdaki adreslere yönlendirebilirdi.
Geçiş notları bu seçeneklerin sunucu tarafında yapılandırılmasını öneriyor. Ancak 0.9.4 kaynak kodunda bir çıkış koruması (egress guard), config.yml içindekiler dahil her proxy_config değerini siliyor ve Chromium'u sunucunun kendi filtreleme proxy'si üzerinden yönlendiriyor. Kaynak kod ayrıca CRAWL4AI_UPSTREAM_PROXY ya da HTTPS_PROXY değişkeninden bir üst (upstream) HTTP proxy okuyor; bu davranış belgelenmemiş ve biz test edemedik. Kendi proxy'nizi kullanmak için SDK'yı kendi servisinizde çalıştırın.
robots.txt, hız ve eşzamanlılık nasıl ayarlanır?
check_robots_txt varsayılan olarak False değerindedir. 0.9.4'ün davranışını yerel sitelerde test ettik:
- İzin verilmeyen bir yol
403durum kodu döndürür ve sayfa hiç istenmez. 500yanıtı veren bir robots.txt "her şey serbest" sayılır; 2 saniyelik zaman aşımı ve ağ hatası da öyle. Oysa RFC 9309, sunucu hatalarında crawler'ın siteyi tamamen yasaklı kabul etmesi gerektiğini söyler.- Kurallar 7 gün önbellekte tutulur. RFC 9309'a göre önbellekteki kopya 24 saatten uzun kullanılmamalı;
crawler.robots_parser.clear_cache()önbelleği boşaltır. - robots.txt proxy üzerinden değil, doğrudan sizin makinenizden indirilir ve istekte genel bir
aiohttpUser-Agent'ı kullanılır. - Kurallar
BrowserConfig.user_agentdeğeriyle eşleştirilir. Varsayılan değer bir Chrome dizgisidir; bu yüzden botunuzun adına yazılmış birDisallowancakUser-Agentdeğeriniz o adı taşıyorsa geçerli olur./privatealtındaki bir yol varsayılan dizgiyle açıldı,NorthwindDocsBot/1.0ile ise403döndü.
Hassas işlerde robots.txt'yi önce kendiniz kontrol edin (robots.txt, User-Agent Nedir?).
Hız, dispatcher'da (sayfaları sıraya koyup dağıtan bileşende) ayarlanır. SemaphoreDispatcher(semaphore_count=3) aynı anda en fazla üç sayfayı açık tutar (concurrency ve parallelism). RateLimiter aynı alan adına giden istekler arasında bekler, 429 ya da 503 sonrasında bekleme süresini max_delay sınırına kadar yaklaşık iki katına çıkarır ve başarılı yanıtlardan sonra kısaltır. Reddedilen sayfayı yeniden indirmez: sonuç 429 ile döner, yeniden denemek size kalır. Aşağıdaki betik sayfaları üçerli gruplar hâlinde tarar ve reddedilenlere iki tur daha şans verir:
"""Tek bir sitenin sayfalarını ölçülü bir hızda tara ve her birini Markdown olarak kaydet."""
import asyncio
import os
import re
from pathlib import Path

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    DefaultMarkdownGenerator,
    ProxyConfig,
    PruningContentFilterLXML,
    RateLimiter,
    SemaphoreDispatcher,
)

BASE = os.environ.get("DOCS_BASE", "https://docs.example.com")
URLS = [f"{BASE}/docs/{n}" for n in range(1, 13)] + [f"{BASE}/private/report"]
OUT = Path("pages")
BATCH = 3                 # aynı anda açık tutulan sayfa sayısı
PAUSE = 5.0               # iki grup arasındaki bekleme (saniye)
RETRY_CODES = {429, 503}  # sonra yeniden denemeye değer
ROUNDS = 3                # ilk tur artı iki yeniden deneme turu
ROUND_PAUSE = 60          # yeniden deneme turundan önceki bekleme (saniye); her turda ikiye katlanır


def file_name(url):
    return re.sub(r"[^a-z0-9]+", "-", url.lower()).strip("-") + ".md"


async def crawl_round(crawler, urls, run_config, dispatcher):
    """URL'leri küçük gruplar hâlinde tara, sonra yeniden denenecek olanları döndür."""
    retry = []
    for i in range(0, len(urls), BATCH):
        results = await crawler.arun_many(
            urls[i : i + BATCH], config=run_config, dispatcher=dispatcher
        )
        for r in results:
            if r.success and r.status_code == 200:
                (OUT / file_name(r.url)).write_text(r.markdown.fit_markdown, encoding="utf-8")
                print(f"saved  {r.url}")
            elif r.status_code in RETRY_CODES:
                retry.append(r.url)
                print(f"later  {r.status_code} {r.url}")
            else:
                print(f"skip   {r.status_code} {r.url}: {r.error_message}")
        await asyncio.sleep(PAUSE)
    return retry


async def main():
    OUT.mkdir(exist_ok=True)
    browser_config = BrowserConfig(
        headless=True,
        user_agent="NorthwindDocsBot/1.0 (+https://example.com/bot)",
    )
    run_config = CrawlerRunConfig(
        proxy_config=ProxyConfig.from_string(os.environ["PROXY_URL"]),
        check_robots_txt=True,
        cache_mode=CacheMode.BYPASS,
        page_timeout=30000,
        markdown_generator=DefaultMarkdownGenerator(
            content_filter=PruningContentFilterLXML(threshold=0.48)
        ),
    )
    # Tüm çalışma için tek dispatcher: RateLimiter 429'lardan öğrendiği yavaş tempoyu korur
    dispatcher = SemaphoreDispatcher(
        semaphore_count=BATCH,
        rate_limiter=RateLimiter(base_delay=(1.0, 3.0), max_delay=60.0, max_retries=3),
    )

    pending = list(URLS)
    async with AsyncWebCrawler(config=browser_config) as crawler:
        for round_no in range(ROUNDS):
            if round_no:
                wait = ROUND_PAUSE * 2 ** (round_no - 1)
                print(f"round {round_no + 1}: {len(pending)} pages again in {wait} s")
                await asyncio.sleep(wait)
            pending = await crawl_round(crawler, pending, run_config, dispatcher)
            if not pending:
                break

    print(f"done, {len(pending)} pages still refused")


asyncio.run(main())
DOCS_BASE değişkenini, /docs/ altındaki her dördüncü isteğe 429 veren ve /private yolunu yasaklayan yerel bir siteye yönelttik; test için ROUND_PAUSE değerini 5 saniyeye indirdik. Kısaltılmış çıktı:
saved  http://192.168.1.2:28130/docs/1
saved  http://192.168.1.2:28130/docs/2
saved  http://192.168.1.2:28130/docs/3
later  429 http://192.168.1.2:28130/docs/4
...
later  429 http://192.168.1.2:28130/docs/11
saved  http://192.168.1.2:28130/docs/12
skip   403 http://192.168.1.2:28130/private/report: Access denied by robots.txt
round 2: 3 pages again in 5 s
saved  http://192.168.1.2:28130/docs/4
saved  http://192.168.1.2:28130/docs/9
saved  http://192.168.1.2:28130/docs/11
done, 0 pages still refused
Crawl4AI'ın kendi log çıktısı da reddedilen her sayfa için "Blocked by anti-bot protection: HTTP 429 Too Many Requests" yazar. Gerçek bir Retry-After header'ına nasıl uyulacağı Scraping'de HTTP Hata Kodları yazısında.
Crawl4AI ile Firecrawl arasındaki fark nedir?
İkisi de sayfaları dil modelleri için Markdown'a çevirir; fark, onları nasıl çalıştırdığınızda ortaya çıkar.
| Crawl4AI | Firecrawl | |
|---|---|---|
| Lisans | Apache 2.0 ve ek bir atıf şartı | AGPL-3.0 |
| Ana biçim | Python kütüphanesi; isteğe bağlı Docker sunucusu | Barındırılan (hosted) API; kendi sunucunuza da kurulabilir |
| Kendi sunucunuzda çalışan parçalar | Tek konteyner | API, worker'lar, Playwright, Redis, RabbitMQ, PostgreSQL |
| Maliyet | Sunucunuz, proxy ve kullandığınız LLM | API paketi ya da kendi sunucularınız |
Firecrawl'ın self-hosting kılavuzu, kendi sunucunuzda çalışan API'de varsayılan olarak kimlik doğrulama olmadığını belirtiyor. Crawl4AI, taramalarını ve proxy'lerini kendisi yönetmek isteyen bir Python ekibine uyar.
Crawl4AI, MCP ve n8n ile nasıl kullanılır?
Docker sunucusu MCP'yi /mcp/sse ve /mcp/ws adreslerinde açar; araçları md, html, screenshot, pdf, execute_js, crawl ve ask. Kılavuzdaki Claude Code komutunda token yok, ama MCP endpoint'leri API ile aynı token kontrolünün arkasında duruyor. Bu yüzden header'ı ekleyin:
claude mcp add --transport sse c4ai-sse http://localhost:11235/mcp/sse \
  --header "Authorization: Bearer $CRAWL4AI_API_TOKEN"
Header ayarlayamayan WebSocket istemcileri token'ı ?token= ile gönderebilir. Protokolün kendisini MCP Nedir?, bir ajana tam bir tarayıcı vermeyi ise Playwright MCP yazımızda anlattık.
n8n'de bir HTTP Request düğümü, Bearer header'ı ve {"url": "https://quotes.toscrape.com/", "f": "fit"} gibi bir gövdeyle POST /md isteği gönderir; sayfa markdown alanında döner (n8n ile web scraping).
Kullanım alanları
- RAG için dokümantasyon: ürün belgelerini bir arama dizinine (retrieval index) Markdown olarak vermek; LLM'e güvenli web erişimi yazısındaki kontrollerden geçirerek.
- Ajanlar için temiz girdi: ham HTML yerine fit Markdown (agentic web scraping).
- Fiyat kontrolü: ürün sayfalarını bir CSS şemasıyla JSON'a çevirmek (fiyat takibi).
- Kendi sitenizin envanteri: içerik denetimi ve kırık bağlantı kontrolü için her sayfa ve bağlantı (web crawler).
- Katalog verisi: herkese açık katalog sayfalarından ürün adları, teknik özellikler ve fiyatlar (veri kazıma).
Sık yapılan hatalar
- Token olmadan
docker runya da değersiz-e CRAWL4AI_API_TOKEN: sağlıklı görünen bir konteynerden "connection reset" gelir. - REST isteğine
proxy_configyazmak: sunucu400ile yanıt verir. - Parolalı
socks5://: Chromium kabul etmez. - Rotating bir ağ geçidini
RoundRobinProxyStrategylistesine birkaç kez yazmak: ağ geçidi IP'yi zaten değiştiriyor. content_filterolmadanfit_markdownbeklemek: alan boş kalır.- robots.txt'nin kontrol edildiğini varsaymak: kontrol varsayılan olarak kapalıdır, yüklenemeyen bir robots.txt da "izin var" sayılır.
RateLimiterolmadan yüksek eşzamanlılık: küçük bir sitede aynı anda açılan on sayfa ani bir yük gibi görünür, ardından429yanıtları gelir.429diyen bir siteyi IP değiştirerek zorlamak: bunun yerine yavaşlayın (bot tespiti nasıl yapılır).
Belgelerdeki stealth modu, "magic" modu ve anti-bot fallback özellikleri bu yazının kapsamı dışında; bunları önermiyoruz.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Birkaç dokümantasyon sayfasını LLM için temiz metin olarak almak | pip kurulumu, PruningContentFilterLXML ile arun() |
| Her istekte farklı bir çıkış IP'si | Rotating residential ağ geçidiyle tek bir ProxyConfig |
| Çok adımlı bir akış boyunca aynı IP | Sağlayıcının sticky oturumu; liste kullanıyorsanız ek olarak proxy_session_id |
| Sabit bir IP listesi | RoundRobinProxyStrategy ile ProxyConfig.from_env("PROXIES") |
| n8n'den, başka bir dilden ya da bir ajandan tarama başlatmak | Token'lı Docker sunucusu; proxy işleri SDK'da kalır |
| Siteyi yormadan yüzlerce sayfa taramak | Küçük gruplar, RateLimiter, check_robots_txt=True |
| Altyapı yönetmeden çalışmak | Firecrawl gibi barındırılan bir API |
Sıkça sorulan sorular
Crawl4AI ücretsiz mi?
Evet, kütüphane Apache 2.0 lisansıyla ücretsizdir. LICENSE dosyası buna, herkese açık kullanımlarda projenin anılmasını isteyen bir şart ekler; örneğin bir README'de ya da "Hakkında" sayfasında. Maliyetiniz sunucu, proxy ve çağırdığınız dil modelinden oluşur.
Crawl4AI hangi Python sürümünü ister?
PyPI sayfasına göre Python 3.10 ya da daha yeni bir sürüm. Biz 0.9.4 sürümünü Python 3.13 ile test ettik.
Crawl4AI, Ollama gibi yerel bir LLM ile çalışır mı?
Markdown çıktısı için dil modeli gerekmez. LLM ile veri çıkarımı için belgeler, yerel bir Ollama modelinde API anahtarı olmadan LLMConfig(provider="ollama/llama3.3") kullanımını gösteriyor.
Crawl4AI ile Scrapy arasındaki fark nedir?
Scrapy sade HTTP istekleri gönderir ve varsayılan olarak JavaScript çalıştırmaz; Crawl4AI ise her sayfayı Chromium'da render eder ve Markdown döndürür. Scrapy statik HTML'in büyük ölçekli taramalarına uyar (Scrapy ile proxy kullanımı), Crawl4AI ise bir dil modeline gidecek sayfalara.
Crawl4AI Node.js ya da başka bir dilden kullanılabilir mi?
Kütüphanenin kendisi Python'dır. Diğer dillerden Docker sunucusunun REST API'sini çağırın; örneğin token'ı header'a koyarak POST /md isteği gönderin.
Bir site Crawl4AI'ı engellerse ne yapmalı?
Önce yavaşlayın: daha az paralel sayfa, daha uzun beklemeler ve her 429 sonrasında bir mola. robots.txt'yi ve sitenin kullanım şartlarını kontrol edin, resmî bir API ya da feed arayın. Site hâlâ reddediyorsa durun; işin hukuki tarafı Web Scraping (Web Kazıma) Yasal mı? yazısında.
Özet
Crawl4AI sayfaları bir dil modelinin okuyabileceği Markdown'a çevirir. Proxy gerektiren işlerde SDK'yı kullanın: rotating ağ geçidi için tek bir ProxyConfig, sabit liste için RoundRobinProxyStrategy, SOCKS5'te ise parolasız bağlantı. Docker sunucusu token ister ve istekte proxy kabul etmez. check_robots_txt ayarını açın, dürüst bir User-Agent gönderin ve hızı bir RateLimiter'a bırakın. Birçok ülkede çıkış noktası ya da sabit bir adres için proxy hizmetlerimize göz atın.