
Web scraping · Blog de Proxynet – Página 4
Publicado
¿Qué es el agentic web scraping y cómo funciona?
En el agentic web scraping el agente recorre la página, decide el siguiente paso y extrae los datos según un esquema. Explicamos bucle, costo y límites.
Autor: Acar Diveroli
Publicado
¿Qué es un AI web scraper y cómo funciona?
Un AI web scraper deja la extracción de campos en manos de la IA en lugar de selectores fijos. Explicamos los pasos, los tipos de herramientas y los límites.
Autor:Acar Diveroli
Publicado
¿Qué es Error 1015? Solución a You are being rate limited
Error 1015 es un bloqueo temporal que aparece cuando llegan demasiadas solicitudes en poco tiempo a un sitio detrás de Cloudflare. Causas, duración y solución.
Autor:Acar Diveroli
Publicado
Cómo hacer seguimiento de precios de la competencia
Seguir los precios de la competencia exige emparejar productos, leer a intervalos y lanzar alertas. Vemos las API de vendedor, un script Python y la frecuencia.
Autor: Enver Kaya
Publicado
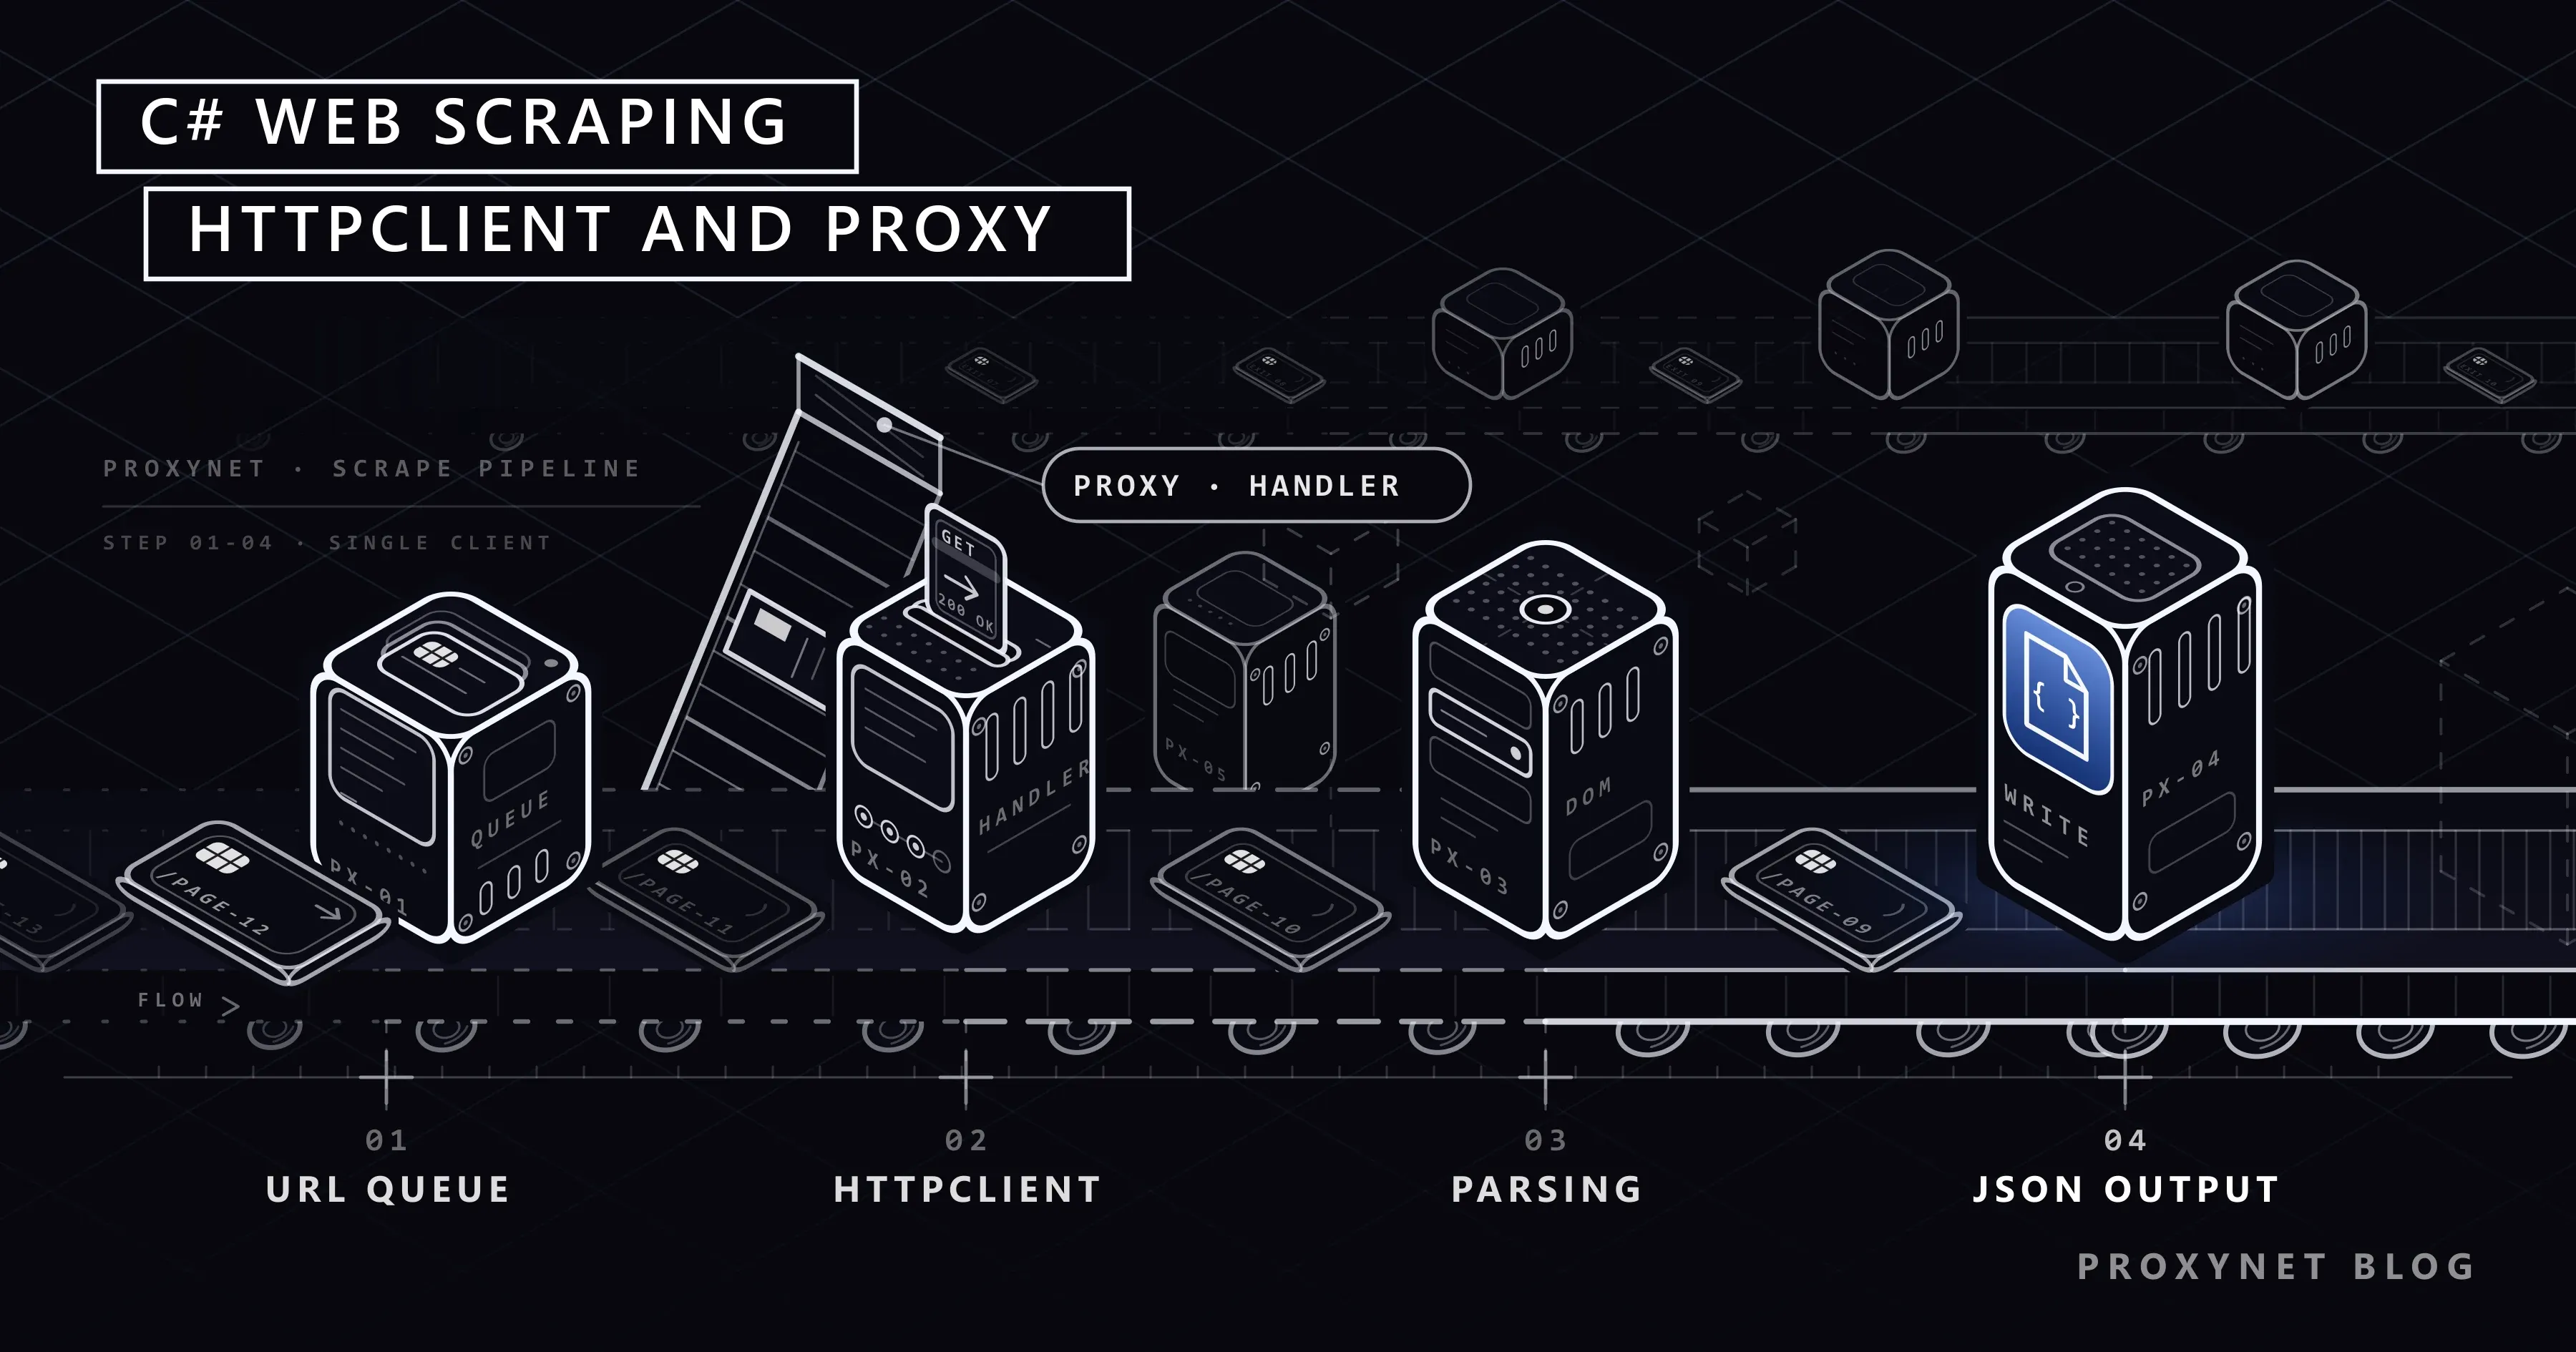
Web scraping con C#: HttpClient y proxy paso a paso
Para extraer datos con C# montas un único HttpClient de larga vida, analizas el HTML con HtmlAgilityPack y pasas el proxy al handler como un WebProxy.
Autor:Acar Diveroli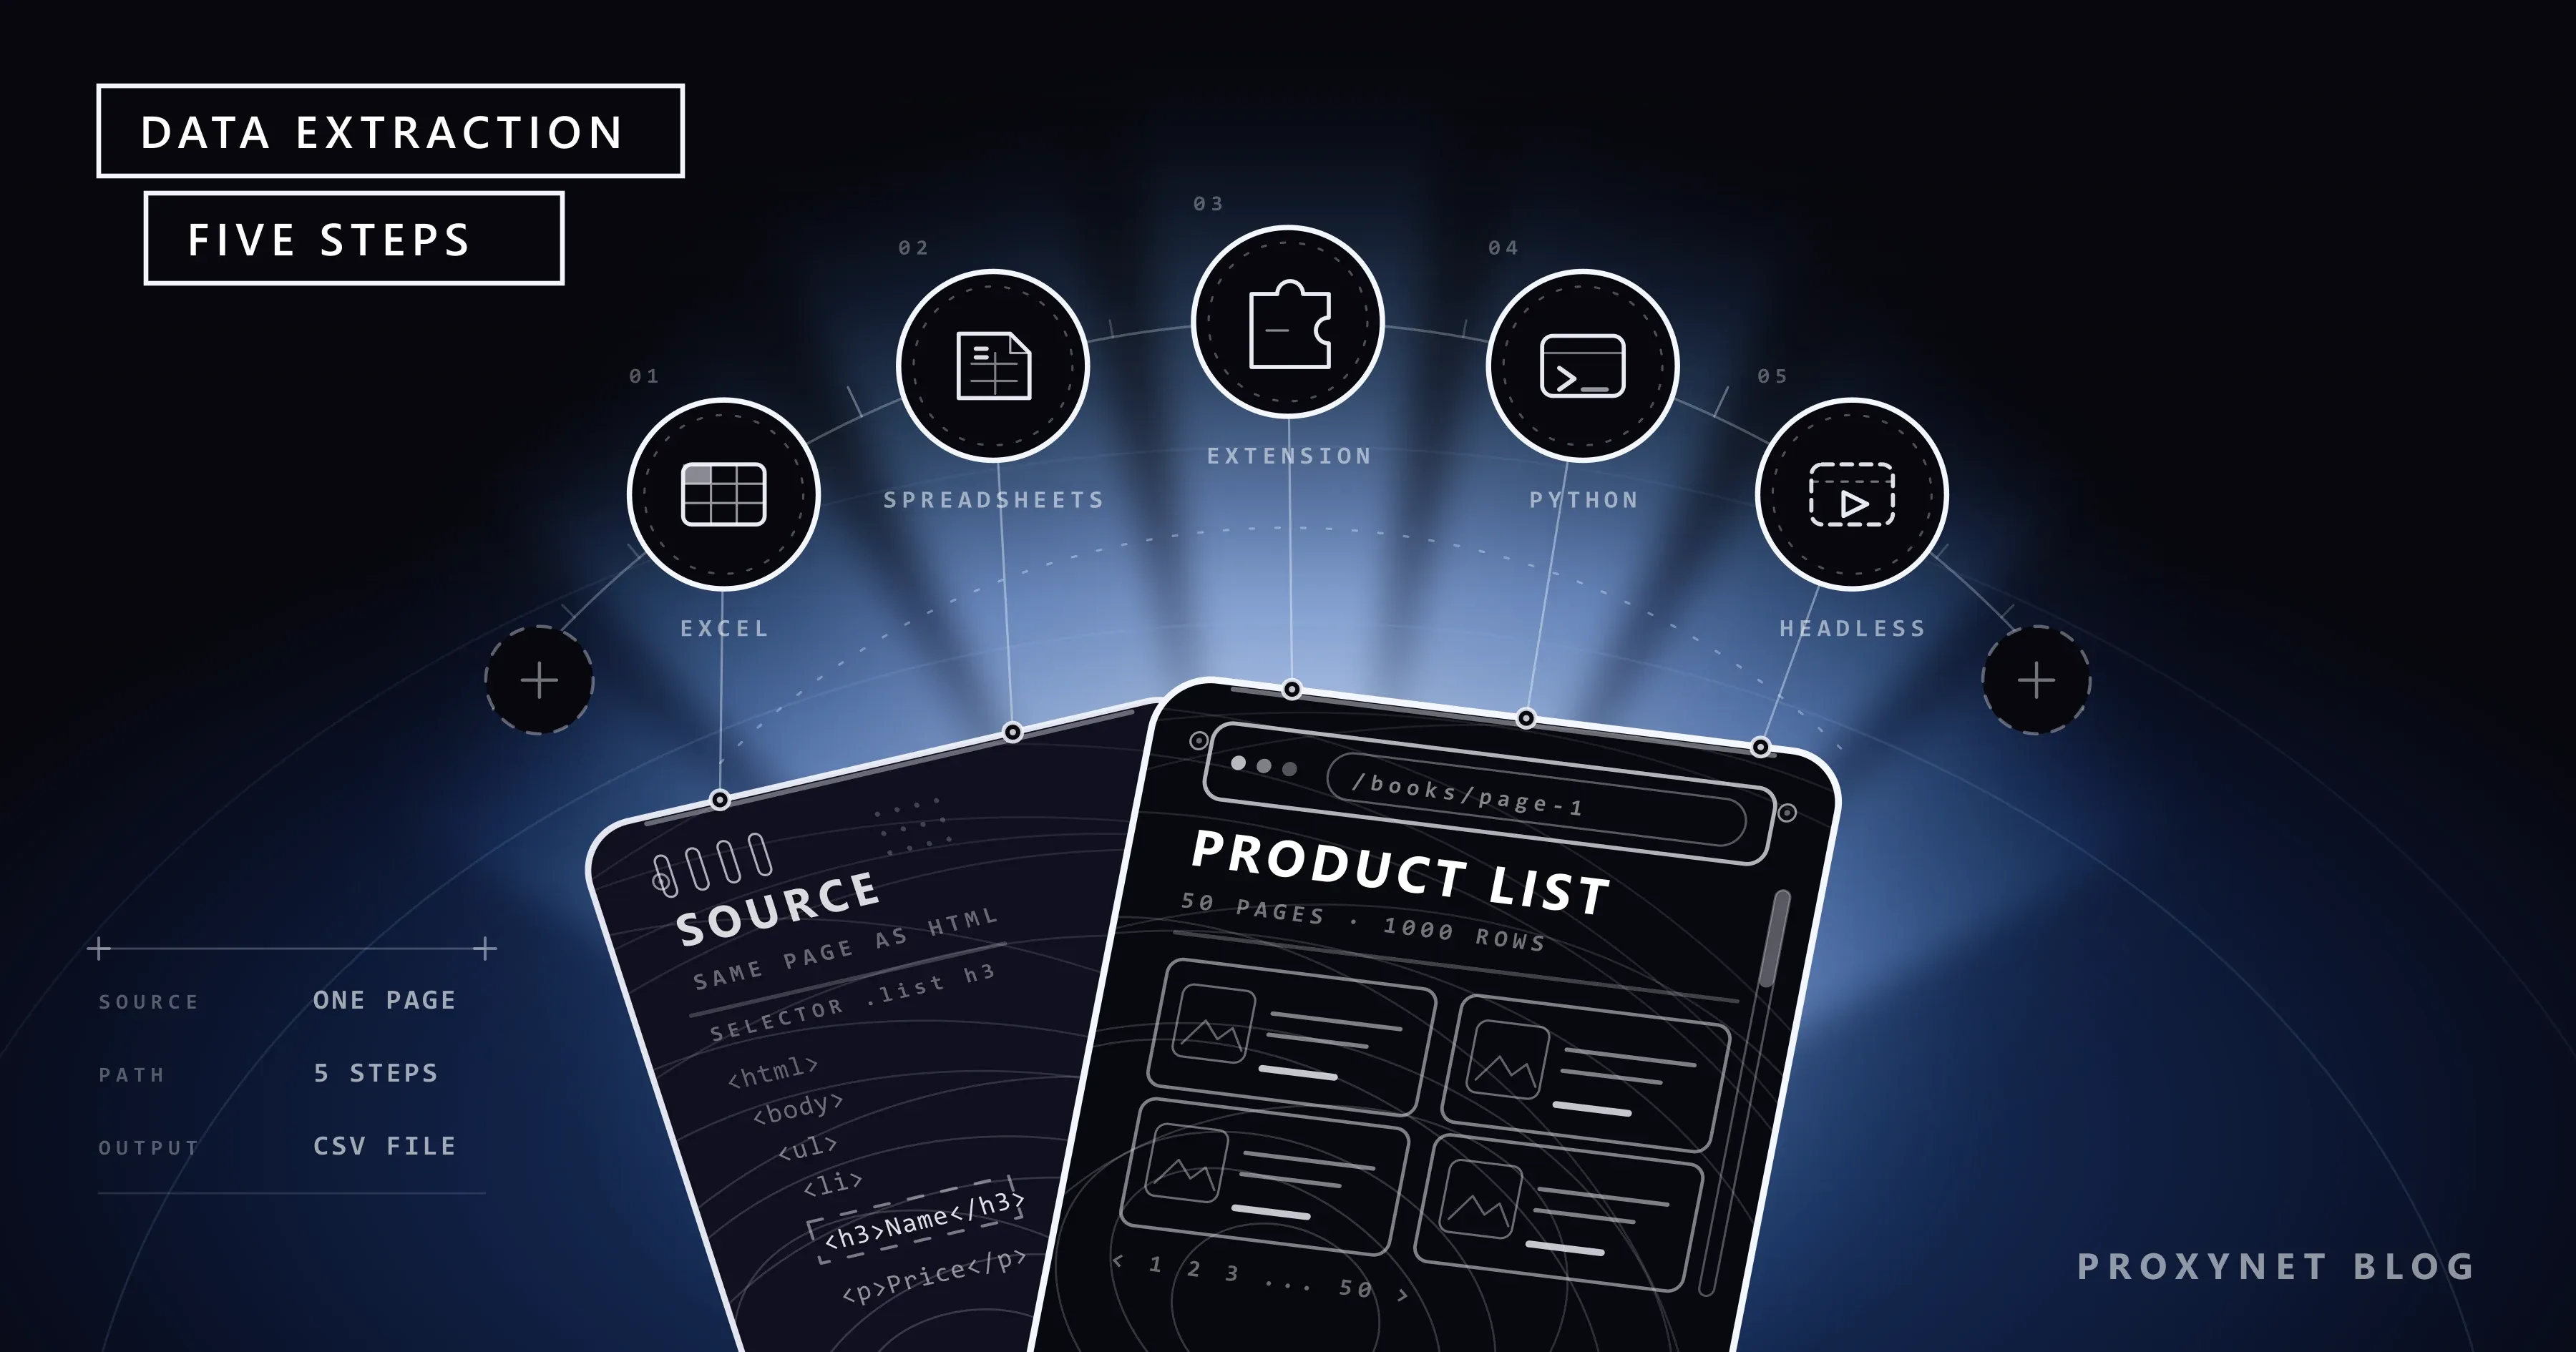
Publicado
Cómo extraer datos de una web: Excel, Python y herramientas
La forma de extraer datos de una web depende del volumen y de la estructura de la página. Cinco métodos, de Excel a Python, y cuándo basta cada uno.
Autor:Enver Kaya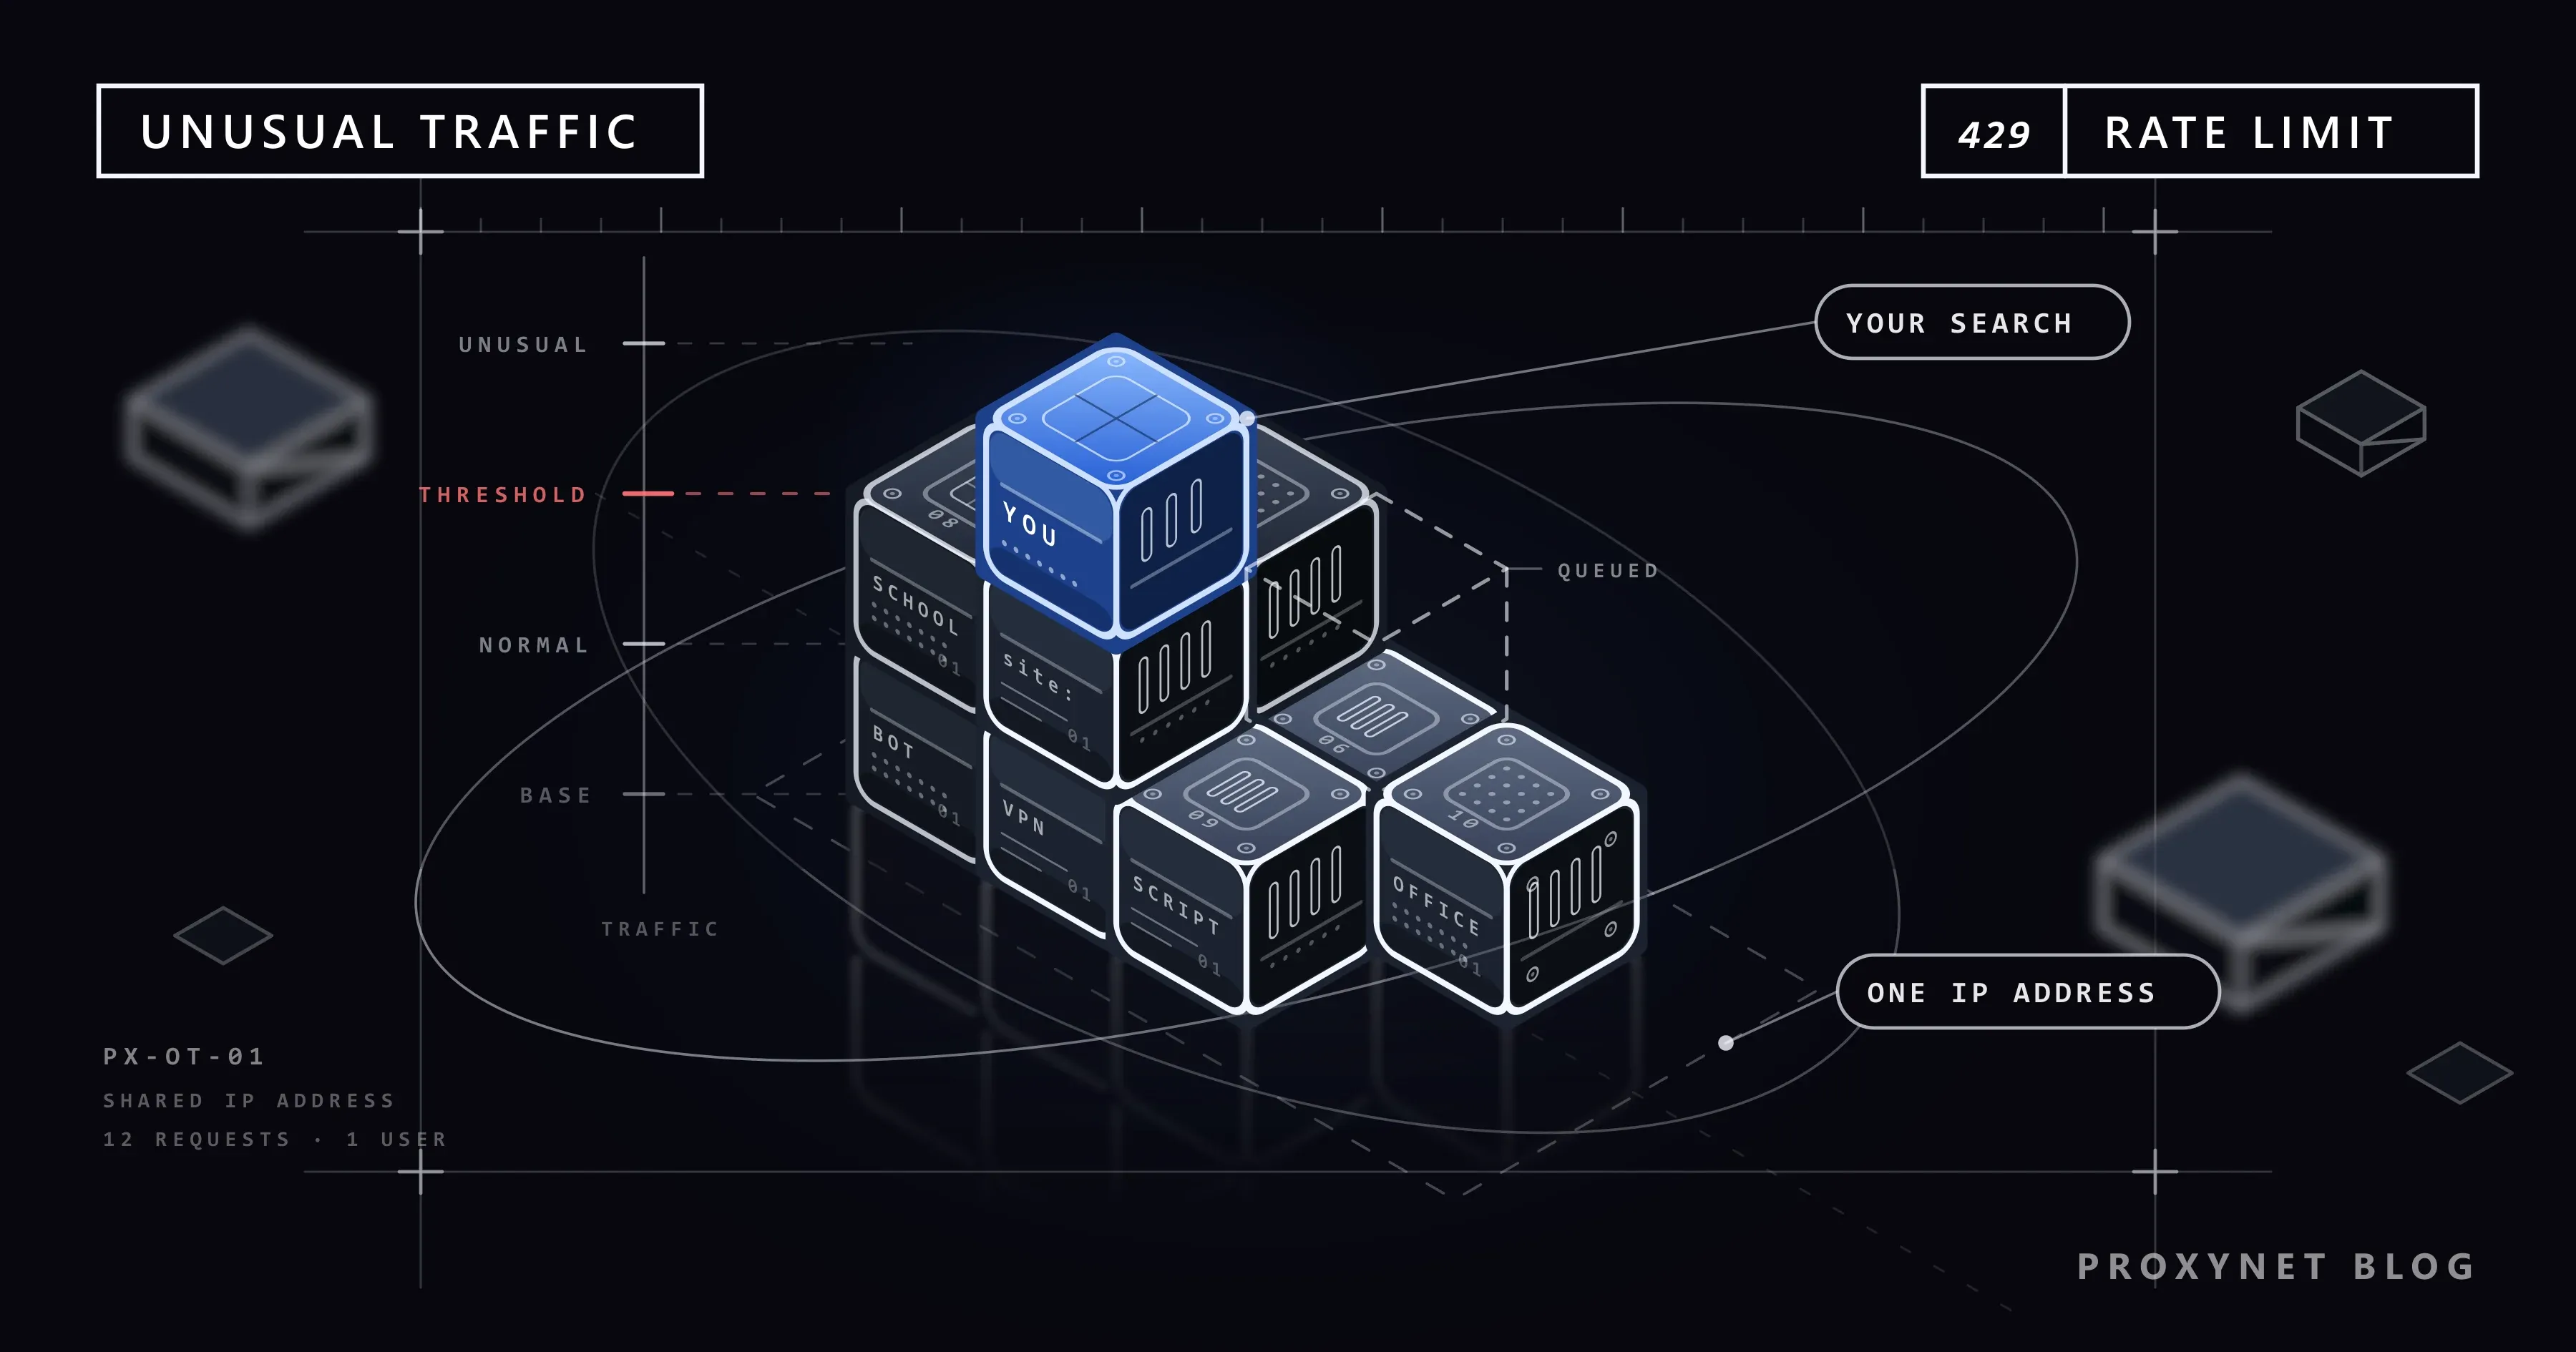
Publicado
Tráfico inusual en Google: qué significa y cómo solucionarlo
El aviso de tráfico inusual de Google va contra tu dirección IP, no contra tu cuenta. Qué dice la página sorry, por qué vuelve el CAPTCHA y cómo resolverlo.
Autor:Enver Kaya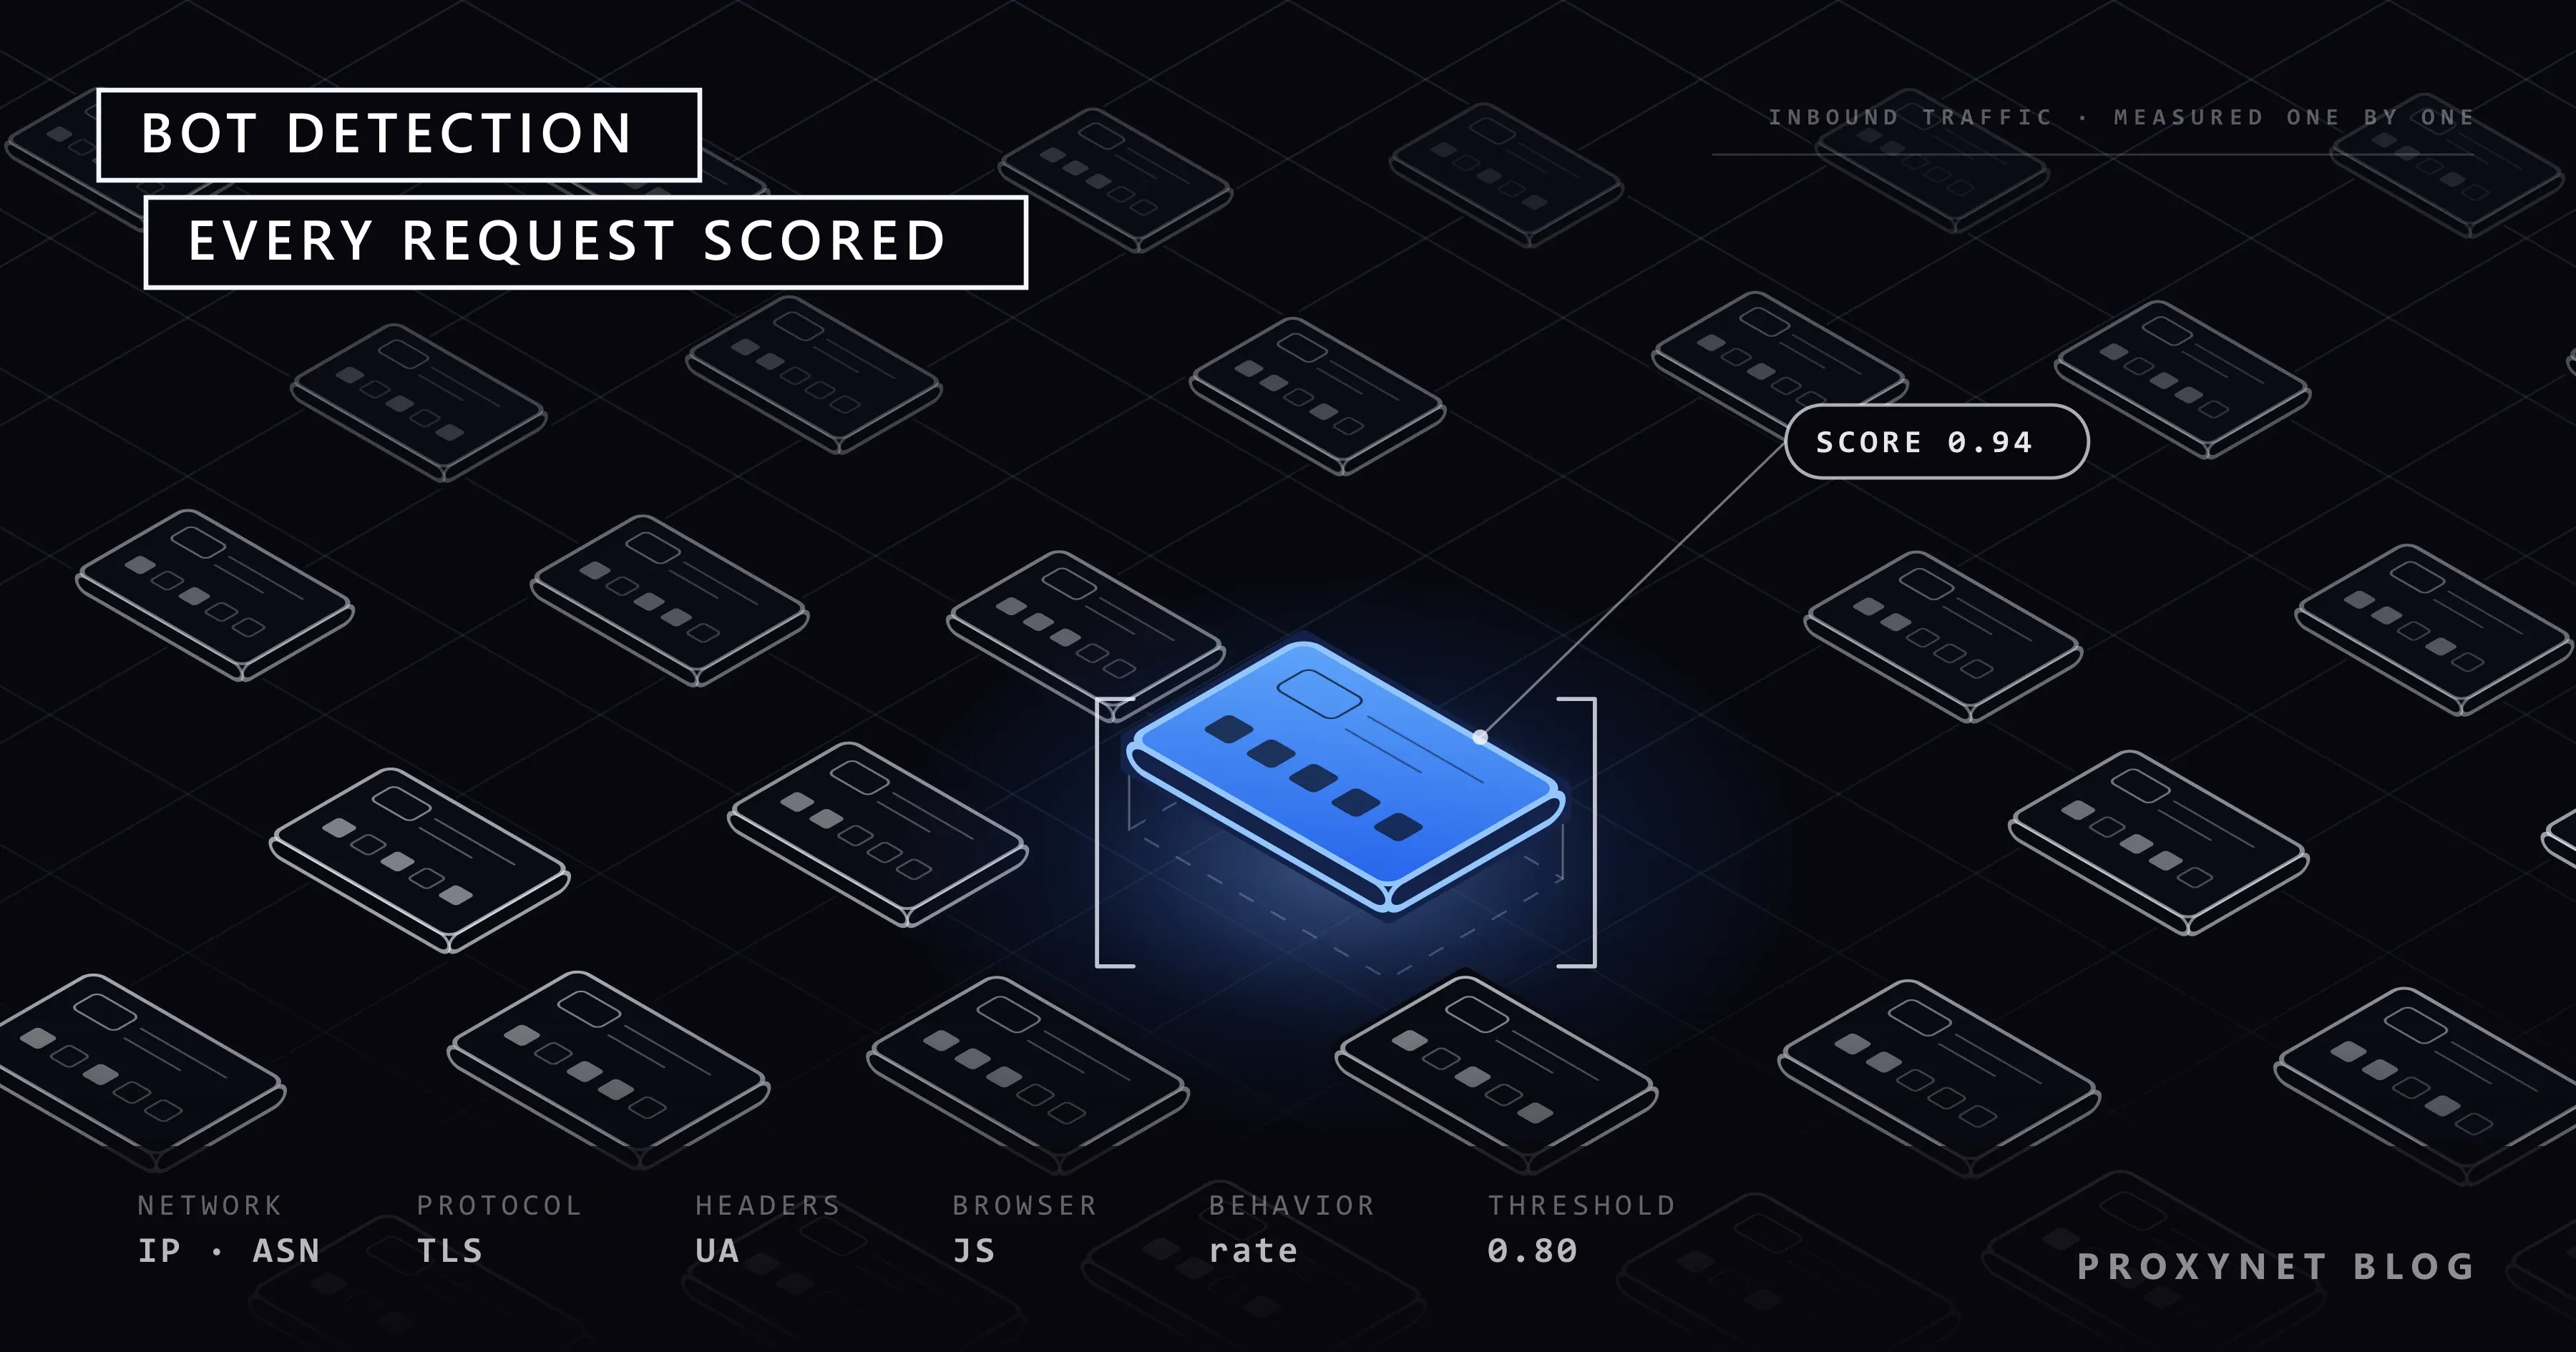
Publicado
Cómo funciona la detección de bots: la lógica anti-bot
La detección de bots no es una sola comprobación: reputación de la IP, huella TLS, cabeceras, señales del navegador y comportamiento se unen en una puntuación.
Autor:Acar Diveroli
Publicado
429 Too Many Requests: qué es el error de rate limit
429 Too Many Requests indica que enviaste más solicitudes de las que un servicio permite en poco tiempo. Cómo funciona el rate limit y cómo resolver el error.
Autor:Acar Diveroli
Publicado
Qué es la rotación de IP y cómo funciona
La rotación de IP es el cambio de la IP de salida de tus peticiones dentro de un pool. Tres modos, el flujo del gateway y por qué a veces la IP no cambia.
Autor:Acar Diveroli
Publicado
¿Qué es la paginación y cómo rastrear todas las páginas?
La paginación divide una lista larga en trozos. Vemos los cinco tipos, las condiciones de parada y cómo reanudar con SQLite un rastreo interrumpido.
Autor:Acar Diveroli
Publicado
Web scraping con PHP: cURL, Guzzle y uso de proxy
El núcleo del scraping en PHP es la petición con cURL y el análisis con DOM y XPath. Explicamos Guzzle, proxy, robots.txt y reintentos con código probado.
Autor:Acar Diveroli
¿Qué es el agentic web scraping y cómo funciona?
Autor: Acar DiveroliIAPublicado
¿Qué es un AI web scraper y cómo funciona?
Autor: Acar DiveroliWeb scrapingPublicado
¿Qué es Error 1015? Solución a You are being rate limited
Autor: Acar DiveroliTutorialesPublicado
Cómo hacer seguimiento de precios de la competencia
Autor: Enver KayaCasos de usoPublicado
Web scraping con C#: HttpClient y proxy paso a paso
Autor: Acar DiveroliTutorialesPublicado
Cómo extraer datos de una web: Excel, Python y herramientas
Autor: Enver KayaCasos de usoPublicado
Tráfico inusual en Google: qué significa y cómo solucionarlo
Autor: Enver KayaTutorialesPublicado
Cómo funciona la detección de bots: la lógica anti-bot
Autor: Acar DiveroliWeb scrapingPublicado
429 Too Many Requests: qué es el error de rate limit
Autor: Acar DiveroliTutorialesPublicado
Qué es la rotación de IP y cómo funciona
Autor: Acar DiveroliProxy 101Publicado
¿Qué es la paginación y cómo rastrear todas las páginas?
Autor: Acar DiveroliWeb scrapingPublicado
Web scraping con PHP: cURL, Guzzle y uso de proxy
Autor: Acar DiveroliTutorialesPublicado
Ningún artículo coincide
Publicado
Publicado