

































Web Scraping · Proxynet Blog – Sayfa 4

Yayın tarihi
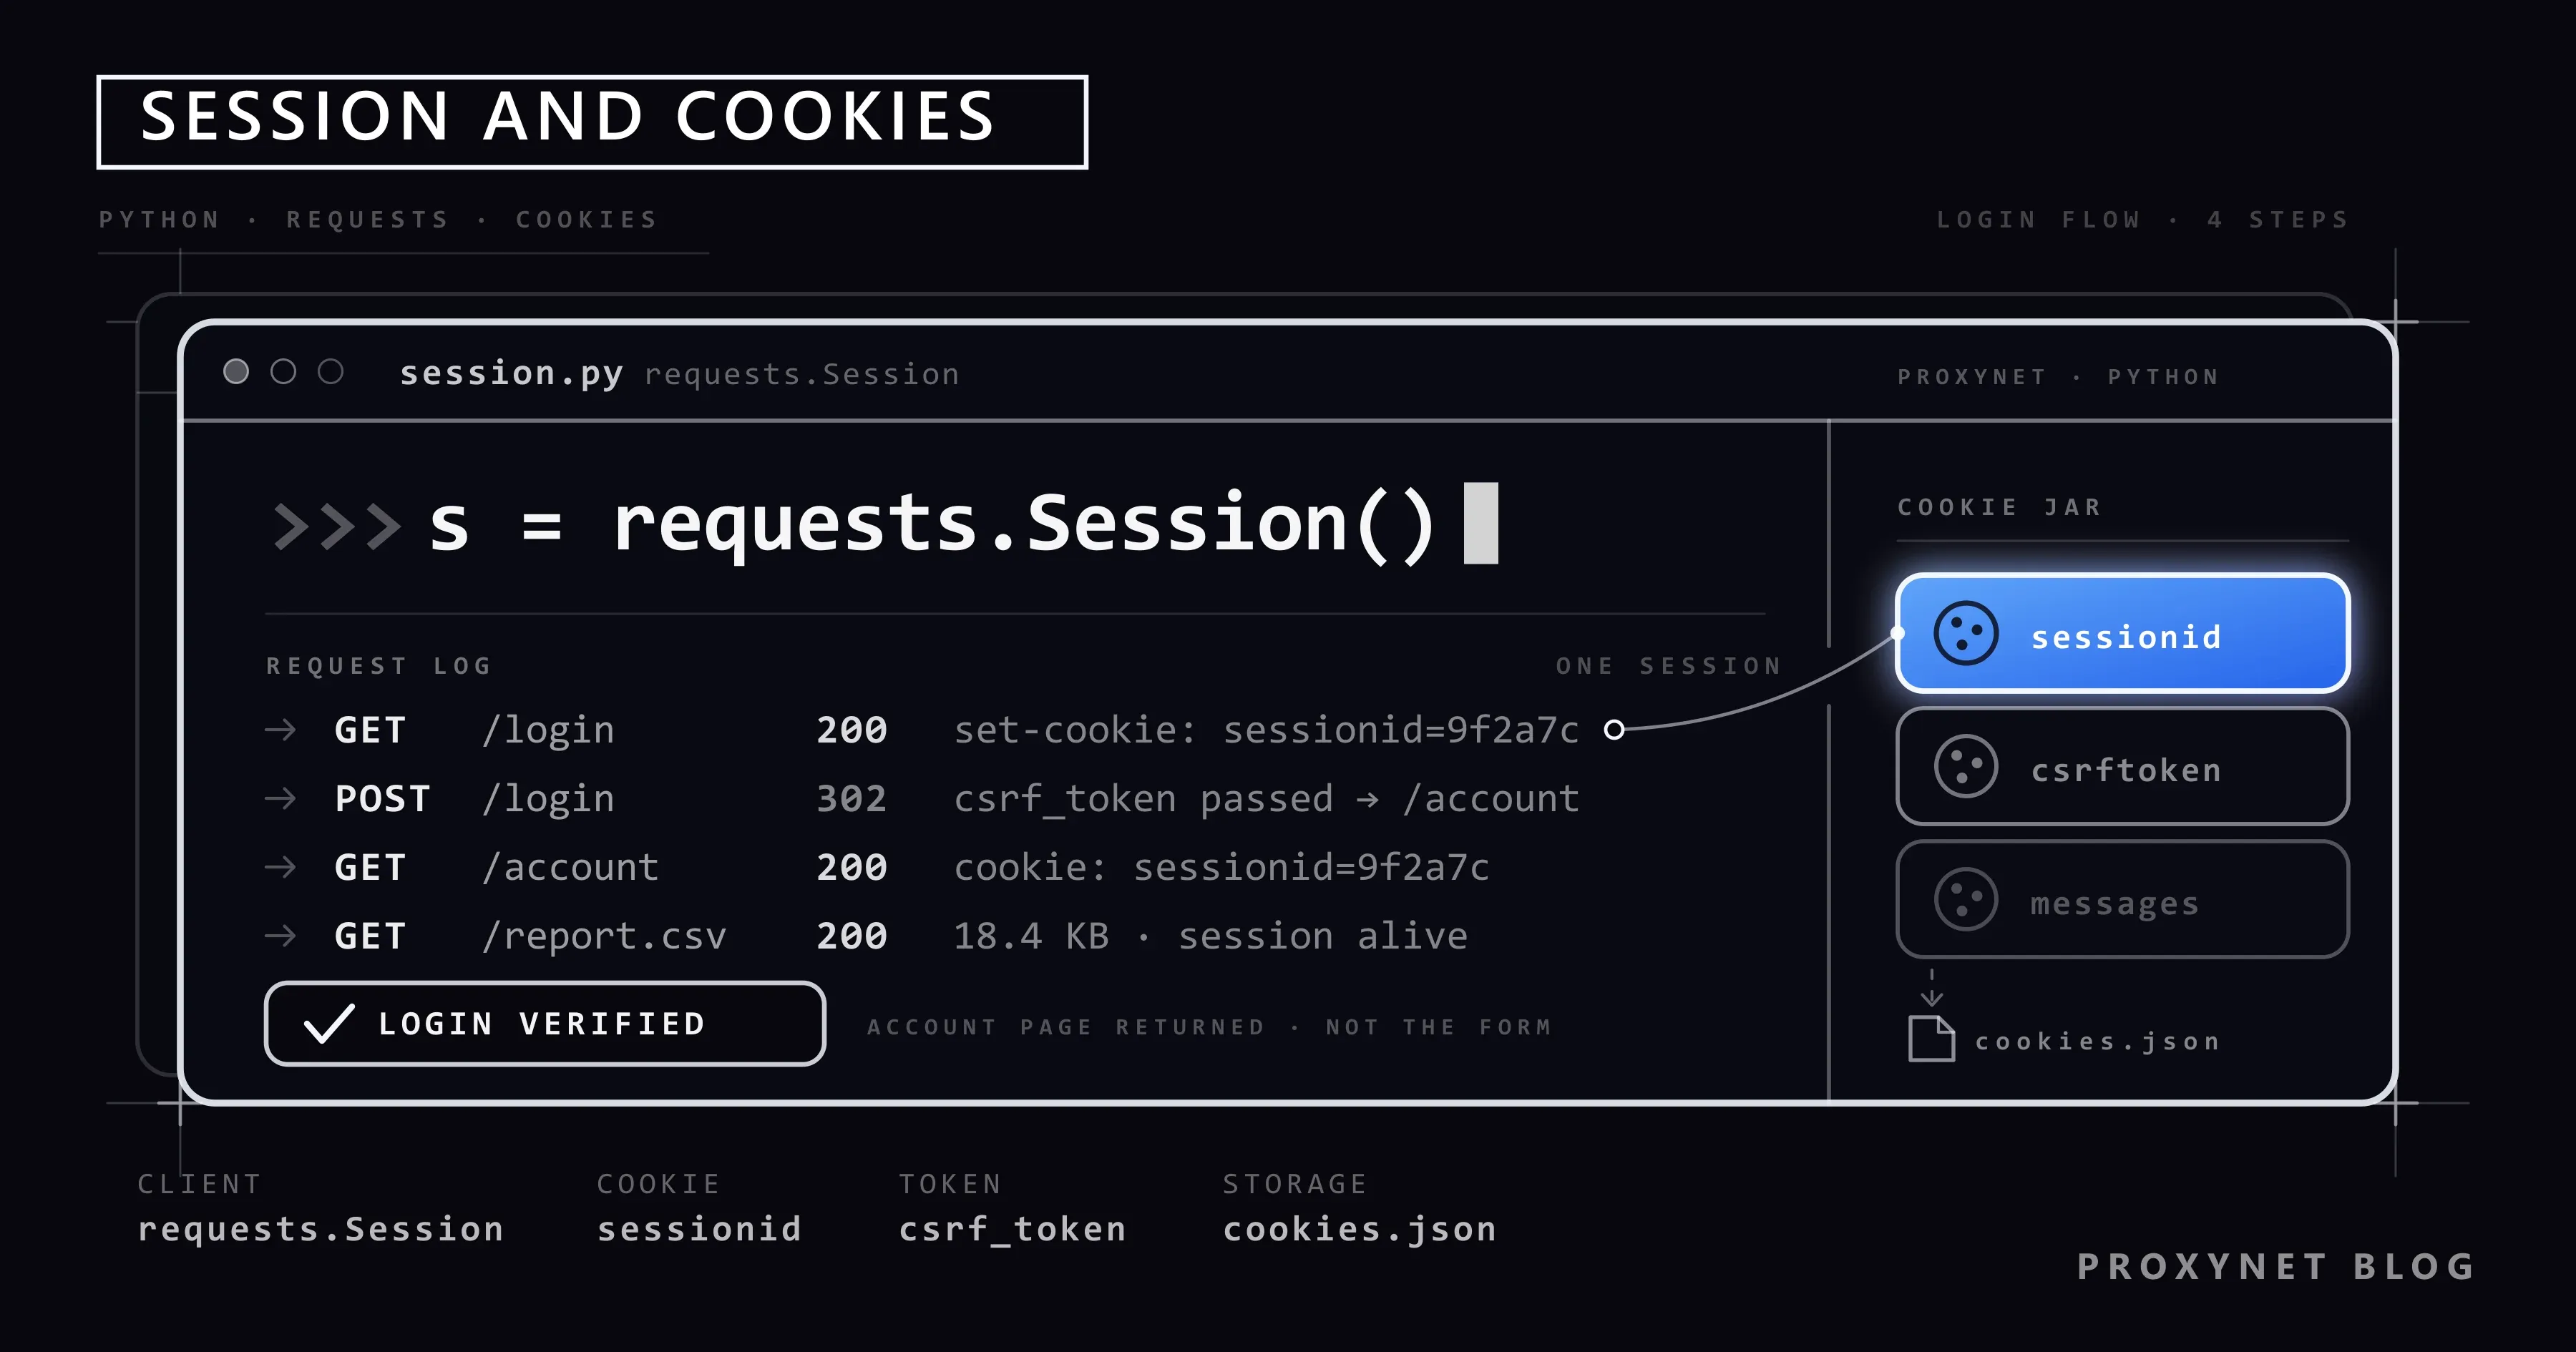
Python'da Oturum ve Çerez Yönetimi: Session ile Giriş
requests.Session çerezleri istekler arasında taşır ve oturumu sürdürür. Formdan CSRF belirtecini okumayı, girişi doğrulamayı ve oturumu saklamayı anlatıyoruz.
Yazar: Acar Diveroli
Yayın tarihi
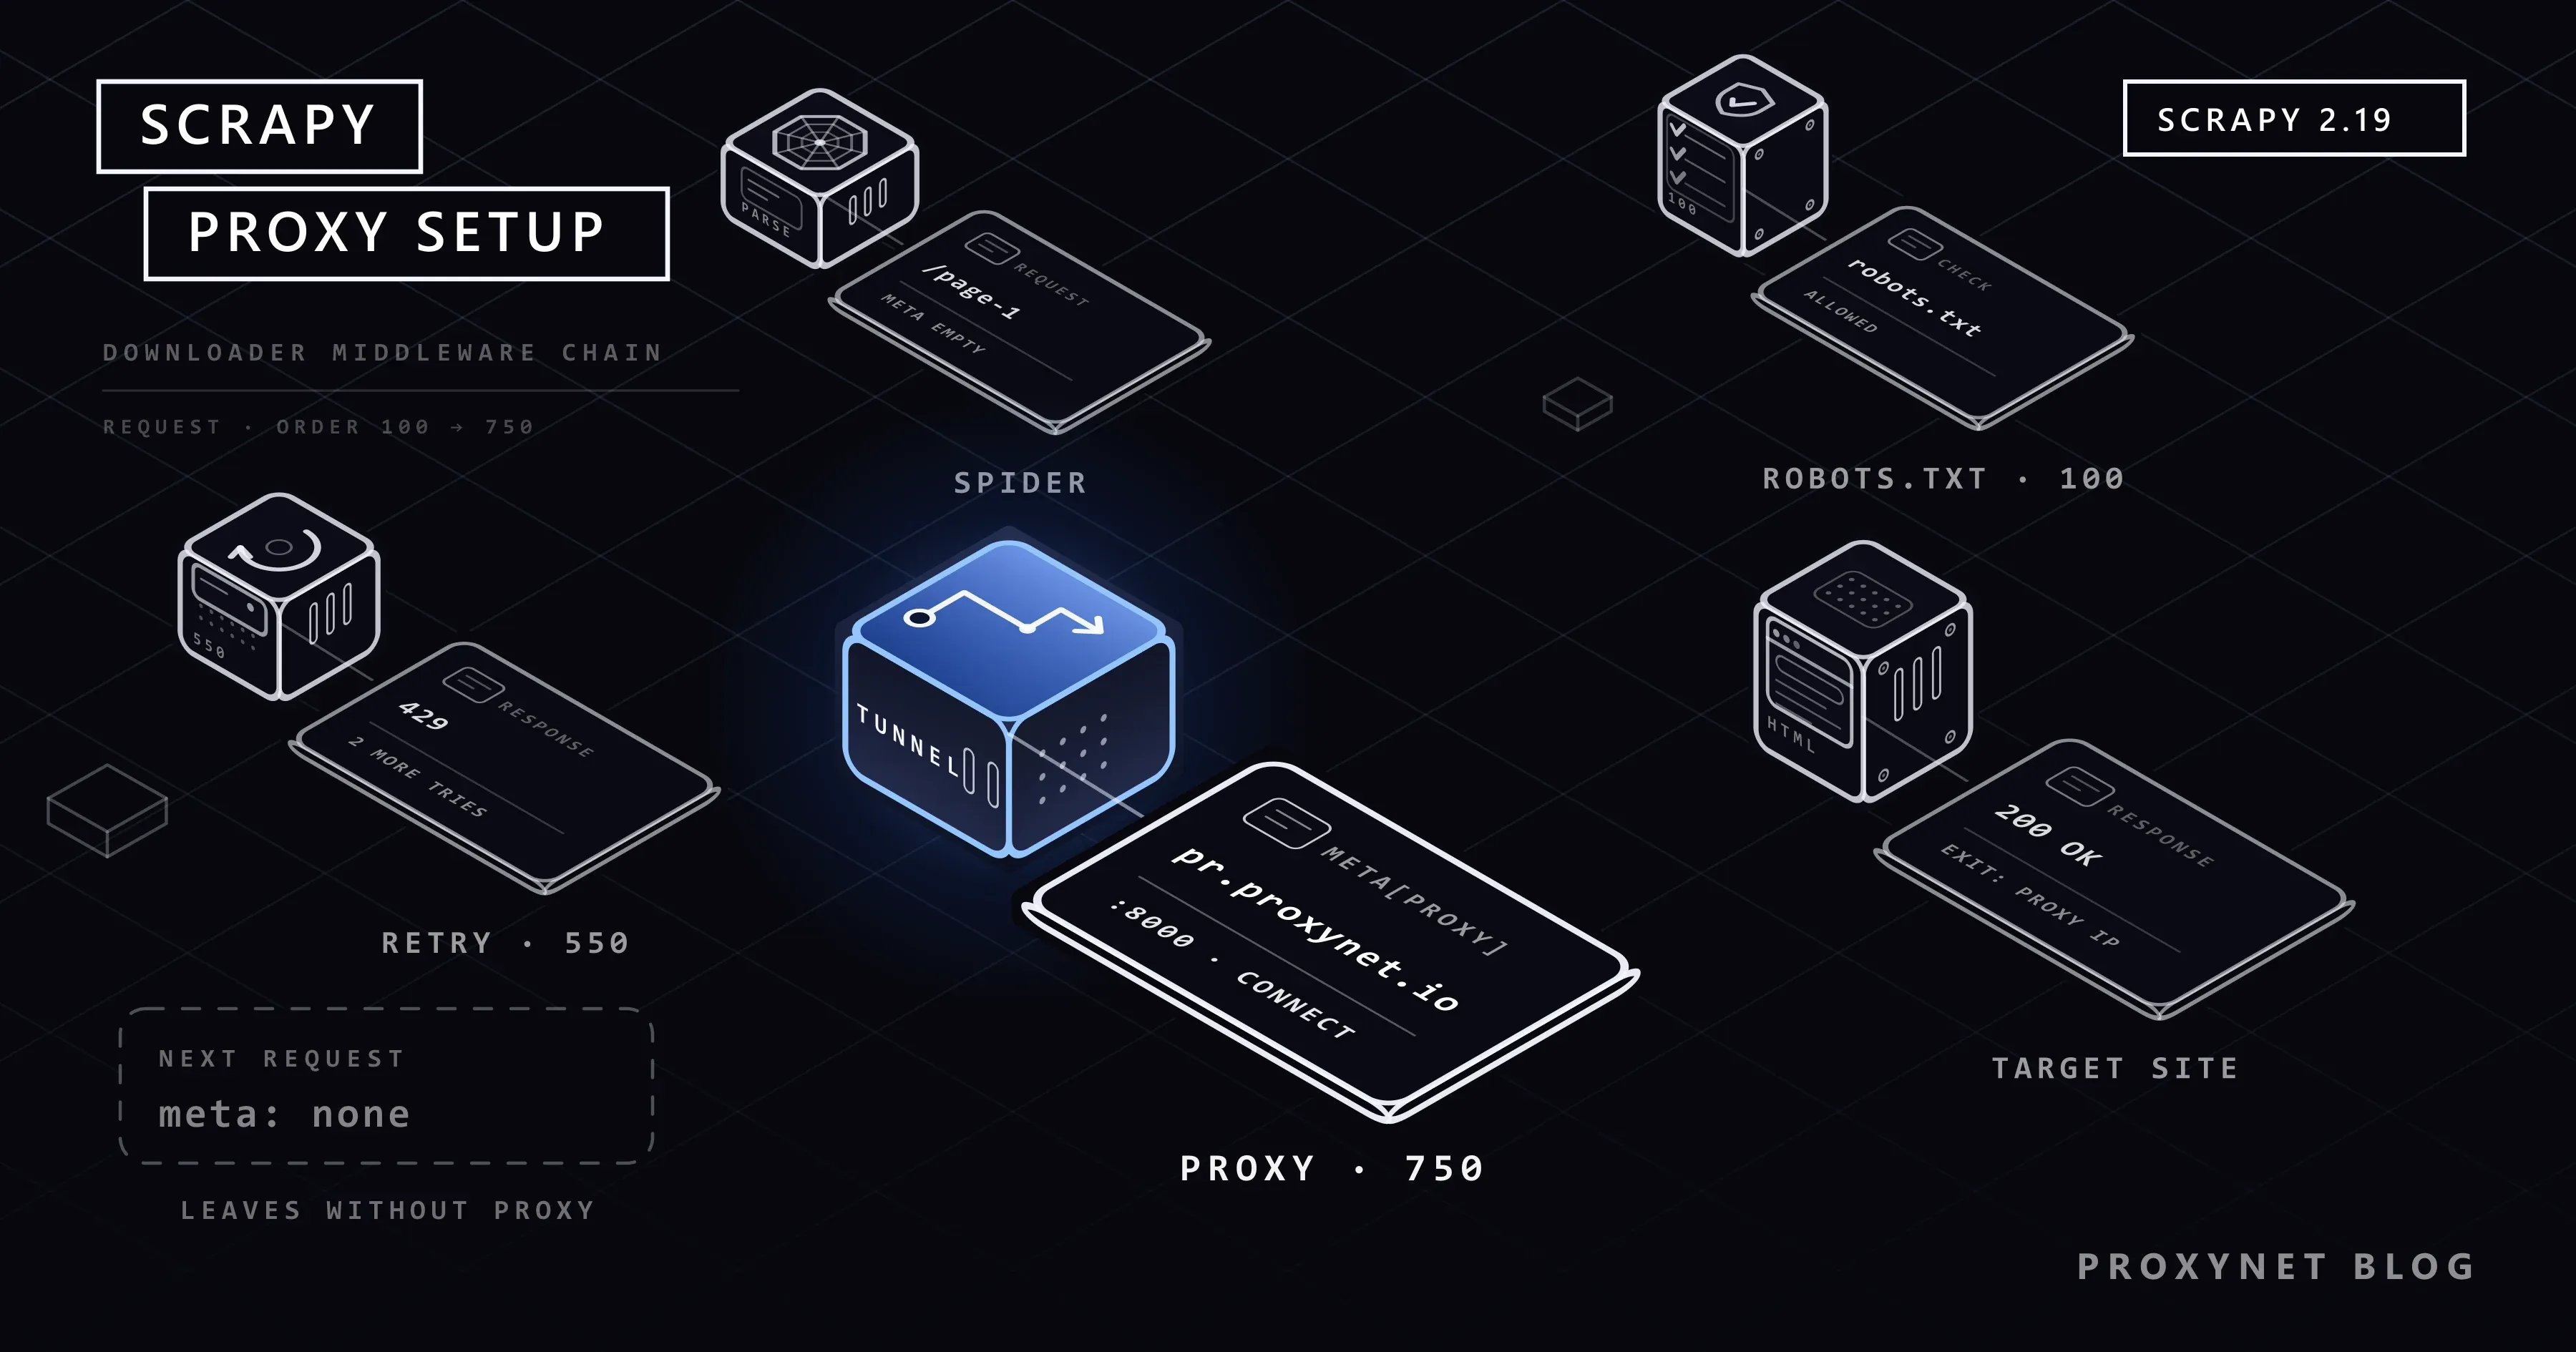
Scrapy Nedir ve Proxy ile Nasıl Kullanılır?
Scrapy'de proxy, isteğin meta alanıyla ya da bir middleware ile tanımlanır. Kurulumu, kimlik doğrulamayı, AutoThrottle ayarını ve rotasyonu kodla anlatıyoruz.
Yazar:Acar Diveroli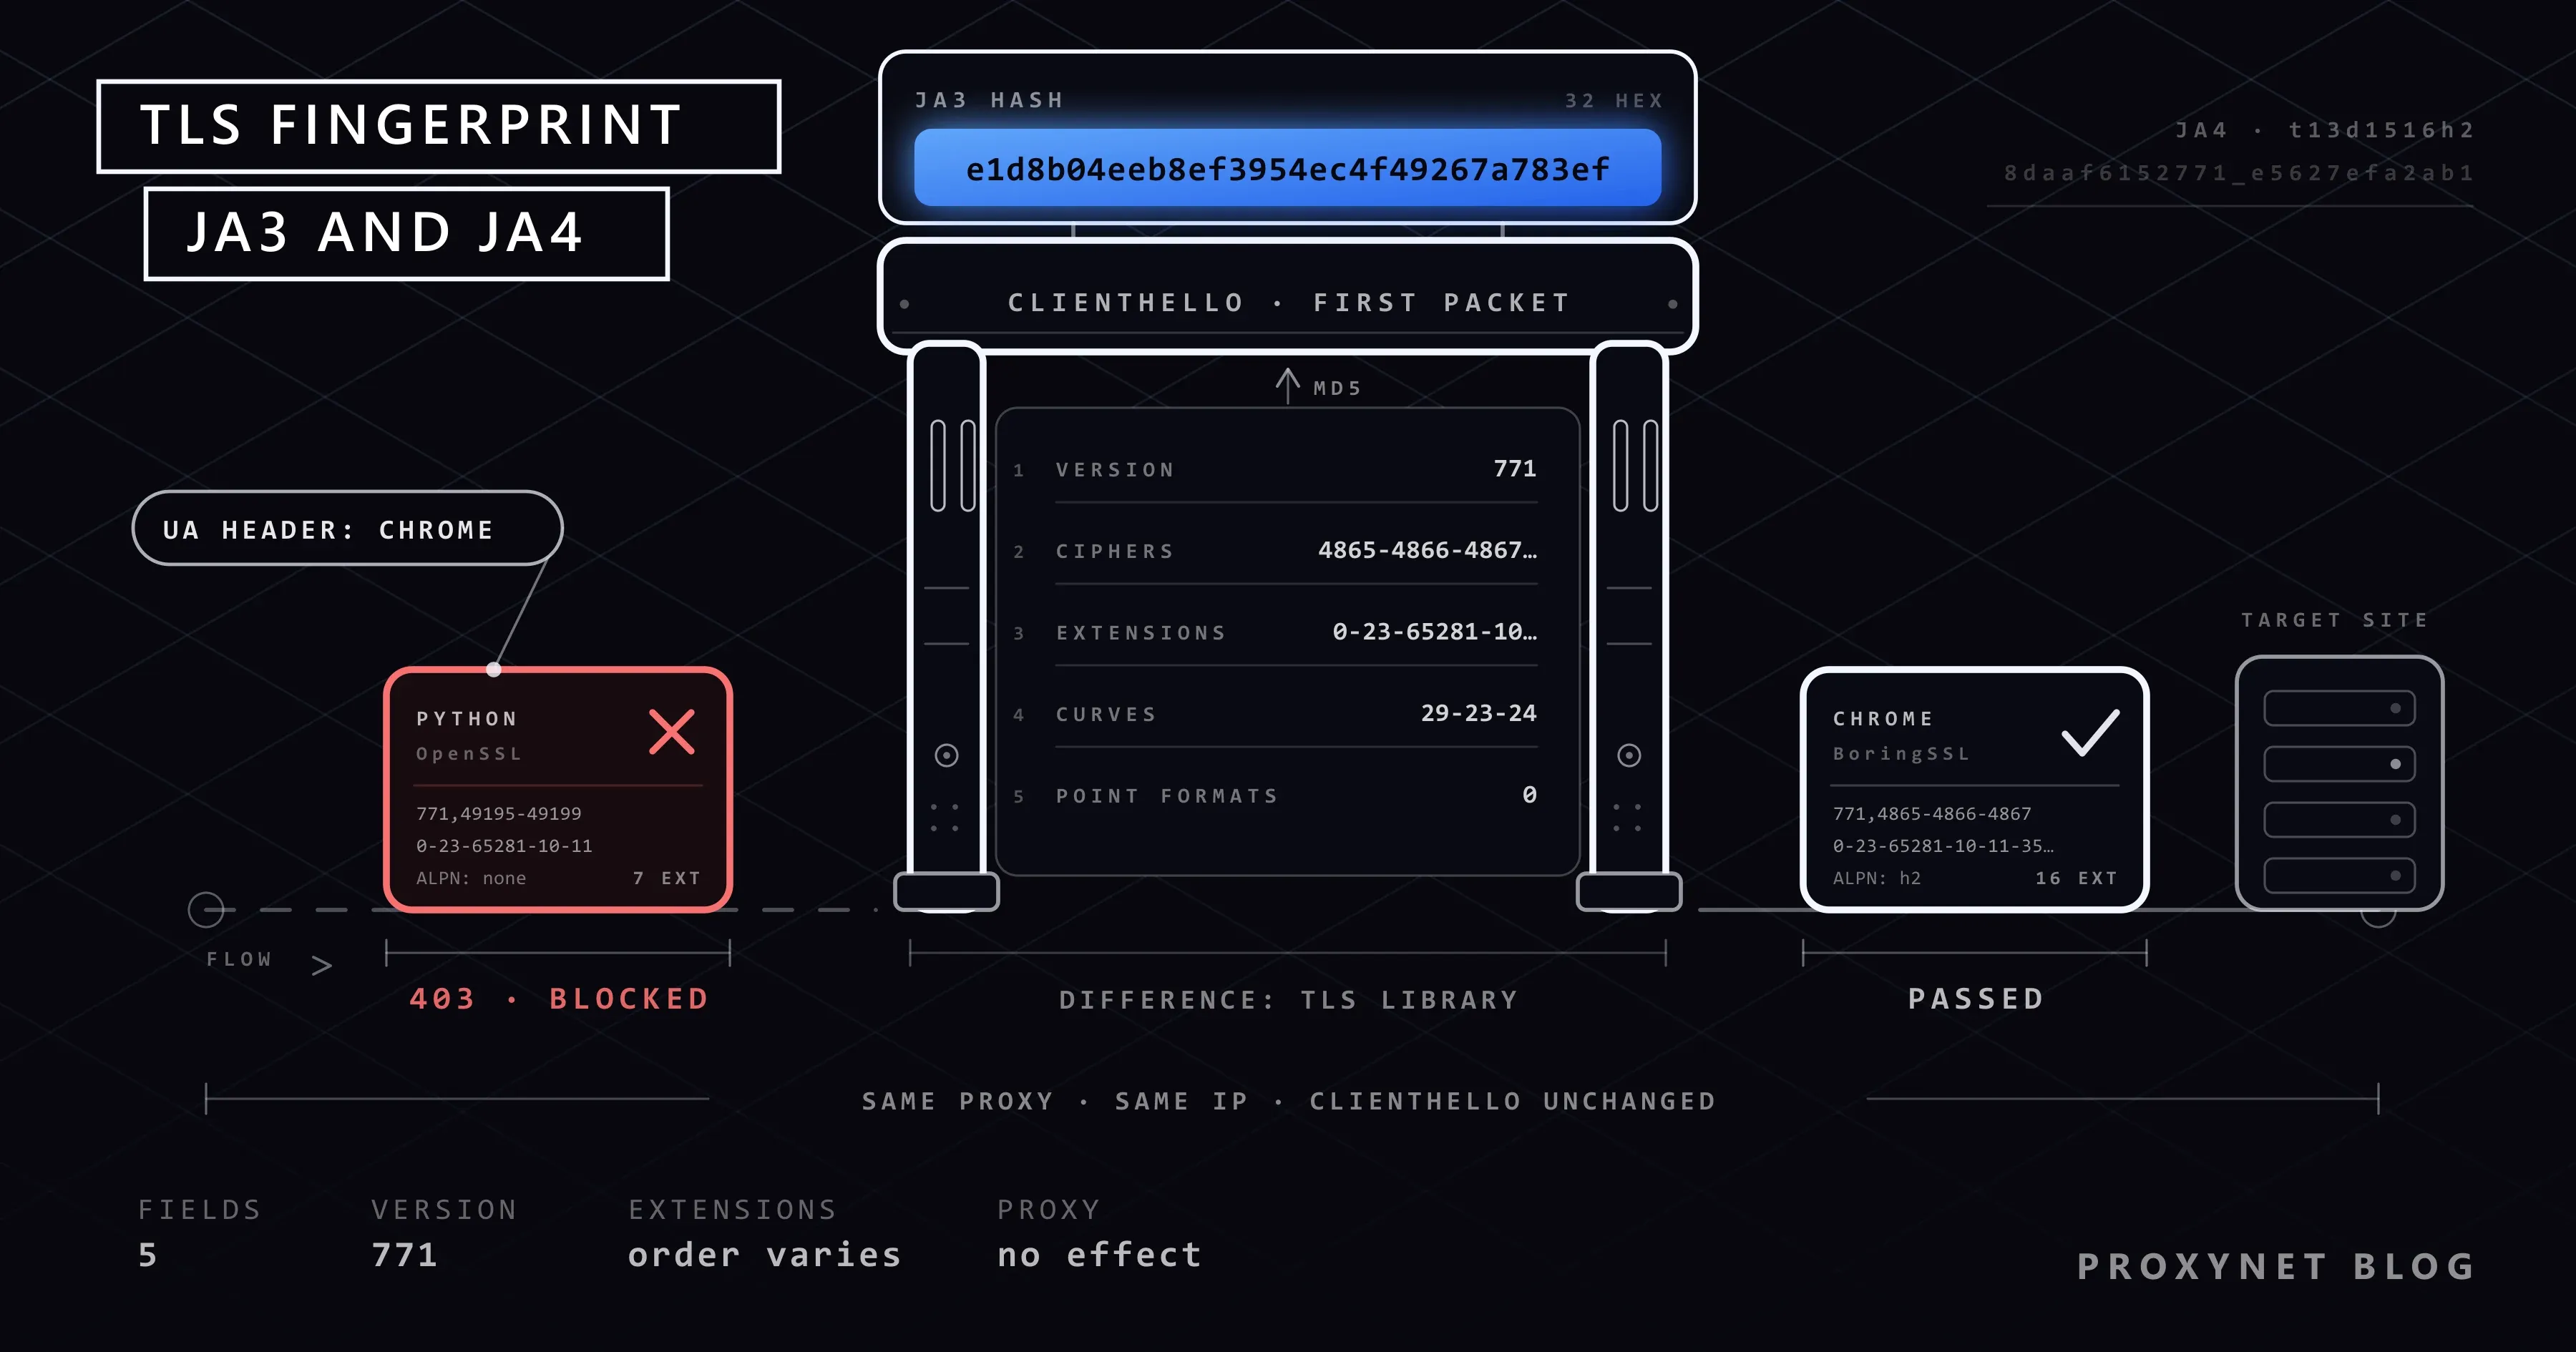
Yayın tarihi
TLS Parmak İzi ve JA3 Nedir, Nasıl Çalışır?
TLS parmak izi, istemcinin ClientHello paketindeki şifre ve uzantı listesinden çıkarılan kimliktir. JA3 ve JA4 hesabını, proxy'nin buna etkisini anlatıyoruz.
Yazar:Acar Diveroli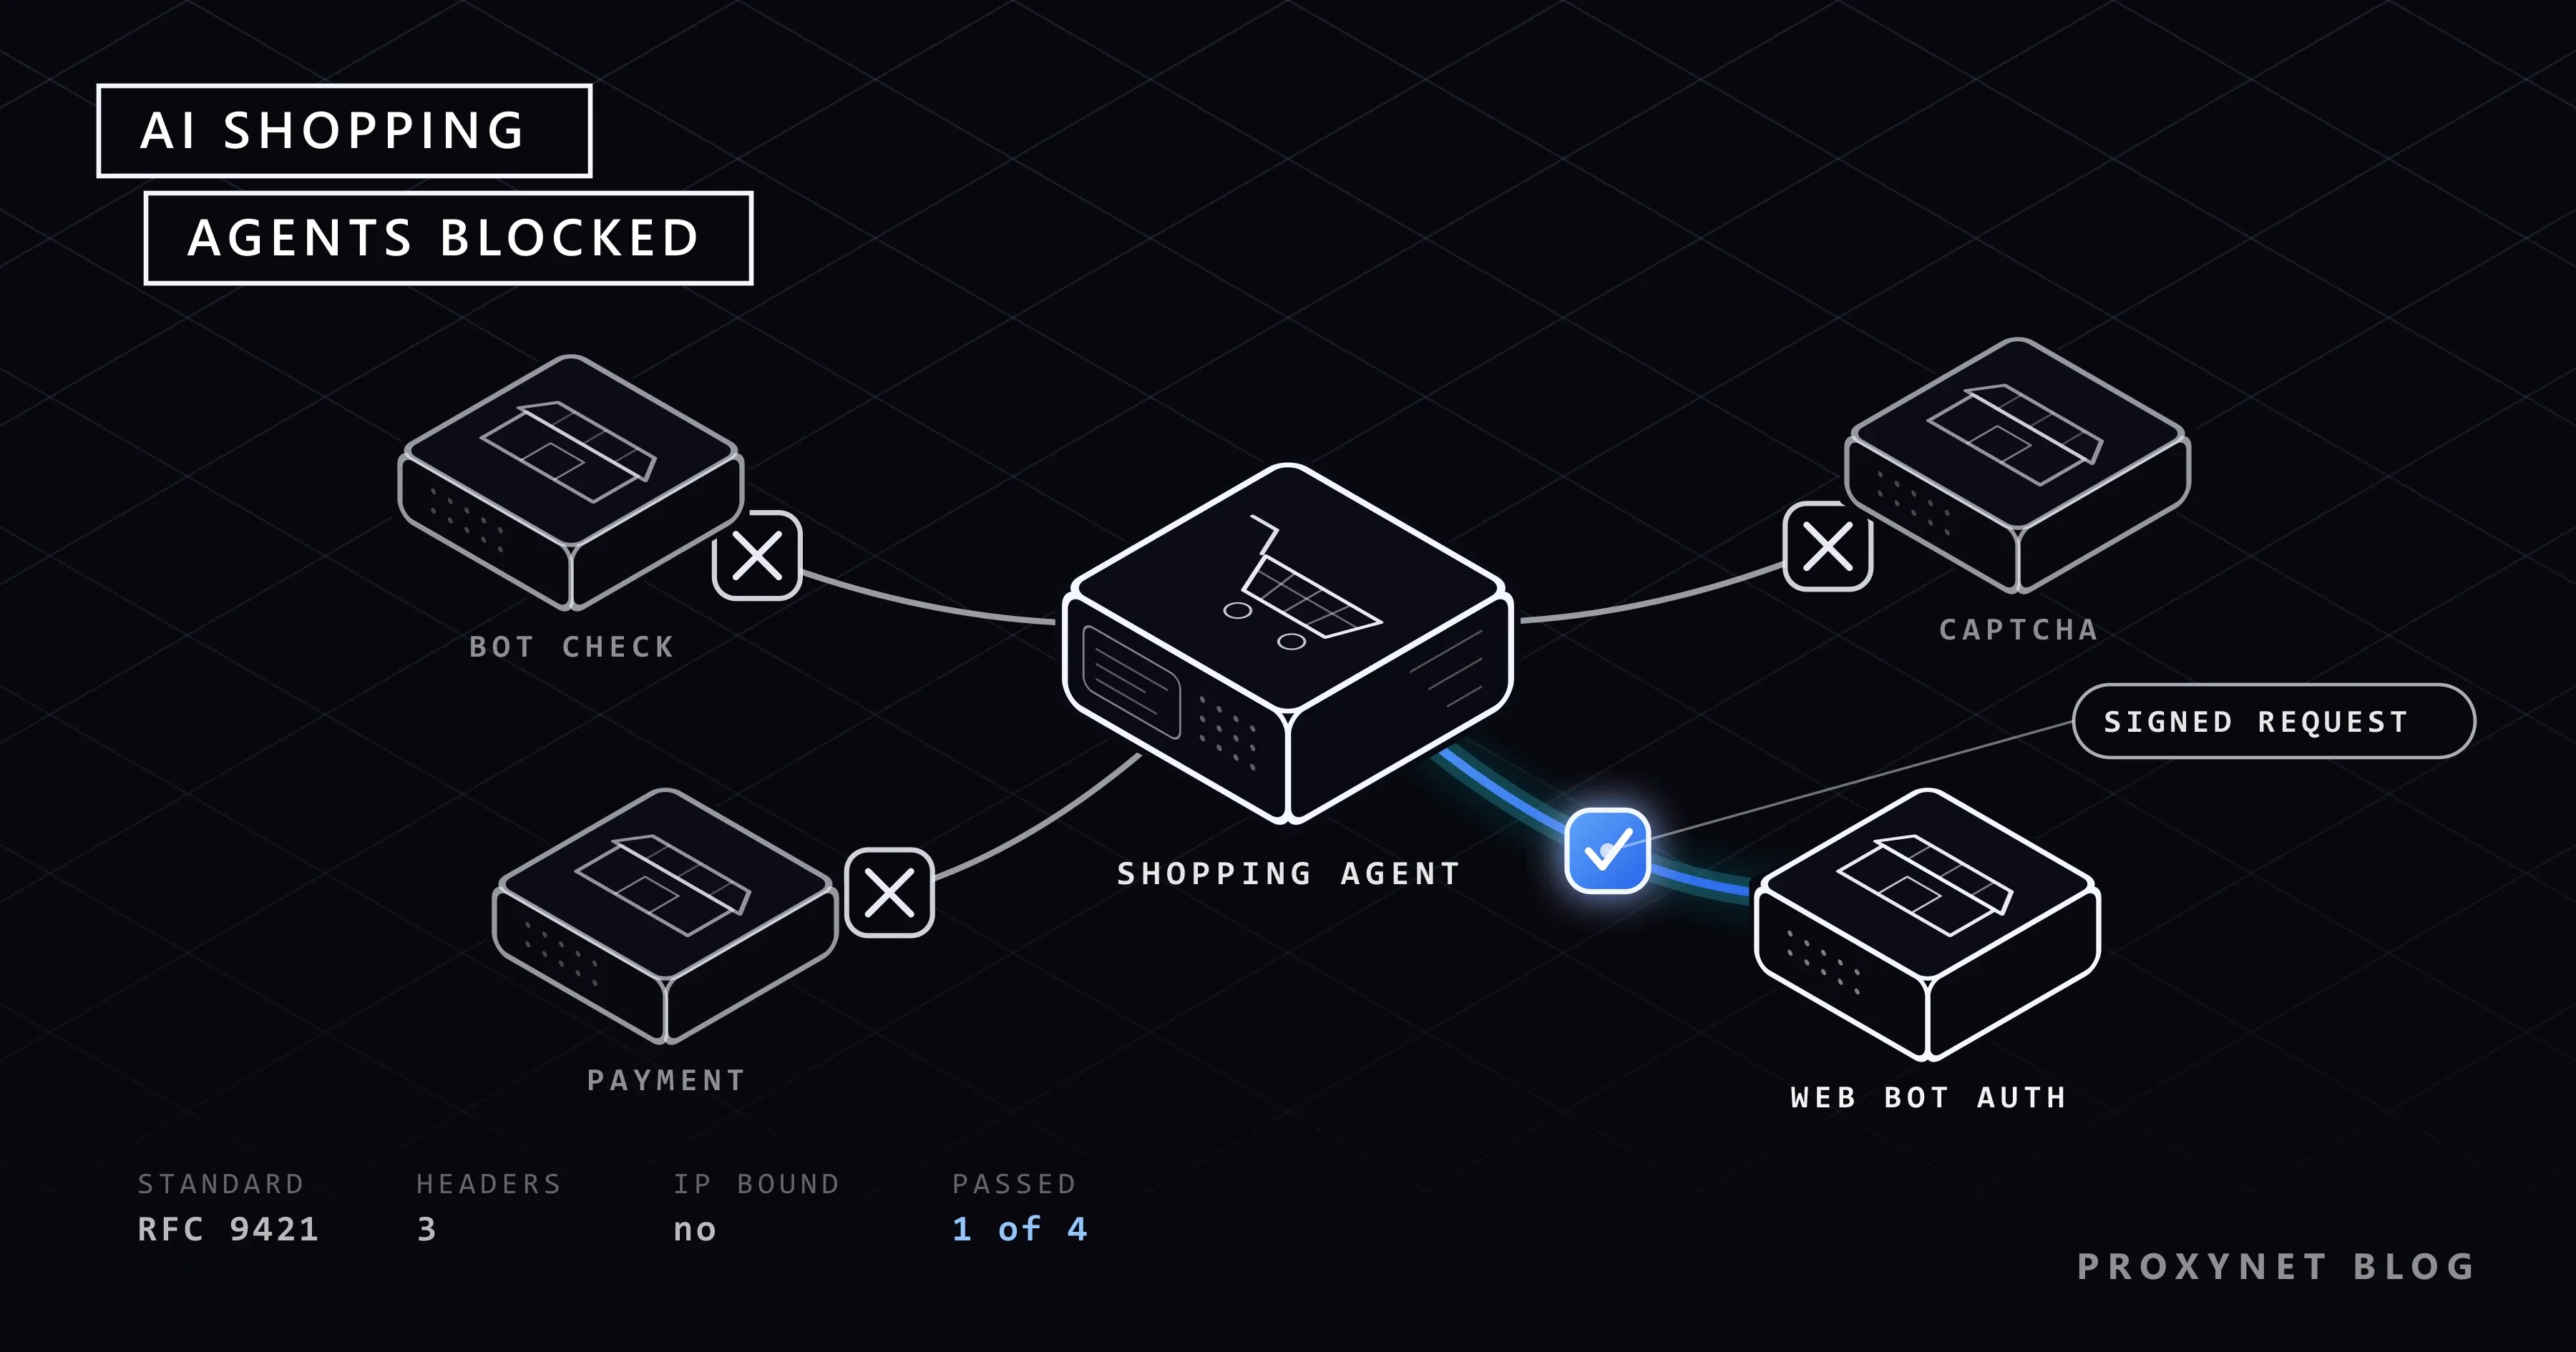
Yayın tarihi
AI Alışveriş Ajanları Neden Sitelerde Engelleniyor?
Alışveriş ajanları bot korumasına takılıyor, çünkü site insanı yetkili bir ajandan ayıramıyor. Nedenlerini ve imzalı ajanlar gibi yeni çözümleri anlatıyoruz.
Yazar:Acar Diveroli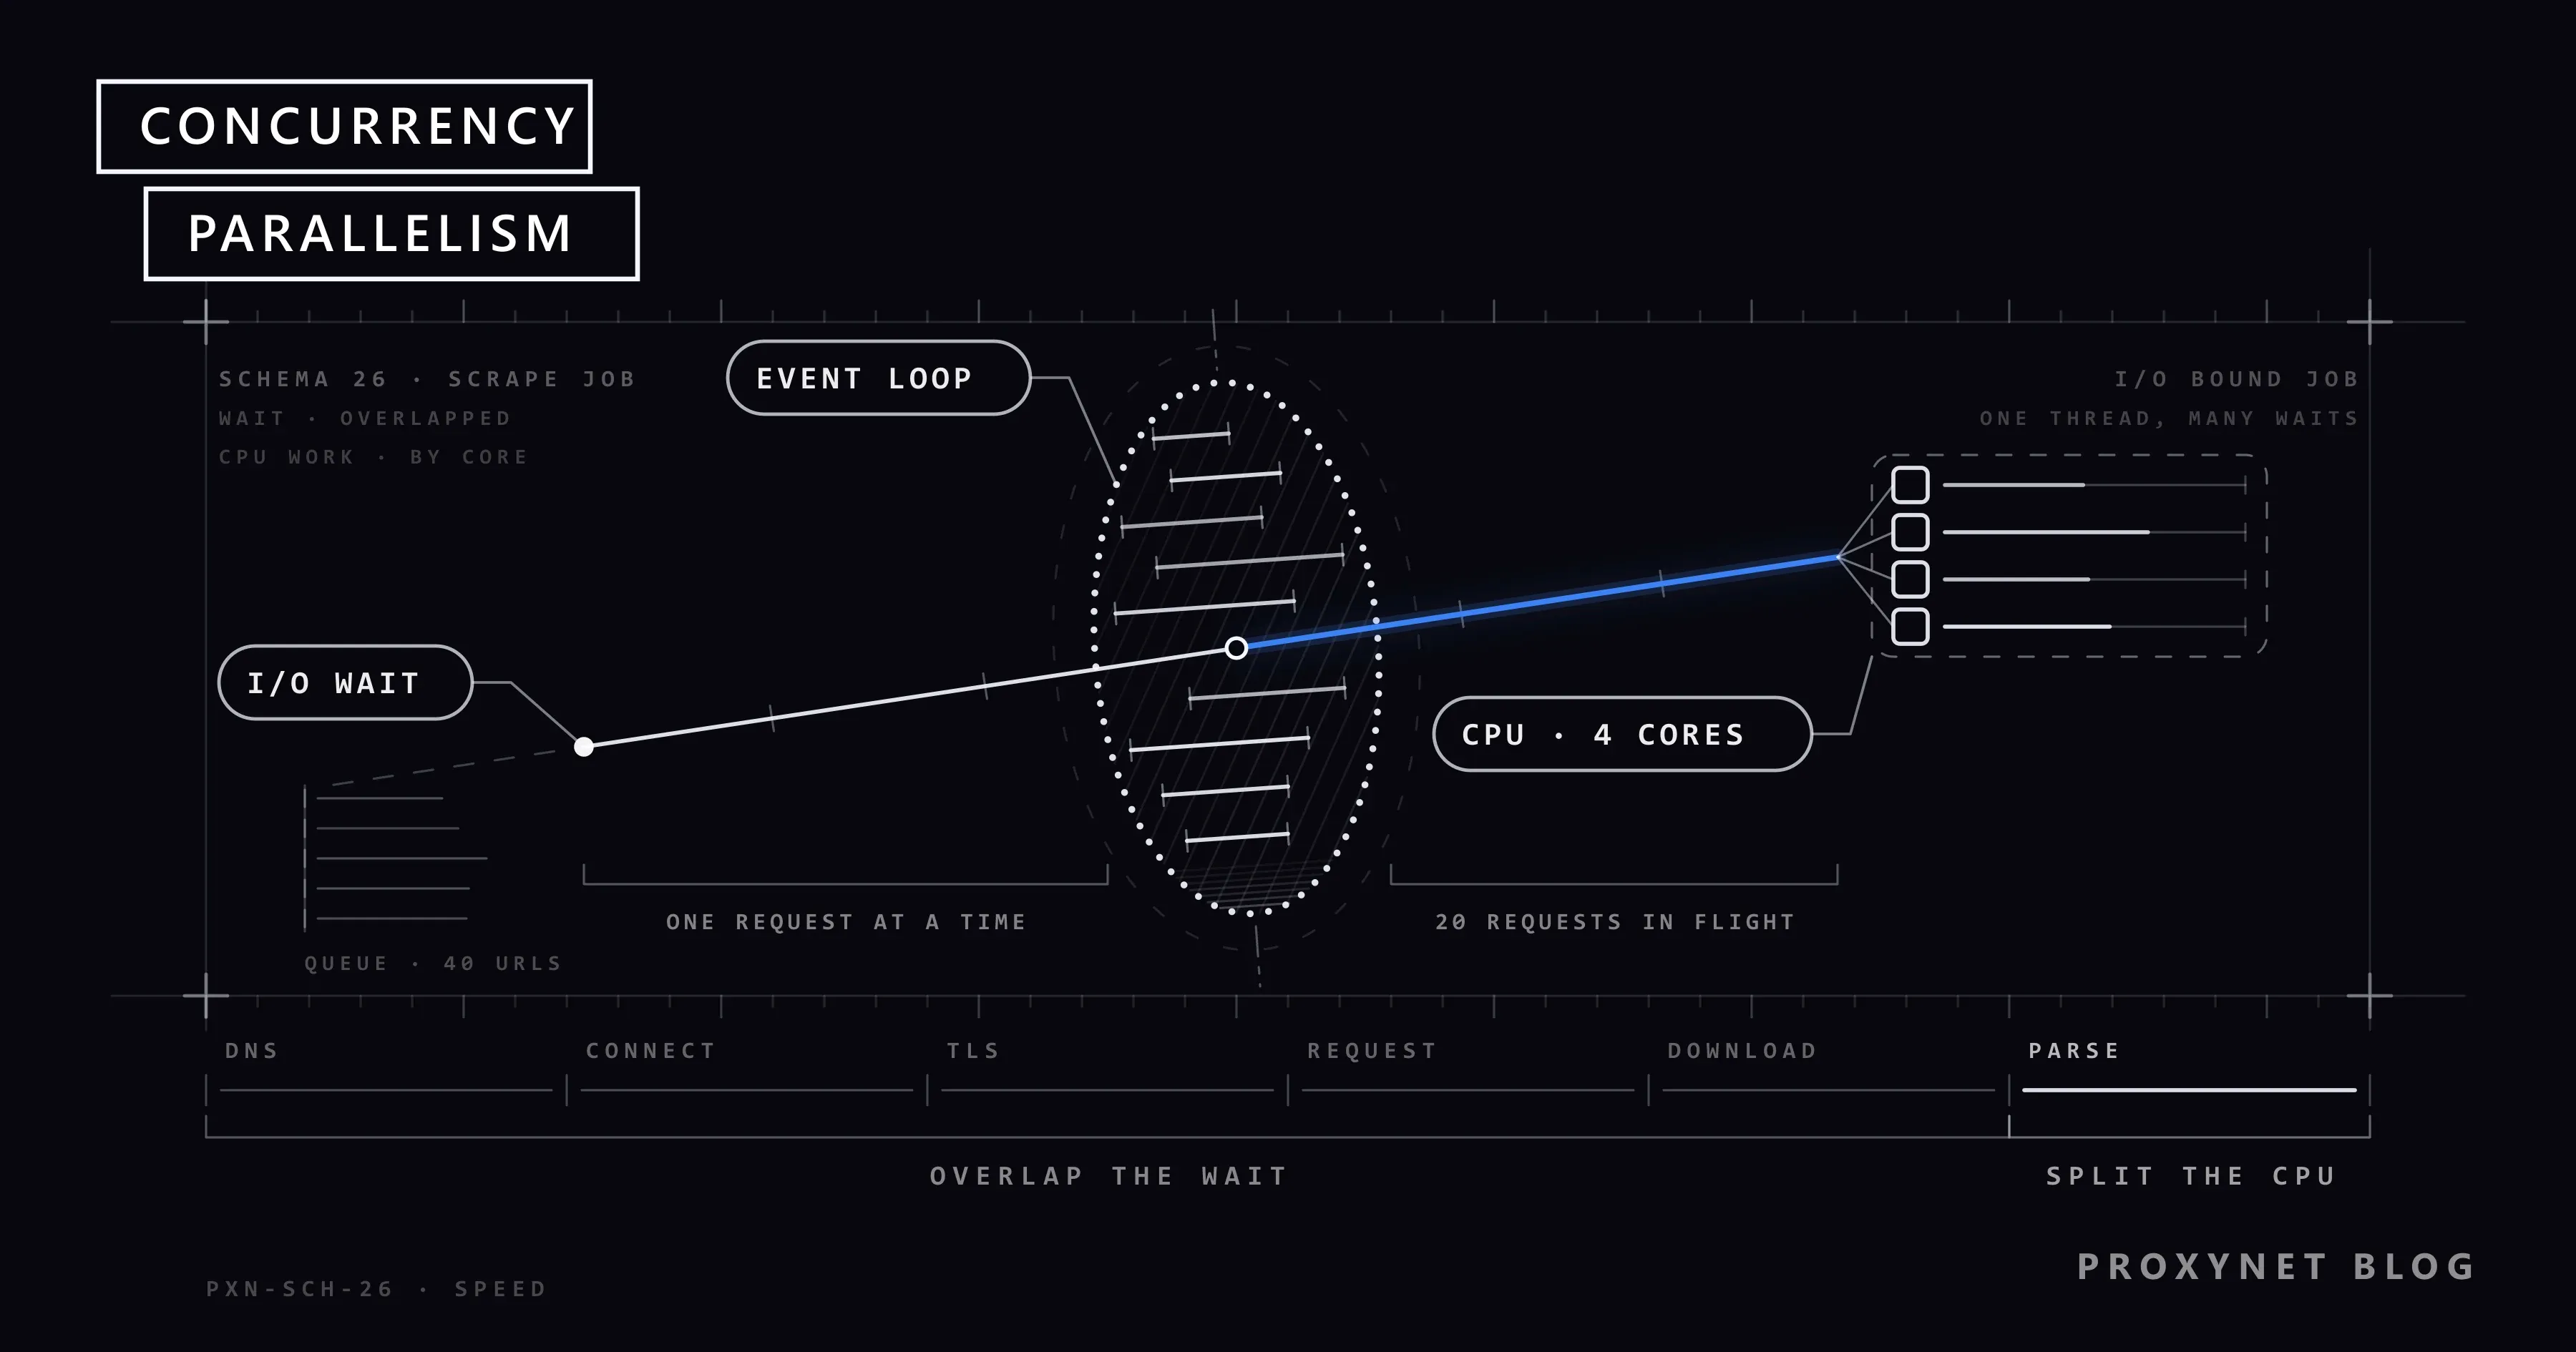
Yayın tarihi
Concurrency ve Parallelism: Scraping Hızını Ne Belirler?
Eşzamanlılık bekleme süresini, paralellik işlemci gücünü değerlendirir. Scraping'de hangisinin hızı artırdığını Python ve Node.js örnekleriyle açıklıyoruz.
Yazar:Acar Diveroli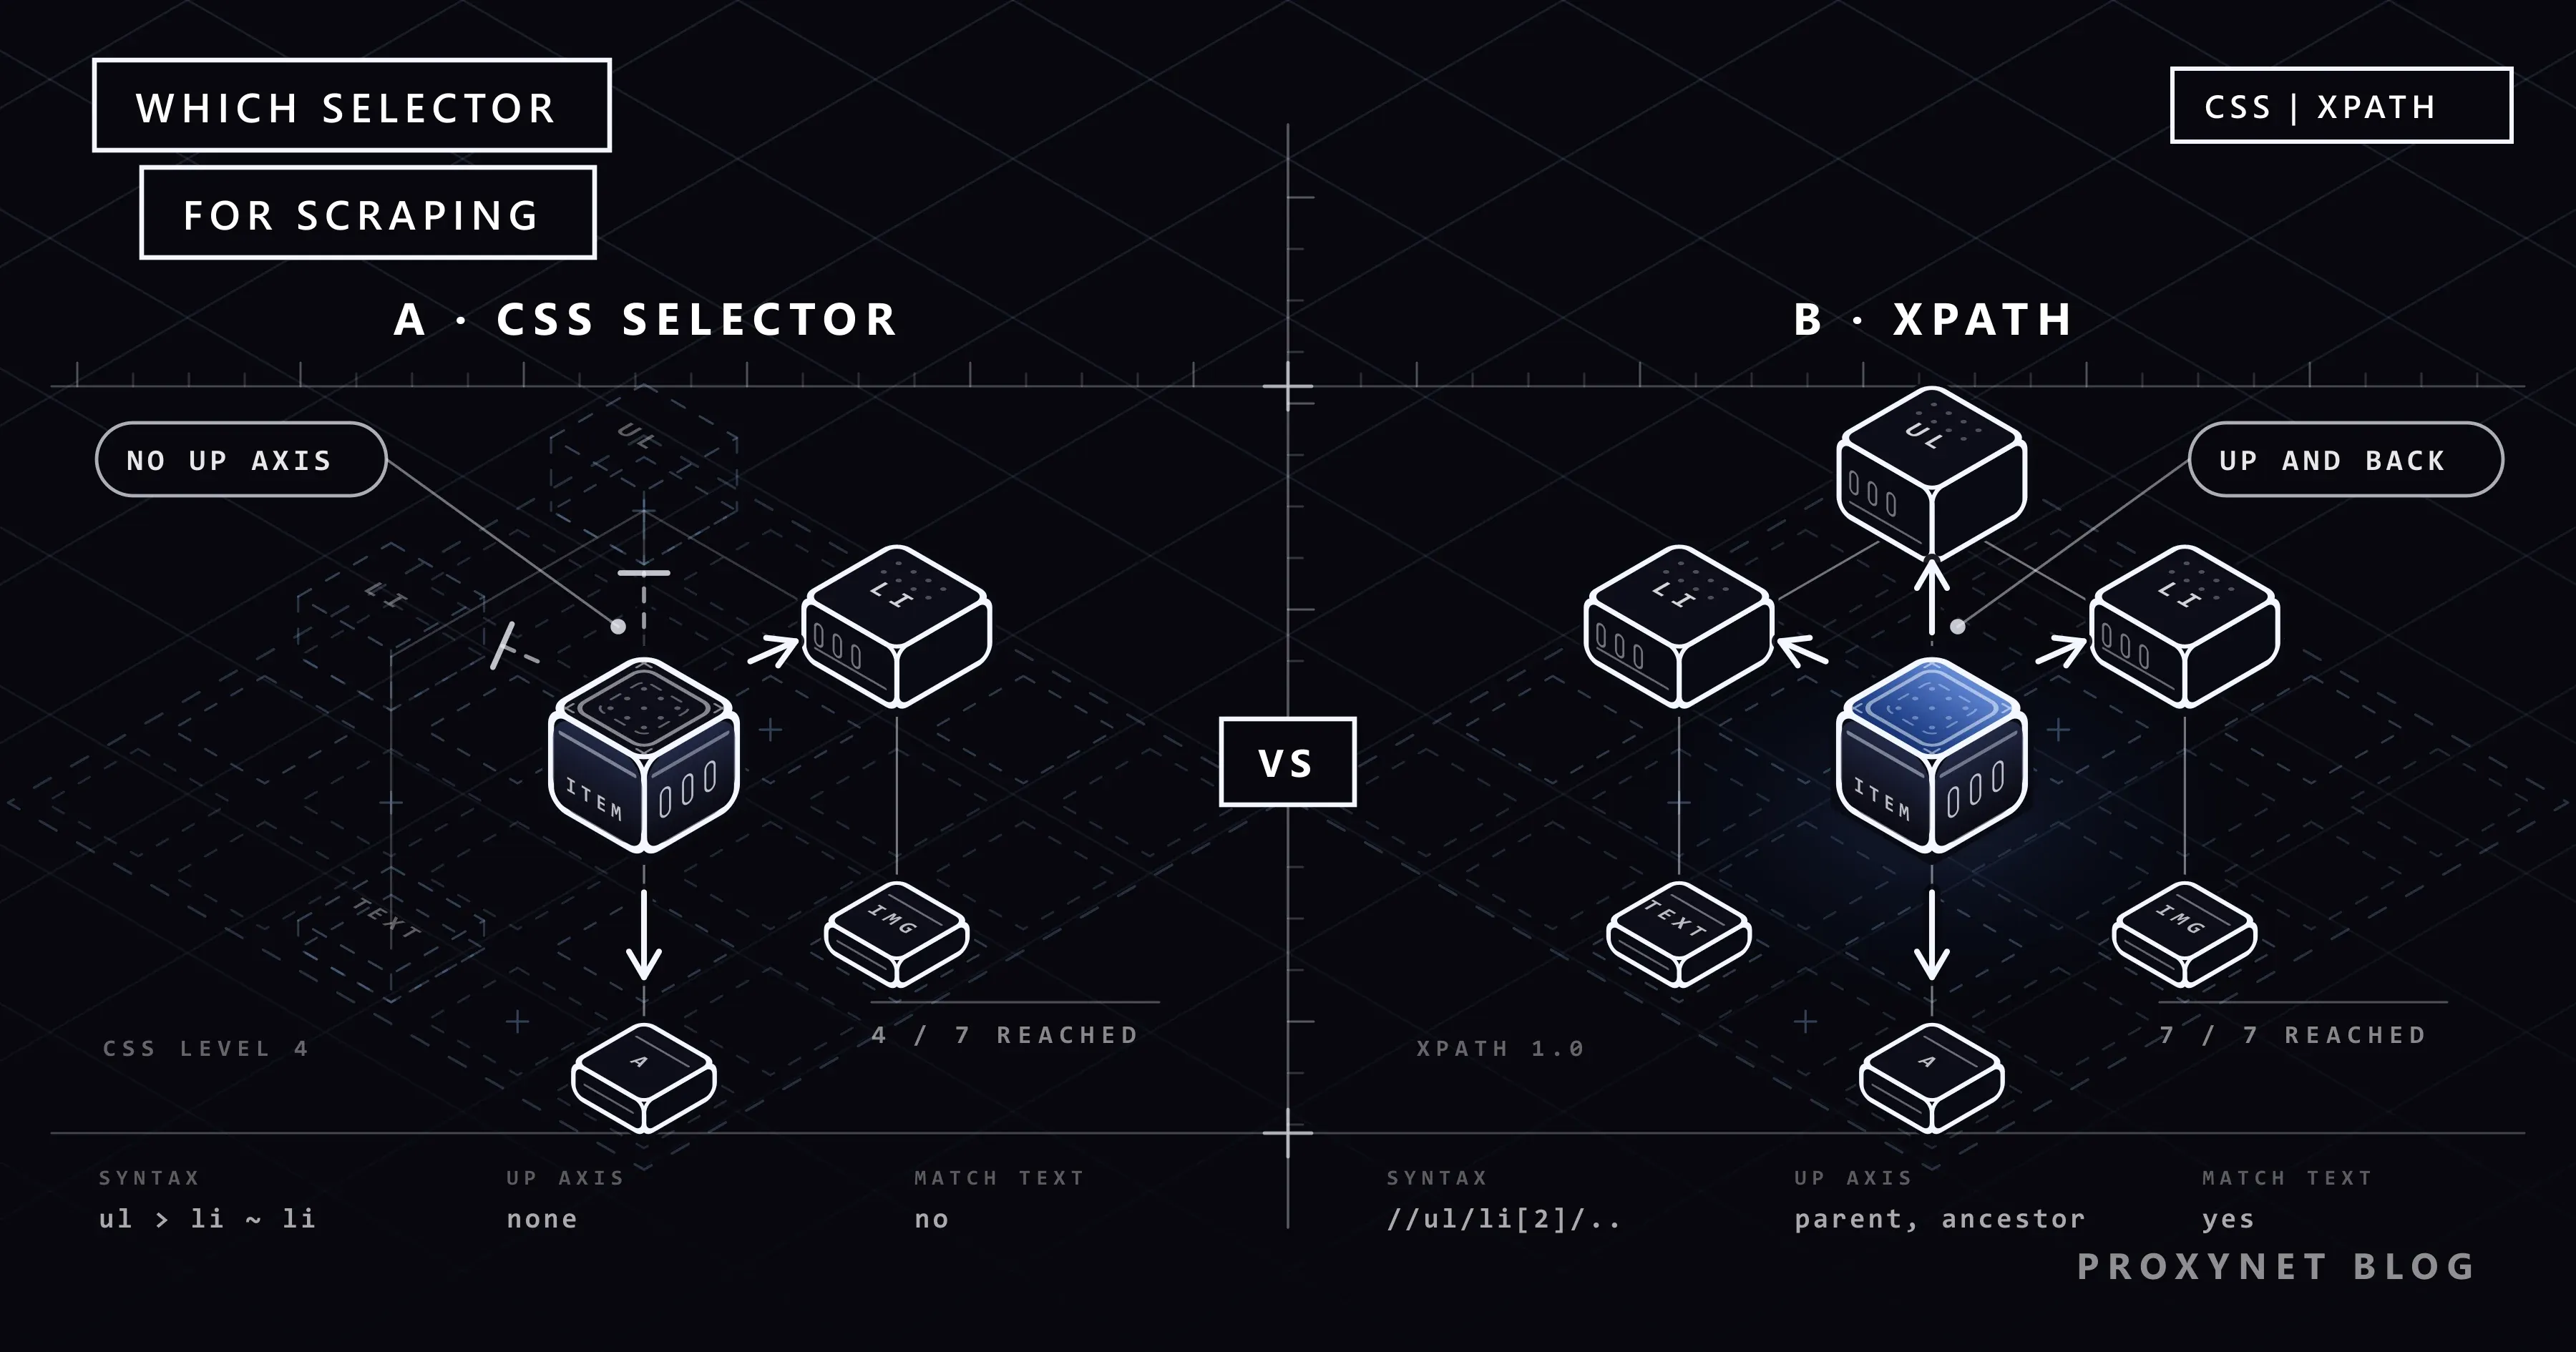
Yayın tarihi
CSS Selector ve XPath: Web Scraping İçin Hangisi?
CSS selector kısa ve okunaklıdır, XPath ise metne ve üst öğelere göre de seçim yapar. İki yöntemi söz dizimi, hız ve Python örnekleriyle karşılaştırıyoruz.
Yazar:Acar Diveroli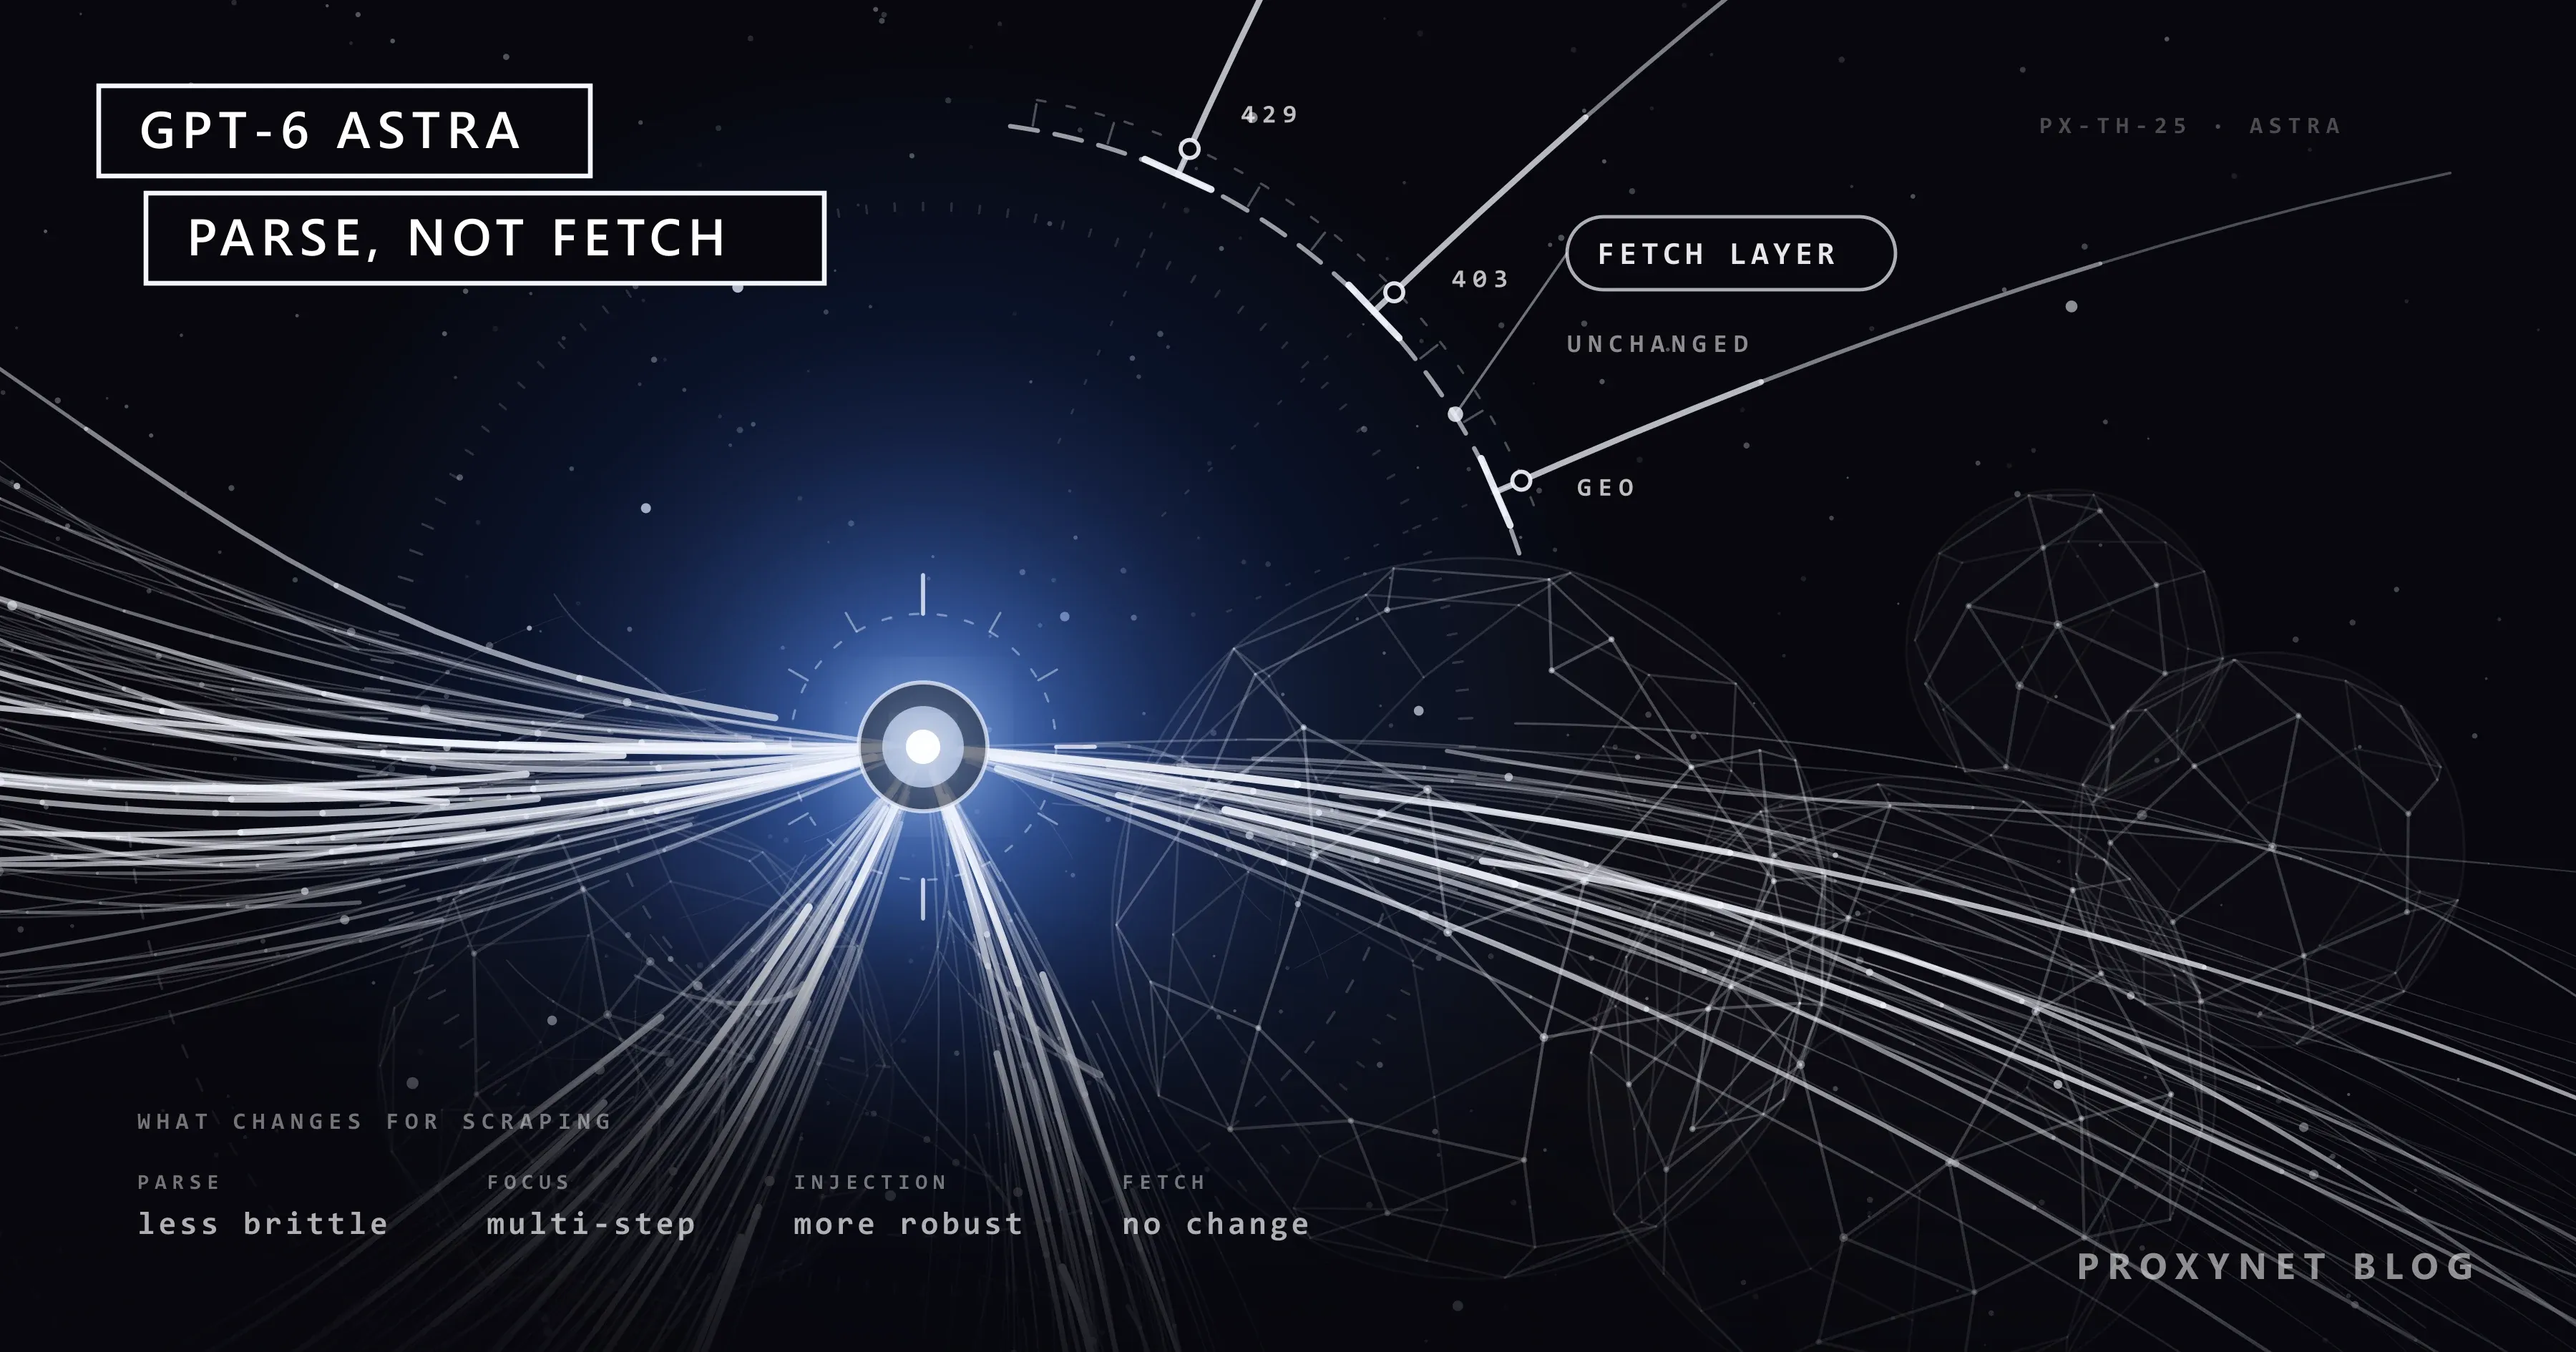
Yayın tarihi
GPT-6 Astra ile Web Kazıma: Neler Değişti?
GPT-6 Astra sayfayı okuma ve tarayıcıyı yönetme işini güçlendiriyor; engel, CAPTCHA ve istek sınırını ise çözmüyor. Kazıma akışında modelin gerçek yeri.
Yazar:Acar Diveroli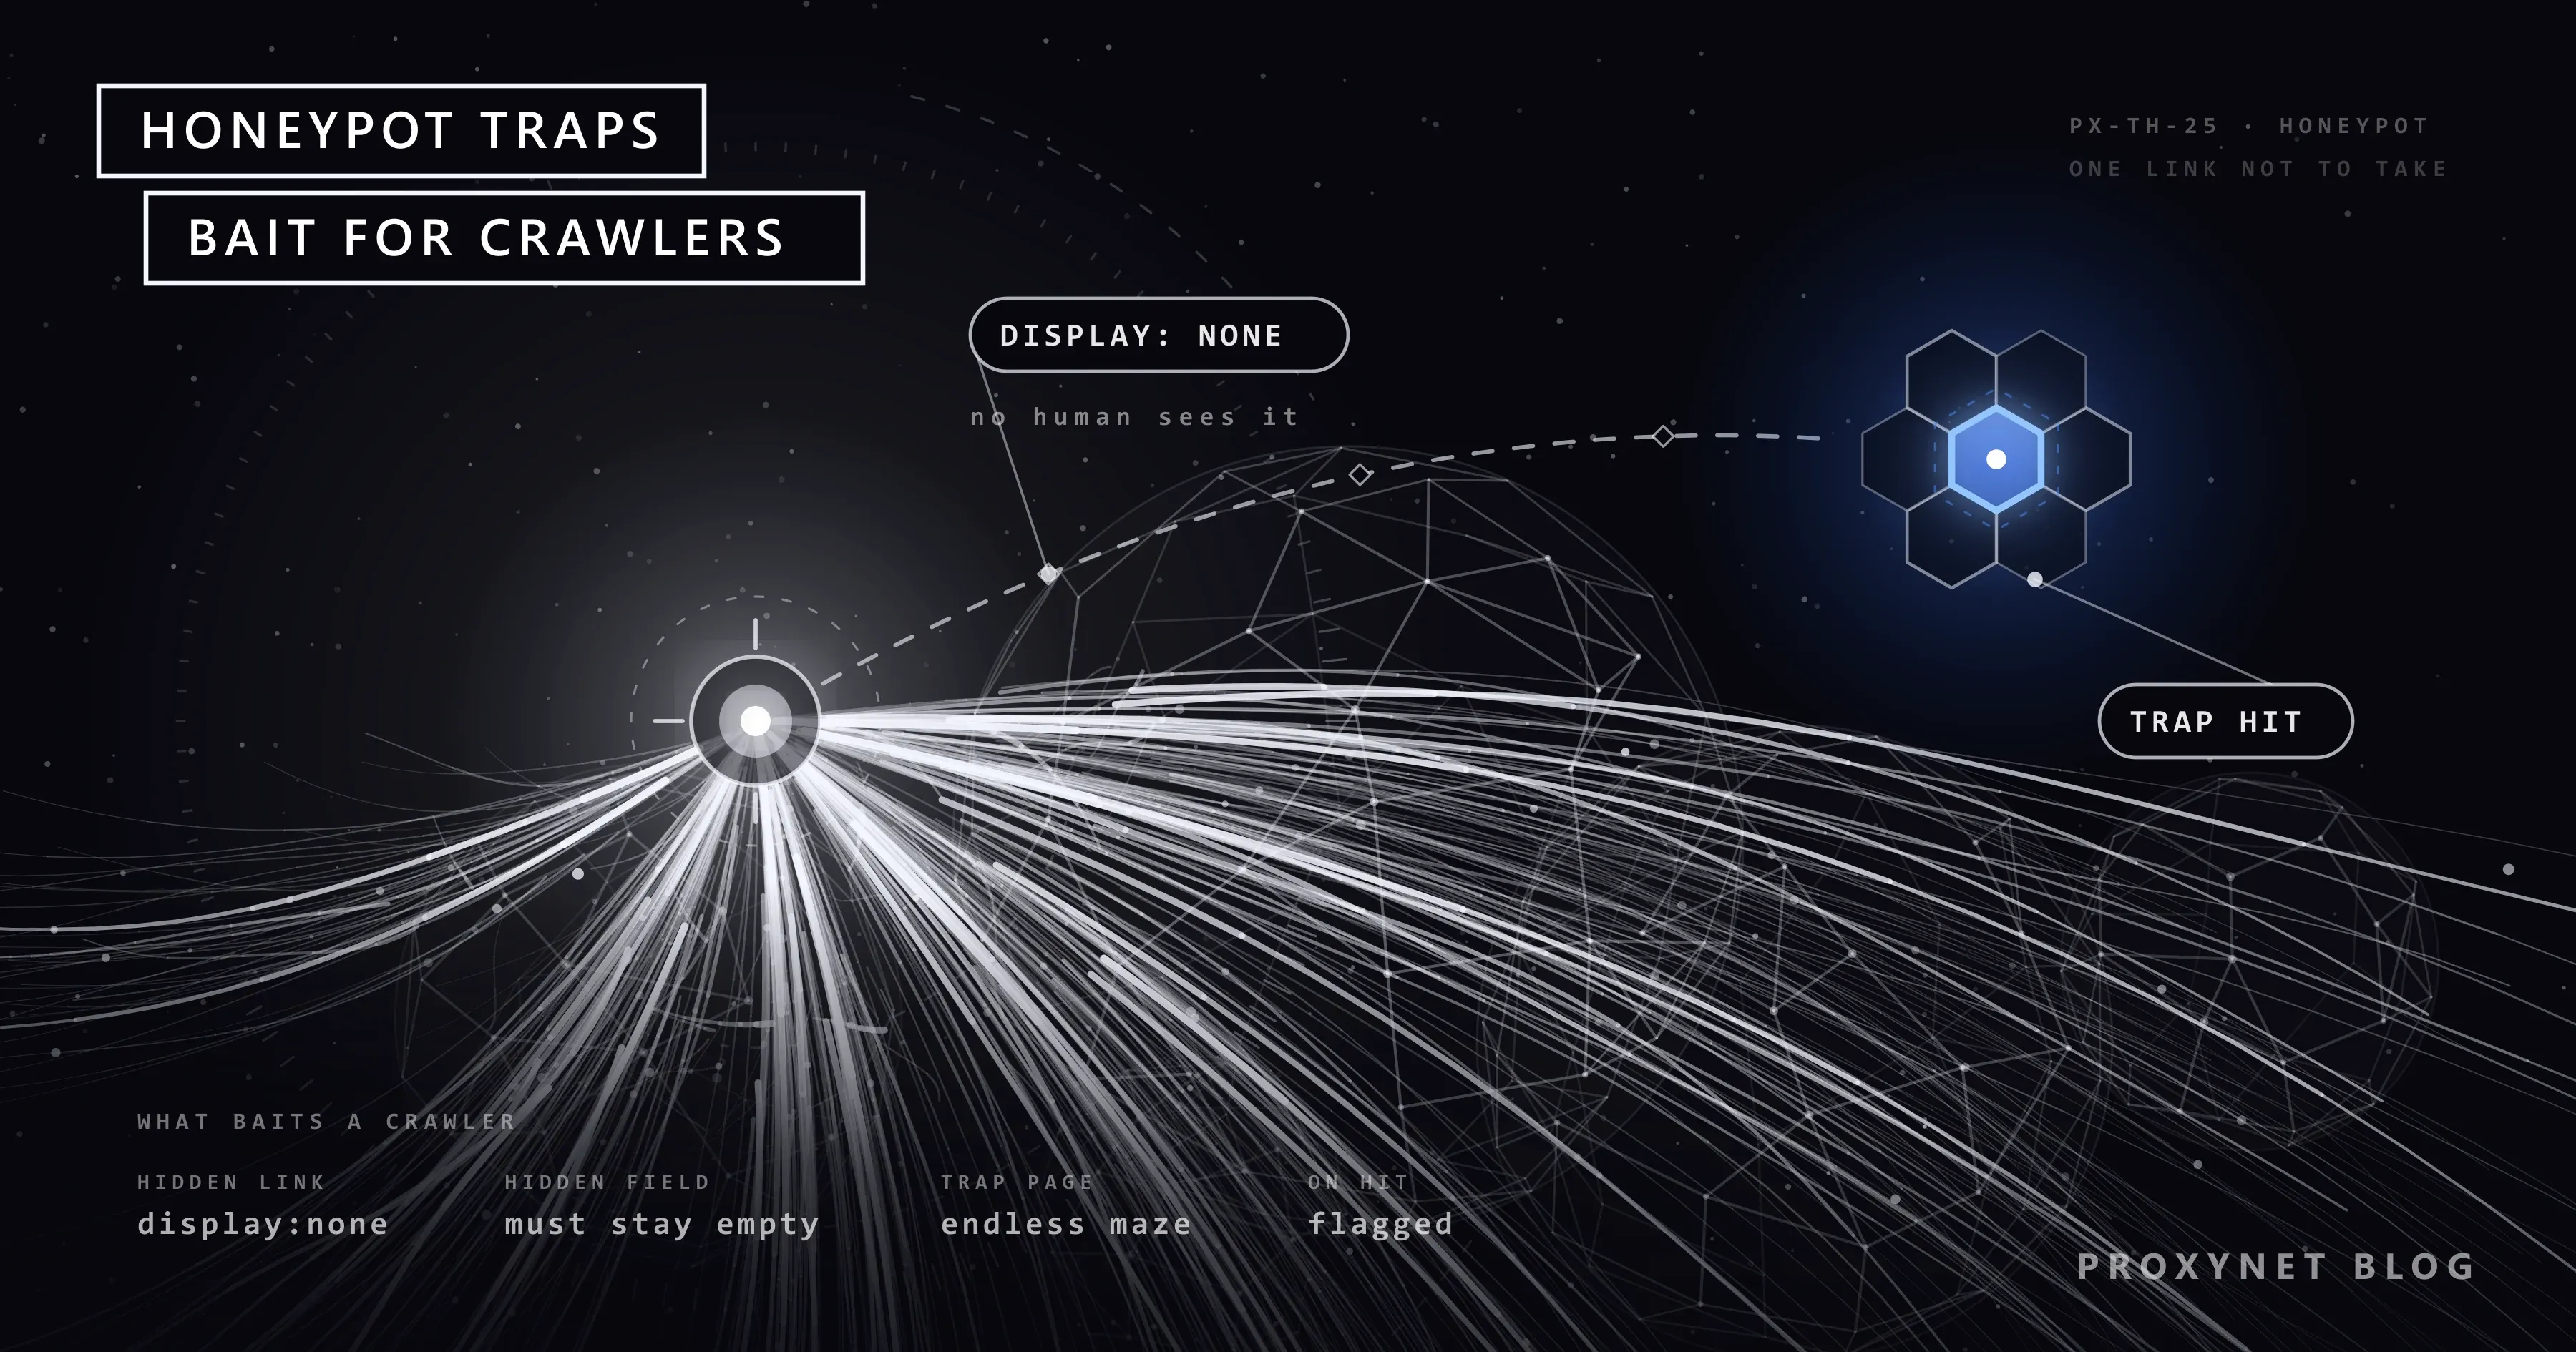
Yayın tarihi
Honeypot Tuzakları Nedir, Web Scraping'i Nasıl Etkiler?
Honeypot, ziyaretçinin görmediği ama botların takıldığı gizli bağlantılardır. Nasıl çalıştıklarını ve bir scraper'ı nasıl işaretlediklerini anlatıyoruz.
Yazar:Acar Diveroli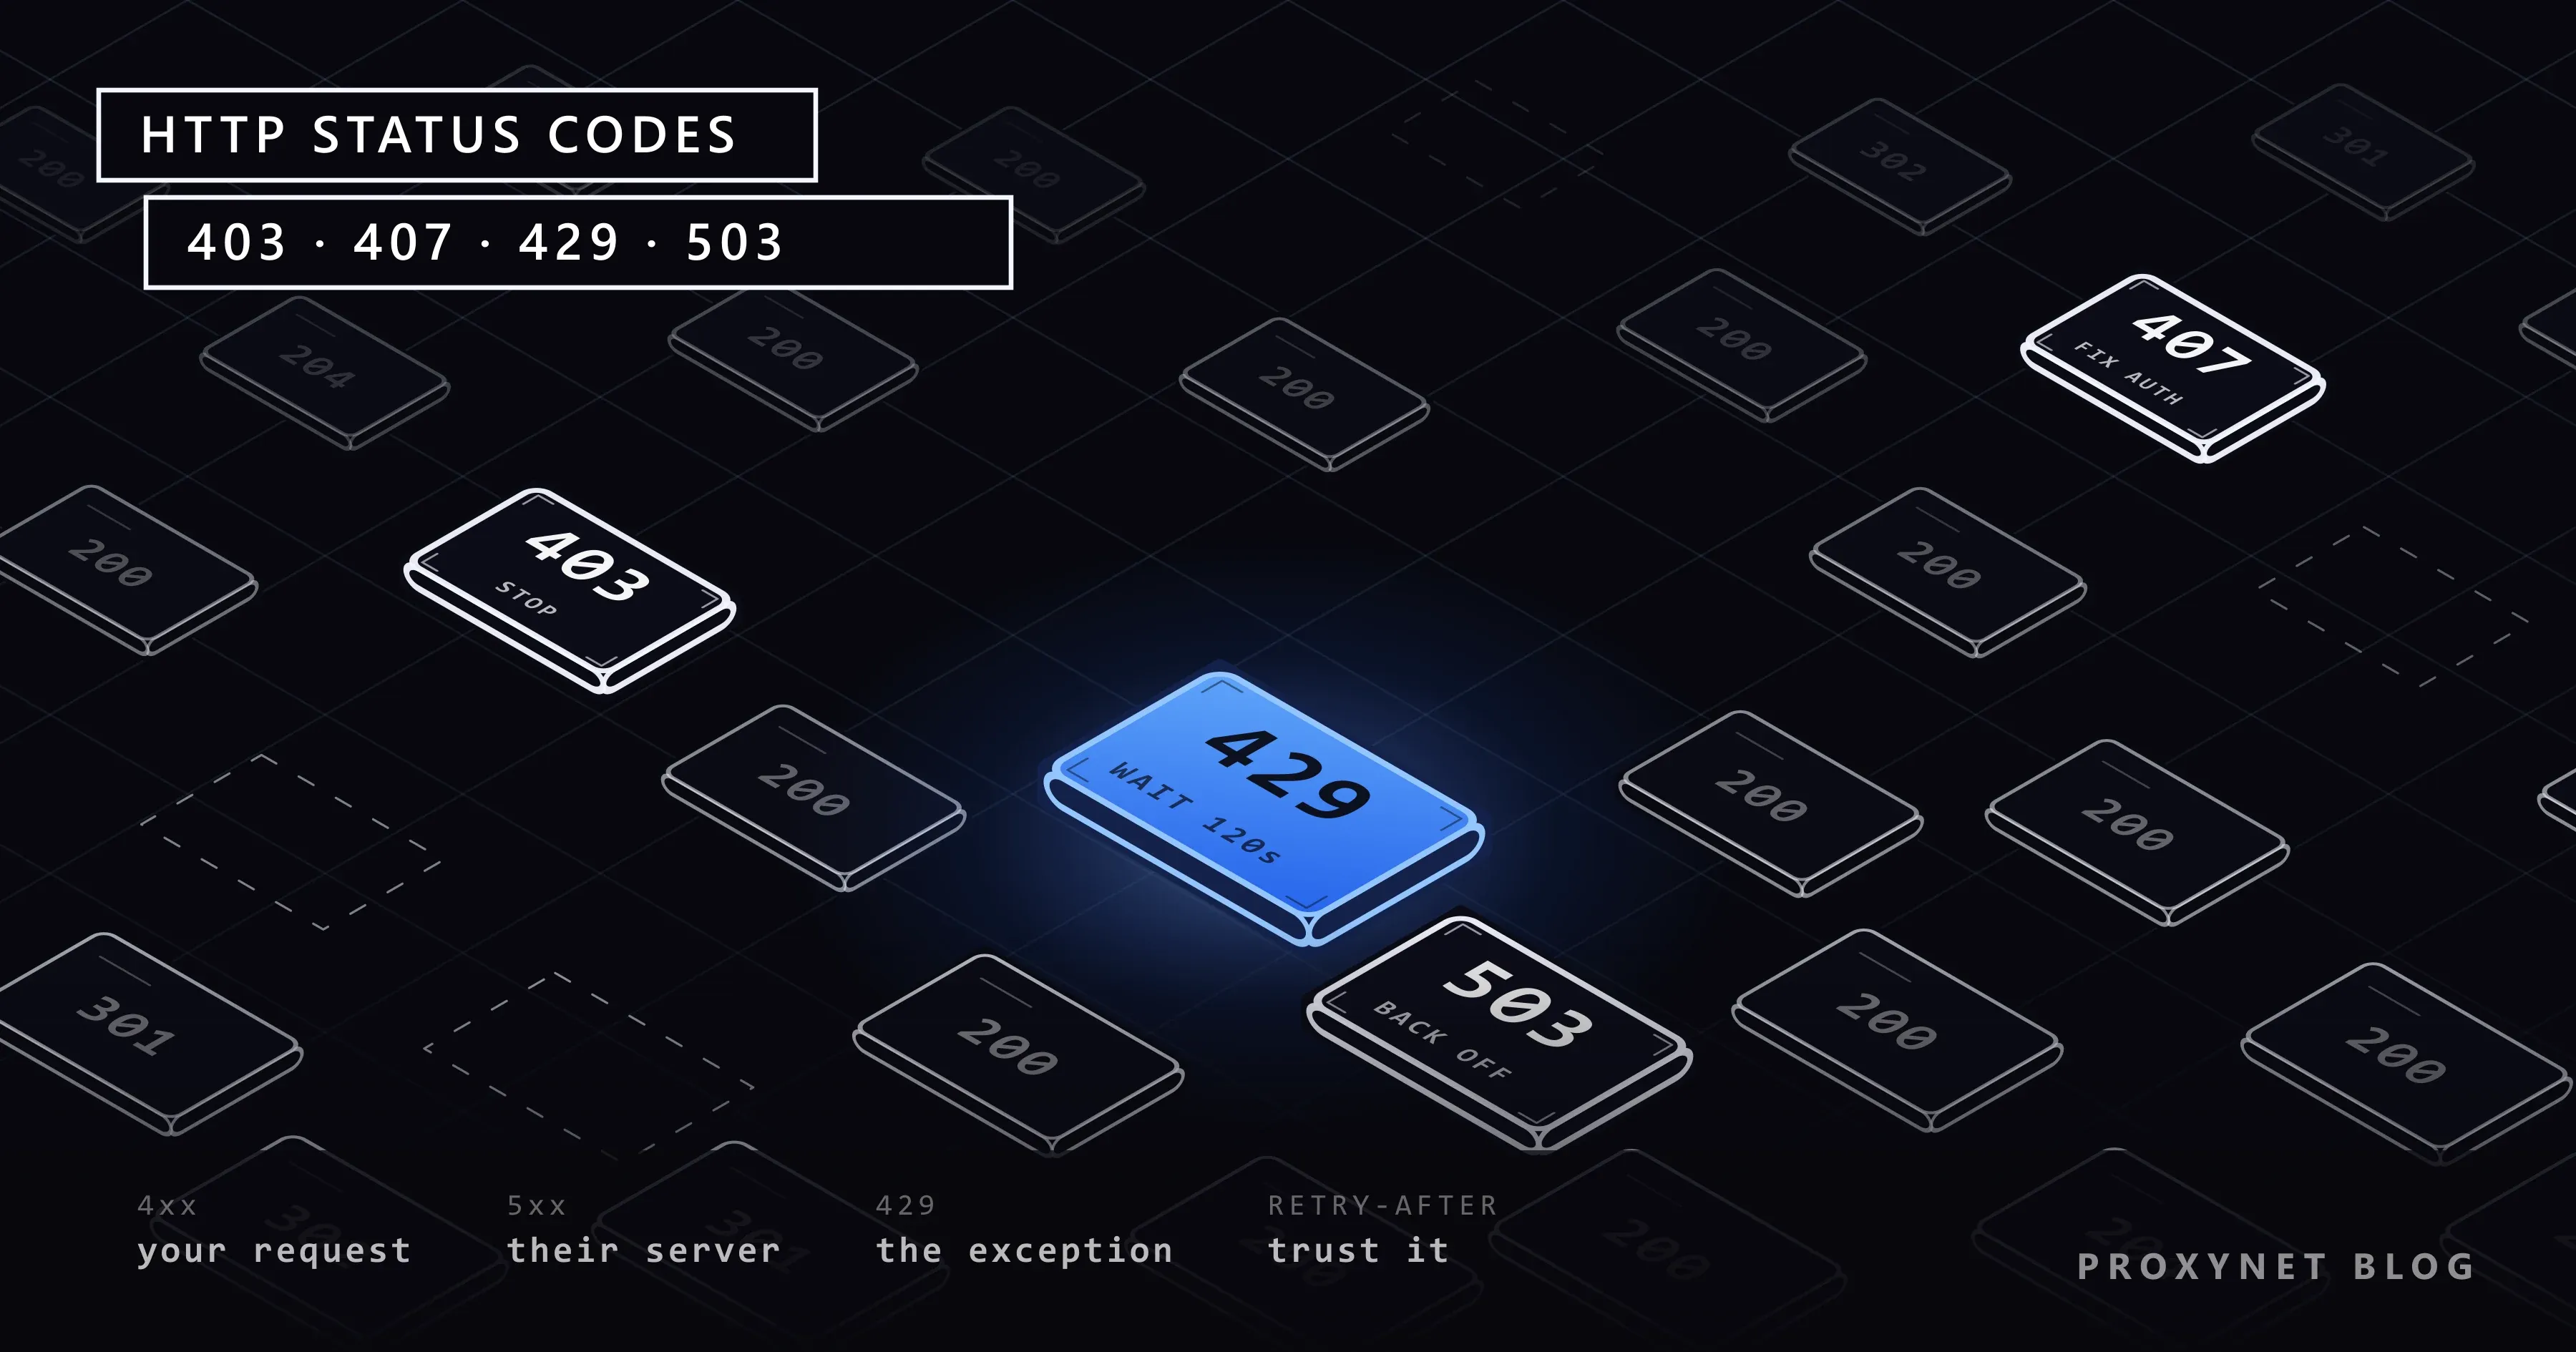
Yayın tarihi
Scraping'de HTTP Hata Kodları: 403, 407, 429 ve 503
403, 407, 429 ve 503 yanıtları scraping'de farklı sorunlara işaret eder. Her kodun anlamını, nedenini ve Retry-After ile doğru yeniden denemeyi anlatıyoruz.
Yazar:Acar Diveroli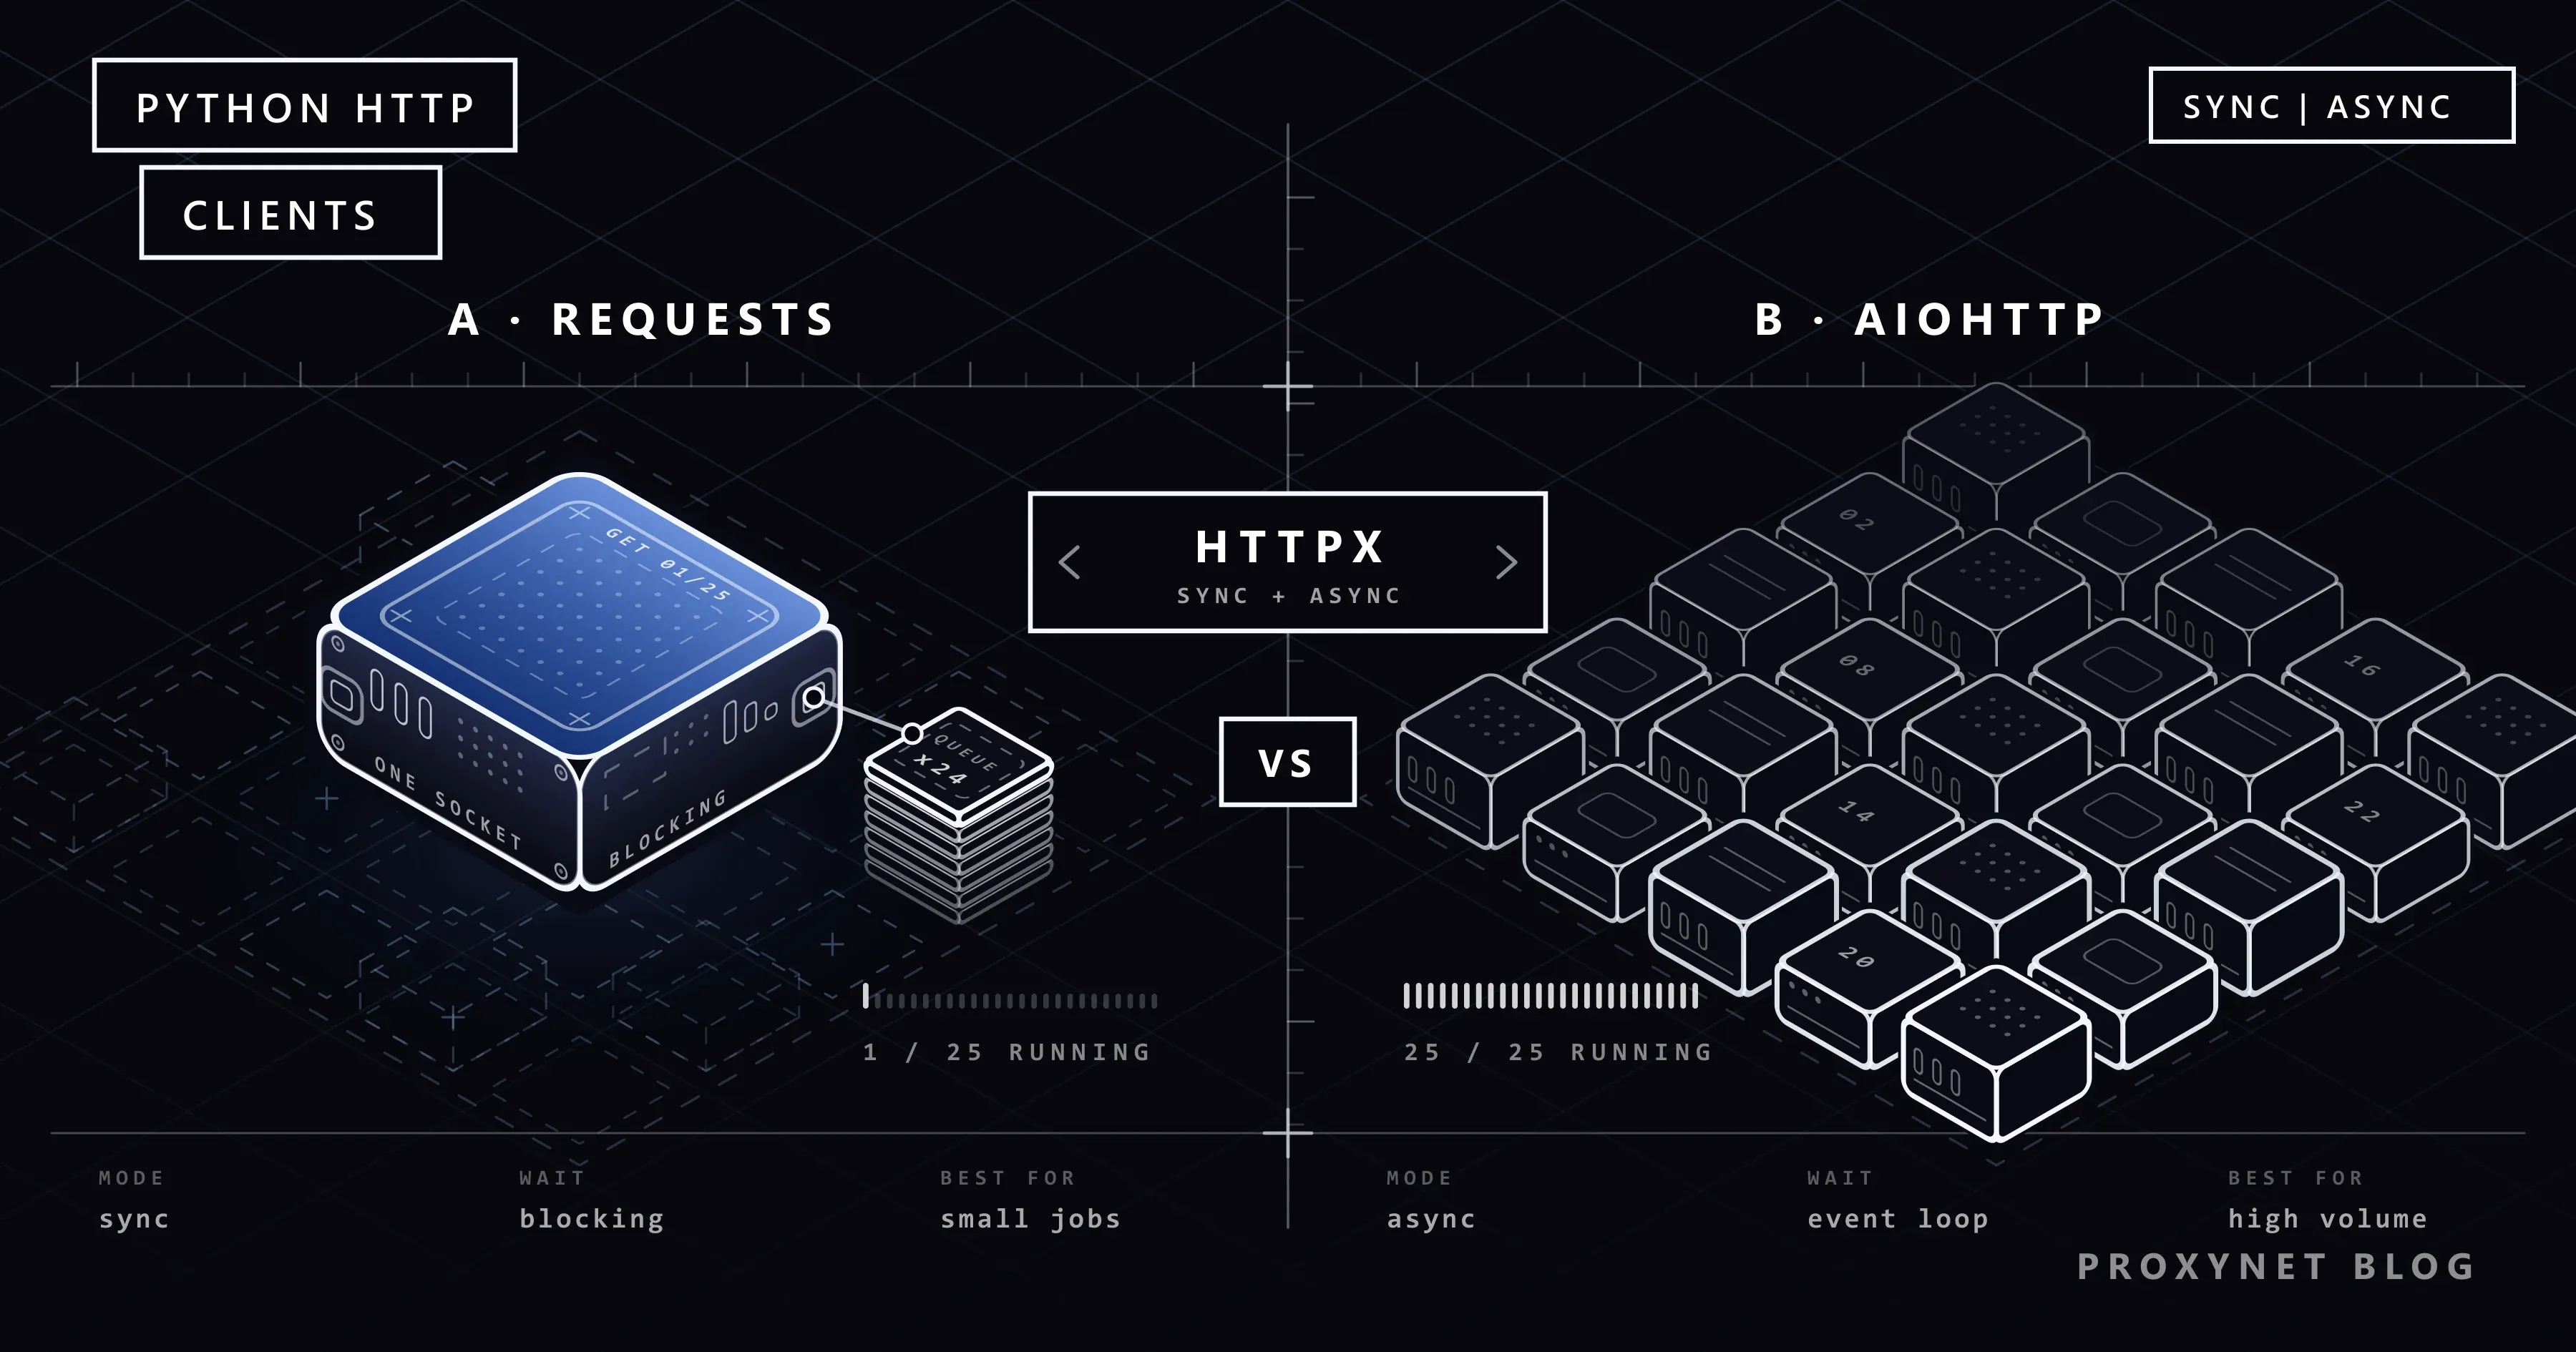
Yayın tarihi
HTTPX, Requests ve AIOHTTP Karşılaştırması
Requests basit ve senkron, AIOHTTP asenkron, HTTPX ise ikisini de sunar. Proxy kullanımı, performans ve hangi projede hangisinin seçileceği kod örnekleriyle.
Yazar:Acar Diveroli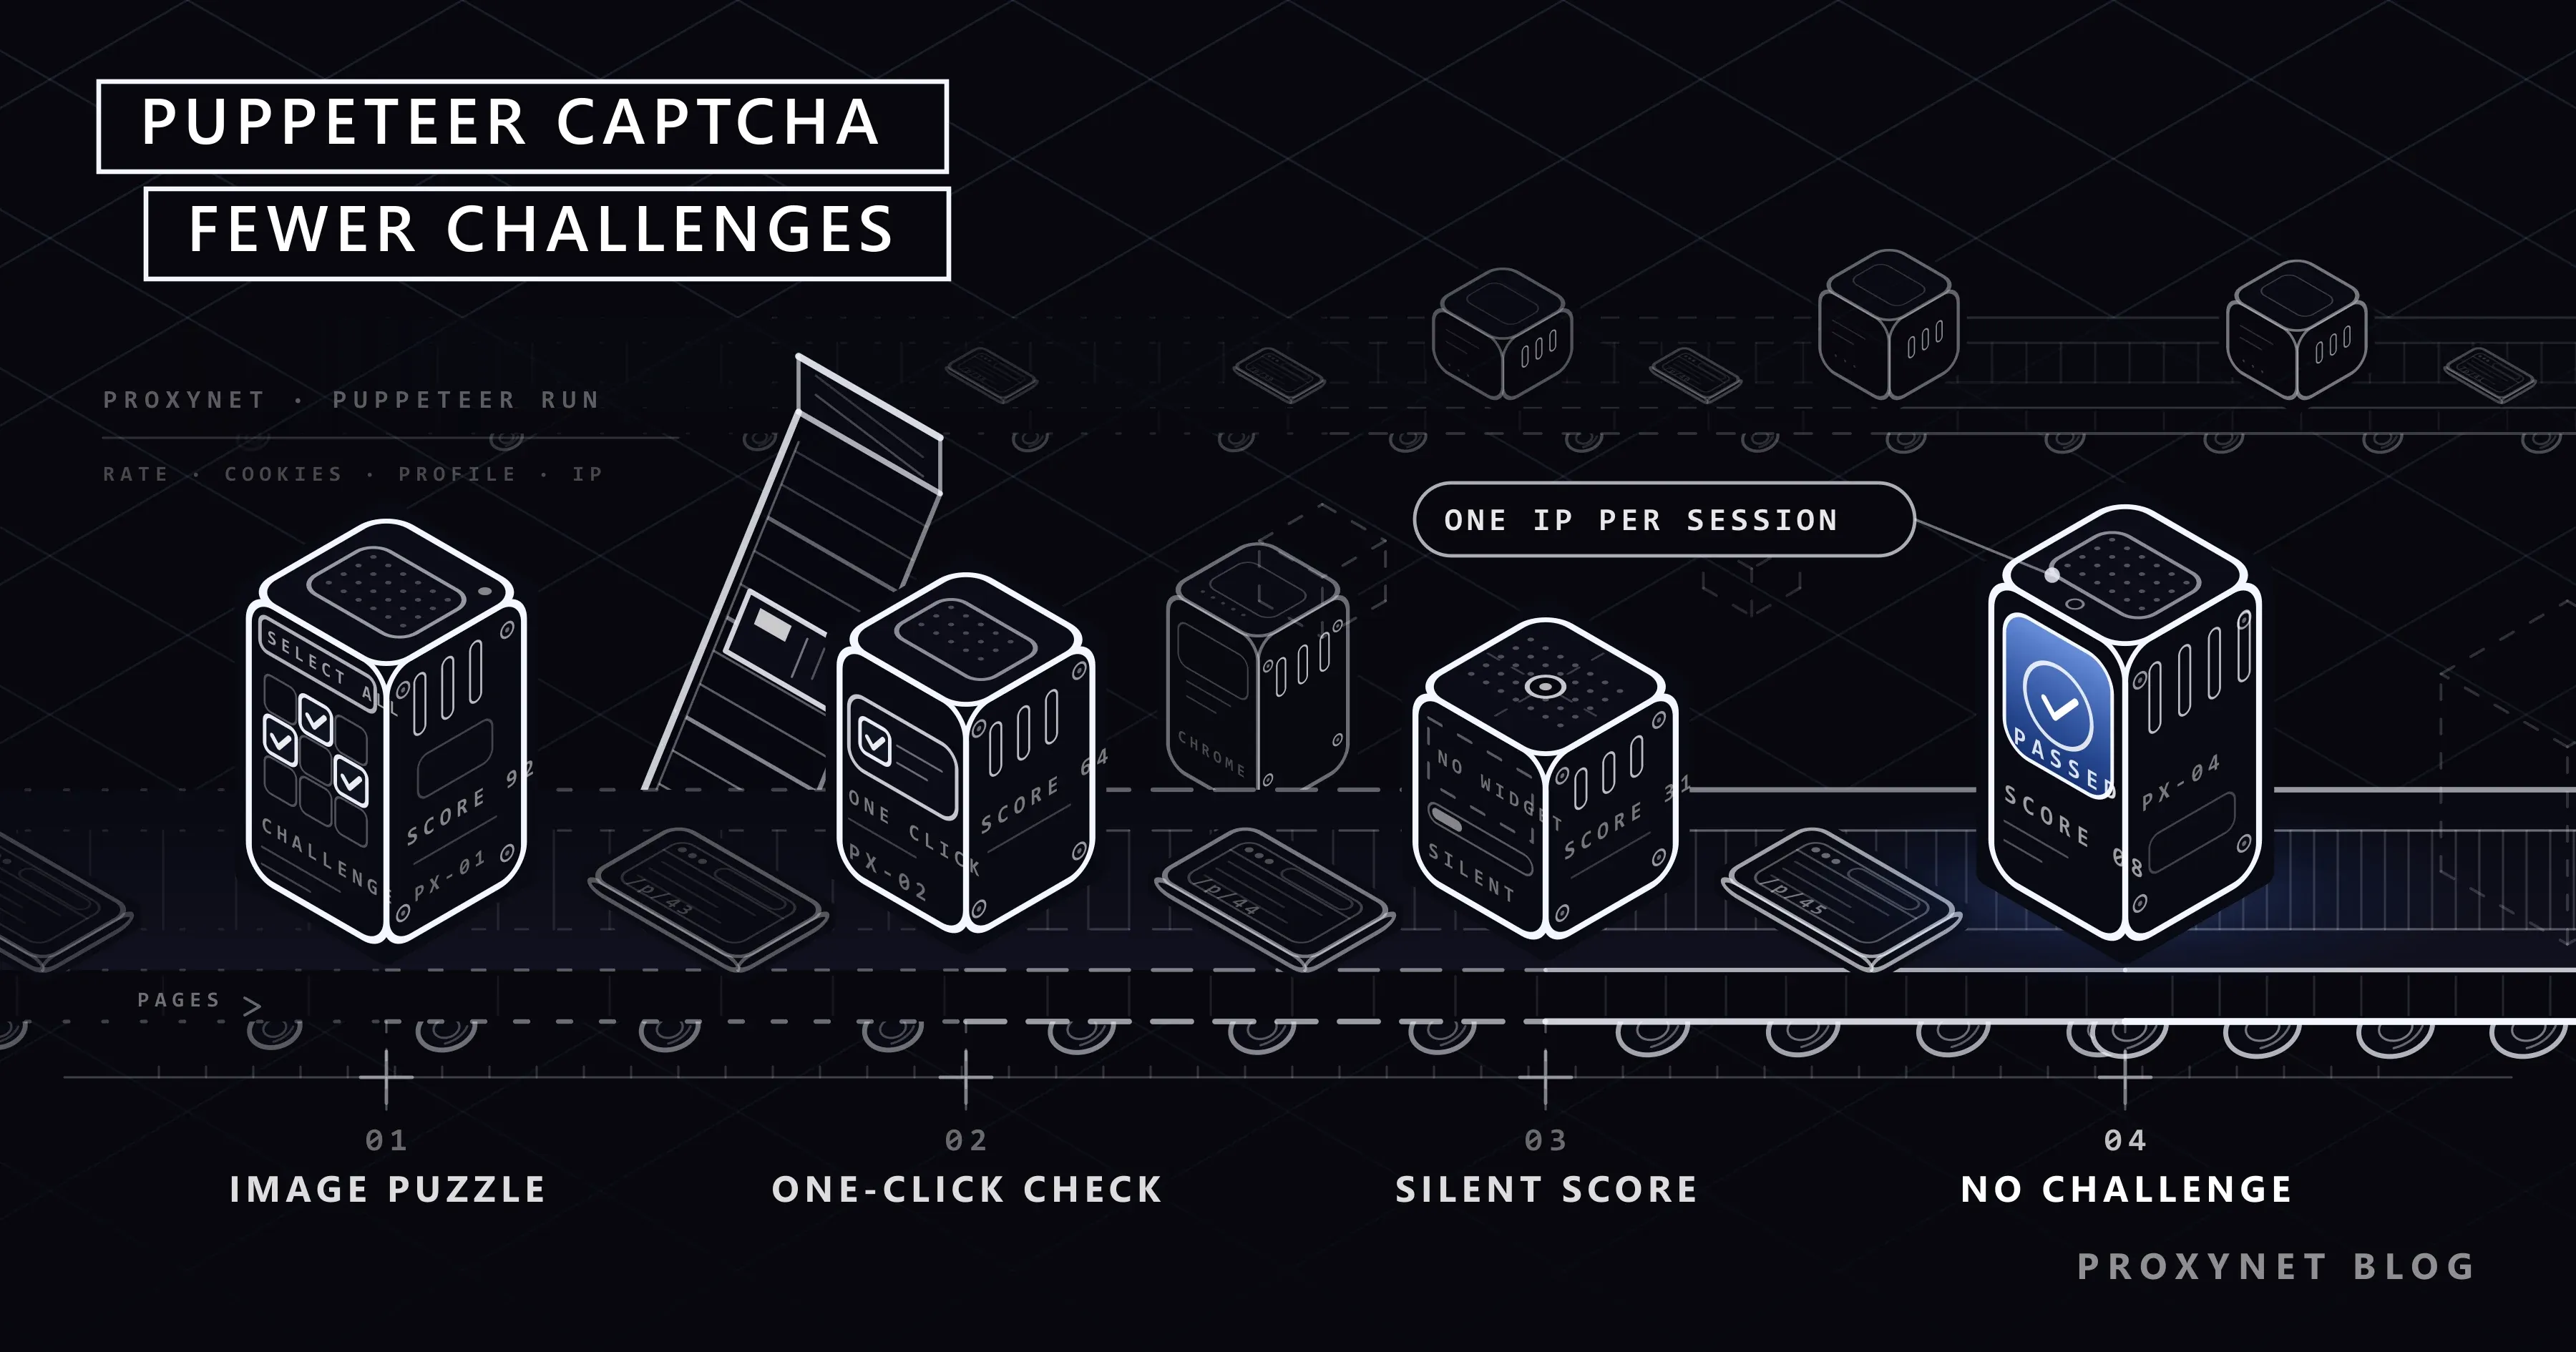
Yayın tarihi
Puppeteer ve CAPTCHA: Neden Çıkar, Nasıl Azalır?
Puppeteer'da CAPTCHA çoğunlukla IP itibarı, istek hızı ve başsız tarayıcı izlerinden tetiklenir. Nedenlerini ve meşru azaltma yollarını anlatıyoruz.
Yazar:Acar Diveroli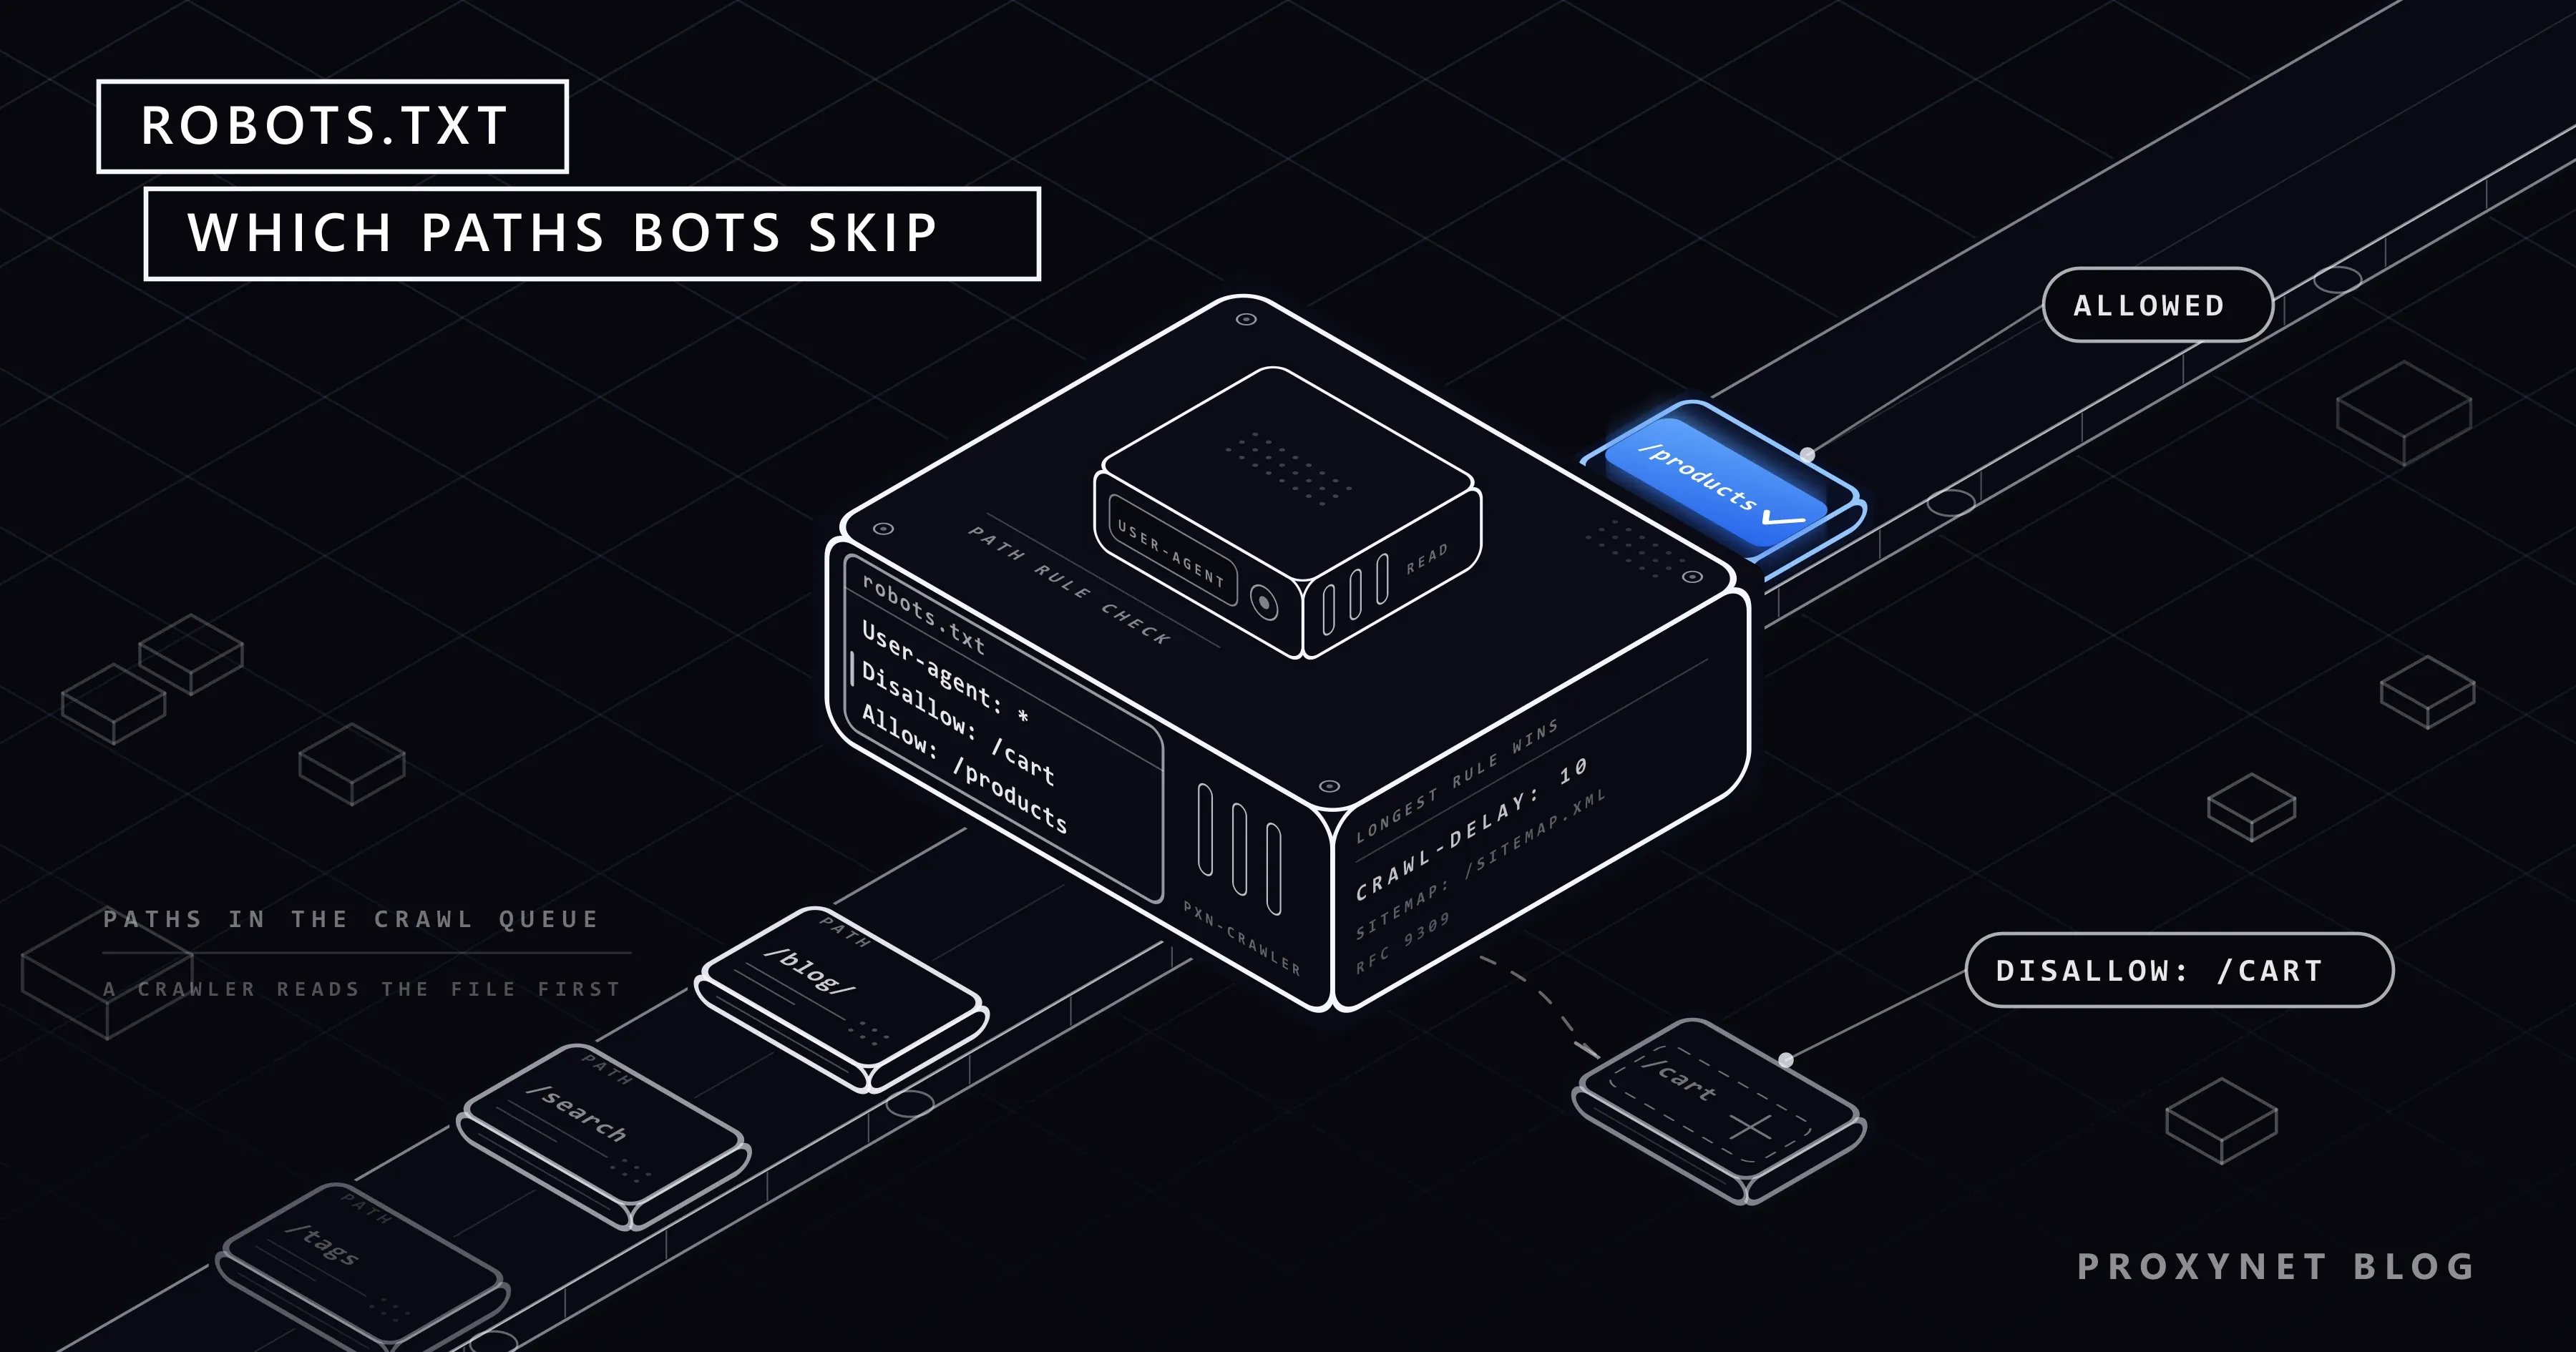
Yayın tarihi
robots.txt Dosyası Nedir, Nasıl Okunur?
robots.txt, bir sitenin botlara hangi yolları taramamalarını söylediği dosyadır. Disallow, Allow ve Crawl-delay kurallarını ve Python ile okunuşunu anlatıyoruz.
Yazar:Acar Diveroli
Python'da Oturum ve Çerez Yönetimi: Session ile Giriş
Yazar: Acar DiveroliNasıl YapılırYayın tarihi
Scrapy Nedir ve Proxy ile Nasıl Kullanılır?
Yazar: Acar DiveroliWeb ScrapingYayın tarihi
TLS Parmak İzi ve JA3 Nedir, Nasıl Çalışır?
Yazar: Acar DiveroliWeb ScrapingYayın tarihi
AI Alışveriş Ajanları Neden Sitelerde Engelleniyor?
Yazar: Acar DiveroliYapay ZekâYayın tarihi
Concurrency ve Parallelism: Scraping Hızını Ne Belirler?
Yazar: Acar DiveroliKarşılaştırmaYayın tarihi
CSS Selector ve XPath: Web Scraping İçin Hangisi?
Yazar: Acar DiveroliKarşılaştırmaYayın tarihi
GPT-6 Astra ile Web Kazıma: Neler Değişti?
Yazar: Acar DiveroliYapay ZekâYayın tarihi
Honeypot Tuzakları Nedir, Web Scraping'i Nasıl Etkiler?
Yazar: Acar DiveroliWeb ScrapingYayın tarihi
Scraping'de HTTP Hata Kodları: 403, 407, 429 ve 503
Yazar: Acar DiveroliWeb ScrapingYayın tarihi
HTTPX, Requests ve AIOHTTP Karşılaştırması
Yazar: Acar DiveroliKarşılaştırmaYayın tarihi
Puppeteer ve CAPTCHA: Neden Çıkar, Nasıl Azalır?
Yazar: Acar DiveroliNasıl YapılırYayın tarihi
robots.txt Dosyası Nedir, Nasıl Okunur?
Yazar: Acar DiveroliWeb ScrapingYayın tarihi
Eşleşen yazı yok
Yayın tarihi
Yayın tarihi