

































Web scraping · Blog de Proxynet – Página 5
Publicado
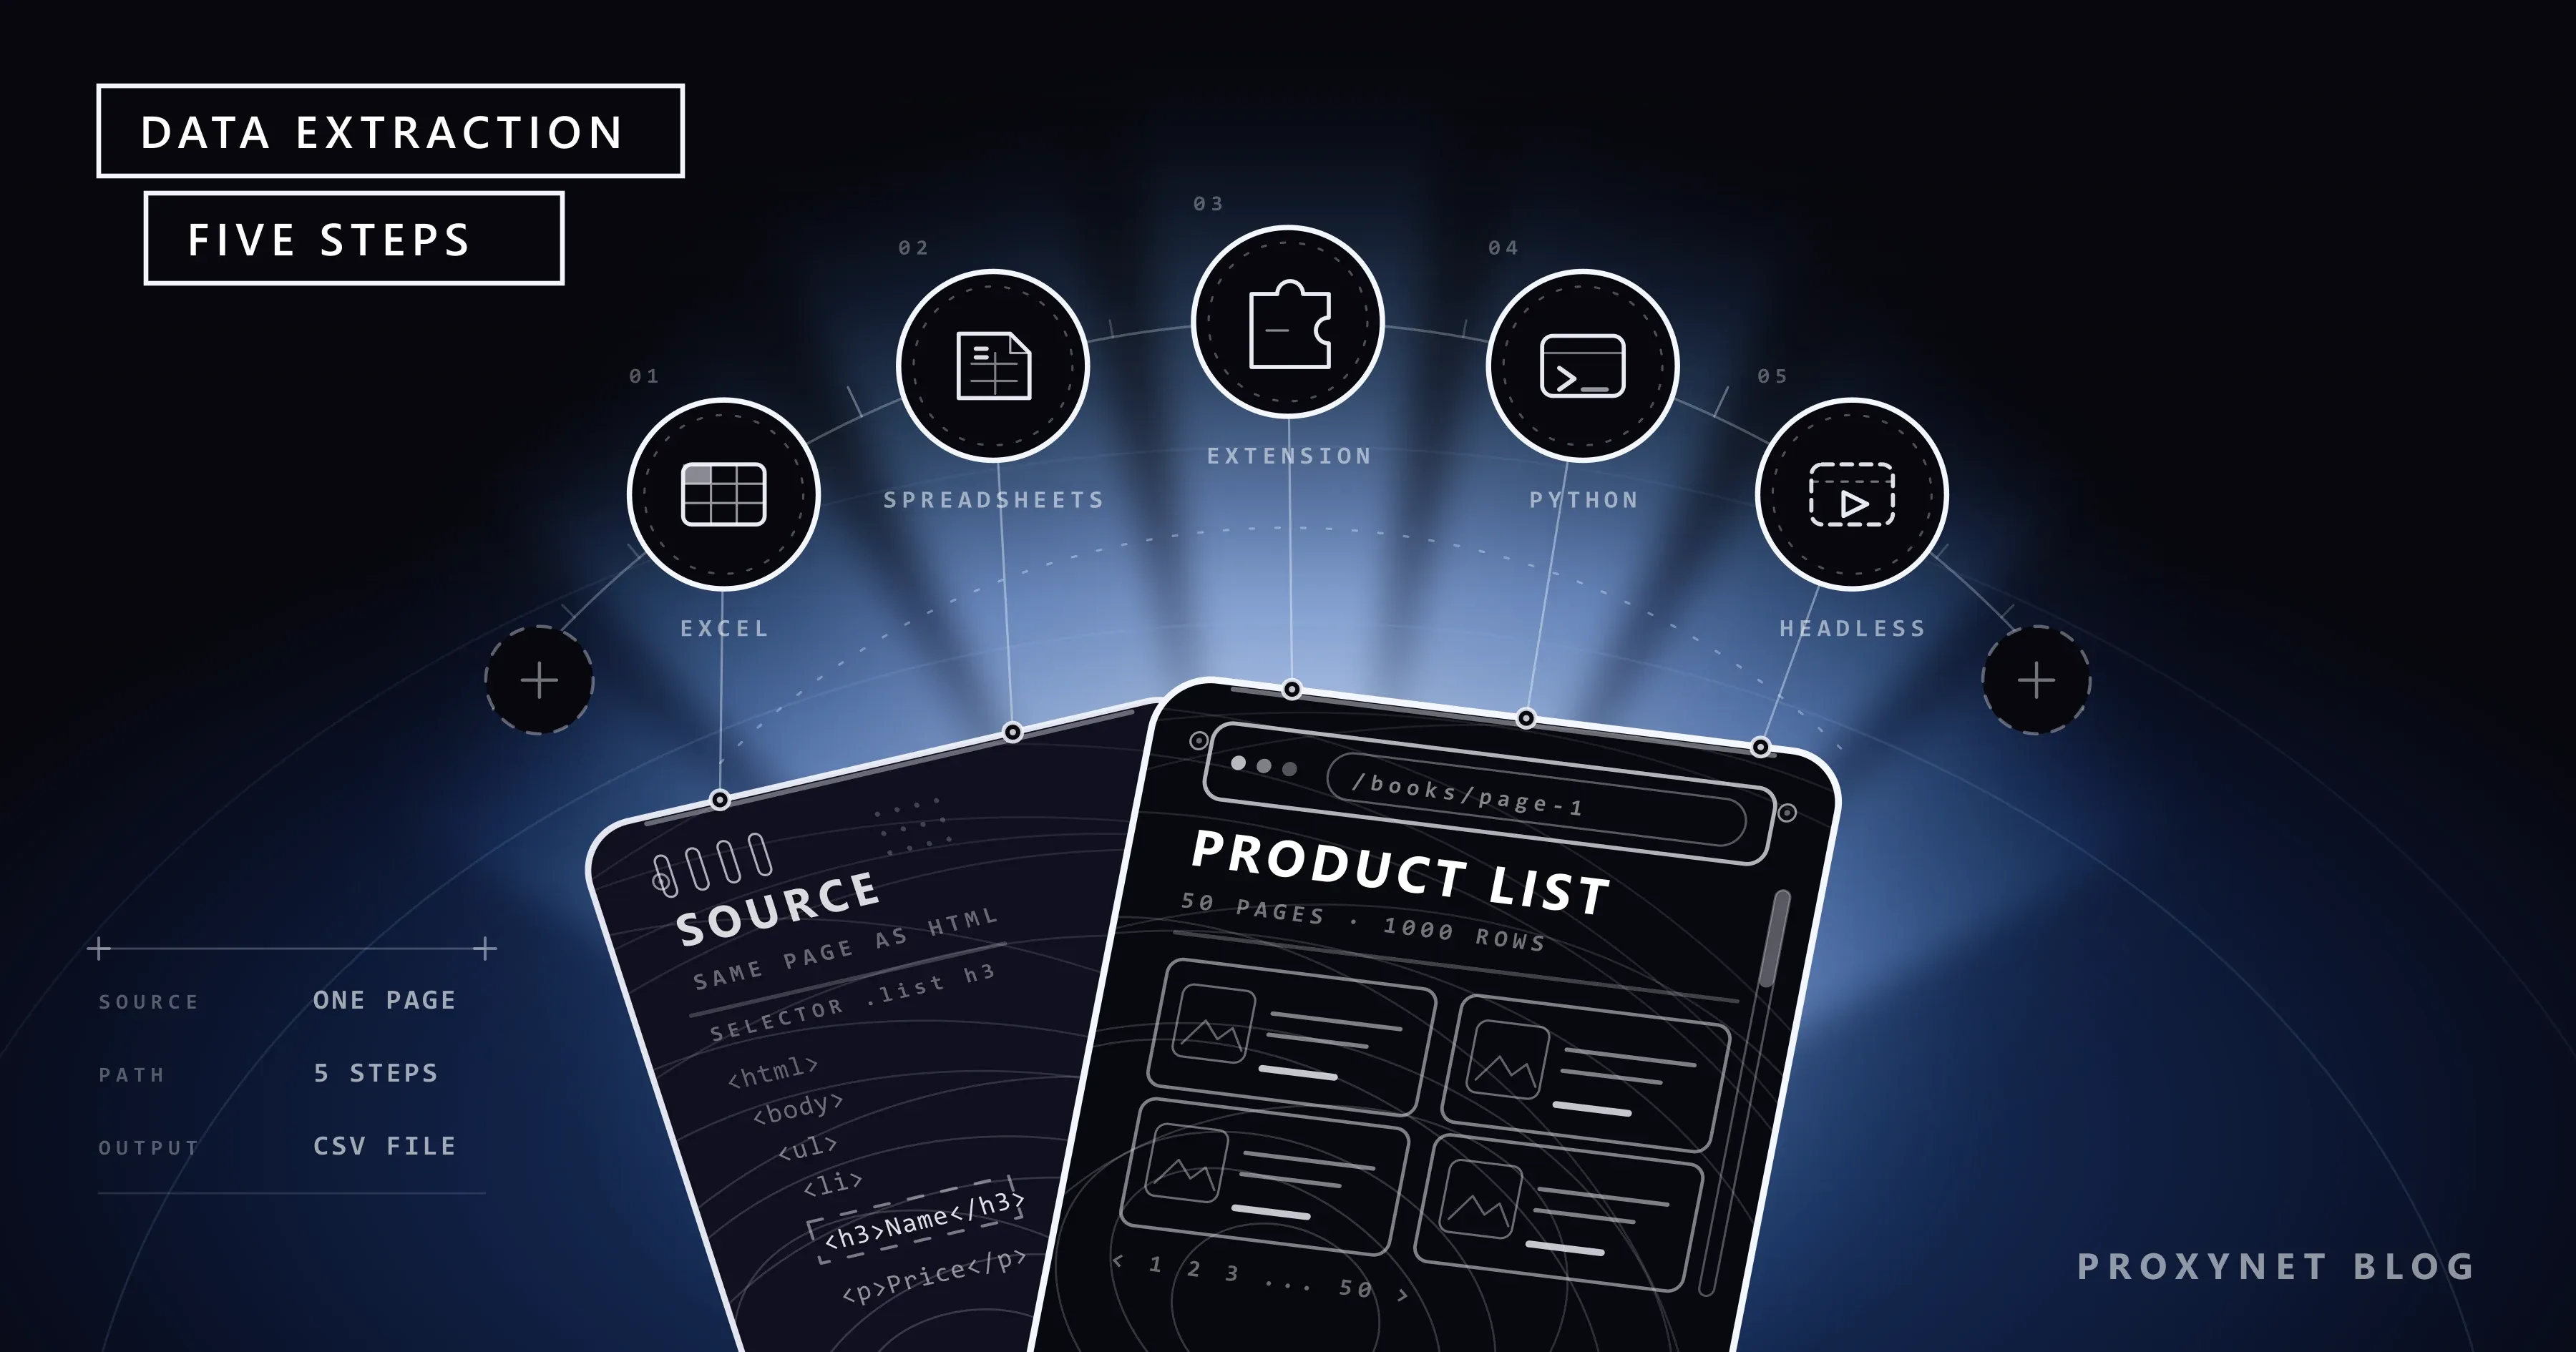
Cómo extraer datos de una web: Excel, Python y herramientas
La forma de extraer datos de una web depende del volumen y de la estructura de la página. Cinco métodos, de Excel a Python, y cuándo basta cada uno.
Autor: Enver Kaya
Publicado
Tráfico inusual en Google: qué significa y cómo solucionarlo
El aviso de tráfico inusual de Google va contra tu dirección IP, no contra tu cuenta. Qué dice la página sorry, por qué vuelve el CAPTCHA y cómo resolverlo.
Autor:Enver Kaya
Publicado
Cómo funciona la detección de bots: la lógica anti-bot
La detección de bots no es una sola comprobación: reputación de la IP, huella TLS, cabeceras, señales del navegador y comportamiento se unen en una puntuación.
Autor: Acar Diveroli
Publicado
429 Too Many Requests: qué es el error de rate limit
429 Too Many Requests indica que enviaste más solicitudes de las que un servicio permite en poco tiempo. Cómo funciona el rate limit y cómo resolver el error.
Autor:Acar Diveroli
Publicado
Qué es la rotación de IP y cómo funciona
La rotación de IP es el cambio de la IP de salida de tus peticiones dentro de un pool. Tres modos, el flujo del gateway y por qué a veces la IP no cambia.
Autor:Acar Diveroli
Publicado
¿Qué es la paginación y cómo rastrear todas las páginas?
La paginación divide una lista larga en trozos. Vemos los cinco tipos, las condiciones de parada y cómo reanudar con SQLite un rastreo interrumpido.
Autor:Acar Diveroli
Publicado
Web scraping con PHP: cURL, Guzzle y uso de proxy
El núcleo del scraping en PHP es la petición con cURL y el análisis con DOM y XPath. Explicamos Guzzle, proxy, robots.txt y reintentos con código probado.
Autor:Acar Diveroli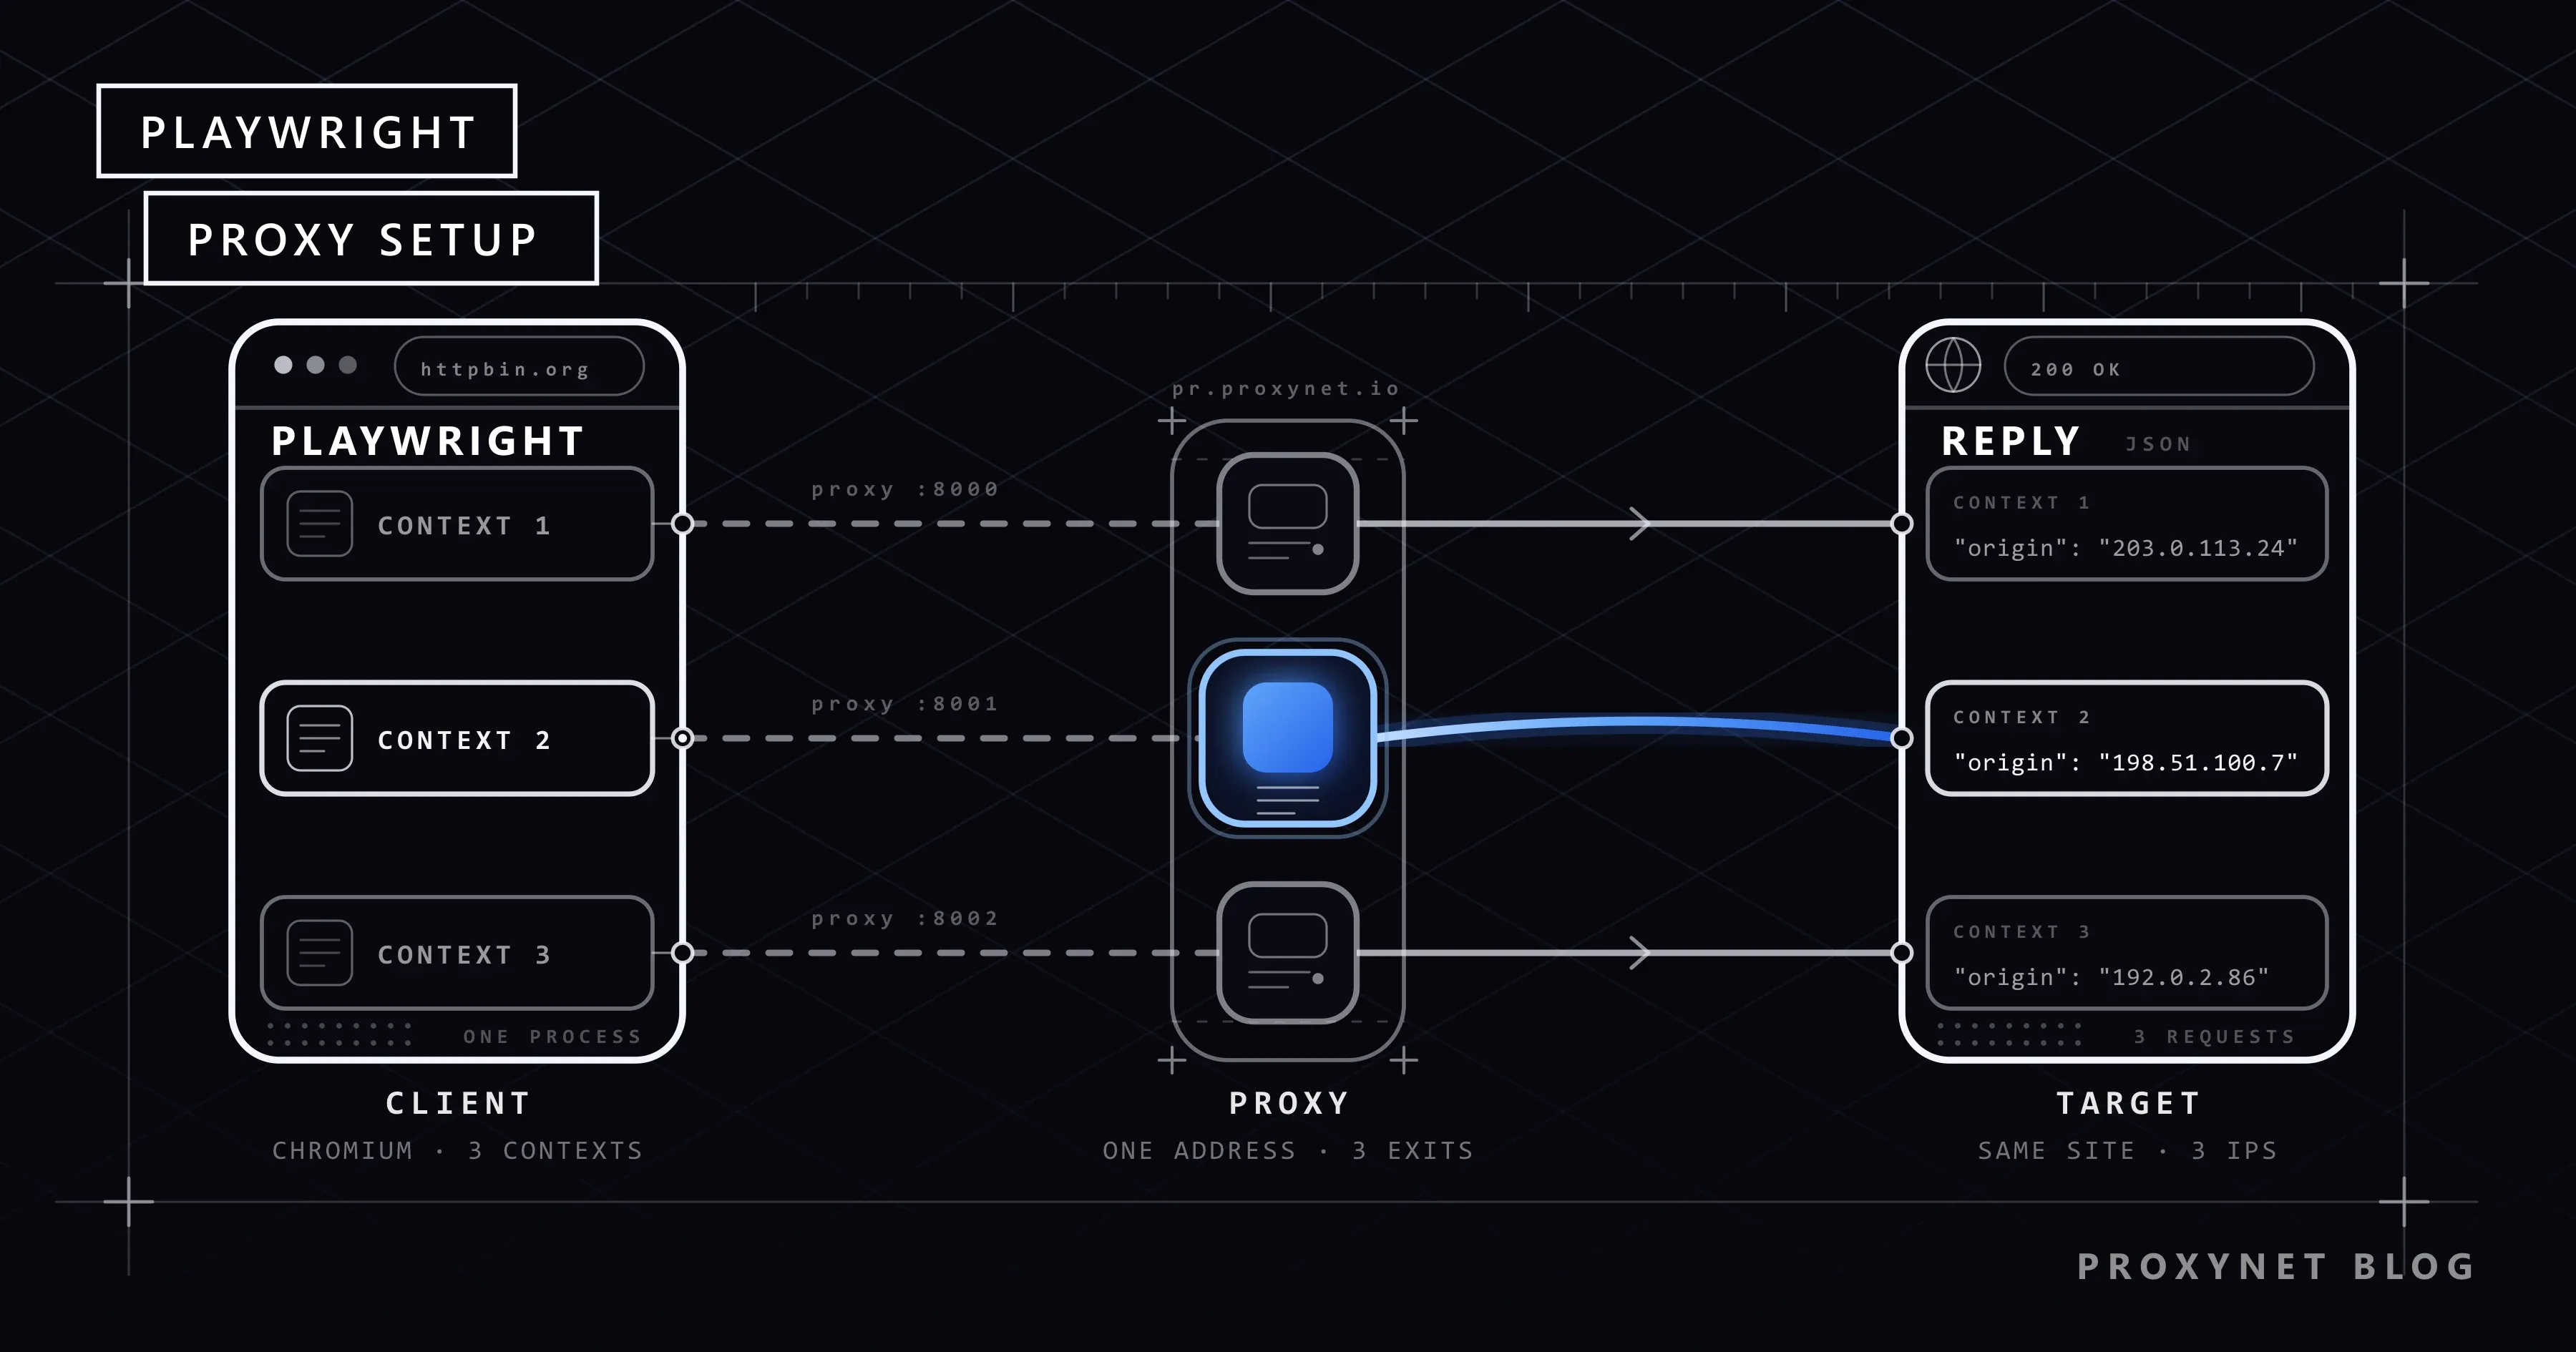
Publicado
Qué es Playwright y cómo usarlo con un proxy
En Playwright el proxy se define al iniciar el navegador o por contexto. Explicamos autenticación, SOCKS5 y rotación con ejemplos en Python y Node.js.
Autor:Acar Diveroli
Publicado
Playwright o Selenium: ¿cuál elegir en tu proyecto?
Playwright espera los elementos solo y toma el proxy por contexto; Selenium cubre más lenguajes y Safari real. Escribimos el mismo trabajo con las dos.
Autor:Acar Diveroli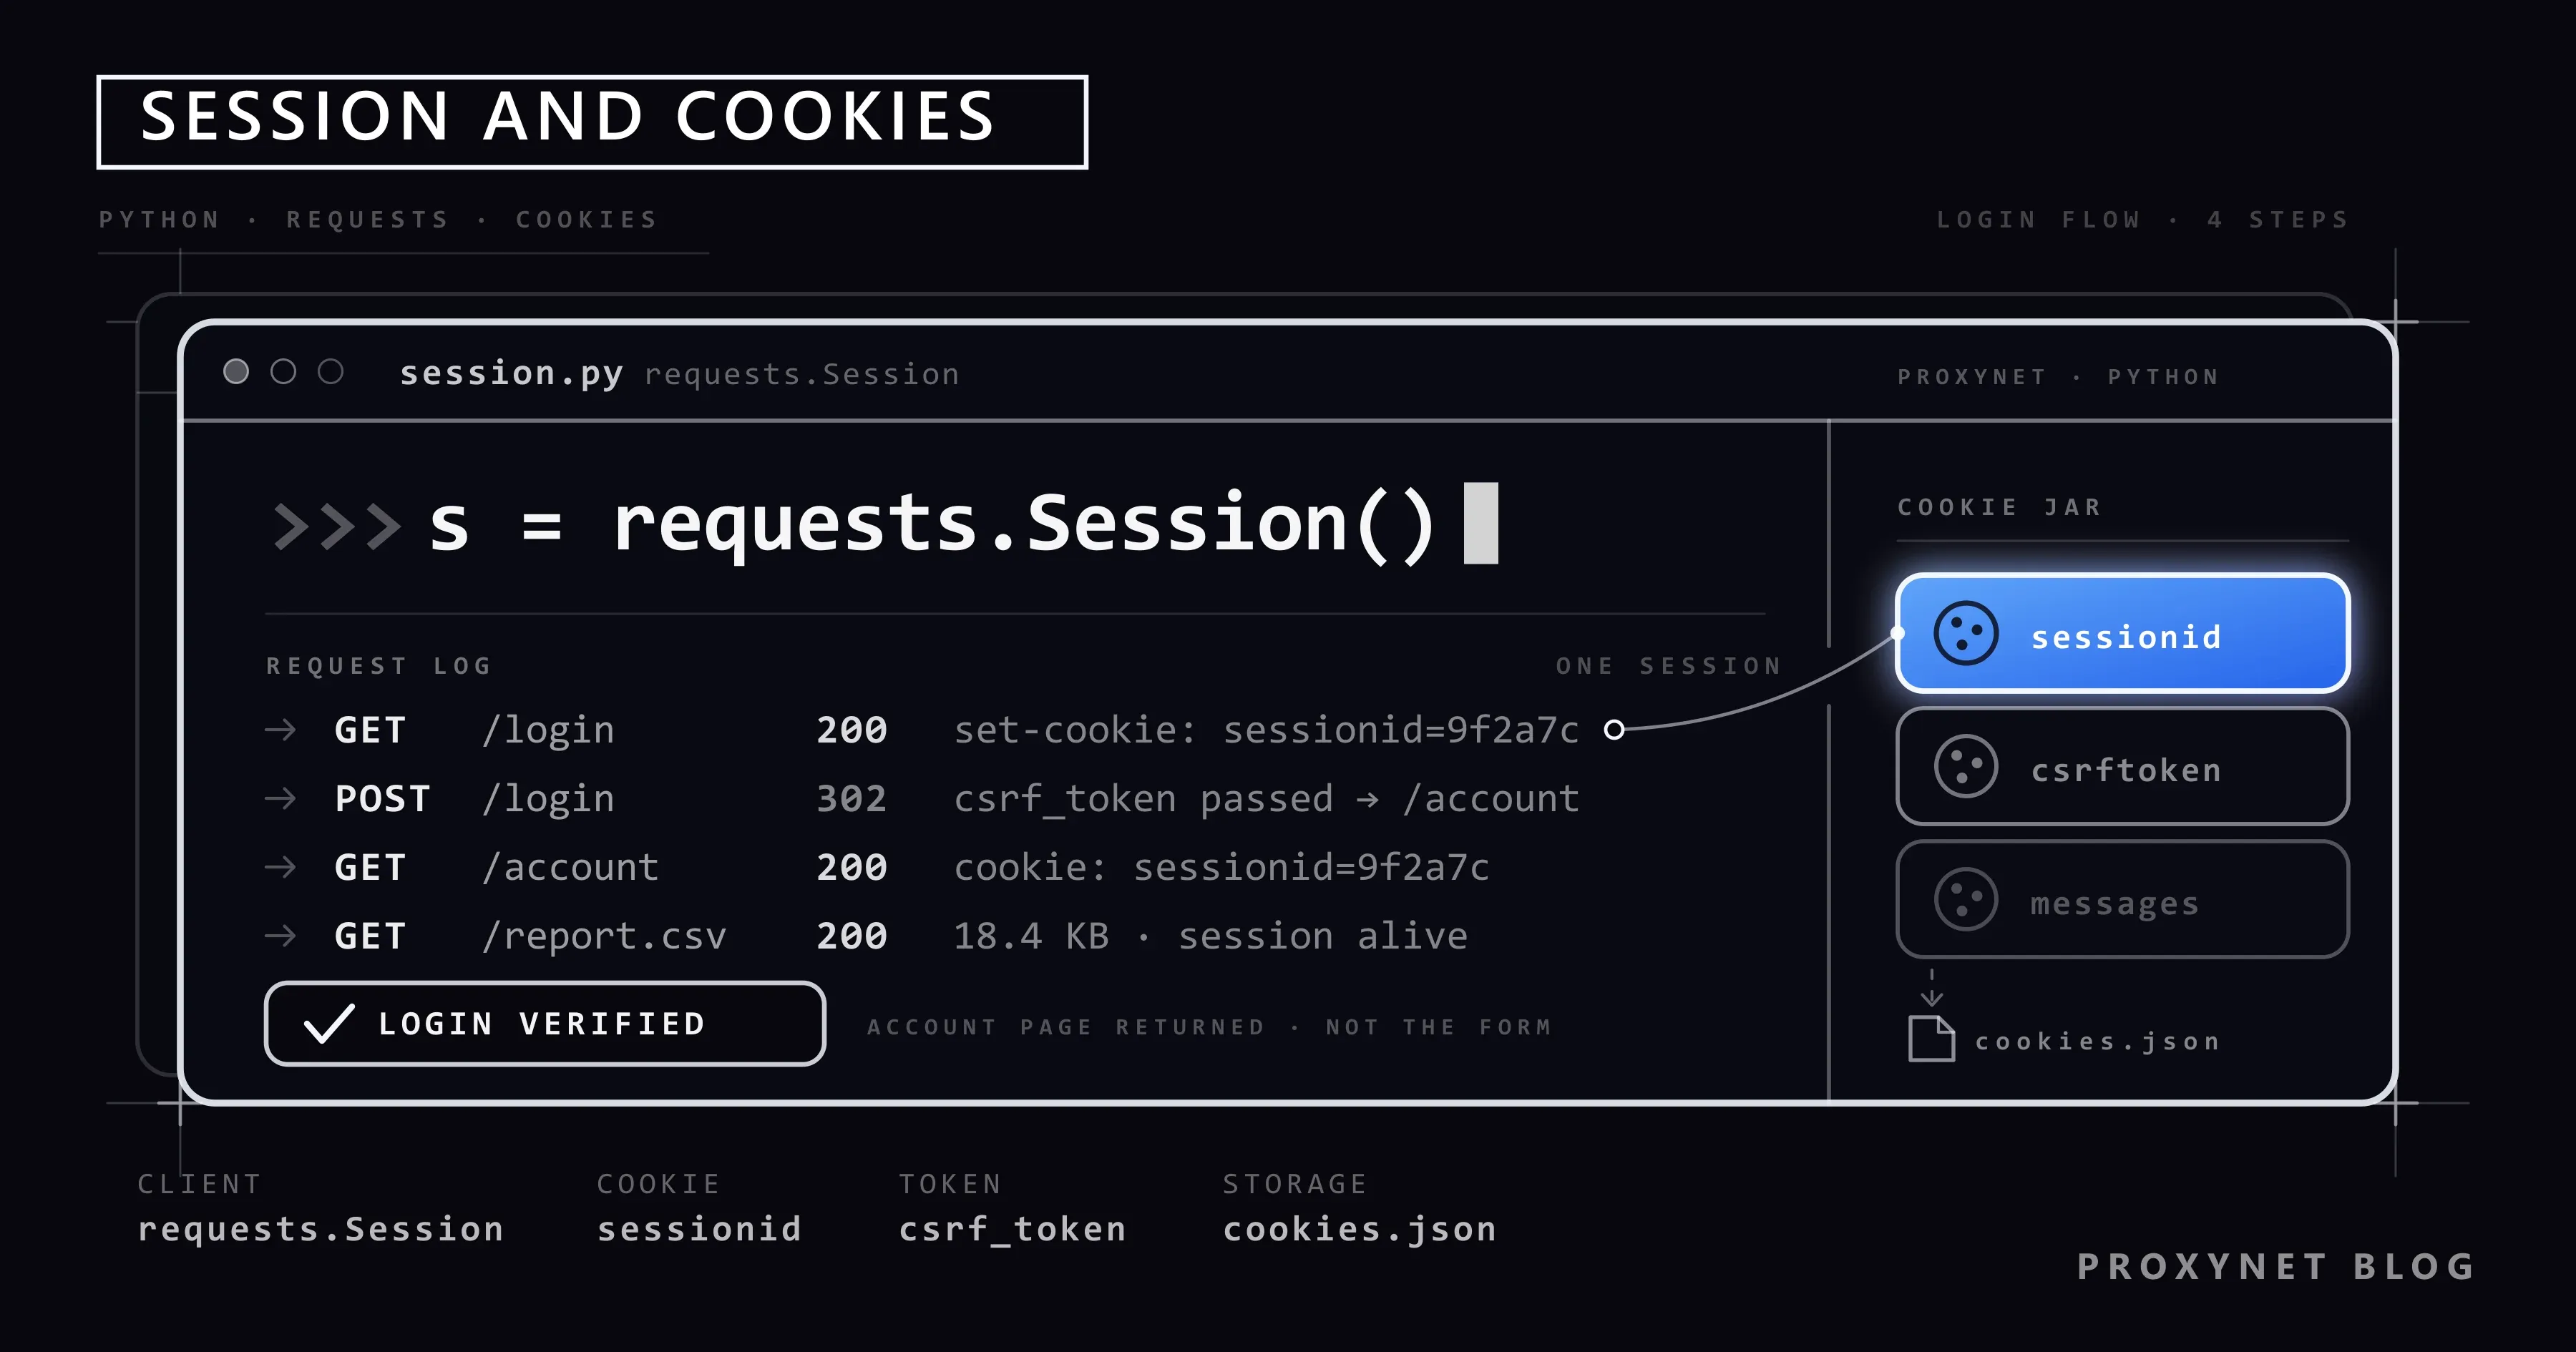
Publicado
Sesiones y cookies en Python: iniciar sesión con requests
requests.Session lleva las cookies entre peticiones y mantiene la sesión abierta. Te mostramos el token CSRF del formulario, la verificación y el guardado.
Autor:Acar Diveroli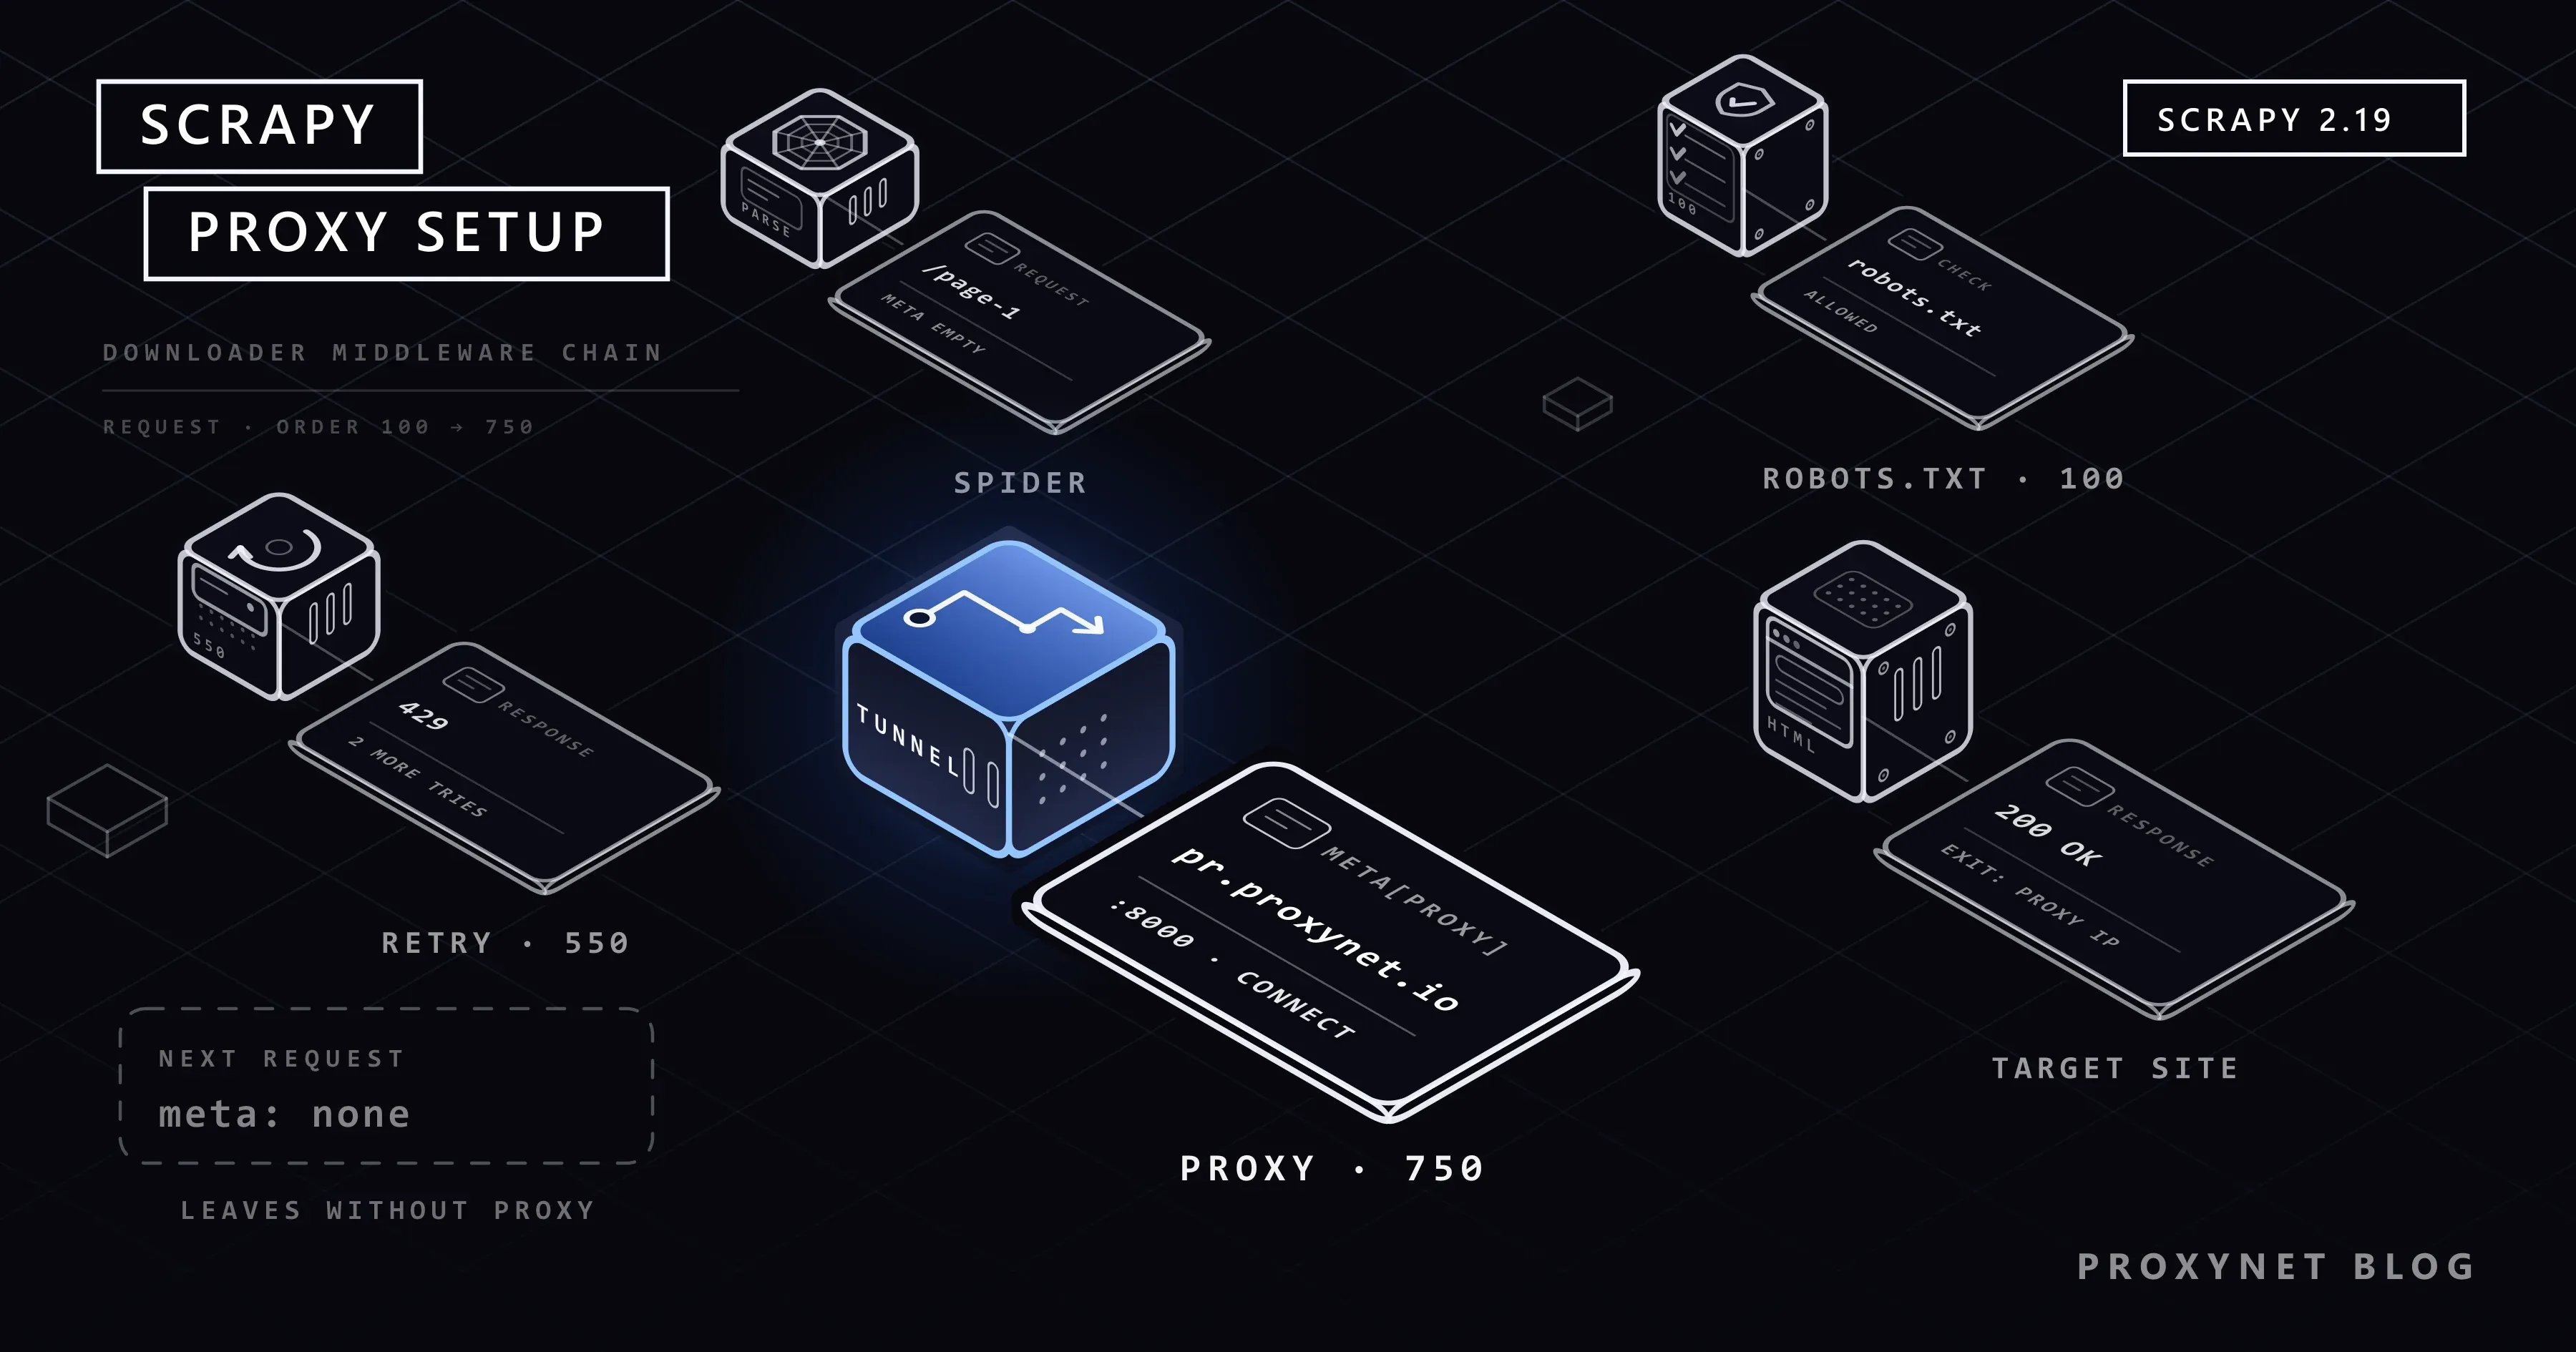
Publicado
Qué es Scrapy y cómo usarlo con un proxy
En Scrapy el proxy se define con el campo meta de la petición o con un middleware. Instalación, autenticación, AutoThrottle y rotación, explicados con código.
Autor:Acar Diveroli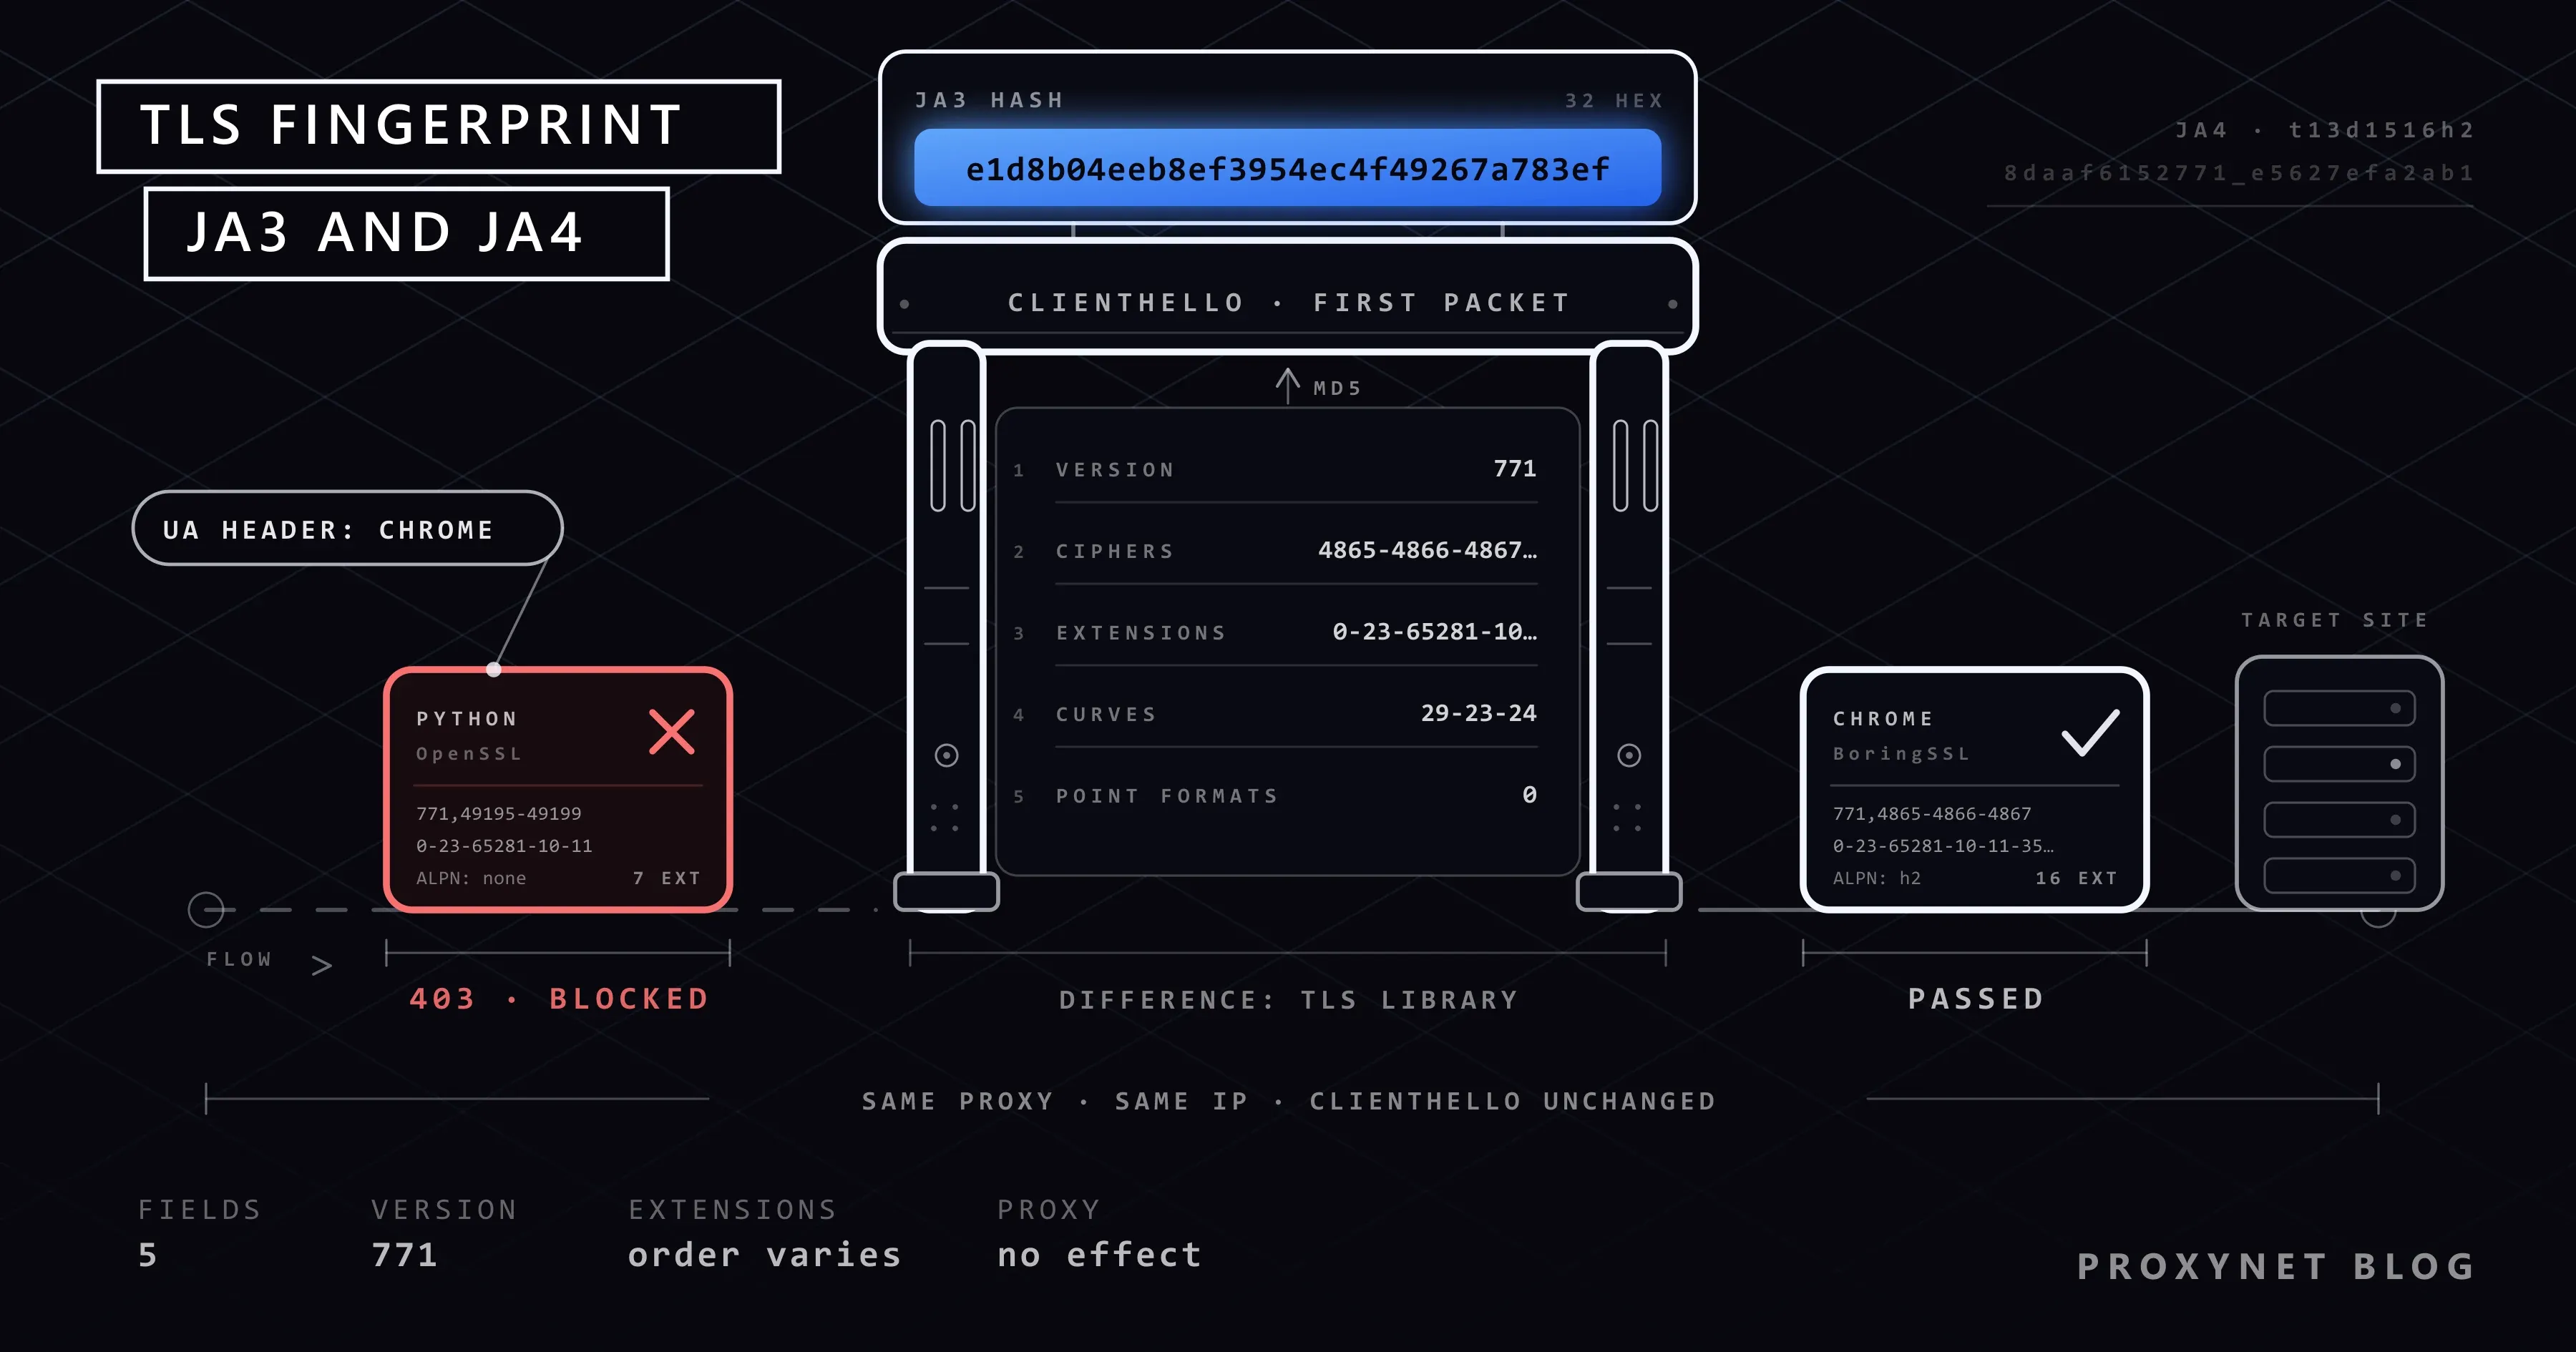
Publicado
¿Qué es la huella TLS y cómo funciona JA3?
La huella TLS es un identificador que sale de las listas de cifrados y extensiones del ClientHello. Cómo se calculan JA3 y JA4, y qué cambia un proxy.
Autor:Acar Diveroli
Cómo extraer datos de una web: Excel, Python y herramientas
Autor: Enver KayaCasos de usoPublicado
Tráfico inusual en Google: qué significa y cómo solucionarlo
Autor: Enver KayaTutorialesPublicado
Cómo funciona la detección de bots: la lógica anti-bot
Autor: Acar DiveroliWeb scrapingPublicado
429 Too Many Requests: qué es el error de rate limit
Autor: Acar DiveroliTutorialesPublicado
Qué es la rotación de IP y cómo funciona
Autor: Acar DiveroliProxy 101Publicado
¿Qué es la paginación y cómo rastrear todas las páginas?
Autor: Acar DiveroliWeb scrapingPublicado
Web scraping con PHP: cURL, Guzzle y uso de proxy
Autor: Acar DiveroliTutorialesPublicado
Qué es Playwright y cómo usarlo con un proxy
Autor: Acar DiveroliTutorialesPublicado
Playwright o Selenium: ¿cuál elegir en tu proyecto?
Autor: Acar DiveroliComparativasPublicado
Sesiones y cookies en Python: iniciar sesión con requests
Autor: Acar DiveroliTutorialesPublicado
Qué es Scrapy y cómo usarlo con un proxy
Autor: Acar DiveroliWeb scrapingPublicado
¿Qué es la huella TLS y cómo funciona JA3?
Autor: Acar DiveroliWeb scrapingPublicado
Ningún artículo coincide
Publicado
Publicado