

































Web scraping · Blog da Proxynet – Página 4
Publicado
Como baixar todas as imagens de um site sem código
Para baixar todas as imagens de uma página, salve-a no Chrome como "Página da Web, completa" ou use uma extensão. Veja também por que algumas saem pequenas.
Autor: Enver Kaya
Publicado
Como encontrar o sitemap de um site e ver todas as páginas
Veja primeiro a linha Sitemap do robots.txt e depois caminhos comuns como /sitemap.xml. Mostramos como ler índices, arquivos .gz e lastmod com Python.
Autor: Acar Diveroli
Publicado
Como corrigir JSONDecodeError: Expecting Value no Python
JSONDecodeError: Expecting Value significa que o parser não achou JSON no primeiro caractere: o corpo está vazio, é HTML ou texto puro. Veja como achar a causa.
Autor:Acar Diveroli
Publicado
Max Retries Exceeded With URL: o que é e como resolver
Max Retries Exceeded With URL é a mensagem que envolve o erro real de conexão no Requests. A causa está na parte Caused by; veja como ler e corrigir.
Autor:Acar Diveroli
Publicado
Erros de codificação no Python: acentos e UnicodeDecodeError
Acentos quebrados no Python vêm de bytes lidos com o codec errado. Veja como corrigir o UnicodeDecodeError em arquivos, no console do Windows e em páginas web.
Autor:Acar Diveroli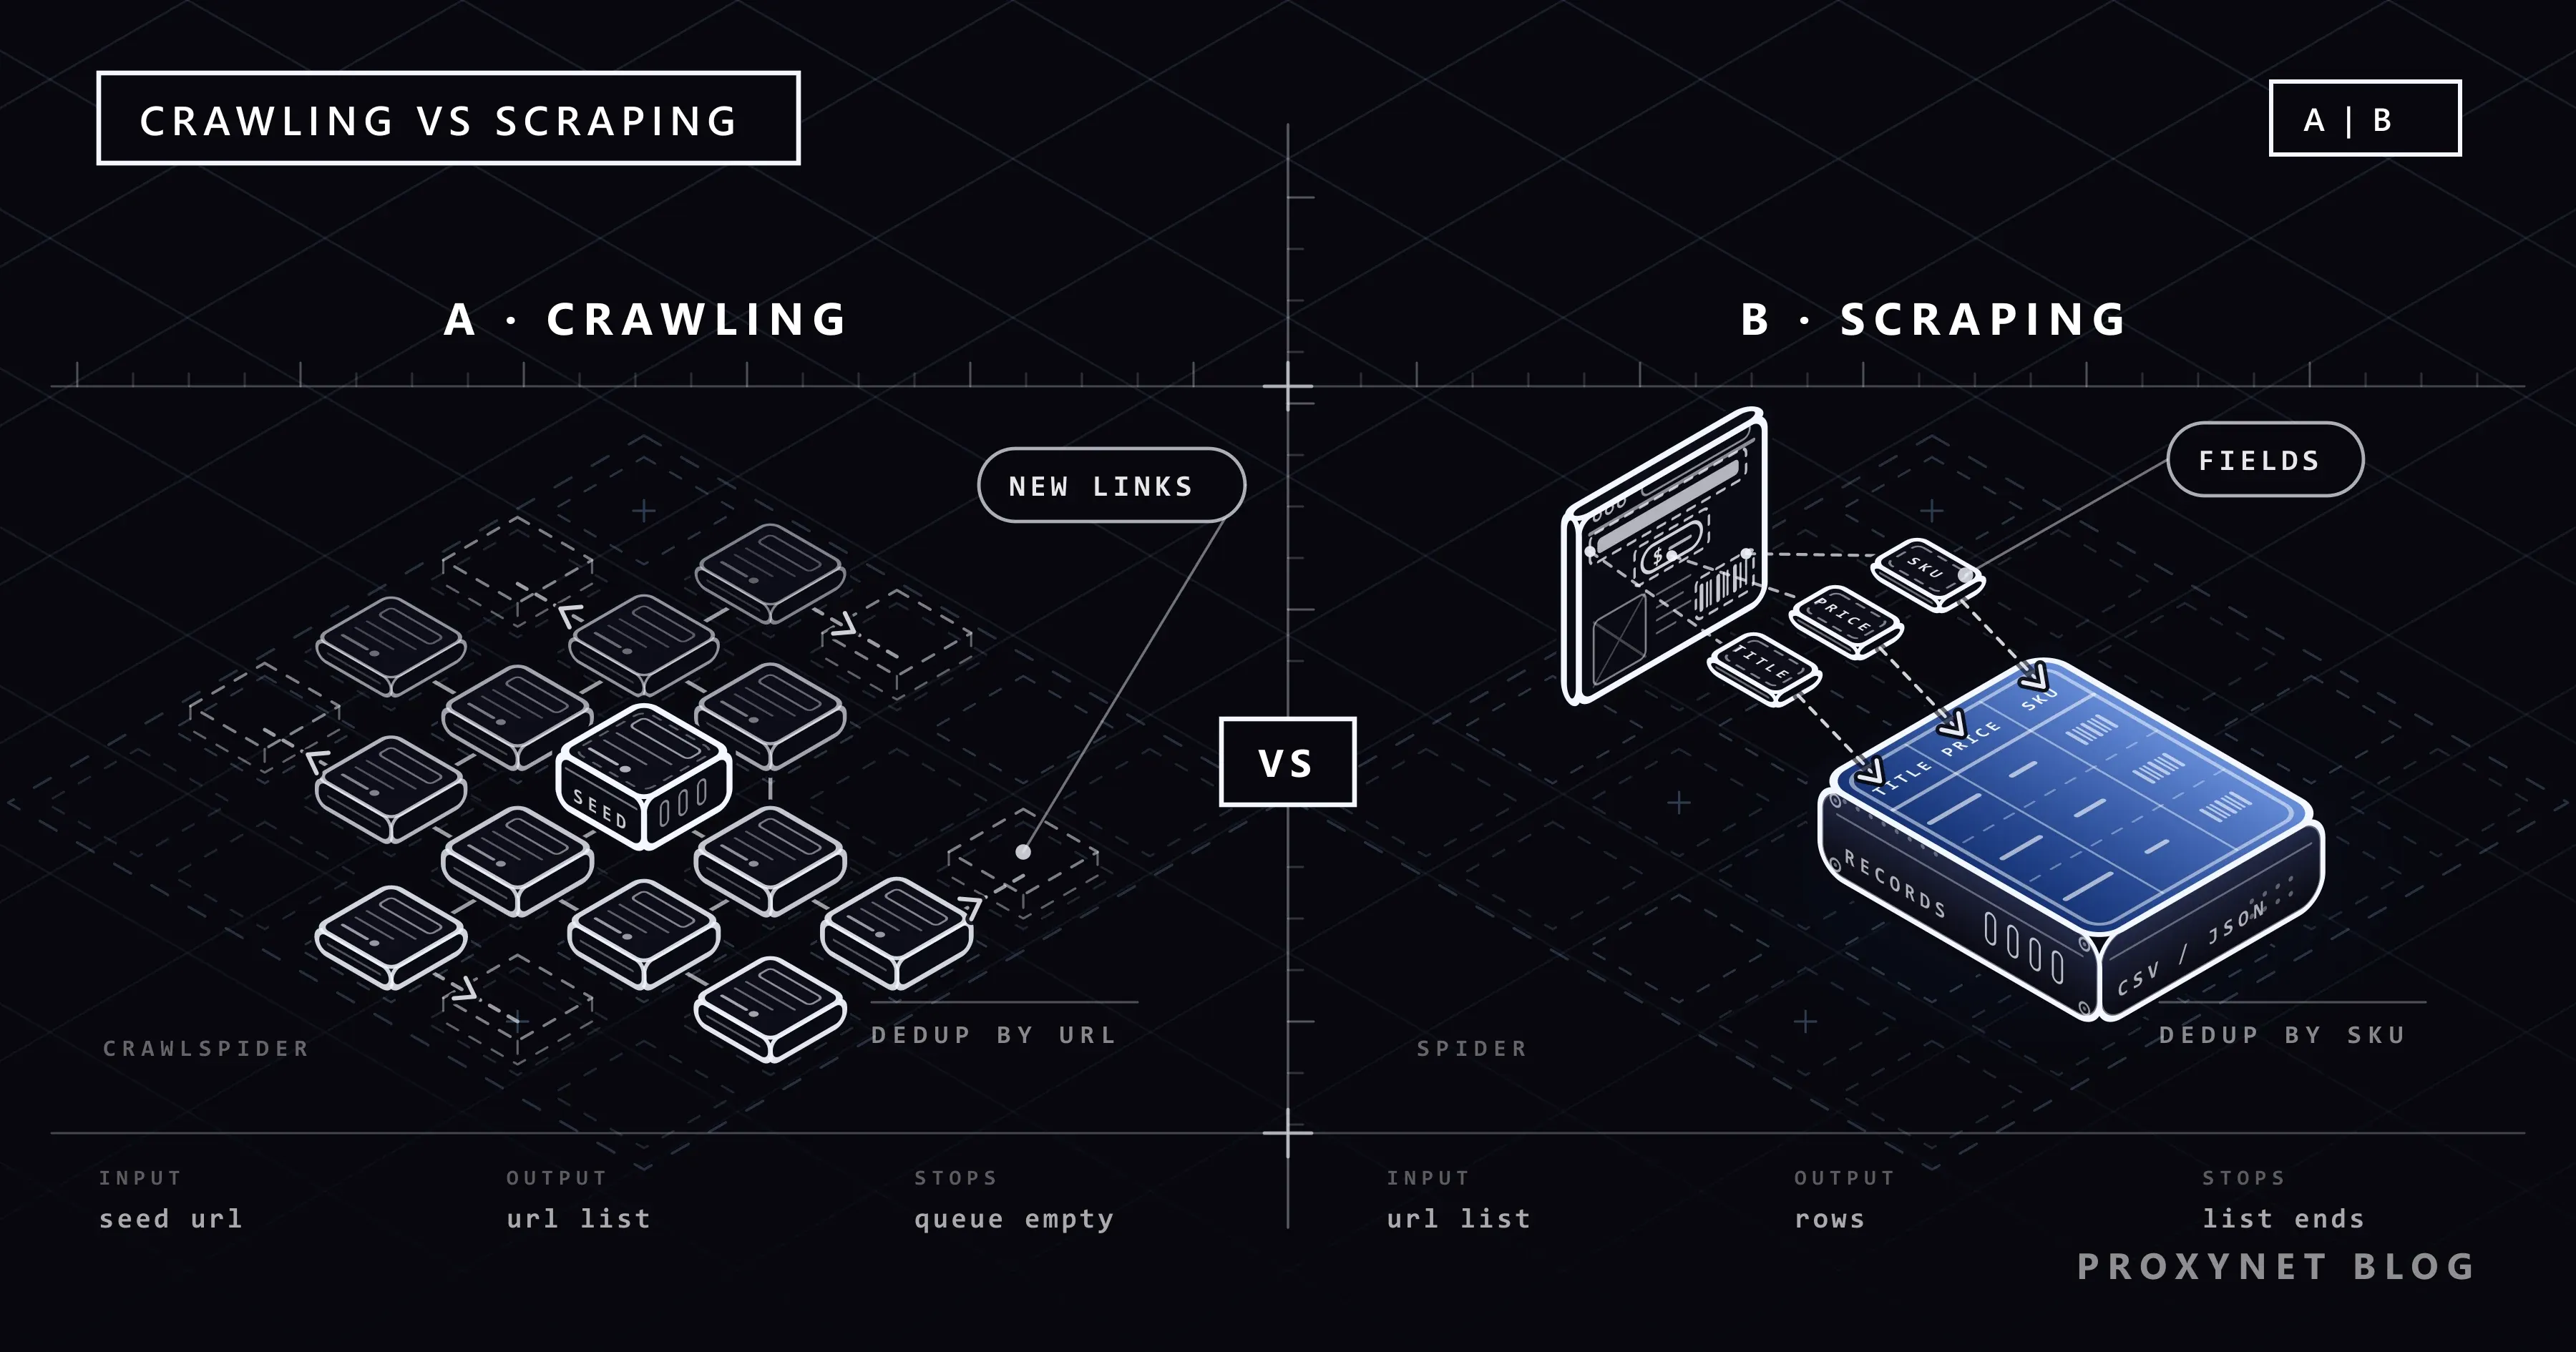
Publicado
Web scraping vs. web crawling: qual é a diferença?
O web crawling descobre quais páginas existem seguindo links; o web scraping extrai delas campos como preço ou título. Comparamos os dois com código Scrapy.
Autor:Acar Diveroli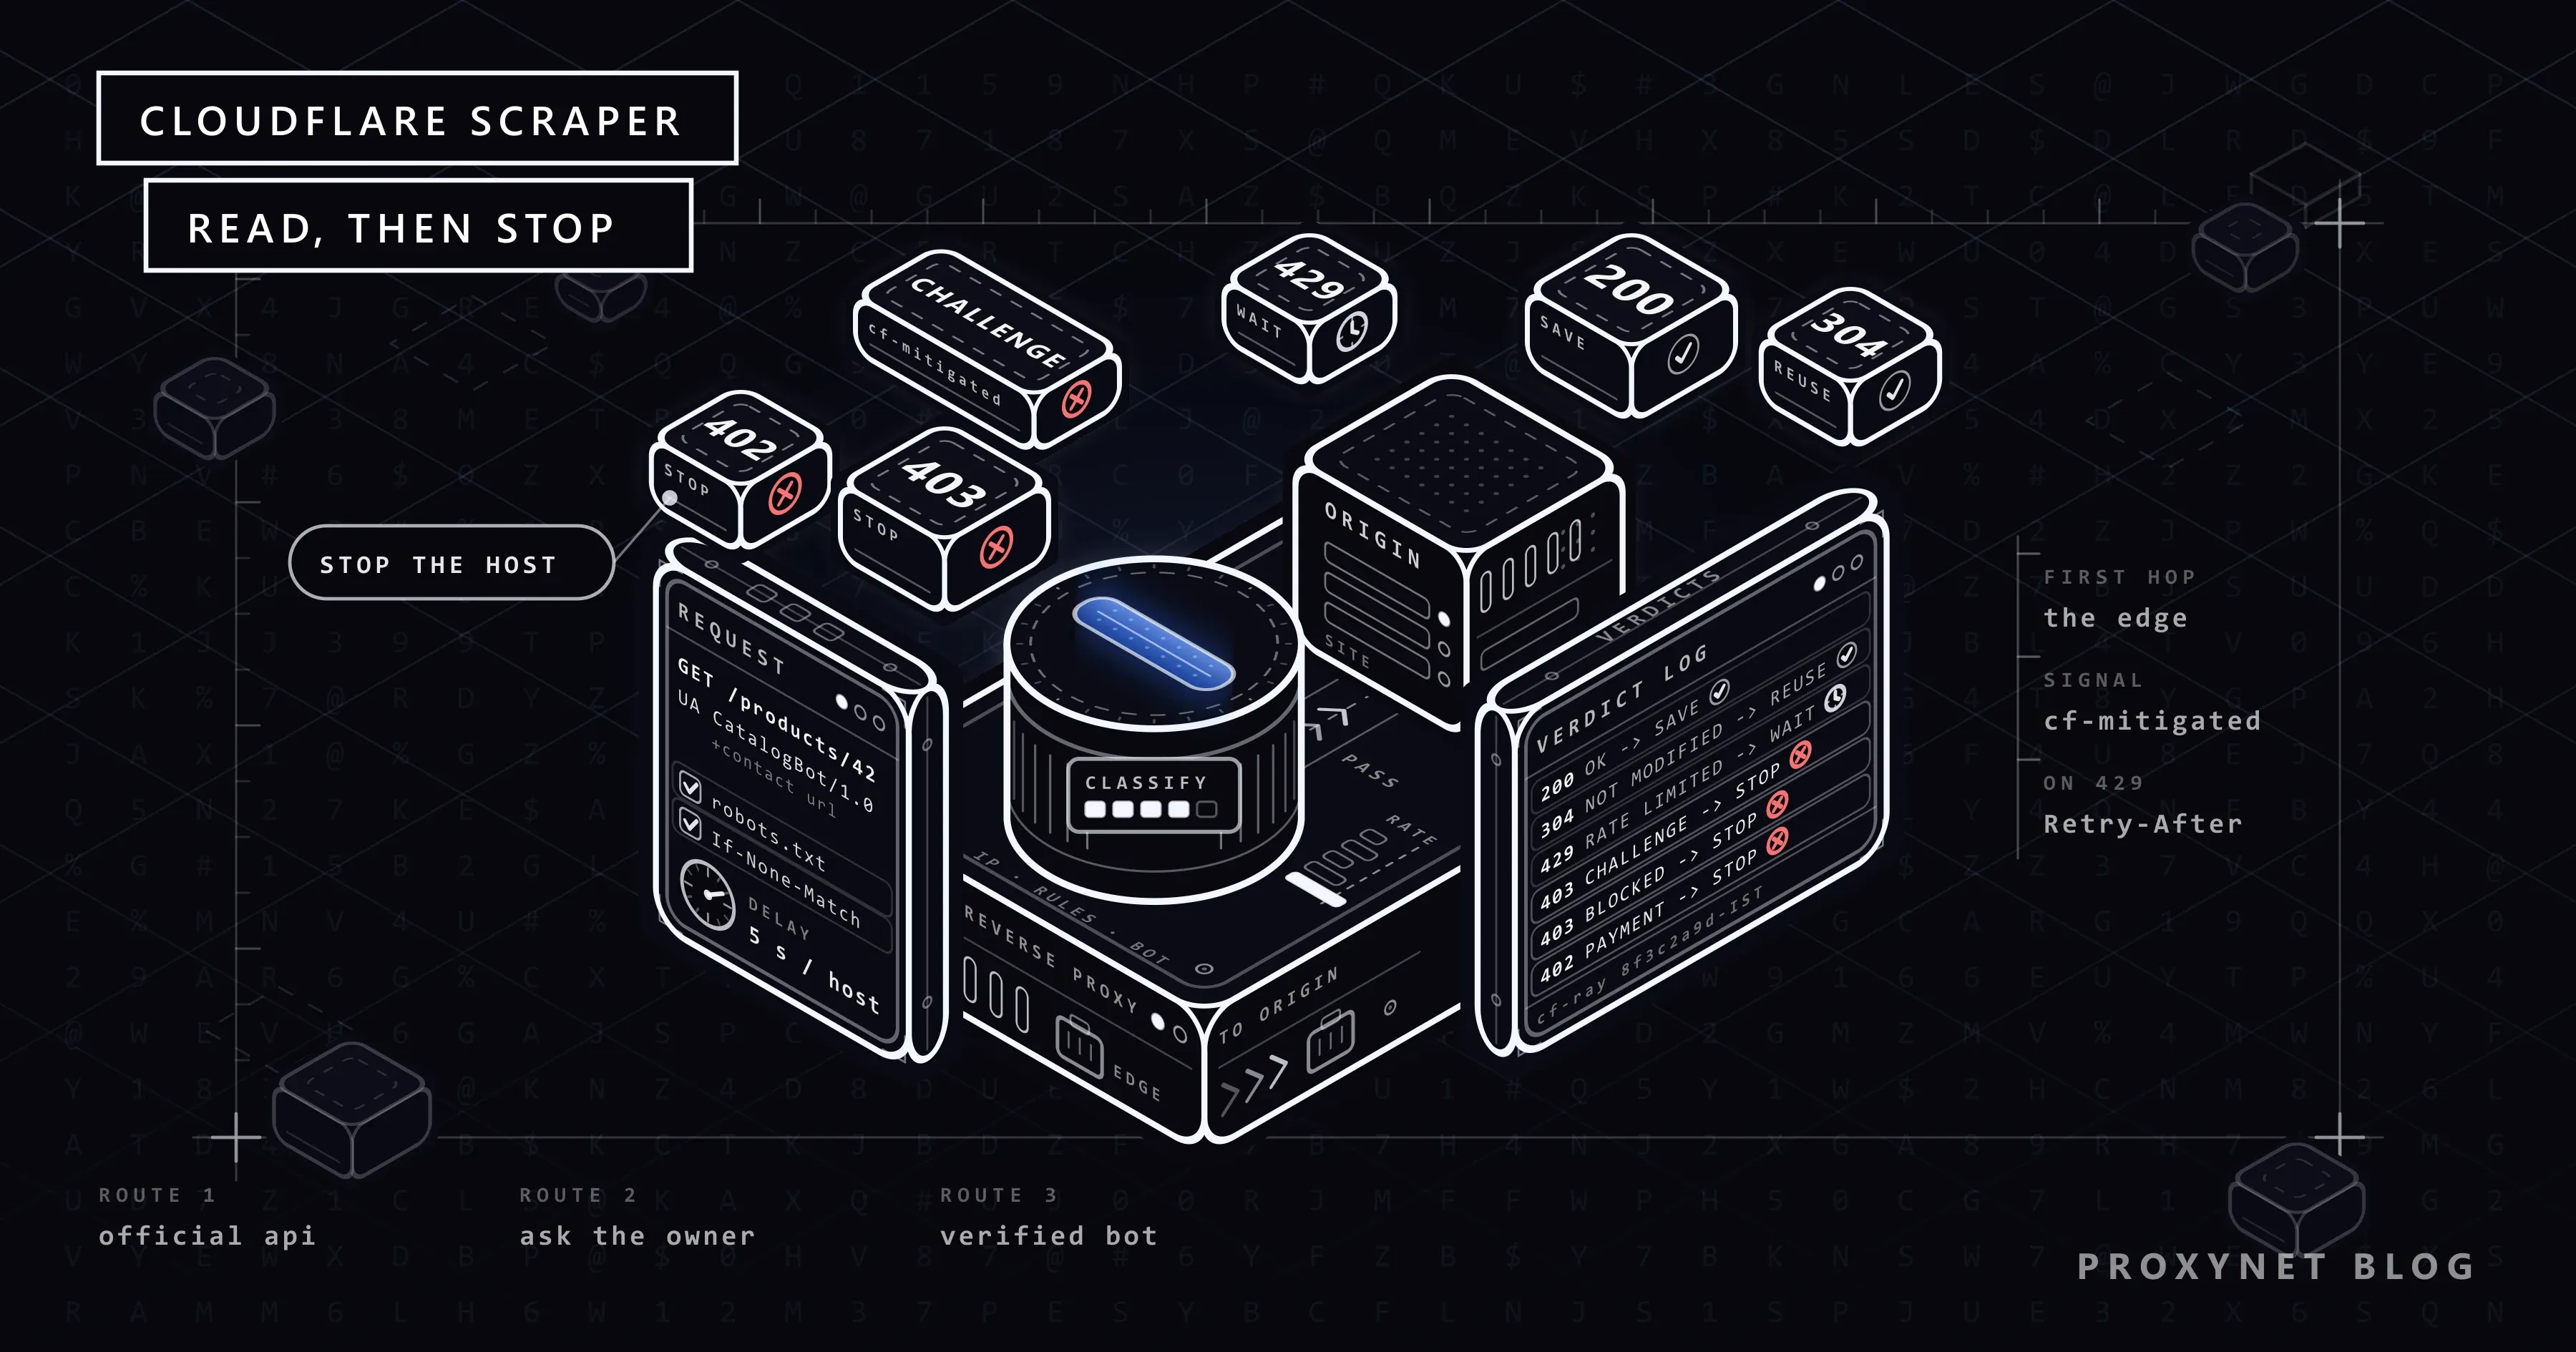
Publicado
Cloudflare scraper: por que é bloqueado e o que funciona
Um scraper é bloqueado quando a Cloudflare classifica as requisições dele como bot. Veja como ler o bloqueio e escolher um caminho legítimo até os dados.
Autor:Acar Diveroli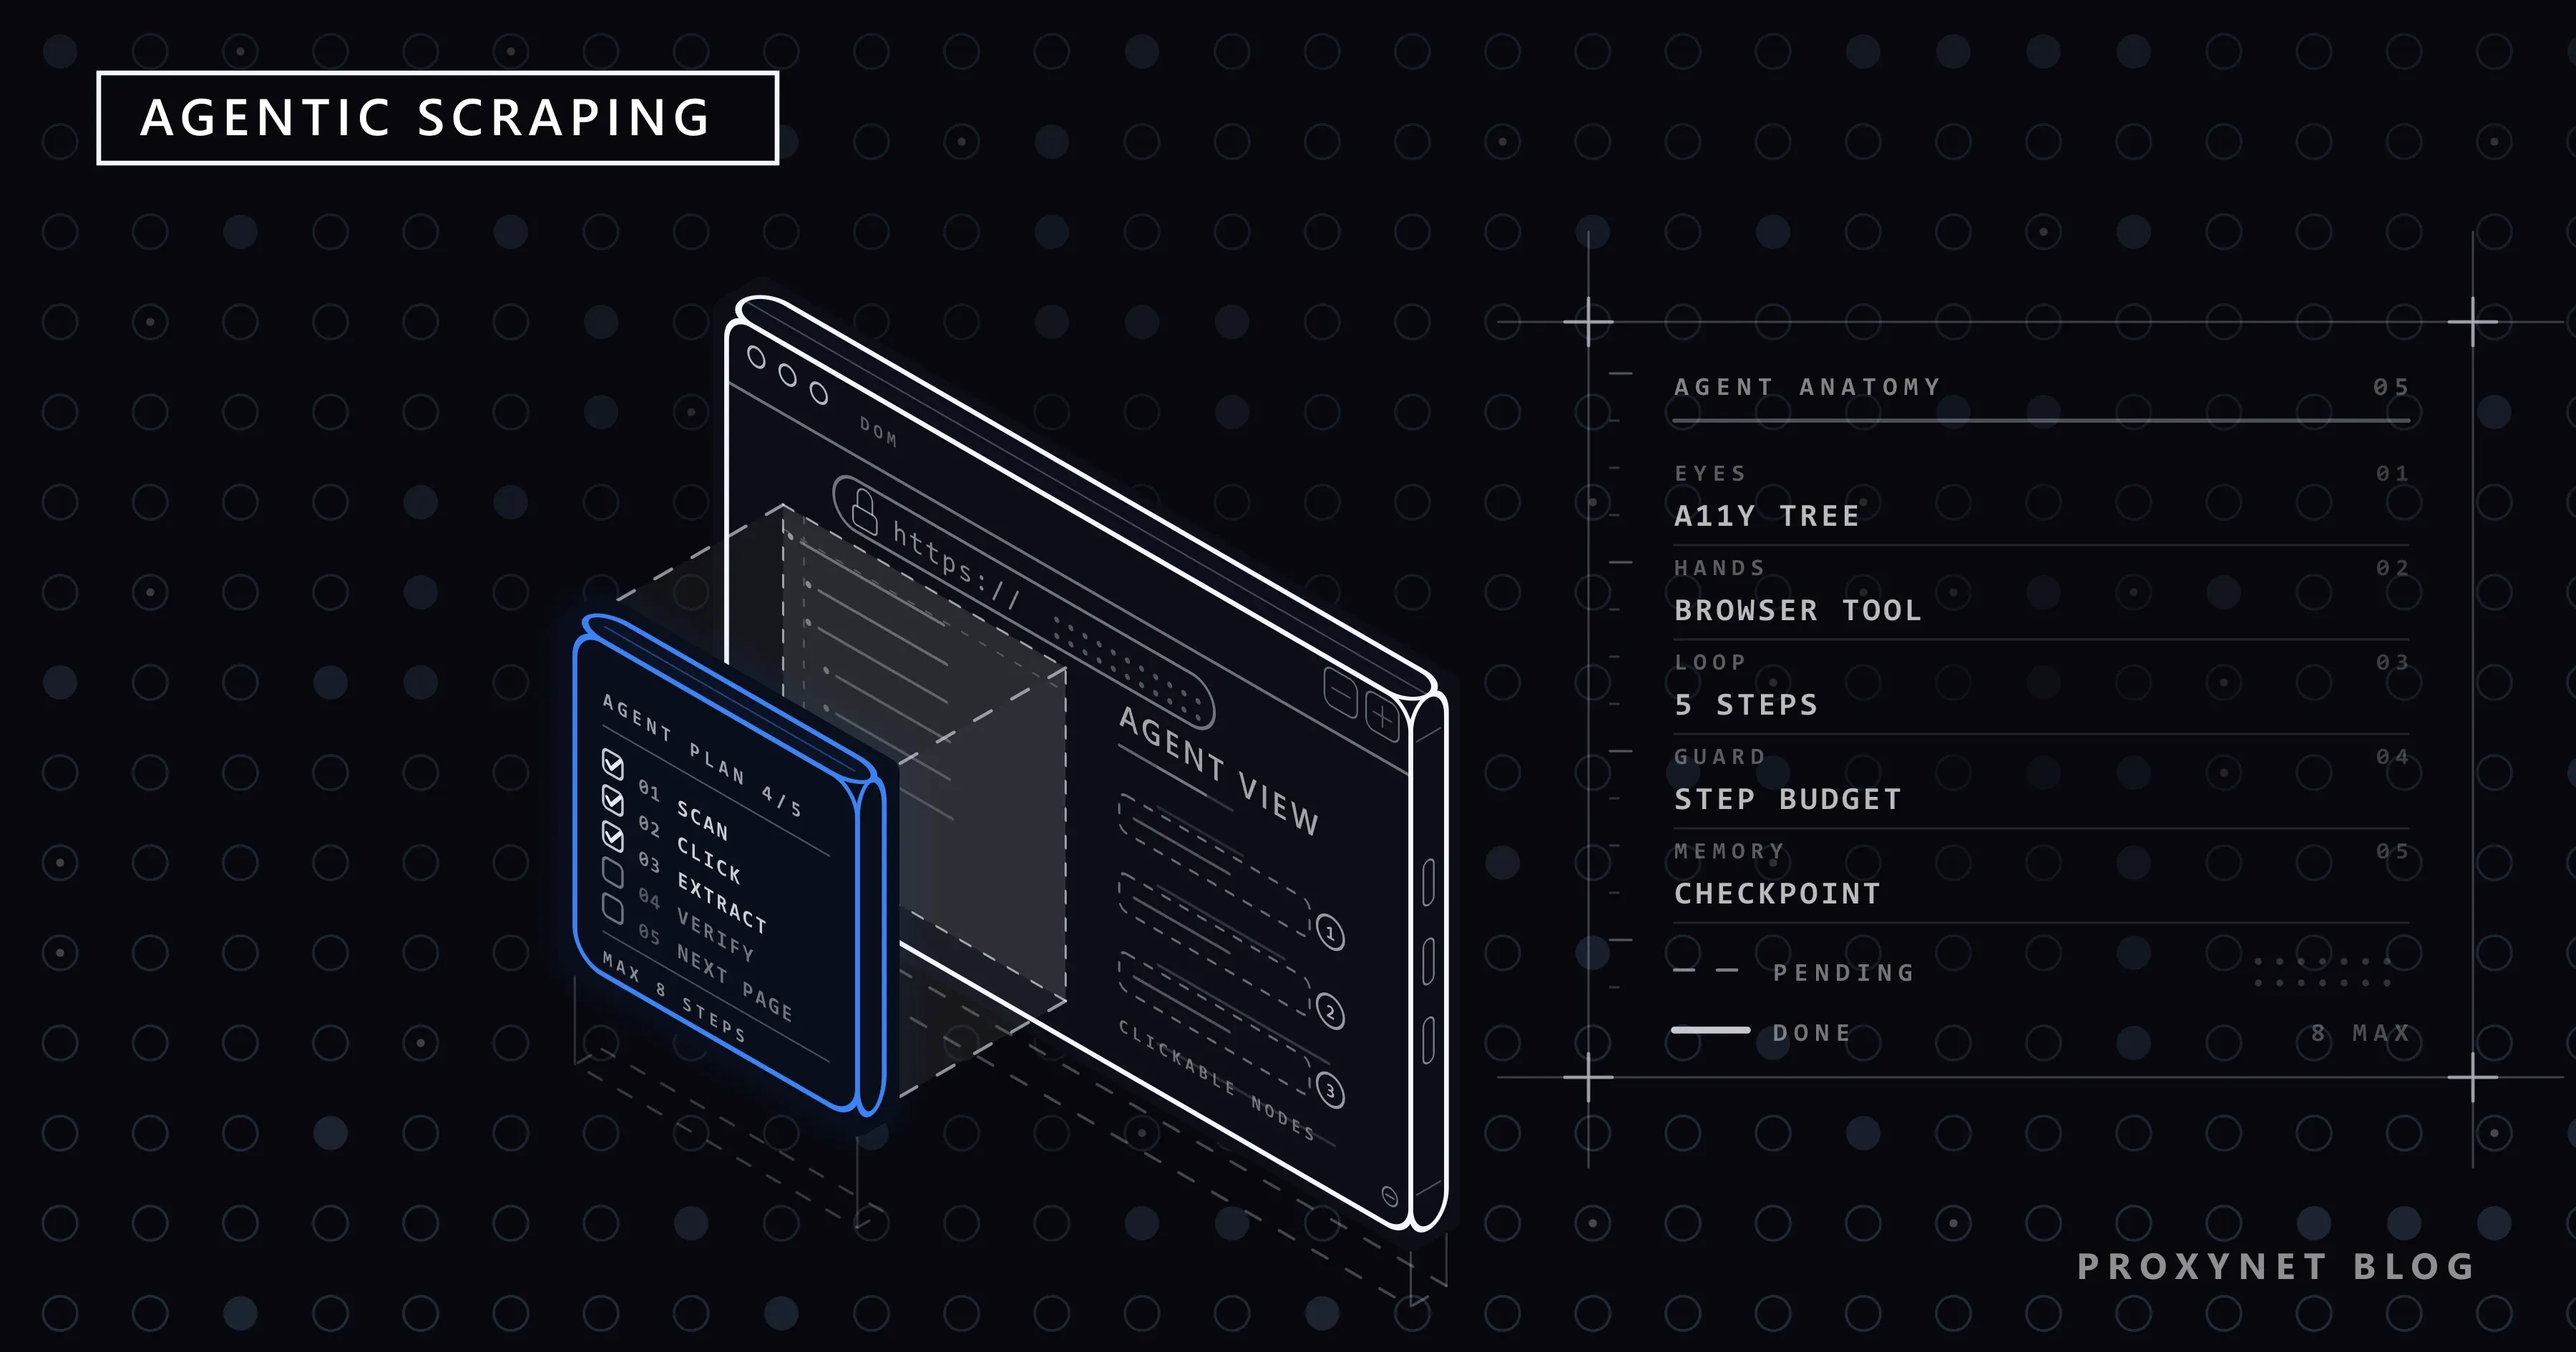
Publicado
O que é agentic web scraping e como funciona?
No agentic web scraping o agente navega pela página, decide a próxima etapa e extrai os dados conforme um esquema. Explicamos o loop, o custo e os limites.
Autor:Acar Diveroli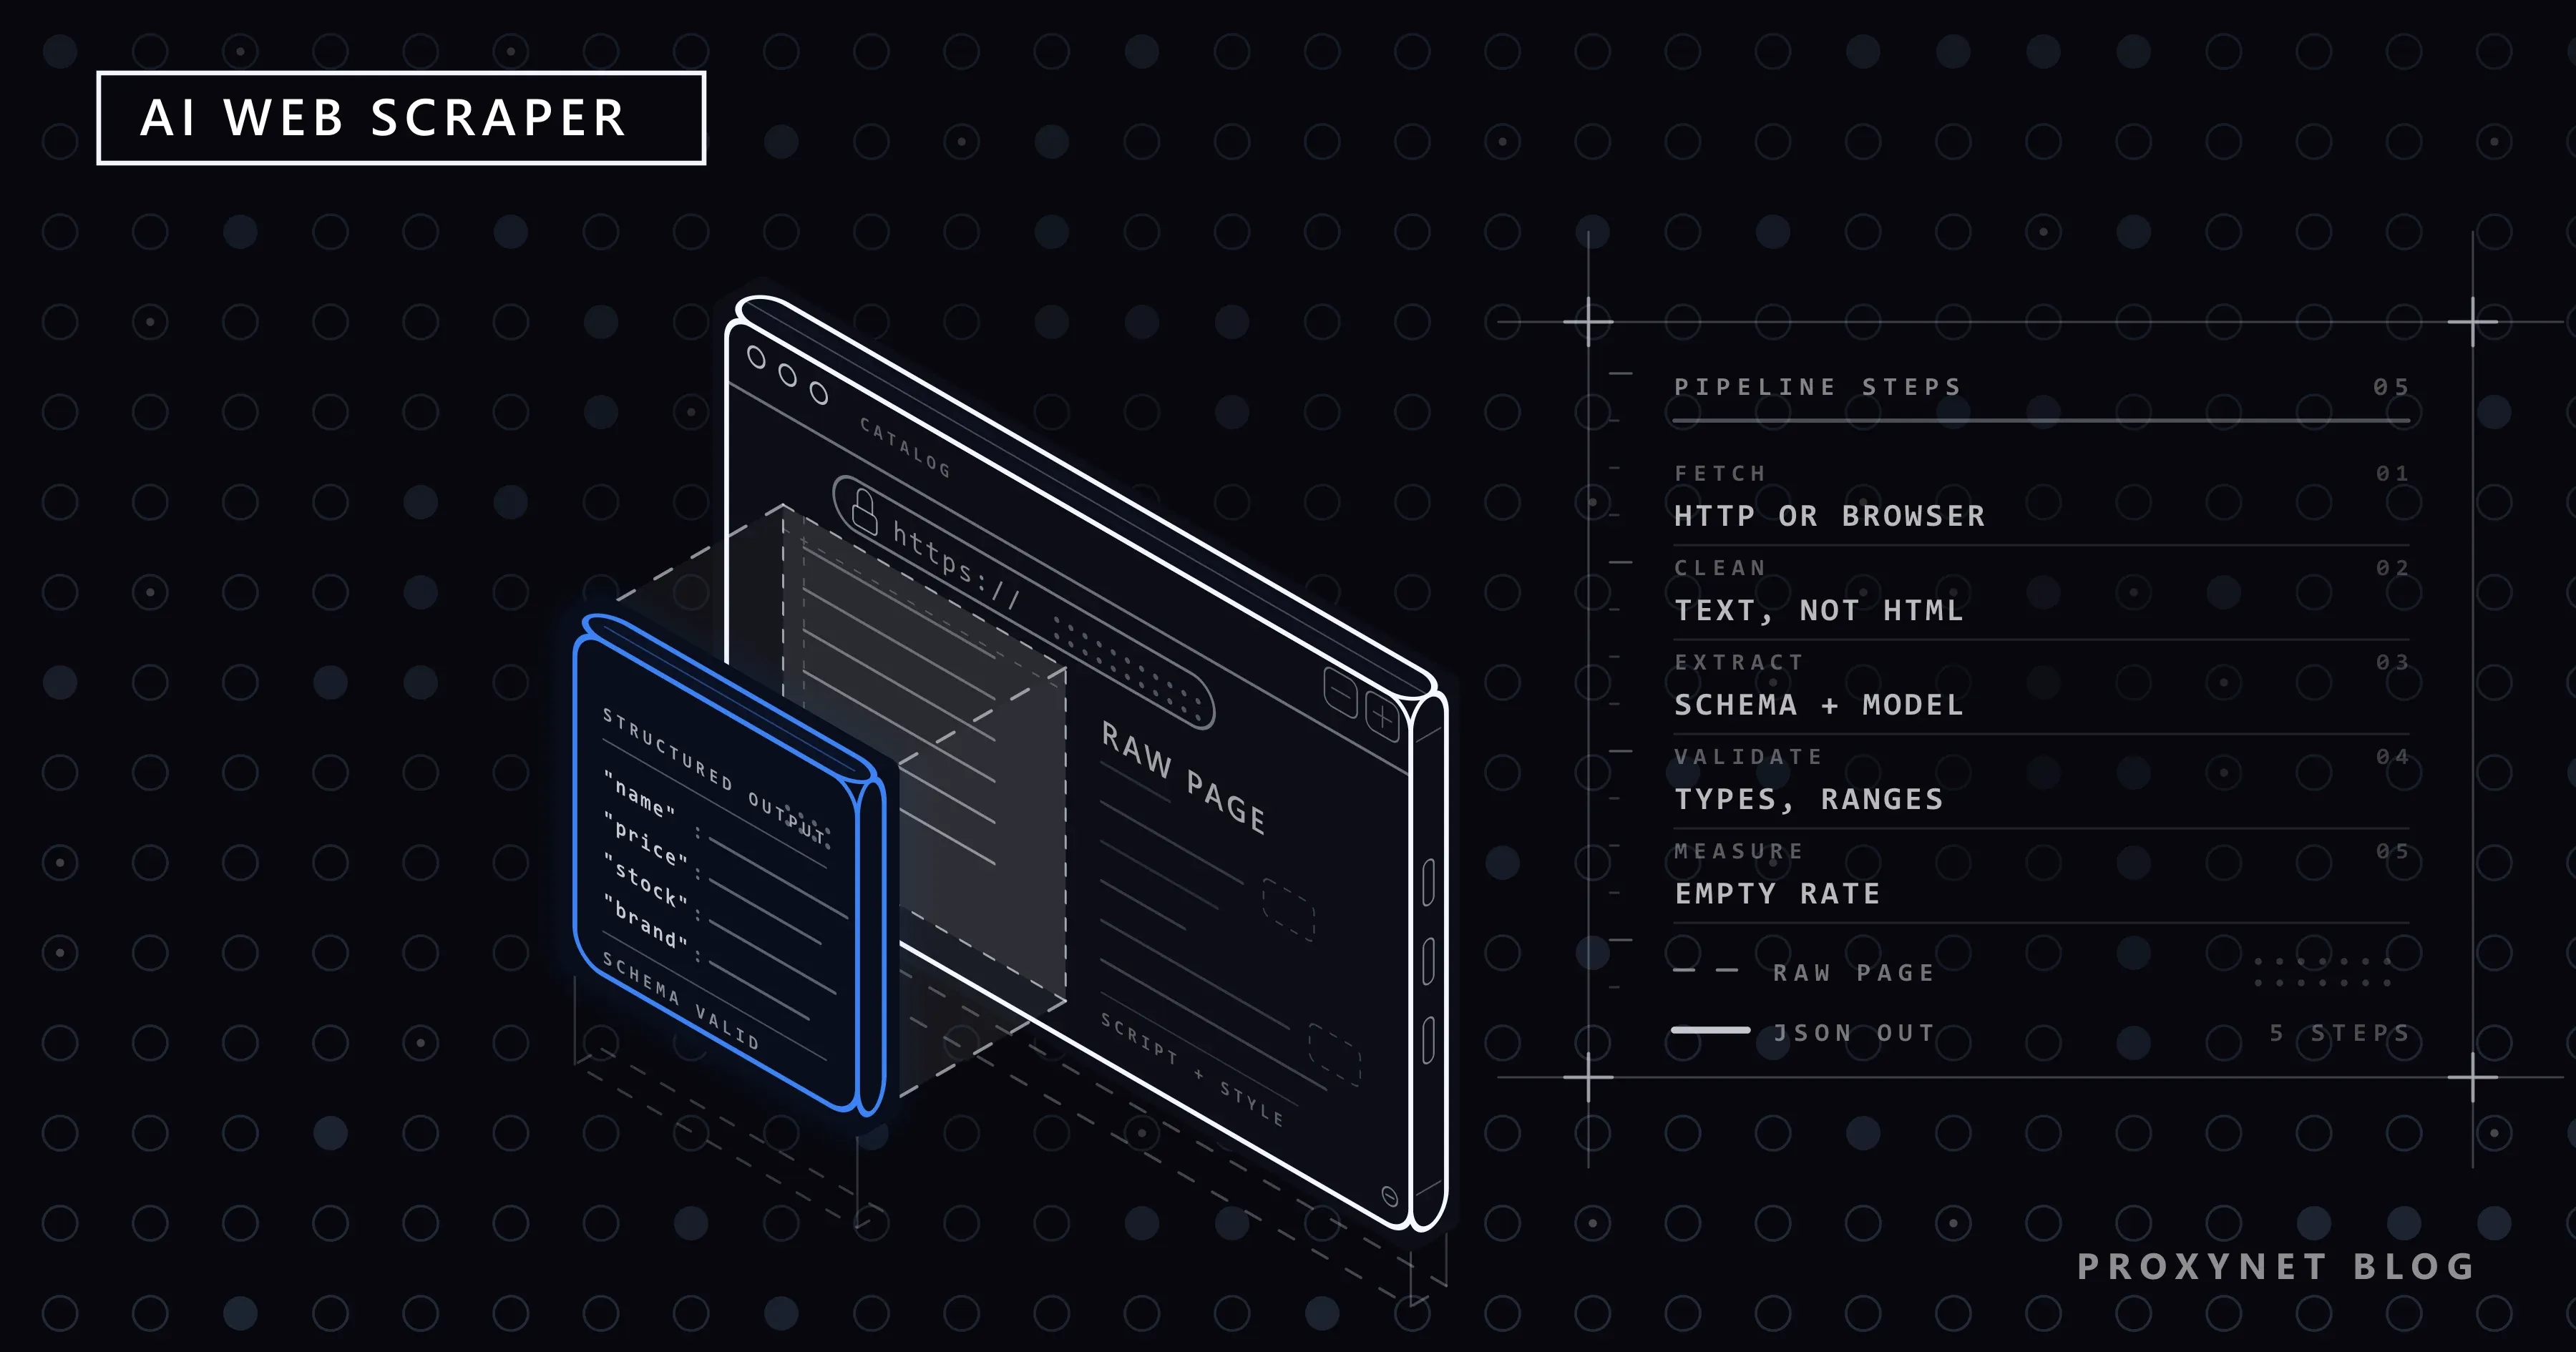
Publicado
O que é AI web scraper e como funciona?
Um AI web scraper deixa a extração de campos a cargo da IA em vez de seletores fixos. Explicamos as etapas, os tipos de ferramentas e os limites.
Autor:Acar Diveroli
Publicado
O que é Error 1015? Como resolver You are being rate limited
Error 1015 é um bloqueio temporário que aparece quando muitas requisições chegam em pouco tempo a um site atrás da Cloudflare. Veja causas, duração e solução.
Autor:Acar Diveroli
Publicado
Como monitorar preços da concorrência no e-commerce
Monitorar preços da concorrência reúne pareamento de produtos, leituras periódicas e alertas. Veja as APIs de vendedor, um script Python testado e a frequência.
Autor:Enver Kaya
Publicado
Web scraping com C#: HttpClient e proxy na prática
Para extrair dados com C# você monta um único HttpClient de vida longa, analisa o HTML com HtmlAgilityPack e passa o proxy ao handler como um WebProxy.
Autor:Acar Diveroli
Como baixar todas as imagens de um site sem código
Autor: Enver KayaWeb scrapingPublicado
Como encontrar o sitemap de um site e ver todas as páginas
Autor: Acar DiveroliWeb scrapingPublicado
Como corrigir JSONDecodeError: Expecting Value no Python
Autor: Acar DiveroliTutoriaisPublicado
Max Retries Exceeded With URL: o que é e como resolver
Autor: Acar DiveroliTutoriaisPublicado
Erros de codificação no Python: acentos e UnicodeDecodeError
Autor: Acar DiveroliWeb scrapingPublicado
Web scraping vs. web crawling: qual é a diferença?
Autor: Acar DiveroliComparativosPublicado
Cloudflare scraper: por que é bloqueado e o que funciona
Autor: Acar DiveroliWeb scrapingPublicado
O que é agentic web scraping e como funciona?
Autor: Acar DiveroliIAPublicado
O que é AI web scraper e como funciona?
Autor: Acar DiveroliWeb scrapingPublicado
O que é Error 1015? Como resolver You are being rate limited
Autor: Acar DiveroliTutoriaisPublicado
Como monitorar preços da concorrência no e-commerce
Autor: Enver KayaCasos de usoPublicado
Web scraping com C#: HttpClient e proxy na prática
Autor: Acar DiveroliTutoriaisPublicado
Nenhum artigo encontrado
Publicado
Publicado