El equipo de operaciones de un distribuidor empieza cada mañana igual: alguien inicia sesión en el portal de un proveedor, descarga la lista de precios de ayer y teclea los cambios en un sistema ERP que no tiene API. Al fondo del pasillo, el equipo de analítica quiere los precios de los mismos productos en veinte sitios minoristas públicos, cada día, en una sola tabla. Los dos trabajos son «automatización», pero piden herramientas distintas: un robot de software que maneja el portal pantalla a pantalla y un scraper que lee páginas públicas como respuestas HTTP.
Este artículo explica qué son RPA y web scraping, cómo funciona cada uno, en qué se diferencian, dónde se solapan, cuándo gana cada uno, quién debería encargarse de ellos, dónde encaja un proxy y qué cambian los agentes de IA. Los datos de los fabricantes proceden de la documentación de UiPath, Automation Anywhere y Microsoft, leída el 9 de noviembre de 2026.
¿Qué es RPA?
RPA, siglas de robotic process automation (automatización robótica de procesos), es software que automatiza trabajo repetitivo y basado en reglas manejando otro software como lo haría una persona. El «robot» es un programa: abre una aplicación, encuentra un botón o un campo, hace clic, escribe, copia un valor y lo pega en otro sitio. Trabajar en la interfaz de usuario le permite conectar sistemas que nunca se diseñaron para hablar entre sí.
Hasta el vocabulario tiene un estándar. IEEE 2755-2017, la IEEE Guide for Terms and Concepts in Intelligent Process Automation, se publicó el 28 de septiembre de 2017 para mantener coherente la terminología de la automatización inteligente de procesos basada en software, y sigue figurando como activa. La definición de UiPath se parece: RPA «usa robots de software para automatizar tareas repetitivas y basadas en reglas, como la entrada de datos y la integración de sistemas» e «imita acciones humanas en sistemas digitales». Automation Anywhere lo llama «basado en reglas por naturaleza» y lo remonta a las macros de teclado de los años noventa.
Hay dos clases de robots. Un robot attended (asistido) trabaja con una persona en la misma máquina: el usuario lo inicia con un botón o un atajo de teclado, aporta las entradas y gestiona las excepciones, como lo describe la documentación de Automation 360 de Automation Anywhere. Un robot unattended (desatendido) se ejecuta solo, normalmente en una máquina dedicada, iniciado por una programación, una llamada a una API o un evento; UiPath describe esos procesos como «controlados a través de Orchestrator», su servidor de gestión, con una licencia aparte.
¿Qué es el web scraping?
El web scraping es la obtención programática de páginas web y la extracción de datos estructurados a partir de ellas. Un scraper envía la solicitud HTTP que enviaría un navegador, recibe el HTML o el JSON que la página carga en segundo plano, selecciona los campos que le indicaron y los guarda como filas. No interviene ninguna pantalla: el programa lee el código de la página, no sus píxeles. El proceso completo está en ¿Qué es el web scraping y cómo funciona?
¿Cómo funciona cada uno?
Un proceso de RPA:
- Diseñar el flujo. Un desarrollador o un usuario de negocio graba los clics una vez, o combina acciones predefinidas en un diseñador visual, y añade reglas como «enviar a aprobación las facturas que superen un umbral».
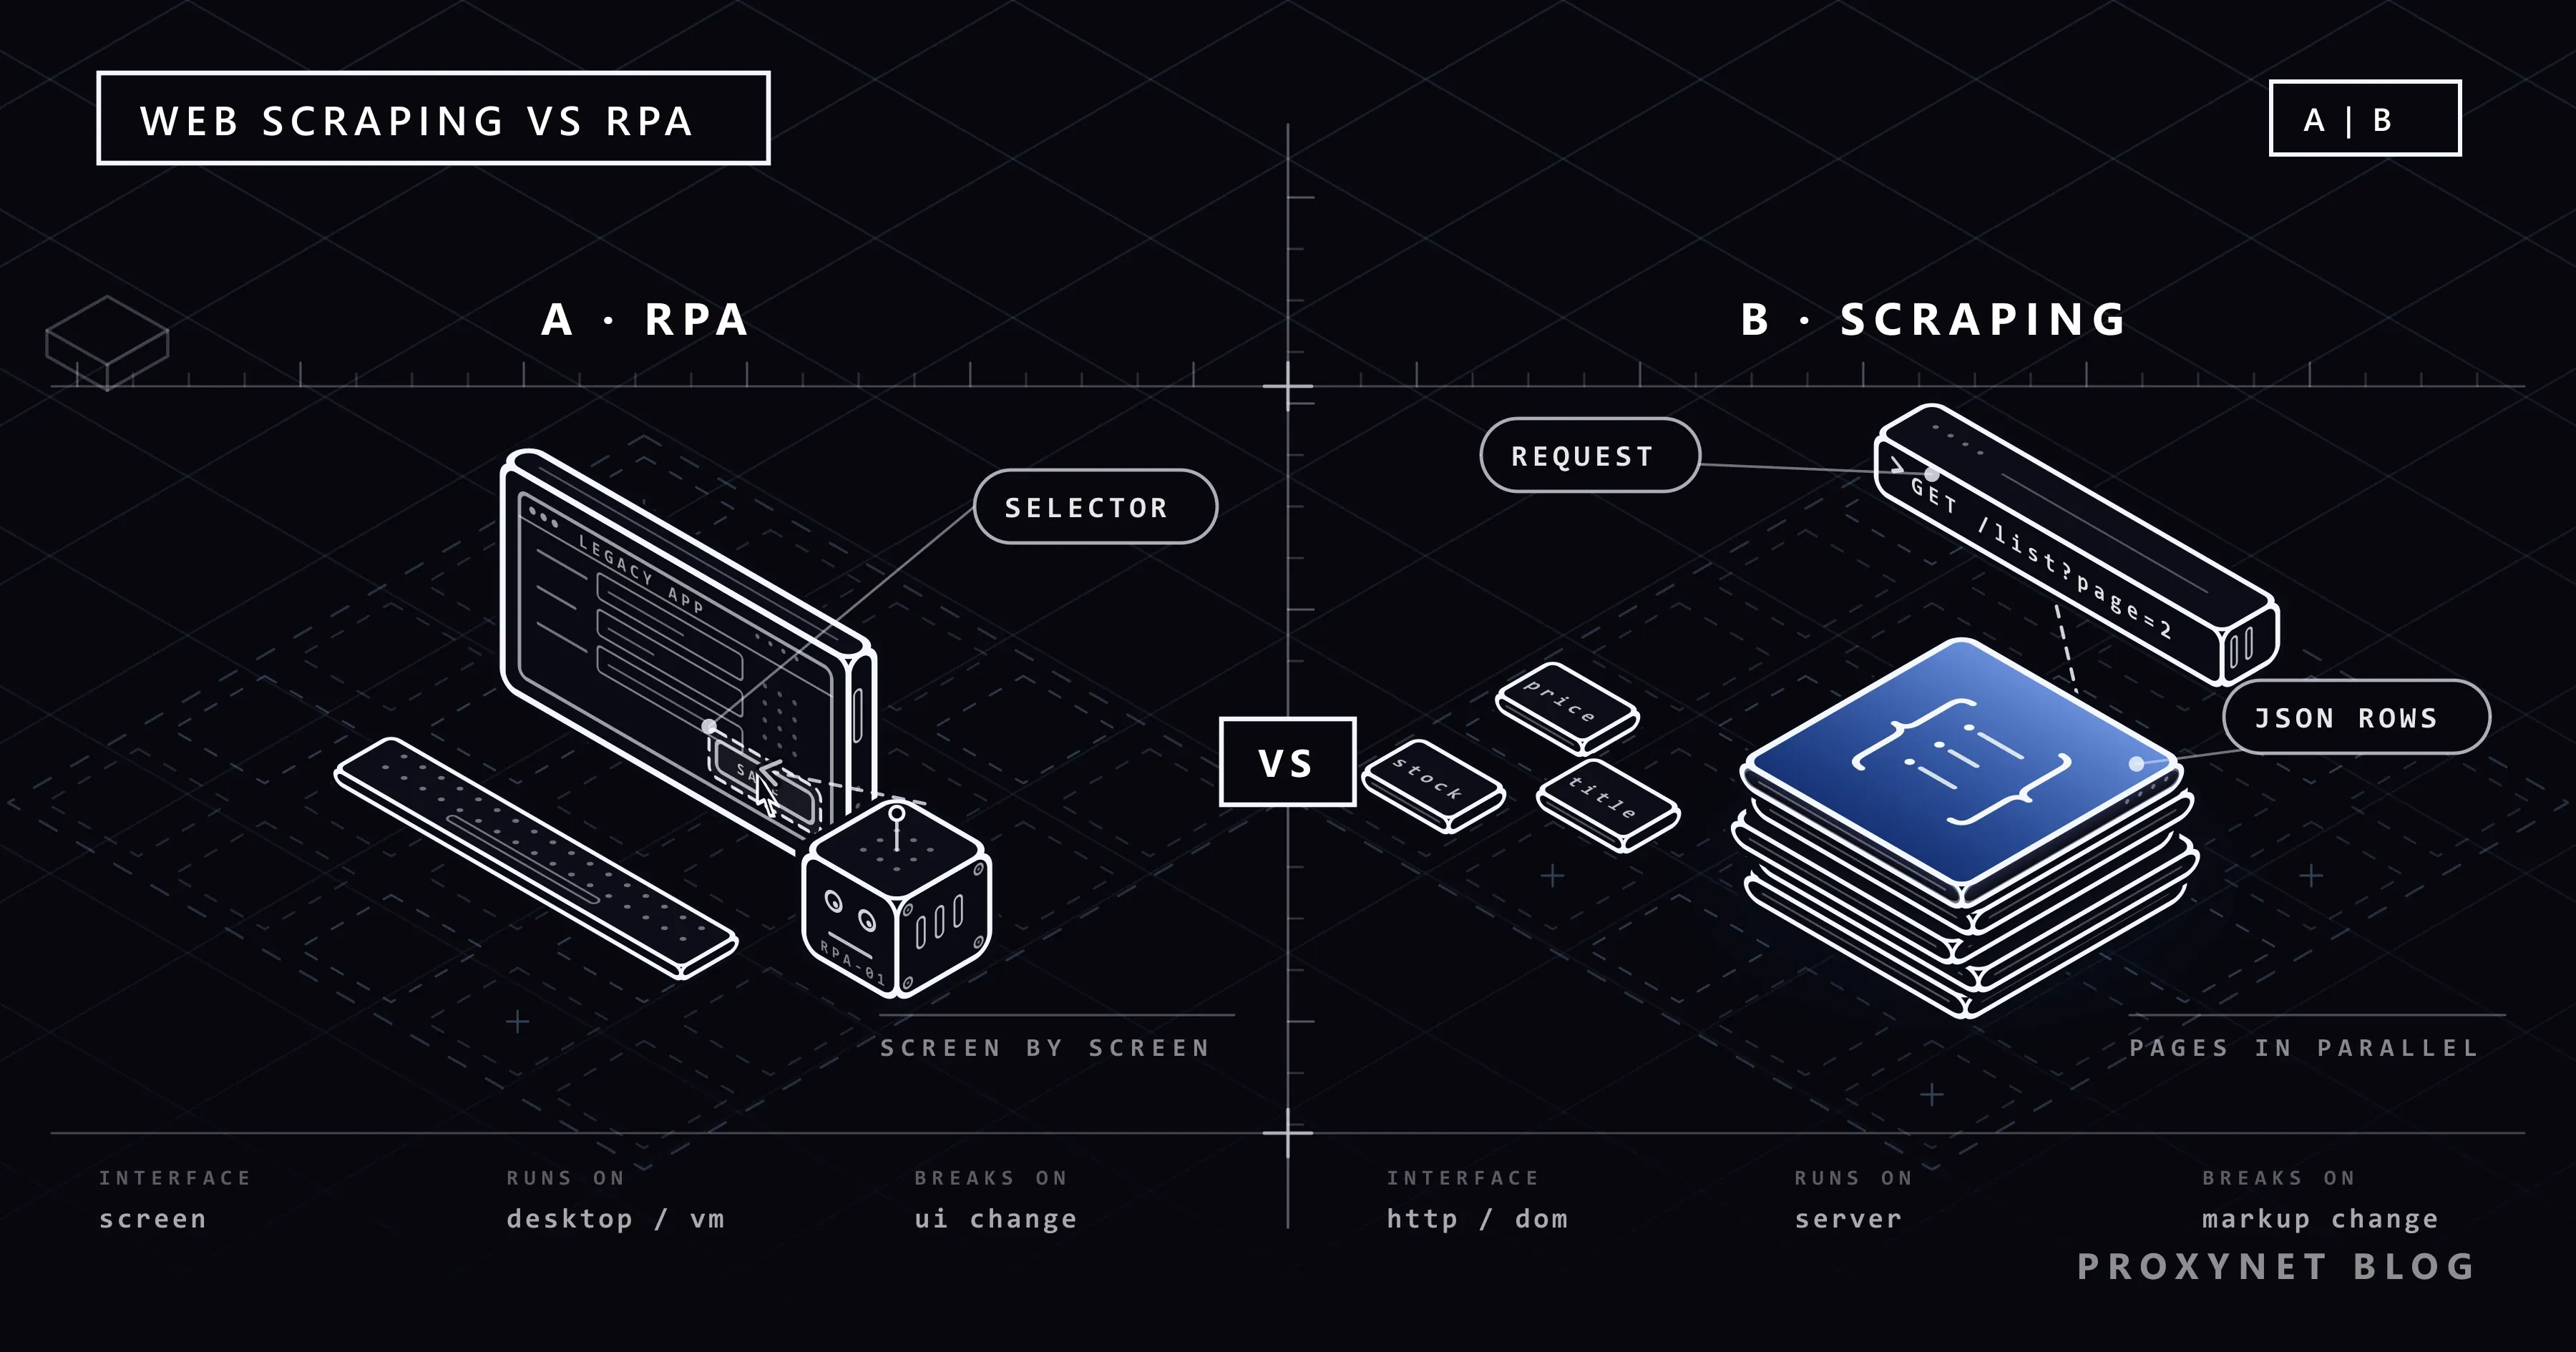
- Vincular cada paso a un elemento de la interfaz mediante un selector. La documentación de UiPath define un selector como un fragmento XML que almacena «los atributos de un elemento de la interfaz gráfica de usuario y de sus elementos superiores»; Power Automate lo construye a partir del lugar del elemento en la jerarquía de la aplicación y prueba el siguiente selector cuando el primero falla.
- Ejecutar el robot en un equipo de escritorio o una máquina virtual. Una ejecución asistida usa la sesión del usuario. Una ejecución desatendida necesita su propia máquina: Power Automate inicia sesión con una conexión guardada, abre una sesión de escritorio remoto, mantiene la pantalla bloqueada y cierra la sesión al terminar; en Windows 10 y 11 no arranca mientras haya cualquier sesión de usuario activa, aunque esté bloqueada (Microsoft Learn).
- Pasar las excepciones a una persona. Cuando un selector no encuentra nada o un valor no supera una comprobación, el robot deja el elemento en una cola para que lo revise alguien.
Un trabajo de web scraping:
- Solicitar. Solicitudes HTTP para una lista de URL a un ritmo prudente, con tiempo de espera y un User-Agent honesto, después de revisar robots.txt y las condiciones de uso.
- Analizar. El HTML se convierte en un árbol y los campos se seleccionan con selectores CSS o XPath, o se leen del endpoint JSON al que llama la propia página.
- Normalizar. Los precios pasan a ser números en una sola moneda, las fechas adoptan un único formato y los duplicados se convierten en un solo registro.
- Guardar y repetir. Las filas van a un archivo o a una base de datos, y el trabajo vuelve a ejecutarse según una programación.
Web scraping vs RPA: tabla comparativa
| Aspecto | RPA | Web scraping |
|---|---|---|
| Propósito | Automatizar un proceso de negocio entre aplicaciones | Recopilar datos de páginas web |
| Trabaja en | La interfaz de usuario: ventanas, botones, campos | Respuestas HTTP: HTML, JSON |
| Necesita pantalla | Sí, una sesión de escritorio o de VM | No |
| Escala | Una pantalla a la vez por robot | Muchas solicitudes en paralelo desde un servidor |
| Se rompe cuando | Cambia una ventana, una etiqueta, el diseño o la resolución | Cambia el HTML; el sitio limita las solicitudes |
| Modelo de costos | Licencia por robot o por runtime, máquinas, un desarrollador | Tiempo de ingeniería, servidores, proxies, mantenimiento |
| Responsable típico | Operaciones, finanzas o automatización de TI | Equipo de datos o de ingeniería |
| Resultado | Un proceso completado | Un conjunto de datos en filas |
¿Dónde se solapan RPA y web scraping?
La mayoría de las suites de RPA incluyen un pequeño scraper, y la mayoría de los equipos de datos acaban necesitando un bot.
Un bot de RPA que lee un sitio web público. La acción Extract data from web page (extraer datos de una página web) de Power Automate, según su página de referencia, extrae «datos de partes concretas de una página web como valores únicos, listas, filas o tablas», sigue la paginación hasta un número de páginas definido y guarda el resultado en una variable o en una hoja de cálculo de Excel. Eso es scraping a través de un navegador que controla el robot: sirve para unas pocas páginas dentro de un proceso más amplio y es la herramienta equivocada para diez mil páginas al día, porque cada página se renderiza de una en una.
Un scraper que alimenta un proceso de RPA. Un scraper recoge los precios de la competencia, un analista decide y un bot teclea los nuevos precios en una herramienta de precios sin función de importación: el scraper pone el volumen y el bot recorre el último tramo.
Una API oficial que hace innecesarios a los dos. Si el portal del proveedor ofrece una API, el bot que hace clic sobra; si un sitio publica un feed de datos, hacerle scraping también. Nuestra comparación entre web scraping y API trata esa decisión.
¿Cuándo gana cada uno?
RPA gana cuando el trabajo vive dentro de sistemas a los que no puedes llegar de otra forma:
- Aplicaciones heredadas sin API: emuladores de terminal, aplicaciones publicadas con Citrix, un programa de Windows de 2004; Microsoft menciona los emuladores de terminal entre las aplicaciones heredadas que automatizan los flujos de escritorio.
- Software de escritorio con licencia que un usuario puede manejar pero que no ofrece acceso programático.
- Aprobaciones con una persona en el circuito, donde un robot asistido prepara el trabajo y una persona lo valida.
- Procesos en lugar de conjuntos de datos: el objetivo es «la factura está contabilizada», no «aquí hay una tabla».
El web scraping gana cuando los datos son públicos, el volumen es grande y las fuentes son muchas:
- Escala: miles de páginas de producto al día son un trabajo de scraping corriente y un trabajo de RPA imposible.
- Seguimiento: las comprobaciones cada hora necesitan un programa en un servidor, no un robot que necesita una sesión de escritorio.
- Conjuntos de datos recopilados durante semanas; el resultado ya es una tabla.
- Vistas de varios países: un scraper puede enviar cada solicitud por una salida en el país adecuado; un robot de escritorio en una oficina no puede.
¿Cuánto cuestan y qué los rompe?
Los costos de RPA empiezan por las licencias, que se venden por robot, por usuario o por runtime, y las ejecuciones desatendidas suelen estar en un nivel superior; Power Automate exige su plan Process para los flujos de escritorio desatendidos. Después vienen las máquinas, un desarrollador y los usuarios que gestionan las excepciones. Los costos del scraping son el tiempo de ingeniería de los parsers, los servidores, el tráfico de proxy donde los destinos lo requieren y un seguimiento que detecte cuándo un selector deja de devolver datos sin avisar.
Lo que rompe el RPA es la pantalla: un botón renombrado, un campo nuevo, un cuadro de diálogo inesperado o una resolución distinta en la máquina desatendida, que según advierte Microsoft puede ocultar un elemento de destino o hacer que el robot actúe sobre el elemento equivocado. La guía de selectores de UiPath dice que, cuando el valor de un atributo cambia entre ejecuciones, «el selector no podrá identificar correctamente el elemento». Lo que rompe el scraping es el marcado y el portero: un rediseño renombra las clases de las que depende tu parser, y un sitio que ve demasiadas solicitudes desde una misma dirección responde 429 Too Many Requests o muestra una página de protección contra bots.
¿Quién es el responsable del bot?
Un bot de RPA actúa dentro de tus sistemas con las credenciales de un empleado o de una cuenta de servicio: las ejecuciones desatendidas de Power Automate inician sesión con las credenciales guardadas en una conexión de flujo de escritorio, y los bots desatendidos de Automation Anywhere los inicia el programador de su Control Room, llamadas a la API o eventos. Dale los mínimos privilegios, registra cada ejecución y avisa a alguien cuando se acumulen las excepciones.
Un scraper actúa como visitante del sitio de otra persona, bajo sus condiciones de uso, su robots.txt y la ley de protección de datos. Los precios y el stock son datos comerciales públicos; los nombres, los teléfonos y las direcciones de correo de las personas son datos personales según el RGPD y la KVKK de Türkiye, y nuestros ejemplos nunca los recopilan. Mantén un ritmo prudente, identifica el scraper con honestidad y detente cuando te lo pidan. Este artículo describe las reglas; para un proyecto concreto, consulta a un abogado.
¿Dónde encaja un proxy?
Un proxy solo importa en el lado de cualquiera de las dos herramientas que mira hacia la web. Un robot o un scraper que se ejecuta en un centro de datos llega a los sitios públicos desde la dirección IP de ese centro de datos y ve los precios y el idioma que recibe esa ubicación; cuando el proceso debe ver la versión local de un mercado, dale una salida en ese mercado.
Para un robot o un scraper que inicia sesión en el portal de un socio o llama a la API de un socio que solo acepta direcciones autorizadas, con los Proxies ISP tiene una única IP estable; estos productos por IP vienen con el acceso limitado a los sitios de destino que indiques, y el acceso a todos los sitios web es un complemento de pago.
Para leer cómo ve un sitio un cliente de un país o una ciudad concretos, los Proxies residenciales orientados a esa ubicación muestran los precios locales. Un proxy cambia de dónde viene la solicitud, no lo que permite el sitio.
RPA y agentes de IA: ¿qué cambia?
Un agente de IA planifica sus propios pasos; un bot de RPA sigue los pasos que le dieron. Un agente construido alrededor de un modelo de lenguaje mira un objetivo, elige la siguiente herramienta, lee el resultado y se adapta, así que puede arreglárselas con una ventana que nunca ha visto, a cambio de una llamada al modelo por paso y de una ruta que mañana puede ser distinta. Un flujo de RPA hace lo mismo cada vez. Cómo funciona el bucle del agente, y por qué los trabajos predecibles siguen perteneciendo a un flujo de trabajo fijo, se explica en Agentes de IA: planificación, herramientas y memoria.
Los fabricantes están fusionando las dos cosas (UiPath incluye la visión artificial y la comprensión de documentos entre las capacidades de IA que amplían sus robots); el patrón que se sostiene es un flujo fijo con un modelo en un paso, no un agente haciendo clic libremente por un sistema de producción.
Errores comunes
- Hacer scraping de diez mil páginas con un bot de RPA. Cada página cuesta un navegador renderizado en una máquina ocupada; pasa el volumen a un scraper.
- Construir un scraper para un sistema interno que tiene API. Asumes mantenimiento para nada, y la API es la vía que permiten sus condiciones.
- Ejecutar un robot con una cuenta personal. Cuando esa persona se va, el proceso se detiene y el registro de auditoría se difumina.
- Tratar un scraper como si estuviera exento de las reglas del sitio. Las condiciones de uso, el robots.txt y los límites de solicitudes se aplican a un programa igual que a un visitante.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Mover datos entre dos sistemas internos sin API | RPA |
| El proveedor ofrece una API o un feed de datos | Usa la API |
| Precios públicos de cientos de sitios cada día | Web scraping, con salidas por país |
| Una persona debe aprobar cada elemento | RPA asistido |
| Documentos sin estructura en un paso de un proceso fijo | RPA más un modelo en ese paso |
| Pasos que no se pueden dibujar de antemano | Un agente de IA con límites y aprobación |
| Muchos sitios y ningún equipo que mantenga los parsers | Una API de scraping gestionada |
Preguntas frecuentes
¿Qué es RPA y para qué se usa?
RPA es la automatización robótica de procesos: robots de software que realizan tareas basadas en reglas manejando otros programas a través de su interfaz de usuario, como lo haría una persona. Mueve datos entre sistemas que no tienen API, contabiliza facturas y ejecuta otros procesos repetitivos de back office.
¿El web scraping es un tipo de RPA?
No. El web scraping lee páginas web por HTTP y extrae campos de la respuesta; RPA automatiza procesos de negocio actuando sobre las pantallas de las aplicaciones. Son herramientas distintas, con responsables y costos distintos.
¿Las herramientas de RPA pueden hacer scraping de sitios web?
Sí, a pequeña escala. La acción Extract data from web page de Power Automate saca valores únicos, listas o tablas de una página; para miles de páginas al día, un scraper dedicado es más rápido y más barato, porque no renderiza una pantalla por cada una.
RPA vs API: ¿cuál deberías elegir?
La API, siempre que el sistema ofrezca una con los datos que necesitas: es un contrato que el proveedor mantiene, mientras que un robot depende de una pantalla que puede cambiar en cualquier momento. RPA es la alternativa para sistemas sin API, como el software de escritorio heredado o con licencia.
¿Los agentes de IA reemplazarán al RPA?
No en los procesos predecibles. Un agente decide sus propios pasos, lo que ayuda cuando un trabajo no se puede guionizar de antemano, pero añade costo por paso y hace el resultado menos repetible; un proceso fijo y auditable sigue perteneciendo a un flujo definido, a menudo con un modelo en un paso.
¿Qué es más barato, RPA o web scraping?
Depende del trabajo. RPA conlleva costos de licencias, máquinas y desarrolladores y encaja en procesos con decenas o cientos de elementos al día; el scraping conlleva costos de ingeniería, servidores y proxies y se abarata por página a medida que crece el volumen.
En resumen
RPA automatiza un proceso de negocio manejando software a través de su pantalla, lo que alcanza sistemas sin API a cambio de depender de esa pantalla. El web scraping recopila datos de páginas públicas por HTTP, lo que escala a miles de páginas y países a cambio de mantener parsers y seguir las reglas de cada sitio. Comprueba primero si hay una API; después usa RPA para los procesos internos y scraping para los datos web públicos. Si prefieres recibir registros ya extraídos en lugar de mantener parsers, nuestra API de web scraping ofrece extracción de páginas gestionada a través de nuestro equipo de ventas.