Un equipo de soporte quiere un asistente que responda a partir de la documentación pública de los productos que atiende. La primera versión descarga las páginas con Requests y le entrega el HTML al modelo. Las respuestas citan el aviso de cookies, el menú ocupa más espacio en el prompt que el artículo, las páginas que cargan su texto con JavaScript vuelven vacías y una página que cambió la semana pasada todavía se responde desde la copia antigua. El modelo no tiene nada malo. Los datos nunca se prepararon.
Este artículo trata esa preparación: qué es RAG, por qué las páginas web son la fuente más difícil de preparar, por qué Markdown supera tanto al HTML como al texto plano, el pipeline desde la descarga hasta la actualización, un ejemplo medido en una página real con un script de Python de 58 líneas y dónde encajan las API de scraping y los proxies. El script se ejecutó el 9 de noviembre de 2026 con trafilatura 2.3.1, tiktoken 0.14.0 y Python 3.13.
¿Qué es RAG y para qué se usa?
RAG, abreviatura de retrieval-augmented generation (generación aumentada por recuperación), es una forma de responder con un modelo de lenguaje en la que los hechos salen de documentos recuperados en el momento de la pregunta y no solo del entrenamiento del modelo. Un recuperador (retriever) busca en un índice de pasajes, las mejores coincidencias entran en el prompt y el modelo escribe su respuesta a partir de ellas. El índice puede guardar cualquier cosa convertida en texto: PDF, tickets, filas de bases de datos y páginas web.
El nombre viene de un artículo de 2020 de Patrick Lewis, Ethan Perez, Aleksandra Piktus y colegas, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Combina un modelo secuencia a secuencia preentrenado, cuyo conocimiento vive en sus parámetros, con un índice vectorial denso de Wikipedia que lee un recuperador neuronal, lo que los autores llaman memoria no paramétrica. Dos problemas que el artículo nombra son exactamente los que plantea el contenido web: actualizar lo que el modelo sabe y mostrar de dónde salió una respuesta. El ajuste fino (fine-tuning) fija el conocimiento en los pesos, así que cada cambio en una página supone otra ronda de entrenamiento y ninguna fuente que citar; con RAG, una página modificada se vuelve a descargar y a indexar, y cada respuesta puede llevar su URL y su sección.
¿Por qué las páginas web son la fuente más difícil para RAG?
Las páginas web son difíciles porque el contenido que quieres es una minoría de lo que envía el servidor. Una página de documentación lleva un árbol de navegación, una cabecera, un pie de página, un aviso de cookies, botones para compartir y «artículos relacionados», todo como texto que un pipeline ingenuo indexa junto al artículo. Cuando un usuario pregunta por los límites de solicitudes, el recuperador devuelve el aviso de cookies porque contiene la palabra «límite».
Otros tres problemas son propios de la web. Muchas páginas cargan su texto con JavaScript, así que el HTML que descargas tiene un título y un div vacío. Un mismo artículo suele vivir en varias URL, con parámetros de seguimiento, una vista de impresión, http y https o una barra final, de modo que el mismo pasaje entra tres veces en el índice y llena los primeros resultados con copias de sí mismo. Y las páginas cambian en silencio: un PDF que indexaste en marzo sigue siendo ese PDF, una página de precios no. Suma la paginación que reparte un documento en varias páginas y los errores de codificación que convierten — en —, y tienes el estado normal de un sitio público.
¿Por qué Markdown y no HTML o texto plano?
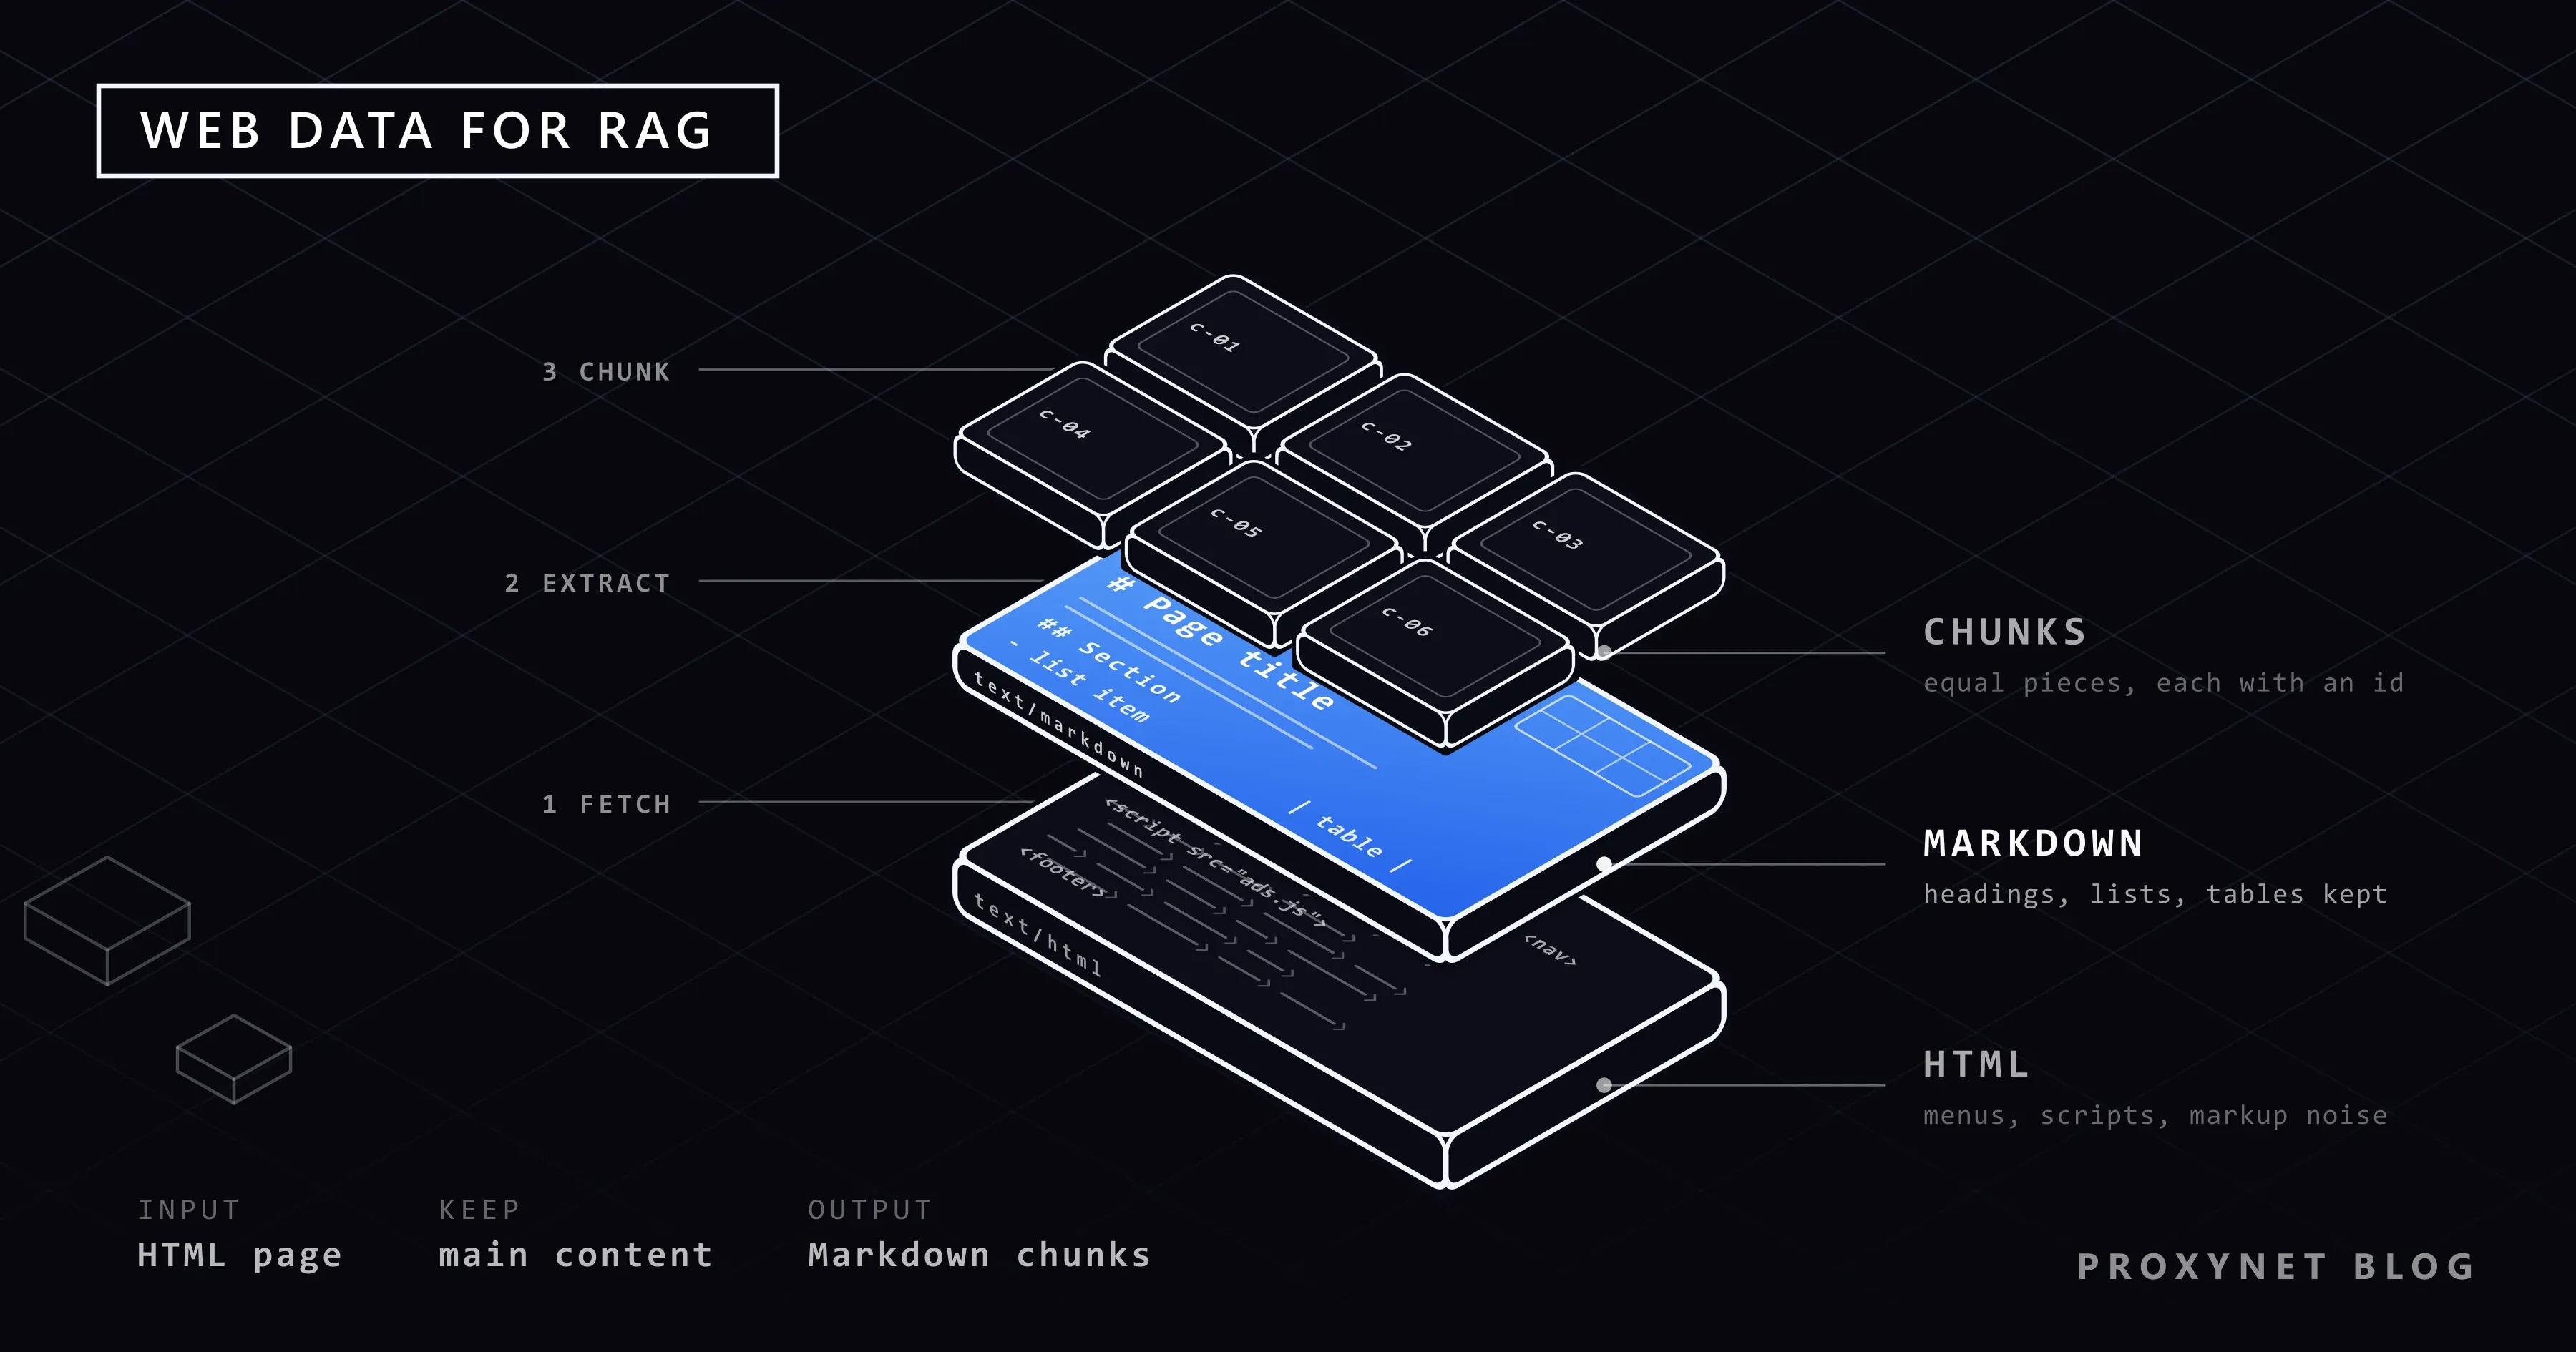
Markdown es el formato intermedio correcto porque conserva la estructura que necesitan un recuperador y un modelo, como encabezados, listas, tablas, bloques de código y enlaces, y descarta el marcado, los scripts y los estilos que no aportan significado. El HTML gasta la mayoría de sus tokens en etiquetas y atributos. El texto plano se pasa al otro extremo: una tabla se convierte en una tira de palabras, un encabezado en una línea como cualquier otra, y ya no queda un lugar fiable donde cortar un fragmento. La propuesta llms.txt, que pide a los sitios publicar versiones Markdown de sus páginas, lo dice sin rodeos: «At the moment the most widely and easily understood format for language models is Markdown» (en este momento, el formato más extendido y más fácil de entender para los modelos de lenguaje es Markdown).
Medimos la diferencia en una página real, el HOWTO de la documentación de Python sobre cómo obtener recursos de internet con urllib, con el tokenizador o200k_base de tiktoken. Las cifras describen esta página, no la web en general.
| Formato | Qué sobrevive | Tokens en la página de prueba | Dónde se pueden cortar los fragmentos |
|---|---|---|---|
| HTML en bruto | Todo, incluidos menús, scripts y marcado | 21.044 | En las etiquetas, que no dicen nada del significado |
| Texto plano | Solo palabras; encabezados y tablas se aplanan | 4.133 | En las líneas en blanco, como mucho |
| Markdown | Encabezados, listas, tablas, código y enlaces | 4.405 | En las líneas de encabezado |
Markdown costó 272 tokens más que el texto plano en esta página, alrededor de un 7 %, y a cambio cada encabezado de sección sigue siendo un encabezado. Frente al HTML en bruto es 4,8 veces más pequeño. Una advertencia: Markdown tiene una especificación para su núcleo, CommonMark (versión 0.31.2, enero de 2024), pero las tablas con barras verticales y los bloques de código delimitados (fenced code blocks) son extensiones que popularizó GitHub, así que comprueba que tu conversor los escribe en lugar de descartarlos.
¿Cómo funciona el pipeline de la web a RAG?
El pipeline tiene diez pasos, y el orden importa porque cada uno depende del anterior.
- Descarga solo lo que puedes descargar. Lee el robots.txt del sitio antes de la primera solicitud y omite las rutas no permitidas; las reglas se explican en nuestra guía de robots.txt. Lee los términos de uso, envía un
User-Agentque nombre a tu bot y una dirección de contacto, y mantén un ritmo prudente por dominio. Si el sitio publica versiones Markdown de sus páginas, úsalas en lugar de analizar el HTML. - Extrae el contenido principal. trafilatura es un paquete de Python y una herramienta de línea de comandos con licencia Apache 2.0 que convierte HTML en bruto en texto, Markdown, XML o JSON y además extrae el título, el autor y la fecha. Mozilla Readability es la biblioteca de JavaScript detrás de la Reader View (vista de lectura) de Firefox;
new Readability(document).parse()devuelve el título, el contenido limpio y la línea de autor. Las dos trabajan a partir de la estructura y la densidad de texto, sin un parser por sitio. - Convierte a Markdown. trafilatura escribe Markdown directamente con
output_format="markdown". Si ya tienes HTML limpio, markdownify en Python o Turndown en JavaScript lo convierten; elige encabezados#de estilo ATX, porque el fragmentador corta por ellos. Las páginas que construyen su contenido con JavaScript necesitan un navegador: Crawl4AI las renderiza en Chromium y devuelve un Markdown «fit» sin menús, como se muestra en nuestra guía de Crawl4AI. - Limpia. Elimina lo que dejó el extractor: símbolos de ancla tras los encabezados, enlaces de «Editar esta página», migas de pan, espacios duplicados. Corrige la codificación en el origen, no en el texto. Deja los bloques de código y las tablas exactamente como están.
- Fragmenta por los encabezados dentro de un presupuesto de tokens. Corta donde empieza una línea de encabezado, guarda la ruta de encabezados como metadatos (
Fetching URLs > Data) y divide las secciones que superan el presupuesto por los límites de párrafo. Cuenta los tokens con el tokenizador del modelo con el que generas los embeddings; tiktoken es el tokenizador BPE rápido de los modelos de OpenAI, yo200k_basees la codificación que usa su README. Los caracteres no sirven de sustituto: 500 caracteres son unos 100 tokens en prosa inglesa y muchos más en código. - Elimina los duplicados. Calcula el hash del texto normalizado del fragmento; dos fragmentos con el mismo hash son el mismo pasaje, vengan de la URL que vengan. Los casi duplicados, como la misma página con una línea de «última actualización» distinta, necesitan una prueba de similitud sobre shingles de palabras o sobre los embeddings.
- Añade la procedencia. Cada fragmento lleva su URL, la hora de descarga, el título de la página, la ruta de la sección, el hash del contenido y el número de tokens. Sin esto no puedes citar, actualizar ni borrar.
- Genera los embeddings e indexa. Cada fragmento se convierte en un vector dentro de un índice vectorial; muchos equipos añaden un índice de palabras clave y fusionan las dos listas de resultados. El modelo y la base de datos que elijas no cambian los pasos anteriores.
- Actualiza. Guarda las cabeceras
ETagyLast-Modifiedy envíaIf-None-MatchoIf-Modified-Sincela próxima vez; un304 Not Modifiedno cuesta casi nada, y nuestra página de prueba envió ambas cabeceras. Usa las fechaslastmoddel sitemap para decidir qué revisar primero, reemplaza los fragmentos por URL y sección, y descarta los fragmentos de las páginas que ahora devuelven 404 o 410. - Evalúa la recuperación. Anota 30 o 50 preguntas reales con el pasaje que responde a cada una y mide con qué frecuencia el fragmento correcto aparece entre los primeros resultados. Ajusta el tamaño de fragmento, el solapamiento y el presupuesto contra esa cifra, no contra una sensación.
Un ejemplo probado: una página de HTML a fragmentos Markdown
El script ejecuta los primeros siete pasos en una página e imprime lo que encontró. Elegimos una página de la documentación de Python, cuyo robots.txt no permite /dev, /release ni versiones antiguas como /3.10/, pero sí /3/, comprobado el 9 de noviembre de 2026; el script lo vuelve a comprobar con urllib.robotparser antes de descargar.
python -m venv .venv
.venv/bin/pip install trafilatura tiktoken requests   # Windows: .venv\Scripts\pip
Dos detalles explican dos líneas del código. docs.python.org envía Content-Type: text/html sin juego de caracteres, así que resp.text de Requests decodificaría la página como ISO-8859-1 y cada encabezado terminaría en una  suelta; la página declara UTF-8 en su <meta charset>, así que el script decodifica los bytes por su cuenta. Y el generador de la documentación deja un calderón (¶) tras cada encabezado como enlace de ancla, que trafilatura conserva como texto, así que el paso de limpieza lo elimina. Un tercer detalle importa para la fragmentación: la página contiene 17 bloques de código delimitados cuyos comentarios de Python empiezan por # , de modo que un fragmentador que cortara en cada línea # partiría el código por dentro y trataría los comentarios como encabezados. El script mantiene entero cada bloque delimitado.
"""Descarga una página pública, conserva su contenido principal como Markdown, fragméntala por encabezados y cuenta los tokens."""
import hashlib, json, re, sys
from datetime import datetime, timezone
from urllib.parse import urlsplit
from urllib.robotparser import RobotFileParser
import requests
import tiktoken
import trafilatura

URL = sys.argv[1] if len(sys.argv) > 1 else "https://docs.python.org/3/howto/urllib2.html"
UA = "rag-prep-demo/1.0 (+https://example.com/bot)"
BUDGET = 512                                  # máximo de tokens por fragmento; las secciones más largas se dividen por párrafos
enc = tiktoken.get_encoding("o200k_base")     # el tokenizador de los modelos actuales de OpenAI
tokens = lambda s: len(enc.encode(s))

# 1. primero robots.txt: detente si la ruta no está permitida para nuestro user agent
robots = RobotFileParser(urlsplit(URL)._replace(path="/robots.txt", query="", fragment="").geturl())
robots.read()
if not robots.can_fetch(UA, URL):
    sys.exit(f"robots.txt disallows {URL}")

# 2. una descarga, tres vistas de la misma página: HTML en bruto, contenido principal como Markdown, texto plano
resp = requests.get(URL, headers={"User-Agent": UA}, timeout=30)
resp.raise_for_status()
html = resp.content.decode("utf-8")           # la página declara UTF-8; resp.text adivinaría ISO-8859-1
fetched_at = datetime.now(timezone.utc).isoformat(timespec="seconds")
md = trafilatura.extract(html, url=URL, output_format="markdown", include_tables=True, include_formatting=True)
md = md.replace("¶", "")                 # limpieza: Sphinx deja un calderón de ancla tras cada encabezado
txt = trafilatura.extract(html, url=URL, output_format="txt", include_tables=True)
title = trafilatura.extract_metadata(html, default_url=URL).title

# 3. dividir en bloques (párrafos, líneas de encabezado, bloques de código enteros), luego cortar por encabezados y por el presupuesto
blocks = []
for seg in re.split(r"(```[\s\S]*?```)", md.strip()):           # un bloque de código delimitado es un solo bloque, nunca se corta
    blocks += [seg] if seg.startswith("```") else [p.strip() for p in re.split(r"\n\s*\n|\n(?=#{1,6} )", seg) if p.strip()]
chunks, path, piece = [], [], ""
for block in blocks + ["# end"]:                                 # el encabezado centinela vacía el último fragmento
    head = re.match(r"(#{1,6}) (.+)", block)
    if head or (piece and tokens(piece + "\n\n" + block) > BUDGET):
        if piece:
            chunks.append((list(path), piece))                   # un encabezado sin texto debajo no añade ningún fragmento
        piece = "" if head else block
    else:
        piece = f"{piece}\n\n{block}".strip()
    if head:
        path = path[:len(head.group(1)) - 1] + [head.group(2).strip()]

# 4. procedencia: cada fragmento lleva de dónde viene, cuándo, y un hash para la deduplicación
records = [{"url": URL, "fetched_at": fetched_at, "title": title, "section": " > ".join(p[1:]) or "(top)",
            "content_hash": hashlib.sha256(text.encode()).hexdigest()[:16], "tokens": tokens(text), "text": text}
           for p, text in chunks]

print(f"page: {title}\nfetched: {fetched_at}")
print(f"tokens (o200k_base): html={tokens(html)}  markdown={tokens(md)}  text={tokens(txt)}")
sizes = sorted(r["tokens"] for r in records)
print(f"chunks: {len(records)}  min={sizes[0]}  median={sizes[len(sizes) // 2]}  max={sizes[-1]}  budget={BUDGET}")
print("\n".join(f"  {r['tokens']:>4} tok  {r['content_hash']}  {r['section'][:60]}" for r in records[:6]))
print(json.dumps({k: v for k, v in records[1].items() if k != "text"}, indent=2))
Imprimió:
page: HOWTO Fetch Internet Resources Using The urllib Package
fetched: 2026-11-09T12:32:13+00:00
tokens (o200k_base): html=21044  markdown=4405  text=4133
chunks: 19  min=10  median=183  max=495  budget=512
   276 tok  e21a9bc9bc9dc71b  Introduction
   460 tok  30fc2c8722d53c1a  Fetching URLs
   434 tok  51aca2bdee7780e4  Fetching URLs > Data
   144 tok  f8e6254387670d87  Fetching URLs > Data
   329 tok  3b49bcc1ef1326f3  Fetching URLs > Headers
    79 tok  3928e9cb23c19eee  Handling Exceptions
{
  "url": "https://docs.python.org/3/howto/urllib2.html",
  "fetched_at": "2026-11-09T12:32:13+00:00",
  "title": "HOWTO Fetch Internet Resources Using The urllib Package",
  "section": "Fetching URLs",
  "content_hash": "30fc2c8722d53c1a",
  "tokens": 460
}
La página se convirtió en 19 fragmentos con una mediana de 183 tokens, y ninguno superó el presupuesto de 512 tokens. «Fetching URLs > Data» aparece dos veces porque esa sección era más larga que el presupuesto y se cortó por un límite de párrafo en 434 y 144 tokens; las dos piezas comparten la ruta de sección pero tienen hashes distintos, que es lo que necesita un paso de deduplicación. El fragmento más pequeño tiene 10 tokens, la sección «Footnotes» de una sola frase de la página; un pipeline en producción lo fusionaría con su vecino. La barra lateral, los enlaces a la página anterior y siguiente y el pie de la página original no aparecen en el Markdown en absoluto, que es el extractor haciendo su trabajo. El registro JSON es la procedencia que viaja con el fragmento hasta el índice; muchos equipos también anteponen la ruta de sección al texto antes de generar el embedding.
¿Dónde encajan las API de scraping?
Una API de scraping encaja cuando el renderizado, la extracción y la cortesía con el sitio deben ser problema de otro. Muchas devuelven Markdown directamente, renderizan las páginas con JavaScript en un navegador y gestionan el ritmo de solicitudes por dominio, así que tu pipeline empieza en el paso de fragmentación. Cuatro comprobaciones te dicen si un servicio sirve para un corpus de RAG: descarga diez páginas que conozcas y busca menús en el Markdown y tablas que hayan llegado enteras; asegúrate de que el título, la URL canónica y, si existe, la fecha de última modificación vienen con el contenido, porque se convierten en procedencia; descarga dos veces la misma página sin cambios y compara la salida, o tus hashes marcarán todas las páginas como modificadas; y pregunta cómo trata el servicio el robots.txt y los límites de solicitudes, porque las solicitudes se hacen en tu nombre.
¿Dónde encaja un proxy?
Un proxy encaja aquí en dos situaciones, y ninguna consiste en descargar más rápido de un solo sitio. La primera es la amplitud: un corpus de RAG suele abarcar cientos de dominios, y un rastreador (crawler) que respeta el ritmo de cada dominio puede, aun así, recorrer muchos dominios a la vez. Repartir esas descargas entre más de una dirección de salida, por ejemplo a través de Proxies rotativos, hace que cada dominio siga viendo un cliente lento y educado mientras el trabajo completo termina en horas en lugar de días.
La segunda es la ubicación. Las páginas de documentación, ayuda y precios a menudo cambian según el país o el idioma del visitante, y un índice construido a partir de la versión equivocada responde a los usuarios con contenido que nunca ven. Descargar desde el país en el que están tus usuarios, con Proxies residenciales y segmentación por país, indexa la página que de verdad van a leer. El robots.txt, los términos y el ritmo no cambian, salga la solicitud desde la dirección que salga.
Errores comunes
- Fragmentar por número de caracteres sin respetar los encabezados. Una ventana de 1.000 caracteres que abarca dos secciones no responde a ninguna de las dos preguntas. Corta por los encabezados y después por los párrafos.
- Indexar contenido repetitivo (boilerplate). Los avisos de cookies, los menús y los pies de página se convierten en fragmentos que coinciden un poco con todo y bien con nada.
- Sin procedencia. Sin URL, hora de descarga y sección no puedes citar una fuente, actualizar una página modificada ni retirar una que fue eliminada.
- No actualizar nunca. Un corpus construido una vez es una instantánea; las solicitudes condicionales con
ETagyLast-Modifiedhacen que una actualización semanal salga barata. - Generar embeddings de la misma página varias veces. Los parámetros de seguimiento, las vistas de impresión y las barras finales crean copias que llenan los primeros resultados; calcula el hash del contenido, no de la URL.
- Contar caracteres en lugar de tokens, o contar con un tokenizador distinto del que usa el modelo de embeddings.
- Cortar dentro de bloques de código y tablas. Un comentario
#dentro del código no es un encabezado, y media tabla no responde a nada. - Indexar una página vacía. Si el contenido se construye con JavaScript, el HTML descargado no tiene artículo; comprueba el número de tokens extraídos antes de indexar.
- Descargar lo que el robots.txt o los términos excluyen, o más rápido de lo que leería una persona. La situación legal (ver la última pregunta frecuente) no mejora con el volumen.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Unos cientos de páginas de documentación | trafilatura a Markdown, fragmentos por encabezado de 200 a 500 tokens, actualización semanal |
| Páginas que se renderizan con JavaScript | Un extractor basado en navegador como Crawl4AI, o una API de scraping que devuelva Markdown |
| El sitio ofrece versiones Markdown o llms.txt | Descarga los gemelos .md y sáltate la extracción |
| Las respuestas deben citar su fuente | Procedencia en cada fragmento: URL, hora de descarga, título, ruta de sección, hash |
| El mismo pasaje aparece una y otra vez en los resultados | Hashes de contenido, normalización de URL, una prueba de casi duplicados |
| Cientos de dominios a un ritmo prudente cada uno | Dominios en paralelo por varias salidas con un proxy rotativo |
| Documentación o precios específicos de un país | Un proxy residencial con segmentación por país |
| Ningún equipo para operar el pipeline | Una API de scraping gestionada que entregue Markdown con metadatos |
Preguntas frecuentes
¿Qué significa RAG y en qué se diferencia del ajuste fino?
RAG significa retrieval-augmented generation, generación aumentada por recuperación: el modelo responde a partir de pasajes recuperados en el momento de la pregunta. El ajuste fino (fine-tuning) cambia los pesos del modelo con datos de entrenamiento, así que la información nueva necesita otra ronda de entrenamiento y el modelo no puede decir de qué documento salió una respuesta. RAG se actualiza reindexando una página y puede citar la URL y la sección que usó.
¿Por qué Markdown es mejor que HTML para los LLM?
Markdown conserva la estructura que importa, como encabezados, listas, tablas y código, en pocos caracteres, mientras que el HTML gasta la mayoría de sus tokens en etiquetas, atributos y scripts. En nuestra página de prueba, el Markdown tenía 4.405 tokens frente a los 21.044 del HTML, y los fragmentos aún se podían cortar por los encabezados.
¿Cuál es el tamaño ideal de fragmento para RAG?
No hay una cifra única; un rango que funciona para documentación es de 200 a 500 tokens con cortes en los encabezados, y el valor correcto es el que mejor puntúa en tu propia prueba de recuperación. Los fragmentos más pequeños coinciden con más precisión pero pierden contexto; los más grandes aportan contexto pero diluyen la coincidencia.
¿Cada cuánto debo volver a rastrear las páginas para RAG?
Tan a menudo como cambien las páginas, y eso te lo dicen barato las solicitudes condicionales: envía el valor guardado de ETag o Last-Modified, y una respuesta 304 Not Modified significa que nada cambió. A la documentación le suele bastar una vez por semana, las páginas de precios y de estado piden una vez al día, y las fechas lastmod del sitemap indican dónde mirar primero.
¿llms.txt sustituye al scraping?
No. llms.txt es un índice seleccionado de las páginas importantes de un sitio para las herramientas de IA, y la misma propuesta pide a los sitios ofrecer versiones Markdown de sus páginas; donde existen las dos cosas, descarga el Markdown y sáltate la extracción. La mayoría de los sitios no publica ninguna de las dos, y el archivo no controla nada del acceso, como explica nuestra guía de llms.txt, así que el robots.txt y los términos siguen decidiendo qué puedes descargar.
¿Es legal usar páginas web extraídas con scraping en RAG?
Depende del sitio y de la jurisdicción, y esto es una descripción, no asesoramiento legal. Normalmente se examinan cuatro cosas: el robots.txt, que el RFC 9309 describe como una petición a los rastreadores y no como una autorización de acceso; los términos de uso del sitio, que a menudo prohíben el acceso automatizado; los derechos de autor, que afectan a la reproducción de texto y dependen de cuánto de una página repite una respuesta y de si la atribuye; y los datos personales de las páginas, que regulan el RGPD y la KVKK de Türkiye y que un corpus de RAG no debería recopilar en absoluto. La procedencia en cada fragmento te permite retirar una fuente cuando te lo pidan. Consulta a un abogado antes de construir un corpus a partir de sitios de terceros.
En resumen
RAG responde a partir de pasajes recuperados, así que la calidad de las respuestas la fija la calidad de los pasajes. Para las fuentes web eso significa descargar solo lo permitido, extraer el contenido principal, convertirlo a Markdown en lugar de a HTML o texto plano, fragmentar por los encabezados dentro de un presupuesto de tokens, añadir la procedencia, eliminar los duplicados y actualizar con solicitudes condicionales. En nuestra página de prueba, ese pipeline convirtió 21.044 tokens de HTML en 19 fragmentos limpios a partir de un Markdown de 4.405 tokens, con un script lo bastante corto como para leerlo de una sentada. Si prefieres recibir Markdown en lugar de construir el pipeline, nuestra Web Scraping API, un servicio gestionado de extracción de páginas disponible a través del equipo de ventas, se describe en la página de extracción de datos.