A documentação da API de uma transportadora mostra como criar um envio com um comando cURL: curl -X POST https://api.example.com/v1/shipments -H "Authorization: Bearer TOKEN" -H "Content-Type: application/json" -d '{"recipient": "Ayse Demir", "weight_kg": 3}'. No terminal, a resposta é 201 Created. Você passa o comando para o Python como requests.post(url, data=json.dumps(body), headers={"Authorization": ...}), e o servidor responde 415 Unsupported Media Type: com uma string em data=, o Requests não envia Content-Type, e a linha que definia esse cabeçalho ficou no comando cURL.
Este guia trata de json=, data= e files=, dos parâmetros de consulta, dos cabeçalhos e tokens Bearer, da leitura da resposta e do argumento do Requests para cada opção comum do cURL. No final há uma lista de verificação para requisições que funcionam no cURL mas não no Python, e um pequeno cliente de API que tenta de novo com segurança. Todos os exemplos rodaram no Python 3.13.9, Requests 2.34.2 e curl 8.21.0 (Windows 11), contra o httpbin.org e um servidor local que devolve os bytes que recebe.
Como enviar uma requisição POST com o Python Requests?
Instale o pacote com pip install requests. O PyPI lista a 2.34.2, lançada em 14 de maio de 2026, como versão atual; ela exige Python 3.10 ou mais recente. A escolha entre bibliotecas está em Comparativo entre HTTPX, Requests e AIOHTTP.
Um POST com corpo JSON é uma única chamada. O httpbin.org/post devolve o que recebeu:
import requests

payload = {"recipient": "Ayse Demir", "weight_kg": 3}
r = requests.post("https://httpbin.org/post", json=payload, timeout=20)

print(r.status_code)                         # 200
print(r.json()["headers"]["Content-Type"])   # application/json
print(r.json()["data"])                      # {"recipient": "Ayse Demir", "weight_kg": 3}
print(r.json()["json"])                      # o mesmo corpo, convertido de volta em dict
O campo data é o corpo como foi enviado, com um espaço depois de cada dois-pontos e de cada vírgula. requests.put(), requests.patch() e requests.delete() aceitam os mesmos argumentos. Passe sempre timeout: o Requests não tem valor padrão, então um servidor que não responde deixa o script esperando (Max Retries Exceeded With URL trata dos erros de tempo limite).
Qual é a diferença entre json=, data= e files=?
Cada argumento monta o corpo de um jeito e define um Content-Type diferente. Enviamos o mesmo dict de quatro formas:
import json
import requests

url = "https://httpbin.org/post"
body = {"recipient": "Ayse Demir", "weight_kg": 3}

for label, kwargs in [
    ("json=body", {"json": body}),
    ("data=body", {"data": body}),
    ("data=json.dumps(body)", {"data": json.dumps(body)}),
    ("json= and data=", {"json": body, "data": {"note": "x"}}),
]:
    echo = requests.post(url, timeout=20, **kwargs).json()
print(f"{label:22} {echo['headers'].get('Content-Type')!s:34} form={echo['form']} json={echo['json']}")json=body application/json form={} json={'recipient': 'Ayse Demir', 'weight_kg': 3}
data=body application/x-www-form-urlencoded form={'recipient': 'Ayse Demir', 'weight_kg': '3'} json=None
data=json.dumps(body) None form={} json={'recipient': 'Ayse Demir', 'weight_kg': 3}
json= and data= application/x-www-form-urlencoded form={'note': 'x'} json=NoneO que as quatro linhas mostram:
json=serializa o dict e defineContent-Type: application/json. Use para APIs JSON.data=com um dict envia um formulário, e todo valor vira texto:weight_kgchegou como'3'.data=com uma string não enviaContent-Type. O httpbin interpretou o corpo mesmo assim; uma API rigorosa responde415ou400. Defina o cabeçalho você mesmo.json=junto comdata=oufiles=perde o JSON sem nenhum erro. O guia rápido do Requests diz que o parâmetrojsoné ignorado quandodataoufilesé passado.
Envie texto JSON por data= só quando os bytes exatos importam. Uma API que assina o corpo com HMAC confere os bytes que recebe, e json= acrescenta espaços e escapa caracteres não ASCII ("İzmir" sai como "\u0130zmir"). Monte os bytes você mesmo:
import json
import requests

body = {"recipient": "Ayse Demir", "city": "İzmir", "weight_kg": 3}
raw = json.dumps(body, separators=(",", ":"), ensure_ascii=False).encode("utf-8")

r = requests.post("https://httpbin.org/post", data=raw,
                  headers={"Content-Type": "application/json"}, timeout=20)
print(r.json()["data"])  # {"recipient":"Ayse Demir","city":"İzmir","weight_kg":3}
Esses bytes tiveram o mesmo hash SHA-256 do corpo que curl --data-binary @body.json enviou a partir do mesmo arquivo UTF-8. Logins por formulário com tokens CSRF estão em Sessões e cookies em Python, e files= mais abaixo.
Como converter um comando cURL para o Requests, passo a passo?
A mesma requisição, copiada na aba Rede (Network) do navegador enquanto você usa o painel web da transportadora, tem algumas linhas a mais. Como encontrar uma requisição assim está em Páginas estáticas e dinâmicas no web scraping.
curl -X POST "https://api.example.com/v1/shipments?notify=false" \
  -H "Authorization: Bearer TOKEN" \
  -H "Content-Type: application/json" \
  -H "Accept-Encoding: gzip, deflate, br" \
  -H "Cookie: session=abc123" \
--data-raw '{"recipient": "Ayse Demir", "weight_kg": 3}'- Desfaça a sintaxe do shell. Remova as quebras de linha com
\(^numa cópia feita para ocmddo Windows) e as aspas. - Leve a query string para
params=.?notify=falseviraparams={"notify": "false"}. - Filtre os cabeçalhos. Mantenha o que a API precisa:
Authorization,Accept, chaves de API. TireAccept-Encoding, que o Requests trata sozinho, eContent-Typequando usarjson=. Nunca copieHostnemContent-Length; o Requests calcula os dois. Linhas do navegador comosec-fetch-*raramente são necessárias, e uma linhaCookievai paracookies=ou para umaSession. - Escolha o argumento do corpo. JSON vira
json=(oudata=com bytes exatos, se o corpo for assinado),-d "a=1&b=2"viradata={"a": "1", "b": "2"}, e-Fvirafiles=. - Escolha o método.
-d,--data-raw,--jsone-Fsignificam POST, a menos que-Xdiga outra coisa;-Gtransforma a requisição em uma consulta GET. - Adicione um
timeout=e chamer.raise_for_status(). - Compare. Envie o comando cURL e a sua chamada Python para
https://httpbin.org/anythinge compare o método, a URL, os cabeçalhos e o corpo devolvidos.
O resultado, com o token lido de uma variável de ambiente:
import os
import requests

r = requests.post(
    "https://api.example.com/v1/shipments",
    params={"notify": "false"},
    headers={"Authorization": f"Bearer {os.environ['API_TOKEN']}"},
    json={"recipient": "Ayse Demir", "weight_kg": 3},
    timeout=20,
)
r.raise_for_status()
print(r.status_code, r.headers.get("Location"))
O curlconverter faz os passos 1 a 5 e tem o Python Requests como saída padrão. Instale com npm e troque curl por curlconverter no comando. Para o comando acima, a versão 4.12.0 levou notify para params, o cookie para cookies= e o corpo para json=, e deixou Content-Type e Accept-Encoding comentados. Não acrescentou tempo limite, e o README avisa que o código gerado segue redirecionamentos, a menos que o comando defina uma política de redirecionamento. Um comando copiado do navegador contém o seu cookie de sessão ativo e o seu token, então converta na sua máquina, não em um site.
Qual argumento do Requests corresponde a cada opção do cURL?
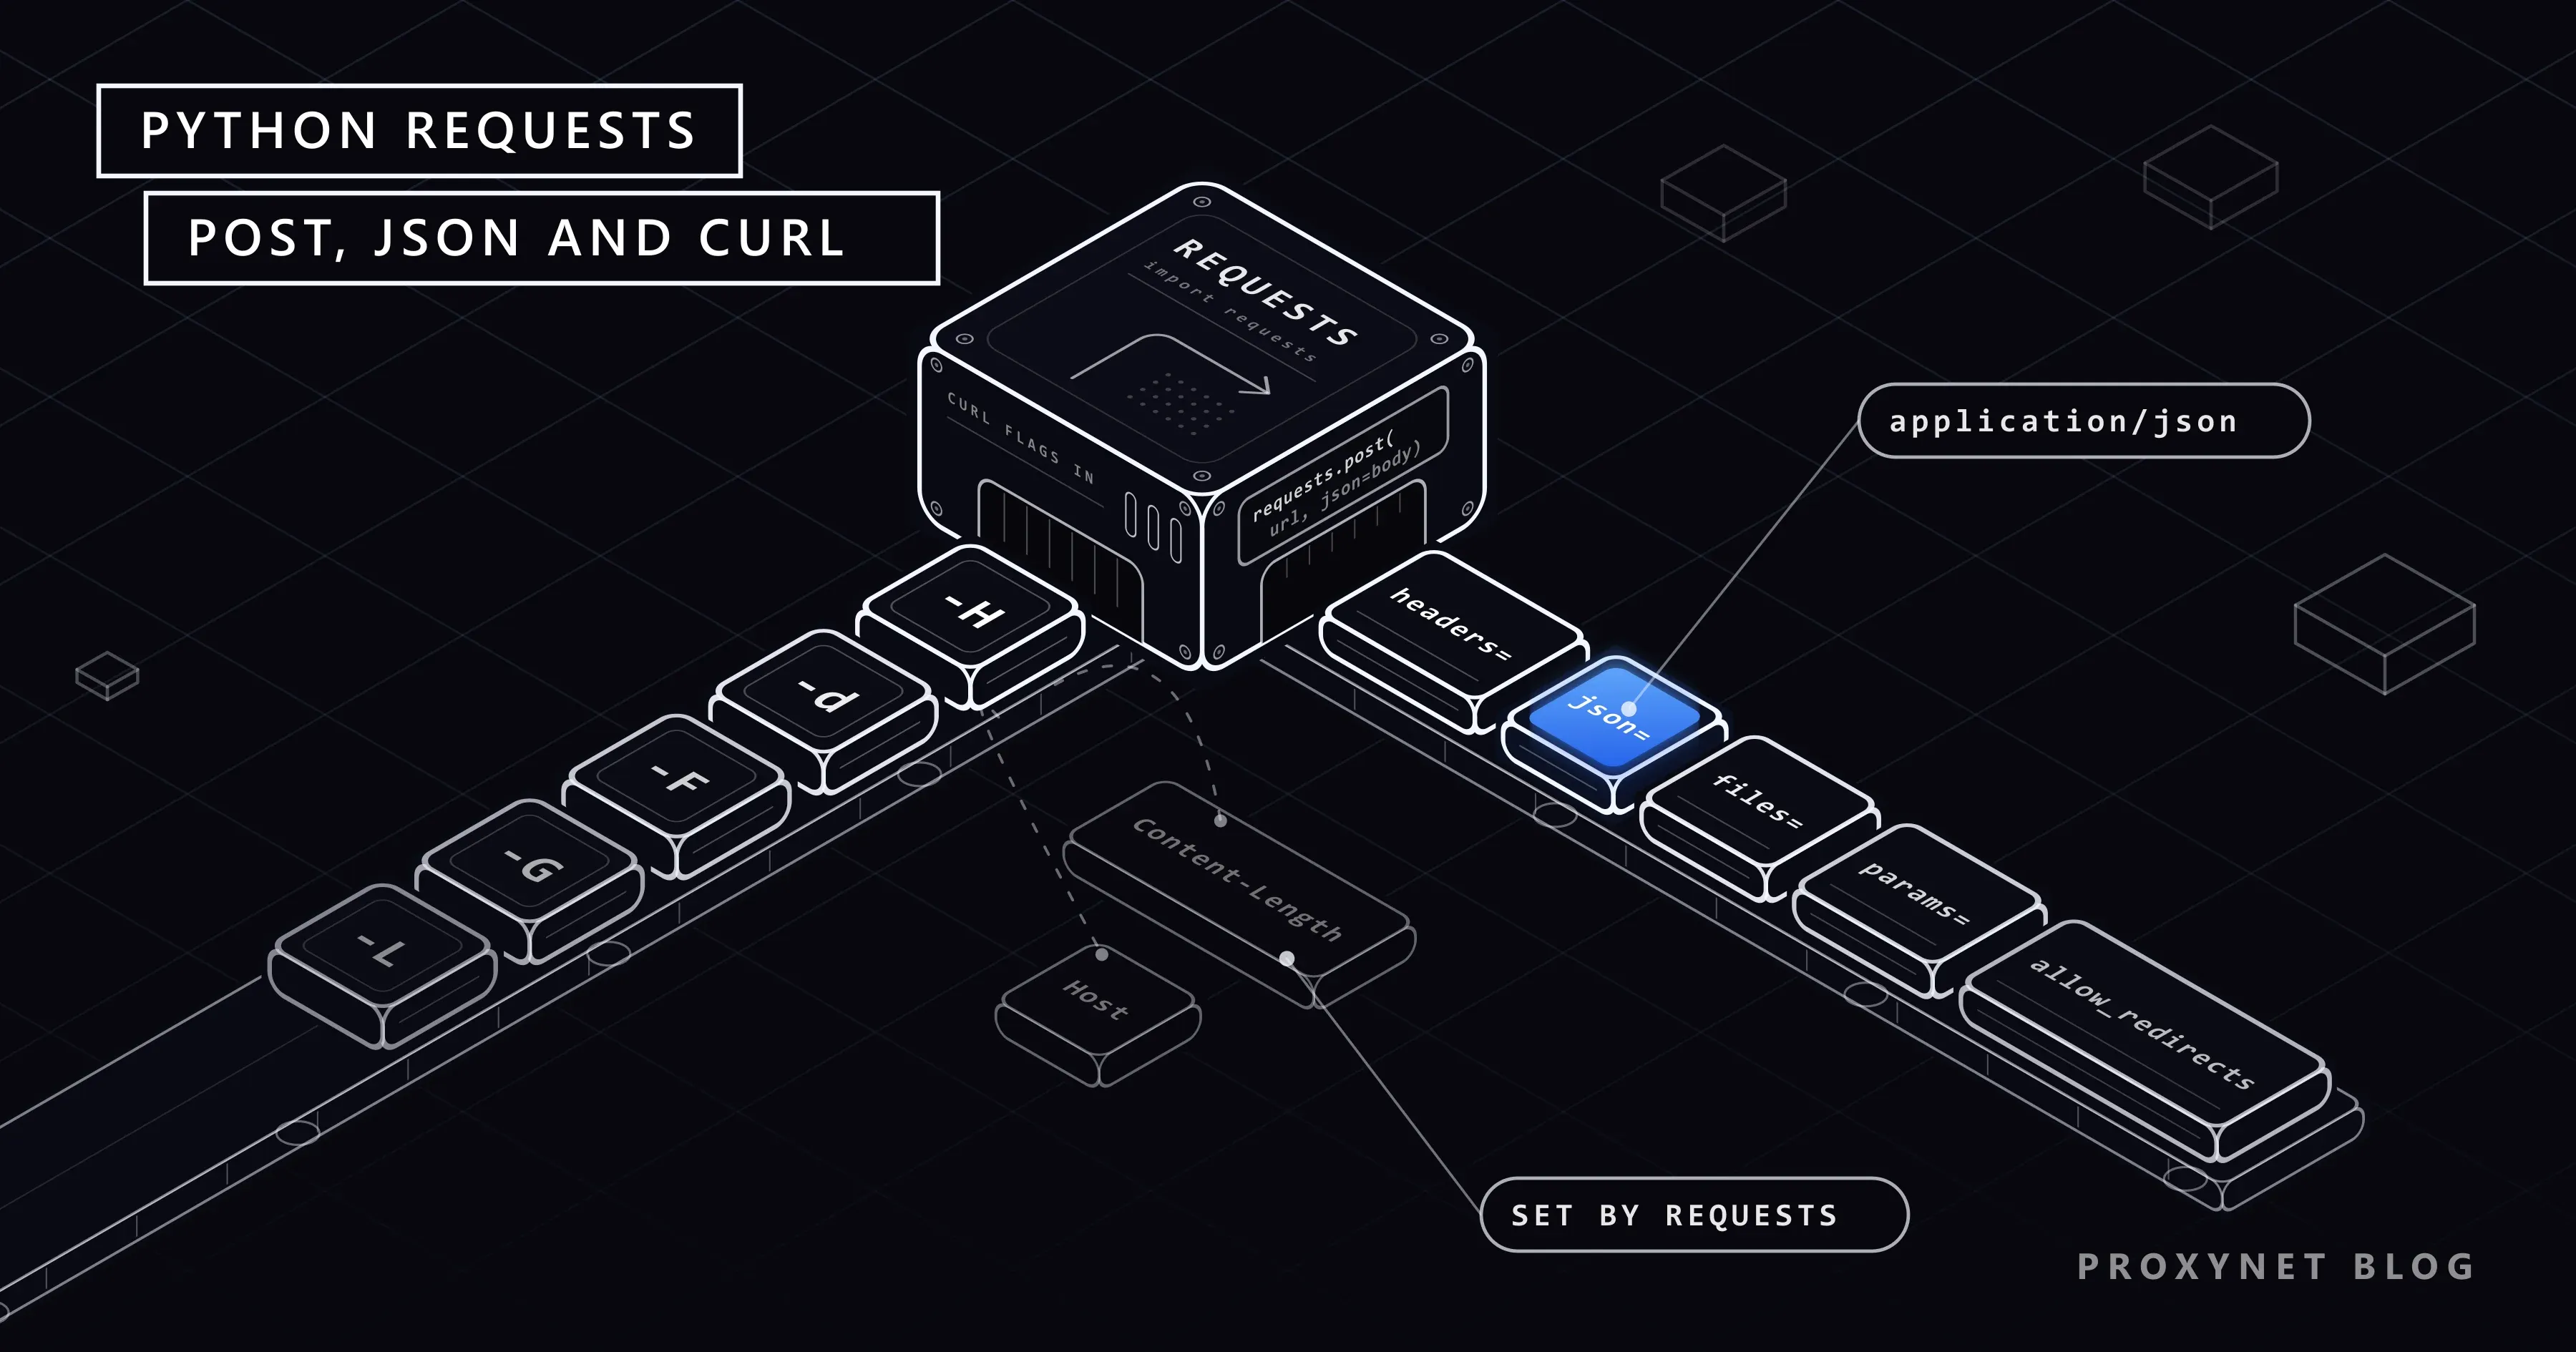
| Opção do cURL | Requests | O que muda |
|---|---|---|
-d '{"a":1}' com Content-Type: application/json | json={"a": 1} | O Requests acrescenta espaços; use data= para bytes exatos |
--json '{"a":1}' | json={"a": 1}, headers={"Accept": "application/json"} | --json (curl 7.82.0+) também define Accept |
-d "a=1&b=2" | data={"a": "1", "b": "2"} | Mesmos bytes |
--data-binary @body.json | data=open("body.json", "rb") | -d @file removeria as quebras de linha; estes dois as mantêm |
-F "file=@report.csv" | files={"file": open("report.csv", "rb")} | O curl marca a parte como application/octet-stream; o Requests só acrescenta um tipo a partir de uma tupla de 3 itens |
-G --data-urlencode "q=kargo takip" | params={"q": "kargo takip"} | Mesma consulta: ?q=kargo+takip |
-X PUT | requests.put(url, ...) | O mesmo vale para PATCH e DELETE |
-H "Name: value" | headers={"Name": "value"} | Os valores precisam ser strings; um int gera InvalidHeader |
-A "ShipmentSync/1.0" | headers={"User-Agent": "ShipmentSync/1.0"} | Sem isso, cada ferramenta envia o próprio nome |
-b "session=abc123" | cookies={"session": "abc123"} | Mesmo cabeçalho Cookie |
-u user:pass | auth=("user", "pass") | Mesmo cabeçalho Basic |
-L | Padrão | O cURL precisa de -L; allow_redirects=False desliga isso no Requests |
--max-redirs 5 | session.max_redirects = 5 | Padrão do Requests: 30 |
--connect-timeout 3 -m 20 | timeout=(3.05, 20) | -m limita a transferência inteira; o tempo limite de leitura é o intervalo entre bytes |
-k / --cacert ca.pem | verify=False / verify="ca.pem" | verify=False só em testes locais |
-x http://user:pass@pr.proxynet.io:8000 | proxies={"http": url, "https": url} | Veja cURL com proxy |
--compressed | Nada | O Requests trata a compressão sozinho |
-I | requests.head(url) | O HEAD não segue redirecionamentos |
-i / -v | r.headers / r.request.headers | O que foi recebido e o que foi enviado |
Cada opção está descrita no manual do curl. Usar um proxy novo a cada requisição é outra tarefa (Como rotacionar proxies em Python).
Como passar parâmetros de consulta e cabeçalhos?
Passe os valores de consulta para params= como um dict:
import requests

params = {"q": "kargo takip", "status": ["pending", "shipped"], "sort": None}
r = requests.get("https://httpbin.org/get", params=params, timeout=20)
print(r.url)  # https://httpbin.org/get?q=kargo+takip&status=pending&status=shipped
Uma lista repete a chave, None fica de fora, e espaços e caracteres não ASCII são codificados para você. Uma query string que já esteja na URL permanece, e params= é acrescentado depois dela. Como percorrer páginas de resultados é explicado em paginação no web scraping.
Os cabeçalhos vão num dict de strings, com o token lido do ambiente:
import os
import requests

headers = {
    "Authorization": f"Bearer {os.environ['API_TOKEN']}",
    "Accept": "application/json",
}
r = requests.get("https://httpbin.org/headers", headers=headers, timeout=20)
print(r.json()["headers"]["Authorization"])  # Bearer <seu token>

r = requests.get("https://httpbin.org/basic-auth/user/pass", auth=("user", "pass"), timeout=20)
print(r.status_code)  # 200
Os cabeçalhos que toda chamada precisa ficam uma vez só numa requests.Session, em session.headers. Três regras da documentação do Requests, todas confirmadas nos nossos testes:
- O
.netrcvenceheaders=. Uma entrada do.netrcpara o host substituiu o nosso cabeçalhoBearerpor umBasic;auth=vence os dois. - O cabeçalho Authorization fica no host original. Depois de um redirecionamento de
127.0.0.1paralocalhost, o cabeçalho tinha sumido. - Os valores são strings.
headers={"X-Page": 2}gerouInvalidHeader.
Sem um User-Agent próprio, o Requests envia python-requests/2.34.2. O que colocar ali está em O que é User-Agent?, e por que os cabeçalhos de um mesmo cliente devem ser coerentes entre si, em Como fazer web scraping sem ser bloqueado.
Como ler a resposta e capturar erros HTTP?
Um Response oferece r.status_code, r.headers (um dict que não diferencia maiúsculas de minúsculas), r.content (bytes brutos), r.text (os bytes decodificados com r.encoding) e r.json(). Caracteres quebrados em r.text indicam um palpite errado de codificação (Erros de codificação no Python).
A documentação do Requests avisa que um r.json() bem-sucedido não significa uma requisição bem-sucedida: um servidor pode enviar um corpo de erro em JSON junto com um 500. Confira o status primeiro:
import requests

r = requests.get("https://httpbin.org/status/404", timeout=20)
try:
    r.raise_for_status()
except requests.HTTPError as exc:
    print(exc)  # 404 Client Error: NOT FOUND for url: https://httpbin.org/status/404
raise_for_status() gera HTTPError para qualquer 4xx ou 5xx. Quando o corpo está vazio ou é HTML, r.json() falha com JSONDecodeError (JSONDecodeError: Expecting Value lista as causas). Os códigos que vale a pena tentar de novo estão em Códigos de status HTTP no web scraping.
Como enviar e baixar arquivos com o Requests?
files= monta um corpo multipart/form-data. Uma tupla de 3 itens define o nome do arquivo e o tipo da parte, e os campos de data= viajam como partes extras. Como json= é ignorado ao lado de files=, envie o JSON como uma parte própria:
import json
import requests

with open("report.csv", "rb") as f:
    files = {
        "file": ("report.csv", f, "text/csv"),
        "meta": (None, json.dumps({"source": "warehouse"}), "application/json"),
    }
    r = requests.post("https://httpbin.org/post", files=files, data={"note": "daily"}, timeout=20)

print(r.json()["files"])  # {'file': 'sku,price\n1001,19.90\n'}
print(r.json()["form"])   # {'meta': '{"source": "warehouse"}', 'note': 'daily'}
Abra o arquivo em modo binário ("rb"): a documentação explica que o Requests pode definir Content-Length pelo número de bytes do arquivo, e o modo texto pode deixar esse valor errado. Para uploads muito grandes, a mesma página indica o pacote requests-toolbelt, que envia o corpo em streaming.
Para downloads, stream=True mantém um corpo grande fora da memória:
import requests

url = "https://example.com/export.csv"  # troque pela URL do seu arquivo
with requests.get(url, stream=True, timeout=(3.05, 60)) as r:
    r.raise_for_status()
    with open("export.csv", "wb") as f:
        for chunk in r.iter_content(chunk_size=64 * 1024):
            f.write(chunk)
O download de muitos arquivos de uma mesma página é explicado em Como baixar todas as imagens de um site.
Por que uma requisição que funciona no cURL recebe outra resposta no Requests?
Em geral, as duas requisições não são iguais. Confira nesta ordem:
- Redirecionamentos. O cURL para em um
3xxsem-L; o Requests segue o redirecionamento em todo método, excetoHEAD. Quando qualquer uma das ferramentas segue, um POST respondido com301,302ou303vira um GET sem corpo, e307ou308mantêm o POST, conforme a RFC 9110. Uma exceção: com-X POSTe-L, o cURL enviou um POST sem corpo depois de um302;--follow(curl 8.16.0+) muda para GET. Olher.history, ou passeallow_redirects=Falsee leiaLocation. - Cabeçalhos padrão. O curl 8.21.0 enviou
User-Agent: curl/8.21.0,Accept: */*e nenhumAccept-Encoding. O Requests envioupython-requests/2.34.2,Accept: */*,Connection: keep-aliveeAccept-Encoding: gzip, deflate(maisbrcom o brotli instalado, ezstdno Python 3.14). Compare comr.request.headers. - Versão do HTTP. O Requests fala só HTTP/1.1:
r.raw.versiondevolveu11para um site HTTPS. O curl negocia HTTP/2 para HTTPS por padrão quando a sua build tem suporte (curl -VlistaHTTP2), e-w "%{http_version}"mostra a versão usada. A nossa build do Windows não tem esse suporte e usou1.1. - Ambiente. Com
Session.trust_envno padrãoTrue, o Requests lêHTTP_PROXY,HTTPS_PROXYeNO_PROXY, as configurações de proxy do sistema no Windows e no macOS quando nenhuma variável está definida, e o.netrc. O cURL lê as variáveis (http_proxysó em minúsculas), mas não as configurações do sistema, e só lê o.netrccom--netrc.requests.utils.get_environ_proxies(url)mostra o que o Requests escolheu; as variáveis são explicadas em Uso de proxy com o wget. - Certificados. O Requests usa o pacote de certificados
certifi; o curl no Windows com Schannel usa o repositório de certificados do Windows. Atrás de um proxy corporativo que inspeciona o TLS, o cURL pode passar enquanto o Requests geraSSLError(a correção está em Max Retries Exceeded With URL). - Bytes do corpo.
json=serializa o corpo de novo, e-d @fileremove as quebras de linha. Calcule o hash dos dois corpos se a API os assinar. - O que passa pela rede. Um proxy MITM local mostra as duas requisições lado a lado.
Se tudo coincide e a resposta continua diferente, o site está avaliando o próprio cliente, por exemplo o handshake TLS, que os cabeçalhos não mudam. Cloudflare scraper explica como ler uma resposta assim, e O que é fingerprint TLS e como funciona o JA3?, o que o handshake revela. O caminho é a API oficial do site ou a permissão do dono; não tratamos de ferramentas que disfarçam um script de navegador.
Exemplo completo: um pequeno cliente de API com novas tentativas seguras
O script mantém o token Bearer e os cabeçalhos comuns numa única Session, envia params= com um GET e json= com um POST, e confere cada status. Ele só tenta de novo o GET: o MDN descreve o POST como não idempotente, então uma repetição pode criar um segundo envio. A classe Retry do urllib3 já deixa o POST de fora por padrão; o script deixa isso explícito.
"""Um pequeno cliente de API: GET com params, POST com json=, novas tentativas só no GET."""
import os

import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

API = os.environ.get("API_BASE", "https://api.example.com/v1")
TIMEOUT = (3.05, 20)  # tempo limite de conexão, tempo limite de leitura (segundos)


def make_session():
    session = requests.Session()
    session.headers.update({
        "Authorization": f"Bearer {os.environ['API_TOKEN']}",  # nunca deixe o token fixo no código
        "Accept": "application/json",
        "User-Agent": "ShipmentSync/1.0 (+https://example.com/contact)",
    })
    retry = Retry(
        total=3,
        backoff_factor=0.5,
        status_forcelist=[502, 503, 504],
        allowed_methods=["GET"],  # um POST repetido pode criar o mesmo envio duas vezes
        raise_on_status=False,    # devolve a última resposta; raise_for_status() informa o erro
    )
    adapter = HTTPAdapter(max_retries=retry)
    session.mount("https://", adapter)
    session.mount("http://", adapter)
    proxy = os.environ.get("PROXY_URL")  # opcional, ex.: http://user:pass@pr.proxynet.io:8000
    if proxy:
        session.proxies = {"http": proxy, "https": proxy}
        session.trust_env = False  # senão HTTPS_PROXY ou o proxy do sistema vence session.proxies
    return session


def list_shipments(session, status="pending", page=1):
    r = session.get(f"{API}/shipments", params={"status": status, "page": page}, timeout=TIMEOUT)
    r.raise_for_status()
    return r.json()


def create_shipment(session, recipient, weight_kg):
    body = {"recipient": recipient, "weight_kg": weight_kg}
    r = session.post(f"{API}/shipments", json=body, timeout=TIMEOUT)
    r.raise_for_status()
    return r.status_code, r.headers.get("Location"), r.json()


if __name__ == "__main__":
    with make_session() as s:
        try:
            print(list_shipments(s))
            print(create_shipment(s, "Ayse Demir", 3))
        except requests.HTTPError as exc:
            print("API error:", exc)
Contra um servidor local que imita a API, o GET devolveu a lista e o POST devolveu 201 com um cabeçalho Location. Quando o servidor respondeu 503, o GET saiu quatro vezes (com esperas de 0, 1 e 2 segundos entre as tentativas) antes de raise_for_status() informar o erro; um POST para o mesmo endereço saiu uma vez só. Por um proxy de teste local definido em PROXY_URL, as duas chamadas funcionaram, e uma senha errada deu 407 Proxy Authentication Required.
O urllib3 também respeita Retry-After em um 503 por padrão; o tratamento do 429 está em Códigos de status HTTP no web scraping, e muitas chamadas em paralelo, em Concorrência e paralelismo no web scraping.
Casos de uso
- Dados de produtos ou de preços de uma API que o próprio site oferece (extração de dados).
- Um endpoint JSON encontrado na aba Rede, chamado em vez de renderizar a página (Páginas estáticas e dinâmicas).
- Rastrear as páginas por trás dos resultados de uma API num ritmo educado (crawler em Python).
- Testar o seu próprio webhook ou serviço interno a partir de um script, e não de uma ferramenta gráfica (Postman com proxy).
- Conferir a resposta de uma API em outro país por meio de um Proxies residenciais de lá.
- Uma API que só aceita endereços IP cadastrados, chamada a partir de uma saída fixa (IP estático para API).
- A mesma requisição no Node.js com fetch ou Axios (cURL em JavaScript).
Erros comuns
data=json.dumps(body)semContent-Type. O servidor não tem como saber que é JSON; usejson=body.json=edata=na mesma chamada. O JSON é descartado sem aviso.- Nenhum
timeout. Um servidor que não responde trava o script. - Montar a query string à mão. Espaços e caracteres não ASCII quebram a URL.
r.json()antes de conferir o status. Um500com corpo de erro em JSON é lido sem problema.- Uploads abertos em modo texto. Use
"rb". - Copiar
HosteContent-Length. O Requests enviou oHostcopiado sem alteração, então um teste contra outro servidor ainda indicava o antigo. UmContent-Lengthcopiado num GET sem corpo fez o nosso servidor esperar até o tempo limite de leitura. - Colar comandos do navegador em conversores online. Eles contêm o seu cookie de sessão e o seu token.
verify=Falseem produção. Isso desliga a verificação de certificados.- Repetir POST às cegas. Uma nova tentativa depois de um tempo limite esgotado pode criar um segundo registro.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Corpo JSON para uma API | requests.post(url, json=data, timeout=20), sem Content-Type manual |
| Corpo assinado, byte a byte | data= com bytes que você serializou, mais Content-Type |
| Formulário simples (não um login) | data= com um dict; logins e CSRF no guia de sessões |
| Arquivo com campos extras | files= mais data=; JSON como parte própria application/json |
| Conversão rápida de cURL | A tabela acima, ou o curlconverter na sua máquina |
| Funciona no cURL, mas não no Python | Confira r.history, r.request.headers, trust_env e a versão do HTTP |
| HTTP/2 ou chamadas assíncronas | HTTPX; AIOHTTP só para código assíncrono |
Perguntas frequentes
Preciso definir o cabeçalho Content-Type ao enviar JSON com o Requests?
Não com json=: o Requests define Content-Type: application/json sozinho. Você precisa dele quando passa texto JSON por data=, porque uma string em data= sai sem esse cabeçalho, e uma API rigorosa então responde 415 Unsupported Media Type ou 400.
Qual é a diferença entre json= e data=json.dumps() no Requests?
Os dois enviam texto JSON, mas só json= acrescenta o cabeçalho Content-Type. Os bytes também podem ser diferentes: json= coloca espaços depois de dois-pontos e vírgulas e escapa caracteres não ASCII. Use json= por padrão, e data= com os seus próprios bytes quando uma API assina o corpo.
Como enviar um token Bearer com o Python Requests?
Use headers={"Authorization": f"Bearer {token}"}, ou defina o cabeçalho uma vez em session.headers. Leia o token de uma variável de ambiente. Se um arquivo .netrc tiver credenciais para o mesmo host, o Requests usa essas credenciais no lugar do token; Session.trust_env = False desliga esse comportamento.
É possível converter um comando cURL para Python automaticamente?
Sim. O curlconverter transforma um comando cURL em código Requests e roda na sua própria máquina. Revise a saída: ele não acrescenta tempo limite, e o Requests segue redirecionamentos que o comando cURL não seguia. Mantenha comandos com cookies ou tokens longe de conversores online.
O Requests segue redirecionamentos, e por que o meu POST vira GET?
O Requests segue redirecionamentos em todo método, exceto HEAD. Depois de um 301, 302 ou 303, um POST vira GET e perde o corpo, como nos navegadores; depois de um 307 ou 308, continua sendo POST. allow_redirects=False para na primeira resposta.
O Python Requests tem suporte a HTTP/2?
Não. O Requests fala só HTTP/1.1; no nosso teste, r.raw.version devolveu 11 para um site HTTPS. O HTTPX tem suporte a HTTP/2 quando você instala httpx[http2] e cria o cliente com http2=True; o recurso vem desligado por padrão.
Em resumo
Para uma API JSON, requests.post(url, json=data, timeout=20) resolve o trabalho inteiro: o Requests serializa o corpo e define o cabeçalho. data= envia formulários ou bytes exatos, files= envia corpos multipart, e params= monta a query string. Um comando cURL corresponde a esses argumentos opção por opção; quando as respostas continuam diferentes, confira os redirecionamentos, os cabeçalhos padrão, a versão do HTTP e o ambiente, nessa ordem. Quando uma API precisa ser chamada de um país específico ou de um endereço fixo, compare as opções na nossa página de serviços de proxy.