Você tem 200 sites pequenos diferentes e precisa coletar de todos eles os mesmos campos — nome do produto, preço, situação de estoque. Escrever um script por site significa centenas de seletores; colocar tudo em uma única API de scraping significa registros vazios para a maioria, porque a estrutura deles não encaixa. Quando você dá o mesmo trabalho a um agente de IA, o quadro muda: o agente lê cada página por conta própria, decide olhando essa página onde estão os dados e, se precisar, entra em um link e corrige o plano no meio do caminho.
Esse é, em uma frase, o agentic web scraping (scraping com agentes). Neste artigo explicamos o que é o scraping com agentes, com quais etapas o loop do agente funciona em um trabalho de extração, os blocos que compõem o sistema, um esqueleto de código que funciona, o terreno de custo e confiabilidade em comparação com scripts baseados em regras e os modos típicos de falha do agente. O outro lado da pergunta de quem escolhe a rota — o pipeline fixo em que o modelo só trabalha na etapa de análise — tratamos no nosso artigo scraper de IA.
O que é agentic web scraping?
Há três níveis para coletar dados de uma página e, para usar o termo corretamente, é preciso manter os três separados. No primeiro nível tudo está nas mãos do desenvolvedor: o script sabe no código a qual endereço ir e de qual elemento tirar os dados. No segundo nível o trabalho de análise é delegado ao modelo, mas a rota continua fixa: a página chega, o modelo extrai os campos, o fluxo termina — esse era o tema do nosso artigo scraper de IA. No terceiro nível o modelo entra no loop: qual página visitar, qual botão apertar, quando parar, é decidido em tempo de execução. Esse terceiro nível é o agentic web scraping.
Dito com a distinção do artigo Building effective agents da Anthropic: fluxos cujas etapas o código desenha são fluxos de trabalho; fluxos em que o modelo conduz o próprio processo são agentes. O scraping com agentes é essa definição aplicada à coleta de dados. Para condensar a diferença em uma frase: no scraper de IA, a resposta à pergunta "quem analisa a página?" é o modelo; no scraping com agentes, a resposta à pergunta "quem escolhe a rota?" também passa ao modelo.
Como o loop do agente funciona na extração?
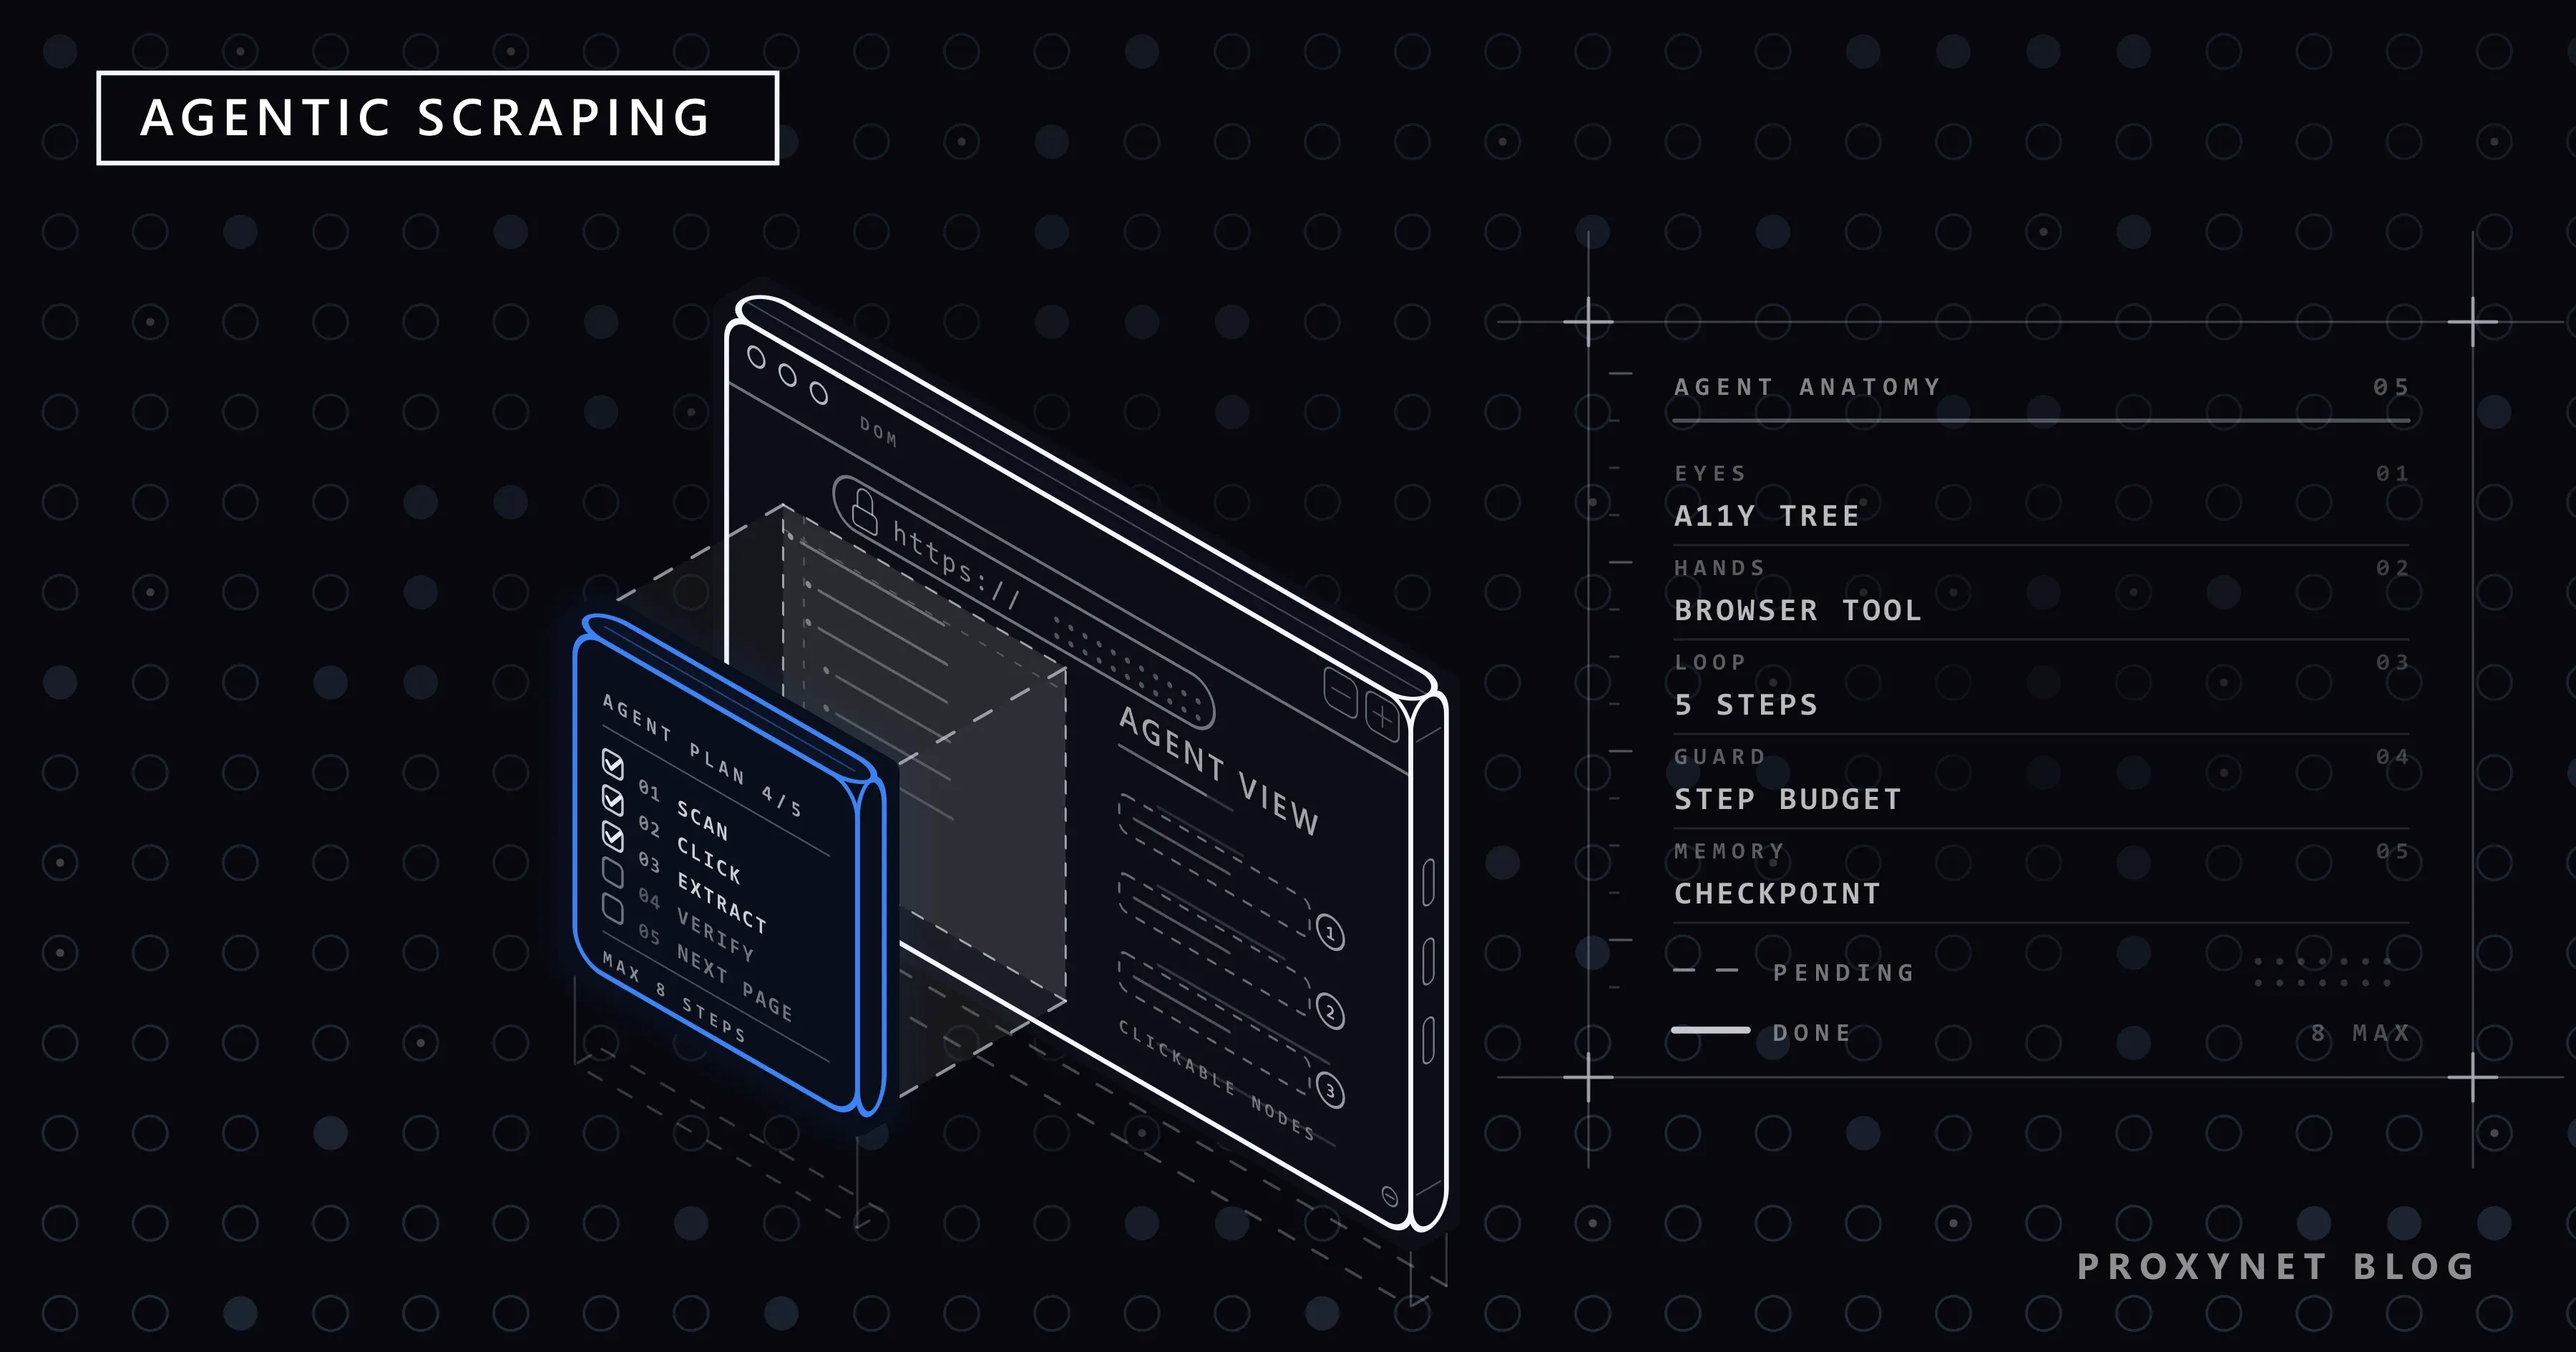
A forma geral de trabalho do agente — perceber, planejar, agir, avaliar — e a base teórica desse loop eram o tema do nosso artigo Como funcionam os agentes de IA; em vez de repeti-lo, vejamos a forma específica da extração. A cada volta do loop, cinco etapas se repetem:
- Perceber. O que o agente "vê" não são os pixels da janela do navegador, mas o resumo estrutural da página: a árvore de acessibilidade, os títulos, as listas de links, os campos de formulário. Esse resumo entra na janela de contexto do modelo; o HTML bruto não entra por completo.
- Planejar. Olhando o objetivo — "extraia o preço de cada produto desta lista" —, o modelo escolhe a próxima ação: clicar no botão de filtro, passar para a segunda página da paginação ou decidir que os dados já estão visíveis.
- Agir. A ação que o modelo escolhe é uma chamada de ferramenta:
git(url),tıkla(betimleme),doldur(alan, değer). Quem executa de fato a chamada é o navegador; o modelo só escreve a ordem. - Extrair. Quando os dados-alvo estão visíveis, o modelo preenche os campos conforme o esquema que você definiu. Esta etapa é a etapa de análise do pipeline fixo, colocada dentro do agente.
- Conferir e repetir ou terminar. Os tipos e os campos obrigatórios da saída são verificados no código; se falta algo, o modelo vê qual informação falta e volta à página correspondente. Uma condição de parada como um limite de etapas, um limite de custo ou um número de páginas evita que o loop rode para sempre.
A quarta e a quinta etapa mostram que o scraping com agentes trabalha ao mesmo tempo com duas disciplinas separadas: não confiar nas decisões do modelo e na saída dele adiciona de uma vez duas camadas de trabalho — uma camada de validação e uma camada de parada. Sem as duas, o sistema parece "funcionar" enquanto produz dados errados em silêncio.
Blocos de construção
- Ferramenta de navegador. As mãos do agente. Uma biblioteca de automação como o Playwright oferece a árvore de acessibilidade que o modelo pode ver e as ações que ele pode usar; também existe um componente pronto que faz esse trabalho como servidor MCP. A configuração e as flags de proxy explicamos no nosso artigo Playwright MCP; o protocolo em si deixamos para o nosso artigo O que é MCP?.
- Esquema e validação. O esquema JSON dos dados pedidos prende a saída do modelo a um contrato. As verificações de tipo, obrigatoriedade e intervalo ficam no código; registros suspeitos vão para uma fila separada em vez de serem gravados no repositório principal.
- Ponto de parada e memória. Trabalhos longos podem ser interrompidos; os endereços que o agente visitou, as páginas que concluiu e os registros que reuniu ficam guardados fora. A janela de contexto é a memória de curto prazo; a memória de um trabalho de 200 sites não cabe na janela do modelo, mas cabe em um arquivo.
- Limites de segurança. Os domínios que o agente pode abrir, o número de etapas que pode dar e as ferramentas que pode chamar são restringidos de antemão; o conteúdo da página que ele extrai entra no modelo como dado, não como instrução. Essa camada inteira, incluindo lista de permitidos, limite de taxa e limpeza contra injeção, montamos no nosso artigo Acesso seguro à web para LLMs.
Um pequeno esqueleto de agente
O rascunho em Python abaixo mostra o esqueleto do loop acima, independente do provedor. O lado do navegador é o Playwright; a função model_cagir é preenchida com o cliente do provedor que você usa, e do modelo se espera ou uma ação ou uma saída conforme o esquema.
import json
from playwright.sync_api import sync_playwright

PROXY = {"server": "http://pr.proxynet.io:8000",
         "username": "kullanici", "password": "parola"}
HEDEF = "https://example.com/urun-listesi"
SEMA = {"urun_adi": str, "fiyat": float, "stokta": bool}

def gozlemle(sayfa):
    # O olho do agente: não o HTML bruto, mas o resumo estrutural da página.
    return sayfa.locator("body").aria_snapshot()

def model_cagir(gozlem, talimat):
    # Preencha com o cliente oficial do provedor. gozlem + talimat é enviado
    # ao modelo; a resposta é ou {"arac": ..., ...} ou dados conformes ao esquema.
    raise NotImplementedError("a chamada ao modelo é feita aqui")

def dogrula(kayit):
    for alan, tur in SEMA.items():
        if not isinstance(kayit.get(alan), tur):
            raise ValueError(f"{alan} não está no tipo esperado")
    return kayit

with sync_playwright() as p:
    tarayici = p.chromium.launch(proxy=PROXY)
    sayfa = tarayici.new_page()
    sayfa.goto(HEDEF)

    for adim in range(8):                       # condição de parada: limite de etapas
        karar = json.loads(model_cagir(gozlemle(sayfa),
                                       "Extraia os produtos da lista."))
        if karar.get("arac") == "cikar":
            print(dogrula(karar["kayit"]))      # nunca confie diretamente no modelo
            break
        if karar["arac"] == "git":
            sayfa.goto(karar["url"])
        elif karar["arac"] == "tikla":
            sayfa.get_by_role(karar["rol"], name=karar["ad"]).click()
Três características do esqueleto resumem o resto do artigo: o que o modelo vê a cada volta não é o HTML bruto, mas um resumo estrutural; o loop tem uma condição de parada; a saída do modelo não é gravada em lugar nenhum antes de passar por dogrula. Todas as opções de proxy do Playwright nós apresentamos em forma de tabela no nosso artigo proxy do Playwright.
Lado a lado com a extração baseada em regras
Colocar os três níveis na mesma tabela esclarece qual trabalho vai para qual nível:
| Critério | Script baseado em regras | Scraper de IA (pipeline fixo) | Agente (agentic) |
|---|---|---|---|
| Quem escolhe a rota? | O desenvolvedor, no código | O desenvolvedor, no código | O modelo, em tempo de execução |
| Resistência a mudanças no site | Baixa | Alta (na análise) | Alta (análise + rota) |
| Custo unitário | Praticamente zero | Tokens por página | Tokens por volta; o número de voltas varia |
| Previsibilidade | Alta | Média | Baixa |
| Trabalho adequado | Páginas estáveis, alto volume | Páginas de estrutura variável | Trabalhos de várias etapas em que a rota não se conhece de antemão |
A fórmula do custo é simples: o pagamento total do agente é o número de voltas multiplicado pelos tokens enviados e recebidos por volta. No script baseado em regras esse número fica próximo de zero; no scraper de IA o número de voltas é um (uma única chamada de análise); nos trabalhos com agente o número de voltas varia conforme a dificuldade da página — a maioria das páginas termina em duas voltas, enquanto um trabalho que passa por menus de filtros pode levar de seis a oito voltas. Por isso o orçamento do agente se prende a um limite de etapas, e não ao trabalho em si: um sistema montado sem um teto como for adim in range(8) no loop pode dar voltas por horas em uma página quebrada. Como os custos unitários do lado do modelo são calculados, tratamos no nosso artigo Web scraping com GPT-6 Astra.
Os modos de falha do agente
As falhas dos sistemas com agente são diferentes das de um script; o script quebra e para, o agente pode se desviar sem quebrar. Os modos principais e onde aparecem:
- Entrar em loop. O agente vai e volta entre as mesmas duas páginas ou clica no mesmo botão repetidamente. Sua aparência é um número de voltas que infla e a mesma sequência de ações se repetindo nos registros; a cura é guardar os endereços visitados e as ações e mostrar ao modelo essa lista a cada volta.
- Deriva do objetivo. O modelo converte o objetivo "extraia preços" no objetivo "navegue pelo site"; não chegam registros, mas a volta se gasta. A cura é repetir o objetivo no contexto de cada volta e pôr um teto no número de voltas vazias.
- Preenchimento inventado. Quando os dados não estão visíveis, o modelo preenche os campos por probabilidade. A única cura é a camada de validação; a fila de registros suspeitos é o único lugar que captura esse modo de falha.
- Explosão de custo. O resultado combinado do loop e da deriva: um trabalho escrito sem teto de etapas e sem teto de orçamento pode gastar o orçamento do dia em uma única execução. Os dois tetos moram no código, não na consciência do modelo.
- Degradação silenciosa. O modo mais sorrateiro: o agente volta "bem-sucedido" com poucos registros. Se trinta de 200 sites voltarem vazios e ninguém olhar, o erro não está escondido no log, mas no próprio relatório. A cura é o alerta de abaixo do esperado: o trabalho que cai abaixo do número de registros esperado é marcado à parte.
O que mudou do lado do bloqueio?
Para as proteções contra bots, o agente se parece com qualquer scraper que usa um navegador headless: reputação de IP, taxa de requisição e sinais do navegador são medidos da mesma forma; a inteligência do modelo é invisível para essas medições. Além disso, o agente produz mais requisições que o pipeline fixo — para cada decisão, páginas intermediárias são abertas e depois revisitadas. Por isso a continuidade de sessão ganha importância nos trabalhos com agente: a mesma sessão de navegação sair sempre do mesmo endereço de saída significa que as requisições do meio não ficam desconectadas umas das outras. Um Proxies de sessão fixa que fornece um endereço que não muda durante a sessão é, por isso, adequado a trabalhos com agente; em listas de alvos amplas, usa-se um Proxies residenciais para crescer o pool.
Do lado do quadro legítimo também nada fica mais fácil: o agente continua obrigado a seguir robots.txt e os termos do site, o conteúdo atrás de login e os dados pessoais seguem sendo uma responsabilidade separada. Uma linha foi somada a essas: os sites começaram a separar os agentes que chegam se anunciando com clareza (identidade de bot verificada, requisições assinadas) dos que não fazem isso. Por que os agentes são bloqueados e essa nova ordem tratamos no nosso artigo Por que os sites bloqueiam agentes de compras com IA?; o resumo é este: o caminho legítimo não é burlar a detecção, e sim carregar a identidade abertamente.
Casos de uso
- Listas que passam por menus de filtros. Em catálogos em que as etapas de categoria, filtro e paginação funcionam diferente em cada site, o agente reduz horas de trabalho por script a uma única instrução; o lado do script da lógica de paginação explicamos no nosso artigo Paginação.
- Catálogos de cauda longa. Reunir centenas de sites de pequenos vendedores em um só esquema nasce de prototipar com um agente em vez de escrever seletores por site; a tabela de decisão para escalar com o pipeline fixo está no artigo scraper de IA.
- Primeira configuração do monitoramento de preços e estoque. Em um conjunto novo de alvos, o agente faz a primeira descoberta; se a rota encontrada for estável, o mesmo trabalho é entregue a um script baseado em regras; a configuração de ponta a ponta do monitoramento está no nosso artigo Monitoramento de preços de concorrentes.
- Dados ao vivo para aplicações de modelo. O agente pode coletar o conteúdo atual das páginas para a sua aplicação de modelo de linguagem e entregar limpo; nesse uso, a camada de acesso deve ser limitada pelas regras do nosso artigo Acesso seguro à web para LLMs.
Quando agente, quando script?
| Necessidade | Recomendação |
|---|---|
| Uma única página estável; alto volume | Script baseado em regras; modelo não é necessário |
| Páginas cuja estrutura muda; rota fixa | Scraper de IA (pipeline fixo + análise com LLM) |
| Trabalho de várias etapas com etapas desconhecidas de antemão | Agente, com tetos de etapas e de orçamento |
| Protótipo e descoberta, trabalho que vai crescer depois | Descobrir com o agente e entregar a rota encontrada ao script |
| Milhões de páginas por dia | Não é agente; pipeline baseado em regras + modelo para exceções |
A regra da última linha pode ser resumida assim: o agente pertence à fase de descoberta do trabalho, o script à fase de repetição. Transformar em script a rota que o agente encontrou uma vez (endereços visitados, elementos clicados, valores de formulário enviados) é repetir o mesmo trabalho de agora em diante sem tokens.
Quadro jurídico e ético
O agente não muda a legalidade da extração: robots.txt, termos do site, dados pessoais e as regras de conteúdo atrás de login valem exatamente igual; o quadro explicamos no nosso artigo Web scraping é legal?. O trabalho com agentes carrega duas responsabilidades a mais. A primeira: o conteúdo da página é enviado à API do modelo; em páginas que contêm dados pessoais, essa transferência em si entra na legislação e é preciso limpar antes de enviar. A segunda: o agente não faz só leitura — clica e pode preencher formulários; as permissões dadas a ele devem, por isso, ser limitadas ao mínimo necessário e suas ações devem ficar registradas.
Perguntas frequentes
O agentic web scraping substitui o scraping clássico?
Não. Um agente traz valor em trabalhos em que a rota não se conhece de antemano; em páginas estáveis e em alto volume, um script baseado em regras continua mais rápido, mais barato e mais previsível. O arranjo comum coloca os dois lado a lado: o agente descobre, o script repete.
Como o custo do scraping com agentes é calculado?
É o número de voltas multiplicado pelo custo em tokens por volta. No script baseado em regras o número de voltas é zero, no scraper de IA é um; nos trabalhos com agente varia conforme a dificuldade da página. Por isso o orçamento se prende ao loop, e não ao trabalho: o teto de etapas e o teto de gasto são escritos no código.
Em quais casos faz sentido usar um agente?
Quando a estrutura é diferente a cada vez, as etapas não podem ser escritas de antemano e o volume do trabalho cobre o custo em tokens. Menus de filtros, listas de várias etapas e centenas de sites pequenos diferentes se encaixam nessa definição; uma única página de produto não se encaixa.
Como os dados que o agente coleta são validados?
Não é diferente da validação no pipeline fixo: um esquema JSON, verificações de tipo e de campos obrigatórios, verificações de intervalo e comparação manual por amostragem. Além disso, nos trabalhos com agente o número de registros esperado é monitorado; o trabalho que cai abaixo do esperado não passa em silêncio, é marcado à parte.
Os sites bloqueiam agentes, qual é o caminho legítimo?
Não esconder a identidade do agente, e sim carregá-la abertamente; seguir os termos do site e o robots.txt; usar identidade de bot verificada, quando ela puder ser concedida. Por que acontecem os bloqueios e o arranjo dos agentes assinados explicamos no nosso artigo agentes de compras com IA.
Com qual ferramenta começar o agentic web scraping?
Para o lado do navegador, Playwright e uma interface que o conecte ao modelo: ou um servidor MCP pronto ou o seu próprio loop. Do lado do modelo, qualquer API com suporte a saída estruturada basta; para começar, você pode usar o esqueleto acima junto com um teto de etapas.
Em resumo
O agentic web scraping coloca o modelo tanto na rota quanto na análise da extração: observa a página, decide a próxima etapa e extrai os dados conforme o esquema. O que ele traz é que trabalhos variáveis e de várias etapas cabem em uma única instrução; o preço é um custo que cresce com o número de voltas e uma imprevisibilidade que precisa ser contida com código. Com o teto de etapas, a camada de validação e o registro de eventos no lugar, o agente é uma ferramenta forte para a descoberta; os trabalhos estáveis e repetitivos ficam no script. Ao montar a sua infraestrutura de coleta de dados, dê uma olhada nas nossas soluções de extração de dados.