O script que coleta nome e preço de produto de um e-commerce rodou sem problemas por meses. O site renovou o design, o elemento <span class="price"> mudou para outro componente e, na mesma noite, o script começou a gravar registros vazios. A resposta clássica para esse cenário é reescrever o seletor. A promessa do AI web scraper é outra: que a instrução "encontre o nome e o preço do produto" conserve o significado mesmo quando a estrutura da página muda.
Neste artigo, explicamos o que é um AI web scraper, como ele transforma uma página em dados estruturados em cinco etapas, os quatro tipos de ferramentas, em quais trabalhos ele entrega bons resultados e se, no lado do bloqueio, ele difere de um scraper clássico. A versão com agente, que escolhe o próprio caminho e avança clicando, é um assunto à parte; na última seção traçamos a linha entre os dois e ligamos ao artigo sobre ela.
O que é um AI web scraper?
O web scraping são dois trabalhos separados: obter o conteúdo da página e analisar o conteúdo recebido para extrair os campos e convertê-lo em dados estruturados. Essa distinção, ligada ao lugar real do modelo nesse fluxo, contamos no nosso artigo Extração de dados com o GPT-6 Astra; aqui vai a parte dos termos. Quando se fala em "AI web scraper", a maioria entende a ferramenta que delega ao modelo o lado da análise desses dois trabalhos. A obtenção continua sendo feita com um cliente HTTP ou um navegador headless; o que muda é o código que decide qual elemento da página conta como "preço" ou "estoque".
Dois casos fora dessa definição criam confusão. O primeiro são as ferramentas sem código: alguns serviços pedem que você selecione com o mouse os campos que quer na página e deixam o modelo generalizar sua seleção e aplicá-la a páginas parecidas. Toda a escada de puxar dados sem escrever código (do Excel ao navegador headless) listamos no nosso artigo Como extrair dados de um site; o AI scraper fica vizinho do degrau mais alto dessa escada. O segundo são os sistemas com agente, que deixam o caminho também a cargo do modelo; são assunto não deste artigo, mas de Agentic Web Scraping.
Como um AI scraper transforma uma página em dados?
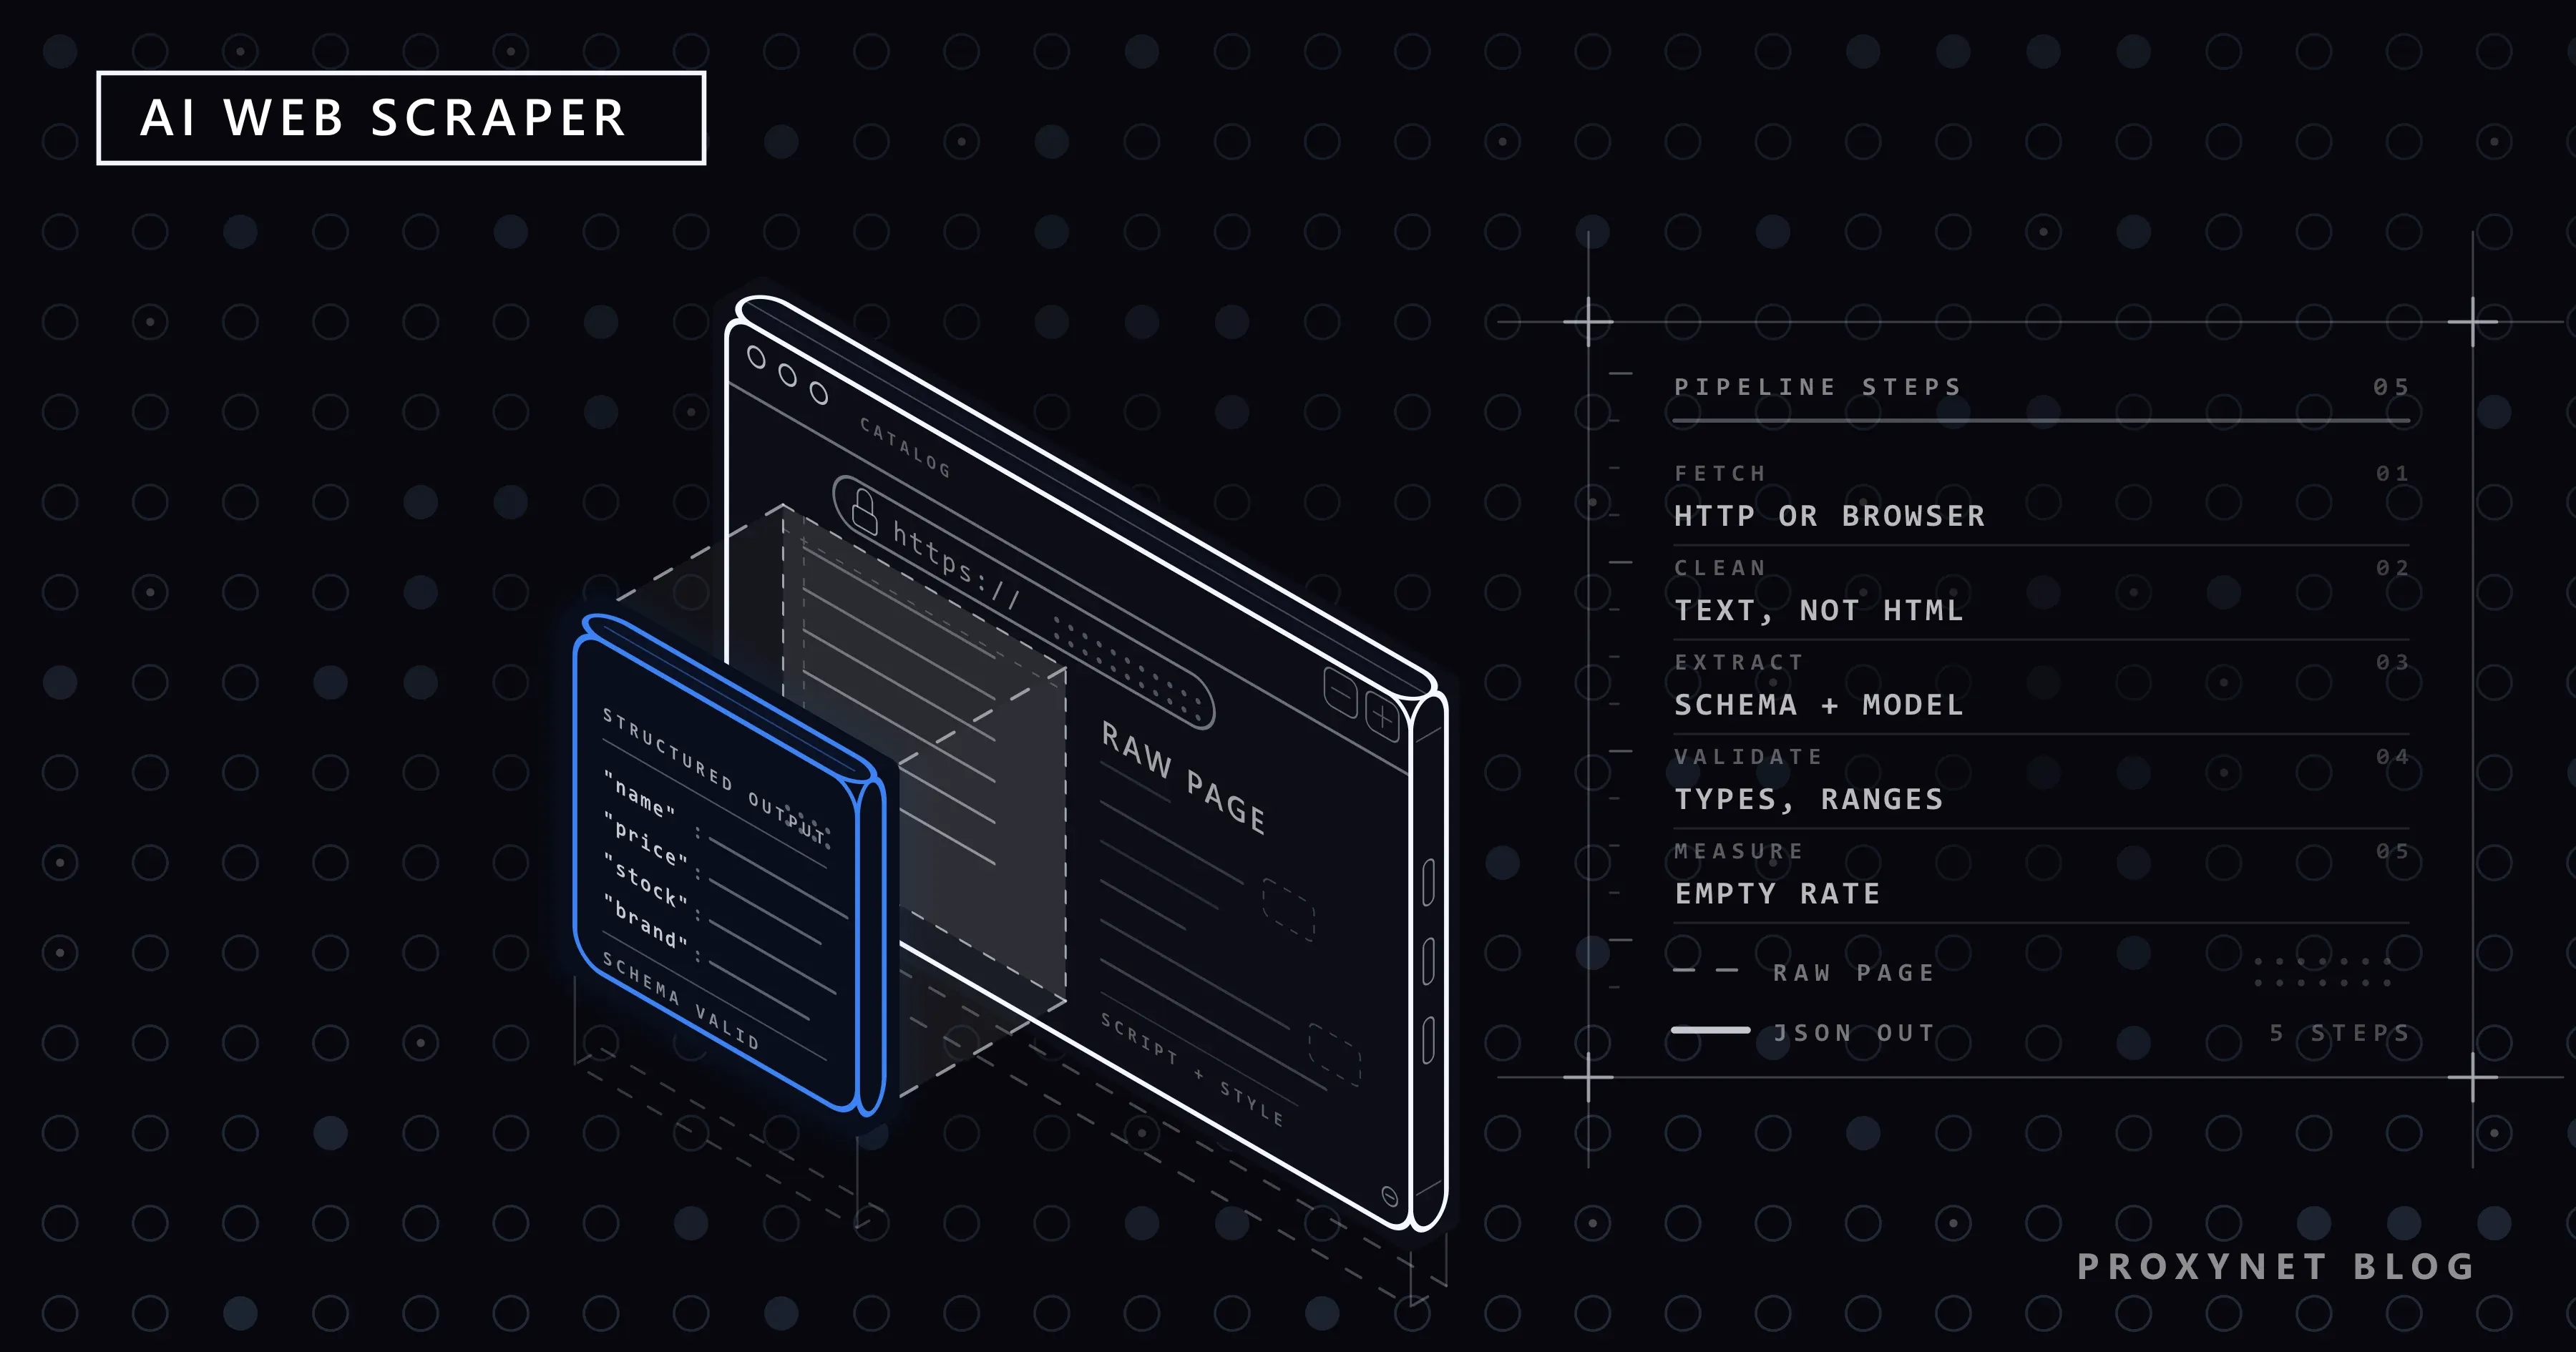
Seja qual for a marca da ferramenta, o fluxo se compõe de cinco etapas. A diferença está, na maior parte, em quantas dessas etapas ficam do seu lado e quantas no serviço.
- Obtenha a página. Para HTML estático, basta uma requisição HTTP simples. Se a página preenche o conteúdo com JavaScript, ela é renderizada com um navegador headless. Nesta etapa estão em jogo o IP usado, a taxa de requisições e a impressão digital do navegador; o modelo não tem nada a ver com isso.
- Tire o ruído. O HTML bruto de uma página de produto pesa várias vezes o texto visível; se blocos de script e navegação chegam ao modelo, fica lento e caro. Os elementos de script e estilo são limpos e, se necessário, extrai-se apenas o bloco de conteúdo principal. A biblioteca Readability, da Mozilla, versão de código aberto do algoritmo por trás do "modo leitura" do navegador, é a referência mais conhecida para esse trabalho.
- Dê o esquema e a instrução. Você define os campos que quer como um esquema JSON: qual é obrigatório, qual é número, qual é data. As APIs modernas de modelos, com suporte a saída estruturada, forçam a resposta do modelo a obedecer a esse esquema; é disso que ela se diferencia de uma resposta livre escrita como texto.
- Valide a saída. Uma resposta que obedece ao esquema ainda pode estar errada: no campo de preço chega o texto "1.299 TL", a moeda vem faltando, um produto fora de estoque volta como "true". Checagens de tipo, intervalo e campos obrigatórios são feitas em código; o registro suspeito não vai para o banco de dados, vai para uma fila separada.
- Salve e meça. Os registros válidos vão para o armazenamento; acompanha-se a taxa de páginas que voltam vazias, pedem correção ou não obedecem ao esquema. Se essa taxa sobe em silêncio, ou o site mudou, ou o modelo não consegue resolver essa estrutura de página; nenhum dos dois é erro do código que você escreveu, e só se enxerga medindo.
O contrato da terceira etapa fica assim. O esquema:
{
  "name": "string (obrigatório)",
  "price": "number (obrigatório)",
  "currency": "string",
  "in_stock": "boolean"
}
A resposta que se espera que o modelo devolva:
{
  "name": "Mouse sem fio",
  "price": 1299,
  "currency": "TRY",
  "in_stock": true
}
Tipos de AI scraper e ferramentas
As ferramentas do mercado se dividem em quatro grupos. A pergunta ao escolher um não é "qual é o melhor", mas quais etapas ficam do seu lado e quais ficam no serviço.
| Tipo | Exige código? | Representante | Trabalho adequado |
|---|---|---|---|
| Ferramentas sem código | Não | Ferramentas de monitoramento como Browse AI | Monitoramento repetitivo de páginas, alertas de mudança |
| APIs de scraping com análise por IA | No nível de uma chamada de endpoint | Firecrawl, Apify | Integrações prontas, trabalhos de médio porte |
| Bibliotecas do lado do código | Sim | ScrapeGraphAI, cadeias de extração do LangChain | Equipes que montam e personalizam o próprio pipeline |
| Frameworks de agentes | Sim | Browser Use, Playwright MCP | Trabalhos de várias etapas com caminho desconhecido de antemão |
Abrindo com resumo. O Firecrawl é uma API de scraping de código aberto que recebe uma URL e converte a página em Markdown limpo, adequado a modelos de linguagem e, se pedido, em JSON conforme a um esquema. O Apify é uma plataforma em que programas de scraping prontos rodam na nuvem; você escolhe entre centenas de "actors" prontos e os executa. O ScrapeGraphAI é uma biblioteca Python de código aberto que monta o pipeline de obtenção e análise em volta de um modelo de linguagem; você diz "extraia estas informações deste site" e deixa o resto do pipeline com a biblioteca. O LangChain é um framework de propósito geral para modelos de linguagem; é nele que você monta cadeias que extraem campos de documentos. A quarta linha abandona o pipeline: nos frameworks de agentes, o modelo decide também a qual página ir e o que clicar.
Os dois primeiros grupos da tabela aceleram o trabalho; os dois últimos mudam como você o define. A maioria das equipes começa pelo segundo grupo e passa ao terceiro conforme a escala e a personalização crescem; o lugar do quarto grupo é outro artigo.
No que ele é bom e no que não consegue?
O lado forte da análise baseada em modelo é exatamente onde o script clássico quebra:
- Resistência a mudanças do site. Quando o design é renovado, os elementos mudam de lugar ou os nomes das classes mudam, a instrução continua a mesma. O item "consertar o seletor" não sai da lista de manutenção, mas fica mais raro.
- Sites de cauda longa. Escrever seletores separados para centenas de sites pequenos de estruturas diferentes é impossível na maioria dos projetos; dar a cada um o mesmo esquema e a mesma instrução é possível.
- Texto livre. Tirar o prazo de entrega da frase "entrega em dois dias" ou o andar do apartamento da descrição de um anúncio não se escreve com seletor; é um trabalho de extrair significado.
Do outro lado há três custos permanentes. Custo e velocidade: o seletor roda em milissegundos e de graça; o modelo leva segundos e pede tokens por página. Numa linha fixa que processa cem mil páginas por dia, essa diferença inverte a conta. Consistência: a mesma entrada pode não dar a mesma saída a cada vez; por isso a quarta etapa não pode ser pulada. Alucinação: o modelo pode preencher um campo que não existe na página com conhecimento próprio. Por causa desses dois riscos da estrutura, num único site cuja estrutura não muda há meses, o seletor CSS continua sendo o caminho mais rápido e mais barato; IA aqui não é melhoria, é despesa.
O que muda no lado do bloqueio?
Nada muda; uma coisa fica mais pesada. Como o modelo não muda como a página é alcançada, a reputação de IP, a taxa de requisições e as restrições de localização são as mesmas do scraping clássico; o 429 que volta não tem nada a ver com o modelo. O que fica mais pesado é o seguinte: para conseguir interpretar o JavaScript, os AI scrapers trabalham na maioria das vezes com um navegador headless — ou seja, cada requisição abre um navegador, executa e fecha. É uma pegada mais lenta e mais visível do que uma requisição HTTP simples; em velocidade alta, bate antes no número de requisições permitidas.
Por isso a camada de obtenção importa mais num AI scraper do que antes. O ponto de partida continua sendo as regras do próprio site: se o arquivo robots.txt não permite, não se faz scraping; se o site tem API, usa-se a API; os limites de taxa são respeitados. O quadro disso listamos no nosso artigo Como fazer web scraping sem ser bloqueado. Em trabalhos volumosos e bagunçados, se as requisições saem de um único IP, o endereço é marcado rápido; um Proxies residenciais que vem de endereços de usuários reais cai em posição melhor na conta de confiabilidade do site de destino, e um Proxies rotativos, que troca o endereço a cada requisição, espalha a carga pelo pool. A escolha de provedor tratamos em uma seção à parte: Os melhores proxies para web scraping.
Em resumo, a expectativa de "faço scraping com IA, então não levo bloqueio" está errada; pelo contrário, num projeto típico um AI scraper envia um tráfego que parece mais pesado para a proteção contra bots. Por isso a camada de obtenção é projetada e monitorada separadamente.
Qual a diferença entre um AI scraper e o scraping agêntico?
Os dois termos se confundem com frequência porque, nos dois, um modelo de linguagem lê a página. A diferença está em quem fica com a decisão. Um AI web scraper é um pipeline fixo: as etapas são escritas pelo desenvolvedor, e o modelo só atua na etapa de análise. A página é obtida, processada e pronto; o modelo não decide sobre a próxima volta do fluxo.
No scraping agêntico, o modelo está dentro do loop: ele mesmo decide em qual link entrar, quando parar, se o plano desmoronou. Isso significa passar de trabalhos de página única a tarefas de várias etapas; o preço é que custo e duração ficam amarrados ao número de etapas. Como funciona o loop geral de um agente, explicamos no nosso artigo Agentes de IA: planejamento, ferramentas e memória; a versão específica do scraping, os blocos de construção e os modos de falha tratamos no artigo Agentic Web Scraping.
Casos de uso
- Monitoramento de preço e estoque. As páginas de produto de centenas de vendedores caem num único esquema; mudanças de design não derrubam a linha. A montagem de ponta a ponta explicamos no nosso artigo Como monitorar preços da concorrência.
- Coleta de dados de cauda longa. Extrair os mesmos campos de centenas de sites pequenos de estruturas diferentes sai muito mais barato do que escrever um seletor por site.
- Extrair informação de texto livre. Em textos sem estrutura, como avaliações, descrições de anúncios e vagas de emprego, seletor não tem lugar; os campos extraídos alimentam a linha de mineração de dados.
- Dados atualizados para aplicações de modelo de linguagem. Se o modelo precisa receber informação atual, como catálogo de produtos, documentação ou preços, um AI scraper faz esse trabalho já em forma estruturada; para um desenho seguro da camada de acesso, veja nosso artigo Acesso seguro à web para LLMs.
Erros comuns
- Mandar toda página para o modelo. A região estável em que o seletor funciona não deve ir para o modelo; estreitar a região com um seletor grosso e deixar o interior para o modelo junta as vantagens dos dois métodos.
- Mandar HTML bruto. Blocos de script e estilo queimam o orçamento de tokens; se a etapa de limpeza é pulada, o mesmo trabalho sai várias vezes mais caro.
- Saída sem validação. Obedecer ao esquema não significa que o dado está correto. Sem checagens de tipo, intervalo e campos obrigatórios, uma única resposta errada do modelo é gravada em silêncio no seu banco de dados.
- Não definir um esquema. Uma instrução livre como "me dê as informações do produto desta página" é respondida num formato diferente a cada página; montar a linha sem amarrar o conjunto de campos a um contrato é trabalho jogado fora.
- Tratar sintomas de bloqueio no modelo. Resposta 429, conteúdo vazio ou CAPTCHA aparece como um problema de análise; mudar o prompt não resolve, consertar a camada de obtenção (taxa, estratégia de IP) resolve.
- Abrir páginas privadas em ferramenta de terceiro. Carregar na janela de um serviço sem código páginas que exigem sessão ou contêm dados pessoais leva esses dados para o terceiro; esse tipo de página é processado na sua própria infraestrutura.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Uma única página cuja estrutura raramente muda; alto volume | Seletor clássico; não precisa de IA |
| Monitoramento repetitivo sem escrever código | Ferramenta sem código |
| Trabalho de médio porte num site cuja estrutura muda com frequência | API com análise por IA ou biblioteca |
| Centenas de sites de estruturas diferentes, texto livre | Análise com LLM + camada obrigatória de validação |
| Tarefas de várias etapas cujas etapas não se conhecem de antemano | Framework de agentes (Agentic Web Scraping) |
Perguntas frequentes
Preciso saber programar para usar um AI web scraper?
Talvez não. As ferramentas sem código permitem selecionar campos na página e montar um monitoramento repetitivo; as bibliotecas do lado do código dão flexibilidade a quem quer montar o pipeline por conta própria. Conforme o trabalho cresce e a necessidade de personalização aumenta, o lado do código se torna inevitável.
AI scrapers são bloqueados mais facilmente que scrapers clássicos?
A causa do bloqueio é o tráfego em si, não o modelo; mas como o AI scraper tipicamente trabalha com um navegador headless, cada requisição é mais lenta e mais visível. Em velocidade alta, isso pode bater no limite mais cedo do que uma requisição simples clássica. Por isso é importante projetar a camada de obtenção separadamente.
É legal extrair dados com IA?
O uso de IA não muda a pergunta jurídica: dados pessoais, conteúdo atrás do login e regras de direitos autorais valem do mesmo jeito; robots.txt e os termos do site continuam sendo o ponto de partida. O enquadramento contamos no nosso artigo Web scraping é legal?. Um cuidado a mais: enviar o conteúdo da página à API de um modelo de terceiro é, por si só, uma transferência de dados.
Posso extrair dados de um site com o ChatGPT?
Para trabalhos pequenos de página única, sim: você copia a página do navegador, entrega seu esquema e recebe uma saída editada. Isso não é um pipeline; não há obtenção, nem validação, nem repetição. Em trabalhos contínuos ou de muitas páginas, é preciso uma linha montada com script e chamadas de API.
Dá para confiar nos dados que um AI scraper extrai?
Saída que obedece ao esquema não é o mesmo que saída correta. Checagens de tipo e campos obrigatórios, verificações de intervalo e comparação manual por amostragem são a prática padrão; registros suspeitos vão para a fila antes de serem gravados no armazenamento principal. O que aumenta a confiança não é engordar o modelo, é montar a sério a camada de validação.
Em qual caso um script clássico faz mais sentido?
Em trabalhos em que a estrutura da página não muda há meses, o volume é alto e o conjunto de campos é fixo. O seletor roda em milissegundos e sem tokens; o modelo aqui não é melhoria, é custo permanente. As exceções em que o seletor quebra e os sites de cauda longa devem ficar para a IA.
Em resumo
O AI web scraper entrega ao modelo de linguagem a ponta frágil do scraping — a extração de campos; obtenção, validação e medição seguem com a disciplina clássica. O ganho de curto prazo são as linhas que saem da lista de manutenção; o preço é o custo em tokens de cada página. A equipe que equilibra os dois usa o seletor nas páginas estáveis e o modelo nas estruturas que mudam. Ao montar a sua linha de coleta de dados, dê uma olhada nas nossas soluções de extração de dados.