


































Você está coletando dados de uma loja que carrega os preços com JavaScript. O HTML que chega com Requests vem vazio, então você passa para o Playwright e a página abre sem problemas. Quando o trabalho cresce, é preciso passar o tráfego por um proxy, e a primeira tentativa termina com net::ERR_TUNNEL_CONNECTION_FAILED ou com "Browser does not support socks5 proxy authentication". A maioria dos tutoriais apresenta o Playwright como ferramenta de automação de testes, por isso a parte do proxy costuma ser montada a partir de tópicos de fórum e de issues no GitHub.
Neste artigo definimos rapidamente o que é o Playwright, mostramos a instalação em Python e em Node.js lado a lado e depois passamos ao proxy: a diferença entre proxy no nível do navegador e no nível do contexto, a autenticação com usuário e senha, o comportamento do Chromium com SOCKS5, a escolha entre rotativo e sticky, a economia de tráfego ao cortar as requisições de imagens e fontes, a verificação do IP e uma tabela de erros. Executamos todos os exemplos do artigo com Playwright 1.63 e Chromium, por meio de um proxy local de teste com autenticação.
O que é o Playwright?
O Playwright é uma biblioteca de código aberto para automação de navegadores desenvolvida pela Microsoft. Ele abre um navegador real a partir do código, vai até um endereço, clica, preenche formulários e lê os elementos da página. Controla os motores Chromium, Firefox e WebKit com a mesma API e tem versões oficiais para Node.js, Python, Java e .NET.
A ferramenta nasceu para testes de ponta a ponta, e a maioria dos guias a apresenta por esse lado. Para equipes de dados, o valor está em outro lugar: ela executa em um navegador real a página gerada com JavaScript, espera sozinha até que um elemento apareça e permite ouvir as chamadas de API que a página faz em segundo plano e cortar as requisições desnecessárias. Para saber se uma página realmente precisa de um navegador, consulte antes o nosso artigo Páginas estáticas e dinâmicas no web scraping; se os dados estão no código-fonte da página ou em um endpoint JSON, abrir um navegador é um custo desnecessário.
Os trabalhos feitos com o Playwright se agrupam, em linhas gerais, em quatro frentes:
- Coletar dados de páginas dinâmicas (lista de produtos, preço, estoque, número de avaliações).
- Testar como o seu próprio site ou aplicativo aparece em diferentes países.
- Gerar capturas de tela e PDF.
- Fazer agentes de IA usarem um navegador. Os detalhes deste último ponto estão no nosso artigo sobre o Playwright MCP, sua instalação e as configurações de proxy.
As diferenças de arquitetura em relação ao Selenium e qual escolher em cada projeto são assunto de um artigo à parte: diferenças entre Playwright e Selenium.
Como instalar o Playwright?
A instalação tem dois passos: primeiro a biblioteca, depois os binários dos navegadores. O Playwright não usa o Chrome instalado no sistema, e sim navegadores que ele mesmo baixa e cuja versão ele fixa. O erro "instalei a biblioteca, mas o navegador não foi encontrado" acontece quando o segundo passo é pulado.
Em Python, crie um ambiente virtual e instale a biblioteca. A documentação oficial da biblioteca Python traz os mesmos passos também para poetry e uv.
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install playwright
playwright install chromium
Em Node.js:
npm init -y
npm install playwright
npx playwright install chromium
Se você não informar um navegador ao comando install, os três motores são baixados. Em trabalhos de scraping, o Chromium costuma bastar. Se for escrever testes, recomenda-se o pacote pytest-playwright em Python e @playwright/test em Node.js; para coleta de dados, a instalação simples da biblioteca mostrada acima é suficiente.
Em Python há duas APIs: sync_api e async_api. Em scripts que abrem páginas uma a uma, a versão síncrona é mais legível. Se for processar várias páginas ao mesmo tempo, use a versão baseada em asyncio; o exemplo completo no fim do artigo foi escrito assim.
Como definir um proxy no Playwright?
A seção HTTP Proxy da documentação de rede do Playwright define dois níveis: o proxy é informado para o navegador inteiro ou separadamente para cada contexto. Nos dois casos usa-se o mesmo objeto:
| Campo | Obrigatório? | Significado |
|---|---|---|
server | Sim | http://pr.proxynet.io:8000 ou socks5://host:porta. Sem o esquema, é tratado como proxy HTTP |
username | Não | Usuário para a autenticação do proxy HTTP |
password | Não | Senha para a autenticação do proxy HTTP |
bypass | Não | Domínios que não passam pelo proxy, separados por vírgula (.exemplo.com, api.suaempresa.com) |
Em Python, a definição no nível do navegador fica assim:
from playwright.sync_api import sync_playwright

PROXY = {
    "server": "http://pr.proxynet.io:8000",
    "username": "user",
    "password": "pass",
}

with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    page = browser.new_page()
    page.goto("https://httpbin.org/ip")
    print(page.inner_text("body"))  # IP de saída do proxy
    browser.close()
O equivalente em Node.js:
import { chromium } from "playwright";

const browser = await chromium.launch({
  proxy: {
    server: "http://pr.proxynet.io:8000",
    username: "user",
    password: "pass",
  },
});
const page = await browser.newPage();
await page.goto("https://httpbin.org/ip");
console.log(await page.innerText("body")); // IP de saída do proxy
await browser.close();
O ponto de atenção é o lugar das credenciais. Escrever http://user:pass@pr.proxynet.io:8000 por hábito do cURL ou do Requests não funciona aqui: o Playwright aproveita do valor server apenas o esquema, o host e a porta, e não repassa ao navegador o usuário e a senha embutidos no endereço. As credenciais vão sempre nos campos username e password. Há uma vantagem adicional: se a senha tiver caracteres como @ ou :, você não precisa se preocupar com a codificação de URL. A lógica geral dos dois métodos está em Autenticação de proxy: user:pass ou whitelist de IP.
Qual a diferença entre proxy no nível do navegador e no nível do contexto?
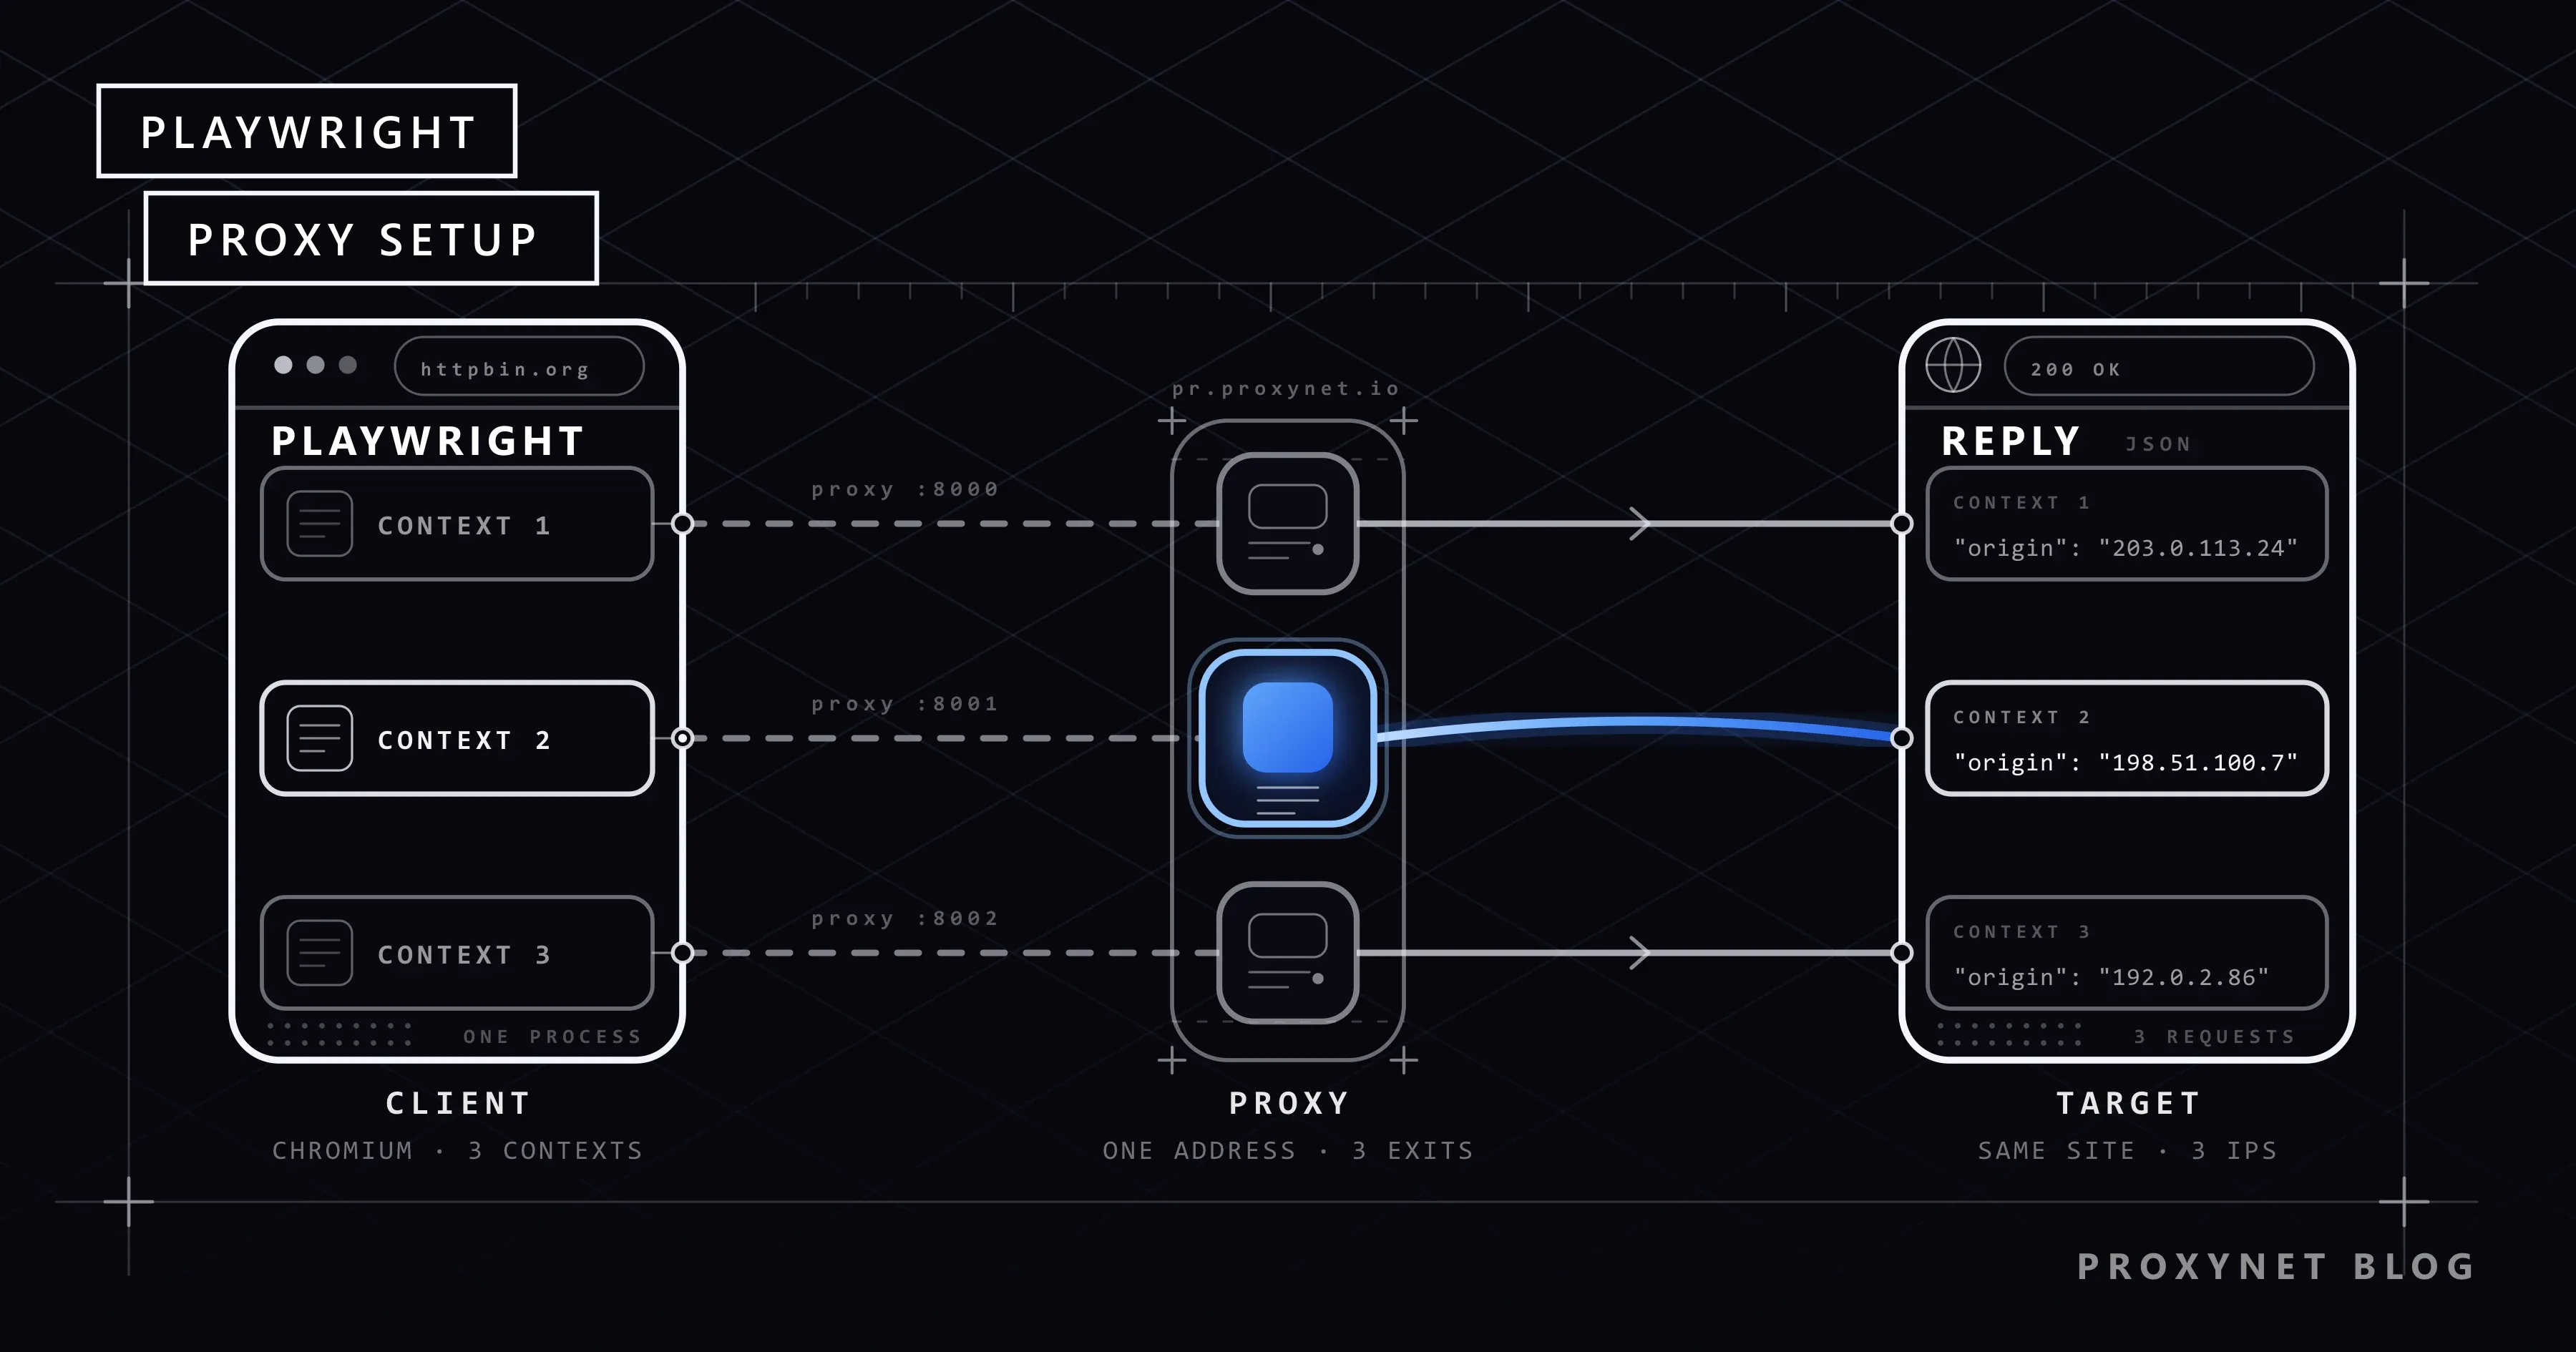
No Playwright, um contexto é uma sessão de navegador isolada das demais: tem seus próprios cookies, seu próprio cache e seu próprio armazenamento local. Lembra uma janela anônima, mas dezenas deles podem ficar abertos ao mesmo tempo em um único processo de navegador, e abrir um contexto custa muito menos do que iniciar um navegador novo.
Quando você passa o proxy à chamada new_context() em vez de launch(), a configuração vale apenas para aquele contexto:
from playwright.sync_api import sync_playwright

PROXIES = [
    {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"},
    {"server": "http://pr.proxynet.io:8001", "username": "user", "password": "pass"},
]

with sync_playwright() as p:
    browser = p.chromium.launch()  # o navegador abre uma vez, sem proxy
    for proxy in PROXIES:
        context = browser.new_context(proxy=proxy)  # cada contexto com o seu próprio proxy
        page = context.new_page()
        page.goto("https://httpbin.org/ip")
        print(proxy["server"], page.inner_text("body"))
        context.close()  # cookies e cache são apagados junto com o contexto
    browser.close()
Ao executar este exemplo com dois proxies locais diferentes, a requisição de cada contexto ficou registrada no log do seu próprio proxy, e um terceiro contexto sem proxy se conectou diretamente. Guias antigos dizem que, no Windows, para o Chromium, é preciso escrever na chamada launch() um proxy de preenchimento como http://per-context. Era uma limitação de versões antigas do Playwright e foi removida do código em agosto de 2024; a documentação atual também já não traz essa nota. Com o Playwright 1.63 no Windows 11, o exemplo funcionou sem proxy de preenchimento.
Nível do navegador (launch) | Nível do contexto (new_context) | |
|---|---|---|
| Alcance | Todos os contextos e páginas | Apenas aquele contexto |
| IPs diferentes em um só navegador | Não | Sim, um proxy por contexto |
| Para trocar de proxy | Você fecha o navegador e abre de novo | Você fecha o contexto e abre outro |
| Cookies e sessão | Os contextos continuam separados | São isolados junto com o proxy |
| Indicado para | Scripts e testes para os quais basta um ponto de saída | Muitas sessões independentes, comparação entre países |
A regra prática é esta: uma sessão, um contexto, um IP. Não há como trocar o proxy dentro do mesmo contexto, e é bom que seja assim; uma sessão cujos cookies permanecem enquanto o IP muda é, para o site de destino, um visitante incoerente.
O Playwright funciona com proxy SOCKS5?
Funciona, mas sem usuário e senha. Se você informar em server um endereço com o esquema socks5:// e acrescentar username, o Playwright devolve este erro sem nem iniciar o navegador:
BrowserType.launch: Browser does not support socks5 proxy authenticationA mesma verificação vale para new_context(). A causa é o próprio Chromium: a documentação de proxy do Chromium afirma de forma expressa que nenhum método de autenticação é suportado para SOCKSv5. Testamos isso no dia da redação com um servidor SOCKS5 local. O único método que o Chromium ofereceu na mensagem de negociação foi 0x00, ou seja, "sem autenticação"; o método de usuário e senha (0x02) da RFC 1929 não estava na lista. Embutir as credenciais no endereço (socks5://user:pass@...) também não mudou o resultado: o Playwright descartou essa parte e, como o servidor exigia autenticação, a conexão foi encerrada com net::ERR_SOCKS_CONNECTION_FAILED. Em um servidor SOCKS5 que não pedia autenticação, a página abriu sem problemas.
A solução é comprovar a sua identidade com o endereço IP, e não com senha. Você adiciona o IP de saída do servidor onde o script roda à whitelist de IP no painel do proxy e informa apenas o campo server:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    # Sem usuário nem senha: o seu IP de saída precisa estar na whitelist de IP do painel
    browser = p.chromium.launch(proxy={"server": "socks5://pr.proxynet.io:1080"})
    page = browser.new_page()
    page.goto("https://httpbin.org/ip")
    print(page.inner_text("body"))
    browser.close()
Nos nossos registros de teste, o Chromium enviou ao servidor SOCKS5 o nome de domínio, e não um endereço IP; ou seja, a resolução de DNS é feita do lado do proxy, e a distinção socks5h:// conhecida do cURL não é necessária aqui. Para abrir páginas, um proxy HTTP quase sempre basta, porque o tráfego HTTPS já viaja por um túnel CONNECT. Quando vale a pena preferir SOCKS5 está explicado em Diferença entre SOCKS e HTTP proxy: qual escolher?; o produto está na página de Proxies SOCKS5.
Rotativo ou sticky: qual para cada trabalho?
Um navegador não se comporta como um script que envia uma única requisição HTTP. Enquanto uma página carrega, são abertas conexões separadas com domínios diferentes para o documento principal, os scripts, as folhas de estilo, as imagens e as chamadas de API. Em um gateway que troca o IP de saída a cada conexão, essas conexões podem sair por IPs diferentes. Ao varrer páginas independentes entre si, isso não é um problema. Já em fluxos com login, carrinho ou formulário de várias etapas, a troca de IP no meio da sessão pode levar o site a encerrá-la.
- Páginas independentes (lista de produtos, categoria, resultado de busca): Proxies rotativos é adequado. A rotação é feita pelo gateway, e você não mantém uma lista de proxies no código. Como a rotação funciona está no nosso artigo sobre rotação de IP.
- Fluxos que exigem sessão (login com a sua própria conta, operação de várias etapas): com Proxies de sessão fixa, o mesmo IP é mantido durante toda a vida do contexto. Você obtém os dados da sessão sticky no painel e os escreve no campo
proxydo contexto. - Conteúdo que muda conforme o país: você abre um contexto por país e informa o ponto de saída daquele país; um único navegador, comparação lado a lado.
Dar um proxy por contexto já é, por si só, um esquema de rotação: ao fechar o contexto e abrir outro, os cookies e o IP se renovam juntos.
Como reduzir o tráfego bloqueando imagens e fontes?
O tráfego de Proxies residenciais é cobrado por GB, e um navegador baixa tudo o que um cliente HTTP simples não baixa: imagens de produto, fontes web, vídeos. Se o que você precisa é o preço e o título, não faz sentido pagar por esses bytes. O mecanismo route do Playwright intercepta a requisição antes que ela saia para a rede, e você pode cancelá-la conforme o tipo de recurso.
from playwright.sync_api import sync_playwright

BLOCKED = {"image", "media", "font"}


def filter_resources(route):
    if route.request.resource_type in BLOCKED:
        route.abort()
    else:
        route.continue_()


with sync_playwright() as p:
    browser = p.chromium.launch(proxy={
        "server": "http://pr.proxynet.io:8000",
        "username": "user",
        "password": "pass",
    })
    page = browser.new_page()
    page.route("**/*", filter_resources)
    page.goto("https://books.toscrape.com/")
    print(page.locator("article.product_pod h3 a").first.get_attribute("title"))
    browser.close()
O tamanho do ganho varia conforme a página; dar um percentual geral seria enganoso. Para medir no seu próprio destino, abra a mesma página com filtro e sem filtro e compare o contador de tráfego no painel do proxy. Dois avisos: bloquear as folhas de estilo (stylesheet) e os scripts (script) pode impedir que a página gere o seu conteúdo, então limite a lista a imagens, mídia e fontes. Esta técnica é um método de economia; ela não é usada para remover os scripts de proteção de um site.
A economia maior costuma estar dentro do tráfego que o navegador escuta. Páginas dinâmicas geralmente buscam os dados em um endpoint JSON, e o Playwright permite ler essa resposta diretamente:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(proxy={
        "server": "http://pr.proxynet.io:8000",
        "username": "user",
        "password": "pass",
    })
    page = browser.new_page()
    with page.expect_response("**/api/quotes?page=1") as info:
        page.goto("https://quotes.toscrape.com/scroll")
    data = info.value.json()
    for quote in data["quotes"][:3]:
        print(quote["author"]["name"], "-", quote["text"][:60])
    browser.close()
Em vez de analisar o HTML com seletores, você recebe dados estruturados. Se o endpoint não exigir credenciais, o passo seguinte pode ser abandonar o navegador por completo e chamar esse endereço com um cliente HTTP simples.
Como verificar se o proxy está funcionando?
Três verificações bastam:
- Abra
https://httpbin.org/ipcom o Playwright e compare o IP retornado com o seu. Se for diferente, o tráfego está passando pelo proxy. - Abra o mesmo endereço com um contexto sem proxy. Se os dois resultados forem iguais, o objeto
proxyfoi passado à chamada errada ou o domínio entrou na listabypass. - Se o seu alvo é um país, confira a localização do IP em um serviço de geolocalização. Por que os bancos de dados divergem entre si está explicado em Por que meu IP mostra outra localização? O que ele revela.
Testar o proxy fora do Playwright mostra se o problema está no código ou na rede. Os testes pela linha de comando estão em Seu proxy está funcionando? Como testar um proxy.
Exemplo completo: contextos simultâneos, novas tentativas e bloqueio de recursos
O script abaixo varre seis páginas geradas com JavaScript. Ele mantém no máximo três contextos abertos ao mesmo tempo, usa um contexto e uma conexão de proxy limpos a cada tentativa, bloqueia imagens e fontes e tenta de novo, nos erros transitórios, com espera exponencial e um componente aleatório. Nos erros que indicam que o proxy não foi alcançado, ele não tenta de novo, porque o que resolve essa situação não é esperar, e sim corrigir a configuração.
import asyncio
import random

from playwright.async_api import Error, async_playwright

PROXY = {
    "server": "http://pr.proxynet.io:8000",
    "username": "user",
    "password": "pass",
}
URLS = [f"https://quotes.toscrape.com/js/page/{n}/" for n in range(1, 7)]
BLOCKED = {"image", "media", "font"}
CONCURRENCY = 3  # contextos abertos ao mesmo tempo
ATTEMPTS = 3
# Erros em que tentar de novo não muda o resultado: primeiro corrija a configuração
FATAL = ("ERR_PROXY_CONNECTION_FAILED", "ERR_TUNNEL_CONNECTION_FAILED", "ERR_SOCKS_CONNECTION_FAILED")


async def filter_resources(route):
    if route.request.resource_type in BLOCKED:
        await route.abort()
    else:
        await route.continue_()


async def scrape(browser, url, limit):
    async with limit:
        for attempt in range(ATTEMPTS):
            context = await browser.new_context(proxy=PROXY)  # sessão limpa a cada tentativa
            try:
                page = await context.new_page()
                await page.route("**/*", filter_resources)
                response = await page.goto(url, timeout=30_000)
                if response is None or response.status >= 400:
                    raise Error(f"HTTP {response.status if response else 'sem resposta'}")
                quotes = page.locator("div.quote span.text")
                await quotes.first.wait_for(timeout=10_000)  # espera o JavaScript gerar o conteúdo
                return url, await quotes.all_inner_texts()
            except Error as exc:  # TimeoutError também deriva de Error
                if any(code in str(exc) for code in FATAL):
                    raise
                if attempt == ATTEMPTS - 1:
                    raise
                await asyncio.sleep(2**attempt + random.random())
            finally:
                await context.close()


async def main():
    async with async_playwright() as p:
        browser = await p.chromium.launch()
        limit = asyncio.Semaphore(CONCURRENCY)
        results = await asyncio.gather(
            *(scrape(browser, url, limit) for url in URLS), return_exceptions=True
        )
        await browser.close()
    for url, result in zip(URLS, results):
        if isinstance(result, Exception):
            print(url, "ERRO:", str(result).splitlines()[0])
        else:
            print(url, len(result[1]), "citações")


asyncio.run(main())
No nosso proxy local de teste, as seis páginas voltaram com dez citações cada; quando escrevemos a porta do proxy errada de propósito, o script parou com ERR_PROXY_CONNECTION_FAILED sem tentar de novo. Em um trabalho real, faça dois acréscimos. A lógica de nova tentativa que respeita o cabeçalho Retry-After nas respostas 429 e 503 está no exemplo de Códigos de status HTTP no web scraping: 403, 407, 429, 503; não a repetimos aqui. Ajuste também a concorrência à memória: cada contexto e cada página consomem memória, então comece com um valor baixo em CONCURRENCY e aumente enquanto observa o seu servidor. O detalhe das estratégias de espera (por que se espera um elemento, e não networkidle) está no artigo sobre páginas estáticas e dinâmicas citado acima.
Tabela de erros: ERR_PROXY_CONNECTION_FAILED, ERR_TUNNEL_CONNECTION_FAILED, 407
Provocamos de propósito cada uma das linhas abaixo no proxy local de teste.
| O que você vê | O que significa | O que fazer |
|---|---|---|
net::ERR_PROXY_CONNECTION_FAILED | Não foi possível abrir a conexão TCP com o servidor proxy: endereço ou porta errados, ou um firewall está cortando a saída | Confira o valor de server e a porta, teste o mesmo endereço com cURL |
net::ERR_TUNNEL_CONNECTION_FAILED | O proxy foi alcançado, mas a requisição CONNECT recebeu uma resposta diferente de 200: a autenticação foi recusada (407) ou o proxy não chegou ao destino (502) | Confira primeiro as credenciais, depois o endereço de destino |
Tempo esgotado no goto em endereço HTTPS, 407 no log do proxy | Usuário ou senha errados, ou não informados. No nosso teste, o evento requestfailed informou ERR_TUNNEL_CONNECTION_FAILED, mas o goto esperou até o tempo esgotar em vez de lançar um erro | Veja o erro real com page.on("requestfailed") e corrija os campos username e password |
Código de resposta 407 em endereço HTTP (sem criptografia) | A mesma causa; como não há túnel, a resposta do proxy chega como resposta da página | Confira response.status e corrija as credenciais |
Browser does not support socks5 proxy authentication | username foi informado junto com um endereço socks5:// | Remova as credenciais e use a whitelist de IP, ou passe para um proxy HTTP |
net::ERR_SOCKS_CONNECTION_FAILED | O servidor SOCKS5 exige autenticação ou o seu IP não está na whitelist | Adicione o seu IP de saída à lista no painel |
| A página abre, mas o IP é o seu | O objeto proxy não chegou a ser aplicado ou o domínio está na lista bypass | Confirme que você passou o objeto à chamada launch ou new_context |
A terceira linha é a que mais faz perder tempo: o script não dá erro, apenas espera trinta segundos até o tempo esgotar, e o problema é atribuído à lentidão do site de destino. Acrescentar estas duas linhas durante o desenvolvimento encurta o diagnóstico:
page.on("requestfailed", lambda r: print("FALHOU:", r.url, r.failure))
page.on("response", lambda r: print(r.status, r.url) if r.status >= 400 else None)
O significado geral do código 407 e como ele aparece em outras bibliotecas está no nosso artigo sobre códigos de status HTTP; para erros do tipo "o servidor proxy não está respondendo" fora da automação de navegadores, consulte o nosso artigo sobre erros de proxy e a mensagem "o servidor proxy não está respondendo".
Casos de uso
- Páginas dinâmicas de lojas e catálogos: dados de preço e estoque carregados com JavaScript. A visão geral está na nossa página de solução de extração de dados.
- Varredura periódica de muitas páginas: a descoberta de páginas e o gerenciamento de filas estão na página de solução de web crawler; os padrões de paginação, no nosso artigo sobre paginação no web scraping.
- Testes do seu aplicativo a partir de diferentes países: um contexto por país, cada um com o ponto de saída daquele país. Os detalhes estão na página de testes de aplicativos.
- Monitoramento de preços da concorrência: uma varredura diária, com bloqueio de recursos e que respeita os limites de taxa. O lado de negócio está no nosso artigo sobre monitoramento de preços da concorrência no e-commerce.
Seja qual for o trabalho, a moldura é a mesma: respeite as regras do robots.txt e os termos de uso do site, prefira a API oficial se ela existir e mantenha o ritmo de requisições em um nível que o site suporte. Como ler um arquivo robots.txt está em O que é robots.txt e como ler o arquivo?.
Erros comuns
- Embutir as credenciais no endereço de
server. O Playwright ignora essa parte; o resultado é um407ou tempo esgotado. - Tentar usuário e senha com SOCKS5. O Chromium não oferece suporte; use a whitelist de IP ou um proxy HTTP.
- Iniciar um navegador novo para cada página. O navegador abre uma vez; o isolamento e a troca de proxy são feitos com contextos.
- Passar um fluxo com sessão por um gateway rotativo. As conexões saem por IPs diferentes e a sessão cai. Use sticky.
- Não fechar os contextos. Cada contexto aberto segura memória; feche-o no bloco
finally. - Bloquear scripts e folhas de estilo. A página não consegue gerar o conteúdo e o seu seletor volta vazio.
- Atribuir ao site de destino o tempo esgotado no
goto. Olhe antes o eventorequestfailede as credenciais do proxy. - Aceitar uma resposta
200sem olhar o conteúdo. Confirme que o elemento esperado está na página; telas de verificação também podem devolver200.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Script ou teste para o qual basta um ponto de saída | launch(proxy=...), proxy HTTP |
| Várias sessões independentes em um só navegador | new_context(proxy=...), um proxy por contexto |
| Varredura em massa de páginas independentes | Proxy rotativo, um único endereço de gateway |
| Fluxo de várias etapas com login | Proxy sticky, um contexto, um IP |
| SOCKS5 é obrigatório | Whitelist de IP, sem username nem password |
| Tráfego cobrado por GB | Bloqueie as requisições de imagens, mídia e fontes com route; se possível, leia a resposta JSON |
| Dados no código-fonte da página ou em um endpoint JSON | Cliente HTTP simples em vez do Playwright |
| Fazer um agente de IA usar um navegador | Playwright MCP |
Perguntas frequentes
O Playwright é gratuito?
Sim. É um projeto de código aberto com licença Apache 2.0; não se paga pela biblioteca nem pelos binários de navegador que ela baixa. O custo vem dos recursos de servidor consumidos pelos navegadores e do tráfego de proxy que você usa.
É melhor usar o Playwright com Python ou com Node.js?
A configuração do proxy e o comportamento do navegador são iguais nas duas linguagens, porque ambas falam com o mesmo driver. O que deve decidir é a linguagem da sua equipe e do seu fluxo de processamento de dados. A comparação das duas linguagens do ponto de vista do scraping está em Extração de dados: JavaScript ou Python?.
Posso usar um proxy diferente para cada página?
O proxy é vinculado ao contexto, não à página. Se você quer um IP diferente para cada página, abra cada página no seu próprio contexto. Se usa um gateway rotativo, nem isso é necessário; a rotação é feita pelo gateway.
A autenticação SOCKS5 funciona com Firefox ou WebKit?
Quando um usuário é informado junto com um endereço socks5://, o Playwright lança o erro na sua própria etapa de validação, antes de iniciar o navegador, e essa verificação não olha o tipo de navegador. Nós testamos apenas com o Chromium; para os outros motores, considere também a whitelist de IP.
O proxy se comporta de outra forma no modo headless?
Não. O objeto proxy é aplicado da mesma forma com janela e sem janela. Se quiser ver o problema com os próprios olhos, você pode abrir a janela com launch(headless=False) e executar o mesmo script.
Usar um proxy faz as telas de verificação desaparecerem?
Não. O proxy muda apenas o IP pelo qual a requisição sai; o ritmo de requisições, os sinais do navegador e a coerência da sessão continuam os mesmos. Por que essas telas aparecem está explicado em Puppeteer e CAPTCHA: por que aparece, como reduzir?; o que é dito lá vale também para o Playwright. Não recomendamos extensões para burlar a detecção: o caminho duradouro é um ritmo razoável, uma sessão coerente e, se existir, a API oficial.
Em resumo
No Playwright, o proxy é um único objeto: server, username, password. Se você o passa à chamada launch(), o navegador inteiro sai pelo proxy; se o passa a new_context(), apenas aquela sessão. O segundo caminho significa um IP diferente por contexto em um só navegador. As credenciais não são escritas dentro do endereço, com SOCKS5 usa-se a whitelist de IP no lugar da senha, em fluxos com sessão escolhe-se sticky e, em páginas independentes, rotativo. Se você paga o tráfego por GB, bloqueie imagens e fontes; se vir tempo esgotado, olhe primeiro o evento requestfailed. Os tipos de proxy adequados ao seu trabalho estão em nossos serviços de proxy.


