


































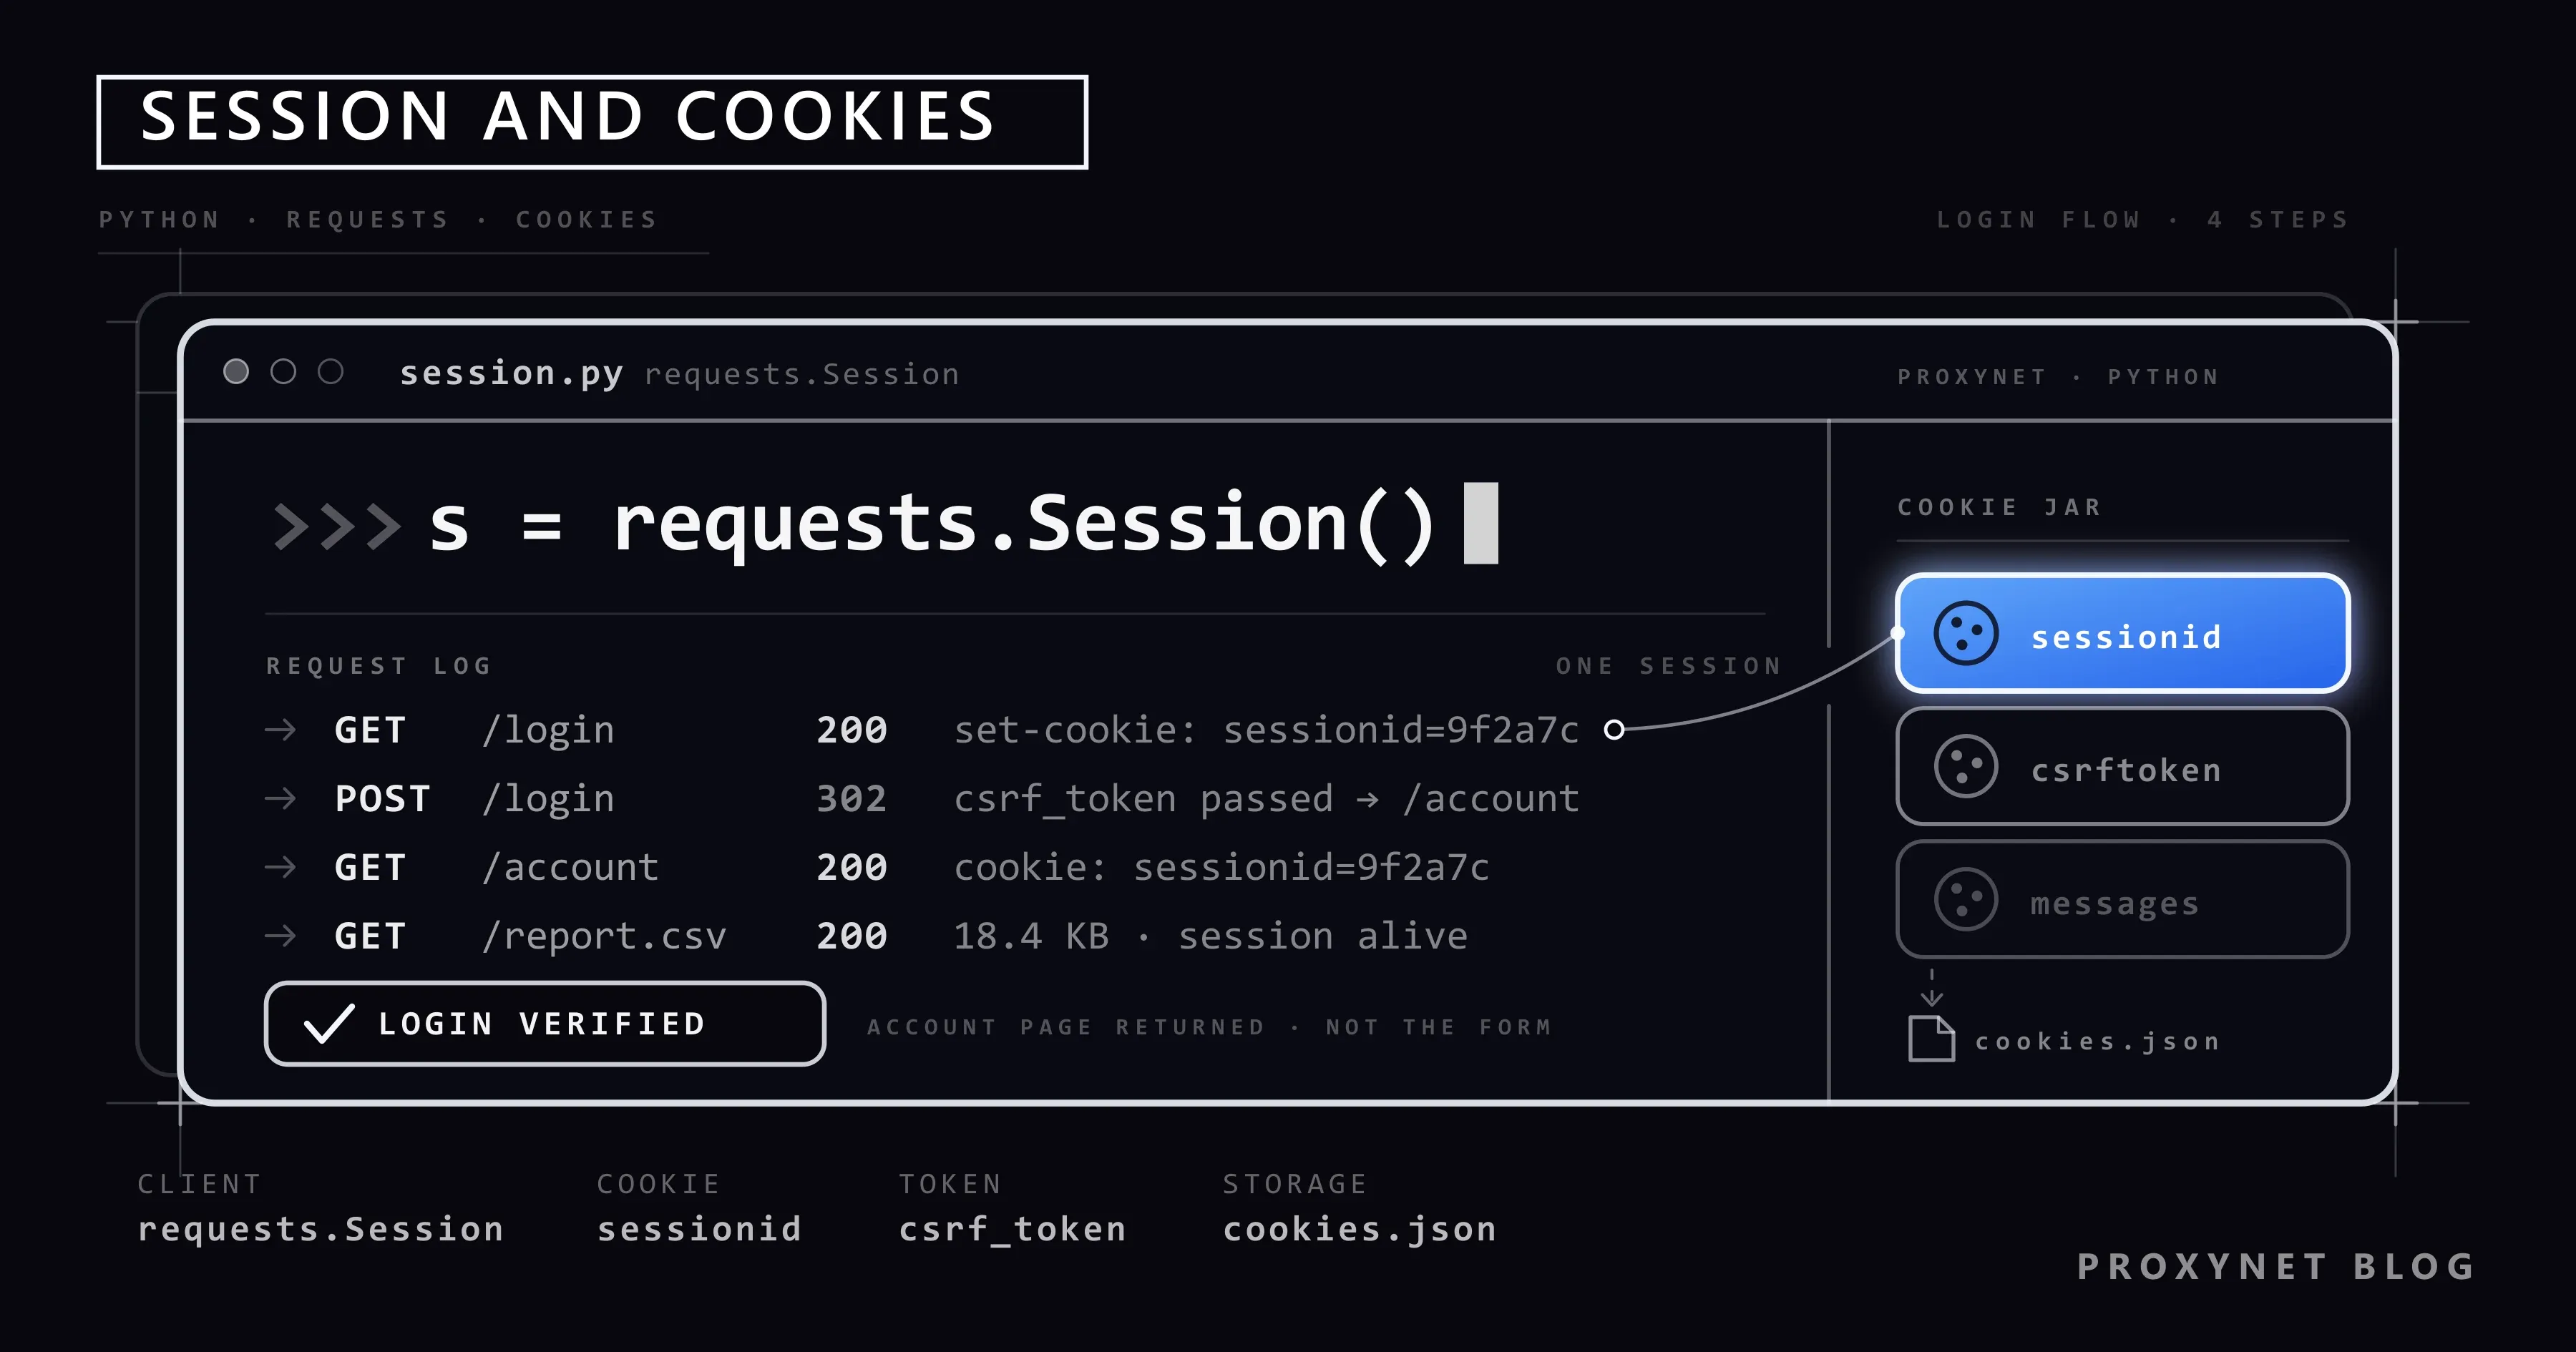
Toda manhã você entra na mão no painel da sua própria empresa e baixa um relatório. O painel tem botão de exportação, não tem API oficial e os mesmos cinco cliques se repetem todo dia. Na hora de passar isso para um script Python, a primeira parede é a página de login: o que requests.get() baixa não é o relatório, é o formulário de login. O HTTP é um protocolo sem estado e o servidor só reconhece você por um cookie que você anexa a cada requisição.
Neste artigo explicamos o que são cookies e sessões, por que o token CSRF é lido de novo a cada execução e como se monta um fluxo de login com requests.Session. Depois tratamos de gravar a sessão em disco, renová-la quando expira, tirar as credenciais do código e ficar no mesmo IP de saída durante toda a sessão. No fim vem o método storage_state do Playwright, para sites que enviam o formulário com JavaScript. Os exemplos de código foram testados contra quotes.toscrape.com.
A quais logins este artigo se aplica?
Tudo aqui se apoia em uma única premissa: a conta em que você entra é sua, ou o titular dela deu permissão por escrito. O painel administrativo da sua própria empresa, a sua própria conta de loja, um sistema de cliente que pediu por escrito "puxem esse relatório para nós todo dia". O que estiver fora disso não é assunto deste artigo.
Três perguntas antes do código:
- Existe uma API oficial ou uma exportação? Se existe, não automatize a interface. Uma chave de API é estável e não quebra quando a interface muda; automatizar o login é o caminho para quando não há outro jeito de chegar ao dado. O lado jurídico tratamos em Web scraping é legal? Um panorama.
- O que dizem os termos de uso do site? Se alguma cláusula proíbe acesso automatizado, sua conta pode ser suspensa. Ser tecnicamente possível não significa ser permitido.
- A sua permissão está por escrito? Em trabalho para cliente, aprovação verbal não basta. Com qual conta, de quais páginas e com que frequência você vai extrair dados precisa estar em contrato ou em e-mail.
Quatro coisas não são explicadas aqui de propósito:
- Nada de testar senhas. Código que joga uma lista no campo do formulário (credential stuffing) ou que gera combinações (força bruta) não aparece aqui. Não faça isso: o acesso não autorizado à conta de outra pessoa é crime em qualquer país, e a possibilidade técnica não muda nada.
- Nada de contornar verificação em duas etapas ou CAPTCHA. Esses controles existem para proteger a conta; tentar passar por eles com um script reduz a segurança justamente da conta com que você trabalha. Se a sua conta tem 2FA ativo, o caminho certo é a chave de API ou a senha de aplicativo do fornecedor; se não existe nenhum dos dois, esse trabalho não vai ser automatizado.
- Nada de conta alheia. "A conta de um amigo", "a conta de quem saiu da empresa" e credenciais compartilhadas na internet entram nessa lista.
- Nada de roubar ou transportar cookie de sessão. Uma sessão aberta com um cookie copiado do navegador de outra pessoa é falsidade de identidade. Os arquivos de cookie deste artigo são gerados apenas com o seu próprio login e ficam apenas na sua máquina.
Uma distinção ainda é necessária por causa da semelhança dos nomes: autenticar-se em um servidor proxy (user:pass ou autorização por IP) e fazer login no site de destino são dois trabalhos diferentes. O primeiro está em Autenticação de proxy: user:pass ou whitelist de IP; aqui falamos do segundo.
O que são cookies e sessões?
O HTTP não guarda estado: o servidor não lembra de nada que ligue duas requisições. Os cookies preenchem essa lacuna. O servidor coloca um cabeçalho Set-Cookie na resposta, o cliente guarda o valor e o devolve com um cabeçalho Cookie nas requisições seguintes ao mesmo domínio. Todos os atributos do cabeçalho estão explicados um a um na página Set-Cookie do MDN.
"Sessão" é o que dá sentido a esse cookie. Há dois desenhos comuns:
- Sessão do lado do servidor. No cookie viaja apenas um identificador aleatório (
sessionid,PHPSESSID,JSESSIONID); quem é o usuário fica em um registro no servidor. Se o servidor apaga esse registro, a sessão acaba mesmo com o cookie ainda na sua mão. - Cookie assinado. A informação do usuário está dentro do cookie e o servidor a assina com uma chave secreta. O cookie
sessionpadrão do Flask funciona assim.
Quanto tempo um cookie vive é definido por Expires e Max-Age. A seção 4.1.2.2 da RFC 6265 diz que, se um cookie não tem nem Max-Age nem Expires, o cliente o mantém até "a sessão atual terminar". No navegador isso significa "até você fechar o navegador"; em um script Python, "enquanto o processo viver". Então não estranhe se o seu script faz login de novo a cada execução: o cookie que ele guardou nunca foi persistente.
A quais requisições um cookie é anexado é decidido por estes atributos do cabeçalho Set-Cookie:
| Atributo | O que faz | O que significa no script |
|---|---|---|
Domain | Para qual domínio o cookie vai | Um cookie de painel.exemplo.com não é anexado a uma requisição para exemplo.com |
Path | Sob qual caminho ele vale | Um cookie em /relatorio não é enviado em uma requisição para / |
Secure | Enviado apenas por HTTPS | Uma requisição que cai para HTTP não leva o cookie |
HttpOnly | O JavaScript da página não consegue ler | Você não o vê com document.cookie no console do navegador; um cliente HTTP vê |
SameSite | Se é anexado a requisições vindas de outro site | Com Strict, a primeira requisição vinda de um link externo parece sem sessão |
Essa tabela não é teoria, é uma lista de diagnóstico: a maior parte dos relatos do tipo "o login parece ter dado certo, mas a próxima requisição cai de novo na página de login" vem de divergência de Domain ou de Path.
O que é o token CSRF e por que ele é lido toda vez?
Enquanto a sua sessão está aberta em uma página de banco, um formulário escondido em outro site pode enviar uma requisição em seu nome. Como o navegador anexa o cookie automaticamente, o servidor entende aquilo como requisição sua. Isso se chama falsificação de requisição entre sites (CSRF).
A defesa mais comum é o método que a página de prevenção de CSRF da OWASP chama de "token sincronizador": o servidor embute em cada página de formulário um valor aleatório ligado àquela sessão, como campo oculto. Ao enviar o formulário, esse valor precisa bater com o correspondente no cookie de sessão. Um formulário em outro site não tem como conhecer o token da sua sessão, então a verificação falha.
Para quem escreve o script, isso tem três consequências:
- O token não é fixo. Se você copiar do navegador uma vez e deixar no código, no dia seguinte não funciona. A cada execução é preciso baixar a página de login e ler o campo de lá.
- O token está preso à sessão. Enviar o token em uma requisição e o formulário por outra conexão não adianta. Os dois têm que passar pelo mesmo objeto
Session; essa é justamente a primeira razão para usar umaSession. - O nome do campo muda conforme o site.
csrf_token,csrfmiddlewaretoken(Django),authenticity_token(Rails) e_token(Laravel) fazem o mesmo trabalho. Olhe o código-fonte do formulário antes de escrever código.
Em aplicações que esperam o token em um cabeçalho (X-CSRF-Token) em vez de campo oculto, o valor continua saindo da página, mas vai para o dicionário headers e não para o corpo.
Qual caminho escolher?
Para um trabalho atrás de um login há três caminhos, e o formulário do site decide qual deles.
| Caminho | Quando | Custo | Ponto fraco |
|---|---|---|---|
requests.Session | O formulário é HTML puro e os campos aparecem na página | O mais baixo, sem navegador | Não enxerga campos gerados por JavaScript |
storage_state do Playwright | O formulário é enviado por JavaScript ou o token é gerado por script | Alto, abre um navegador real | Memória e tempo, custo de instalação |
| Híbrido: entrar com o navegador e seguir por HTTP | O login é complexo, mas as páginas de dados são HTML puro | Navegador uma vez, depois barato | Os cookies passam entre dois ambientes, o IP precisa ser o mesmo |
Faça a escolha olhando o código-fonte da página, não no chute: se dentro de um <form method="post"> você vê campos input com name, requests basta. Se os campos estão vazios ou o formulário é enviado com fetch(), vá para o segundo ou o terceiro caminho.
Como fazer login com requests.Session?
São cinco passos e a ordem importa: os quatro primeiros são o login em si, o quinto é para as execuções seguintes.
- Baixe a página de login com
GET. Essa resposta traz duas coisas: um cookie de sessão ainda anônimo e o token CSRF do formulário. ASessionguarda o cookie no próprio pote. - Leia de fato os campos do formulário. Preencha o formulário no navegador, envie e olhe o corpo da requisição na aba Rede das ferramentas de desenvolvedor. Nomes de campo não se adivinham, se copiam de lá; se houver um campo oculto
nextouredirect, envie também. - Mande o
POSTcom a mesmaSession. O cookie é anexado sozinho. Se o atributoactiondo formulário aponta para outro caminho, envie a requisição para lá. - Verifique o login pelo conteúdo. O código de status engana: muitas aplicações devolvem
200também com senha errada e reexibem o formulário com uma mensagem de erro. O critério é um elemento que só aparece com a sessão aberta: um link de saída, o nome de usuário, um menu de conta. - Guarde os cookies. A execução seguinte pula o passo do login.
Segundo a seção Session Objects da documentação do Requests, além de manter os cookies durante a vida da instância, uma Session também reaproveita a conexão TCP para requisições ao mesmo host. O padrão é igual nas três bibliotecas do Comparativo entre HTTPX, Requests e AIOHTTP; só muda o nome da classe.
Um exemplo que roda: quotes.toscrape.com
O código abaixo foi testado contra quotes.toscrape.com/login. É um site de treino aberto, montado para praticar web scraping, e aceita qualquer nome de usuário e qualquer senha que você digitar; ele não faz autenticação nenhuma, só imita o fluxo. Ver o mecanismo lá primeiro evita que você produza uma sequência de logins falhos na sua própria conta.
Primeiro o fluxo central, em quatro passos:
import os

import requests
from bs4 import BeautifulSoup

BASE_URL = "https://quotes.toscrape.com"

session = requests.Session()

# 1) Peca o formulario de login: o cookie de sessao e o token CSRF vem nesta resposta
page = session.get(f"{BASE_URL}/login", timeout=20)
page.raise_for_status()
token = BeautifulSoup(page.text, "html.parser").select_one('input[name="csrf_token"]')["value"]

# 2) As credenciais nao ficam no codigo, sao lidas de variaveis de ambiente
payload = {
    "csrf_token": token,
    "username": os.environ["SITE_USERNAME"],
    "password": os.environ["SITE_PASSWORD"],
}

# 3) Envie o formulario com a mesma Session; o cookie a propria Session anexa
result = session.post(f"{BASE_URL}/login", data=payload, timeout=20)
result.raise_for_status()

# 4) Verifique pelo conteudo da pagina, nao pelo codigo de status
if BeautifulSoup(result.text, "html.parser").select_one('a[href="/logout"]') is None:
    raise SystemExit("Nao foi possivel verificar o login")

print("Login feito, cookies:", list(session.cookies.keys()))
Coloque as credenciais no ambiente antes de rodar; escrever a senha no código é escrevê-la também no histórico de versões:
export SITE_USERNAME="usuario"
export SITE_PASSWORD="senha"
python login.py
No Windows PowerShell a forma é $env:SITE_USERNAME = "usuario". Como deixar variáveis de ambiente permanentes para ferramentas de linha de comando está em Uso de proxy com o wget: comandos e exemplos.
Como gravar a sessão em disco e quando renová-la?
Fazer login a cada execução enche o log de segurança da sua conta com registros inúteis; em algumas aplicações, logins repetidos em pouco tempo ainda disparam uma verificação extra. A solução é gravar o pote de cookies em um arquivo e recarregá-lo na execução seguinte.
O script completo abaixo faz isso: carrega os cookies salvos se existirem, faz login se não existirem, verifica a cada requisição se a sessão continua aberta e, se ela caiu, faz login de novo uma única vez. Ser uma única vez importa: um laço sem condição vira uma sequência infinita de tentativas de login quando o problema está na credencial.
import json
import os
import time
from pathlib import Path

import requests
from bs4 import BeautifulSoup

BASE_URL = "https://quotes.toscrape.com"
COOKIE_FILE = Path("session_cookies.json")
DELAY_SECONDS = 2.0


class LoginError(Exception):
    """O login nao foi concluido; veja a causa em vez de tentar de novo."""


def build_session():
    session = requests.Session()
    session.headers["User-Agent"] = "script-relatorio/1.0 (contato: voce@exemplo.com)"
    proxy_url = os.environ.get("PROXY_URL")  # ex.: http://user:pass@pr.proxynet.io:8000
    if proxy_url:
        session.proxies = {"http": proxy_url, "https": proxy_url}
    return session


def save_cookies(session, path=COOKIE_FILE):
    cookies = [
        {"name": c.name, "value": c.value, "domain": c.domain, "path": c.path,
         "expires": c.expires, "secure": c.secure}
        for c in session.cookies
    ]
    path.write_text(json.dumps(cookies), encoding="utf-8")
    try:
        path.chmod(0o600)  # o arquivo e tao sensivel quanto uma senha; no Windows o efeito e limitado
    except OSError:
        pass


def load_cookies(session, path=COOKIE_FILE):
    if not path.exists():
        return False
    try:
        cookies = json.loads(path.read_text(encoding="utf-8"))
    except json.JSONDecodeError:
        return False
    now = time.time()
    for c in cookies:
        if c["expires"] and c["expires"] < now:
            continue  # nunca carregue um cookie expirado
        session.cookies.set(c["name"], c["value"], domain=c["domain"], path=c["path"],
                            expires=c["expires"], secure=c["secure"])
    return True


def is_logged_in(html):
    return BeautifulSoup(html, "html.parser").select_one('a[href="/logout"]') is not None


def login(session):
    page = session.get(f"{BASE_URL}/login", timeout=20)
    page.raise_for_status()
    field = BeautifulSoup(page.text, "html.parser").select_one('input[name="csrf_token"]')
    if field is None:
        raise LoginError("Sem campo csrf_token no formulario; a pagina pode ter mudado")
    payload = {
        "csrf_token": field["value"],
        "username": os.environ["SITE_USERNAME"],
        "password": os.environ["SITE_PASSWORD"],
    }
    result = session.post(f"{BASE_URL}/login", data=payload, timeout=20)
    result.raise_for_status()
    if not is_logged_in(result.text):
        raise LoginError("Login nao verificado; confira as credenciais e os campos do formulario")
    save_cookies(session)


def get_page(session, path):
    """Busca a pagina; se a sessao caiu, faz login de novo uma unica vez."""
    for attempt in range(2):
        response = session.get(f"{BASE_URL}{path}", timeout=20)
        response.raise_for_status()
        if is_logged_in(response.text):
            return response
        if attempt == 0:
            print("Sessao invalida, fazendo login de novo")
            session.cookies.clear()
            login(session)
    raise LoginError("Sem sessao mesmo apos a segunda tentativa; pare e veja a causa")


def main():
    session = build_session()
    if load_cookies(session):
        print("Cookies salvos carregados")
    else:
        print("Sem sessao salva, fazendo login")
        login(session)

    for number in range(1, 4):
        response = get_page(session, f"/page/{number}/")
        quotes = BeautifulSoup(response.text, "html.parser").select("div.quote")
        print(f"Pagina {number}: {len(quotes)} registros")
        time.sleep(DELAY_SECONDS)


if __name__ == "__main__":
    main()
A primeira execução diz "Sem sessão salva" e faz login; a segunda diz "Cookies salvos carregados" e vai direto aos dados. Três pontos merecem atenção:
- O arquivo de cookies é um segredo. O valor que está nele substitui a senha durante aquela sessão. Coloque o arquivo no
.gitignoree mantenha fora de backups e pastas compartilhadas; a documentação do Playwright faz o mesmo alerta para o arquivo de estado dele. - Não carregue cookie expirado.
load_cookiesdescarta esses olhando o campoexpires; sem isso o script começa com uma sessão inválida. - Descubra pelo conteúdo que a sessão caiu. Algumas aplicações redirecionam para a página de login com
302, outras devolvem o formulário com200. Um critério único comois_logged_inpega os dois casos.
Por que é preciso o mesmo IP durante a sessão?
Parte das aplicações prende a sessão aberta ao endereço IP de onde veio o login, ou à rede desse endereço. Se a próxima requisição chega de outro endereço, a sessão é encerrada, o usuário é levado à página de login ou uma verificação extra é pedida. Isso é uma decisão de segurança, e o objetivo é dificultar o uso de um cookie de sessão roubado em outro lugar.
Em um script que usa proxy, isso significa uma coisa: um pool rotativo quebra a sessão em trabalhos que exigem login. Um proxy rotativo troca o IP de saída a cada requisição ou em intervalos curtos; o endereço de onde você fez login e o endereço de onde baixa o relatório acabam diferentes, e a aplicação não reconhece você. Como a rotação funciona e para quais trabalhos ela é a escolha certa está em O que é rotação de IP e como ela funciona?.
A montagem correta é uma de duas opções:
- Com Proxies de sessão fixa você fica no mesmo IP de saída pelo tempo que definir, entre 1 e 60 minutos. Se a sessão é curta e você solta a conexão ao terminar o trabalho, isso basta.
- Com Proxies ISP o endereço continua o mesmo também de uma execução para outra. Em sistemas que limitam o acesso ao painel a IPs específicos esse é o único caminho, porque você informa o endereço uma vez ao outro lado e pede a inclusão na lista.
O caso de colocar um endereço na lista de permissões de uma API está em IP estático para API: como resolver o erro de autorização, e a justificativa geral para um IP fixo está na seção "IP sticky onde a sessão é necessária" de Como fazer web scraping sem ser bloqueado.
Vamos evitar uma leitura errada: um IP fixo não é ferramenta para contornar controle de segurança. O que ele faz é manter o seu próprio tráfego coerente em uma conta para a qual você já tem autorização. Se a conta não é sua, um IP fixo também não produz acesso legítimo.
Limite de requisições: manter o script educado
Um script logado é mais visível que um anônimo: as suas requisições agora são registradas não contra um endereço IP, mas diretamente contra a sua conta. Respeitar o limite de requisições aqui não é preferência técnica, é parte de proteger a sua conta.
- Comece com uma única thread. Para um relatório por dia, não monte paralelismo.
- Coloque uma espera entre as requisições.
DELAY_SECONDSno script acima é a forma mais simples disso. - Pare quando vir um
429. O cabeçalhoRetry-Afterda resposta diz quanto esperar. O código completo está em 429 Too Many Requests: o que é o erro de rate limit e em Códigos de status HTTP no web scraping: 403, 407, 429, 503. - Apresente-se. Escrever o nome do script e um endereço de contato no campo
User-Agentpermite que quem administra o site fale com você; para que serve o campo está em O que é User-Agent? Como ver e como alterar.
Se o login roda em JavaScript: storage_state do Playwright
Em algumas aplicações o formulário de login não manda um POST clássico: o JavaScript lê os campos, o navegador gera o token e a resposta vem por uma chamada de API. Em uma página assim, o formulário enviado com requests falha em silêncio. É nesse ponto que um navegador de verdade é necessário.
O Playwright consegue gravar o estado da sessão em um único arquivo JSON. Segundo a documentação de autenticação do Playwright, esse arquivo leva juntos os cookies e o localStorage, então também serve em aplicações que guardam a sessão no localStorage em vez de um cookie. Se a aplicação guarda o token no IndexedDB, isso precisa ser pedido à parte: context.storage_state(path=..., indexed_db=True).
import os
from pathlib import Path

from playwright.sync_api import sync_playwright

BASE_URL = "https://quotes.toscrape.com"
STATE_FILE = Path("storage_state.json")
PROXY = {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"}

with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    if STATE_FILE.exists():
        context = browser.new_context(storage_state=STATE_FILE)  # abre com a sessao salva
    else:
        context = browser.new_context()
    page = context.new_page()
    page.goto(BASE_URL)

    if page.locator('a[href="/logout"]').count() == 0:
        page.goto(f"{BASE_URL}/login")
        page.fill("#username", os.environ["SITE_USERNAME"])
        page.fill("#password", os.environ["SITE_PASSWORD"])
        page.click('input[type="submit"]')
        page.wait_for_selector('a[href="/logout"]')  # prova do login
        context.storage_state(path=STATE_FILE)  # cookies e localStorage em um arquivo so
        print("Login feito, estado salvo")
    else:
        print("Sessao aberta com o estado salvo")

    browser.close()
A primeira execução faz login e grava o arquivo; a segunda nem vê o passo do login. A configuração de proxy do Playwright e a instalação do navegador estão detalhadas em O que é Playwright e como usá-lo com proxy; para o equivalente no Selenium, veja Selenium com proxy: configuração em Python e Java.
Daí sai o padrão híbrido: você entra uma vez com o navegador e gera storage_state.json, depois passa os cookies para uma requests.Session e busca os dados pelo caminho barato.
import json
from pathlib import Path

import requests

state = json.loads(Path("storage_state.json").read_text(encoding="utf-8"))
session = requests.Session()
for c in state["cookies"]:
    session.cookies.set(c["name"], c["value"], domain=c["domain"], path=c["path"])
Esse padrão tem uma condição só: tanto o navegador quanto o cliente HTTP que vem depois precisam sair pelo mesmo IP. Se você der proxies diferentes aos dois, a sessão cai na primeira requisição. Qual automação de navegador combina com qual trabalho comparamos em Playwright ou Selenium: qual escolher?.
Casos de uso
- Baixar o relatório diário do próprio painel. O endereço atrás do botão de exportação costuma ser um link direto para um arquivo; enquanto o cookie de sessão durar,
requestsbaixa. A montagem geral está na nossa página de extração de dados. - Monitorar um fluxo que fica atrás do login. Para conferir os passos de login e de carrinho da sua própria aplicação depois de cada deploy; a montagem está na nossa página de testes de aplicativos.
- Transferir dados de um sistema de cliente. Com permissão por escrito e um IP de saída fixo, para que o outro lado possa incluir esse endereço na lista dele.
- Coletar dados de uma lista com várias páginas. Depois do login é um trabalho de paginação comum; o padrão está em O que é paginação e como percorrê-la em web scraping.
Erros comuns e diagnóstico
- Redirecionamento infinito para a página de login. Se a requisição volta a
/logincom302, o cookie ou não está sendo enviado ou é inválido no servidor. Olhe primeiro o conteúdo desession.cookiese depois compare oDomaindo cookie com o endereço chamado. - Usar
requests.getem vez de umaSession. Orequests.get()no nível do módulo abre uma conexão nova e um pote de cookies vazio a cada chamada. Em um fluxo de login isso não funciona. - Verificar o login pelo código de status. Com senha errada também pode vir
200. Procure uma prova no conteúdo. - Deixar o token CSRF escrito no código. Funciona um dia e no outro dá erro de "token inválido".
- Trocar de IP no meio da sessão. Fazer login com um pool rotativo e depois extrair dados é a causa mais frequente de queda de sessão.
- Entrar em laço depois de um login falho. Se a senha está errada, tentar de novo não resolve; em alguns sistemas bloqueia a conta. O script deve parar na primeira falha.
Guia de decisão
| Situação | O que fazer |
|---|---|
| O site tem API oficial | Nem entre na automação de login, use uma chave de API |
| Formulário HTML puro, campos na página | Faça login com requests.Session e salve os cookies em arquivo |
O formulário tem campo oculto tipo csrf_token | Leia da página a cada execução, não deixe no código |
| O formulário é enviado por JavaScript | Faça login com o Playwright e guarde o arquivo storage_state |
| Login complexo, páginas de dados simples | Híbrido: entre com o navegador e passe os cookies para requests |
| A sessão cai no meio do trabalho | Fixe o IP de saída: Proxies de sessão fixa |
| O painel só aceita IPs específicos | Endereço fixo com Proxies ISP |
| A conta tem verificação em duas etapas | Peça uma chave de API ou senha de aplicativo, não tente passar pelo controle |
| A conta não é sua | Pare; obtenha permissão por escrito do titular |
Perguntas frequentes
Qual é a diferença entre sessão e cookie?
O cookie é um pedaço pequeno de dados que o servidor guarda no seu navegador ou cliente e que volta em cada requisição. A sessão é o estado para o qual esse cookie aponta: quem você é, desde quando está logado, quais permissões tem. No lado do Python, requests.Session é o objeto que une os dois; guarda os cookies e os carrega entre as requisições.
Fiz login, mas a próxima requisição cai de novo na página de login, por quê?
Há três causas comuns. A primeira: você mandou a requisição de login fora da Session e o cookie se perdeu. A segunda: o Domain ou o Path do cookie não bate com o endereço chamado. A terceira: a aplicação prendeu a sessão a um IP e, por causa de um proxy rotativo, a segunda requisição saiu de outro endereço.
Posso pegar o token CSRF uma vez e guardar?
Não. O token está preso à sessão e muda quando a sessão é renovada. A cada execução é preciso baixar a página de login e ler o campo de lá. O que se guarda não é o token, é o cookie de sessão que chega depois do login.
Extrair dados de um site protegido por senha é crime?
O que decide não é o site pedir senha, e sim se você tem autorização de acesso àquela conta. Puxar os seus próprios dados da sua própria conta é uso comum; entrar com credencial de outra pessoa é acesso não autorizado e é crime em qualquer país. Se os termos de uso proíbem acesso automatizado, você descumpre o contrato mesmo na sua própria conta. O detalhe está em Web scraping é legal? Um panorama.
Por quanto tempo um cookie de sessão vale?
Depende da aplicação. Um cookie sem Max-Age nem Expires acaba quando o cliente fecha. Os que têm prazo podem viver de algumas horas a algumas semanas, mas quando o servidor apaga o registro do lado dele, a sessão acaba mesmo com o cookie ainda na sua mão. Por isso um script verifica "a sessão continua aberta?" em vez de "já expirou?".
Posso trocar de proxy depois de fazer login?
Melhor não. Se o IP que abriu a sessão e o IP de onde saem as requisições seguintes são diferentes, a aplicação pode encerrar a sessão ou pedir verificação extra. Se você usa navegador e cliente HTTP no mesmo trabalho, dê o mesmo proxy para os dois.
Em resumo
O núcleo técnico de um trabalho atrás de um login é pequeno: requests.Session carrega os cookies, o token CSRF lido da página de login entra no formulário, o resultado é verificado pelo conteúdo da página e não pelo código de status, e a sessão é gravada em arquivo e passada para a execução seguinte. Em sites que enviam o formulário por JavaScript, o arquivo storage_state do Playwright faz o mesmo serviço. Para a sessão não cair, o IP de saída não pode mudar enquanto ela durar; para isso existem Proxies de sessão fixa ou um endereço fixo. A pré-condição não muda: a conta precisa ser sua ou é preciso ter a permissão por escrito do titular, e se existir uma API oficial, ela vem primeiro. Os tipos de proxy adequados estão nos nossos serviços de proxy.


