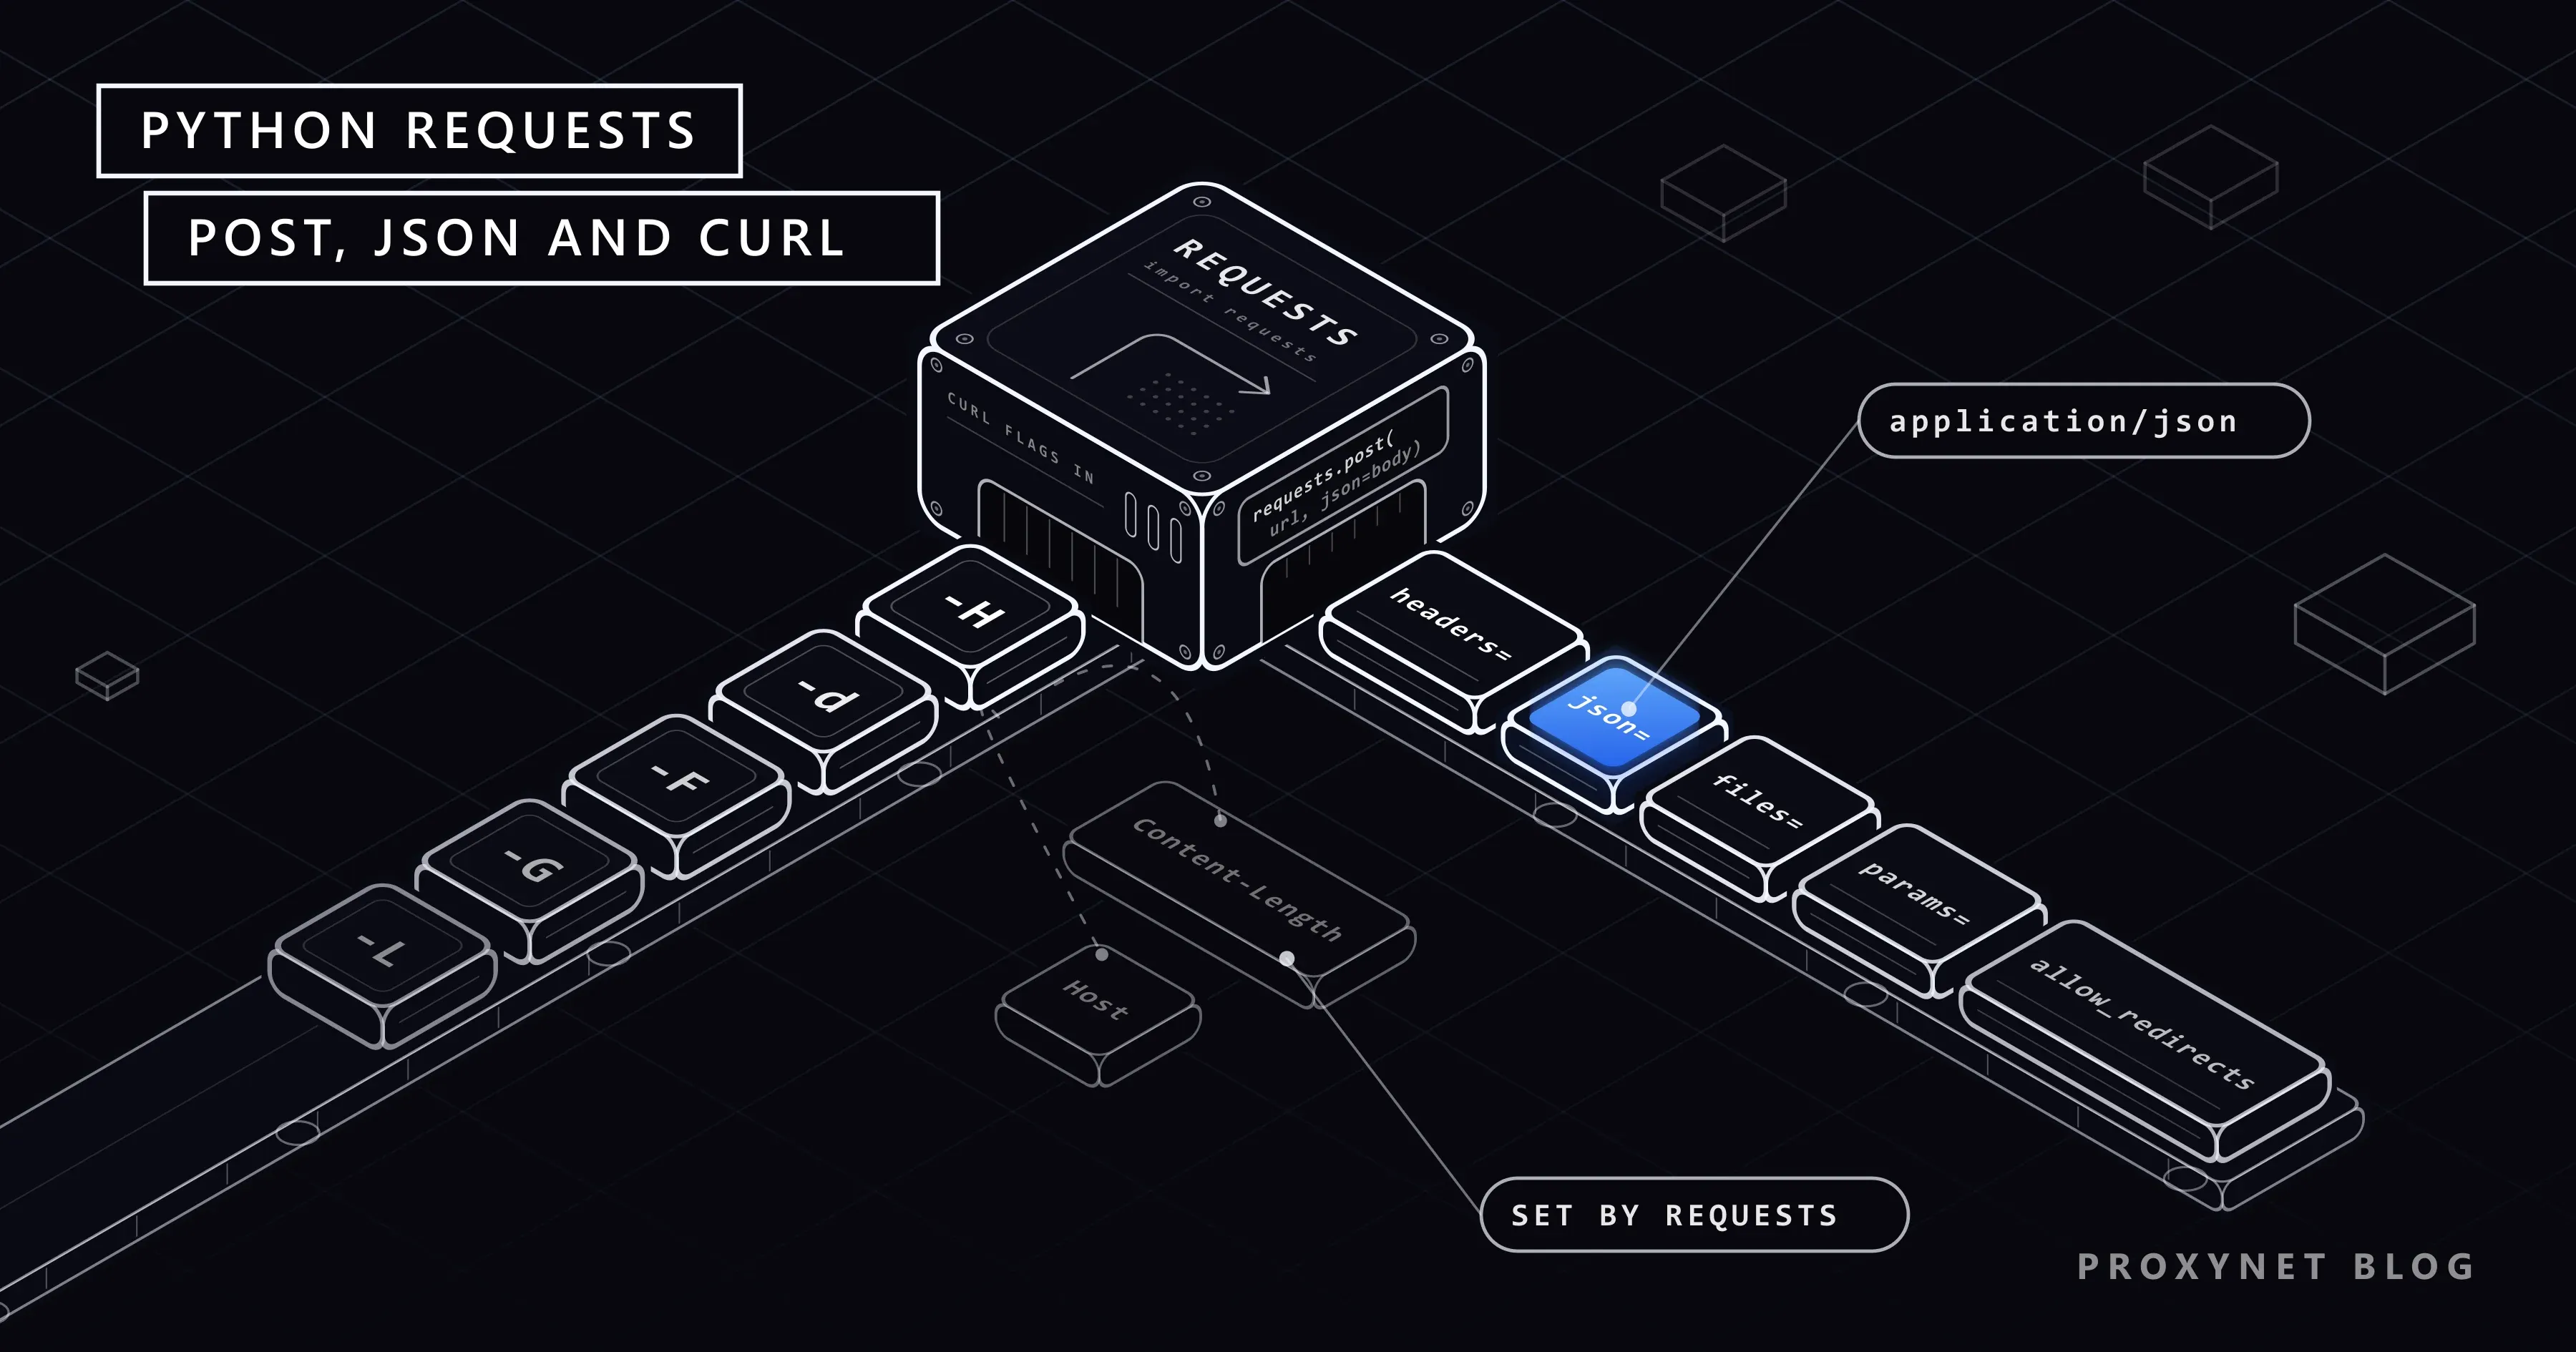
مستندات API یک شرکت حمل مرسوله، ساختن مرسوله تازه را با یک فرمان cURL نشان میدهد: curl -X POST https://api.example.com/v1/shipments -H "Authorization: Bearer TOKEN" -H "Content-Type: application/json" -d '{"recipient": "Ayse Demir", "weight_kg": 3}'. در ترمینال پاسخ 201 Created برمیگردد. فرمان را به شکل requests.post(url, data=json.dumps(body), headers={"Authorization": ...}) به Python منتقل میکنید و سرور پاسخ 415 Unsupported Media Type میدهد: وقتی در data= یک رشته باشد، Requests هیچ Content-Type نمیفرستد، و سطری که این هدر را تنظیم میکرد در فرمان cURL جا مانده است.
این راهنما json=، data= و files=، پارامترهای پرسوجو، هدرها و توکنهای Bearer، خواندن پاسخ و آرگومان Requests متناظر با هر گزینه رایج cURL را پوشش میدهد. در پایان یک فهرست بررسی برای درخواستهایی آمده که در cURL کار میکنند اما در Python نه، و یک کلاینت کوچک API که با احتیاط دوباره تلاش میکند. همه نمونهها روی Python 3.13.9، Requests 2.34.2 و curl 8.21.0 (Windows 11)، در برابر httpbin.org و یک سرور محلی که بایتهای دریافتی را عیناً برمیگرداند، اجرا شدند.
چگونه با Python Requests درخواست POST بفرستیم؟
بسته را با pip install requests نصب کنید. PyPI نسخه 2.34.2 را، که در 14 مه 2026 منتشر شد، نسخه فعلی نشان میدهد؛ این نسخه به Python 3.10 یا جدیدتر نیاز دارد. انتخاب میان کتابخانهها را در مقایسه HTTPX، Requests و AIOHTTP بررسی کردهایم.
یک POST با بدنه JSON فقط یک فراخوانی است. httpbin.org/post هر چه را دریافت کرده برمیگرداند:
import requests

payload = {"recipient": "Ayse Demir", "weight_kg": 3}
r = requests.post("https://httpbin.org/post", json=payload, timeout=20)

print(r.status_code)                         # 200
print(r.json()["headers"]["Content-Type"])   # application/json
print(r.json()["data"])                      # {"recipient": "Ayse Demir", "weight_kg": 3}
print(r.json()["json"])                      # the same body, parsed back into a dict
فیلد data بدنه را به همان شکلی نشان میدهد که فرستاده شده، با یک فاصله پس از هر دونقطه و ویرگول. requests.put()، requests.patch() و requests.delete() همین آرگومانها را میپذیرند. همیشه timeout بدهید: Requests مقدار پیشفرض ندارد، پس سروری که پاسخ نمیدهد اسکریپت شما را منتظر نگه میدارد (خطاهای timeout در خطای Max Retries Exceeded With URL آمدهاند).
تفاوت json=، data= و files= چیست؟
هر آرگومان بدنه را به شیوهای دیگر میسازد و Content-Type دیگری تنظیم میکند. یک دیکشنری را به چهار شکل فرستادیم:
import json
import requests

url = "https://httpbin.org/post"
body = {"recipient": "Ayse Demir", "weight_kg": 3}

for label, kwargs in [
    ("json=body", {"json": body}),
    ("data=body", {"data": body}),
    ("data=json.dumps(body)", {"data": json.dumps(body)}),
    ("json= and data=", {"json": body, "data": {"note": "x"}}),
]:
    echo = requests.post(url, timeout=20, **kwargs).json()
print(f"{label:22} {echo['headers'].get('Content-Type')!s:34} form={echo['form']} json={echo['json']}")json=body application/json form={} json={'recipient': 'Ayse Demir', 'weight_kg': 3}
data=body application/x-www-form-urlencoded form={'recipient': 'Ayse Demir', 'weight_kg': '3'} json=None
data=json.dumps(body) None form={} json={'recipient': 'Ayse Demir', 'weight_kg': 3}
json= and data= application/x-www-form-urlencoded form={'note': 'x'} json=Noneآنچه این چهار سطر نشان میدهند:
json=دیکشنری را به JSON تبدیل میکند وContent-Type: application/jsonرا تنظیم میکند. برای APIهای JSON از همین استفاده کنید.data=با دیکشنری یک فرم میفرستد و هر مقدار به متن تبدیل میشود:weight_kgبه شکل'3'رسید.data=با رشته هیچContent-Typeنمیفرستد. httpbin با این حال آن را تجزیه کرد؛ یک API سختگیر پاسخ415یا400میدهد. هدر را خودتان تنظیم کنید.json=همراه باdata=یاfiles=بیهیچ خطایی JSON را از دست میدهد. راهنمای شروع سریع Requests میگوید اگرdataیاfilesداده شود، پارامترjsonنادیده گرفته میشود.
متن JSON را فقط وقتی از راه data= بفرستید که بایتهای دقیق مهم باشند. وقتی API بدنه را با HMAC امضا میکند، بایتهایی را که دریافت کرده بررسی میکند، و json= فاصله میافزاید و نویسههای غیر ASCII را به شکل دنباله \u مینویسد ("İzmir" به شکل "\u0130zmir" فرستاده میشود). بایتها را خودتان بسازید:
import json
import requests

body = {"recipient": "Ayse Demir", "city": "İzmir", "weight_kg": 3}
raw = json.dumps(body, separators=(",", ":"), ensure_ascii=False).encode("utf-8")

r = requests.post("https://httpbin.org/post", data=raw,
                  headers={"Content-Type": "application/json"}, timeout=20)
print(r.json()["data"])  # {"recipient":"Ayse Demir","city":"İzmir","weight_kg":3}
هش SHA-256 این بایتها با هش بدنهای که curl --data-binary @body.json از همان فایل UTF-8 فرستاد یکی بود. ورود با فرم و توکنهای CSRF در نشست و کوکی در Python آمده و files= در ادامه همین نوشته.
یک فرمان cURL را گامبهگام چگونه به Requests تبدیل کنیم؟
همین درخواست، وقتی در پنل وب شرکت حمل مرسوله از پنل Network مرورگر کپی شود، چند سطر اضافه دارد. یافتن چنین درخواستی را در صفحههای ایستا و پویا در وب اسکرپینگ توضیح دادهایم.
curl -X POST "https://api.example.com/v1/shipments?notify=false" \
  -H "Authorization: Bearer TOKEN" \
  -H "Content-Type: application/json" \
  -H "Accept-Encoding: gzip, deflate, br" \
  -H "Cookie: session=abc123" \
--data-raw '{"recipient": "Ayse Demir", "weight_kg": 3}'- نحو شل را کنار بگذارید. شکستهای سطر با
\(یا^در کپیای که برایcmdویندوز ساخته شده) و نقلقولها را بردارید. - رشته پرسوجو را به
params=ببرید.?notify=falseبهparams={"notify": "false"}تبدیل میشود. - هدرها را پالایش کنید. آنچه را API لازم دارد نگه دارید:
Authorization،Acceptو کلیدهای API.Accept-Encodingرا که Requests خودش مدیریت میکند حذف کنید، وContent-Typeرا هم وقتی ازjson=استفاده میکنید.HostیاContent-Lengthرا هرگز کپی نکنید؛ Requests آنها را خودش محاسبه میکند. سطرهای مرورگر مانندsec-fetch-*بهندرت لازماند، و جای سطرCookieدرcookies=یا یکSessionاست. - آرگومان بدنه را انتخاب کنید. JSON به
json=میرود (یا اگر بدنه امضا میشود،data=با بایتهای دقیق)،-d "a=1&b=2"بهdata={"a": "1", "b": "2"}و-Fبهfiles=. - متد را انتخاب کنید.
-d،--data-raw،--jsonو-Fیعنی POST، مگر آنکه-Xچیز دیگری بگوید؛-Gدرخواست را به یک پرسوجوی GET تبدیل میکند. - یک
timeout=بیفزایید وr.raise_for_status()را فراخوانی کنید. - مقایسه کنید. فرمان cURL و فراخوانی Python را به
https://httpbin.org/anythingبفرستید و متد، نشانی، هدرها و بدنهای را که برمیگردد با هم مقایسه کنید.
نتیجه، با توکنی که از یک متغیر محیطی خوانده میشود:
import os
import requests

r = requests.post(
    "https://api.example.com/v1/shipments",
    params={"notify": "false"},
    headers={"Authorization": f"Bearer {os.environ['API_TOKEN']}"},
    json={"recipient": "Ayse Demir", "weight_kg": 3},
    timeout=20,
)
r.raise_for_status()
print(r.status_code, r.headers.get("Location"))
curlconverter گامهای 1 تا 5 را انجام میدهد و خروجی پیشفرضش Python Requests است. آن را با npm نصب کنید و در فرمان، curl را با curlconverter جایگزین کنید. برای فرمان بالا، نسخه 4.12.0 مقدار notify را به params، کوکی را به cookies= و بدنه را به json= برد، و Content-Type و Accept-Encoding را بهصورت کامنت درآورد. هیچ timeout نیفزود، و README آن هشدار میدهد که کد تولیدشده هدایتها را دنبال میکند، مگر آنکه فرمان سیاست هدایت را تعیین کرده باشد. فرمانی که از مرورگر کپی شده کوکی نشست فعال و توکن شما را در خود دارد، پس آن را روی دستگاه خودتان تبدیل کنید، نه در یک وبسایت.
کدام آرگومان Requests با هر گزینه cURL متناظر است؟
| گزینه cURL | Requests | تفاوت |
|---|---|---|
-d '{"a":1}' با Content-Type: application/json | json={"a": 1} | Requests فاصله میافزاید؛ برای بایتهای دقیق از data= استفاده کنید |
--json '{"a":1}' | json={"a": 1}، headers={"Accept": "application/json"} | --json (از curl 7.82.0 به بعد) Accept را هم تنظیم میکند |
-d "a=1&b=2" | data={"a": "1", "b": "2"} | بایتهای یکسان |
--data-binary @body.json | data=open("body.json", "rb") | -d @file شکستهای سطر را حذف میکند؛ این دو آنها را نگه میدارند |
-F "file=@report.csv" | files={"file": open("report.csv", "rb")} | curl نوع بخش را application/octet-stream میگذارد؛ Requests فقط با تاپل سهتایی نوع میافزاید |
-G --data-urlencode "q=kargo takip" | params={"q": "kargo takip"} | پرسوجوی یکسان: ?q=kargo+takip |
-X PUT | requests.put(url, ...) | برای PATCH و DELETE هم همینطور |
-H "Name: value" | headers={"Name": "value"} | مقدارها باید رشته باشند؛ int خطای InvalidHeader میدهد |
-A "ShipmentSync/1.0" | headers={"User-Agent": "ShipmentSync/1.0"} | در غیر این صورت هر ابزار نام خودش را میفرستد |
-b "session=abc123" | cookies={"session": "abc123"} | همان هدر Cookie |
-u user:pass | auth=("user", "pass") | همان هدر Basic |
-L | پیشفرض | cURL به -L نیاز دارد؛ در Requests allow_redirects=False آن را خاموش میکند |
--max-redirs 5 | session.max_redirects = 5 | پیشفرض Requests: 30 |
--connect-timeout 3 -m 20 | timeout=(3.05, 20) | -m کل انتقال را محدود میکند؛ timeout خواندن فاصله میان بایتهاست |
-k / --cacert ca.pem | verify=False / verify="ca.pem" | verify=False فقط در آزمونهای محلی |
-x http://user:pass@pr.proxynet.io:8000 | proxies={"http": url, "https": url} | استفاده از cURL با پروکسی را ببینید |
--compressed | هیچ | Requests فشردهسازی را خودش مدیریت میکند |
-I | requests.head(url) | برای HEAD هدایت دنبال نمیشود |
-i / -v | r.headers / r.request.headers | آنچه دریافت و فرستاده شد |
هر گزینه در راهنمای curl توضیح داده شده است. پروکسی تازه برای هر درخواست کار جداگانهای است (چرخاندن پروکسی در Python).
پارامترهای پرسوجو و هدرها را چگونه بفرستیم؟
مقدارهای پرسوجو را به شکل دیکشنری به params= بدهید:
import requests

params = {"q": "kargo takip", "status": ["pending", "shipped"], "sort": None}
r = requests.get("https://httpbin.org/get", params=params, timeout=20)
print(r.url)  # https://httpbin.org/get?q=kargo+takip&status=pending&status=shipped
فهرست کلید را تکرار میکند، None کنار گذاشته میشود، و فاصلهها و نویسههای غیر ASCII برای شما کدگذاری میشوند. رشته پرسوجویی که از پیش در نشانی هست میماند و params= پس از آن افزوده میشود. پیمایش صفحهبهصفحه نتایج را در صفحهبندی در وب اسکرپینگ توضیح دادهایم.
هدرها در یک دیکشنری از رشتهها قرار میگیرند و توکن از محیط خوانده میشود:
import os
import requests

headers = {
    "Authorization": f"Bearer {os.environ['API_TOKEN']}",
    "Accept": "application/json",
}
r = requests.get("https://httpbin.org/headers", headers=headers, timeout=20)
print(r.json()["headers"]["Authorization"])  # Bearer <your token>

r = requests.get("https://httpbin.org/basic-auth/user/pass", auth=("user", "pass"), timeout=20)
print(r.status_code)  # 200
هدرهایی که همه فراخوانیها لازم دارند یک بار روی یک requests.Session و از راه session.headers تنظیم میشوند. سه قاعده از مستندات Requests که آزمونهای ما هر سه را تأیید کردند:
.netrcبرheaders=مقدم است. یک ورودی.netrcبرای همان میزبان، هدرBearerما را با یک هدرBasicجایگزین کرد؛auth=بر هر دو مقدم است.- Authorization روی میزبان اصلی میماند. پس از هدایت از
127.0.0.1بهlocalhost، این هدر حذف شده بود. - مقدارها رشتهاند.
headers={"X-Page": 2}خطایInvalidHeaderداد.
اگر User-Agent خودتان را ندهید، Requests مقدار python-requests/2.34.2 را میفرستد. اینکه در آن چه بنویسید در User-Agent چیست؟ آمده، و اینکه چرا هدرهای یک کلاینت باید با هم سازگار بمانند در وب اسکرپینگ بدون مسدود شدن.
پاسخ را چگونه بخوانیم و خطاهای HTTP را بگیریم؟
یک Response اینها را در اختیار شما میگذارد: r.status_code، r.headers (دیکشنریای که به بزرگی و کوچکی حروف حساس نیست)، r.content (بایتهای خام)، r.text (بایتهایی که با r.encoding رمزگشایی شدهاند) و r.json(). نویسههای بههمریخته در r.text یعنی کدگذاری اشتباه حدس زده شده است (خطاهای کدگذاری در Python).
مستندات Requests هشدار میدهد که موفق بودن r.json() به معنای موفق بودن درخواست نیست: سرور میتواند همراه 500 یک بدنه خطای JSON بفرستد. نخست وضعیت را بررسی کنید:
import requests

r = requests.get("https://httpbin.org/status/404", timeout=20)
try:
    r.raise_for_status()
except requests.HTTPError as exc:
    print(exc)  # 404 Client Error: NOT FOUND for url: https://httpbin.org/status/404
raise_for_status() برای هر 4xx یا 5xx خطای HTTPError برمیانگیزد. وقتی بدنه خالی یا HTML باشد، r.json() با JSONDecodeError شکست میخورد (علتها در رفع خطای JSONDecodeError: Expecting Value آمدهاند). اینکه کدام کدها را دوباره تلاش کنید در کدهای وضعیت HTTP در وب اسکرپینگ آمده است.
با Requests چگونه فایل آپلود و دانلود کنیم؟
files= یک بدنه multipart/form-data میسازد. تاپل سهتایی نام فایل و نوع بخش را تعیین میکند، و فیلدهای data= به شکل بخشهای اضافه فرستاده میشوند. چون json= در کنار files= نادیده گرفته میشود، JSON را به شکل بخشی جداگانه بفرستید:
import json
import requests

with open("report.csv", "rb") as f:
    files = {
        "file": ("report.csv", f, "text/csv"),
        "meta": (None, json.dumps({"source": "warehouse"}), "application/json"),
    }
    r = requests.post("https://httpbin.org/post", files=files, data={"note": "daily"}, timeout=20)

print(r.json()["files"])  # {'file': 'sku,price\n1001,19.90\n'}
print(r.json()["form"])   # {'meta': '{"source": "warehouse"}', 'note': 'daily'}
فایل را در حالت دودویی ("rb") باز کنید: مستندات توضیح میدهد که Requests ممکن است Content-Length را برابر تعداد بایتهای فایل بگذارد و حالت متنی میتواند این مقدار را نادرست کند. برای آپلودهای بسیار بزرگ، همان صفحه بسته requests-toolbelt را معرفی میکند که بدنه را بهصورت جریانی میفرستد.
برای دانلود، stream=True بدنه بزرگ را بیرون از حافظه نگه میدارد:
import requests

url = "https://example.com/export.csv"  # replace with your file's URL
with requests.get(url, stream=True, timeout=(3.05, 60)) as r:
    r.raise_for_status()
    with open("export.csv", "wb") as f:
        for chunk in r.iter_content(chunk_size=64 * 1024):
            f.write(chunk)
دانلود فایلهای فراوان از یک صفحه در دانلود همه تصویرهای یک وبسایت آمده است.
چرا درخواستی که در cURL کار میکند در Requests پاسخ دیگری میگیرد؟
معمولاً دو درخواست با هم فرق دارند. به این ترتیب بررسی کنید:
- هدایتها. cURL بدون
-Lدر یک3xxمیایستد؛ Requests برای همه متدها جزHEADهدایت را دنبال میکند. وقتی هر یک از دو ابزار هدایت را دنبال کند، درخواست POST که پاسخ301،302یا303بگیرد به GET بدون بدنه تبدیل میشود، و307یا308همان POST را نگه میدارند؛ این رفتار با RFC 9110 هماهنگ است. یک استثنا: با-X POSTو-L، cURL پس از یک302یک POST بدون بدنه فرستاد؛--follow(از curl 8.16.0 به بعد) به GET تغییر میدهد. بهr.historyنگاه کنید، یاallow_redirects=Falseبدهید وLocationرا بخوانید. - هدرهای پیشفرض. curl 8.21.0 هدرهای
User-Agent: curl/8.21.0وAccept: */*را فرستاد وAccept-Encodingنفرستاد. Requests اینها را فرستاد:python-requests/2.34.2،Accept: */*،Connection: keep-aliveوAccept-Encoding: gzip, deflate(بهعلاوهbrاگر brotli نصب باشد، وzstdروی Python 3.14). باr.request.headersمقایسه کنید. - نسخه HTTP. Requests فقط با
HTTP/1.1کار میکند:r.raw.versionبرای یک سایت HTTPS مقدار11برگرداند. curl برای HTTPS بهطور پیشفرض HTTP/2 را مذاکره میکند، اگر نسخه ساختهشدهاش از آن پشتیبانی کند (curl -VعبارتHTTP2را فهرست میکند)، و-w "%{http_version}"نسخه بهکاررفته را چاپ میکند. نسخه ویندوزی ما این پشتیبانی را نداشت و از1.1استفاده کرد. - محیط. وقتی
Session.trust_envروی مقدار پیشفرضTrueاست، Requests متغیرهایHTTP_PROXY،HTTPS_PROXYوNO_PROXYرا میخواند، اگر متغیری تنظیم نشده باشد تنظیمات پروکسی سیستم را در ویندوز و macOS، و همچنین.netrcرا. cURL متغیرها را میخواند (http_proxyفقط با حروف کوچک) اما تنظیمات سیستم را نه، و.netrcرا فقط با--netrc.requests.utils.get_environ_proxies(url)نشان میدهد Requests کدام پروکسی را برداشته است؛ این متغیرها در استفاده از پروکسی در wget توضیح داده شدهاند. - گواهیها. Requests از بسته گواهی
certifiاستفاده میکند؛ curl در ویندوز با Schannel از مخزن گواهی ویندوز. پشت پروکسی سازمانیای که TLS را بازرسی میکند، cURL ممکن است کار کند در حالی که Requests خطایSSLErrorمیدهد (راهحل در خطای Max Retries Exceeded With URL). - بایتهای بدنه.
json=بدنه را دوباره به JSON تبدیل میکند و-d @fileشکستهای سطر را حذف میکند. اگر API بدنه را امضا میکند، از هر دو بدنه هش بگیرید و مقایسه کنید. - آنچه روی سیم میرود. یک پروکسی MITM محلی هر دو درخواست را کنار هم نشان میدهد.
اگر همهچیز یکسان است و پاسخ باز هم فرق دارد، سایت درباره خود کلاینت قضاوت میکند، برای نمونه درباره دستدادن TLS آن، که هدرها تغییرش نمیدهند. اسکرپر Cloudflare توضیح میدهد چنین پاسخی را چگونه بخوانید، و اثر انگشت TLS و JA3 نشان میدهد دستدادن چه چیزی را آشکار میکند. راه پیش رو API رسمی سایت یا اجازه صاحب آن است؛ به ابزارهایی که اسکریپت را بهجای مرورگر جا میزنند نمیپردازیم.
نمونه کامل: یک کلاینت کوچک API با تلاش دوباره ایمن
اسکریپت توکن Bearer و هدرهای مشترک را روی یک Session نگه میدارد، params= را با یک GET و json= را با یک POST میفرستد و وضعیت هر پاسخ را بررسی میکند. فقط GET را دوباره تلاش میکند: MDN متد POST را idempotent نمیداند، یعنی تکرار آن میتواند مرسوله دومی بسازد. کلاس Retry در urllib3 بهطور پیشفرض POST را کنار میگذارد؛ اسکریپت این را صریح مینویسد.
"""A small API client: GET with params, POST with json=, retries for GET only."""
import os

import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

API = os.environ.get("API_BASE", "https://api.example.com/v1")
TIMEOUT = (3.05, 20)  # connect timeout, read timeout (seconds)


def make_session():
    session = requests.Session()
    session.headers.update({
        "Authorization": f"Bearer {os.environ['API_TOKEN']}",  # never hard-code the token
        "Accept": "application/json",
        "User-Agent": "ShipmentSync/1.0 (+https://example.com/contact)",
    })
    retry = Retry(
        total=3,
        backoff_factor=0.5,
        status_forcelist=[502, 503, 504],
        allowed_methods=["GET"],  # a repeated POST could create the same shipment twice
        raise_on_status=False,    # hand back the last response, raise_for_status() reports it
    )
    adapter = HTTPAdapter(max_retries=retry)
    session.mount("https://", adapter)
    session.mount("http://", adapter)
    proxy = os.environ.get("PROXY_URL")  # optional, e.g. http://user:pass@pr.proxynet.io:8000
    if proxy:
        session.proxies = {"http": proxy, "https": proxy}
        session.trust_env = False  # otherwise HTTPS_PROXY or the system proxy wins over session.proxies
    return session


def list_shipments(session, status="pending", page=1):
    r = session.get(f"{API}/shipments", params={"status": status, "page": page}, timeout=TIMEOUT)
    r.raise_for_status()
    return r.json()


def create_shipment(session, recipient, weight_kg):
    body = {"recipient": recipient, "weight_kg": weight_kg}
    r = session.post(f"{API}/shipments", json=body, timeout=TIMEOUT)
    r.raise_for_status()
    return r.status_code, r.headers.get("Location"), r.json()


if __name__ == "__main__":
    with make_session() as s:
        try:
            print(list_shipments(s))
            print(create_shipment(s, "Ayse Demir", 3))
        except requests.HTTPError as exc:
            print("API error:", exc)
در برابر یک سرور محلی که API را شبیهسازی میکرد، GET فهرست را برگرداند و POST پاسخ 201 را همراه هدر Location. وقتی سرور 503 داد، GET چهار بار فرستاده شد (با انتظار 0، 1 و 2 ثانیه میان تلاشها) و سپس raise_for_status() خطا را گزارش کرد؛ یک POST به همان نشانی فقط یک بار فرستاده شد. از راه یک پروکسی آزمایشی محلی که در PROXY_URL تنظیم شده بود، هر دو فراخوانی کار کردند و رمز نادرست پاسخ 407 Proxy Authentication Required داد.
urllib3 بهطور پیشفرض به Retry-After در پاسخ 503 هم احترام میگذارد؛ مدیریت 429 در کدهای وضعیت HTTP در وب اسکرپینگ آمده، و فراخوانیهای موازی فراوان در همروندی و موازیسازی در وب اسکرپینگ.
کاربردها
- داده محصول یا قیمت از API خود سایت (استخراج داده).
- یک نقطه اتصال JSON که در پنل Network پیدا شده، بهجای رندر کردن صفحه فراخوانی میشود (صفحههای ایستا و پویا).
- خزش صفحههای پشت نتایج API با سرعتی ملایم (خزنده وب با Python).
- آزمودن webhook یا سرویس داخلی خودتان با یک اسکریپت بهجای ابزار گرافیکی (تنظیم پروکسی در Postman).
- بررسی پاسخ یک API برای کشوری دیگر از راه یک پروکسی مسکونی در همان کشور.
- APIهایی که فقط نشانیهای IP ثبتشده را میپذیرند، از یک نقطه خروج ثابت فراخوانی میشوند (IP ثابت برای API).
- همین درخواست در Node.js با fetch یا Axios (معادل cURL در JavaScript).
اشتباهات رایج
data=json.dumps(body)بدونContent-Type. سرور نمیتواند تشخیص دهد که بدنه JSON است؛ ازjson=bodyاستفاده کنید.json=وdata=در یک فراخوانی. JSON بیصدا کنار گذاشته میشود.- نبودن
timeout. یک سرور بیپاسخ اسکریپت را متوقف میکند. - چسباندن دستی رشته پرسوجو. فاصلهها و نویسههای غیر ASCII نشانی را خراب میکنند.
r.json()پیش از بررسی وضعیت. یک500با بدنه خطای JSON بیمشکل تجزیه میشود.- باز کردن فایل آپلود در حالت متنی. از
"rb"استفاده کنید. - کپی کردن
HostوContent-Length. Requests هدرHostکپیشده را بدون تغییر فرستاد، پس آزمونی که روی سرور دیگری اجرا شد هنوز نام سرور قبلی را داشت. یکContent-Lengthکپیشده روی GET بدون بدنه، سرور ما را تا پایان timeout خواندن منتظر نگه داشت. - چسباندن فرمانهای مرورگر در مبدلهای آنلاین. این فرمانها کوکی نشست و توکن شما را در خود دارند.
verify=Falseدر محیط عملیاتی. بررسی گواهی را خاموش میکند.- تلاش دوباره کورکورانه برای POST. تلاش دوباره پس از timeout میتواند رکورد دومی بسازد.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| بدنه JSON برای یک API | requests.post(url, json=data, timeout=20)، بدون Content-Type دستی |
| بدنه امضاشده، بایت به بایت | data= با بایتهایی که خودتان ساختهاید، بهعلاوه Content-Type |
| فرم ساده (نه فرم ورود) | data= با دیکشنری؛ ورود و CSRF در راهنمای نشستها |
| فایل همراه فیلدهای اضافه | files= بهعلاوه data=؛ JSON به شکل بخش جداگانه application/json |
| تبدیل سریع cURL | جدول بالا، یا curlconverter روی دستگاه خودتان |
| در cURL کار میکند، در Python نه | r.history، r.request.headers، trust_env و نسخه HTTP را بررسی کنید |
| HTTP/2 یا فراخوانی ناهمگام | HTTPX؛ AIOHTTP فقط برای ناهمگام |
پرسشهای متداول
آیا هنگام ارسال JSON با Requests باید هدر Content-Type را تنظیم کنم؟
با json= نه: Requests خودش Content-Type: application/json را تنظیم میکند. وقتی متن JSON را از راه data= میفرستید به آن نیاز دارید، چون رشتهای که در data= باشد بدون این هدر فرستاده میشود و یک API سختگیر پاسخ 415 Unsupported Media Type یا 400 میدهد.
تفاوت json= و data=json.dumps() در Requests چیست؟
هر دو متن JSON میفرستند، اما فقط json= هدر Content-Type را میافزاید. بایتها هم ممکن است فرق کنند: json= پس از دونقطهها و ویرگولها فاصله میگذارد و نویسههای غیر ASCII را به شکل دنباله \u مینویسد. بهطور پیشفرض از json= استفاده کنید، و وقتی API بدنه را امضا میکند از data= با بایتهای خودتان.
چگونه با Python Requests توکن Bearer بفرستیم؟
از headers={"Authorization": f"Bearer {token}"} استفاده کنید، یا آن را یک بار در session.headers تنظیم کنید. توکن را از یک متغیر محیطی بخوانید. اگر فایل .netrc برای همان میزبان اطلاعات ورود داشته باشد، Requests بهجای توکن از همان اطلاعات استفاده میکند؛ Session.trust_env = False این رفتار را خاموش میکند.
آیا میتوان یک فرمان cURL را خودکار به Python تبدیل کرد؟
بله. curlconverter فرمان cURL را به کد Requests تبدیل میکند و روی دستگاه خودتان اجرا میشود. خروجی را بازبینی کنید: timeout نمیافزاید، و Requests هدایتهایی را دنبال میکند که فرمان cURL دنبال نمیکرد. فرمانهایی را که کوکی یا توکن دارند به مبدلهای آنلاین ندهید.
آیا Requests هدایتها را دنبال میکند و چرا POST من به GET تبدیل میشود؟
Requests برای همه متدها جز HEAD هدایتها را دنبال میکند. پس از 301، 302 یا 303، درخواست POST مانند مرورگرها به GET تبدیل میشود و بدنهاش را از دست میدهد؛ پس از 307 یا 308 همان POST میماند. allow_redirects=False در نخستین پاسخ متوقف میشود.
آیا Python Requests از HTTP/2 پشتیبانی میکند؟
نه. Requests فقط با HTTP/1.1 کار میکند؛ در آزمون ما r.raw.version برای یک سایت HTTPS مقدار 11 برگرداند. HTTPX وقتی httpx[http2] را نصب کنید و کلاینت را با http2=True بسازید از HTTP/2 پشتیبانی میکند؛ این قابلیت بهطور پیشفرض خاموش است.
خلاصه
برای یک API مبتنی بر JSON، requests.post(url, json=data, timeout=20) کل کار است: Requests بدنه را به JSON تبدیل میکند و هدر را تنظیم میکند. data= فرمها یا بایتهای دقیق را میفرستد، files= بدنههای چندبخشی را و params= رشته پرسوجو را. یک فرمان cURL گزینه به گزینه به همین آرگومانها نگاشته میشود؛ اگر پاسخها باز هم فرق داشتند، به این ترتیب هدایتها، هدرهای پیشفرض، نسخه HTTP و محیط را بررسی کنید. وقتی API باید از کشوری مشخص یا از نشانی ثابتی فراخوانی شود، گزینهها را در صفحه خدمات پروکسی ما مقایسه کنید.