


































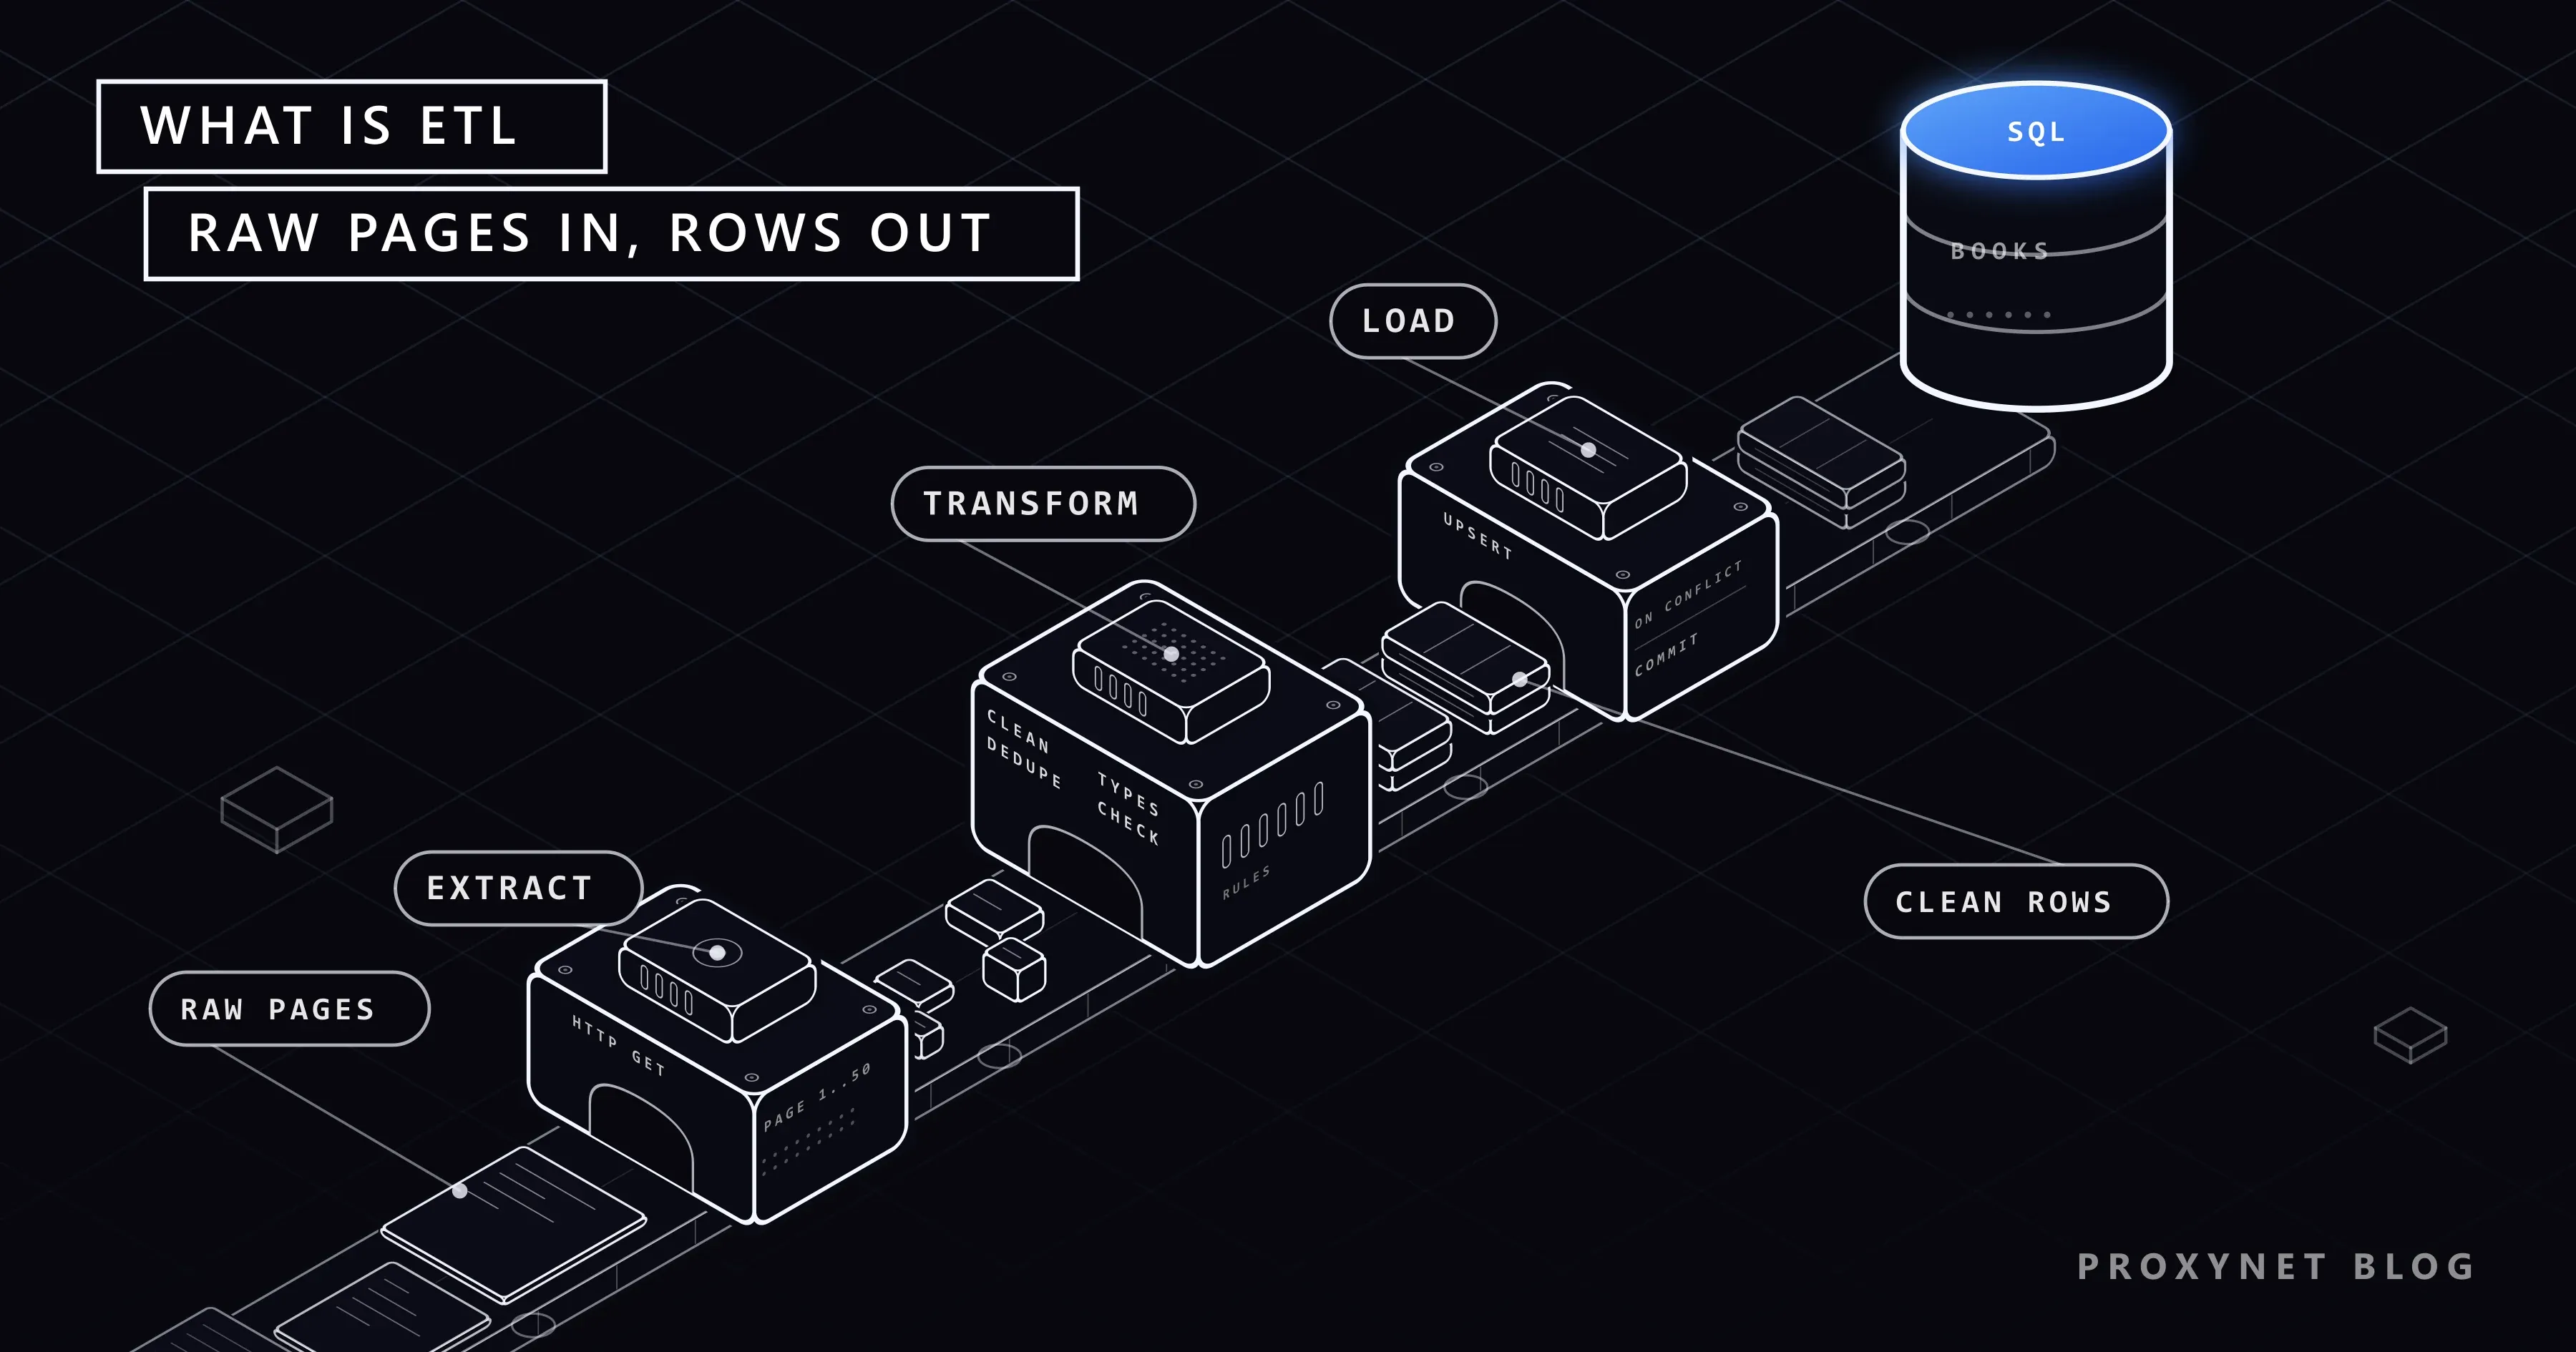
اسکرپری که ماه پیش درست کار میکرد حالا صفحهگستردهای را با قیمتهایی مثل £51.77 پر میکند، یک کتاب را سه بار ثبت میکند و ستونی میسازد که در آن "In stock" کنار "In stock (19 available)" نشسته است. با این داده نمیشود نمودار کشید. اسکرپر کار خودش را کرده است؛ آنچه کم است همه چیزهایی است که بعد از آن میآید: تبدیل متن خام صفحه به ردیفهایی با نوع درست و بدون تکرار، و نگهداشتن آنها در جایی که از اجرای بعدی جان سالم به در ببرد. این بخش گمشده نام دارد و از وب اسکرپینگ هم قدیمیتر است: ETL.
در این نوشته توضیح میدهیم ETL یعنی چه، هر یک از سه گام آن چه میکند و یک پایپلاین ETL از لحظه راهاندازی تا جدول نهایی چگونه اجرا میشود. ETL را با ELT مقایسه میکنیم، دو ویژگی را که یک اسکریپت را از یک پایپلاین جدا میکنند (اجرای دوباره بیخطر و پایش) بررسی میکنیم و یک کار (job) کامل و آزموده در Python میسازیم که داده کتابها را از یک محیط تمرینی اسکرپینگ استخراج میکند، تمیز میکند و در SQLite بارگذاری میکند. بخشهای پایانی به کاربردها، اشتباههای رایج و یک راهنمای انتخاب کوتاه میپردازند.
ETL چیست؟
ETL فرایندی برای یکپارچهسازی داده است: داده از یک یا چند منبع بیرون میآید، با قواعدی که شما تعریف میکنید شکل تازه میگیرد و در یک مخزن واحد قرار میگیرد که میتوان از آن پرسوجو کرد. راهنمای معماری مایکروسافت آن را فرایندی توصیف میکند که داده منابع گوناگون را در یک مخزن داده یکپارچه جمع میکند و تبدیل را پیش از بارگذاری و بر اساس قواعد کسبوکار انجام میدهد.
این ایده از انبارش داده (data warehousing) آمده است و با اسکرپینگ هم به همان خوبی جور است. وبسایت منبعی است مثل بقیه منبعها، فقط نامرتبتر: دادهاش برای خواندن انسان قالببندی شده، میان چند صفحه پخش است و ممکن است بیخبر تغییر کند. اگر تا به حال اسکرپری نوشتهاید و بعد اسکریپت دومی برای درست کردن خروجی آن، در واقع دو سوم یک پایپلاین ETL را ساختهاید.
هر گام چه میکند؟
استخراج داده خام را جمع میکند و تا جای ممکن آن را تغییر نمیدهد. برای داده وب یعنی فرستادن درخواست، دنبال کردن صفحهبندی و بیرون کشیدن فیلدهای لازم از HTML. خروجی هنوز متن است: "£51.77"، "Three"، "\n In stock\n". ساده نگهداشتن استخراج یک فایده دارد: وقتی چیزی خراب میشود، میتوانید بفهمید منبع تغییر کرده یا قواعد تمیزکاری شما.
تبدیل جایی است که قواعد در آن زندگی میکنند. کارهای معمول اینهاست:
- تبدیل نوع (متن قیمت به عدد، واژه امتیاز به عدد صحیح، رشته تاریخ به تاریخ)
- یکدست کردن متن (فاصلهها، شکلهای Unicode، حروف کوچک و بزرگ)
- حذف تکرار بر اساس یک کلید پایدار، مثل URL محصول
- اعتبارسنجی (قیمت باید مثبت باشد، امتیاز باید بین 1 تا 5 باشد) و کنار گذاشتن ردیفهایی که رد میشوند
- غنیسازی یا ترکیب (افزودن واحد پول، دستهبندی یا زمان اسکرپ)
تبدیل HTML صفحه به فیلدها خودش یک گام تجزیه است؛ انواع تجزیهگر و جاهایی که از کار میافتند را در تجزیه داده (parsing) چیست؟ توضیح دادهایم. یک تمیزکاری کامل با pandas در پاکسازی دادههای اسکرپینگ با pandas در Python آمده است.
بارگذاری ردیفهای تمیز را در مقصد مینویسد و نتیجه را یکجا قابل دیدن میکند. در یک پروژه کوچک مقصد یک فایل SQLite است؛ برای یک تیم، PostgreSQL یا یک انبار داده ابری. بیشتر باگهای ردیف تکراری هم در همین گام متولد میشوند و به همین دلیل روش بارگذاری از خود مقصد مهمتر است. مزایا و معایب CSV، JSON و SQLite را در ذخیره دادههای اسکرپینگ در CSV، JSON و SQLite بررسی کردهایم.
یک پایپلاین ETL چگونه اجرا میشود؟
یک اجرای یک کار ETL زمانبندیشده برای اسکرپینگ از این گامها میگذرد:
- یک محرک اجرا را آغاز میکند. یک خط cron، یک هماهنگساز (orchestrator) مثل Apache Airflow یا کسی که اسکریپت را اجرا میکند.
- استخراج منبع را دریافت میکند. صفحهها با سرعتی مؤدبانه درخواست میشوند، درخواستهای ناموفق پس از مکث دوباره فرستاده میشوند و فیلدهای خام جمع میشوند.
- تبدیل هر رکورد را تمیز میکند. نوعها تبدیل و تکراریها حذف میشوند، و رکوردهایی که قاعدهای را میشکنند بهجای آنکه بیصدا رد شوند شمرده و در لاگ ثبت میشوند.
- دروازه کیفیت تصمیم میگیرد. اگر استخراج چیزی برنگرداند یا ردیفهای زیادی رد شده باشند، اجرا پیش از دست زدن به مقصد متوقف میشود. تغییر چیدمان سایت نباید داده خوب دیروز را بازنویسی کند.
- بارگذاری در یک تراکنش انجام میشود. ردیفها بر اساس کلید upsert میشوند؛ یا کل دسته ثبت میشود یا هیچچیز.
- اجرا گزارش میدهد. شمار ردیفهای استخراجشده، تمیز، ردشده و بارگذاریشده به لاگ یا هشدار میرود تا شکست بیصدا دیده شود.
در کارهای بزرگ این مرحلهها میتوانند همپوشانی داشته باشند و تبدیل روی دادهای که رسیده است شروع شود. برای چند هزار ردیف، اجرای پشت سر هم اشکالزدایی را آسانتر میکند.
ETL در برابر ELT: تفاوت چیست؟
ELT (استخراج، بارگذاری، تبدیل) همان سه گام را نگه میدارد اما تبدیل را به درون مقصد میبرد. داده خام همانطور که هست بارگذاری میشود و SQL یا موتور انبار داده بعداً آن را شکل میدهد. راهنمای مایکروسافت تفاوت را صریح میگوید: در ELT تبدیل درون مخزن داده مقصد رخ میدهد.
| ETL | ELT | |
|---|---|---|
| ترتیب | استخراج، تبدیل، سپس بارگذاری | استخراج، بارگذاری، سپس تبدیل |
| تمیزکاری کجا اجرا میشود | در اسکریپت شما یا یک موتور جداگانه | درون پایگاه داده یا انبار داده (SQL) |
| مقصد چه چیزی نگه میدارد | فقط ردیفهای تمیز و اعتبارسنجیشده | ردیفهای خام بهعلاوه جدولها یا viewهای تمیز |
| داده خام نگهداری میشود؟ | فقط اگر جداگانه ذخیرهاش کنید | بله، ذاتاً |
| نیاز مقصد | هر مخزنی، حتی یک فایل SQLite | مقصدی که توان تبدیل در مقیاس بالا را داشته باشد |
| رفع باگ تمیزکاری | استخراج دوباره یا اجرای دوباره از فایلهای خام ذخیرهشده | بازنویسی SQL و ساخت دوباره از جدولهای خام |
| مناسب برای | کارهای اسکرپینگ کوچک و متوسط، طرحوارههای سختگیر | حجم بالا، تحلیل اکتشافی، قواعد متغیر |
برای اسکرپینگ یک راه میانه مفید هم هست: HTML یا JSON خام هر اجرا را روی دیسک ذخیره کنید (یک ناحیه میانی یا staging) و تبدیل را از روی همان فایلها انجام دهید. اگر معلوم شود قاعدهای در تمیزکاری اشتباه بوده، جدول را بدون فرستادن حتی یک درخواست تازه به سایت دوباره میسازید.
چرا کار ETL باید دو بار اجرا شدن را تحمل کند؟
کارها وسط راه شکست میخورند. اتصال در صفحه 38 قطع میشود، دستگاه ریاستارت میشود، زمانبند دوباره تلاش میکند. پرسش این است که مقصد پس از تلاش دوم چه شکلی دارد. راهنمای بهترین شیوههای Apache Airflow مستقیم پاسخ میدهد: با هر وظیفه مثل یک تراکنش در پایگاه داده رفتار کنید، هرگز نتیجه ناقص تولید نکنید و یک INSERT ساده را با upsert جایگزین کنید، چون اجرای دوباره با INSERT ممکن است ردیف تکراری به جا بگذارد.
این ویژگی خودتوانی (idempotency) نام دارد: اجرای یکباره یا سهباره کار روی ورودی یکسان همان نتیجه را به جا میگذارد. در عمل از سه عادت به دست میآید:
- یک کلید طبیعی. هر ردیف شناسهای دارد که میان اجراها ثابت میماند. برای صفحه محصول URL مناسب است؛ شناسه خودافزا نه.
- upsert بهجای insert. upsert ردیف را اگر کلیدش وجود نداشته باشد درج میکند و اگر وجود داشته باشد بهروز میکند. SQLite از نسخه 3.24.0 از
INSERT … ON CONFLICT DO UPDATEپشتیبانی میکند و پیشوند ویژهexcluded.به مقدارهایی اشاره دارد که قرار بود درج شوند. PostgreSQL همین نحو را دارد. - یک تراکنش برای هر بارگذاری. دسته یا کامل ثبت میشود یا کامل برگردانده میشود، پس یک خرابی هیچوقت نیمی از جدول را به جا نمیگذارد.
زمانبندی و پایش یک کار ETL
کاری که فقط وقتی یادتان بیفتد اجرا میشود، یک اسکریپت است. برای یک دستگاه و یک کار، cron (یا Task Scheduler در Windows) کافی است. وقتی کارها به هم وابستهاند (اسکرپ، سپس تمیزکاری، سپس ساخت گزارش)، هماهنگساز ارزش خود را نشان میدهد. در Airflow هر پایپلاین یک DAG است، یعنی مجموعهای از وظیفهها با وابستگیها، و آرگومان schedule آن مقدارهای آمادهای مثل @daily، یک رشته cron یا یک بازه زمانی را میپذیرد. Airflow وظیفههای ناموفق را هم دوباره اجرا میکند و این دلیل دیگری است که وظیفهها باید خودتوان باشند.
پایش از روز اول به یک پلتفرم نیاز ندارد. در هر اجرا چهار عدد را ثبت کنید (صفحههای دریافتشده، ردیفهای استخراجشده، ردیفهای ردشده، ردیفهای بارگذاریشده) و برای دو وضعیت هشدار بگذارید: کار اجرا نشده، یا یکی از این عددها از مقدار معمولش بسیار فاصله گرفته است. افت از 1000 ردیف به 20 معمولاً یعنی سایت چیدمانش را عوض کرده، نه اینکه موجودی فروشگاه تمام شده باشد. برای سمت اسکرپینگ، پایش تغییرات یک وبسایت نشان میدهد چطور بفهمید خود صفحه کی تغییر کرده است.
جای پروکسی در ETL کجاست؟
فقط در گام استخراج، و فقط وقتی کار به آن نیاز دارد. چند صفحه در روز از یک سایت عمومی بهندرت پروکسی لازم دارد. پروکسی وقتی اهمیت پیدا میکند که قیمتهایی را جمع میکنید که در هر کشور فرق دارند، وقتی یک کار مشروع با درخواستهای زیاد به محدودیتهای بهازای هر IP سایت برمیخورد، یا وقتی منبع محتوای وابسته به موقعیت نشان میدهد. یک پروکسی مسکونی به گام استخراج اجازه میدهد صفحهها را از کشور و شهر دلخواه درخواست کند؛ یک پروکسی چرخشی درخواستها را در خزشهای بزرگتر میان IPهای مختلف پخش میکند.
پروکسی قواعد را عوض نمیکند. robots.txt سایت، شرایط استفاده آن و نرخ درخواست معقول همچنان پابرجاست، و هر جا API رسمی یا خروجی آمادهای وجود دارد، اول سراغ آن بروید. سمت درخواستها را با جزئیات بیشتر در وب اسکرپینگ بدون مسدود شدن و در صفحه استخراج داده بررسی کردهایم.
یک کار ETL کامل در Python
اسکریپت زیر یک پایپلاین کامل در یک فایل است. همه کارتهای کتاب را از books.toscrape.com، محیطی که برای تمرین اسکرپینگ ساخته شده، استخراج میکند، فیلدها را به ردیفهایی با نوع درست تبدیل میکند و با upsert در SQLite بارگذاری میکند. در پاسخهای 429 و 5xx با مکثهای فزاینده دوباره تلاش میکند، میان صفحهها یک ثانیه صبر میکند، اگر ردیفهای زیادی از اعتبارسنجی رد شوند متوقف میشود و فقط وقتی PROXY_URL را تنظیم کنید ترافیک را از پروکسی عبور میدهد.
اول دو وابستگی را نصب کنید:
pip install requests beautifulsoup4سپس این کد را با نام etl_books.py ذخیره کنید:
"""A small ETL job: books.toscrape.com -> clean rows -> SQLite."""
import argparse
import logging
import os
import sqlite3
import time
import unicodedata
from datetime import datetime, timezone
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

BASE = "https://books.toscrape.com/catalogue/"
RATINGS = {"One": 1, "Two": 2, "Three": 3, "Four": 4, "Five": 5}
log = logging.getLogger("etl")


def make_session():
    retry = Retry(total=4, backoff_factor=1.5,
                  status_forcelist=(429, 500, 502, 503, 504),
                  respect_retry_after_header=True)
    s = requests.Session()
    s.mount("https://", HTTPAdapter(max_retries=retry))
    s.headers["User-Agent"] = "etl-demo/1.0 (contact: you@example.com)"
    proxy = os.getenv("PROXY_URL")  # e.g. http://user:pass@pr.proxynet.io:8000
    if proxy:
        s.proxies = {"http": proxy, "https": proxy}
    return s


# ---------- EXTRACT: fetch pages, keep the raw strings ----------
def extract(session, max_pages, delay=1.0):
    raw, url, page = [], urljoin(BASE, "page-1.html"), 0
    while url and page < max_pages:
        resp = session.get(url, timeout=15)
        resp.raise_for_status()
        soup = BeautifulSoup(resp.content, "html.parser")
        for card in soup.select("article.product_pod"):
            raw.append({
                "title": card.h3.a["title"],
                "href": card.h3.a["href"],
                "price": card.select_one("p.price_color").get_text(),
                "rating": card.select_one("p.star-rating")["class"][-1],
                "stock": card.select_one("p.availability").get_text(),
                "page_url": url,
            })
        page += 1
        nxt = soup.select_one("li.next a")
        url = urljoin(url, nxt["href"]) if nxt else None
        time.sleep(delay)
    log.info("extract: %d pages, %d raw rows", page, len(raw))
    return raw


# ---------- TRANSFORM: types, cleaning, dedupe, validation ----------
def transform(raw):
    clean, rejected, seen = [], 0, set()
    now = datetime.now(timezone.utc).isoformat(timespec="seconds")
    for r in raw:
        try:
            url = urljoin(r["page_url"], r["href"])
            if url in seen:
                continue
            seen.add(url)
            title = " ".join(unicodedata.normalize("NFKC", r["title"]).split())
            price = float(r["price"].strip().lstrip("£"))
            rating = RATINGS[r["rating"]]
            in_stock = "in stock" in r["stock"].lower()
            if not title or price <= 0:
                raise ValueError("empty title or bad price")
        except (KeyError, ValueError) as exc:
            rejected += 1
            log.warning("rejected %r: %s", r.get("title"), exc)
            continue
        clean.append((url, title, price, rating, int(in_stock), now))
    log.info("transform: %d clean, %d rejected", len(clean), rejected)
    return clean, rejected


# ---------- LOAD: upsert into SQLite in one transaction ----------
def load(rows, db_path):
    con = sqlite3.connect(db_path)
    with con:  # commits on success, rolls back on error
        con.execute("""CREATE TABLE IF NOT EXISTS books (
            url TEXT PRIMARY KEY, title TEXT NOT NULL, price_gbp REAL NOT NULL,
            rating INTEGER, in_stock INTEGER, updated_at TEXT)""")
        con.executemany("""INSERT INTO books VALUES (?, ?, ?, ?, ?, ?)
            ON CONFLICT(url) DO UPDATE SET title=excluded.title,
              price_gbp=excluded.price_gbp, rating=excluded.rating,
              in_stock=excluded.in_stock, updated_at=excluded.updated_at""", rows)
        total = con.execute("SELECT COUNT(*) FROM books").fetchone()[0]
    con.close()
    log.info("load: %d rows upserted, %d rows in table", len(rows), total)
    return total


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--pages", type=int, default=3)
    ap.add_argument("--db", default="books.db")
    args = ap.parse_args()
    logging.basicConfig(level=logging.INFO, format="%(asctime)s %(levelname)s %(message)s")
    raw = extract(make_session(), args.pages)
    rows, rejected = transform(raw)
    if not rows or rejected > len(raw) * 0.1:  # guard: don't load a broken batch
        raise SystemExit(f"aborting load: {len(rows)} clean, {rejected} rejected")
    load(rows, args.db)


if __name__ == "__main__":
    main()
آن را برای کل کاتالوگ با python etl_books.py --pages 60 اجرا کنید. سایت 50 صفحه دارد، پس حلقه وقتی پیوند "next" ناپدید شود خودبهخود میایستد. اجرای ما این خروجی را داد:
INFO extract: 50 pages, 1000 raw rows
INFO transform: 1000 clean, 0 rejected
INFO load: 1000 rows upserted, 1000 rows in table
بار دوم اجرا کنید و خط آخر باز هم با 1000 rows in table تمام میشود. upsert ردیفهای موجود را بهروز کرد و نسخه تکراری نساخت؛ این همان خودتوانی است که بالاتر توضیح دادیم. مسیرهای شکست را هم آزمودیم. وقتی زمان یک اتصال به پایان رسید، تلاشهای دوباره اجرا شدند و اسکریپت پیش از گام بارگذاری با خطا خارج شد، پس جدول ردیفهای قبلیاش را نگه داشت. وقتی به transform() قیمت £x و امتیاز Six دادیم، هر دو ردیف با دلیل ثبتشده در لاگ رد شدند و یک URL تکراری هم بهعنوان رکورد تکراری حذف شد.
برای اینکه گام استخراج از پروکسی عبور کند، پیش از اجرا متغیر را تنظیم کنید؛ هیچ چیز دیگری تغییر نمیکند:
export PROXY_URL="http://user:pass@pr.proxynet.io:8000"
python etl_books.py --pages 60
برای اجرای هر شب ساعت 03:00 در Linux، خطی مثل 0 3 * * * cd /opt/etl && .venv/bin/python etl_books.py --pages 60 >> etl.log 2>&1 را به crontab اضافه کنید. وقتی چند کار وابسته به هم داشتید، آنها را به یک هماهنگساز منتقل کنید.
کاربردهای ETL با داده وب
- پایش قیمت: یک کار شبانه قیمتهای رقبا را استخراج میکند، واحدهای پول را یکدست میکند و جدولی از تاریخچه را بارگذاری میکند؛ صفحه پایش قیمت و رصد قیمت رقبا را ببینید.
- تحقیقات بازار: تعداد محصولات، امتیازها و تغییرات تنوع کالا در فروشگاههای زیاد، بارگذاریشده در یک طرحواره واحد؛ تحقیقات بازار را ببینید.
- خزشهای بزرگ: اول هزاران URL کشف میشوند و سپس از هر کدام داده استخراج میشود؛ صفحه خزنده وب ما بخش کشف را پوشش میدهد.
- دادههای جایگزین: تحلیلگران داده وب را با منابع دیگر ترکیب میکنند و قواعد کیفیت در گام تبدیل تعیین میکنند که آیا میتوان به نتیجه اعتماد کرد؛ دادههای جایگزین چیست؟ را ببینید.
- تحلیل و کاوش: جدولی تمیز و بارگذاریشده همان ورودی است که دادهکاوی لازم دارد.
اشتباههای رایج در ETL
- تمیزکاری درون گام استخراج. وقتی تجزیه و تبدیل نوع در یک حلقه انجام میشوند، نمیتوانید تغییر سایت را از باگ قواعد خودتان تشخیص دهید. استخراج را خام نگه دارید.
INSERTساده در هر اجرا. اجرای دوم جدول را دو برابر میکند. از کلید طبیعی و upsert استفاده کنید.- نبود دروازه کیفیت. یک تغییر چیدمان همه قیمتها را به
Noneتبدیل میکند و کار با خیال راحت 1000 ردیف خالی را روی داده خوب بارگذاری میکند. - ثبت ردیف به ردیف. خرابی در میانه کار جدولی به جا میگذارد که نه وضعیت قبلی است و نه وضعیت جدید.
- رد کردن بیصدا. دور ریختن ردیفهای بد بدون شمردن آنها مشکل را پنهان میکند تا روزی که کسی متوجه شود عددها کم به نظر میرسند.
- کدگذاری نادرست. خواندن بایتها با مجموعهنویسه اشتباه
£را به£تبدیل میکند؛ نوشته ما درباره خطاهای Unicode در پایتون علت را توضیح میدهد. - نادیده گرفتن محدودیتهای منبع. بدون تأخیر، بدون مکث میان تلاشها، بدون احترام به
Retry-After. سایت شروع به پاسخ دادن با429میکند؛ خطای 429 Too Many Requests چیست؟ را ببینید.
راهنمای انتخاب
| وضعیت شما | چه چیزی به کار ببرید |
|---|---|
| یک منبع، چند هزار ردیف، یک نفر | یک اسکریپت ETL در Python با SQLite که cron اجرایش میکند |
| قواعد اغلب تغییر میکنند و میخواهید داده خام را نگه دارید | ELT: ردیفها یا فایلهای خام را بارگذاری و با SQL تبدیل کنید |
| چند کار که به هم وابستهاند | یک هماهنگساز مثل Apache Airflow |
| حجم بالا و انبار داده ابری که از قبل دارید | ELT درون انبار داده |
| قیمت یا محتوایی که در هر کشور فرق دارد | ETL با پروکسی residential در گام استخراج |
| منبع API یا فایل دانلودی ارائه میدهد | از API استخراج کنید و اسکرپینگ را کنار بگذارید |
پرسشهای متداول
ETL مخفف چیست؟
Extract، transform، load یعنی استخراج، تبدیل و بارگذاری. داده از یک منبع استخراج میشود، به شکلی یکدست و اعتبارسنجیشده تبدیل میشود و در مخزن مقصدی مثل پایگاه داده یا انبار داده بارگذاری میشود.
آیا وب اسکرپینگ همان ETL است؟
نه. اسکرپینگ یکی از راههای انجام گام استخراج است. ETL آنچه را بعد از آن رخ میدهد هم در بر میگیرد: تمیزکاری، حذف تکرار، اعتبارسنجی و بارگذاری داده در جایی که بتوان از آن پرسوجو کرد و بهروز نگهش داشت.
آیا ETL هنوز به کار میرود یا ELT جایش را گرفته است؟
هر دو به کار میروند. ELT وقتی رایج است که انبار داده ابری بتواند تبدیل سنگین را انجام دهد و داده خام باید نگهداری شود. ETL همچنان انتخاب طبیعی است وقتی مقصد کوچک است، طرحواره سختگیر است یا داده باید پیش از ذخیره تمیز شود.
آیا میتوان فقط با Python یک پایپلاین ETL ساخت؟
بله. برای کارهای کوچک و متوسط، requests، یک تجزیهگر HTML و ماژول sqlite3 کتابخانه استاندارد کافی است، همانطور که اسکریپت بالا نشان میدهد. کتابخانههایی مثل pandas وقتی گام تبدیل سنگینتر میشود کمک میکنند.
پایپلاین ETL چیست؟
همان فرایند ETL است که برای اجرای مکرر آماده شده: یک محرک، سه گام، یک دروازه کیفیت و یک گزارش، معمولاً طبق یک زمانبندی. یک اسکریپت یکبارمصرف وقتی به پایپلاین تبدیل میشود که بتواند بدون نظارت اجرا شود و از شکستها بازیابی شود.
آیا برای ETL به Airflow نیاز دارم؟
برای یک کار روی یک دستگاه نه؛ cron کافی است. هماهنگساز وقتی کمک میکند که چند وظیفه به هم وابستهاند، به تلاش دوباره و تاریخچه اجرا نیاز دارند یا میان اعضای یک تیم مشترکاند.
خلاصه
ETL بخشی از پروژه داده است که بعد از جمعآوری میآید: داده خام را استخراج کنید، آن را به ردیفهایی با نوع درست، بدون تکرار و اعتبارسنجیشده تبدیل کنید و در یک تراکنش با upsert بارگذاری کنید تا اجرای دوباره هرگز جدول را دو برابر نکند. ELT گام تبدیل را به درون مقصد میبرد و برای انبارهای داده بزرگ مناسب است؛ برای بیشتر کارهای اسکرپینگ، یک اسکریپت ETL کوچک با SQLite شروع درستی است. یک دروازه کیفیت و چهار عدد ثبتشده اضافه کنید، کار را زمانبندی کنید و فقط وقتی سراغ پروکسی بروید که گام استخراج به موقعیت دیگری یا IPهای بیشتری نیاز داشته باشد. در آن صورت پلنهای پروکسی ما را ببینید.


