


































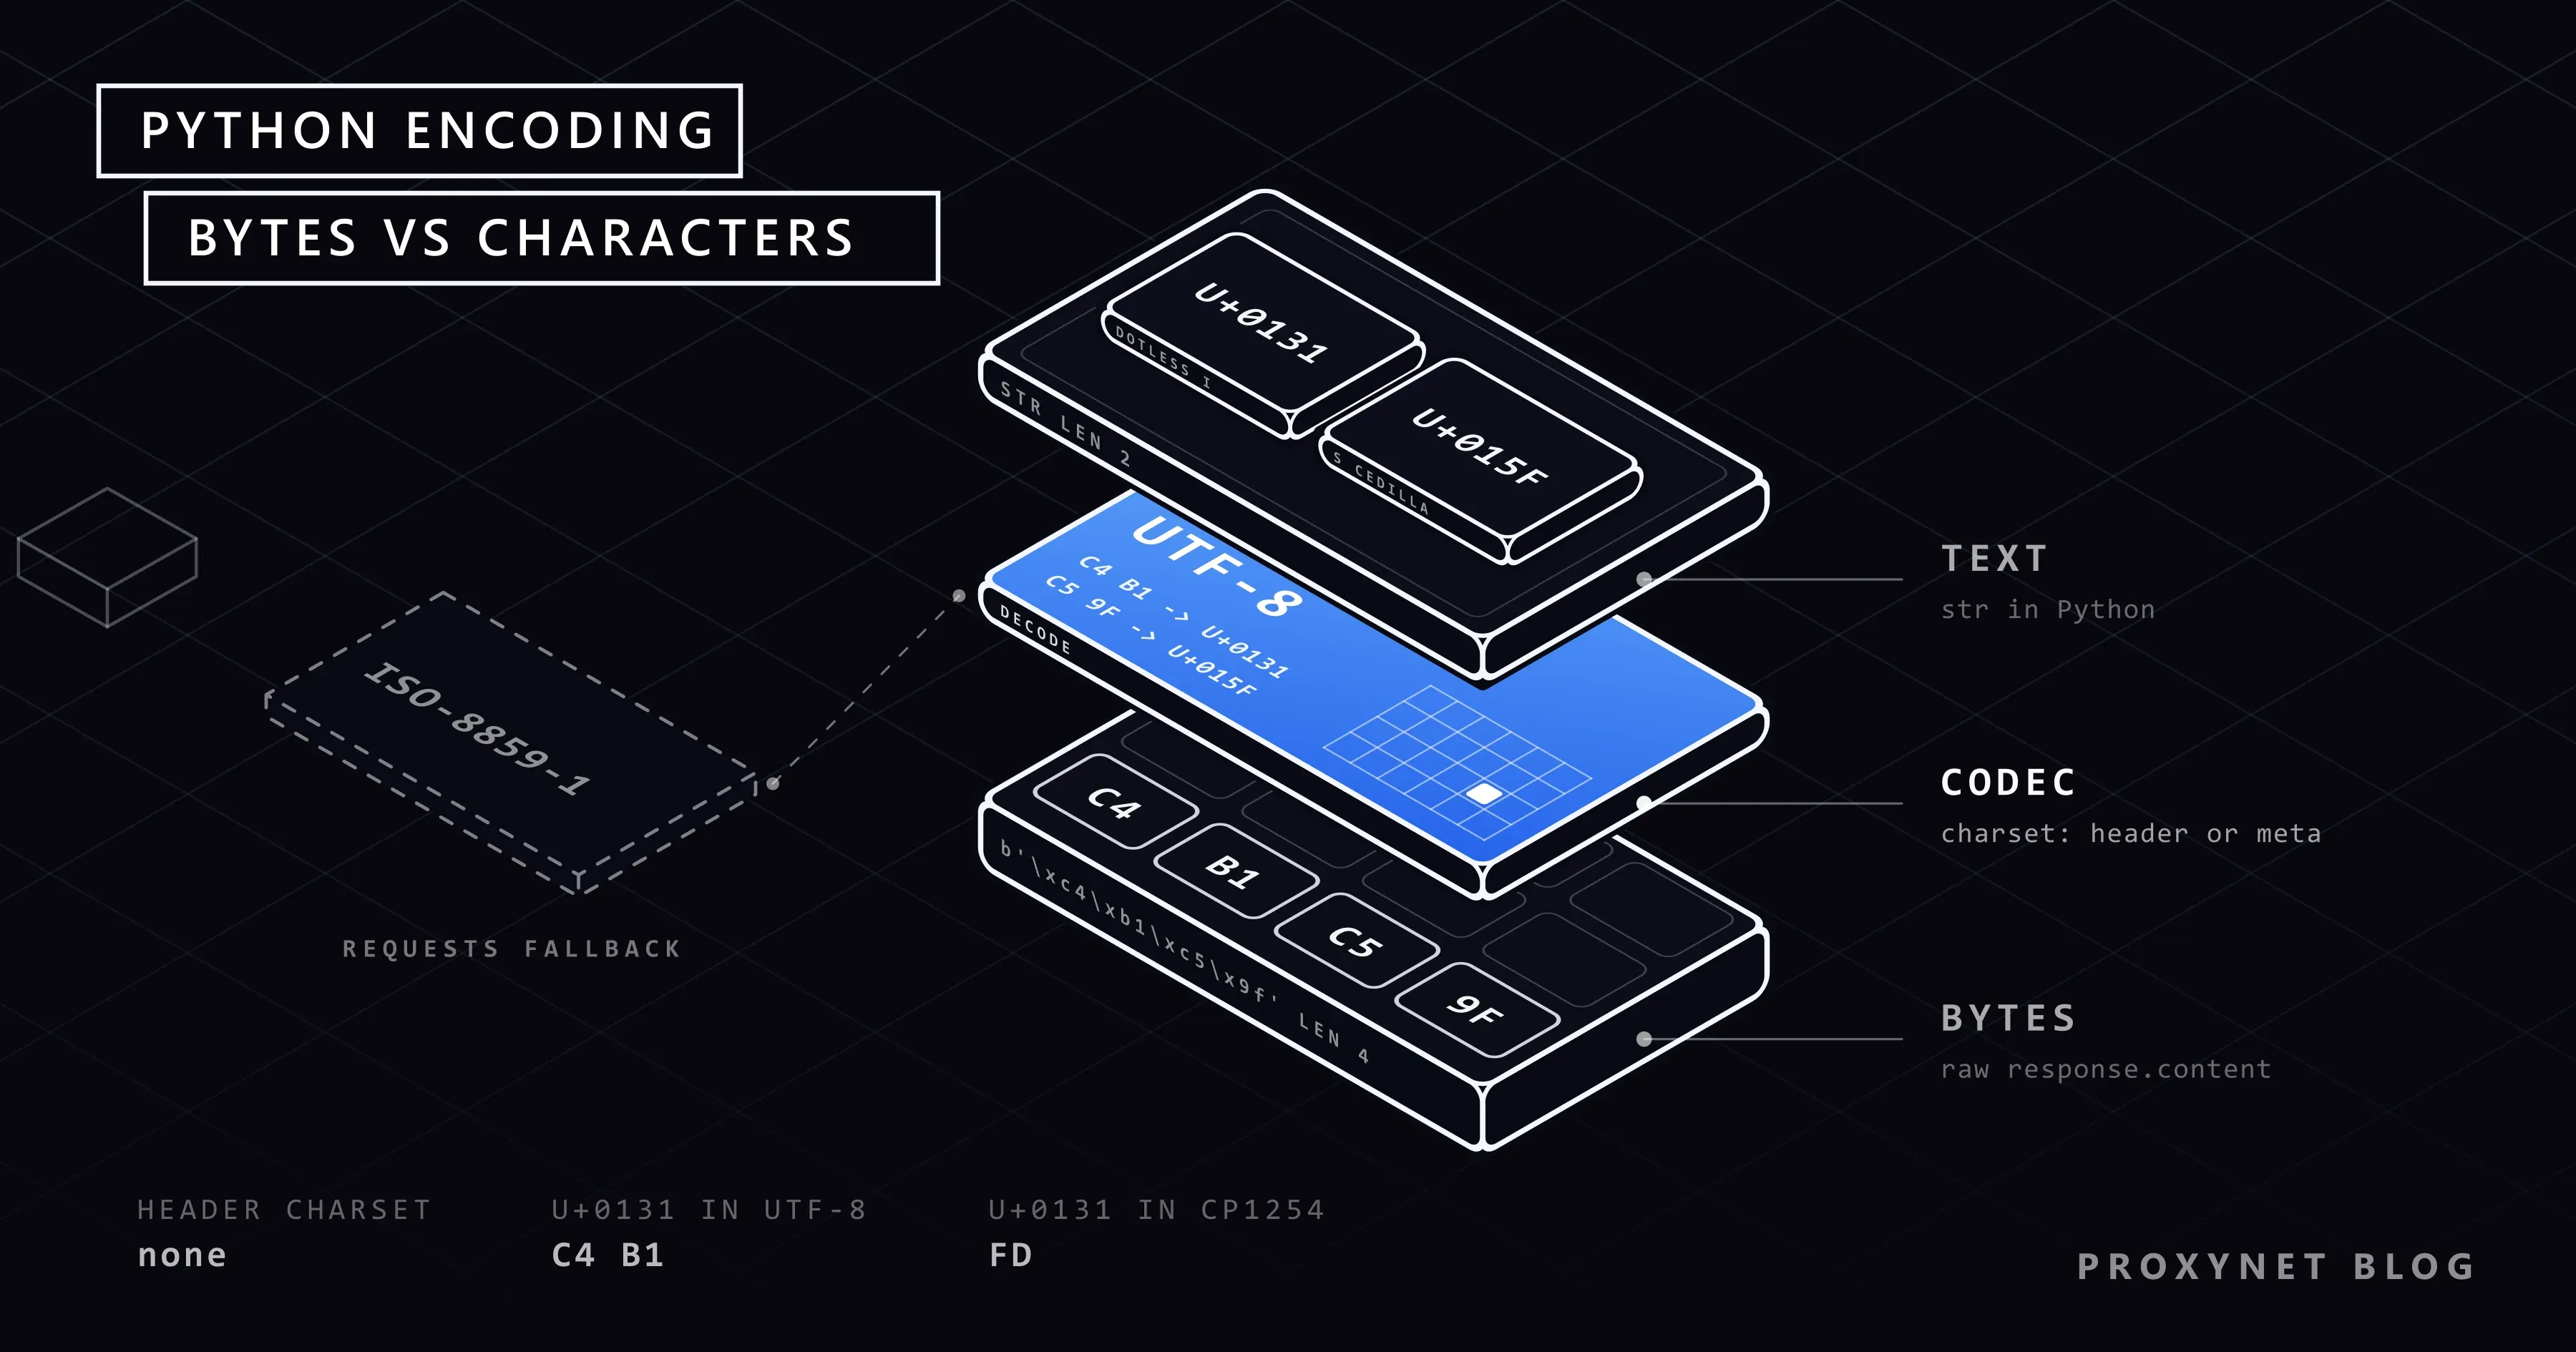
اسکریپتی آگهیهای مناقصه را از وبسایت قدیمی یک شهرداری در ترکیه جمع میکند. عنوانی که در مرورگر Çankırı İhale İlanı خوانده میشود، در خروجی اسکریپت به شکل Çankýrý Ýhale Ýlaný چاپ میشود. فهرستی هم که اسکریپت روی یک لپتاپ ویندوزی ذخیره کرده، روی سرور لینوکس باز نمیشود و این خطا را میدهد: 'utf-8' codec can't decode byte 0xc7 in position 0: invalid continuation byte. هر دو مشکل یک علت دارند: بایتها با یک جدول کد نوشته شدهاند و با جدولی دیگر خوانده شدهاند.
این راهنما همین علت را هر جا که ظاهر شود برطرف میکند: فایلهای منبع، open()، کنسول ویندوز، صفحههایی که با Requests و Beautiful Soup دریافت میشوند و فایلهای CSV برای Excel. همچنین نشان میدهد متن خراب را چگونه بخوانید و ترمیم کنید. همه مقدارهای بایت و پیامهای خطای این نوشته از اجراهای خودمان با Python 3.13 آمدهاند.
تفاوت str و bytes در پایتون چیست؟
یک str نویسهها را نگه میدارد و هر نویسه یک نقطه کد یونیکد دارد: حرف ترکی ı (i بینقطه) U+0131 است و é U+00E9. دیسکها و شبکهها فقط بایت ذخیره میکنند، پس متن هنگام بیرون رفتن رمزگذاری و هنگام وارد شدن رمزگشایی میشود. کدک تعیین میکند کدام بایتها نماینده کدام نویسهاند. در UTF-8، حرف ı دو بایت است: C4 B1. در windows-1254، صفحه کد قدیمی ترکی در ویندوز، یک بایت است: FD. صفحه کد اروپای غربی cp1252 و ISO-8859-1 اصلاً ı ندارند. حروف فارسی هم همین وضع را دارند: ی (U+06CC) در UTF-8 دو بایت DB 8C است، اما windows-1256، صفحه کد قدیمی عربی و فارسی در ویندوز، این حرف را ندارد و فقط یای عربی (U+064A) را در بایت ED نگه میدارد.
وقتی نویسنده و خواننده کدکهای متفاوتی به کار میبرند، بایتها سالم میمانند اما حرفها عوض میشوند. به این پدیده mojibake میگویند و اغلب میتوان آن را برگرداند.
یک نویسه چگونه به نویسهای اشتباه تبدیل میشود؟
هر خطای رمزگذاری همین گامها را طی میکند:
- متن شما یونیکد است.
"Çankırı"در پایتون هفت نقطه کد است. - با کدک A رمزگذاری میشود. ویندوز ترکی در cp1254 بایتهای
C7 61 6E 6B FD 72 FDرا مینویسد. - فقط بایتها جابهجا میشوند. یک فایل، بدنه یک پاسخ HTTP یا یک pipe چیزی درباره کدک A نمیگوید، مگر اینکه یک هدر، یک BOM یا تگ
<meta>آن را اضافه کند. - کسی با کدک B رمزگشایی میکند. ISO-8859-1 بایت
FDرا بهýنگاشت میکند و نتیجهÇankýrýمیشود. UTF-8 نمیتواندC7 61را یک نویسه بخواند، پسUnicodeDecodeErrorمیدهد. - خروجی دوباره رمزگذاری میشود.
print()وwrite()کدک کنسول یا فایل را به کار میبرند و نویسهای که در آن کدک نباشدUnicodeEncodeErrorمیدهد.
traceback به شما میگوید کدام جهت شکست خورده است.
متن خراب چه چیزی به شما میگوید؟
شکل خرابی نشان میدهد کدام دو کدک با هم اشتباه گرفته شدهاند.
| آنچه میبینید | متن واقعی | چه اتفاقی افتاده | چه باید کرد |
|---|---|---|---|
café، ü، ı، ÅŸ | café، ü، ı، ş | بایتهای UTF-8 (C3 A9، C4 B1) با cp1252 یا ISO-8859-1 رمزگشایی شدهاند | بایتها را با UTF-8 رمزگشایی کنید یا متن را ترمیم کنید (پایینتر) |
ý، þ، ð، Ý | ı، ş، ğ، İ | بایتهای windows-1254 (FD، FE، F0، DD) با ISO-8859-1، یعنی پیشفرض Requests، رمزگشایی شدهاند | r.encoding = "cp1254" را تنظیم کنید یا r.content را به Beautiful Soup بدهید |
ţ بهجای ş | ş | حدس خودکار برای یک صفحه ترکی windows-1250 را انتخاب کرده است | کدک آن سایت را ثابت کنید |
� | هر حرف غیر ASCII | بایتها با UTF-8 و errors="replace" رمزگشایی شدهاند | در متن از دست رفته است؛ بایتهای خام را دوباره رمزگشایی کنید |
? | هر حرفی | متن با errors="replace" به کدکی رمزگذاری شده که آن حرف را ندارد | از دست رفته است؛ با UTF-8 بنویسید |
| یک مربع خالی | حرف درست | فونت گلیف آن حرف را ندارد (PDF، ترمینال قدیمی) | فونت را عوض کنید، نه رمزگذاری را |
متن فارسی در حالت ردیف نخست شکلی آشنا پیدا میکند: اگر بایتهای UTF-8 واژه «سلام» با cp1252 خوانده شوند، سلام نمایش داده میشود.
آیا در Python 3 هنوز به # -*- coding: utf-8 -*- نیاز دارید؟
نه. PEP 3120 در Python 3.0 UTF-8 را رمزگذاری پیشفرض فایلهای منبع کرد، پس این خط یادگار Python 2 است. اگر رشتههای متنی فایل .py شما هنوز خراب میشوند، ویرایشگرتان آن را در یک صفحه کد قدیمی ذخیره کرده است (در ویندوز «ANSI»)؛ آن را با UTF-8 ذخیره کنید. توصیههای دیگر دوران Python 2، مانند پیشوند u"" و codecs.open()، هم دیگر لازم نیستند.
هنگام خواندن و نوشتن فایل رمزگذاری را چگونه تعیین کنیم؟
هر بار آن را بدهید: open("cities.txt", "w", encoding="utf-8"). بدون آن، Python 3.13 در ویندوز صفحه کد ANSI را به کار میبرد. روی دستگاه ویندوز ترکی ما locale.getpreferredencoding(False) مقدار cp1254 را برگرداند و یک open("cities.txt", "w") ساده واژه Çankırı را به شکل C7 61 6E 6B FD 72 FD نوشت. ویندوز انگلیسی cp1252 را به کار میبرد که ı ندارد، پس همان نوشتن با خطای 'charmap' codec can't encode character '\u0131' شکست میخورد.
برای فایلهایی که دریافت میکنید، کدکی را به کار ببرید که با آن نوشته شدهاند: cp1254 برای خروجیهای قدیمی ویندوز و Excel ترکی، cp1252 برای خروجیهای اروپای غربی و cp1256 برای عربی و فارسی. آرگومان errors تعیین میکند با بایتهایی که در کدک جا نمیشوند چه شود:
strict، یعنی پیشفرض، خطا میدهد و تا وقتی دنبال کدک درست هستید همین را میخواهید.replaceبهجای هر بایت خراب�میگذارد تا ببینید خرابی کجاست.backslashreplaceبایتهای خراب را به شکل\xfdقابل دیدن نگه میدارد.ignoreآنها را بیصدا حذف میکند:Iğdırکه با cp1254 نوشته و با UTF-8 خوانده شد، بهIdrتبدیل شد.
توصیه «فقط latin-1 را امتحان کنید» هم به همین شکل شکست میخورد. ISO-8859-1 هر 256 مقدار بایت را به نویسه نگاشت میکند، پس هرگز خطا نمیدهد و متن ترکی بیصدا به Çankýrý تبدیل میشود.
خطای UnicodeDecodeError: 'utf-8' codec can't decode byte
فایل UTF-8 نیست و بایتی که در پیام آمده سرنخ است: 0xfd، 0xfe یا 0xf0 در داده ترکی به cp1254 اشاره میکند، در حالی که 0xe9 (é) یا 0xfc (ü) نشان cp1252 است. در فایل فارسی cp1256 واژه «پروکسی» با بایت 0x81 (پ) آغاز میشود و UTF-8 روی همان بایت با invalid start byte متوقف شد. در pandas کدک را بدهید: pd.read_csv("export.csv", sep=";", encoding="cp1254").
خطای UnicodeEncodeError: 'charmap' codec can't encode character در ویندوز
کنسول تعاملی ویندوز از Python 3.6 به بعد (PEP 528) با UTF-8 مینویسد، اما خروجیای که به فایل یا pipe هدایت شود صفحه کد ANSI را به کار میبرد. حرفهای ترکی در cp1254 جا میشوند، اما پیکان جا نمیشود: python script.py > out.txt با print("Istanbul → Ankara") با خطای 'charmap' codec can't encode character '\u2192' شکست خورد. سه راهحل کار کرد:
set PYTHONUTF8=1(در PowerShell:$env:PYTHONUTF8=1) حالت UTF-8 را برای فایلها و جریانهای استاندارد روشن میکند.python -X utf8 script.pyهمین کار را برای یک اجرا انجام میدهد.PYTHONIOENCODING=utf-8فقط جریانهای استاندارد را تغییر میدهد، نهopen()را.
راهنمای پایتون در ویندوز حالت UTF-8 را مستند کرده است. PEP 686 حالت UTF-8 را از Python 3.15 پیشفرض میکند که انتشار نهایی آن برای 1 اکتبر 2026 برنامهریزی شده است. تا وقتی همه دستگاهها این نسخه را اجرا نکنند، encoding="utf-8" را در کدتان نگه دارید.
گونه 'latin-1' codec can't encode character معمولاً از یک هدر HTTP میآید. http.client، که Requests در لایه زیرین به کار میبرد، مقدار هدرها را با Latin-1 رمزگذاری میکند، پس هدری با مقدار Iğdır به همین شکل شکست خورد. چنین مقدارهایی را با کدگذاری درصدی بفرستید یا در بدنه درخواست قرار دهید.
رمزگذاری یک صفحه وب از کجا میآید؟
مرورگر رمزگذاری صفحه را به این ترتیب تعیین میکند:
- نشانه ترتیب بایت (BOM) در ابتدای بدنه.
- پارامتر
charsetدر هدرContent-Type. - تگ
<meta charset>که به گفته MDN باید در 1024 بایت نخست باشد. - حدسی بر پایه خود بایتها.
Requests فقط هدر را میخواند. برای نوع text/* بدون charset، مستندات Requests میگوید از RFC 2616 پیروی میکند و ISO-8859-1 را به کار میبرد، هرچند RFC 7231 این پیشفرض را در 2014 حذف کرد. پاسخ JSON بدون charset بهصورت UTF-8 خوانده میشود و نوعهای دیگر حدس زده میشوند. در صفحههای آزمایشی ما که با text/html ساده ارائه میشدند، r.encoding هر بار ISO-8859-1 بود. به همین دلیل یک صفحه میتواند در مرورگر درست و در اسکریپت شما نادرست دیده شود.
آیا windows-1254 و ISO-8859-9 یکی هستند؟
تقریباً. هر دو حرفهای ترکی را روی بایتهای یکسانی از 0xA0 تا 0xFF قرار میدهند. در بازه 0x80 تا 0x9F، windows-1254 نویسههای €، “، ” و … را دارد، در حالی که ISO-8859-9 آنجا کدهای کنترلی نامرئی دارد. استاندارد Encoding از WHATWG به مرورگرها میگوید iso-8859-9 را windows-1254 و iso-8859-1 را windows-1252 بخوانند؛ پایتون آنها را کدکهای جداگانه میداند. در صفحه ما که برچسب iso-8859-9 داشت، Beautiful Soup خروجی \x93Kampanya\x94 10\x80 داد و با from_encoding="cp1254" همان بایتها به “Kampanya” 10€ تبدیل شدند. چنین صفحههایی را با cp1254 یا cp1252 رمزگشایی کنید.
صفحه HTML خودتان charset را چگونه اعلام کند؟
فایل را با UTF-8 ذخیره کنید، <meta charset="utf-8"> را در بالای <head> بگذارید و مطمئن شوید هدر Content-Type سرور charset دیگری را نام نمیبرد، چون هدر بر تگ برتری دارد.
response.encoding، apparent_encoding یا Beautiful Soup؟
هر گزینه نشانه متفاوتی را میخواند:
r.encodingاز هدر میآید. تنظیمr.encoding = "cp1254"یک سایت شناختهشده را درست میکند؛ تنظیم"utf-8"برای همه سایتها صفحههای windows-1254 را خراب میکند (در صفحه آزمایشی ما�ank�r�).r.apparent_encodingحدسی است که charset-normalizer از روی بدنه میزند. برای یکی از صفحههای ترکی ماWindows-1254گفت و برای دو صفحه دیگرwindows-1250کهşرا بهţتبدیل میکند.BeautifulSoup(r.content, "html.parser")خودش تگ<meta>را میخواند. بایت بدهید، نهr.text؛ بخش تجزیه در آموزش Beautiful Soup آمده است.
ترتیب ما از مرورگر پیروی میکند: BOM، charset در هدر، تگ <meta> و سپس حدس؛ و ثبت کنید کدام را به کار بردهاید. HTTPX رفتار دیگری دارد: نسخه 0.28.1 وقتی هدر charset ندارد UTF-8 را فرض میکند و صفحه cp1254 ما به شکل �ank�r� درآمد (مقایسه HTTPX، Requests و AIOHTTP).
اسکرپر پایتونی که صفحهها را مانند مرورگر رمزگشایی میکند
اسکریپت هر URL را یک بار دریافت میکند، کدک را به همان ترتیب انتخاب میکند، برچسبهای ISO را مانند مرورگرها نگاشت میکند و عنوانها را در یک فایل CSV برای Excel مینویسد. به pip install requests beautifulsoup4 نیاز دارد. تلاش دوباره نمیکند و IP را نمیچرخاند؛ برای این دو، کدهای وضعیت HTTP در وب اسکرپینگ و چرخاندن پروکسی در پایتون را ببینید.
"""Fetch pages, decode each one the way a browser would, and save the headings to a CSV for Excel."""
import csv
import logging
import sys
from email.message import Message

import requests
from bs4 import BeautifulSoup
from bs4.dammit import EncodingDetector

PROXY = None  # for example "http://user:pass@pr.proxynet.io:8000"
USER_AGENT = "heading-reader/1.0 (+https://example.com/bot)"

# Browsers read these labels as Windows code pages (WHATWG Encoding Standard); Python does not.
BROWSER_ALIASES = {
    "iso-8859-1": "cp1252", "iso8859-1": "cp1252", "latin1": "cp1252", "latin-1": "cp1252",
    "us-ascii": "cp1252", "ascii": "cp1252",
    "iso-8859-9": "cp1254", "iso8859-9": "cp1254", "latin5": "cp1254",
}

log = logging.getLogger("headings")


def header_charset(resp):
    """The charset from the Content-Type header, or None. Requests' own r.encoding
    would say ISO-8859-1 here for any text/* type without a charset."""
    msg = Message()
    msg["content-type"] = resp.headers.get("Content-Type", "")
    return msg.get_param("charset")


def pick_codec(resp):
    """Return (codec, where it came from): a BOM, the header, <meta charset>, then a guess."""
    bom = EncodingDetector.strip_byte_order_mark(resp.content)[1]
    if bom:
        return bom, "bom"
    declared = header_charset(resp)
    source = "header"
    if not declared:
        declared = EncodingDetector.find_declared_encoding(resp.content, is_html=True)
        source = "meta"
    if not declared:
        return resp.apparent_encoding or "utf-8", "guess"
    return BROWSER_ALIASES.get(declared.lower(), declared), source


def clean(text):
    """Collapse runs of whitespace, including the non-breaking space U+00A0."""
    return " ".join(text.split())


def read_headings(session, url):
    resp = session.get(url, timeout=20)
    resp.raise_for_status()
    codec, source = pick_codec(resp)
    soup = BeautifulSoup(resp.content, "html.parser", from_encoding=codec)
    level = logging.WARNING if source == "guess" else logging.INFO
    log.log(level, "%s: %s from %s", url, codec, source)
    if soup.contains_replacement_characters:
        log.warning("%s: some bytes did not fit %s and became U+FFFD", url, codec)
    return [(url, codec, source, clean(h.get_text())) for h in soup.select("h1, h2")]


def main(urls, out="headings.csv"):
    session = requests.Session()
    session.headers["User-Agent"] = USER_AGENT
    if PROXY:
        session.proxies = {"http": PROXY, "https": PROXY}
    rows = []
    for url in urls:
        try:
            rows += read_headings(session, url)
        except requests.RequestException as exc:
            log.error("%s: %s", url, exc)
    # utf-8-sig writes a BOM first, so Excel recognises the file as UTF-8
    with open(out, "w", newline="", encoding="utf-8-sig") as f:
        writer = csv.writer(f)
        writer.writerow(["url", "codec", "source", "heading"])
        writer.writerows(rows)
    log.info("%d headings written to %s", len(rows), out)


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO, format="%(levelname)-7s %(message)s")
    main(sys.argv[1:] or ["https://example.com/"])
آن را با Python 3.13، Requests 2.34.2 و Beautiful Soup 4.15.0 از راه یک پروکسی HTTP محلی اجرا کردیم. صفحههای آزمایشی محلی، بهجز utf8hdr، با text/html و بدون charset ارائه میشدند و آخرین URL یک صفحه عمومی است:
INFO    http://127.0.0.1:8057/cp1254: windows-1254 from meta
INFO    http://127.0.0.1:8057/iso9: cp1254 from meta
INFO    http://127.0.0.1:8057/utf8meta: utf-8 from meta
INFO    http://127.0.0.1:8057/utf8hdr: utf-8 from header
INFO    http://127.0.0.1:8057/latin1: cp1252 from meta
WARNING http://127.0.0.1:8057/nometa: windows-1250 from guess
WARNING https://example.com/: ascii from guess
INFO    12 headings written to headings.csv
همه صفحههایی که charset در هدر یا تگ <meta> داشتند درست درآمدند، از جمله “quoted” 5€ در صفحهای که برچسب ISO-8859-1 داشت. نقطه ضعف صفحهای است که هیچکدام را نداشت: حدس windows-1250 بود و در CSV مقدارهای Çankýrý و ţubat نشست.
اگر سایتهای زیادی را در یک کشور طبق زمانبندی میخوانید، یک پروکسی مسکونی در همان کشور صفحههایی را برمیگرداند که بازدیدکنندگان محلی میبینند؛ منطق انتخاب کدک همان میماند.
can't decode byte 0x8b و 0xa0 یعنی چه؟
خطای UnicodeDecodeError: 'utf-8' codec can't decode byte 0x8b in position 1
جریان gzip با 1F 8B آغاز میشود (RFC 1952)، پس 0x8b در موقعیت 1 یعنی داده فشرده بهعنوان متن رمزگشایی میشود؛ gzip.compress(...).decode("utf-8") دقیقاً همین پیام را به ما داد. در اسکرپینگ این اتفاق وقتی میافتد که r.raw را مستقیم بخوانید، یا هدر Accept-Encoding کپیشده را با urllib.request بفرستید که هرگز پاسخ را از حالت فشرده بیرون نمیآورد. Requests خودش gzip را باز میکند، پس هدر کپیشده را حذف کنید و r.content را به کار ببرید. مقدارهای کپیشده br یا zstd هم شکست میخورند، مگر اینکه بسته اختیاری Brotli یا Zstandard برای urllib3 نصب شده باشد.
خطای UnicodeDecodeError: 'utf-8' codec can't decode byte 0xa0
در cp1252، cp1254 و ISO-8859-1، فاصله نشکن U+00A0 تکبایت A0 است و UTF-8 هرگز هیچ نویسهای را با این بایت آغاز نمیکند. فایل را با کدک واقعیاش بخوانید. اگر این نویسه از قبل در متن شماست، "10\xa0kg".split() آن را حذف میکند، .split(" ") نه، و unicodedata.normalize("NFKC", s) آن را به فاصله ساده تبدیل میکند (NFKC نویسههایی مانند ² را هم به 2 تبدیل میکند).
متنی را که از قبل خراب شده چگونه ترمیم کنیم؟
اگر هیچ بایتی از دست نرفته باشد، گام اشتباه را برعکس کنید:
- متنی مانند
ışğکه از صفحه نمایش یا صفحهگسترده کپی شده:s.encode("cp1252").decode("utf-8")نتیجهışğرا میدهد. همین فرمانسلامرا هم به «سلام» برمیگرداند. - همین خرابی در
r.textاز Requests یک نویسه کنترلی (\x9f) را پنهان میکند که cp1252 نمیتواند رمزگذاری کند، پسs.encode("latin-1").decode("utf-8")را به کار ببرید. cp1252 روی آن با خطای'charmap' codec can't encode character '\x9f'شکست خورد. - متن windows-1254 که با ISO-8859-1 خوانده شده، مانند
Çankýrý:s.encode("latin-1").decode("cp1254")نتیجهÇankırıرا میدهد.
برای دادههای بزرگ یا ترکیبی، ftfy نسخه 6.3.1 خرابیهای UTF-8 را ترمیم میکند: ftfy.fix_text("ışğ") مقدار ışğ را برگرداند. اما Çankýrý را دستنخورده گذاشت، چون شبیه متن لاتین معتبر است؛ پس اشتباههای صفحه کد را دستی درست کنید. متنی که بهجای حرفها ? یا � دارد قابل ترمیم نیست؛ منبع را دوباره دریافت کنید.
چرا Excel در فایل CSV با UTF-8 نویسههای خراب نشان میدهد؟
Excel فایل CSV با UTF-8 را با دوبار کلیک فقط وقتی درست باز میکند که فایل با نشانه ترتیب بایت آغاز شود، همانطور که صفحه پشتیبانی Microsoft اشاره میکند. encoding="utf-8-sig" سه بایت EF BB BF را اضافه میکند؛ در pandas هم df.to_csv("out.csv", encoding="utf-8-sig"). چنین فایلهایی را با utf-8-sig هم بخوانید: با utf-8 ساده، ماژول csv ستون نخستی به نام \ufeffşehir به ما داد، در حالی که pandas در هر دو حالت BOM را حذف کرد. جریان کامل از اسکرپ تا Excel در استخراج داده از وبسایت آمده است.
چرا "I".lower() مقدار "ı" را برنمیگرداند؟
str.lower() نگاشت پیشفرض یونیکد را به کار میبرد که زبان را در نظر نمیگیرد. برای ترکی این کار دو بار نادرست است: "ISPARTA".lower() بهجای ısparta مقدار isparta را برمیگرداند و "İ".lower() حرف i را همراه با یک نقطه ترکیبی (U+0307) برمیگرداند. casefold() هم همین کمبود را دارد. نخست دو حرف ویژه را نگاشت کنید:
TR_LOWER = str.maketrans({"I": "ı", "İ": "i"})
TR_UPPER = str.maketrans({"i": "İ", "ı": "I"})

print("ISPARTA İZMİR".translate(TR_LOWER).lower())  # ısparta izmir
print("istanbul ışık".translate(TR_UPPER).upper())  # İSTANBUL IŞIK
عددها و تاریخها هم از قواعد محلی پیروی میکنند. قیمتی ترکی مانند 1.299,90 پس از s.replace(".", "").replace(",", ".") به عدد اعشاری تبدیل میشود و pandas پارامترهای decimal="," و thousands="." را دارد. در اسکرپر از locale.setlocale() پرهیز کنید، چون کل پروسه را تغییر میدهد. پاکسازی کامل قیمتها در رصد قیمت رقبا آمده است.
کاربردها
- رصد قیمت: فروشگاههایی که هنوز صفحههایشان را با صفحه کدهای قدیمی ارائه میدهند (رصد قیمت رقبا).
- جدولها به Excel: فایل CSV که با حرفهای درست باز میشود (استخراج داده از وبسایت).
- اسکرپرهای PHP:
DOMDocumentراهحل خودش را دارد (وب اسکرپینگ با PHP). - خروجیهای Scrapy:
FEED_EXPORT_ENCODINGکدک خروجی را تعیین میکند (Scrapy با پروکسی). - کارهای .NET:
HttpClientبا charset به شیوه خودش رفتار میکند (استخراج داده با C#). - خزش در سایتهای فراوان: کدک هر صفحه را ثبت کنید (خزنده وب).
اشتباهات رایج
- خاموش کردن خطا با
errors="ignore"یا latin-1. اسکریپت اجرا میشود و حرفها ناپدید یا عوض میشوند. - ثابت نوشتن
r.encoding = "utf-8"برای همه سایتها. برخی صفحهها را درست و صفحههای windows-1254 را خراب میکند. - دو بار رمزگشایی. فراخوانی
.encode().decode()روی متنی که از قبل درست رمزگشایی شده، خطای تازهای به متن سالم اضافه میکند. - پذیرفتن
iso-8859-9یاiso-8859-1همانطور که اعلام شدهاند. مرورگرها windows-1254 و windows-1252 را به کار میبرند و علامتهای نقلقول و نشانه یورو تفاوت را آشکار میکنند. - خواندن فایل
utf-8-sigبهصورتutf-8. نام ستون نخست با یک نویسه نامرئی آغاز میشود و جستوجو بر اساس آن نام شکست میخورد. - اشتباه گرفتن رمزگذاری نویسه با کدگذاری URL.
%40در رمز پروکسی کدگذاری درصدی است و موضوعی جداگانه است (نویسههای ویژه در رمز پروکسی).
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
متن غیر ASCII در فایل .py خودتان | آن را با UTF-8 ذخیره کنید؛ خط coding لازم نیست |
| خواندن یا نوشتن فایل | encoding="utf-8"؛ صفحه کد قدیمی فقط برای فایلهایی که با آن نوشته شدهاند |
خطای 'charmap' در خروجی هدایتشده در ویندوز | PYTHONUTF8=1 یا python -X utf8؛ از Python 3.15 پیشفرض |
| HTML بدون charset در هدر | r.content را به Beautiful Soup بدهید و کدک را ثبت کنید |
نه charset در هدر و نه تگ <meta> | کدک سایت را ثابت کنید؛ apparent_encoding فقط بهعنوان آخرین راه |
صفحه میگوید iso-8859-9 یا iso-8859-1 | مانند مرورگر با cp1254 یا cp1252 رمزگشایی کنید |
متن از قبل به شکل é یا ı درآمده | .encode("cp1252").decode("utf-8") یا ftfy.fix_text |
| نتیجه در Excel باز میشود | CSV را با utf-8-sig بنویسید |
پرسشهای متداول
آیا برای کار با حروف فارسی و دیگر نویسههای غیرانگلیسی در پایتون به کتابخانه نیاز دارم؟
نه. یک str در Python 3 یونیکد است و کتابخانه استاندارد برای صفحه کدهای رایج کدک دارد (رمزگذاریهای استاندارد). charset-normalizer، که همراه Requests نصب میشود، کدکهای ناشناخته را حدس میزند و ftfy متنهای mojibake را ترمیم میکند.
فایل cp1252 یا cp1254 را چگونه به UTF-8 تبدیل کنم؟
آن را با کدک قدیمیاش بخوانید و با کدک تازه بنویسید: Path("new.txt").write_text(Path("old.txt").read_text(encoding="cp1254"), encoding="utf-8") که در آن Path از pathlib میآید. پیش از پاک کردن فایل اصلی، چند نام را بررسی کنید.
آیا errors="ignore" خطای UnicodeDecodeError را برطرف میکند؟
فقط آن را پنهان میکند. بایتهایی که جا نمیشوند بدون هشدار حذف میشوند، پس نامها حرف از دست میدهند. بهجای آن کدک درست را پیدا کنید.
چگونه بفهمم یک فایل با چه رمزگذاریای نوشته شده است؟
یک فایل متنی، مگر اینکه با BOM آغاز شود، کدک خود را جایی ثبت نمیکند، پس هر ابزاری فقط حدس میزند. charset_normalizer.from_path("old.txt").best().encoding برای فایل آزمایشی ترکی ما cp1254 را برگرداند. حدس را با رمزگشایی و خواندن چند واژه که حرفهای محلی دارند تأیید کنید.
تفاوت utf-8 و utf-8-sig چیست؟
utf-8-sig هنگام نوشتن یک BOM (EF BB BF) مینویسد و هنگام خواندن از آن میگذرد. آن را برای فایلهای CSV به کار ببرید که دیگران در Excel باز میکنند.
خطای UnicodeDecodeError را در read_csv از pandas چگونه برطرف کنم؟
کدک فایل را بدهید: encoding="cp1254" برای خروجی ویندوز ترکی، cp1252 برای خروجی اروپای غربی و utf-8-sig اگر فایل BOM دارد. encoding_errors="replace" خطا را متوقف میکند، اما حرفها از دست میروند.
خلاصه
خطاهای رمزگذاری در پایتون به یک قاعده برمیگردند: بایتها را با کدکی رمزگشایی کنید که با آن نوشته شدهاند و خروجی خودتان را با UTF-8 بنویسید. متن خراب را بخوانید تا دو کدکی را که با هم اشتباه گرفته شدهاند پیدا کنید، روی هر open() مقدار encoding را تعیین کنید، تا وقتی Python 3.15 این کار را برایتان انجام دهد در ویندوز حالت UTF-8 را به کار ببرید و صفحههای وب را بهصورت بایت به Beautiful Soup بدهید. برای کارهای اسکرپینگی که از سایتهای محلی فراوان متن تمیز لازم دارند، راهحل استخراج داده ما را ببینید.


