

































Web scraping · Blog da Proxynet – Página 5
Publicado
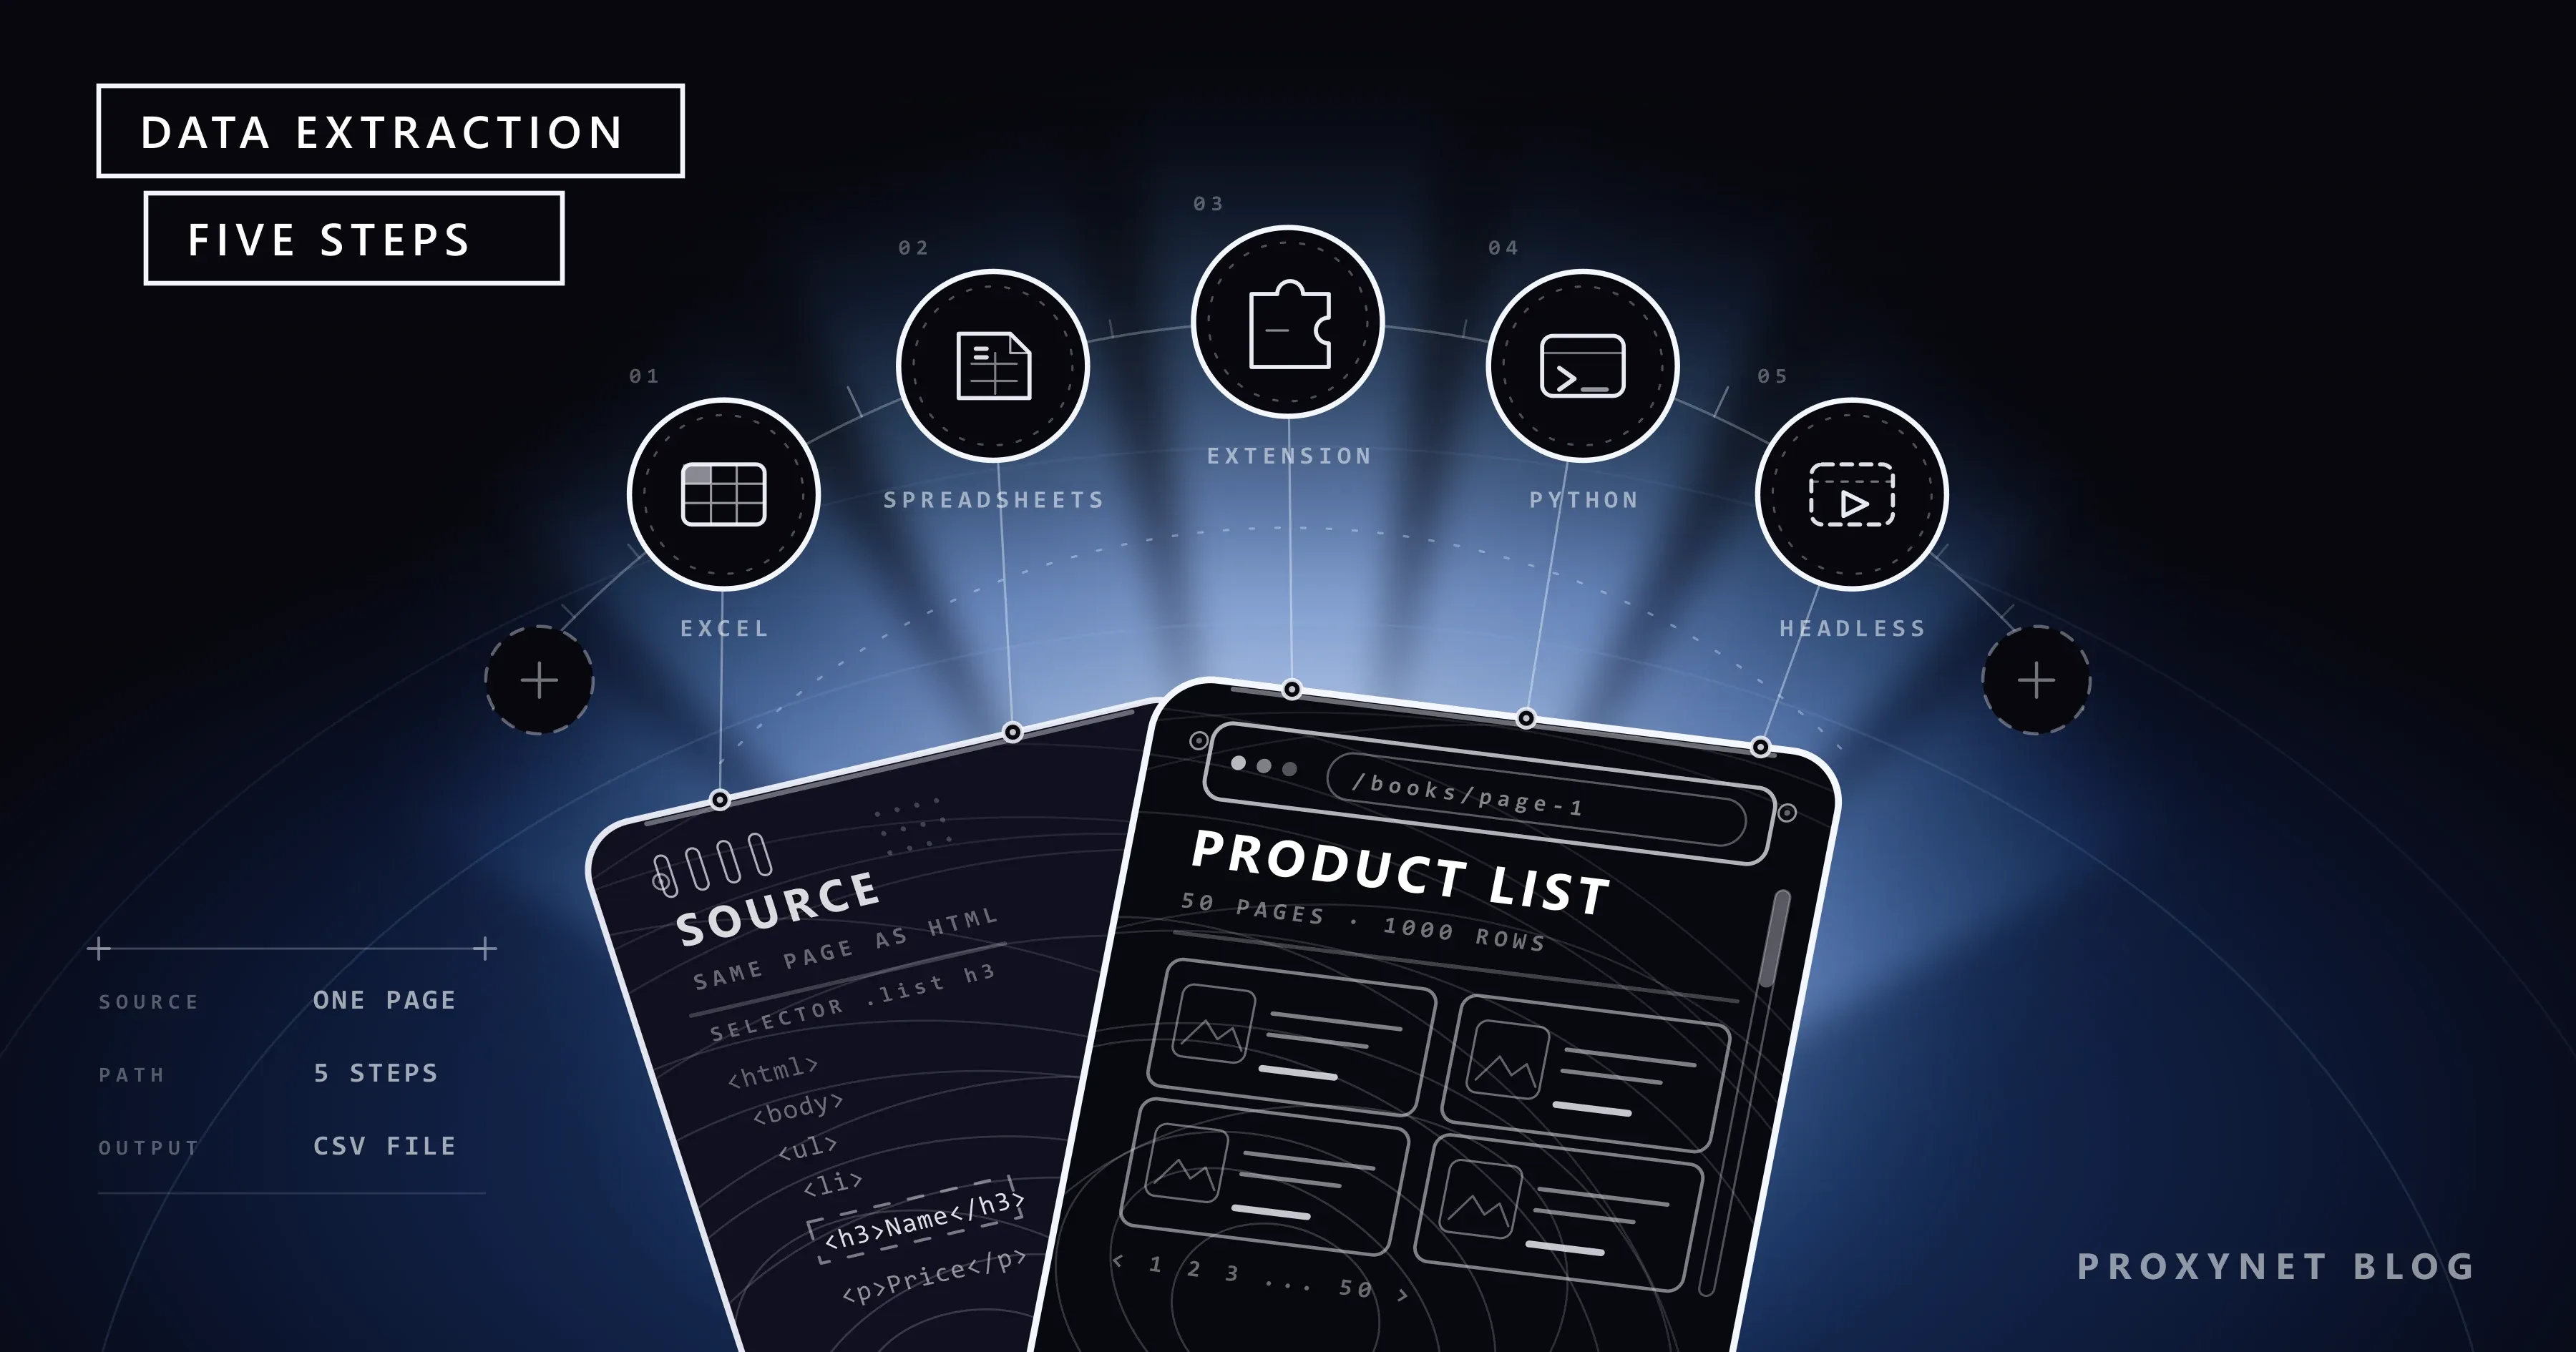
Como extrair dados de um site: Excel, Python e ferramentas
O jeito de extrair dados de um site depende do volume e da estrutura da página. Cinco métodos, do Excel ao Python, e quando cada um deles é suficiente.
Autor: Enver Kaya
Publicado
Tráfego incomum no Google: o que é e como resolver
O aviso de tráfego incomum do Google vale para o seu endereço IP, não para a sua conta. O que a página sorry diz, por que o CAPTCHA volta e como resolver.
Autor:Enver Kaya
Publicado
Como funciona a detecção de bots: a lógica anti-bot
A detecção de bots não é uma única checagem: reputação do IP, impressão digital TLS, cabeçalhos, sinais do navegador e comportamento viram uma só pontuação.
Autor: Acar Diveroli
Publicado
429 Too Many Requests: o que é o erro de rate limit
429 Too Many Requests indica que você enviou mais solicitações do que um serviço permite em pouco tempo. Veja como o rate limit funciona e como resolver o erro.
Autor:Acar Diveroli
Publicado
O que é rotação de IP e como ela funciona?
Rotação de IP é a troca do IP de saída das suas requisições dentro de um pool. Veja os três modos, o fluxo do gateway e por que às vezes o IP não muda.
Autor:Acar Diveroli
Publicado
O que é paginação e como percorrer todas as páginas?
A paginação divide uma lista longa em pedaços. Vemos os cinco tipos, as condições de parada e como retomar com SQLite uma coleta interrompida.
Autor:Acar Diveroli
Publicado
Web scraping com PHP: cURL, Guzzle e uso de proxy
O núcleo do scraping em PHP é a requisição com cURL e a análise com DOM e XPath. Explicamos Guzzle, proxy, robots.txt e novas tentativas com código testado.
Autor:Acar Diveroli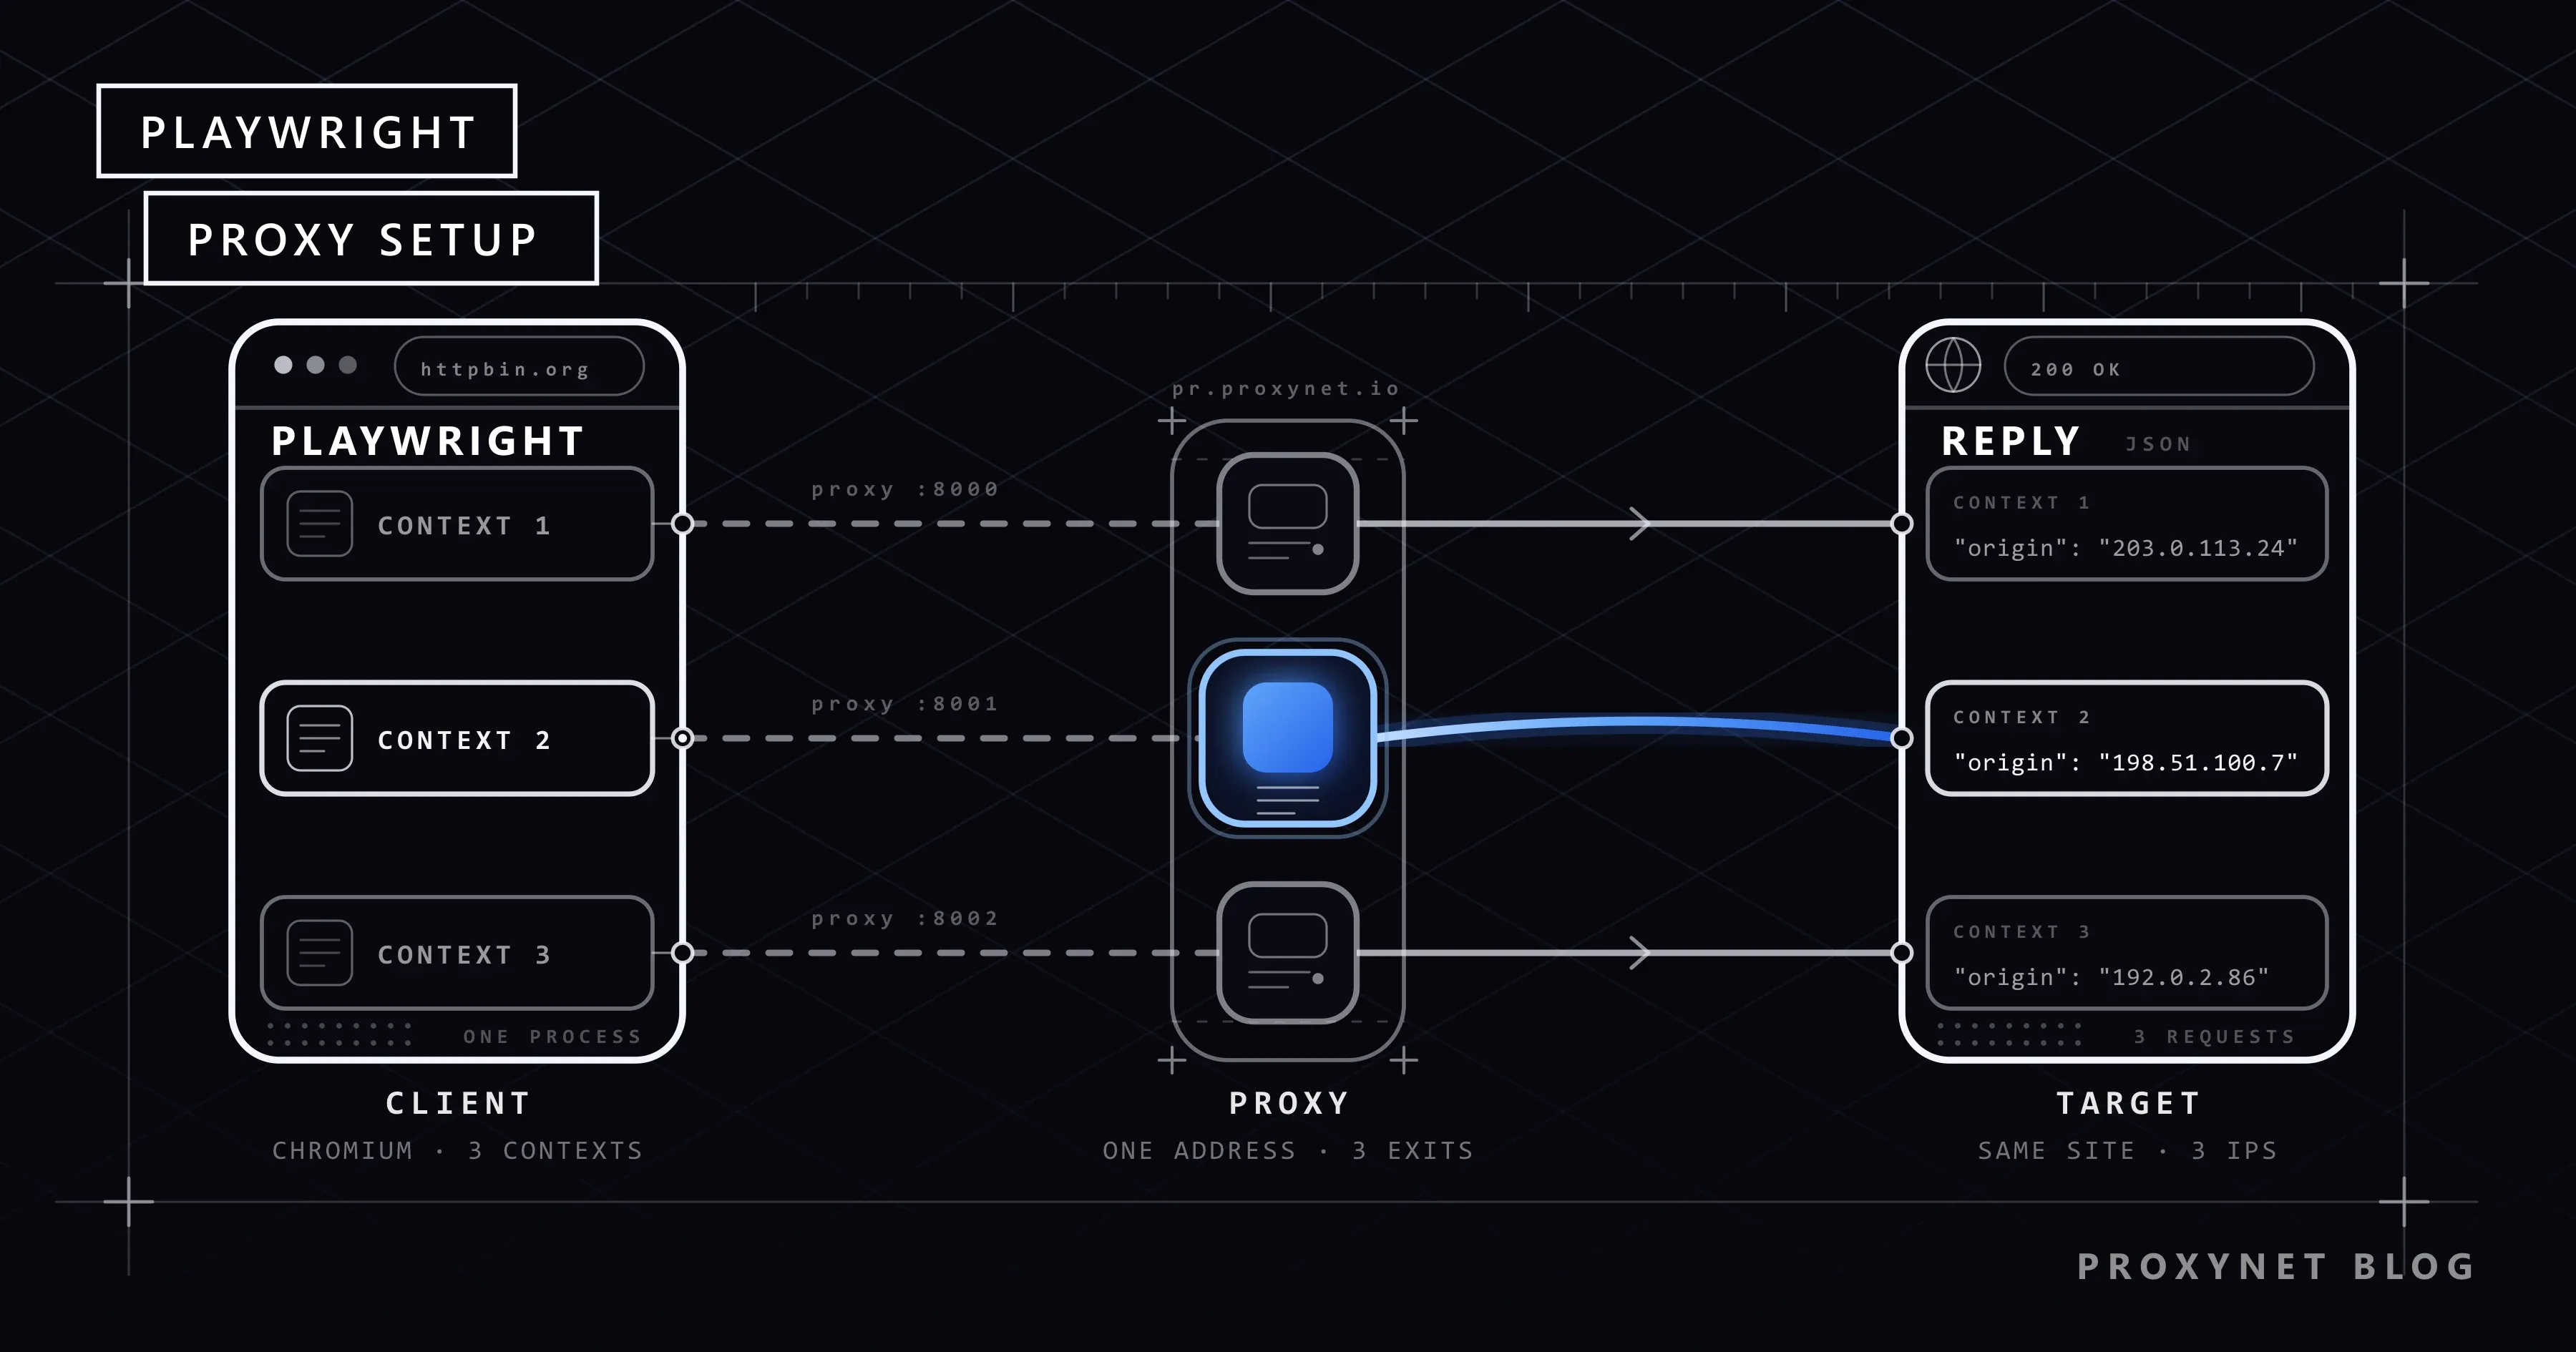
Publicado
O que é Playwright e como usá-lo com proxy
No Playwright, o proxy é definido ao iniciar o navegador ou por contexto. Explicamos autenticação, SOCKS5 e rotação com exemplos em Python e Node.js.
Autor:Acar Diveroli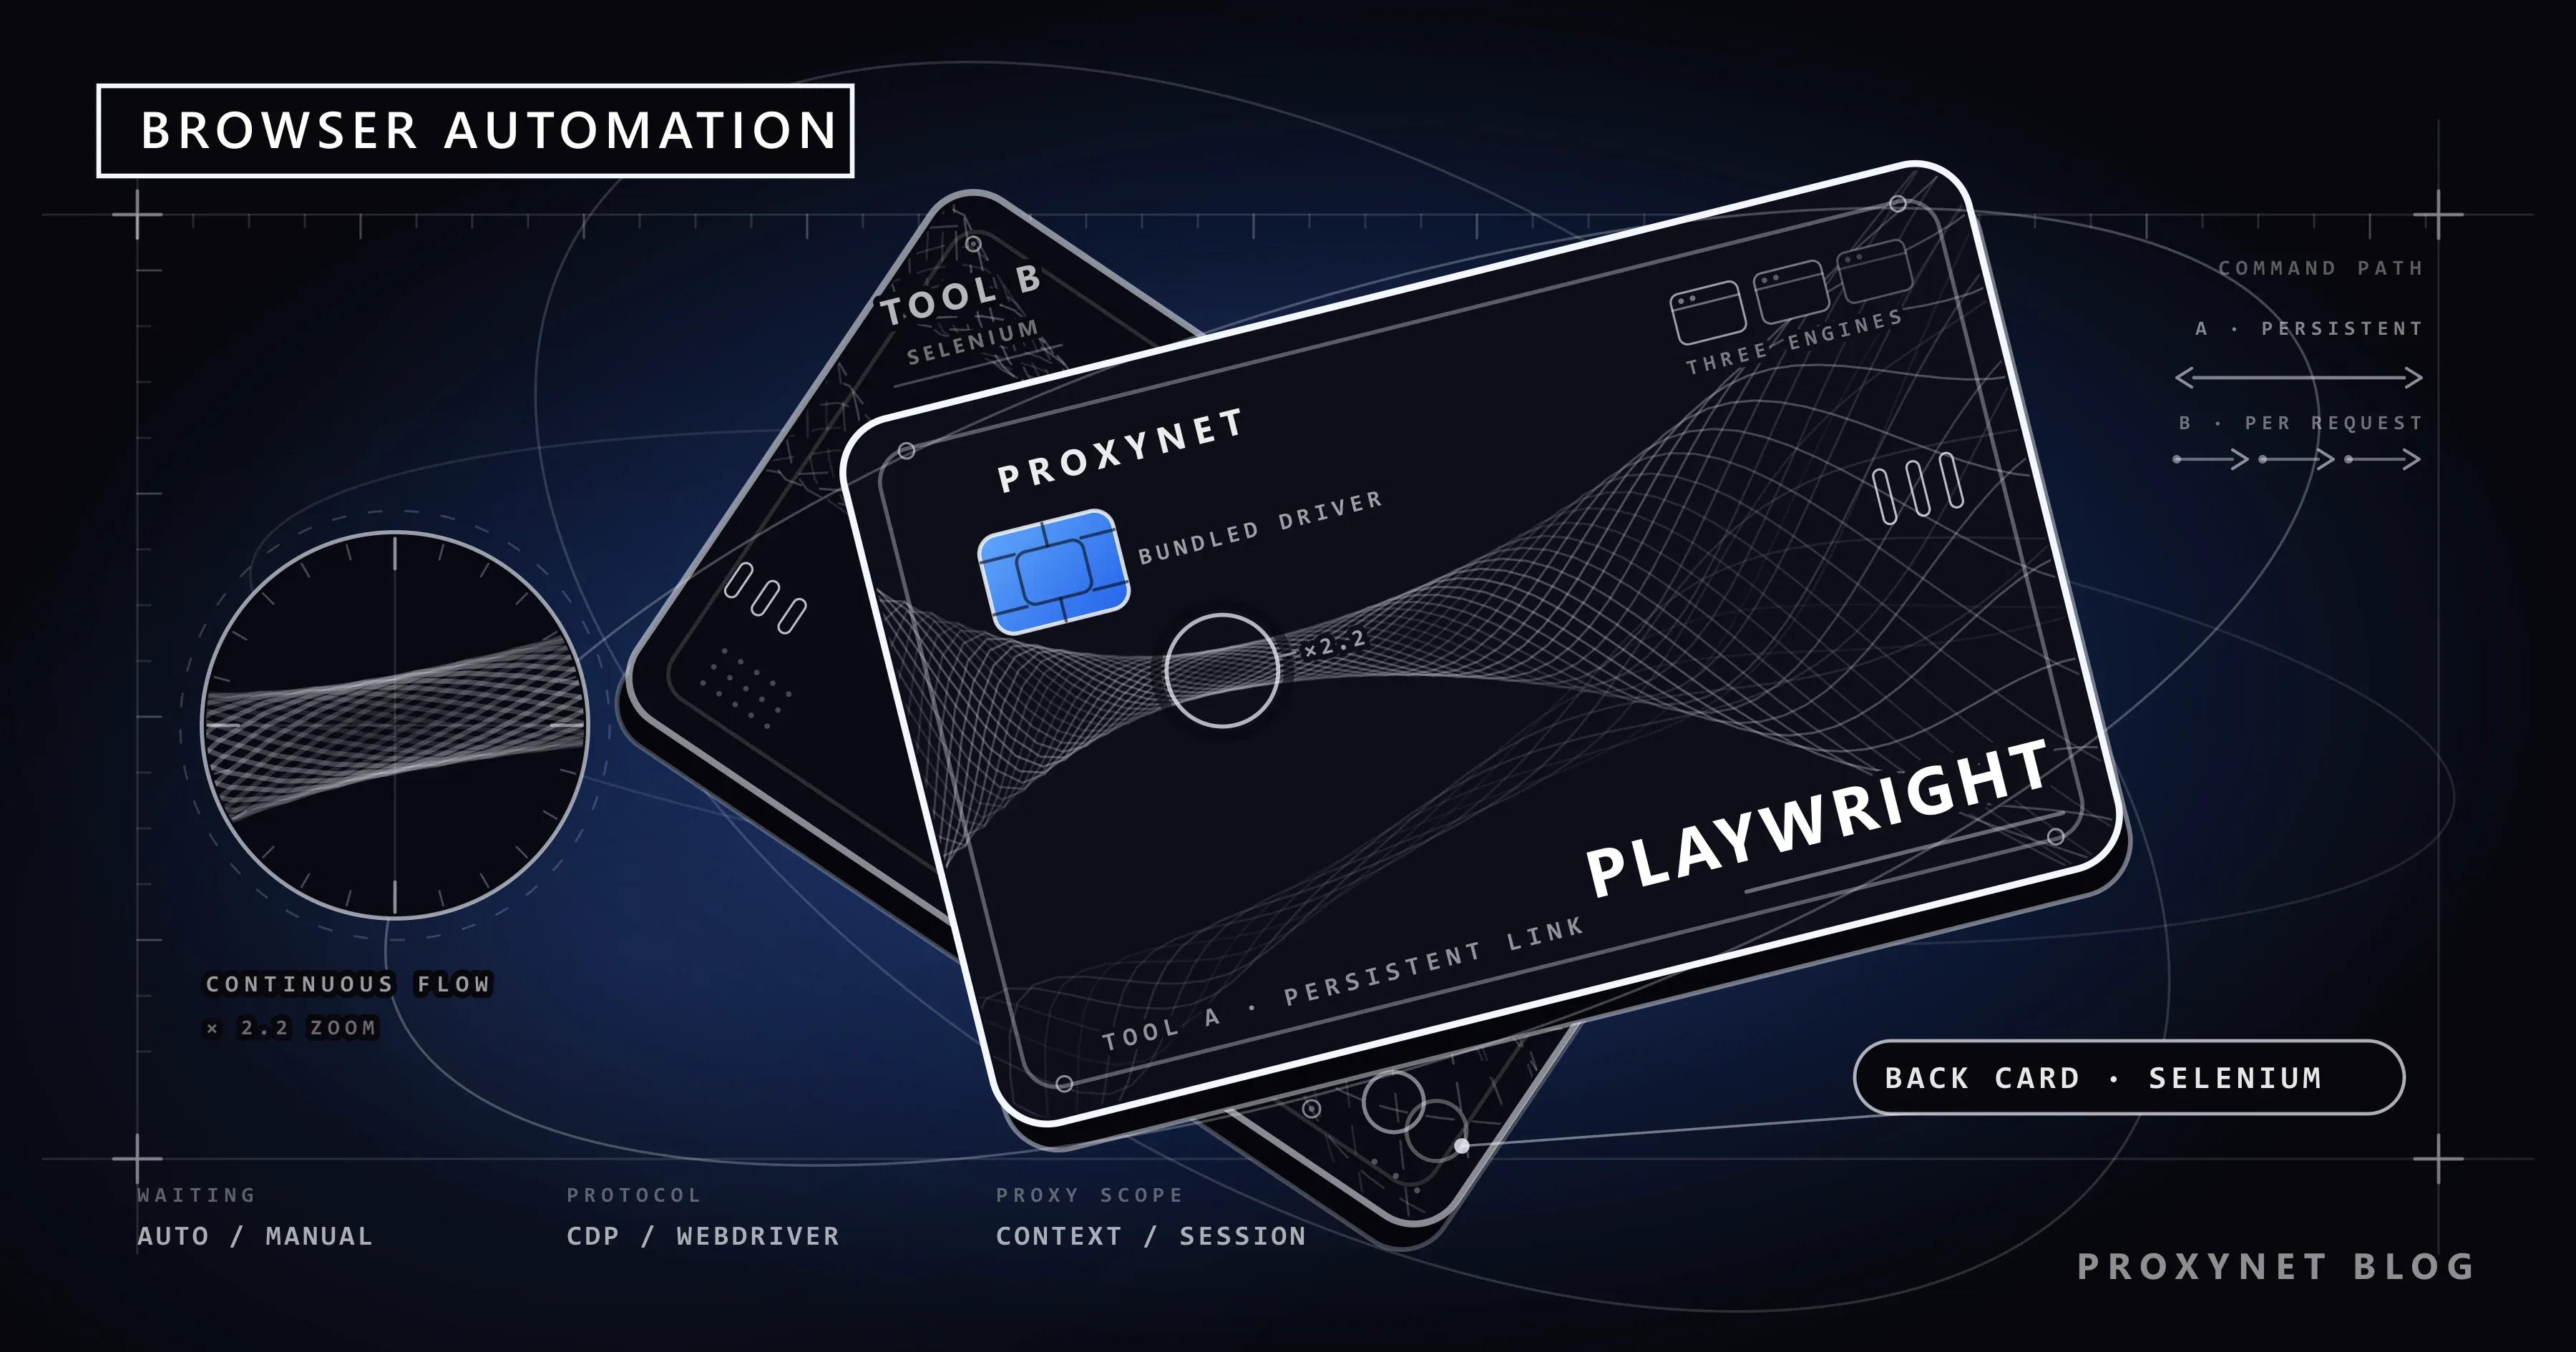
Publicado
Playwright ou Selenium: qual escolher no seu projeto?
O Playwright espera os elementos sozinho e toma o proxy por contexto; o Selenium cobre mais linguagens e o Safari real. Fizemos o mesmo trabalho nos dois.
Autor:Acar Diveroli
Publicado
Sessões e cookies em Python: login com requests
requests.Session leva os cookies entre as requisições e mantém a sessão aberta. Mostramos o token CSRF do formulário, a verificação do login e o armazenamento.
Autor:Acar Diveroli
Publicado
O que é Scrapy e como usar com proxy
No Scrapy, o proxy é definido pelo campo meta da requisição ou por um middleware. Instalação, autenticação, AutoThrottle e rotação, explicados com código.
Autor:Acar Diveroli
Publicado
O que é fingerprint TLS e como funciona o JA3?
O fingerprint TLS é um identificador tirado das listas de cifras e extensões do ClientHello. Como JA3 e JA4 são calculados e o que um proxy muda de fato.
Autor:Acar Diveroli
Como extrair dados de um site: Excel, Python e ferramentas
Autor: Enver KayaCasos de usoPublicado
Tráfego incomum no Google: o que é e como resolver
Autor: Enver KayaTutoriaisPublicado
Como funciona a detecção de bots: a lógica anti-bot
Autor: Acar DiveroliWeb scrapingPublicado
429 Too Many Requests: o que é o erro de rate limit
Autor: Acar DiveroliTutoriaisPublicado
O que é rotação de IP e como ela funciona?
Autor: Acar DiveroliProxy 101Publicado
O que é paginação e como percorrer todas as páginas?
Autor: Acar DiveroliWeb scrapingPublicado
Web scraping com PHP: cURL, Guzzle e uso de proxy
Autor: Acar DiveroliTutoriaisPublicado
O que é Playwright e como usá-lo com proxy
Autor: Acar DiveroliTutoriaisPublicado
Playwright ou Selenium: qual escolher no seu projeto?
Autor: Acar DiveroliComparativosPublicado
Sessões e cookies em Python: login com requests
Autor: Acar DiveroliTutoriaisPublicado
O que é Scrapy e como usar com proxy
Autor: Acar DiveroliWeb scrapingPublicado
O que é fingerprint TLS e como funciona o JA3?
Autor: Acar DiveroliWeb scrapingPublicado
Nenhum artigo encontrado
Publicado
Publicado