Tu equipo ya trabaja con Node.js y alguien pide los títulos, precios y unidades en stock de todos los libros de una categoría de un catálogo. El código fuente de la página en el navegador muestra los datos dentro de etiquetas <article> normales, así que no necesitas un navegador para leerlos. Necesitas una forma de descargar el HTML, elegir los elementos correctos, seguir el enlace "next" y evitar que el script sature el sitio o se detenga con el primer timeout. El camino general desde una página hasta un archivo está en Cómo extraer datos de una web; este tutorial lo hace en JavaScript con Cheerio.
Veremos qué es Cheerio y qué no es, cómo cargar HTML con load y fromURL, los selectores y las listas, el método extract, más reciente, la paginación, un límite de concurrencia, los reintentos con backoff, la escritura en JSON y el envío de las peticiones a través de un proxy con el ProxyAgent de undici. La última parte explica cuándo Cheerio no es la herramienta adecuada. Todos los ejemplos se ejecutaron el 28 de septiembre de 2026 con cheerio 1.2.0, undici 8.11.2 y Node.js 24.11.1 contra books.toscrape.com, un sitio de pruebas creado para practicar web scraping.
¿Qué es Cheerio?
Cheerio es un parser de HTML y XML para Node.js con una API inspirada en jQuery. Le das el marcado, construye un árbol del documento y consultas ese árbol con $("selector css"). Es rápido porque se salta todo lo que hace un navegador después del parsing: no calcula el diseño, no aplica CSS, no carga imágenes ni ejecuta scripts.
La versión actual es la 1.2.0 (cheerio en npm) y requiere Node.js 20.18.1 o posterior. La versión 1.0, publicada en agosto de 2024, cerró una fase de release candidates que había empezado en 2017. El paquete no tiene exportación por defecto, así que escribes import * as cheerio from "cheerio". Los tutoriales que llaman a require("cheerio").default se escribieron para versiones antiguas.
Cheerio solo ve el HTML que envió el servidor. Si JavaScript rellena la lista de productos más tarde, los datos no están en ese HTML y ningún selector los encontrará. Páginas estáticas y dinámicas explica cómo comprobar qué tipo de página tienes antes de escribir una sola línea de código.
¿Cómo funciona un scraper con Cheerio?
Un scraper basado en Cheerio repite los mismos cinco pasos en cada página:
- Descargar. Un cliente HTTP (aquí
fetch) solicita la URL y recibe el HTML como texto. - Analizar.
cheerio.load(html)construye el árbol y devuelve una función$ligada a ese documento. - Seleccionar.
$("article.product_pod")devuelve todos los elementos que coinciden;.find(),.text()y.attr()leen dentro de ellos. - Seguir. El scraper lee la siguiente URL de la página (un enlace de paginación o de detalle) y la resuelve respecto a la URL actual.
- Guardar. Las filas se acumulan en memoria y al final se escriben en un archivo o en una base de datos.
Los pasos 2 y 3 nunca tocan la red. Esa separación ayuda a depurar: si un selector no devuelve nada, guarda el HTML en un archivo y prueba el selector contra él, sin enviar otra petición.
Cheerio vs jsdom vs Playwright
Las tres herramientas que más se comparan para web scraping en Node.js hacen trabajos distintos:
| Herramienta | Qué hace | Ejecuta el JavaScript de la página | Coste por página | Uso adecuado |
|---|---|---|---|---|
| Cheerio | Analiza HTML, consultas al estilo jQuery | No | El más bajo: solo parsing | HTML renderizado en el servidor, muchas páginas |
| jsdom | Construye un DOM parecido al del navegador en Node.js | Opcional, limitado | Mayor que Cheerio | Código que espera document y las API del DOM |
| Playwright | Controla un Chromium, Firefox o WebKit real | Sí | El más alto: navegador completo | Páginas que generan el contenido con JavaScript, clics, inicios de sesión |
Una configuración habitual usa los dos extremos: Playwright para las pocas páginas que necesitan un navegador y Cheerio para todo lo demás. La elección del lenguaje es otra cuestión, tratada en Web scraping: ¿JavaScript o Python?.
Instalar Cheerio y cargar tu primera página
Crea un proyecto e instala el paquete. Añadir "type": "module" te permite usar import y await en el nivel superior:
mkdir book-scraper && cd book-scraper
npm init -y
npm pkg set type=module
npm install cheerio
Node.js 18 y posteriores incluyen fetch, así que el primer script no necesita nada más:
import * as cheerio from "cheerio";

const url = "https://books.toscrape.com/";
const response = await fetch(url, {
  headers: { "user-agent": "book-research/1.0 (+mailto:you@example.com)" },
});
if (!response.ok) throw new Error(`HTTP ${response.status} for ${url}`);

const $ = cheerio.load(await response.text());

console.log($("title").text().trim());
console.log($("article.product_pod").length, "books on this page");

$("article.product_pod").slice(0, 3).each((i, el) => {
  const card = $(el);
  const title = card.find("h3 a").attr("title");
  const price = card.find(".price_color").text();
  console.log(i + 1, title, price);
});All products | Books to Scrape - Sandbox
20 books on this page
1 A Light in the Attic £51.77
2 Tipping the Velvet £53.74
3 Soumission £50.10El título sale del atributo title del enlace, no de su texto: en este sitio el texto visible del enlace aparece recortado ("In a Dark, Dark ...") y el atributo guarda el título completo. Revisa ambos en el código fuente antes de elegir uno. La cabecera user-agent identifica tu script y le da al propietario del sitio una forma de contactarte.
Métodos de carga
Cheerio 1.x ofrece cinco formas de cargar un documento (documentación de carga de Cheerio):
| Método | Entrada | Cuándo usarlo |
|---|---|---|
load(html) | Una cadena | Descargaste la página tú mismo (el caso habitual) |
loadBuffer(buffer) | Bytes sin procesar | La codificación es desconocida; Cheerio la detecta |
stringStream(options, cb) | Flujo de texto decodificado | Archivos grandes con codificación conocida |
decodeStream(options, cb) | Flujo de bytes sin procesar | Archivos grandes con codificación desconocida |
fromURL(url, options) | Una URL | Scripts rápidos; Cheerio descarga la página por su cuenta |
fromURL es cómodo, pero abre su propio cliente de undici para el origen de la página. En nuestra prueba ignoró un dispatcher pasado en requestOptions y se conectó directamente, incluso cuando ese dispatcher apuntaba a un proxy que rechazaba todas las peticiones. Para todo lo que necesite proxy, reintentos o timeouts, descarga con fetch y usa load.
Seleccionar elementos y leer valores
La mayor parte del código de scraping usa una pequeña parte de la API:
$(selector)selecciona en todo el documento;el.find(selector)busca dentro de un elemento..text()devuelve el texto combinado de la selección;.attr("href")devuelve un atributo del primer elemento..each((i, el) => …)recorre la selección;.map((i, el) => value).get()la convierte en un array normal..first(),.eq(n)y.slice(a, b)acotan una selección.
Un selector que no coincide con nada no lanza ninguna excepción. .text() devuelve una cadena vacía y .attr() devuelve undefined, así que un nombre de clase cambiado produce campos vacíos en lugar de un error. Valida las filas que recopilas (más detalles en la lista de errores más abajo). La sintaxis de los selectores y el motivo por el que Cheerio no tiene XPath están en Selector CSS vs XPath.
El método extract
Cheerio 1.0 añadió $.extract(), que describe todo el registro como un único objeto (documentación de extract de Cheerio). Una cadena devuelve el texto de la primera coincidencia, los corchetes recogen todas las coincidencias y { selector, value } lee una propiedad o ejecuta una función:
import * as cheerio from "cheerio";

const $ = await cheerio.fromURL("https://books.toscrape.com/");

const data = $.extract({
  heading: "h1",
  books: [
    {
      selector: "article.product_pod",
      value: {
        title: { selector: "h3 a", value: "title" },
        price: ".price_color",
        link: { selector: "h3 a", value: "href" },
        rating: {
          selector: "p.star-rating",
          value: (el) => $(el).attr("class").replace("star-rating", "").trim(),
        },
      },
    },
  ],
});

console.log(data.heading, data.books.length);
console.log(data.books[0]);All products 20
{
title: 'A Light in the Attic',
price: '£51.77',
link: 'catalogue/a-light-in-the-attic_1000/index.html',
rating: 'Three'
}Los selectores dentro de value se evalúan respecto a cada article, lo que mantiene juntos los campos de un mismo libro. El enlace sigue siendo relativo, así que resuélvelo con new URL(link, pageUrl) antes de solicitarlo.
Un scraper completo: paginación, concurrencia, reintentos y JSON
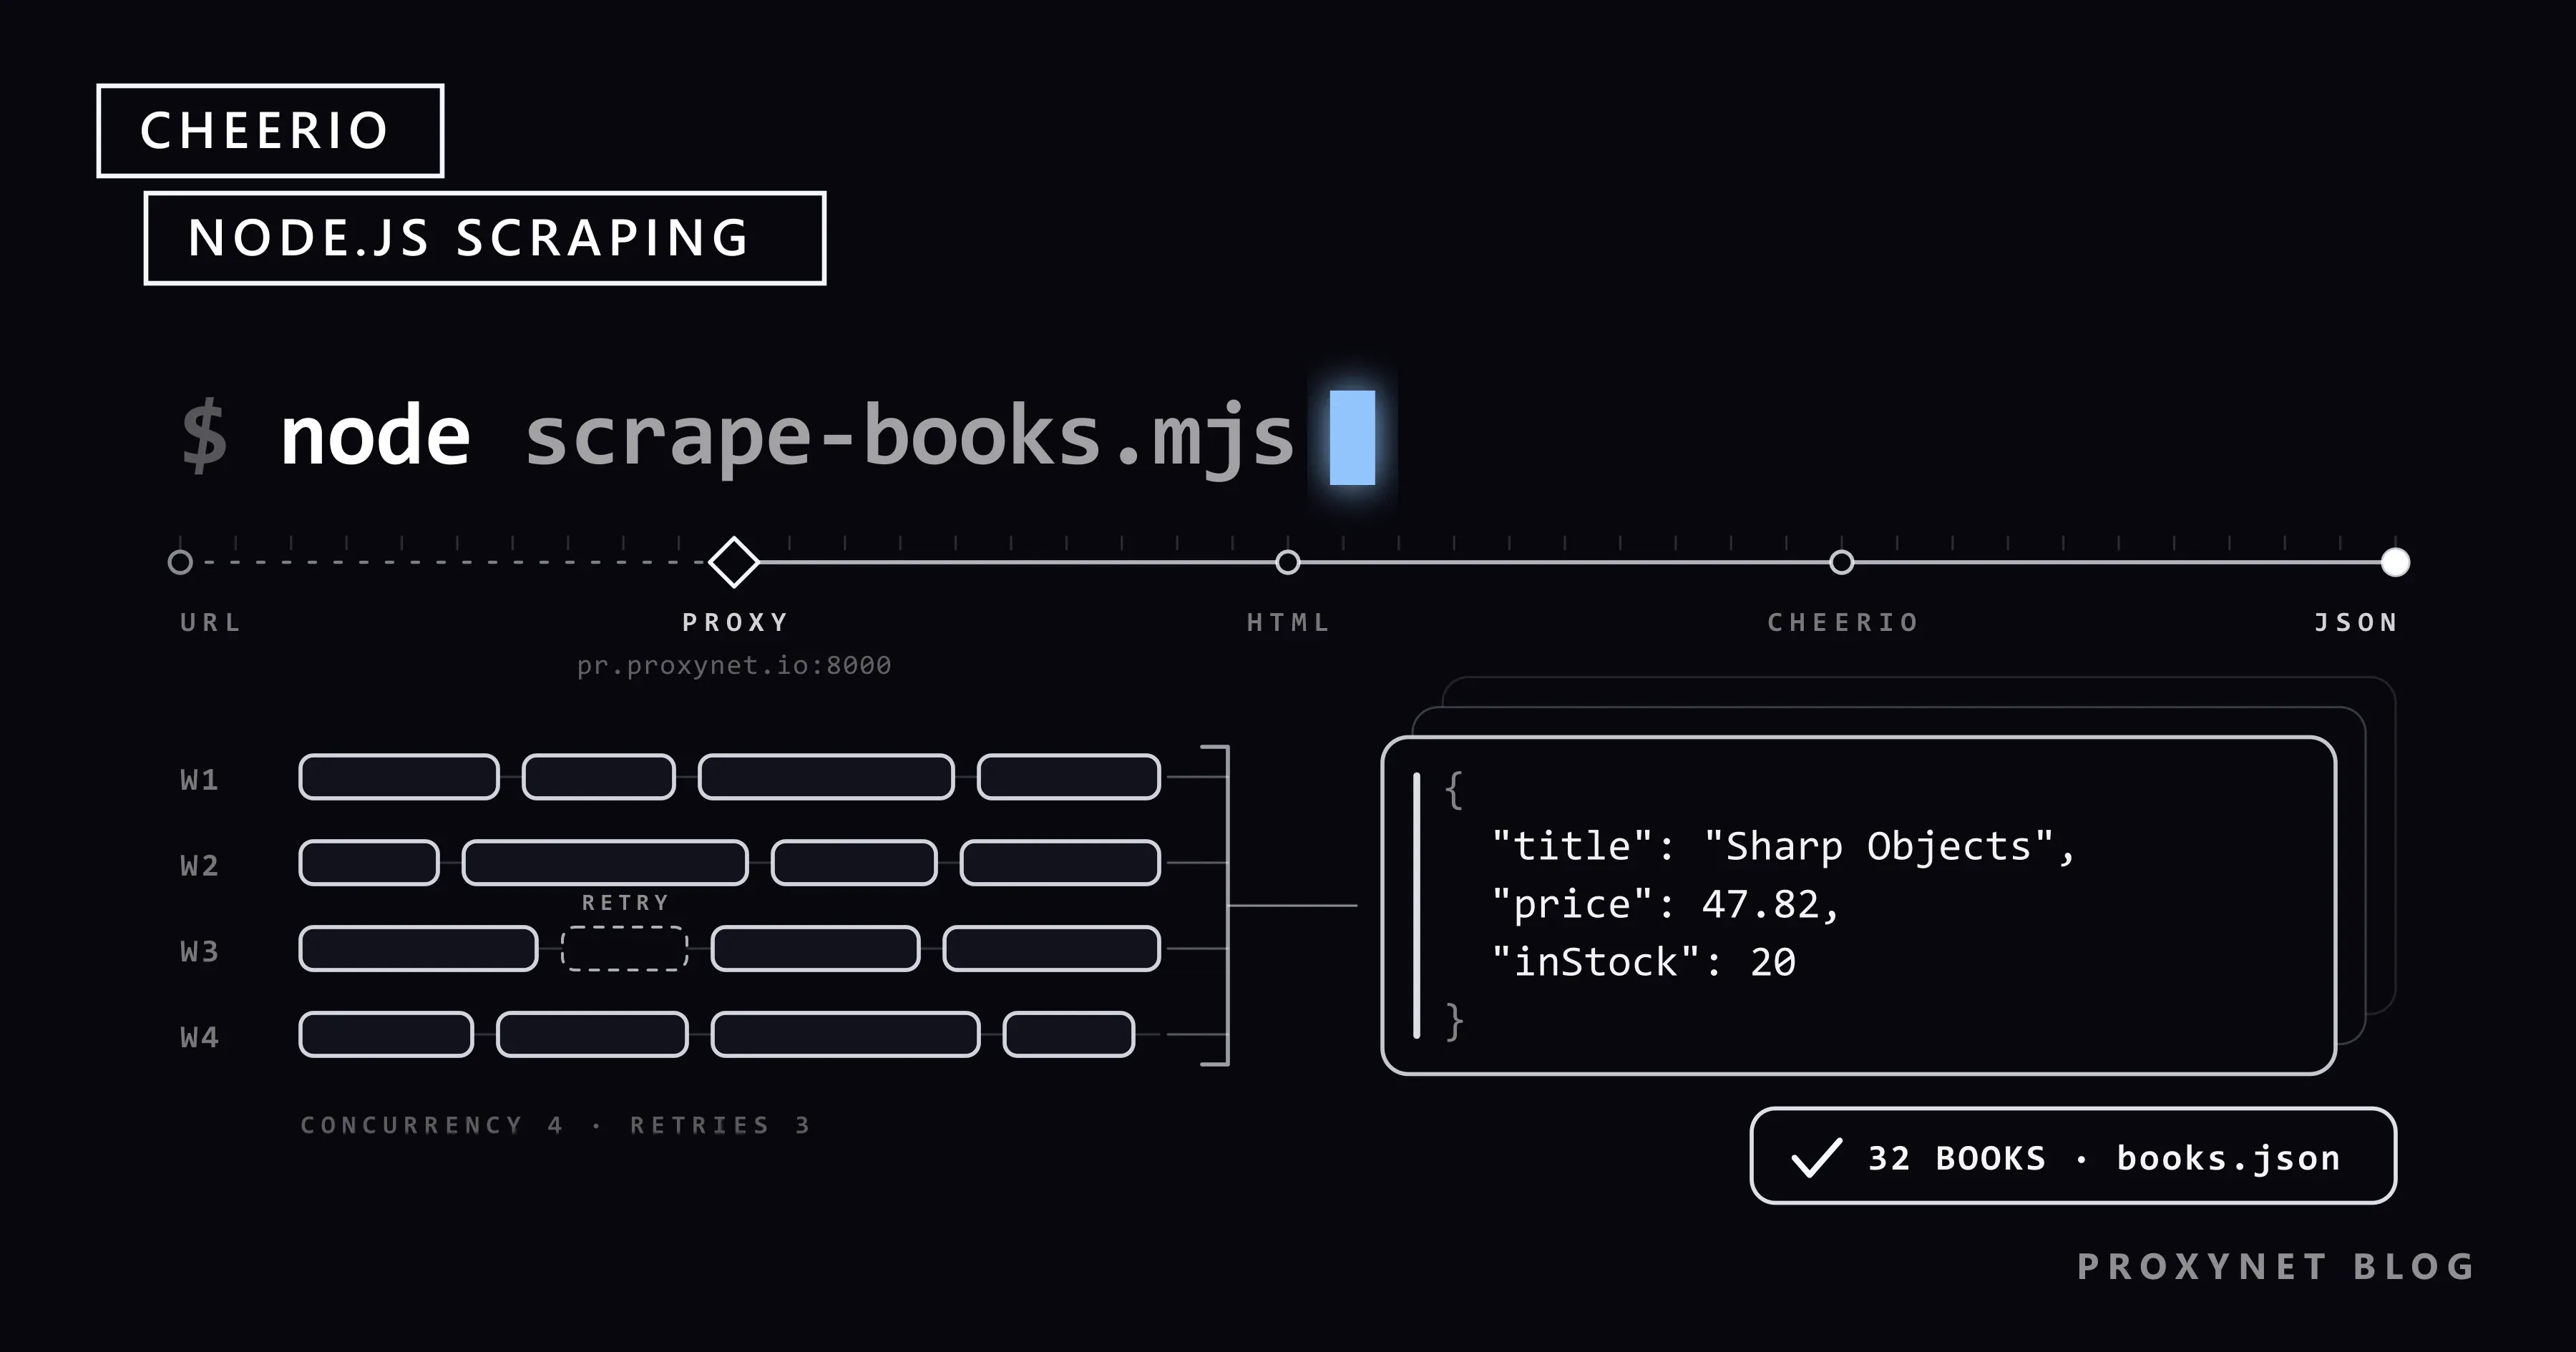
El script siguiente recopila todos los libros de la categoría Mystery. Recorre las páginas del listado siguiendo el enlace "next", abre la página de detalle de cada libro con un máximo de cuatro peticiones en curso, reintenta los errores de red, los timeouts y las respuestas 429 y 5xx con backoff exponencial, y escribe books.json. Usa el fetch de undici para que el proxy opcional de la siguiente sección funcione sin cambios. Instálalo con npm install cheerio undici (undici 8 requiere Node.js 22.19 o posterior).
import * as cheerio from "cheerio";
import { fetch, ProxyAgent } from "undici";
import { writeFile } from "node:fs/promises";

const START_URL =
  "https://books.toscrape.com/catalogue/category/books/mystery_3/index.html";
const CONCURRENCY = 4;   // páginas de detalle descargadas a la vez
const MAX_RETRIES = 3;   // intentos extra después del primero
const HEADERS = { "user-agent": "book-research/1.0 (+mailto:you@example.com)" };

// Proxy opcional: PROXY_URL=http://user:pass@pr.proxynet.io:8000
const dispatcher = process.env.PROXY_URL
  ? new ProxyAgent(process.env.PROXY_URL)
  : undefined;

const sleep = (ms) => new Promise((resolve) => setTimeout(resolve, ms));
const backoff = (attempt) => 1000 * 2 ** (attempt - 1) + Math.random() * 250;

class HttpError extends Error {
  constructor(status, url) {
    super(`HTTP ${status} for ${url}`);
    this.status = status;
  }
}

async function fetchHtml(url) {
  for (let attempt = 1; ; attempt++) {
    let wait;
    try {
      const res = await fetch(url, {
        headers: HEADERS,
        dispatcher,
        signal: AbortSignal.timeout(15_000),
      });
      if (res.ok) return await res.text();
      const retryable = res.status === 429 || res.status >= 500;
      if (!retryable || attempt > MAX_RETRIES) throw new HttpError(res.status, url);
      const retryAfter = Number(res.headers.get("retry-after"));
      wait = retryAfter > 0 ? retryAfter * 1000 : backoff(attempt);
    } catch (err) {
      if (err instanceof HttpError || attempt > MAX_RETRIES) throw err;
      wait = backoff(attempt); // error de red o timeout
    }
    console.warn(`retry ${attempt}/${MAX_RETRIES} in ${Math.round(wait)} ms: ${url}`);
    await sleep(wait);
  }
}

// Ejecuta fn sobre items con un máximo de `limit` llamadas en curso.
async function mapLimit(items, limit, fn) {
  const results = new Array(items.length);
  let next = 0;
  async function worker() {
    while (next < items.length) {
      const i = next++;
      results[i] = await fn(items[i], i);
    }
  }
  await Promise.all(Array.from({ length: Math.min(limit, items.length) }, worker));
  return results;
}

function parseListPage(html, pageUrl) {
  const $ = cheerio.load(html);
  const books = $("article.product_pod")
    .map((_, el) => {
      const card = $(el);
      const link = card.find("h3 a");
      return {
        title: link.attr("title"),
        price: Number(card.find(".price_color").text().replace(/[^0-9.]/g, "")),
        rating: card.find("p.star-rating").attr("class").split(" ").pop(),
        url: new URL(link.attr("href"), pageUrl).href,
      };
    })
    .get();
  const nextHref = $("li.next a").attr("href");
  return { books, nextUrl: nextHref ? new URL(nextHref, pageUrl).href : null };
}

function parseDetailPage(html) {
  const $ = cheerio.load(html);
  const info = {};
  $("table.table-striped tr").each((_, row) => {
    info[$(row).find("th").text().trim()] = $(row).find("td").text().trim();
  });
  const stock = info["Availability"]?.match(/\((\d+) available\)/);
  return {
    upc: info["UPC"],
    inStock: stock ? Number(stock[1]) : 0,
    description: $("#product_description + p").text().trim(),
  };
}

// 1. Recorrer las páginas del listado siguiendo el enlace "next".
const listed = [];
for (let url = START_URL; url; ) {
  const { books, nextUrl } = parseListPage(await fetchHtml(url), url);
  listed.push(...books);
  console.log(`${url} -> ${books.length} books`);
  url = nextUrl;
}

// 2. Abrir cada página de detalle, de cuatro en cuatro.
const books = await mapLimit(listed, CONCURRENCY, async (book) => {
  try {
    return { ...book, ...parseDetailPage(await fetchHtml(book.url)) };
  } catch (err) {
    console.error(`skipped ${book.url}: ${err.message}`);
    return { ...book, error: err.message };
  }
});

// 3. Guardar el resultado.
await writeFile(
  "books.json",
  JSON.stringify({ scrapedAt: new Date().toISOString(), count: books.length, books }, null, 2),
);
console.log(`saved ${books.length} books to books.json`);https://books.toscrape.com/catalogue/category/books/mystery_3/index.html -> 20 books
https://books.toscrape.com/catalogue/category/books/mystery_3/page-2.html -> 12 books
saved 32 books to books.jsonUn registro de books.json (descripción abreviada):
{
  "title": "Sharp Objects",
  "price": 47.82,
  "rating": "Four",
  "url": "https://books.toscrape.com/catalogue/sharp-objects_997/index.html",
  "upc": "e00eb4fd7b871a48",
  "inStock": 20,
  "description": "…"
}
Qué hace cada parte:
- Paginación. El bucle termina cuando la página no tiene
li.next a. El enlace de la página 1 espage-2.html, relativo a la carpeta de la categoría, y por eso cada URL pasa pornew URL(href, pageUrl). Otros patrones (números de página en la query string, cursores, API de "cargar más") están en Paginación en web scraping. - Límite de concurrencia.
mapLimitarranca cuatro workers que toman el siguiente elemento de un contador compartido. UnPromise.allsobre las 32 URL enviaría 32 peticiones a la vez; con 1.000 URL, el servidor lo vería como una ráfaga. Cuatro es un punto de partida respetuoso para un sitio pequeño. - Reintentos. Solo se reintentan los errores que pueden resolverse solos: fallos de red, el timeout de 15 segundos, 429 y 5xx. Un 404 falla de inmediato. Una cabecera
Retry-Afternumérica tiene prioridad sobre la espera calculada; el backoff se duplica a partir de un segundo aproximadamente y añade una variación aleatoria (jitter) para que los workers paralelos no reintenten al mismo tiempo. Por qué aparece el 429 y cómo leer la cabecera se explica en HTTP 429 Too Many Requests. - Fallo parcial. Una página de detalle que sigue fallando después de tres reintentos se convierte en una fila con un campo
erroren lugar de detener la ejecución. Más tarde puedes volver a procesar solo esas filas. - JSON. El archivo incluye
scrapedAtycount, lo que ayuda a comparar ejecuciones. Para CSV, JSON Lines o SQLite con upserts, consulta Cómo guardar datos de scraping en CSV, JSON y SQLite.
Usar un proxy con Cheerio (undici ProxyAgent)
En este script Cheerio nunca abre una conexión, así que el proxy corresponde al cliente HTTP. Con undici, creas un ProxyAgent y se lo pasas a fetch como dispatcher. El script completo de arriba ya lo hace cuando PROXY_URL está definida:
PROXY_URL=http://user:pass@pr.proxynet.io:8000 node scrape-books.mjsundici construye la cabecera Proxy-Authorization a partir del usuario y la contraseña de la URL, y antes los decodifica, así que los caracteres especiales de una contraseña deben ir codificados con porcentaje (documentación de ProxyAgent de undici). Para destinos HTTPS, el agente abre un túnel CONNECT y el TLS hacia el sitio va dentro de él.
Ejecutamos el script a través de un pequeño proxy local que exigía user:pass y registraba cada túnel. Las 34 peticiones (dos páginas de listado y 32 páginas de detalle) llegaron por un único CONNECT books.toscrape.com:443: el agente mantuvo el túnel abierto y lo reutilizó. Con una contraseña incorrecta, el proxy respondió 407 y undici informó Proxy response (407) !== 200 when HTTP Tunneling. El script lo reintentó tres veces antes de rendirse; una contraseña incorrecta nunca se corrige sola, así que revisa las credenciales en lugar de subir el número de reintentos.
Si prefieres no añadir undici como dependencia, Node.js 24.5 y 22.21 incorporaron un soporte de proxy integrado que lee HTTP_PROXY, HTTPS_PROXY y NO_PROXY cuando defines NODE_USE_ENV_PROXY=1 (soporte de proxy integrado de Node.js). La documentación lo marca como en desarrollo activo. En nuestra prueba con Node.js 24.11.1, el fetch global normal pasó por el proxy local con esta configuración:
NODE_USE_ENV_PROXY=1 HTTPS_PROXY=http://user:pass@pr.proxynet.io:8000 node first-page.mjsAxios y node-fetch usan agentes en lugar de dispatchers; Cómo usar un proxy en Node.js cubre ambos. Para rotar la IP de salida en cada petición o para sesiones fijas que mantienen una IP durante un tiempo, Proxies residenciales y Proxies rotativos aceptan la misma URL user:pass@host:port.
Cuándo Cheerio no es suficiente
Cheerio no puede hacer clic, desplazarse ni esperar una petición que la página lanza después de cargar. Señales de que necesitas un navegador:
- El código fuente de la página (Ctrl+U) no contiene los datos que muestra la página renderizada.
- El HTML trae un contenedor vacío como
<div id="root"></div>y un paquete de scripts grande. - Los datos solo aparecen tras un formulario de inicio de sesión, un banner de cookies o un "scroll infinito".
Antes de lanzar un navegador, abre la pestaña Red de las herramientas para desarrolladores. Muchas páginas "dinámicas" cargan sus datos desde un endpoint JSON, y pedir ese endpoint con fetch es más ligero que renderizar la página. Si de verdad necesitas un navegador, Playwright puede renderizar la página y pasar el HTML final a Cheerio con cheerio.load(await page.content()), así tu código de parsing no cambia.
Dónde se usan los scrapers con Cheerio
- Seguimiento de precios: leer precios de páginas de producto renderizadas en el servidor de forma programada (monitorización de precios).
- Catálogo y datos de mercado: recopilar gamas de productos y niveles de stock de varias tiendas (estudios de mercado).
- Visibilidad en buscadores: comprobar títulos, metaetiquetas y encabezados de tus propias páginas (proxy para SEO).
- Pipelines de datos: alimentar un crawler o un proceso ETL más grande con filas ya analizadas (extracción de datos, rastreador web).
- Parsing de HTML guardado: convertir páginas archivadas en registros estructurados; la parte del parsing se explica en ¿Qué es el parsing de datos?.
Errores comunes y cómo diagnosticarlos
- Cadenas vacías por todas partes. El selector no coincidió con nada o los datos los añade JavaScript. Guarda el HTML con
writeFile("page.html", html)y busca en él un valor que veas en el navegador. require(...).default is not a functionodoes not provide an export named 'default'. Estilo de importación antiguo. Usaimport * as cheerio from "cheerio".TypeError: fetch failedconinvalid onRequestStart method. Pasaste unProxyAgentdel paquete undici de npm alfetchglobal de Node.js. Node 24.11.1 incluye undici 7.16.0 y las dos versiones no comparten la interfaz de dispatcher. ImportafetchyProxyAgentdel mismo paquete.- Un proxy que "no hace nada". Pasaste el agente a
cheerio.fromURL, que usa su propio cliente. Descarga confetchy llama acheerio.load. - Los enlaces relativos fallan.
fetch("catalogue/…")lanzaFailed to parse URL. Resuélvelos connew URL(href, pageUrl). - Demasiadas peticiones a la vez.
Promise.all(urls.map(fetch))lo envía todo en paralelo y provoca respuestas 429. Usa un límite comomapLimit. - Deriva silenciosa de los datos. El sitio cambia el nombre de una clase y los precios pasan a ser
NaN. Revisa cada ejecución: cuenta las filas, cuenta los preciosNaNy detén el proceso si las cifras caen de golpe.
Antes de escalar, lee el robots.txt y los términos del sitio, usa una API oficial cuando exista y mantén un ritmo de peticiones moderado. robots.txt explicado y ¿El web scraping es legal? cubren las reglas; Web scraping sin bloqueos explica cómo hacer crawling de forma respetuosa.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Los datos están en el código fuente de la página | fetch + cheerio.load |
| Script puntual, sin proxy | cheerio.fromURL |
| Muchos registros con la misma estructura | $.extract con un descriptor de array |
| Cientos de páginas | Un límite de concurrencia de 2-5 más reintentos con backoff |
| Peticiones a través de un proxy | fetch de undici + ProxyAgent, o NODE_USE_ENV_PROXY=1 en Node.js 24.5+ |
| Los datos solo aparecen después de ejecutar JavaScript | Busca primero el endpoint JSON; si no, Playwright + Cheerio |
El código espera un DOM completo (document, eventos) | jsdom |
Preguntas frecuentes
¿Cheerio sigue manteniéndose en 2026?
Sí. El registro de npm muestra la versión 1.2.0, publicada en enero de 2026, como la última, y el sitio de documentación cubre la API 1.x, incluidos extract y fromURL.
¿Cheerio ejecuta JavaScript?
No. Analiza la cadena HTML que le das y nada más. Los scripts de la página se tratan como texto. Para páginas que construyen su contenido en el navegador, usa Playwright o localiza el endpoint de datos al que llama la página.
¿Necesito Axios con Cheerio?
No. Node.js 18 y posteriores incluyen fetch, que cubre lo que necesita la mayoría de los scrapers. Axios es cuestión de gustos; si lo usas, pasa el cuerpo de la respuesta (response.data) a cheerio.load.
¿Cómo hago scraping de varias páginas con Cheerio?
Lee el enlace a la página siguiente en cada página, resuélvelo respecto a la URL actual y repite el bucle hasta que el enlace desaparezca, como en el script completo de arriba. Si conoces el número de páginas, también puedes generar la lista de URL de antemano y procesarla con un límite de concurrencia.
¿Cómo uso un proxy con Cheerio?
Configura el proxy en el cliente HTTP, no en Cheerio. Con undici: new ProxyAgent("http://user:pass@pr.proxynet.io:8000"), pasado como dispatcher al fetch de undici. En Node.js 24.5 o posterior puedes definir en su lugar NODE_USE_ENV_PROXY=1 y HTTPS_PROXY.
¿Cheerio es más rápido que Puppeteer o Playwright?
Para páginas cuyos datos están en el HTML, sí, porque solo analiza texto, mientras que un navegador además descarga recursos, ejecuta scripts y calcula el diseño de la página. No medimos la diferencia y depende de cada página, así que mídela con tus propios objetivos si las cifras importan.
En resumen
Cheerio convierte el HTML descargado en un árbol que puedes consultar con selectores CSS y, en la versión 1.x, añade fromURL y extract. Un scraper fiable deja el trabajo de red fuera de Cheerio: fetch con timeout, reintentos para 429, 5xx y errores de red, un límite de concurrencia pequeño y un archivo JSON con marca de tiempo. Cuando las peticiones deben salir desde otra IP u otro país, pasa un ProxyAgent de undici como dispatcher y apúntalo a un proxy de Proxynet.