Un equipo de precios quiere cada mañana los precios de 300 productos de 40 tiendas online, tal como los ven los compradores de cinco países. La mitad de las tiendas construye sus páginas con JavaScript, y cada una organiza su HTML de forma distinta. El equipo puede crear y mantener los scrapers por su cuenta, o enviar cada URL de producto a una API de web scraping y recibir los campos en JSON.
Este artículo explica cómo funciona una API de web scraping y qué trabajo te quita de encima. La compara con otras cuatro vías para obtener datos web, repasa los tipos, los precios y el lado legal, y termina con la pregunta de quien compra: ¿una API de scraping o tus propios proxies?
¿Qué es una API de web scraping?
Una API de web scraping es un servicio HTTP que obtiene una página web en tu nombre y devuelve su contenido en una forma que tu programa puede usar. La llamas como a cualquier API, pero los datos salen del scraping de una página cuyo propietario nunca los ofreció como API. También se vende como scraper API o como servicio de web scraping.
El artículo ¿Qué es el web scraping y cómo funciona? explica el web scraping en sí: un programa que descarga páginas y extrae valores del HTML. Una API de scraping hace el mismo trabajo. La diferencia está en quién opera la maquinaria.
¿Cómo es una solicitud?
El endpoint api.example.com y los nombres de los campos de abajo son inventados para ilustrar; cada proveedor llama a sus opciones de forma distinta, pero la estructura se parece.
curl -s https://api.example.com/v1/scrape \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://shop.example.com/p/1234", "country": "de", "render": false, "output": "json"}'
Enviada a una réplica local (mock) de la misma API inventada, la solicitud devolvió:
{
  "url": "https://shop.example.com/p/1234",
  "target_status": 200,
  "country": "de",
  "rendered": false,
  "attempts": 2,
  "data": {
    "name": "Desk lamp",
    "price": "24.90",
    "currency": "EUR",
    "in_stock": true
  }
}
target_status es el código de estado de la tienda, attempts indica que el servicio necesitó dos intentos y data contiene los campos que su parser extrajo. Con "output": "html" recibes la página tal cual y la analizas por tu cuenta.
¿Cómo funciona una API de web scraping?
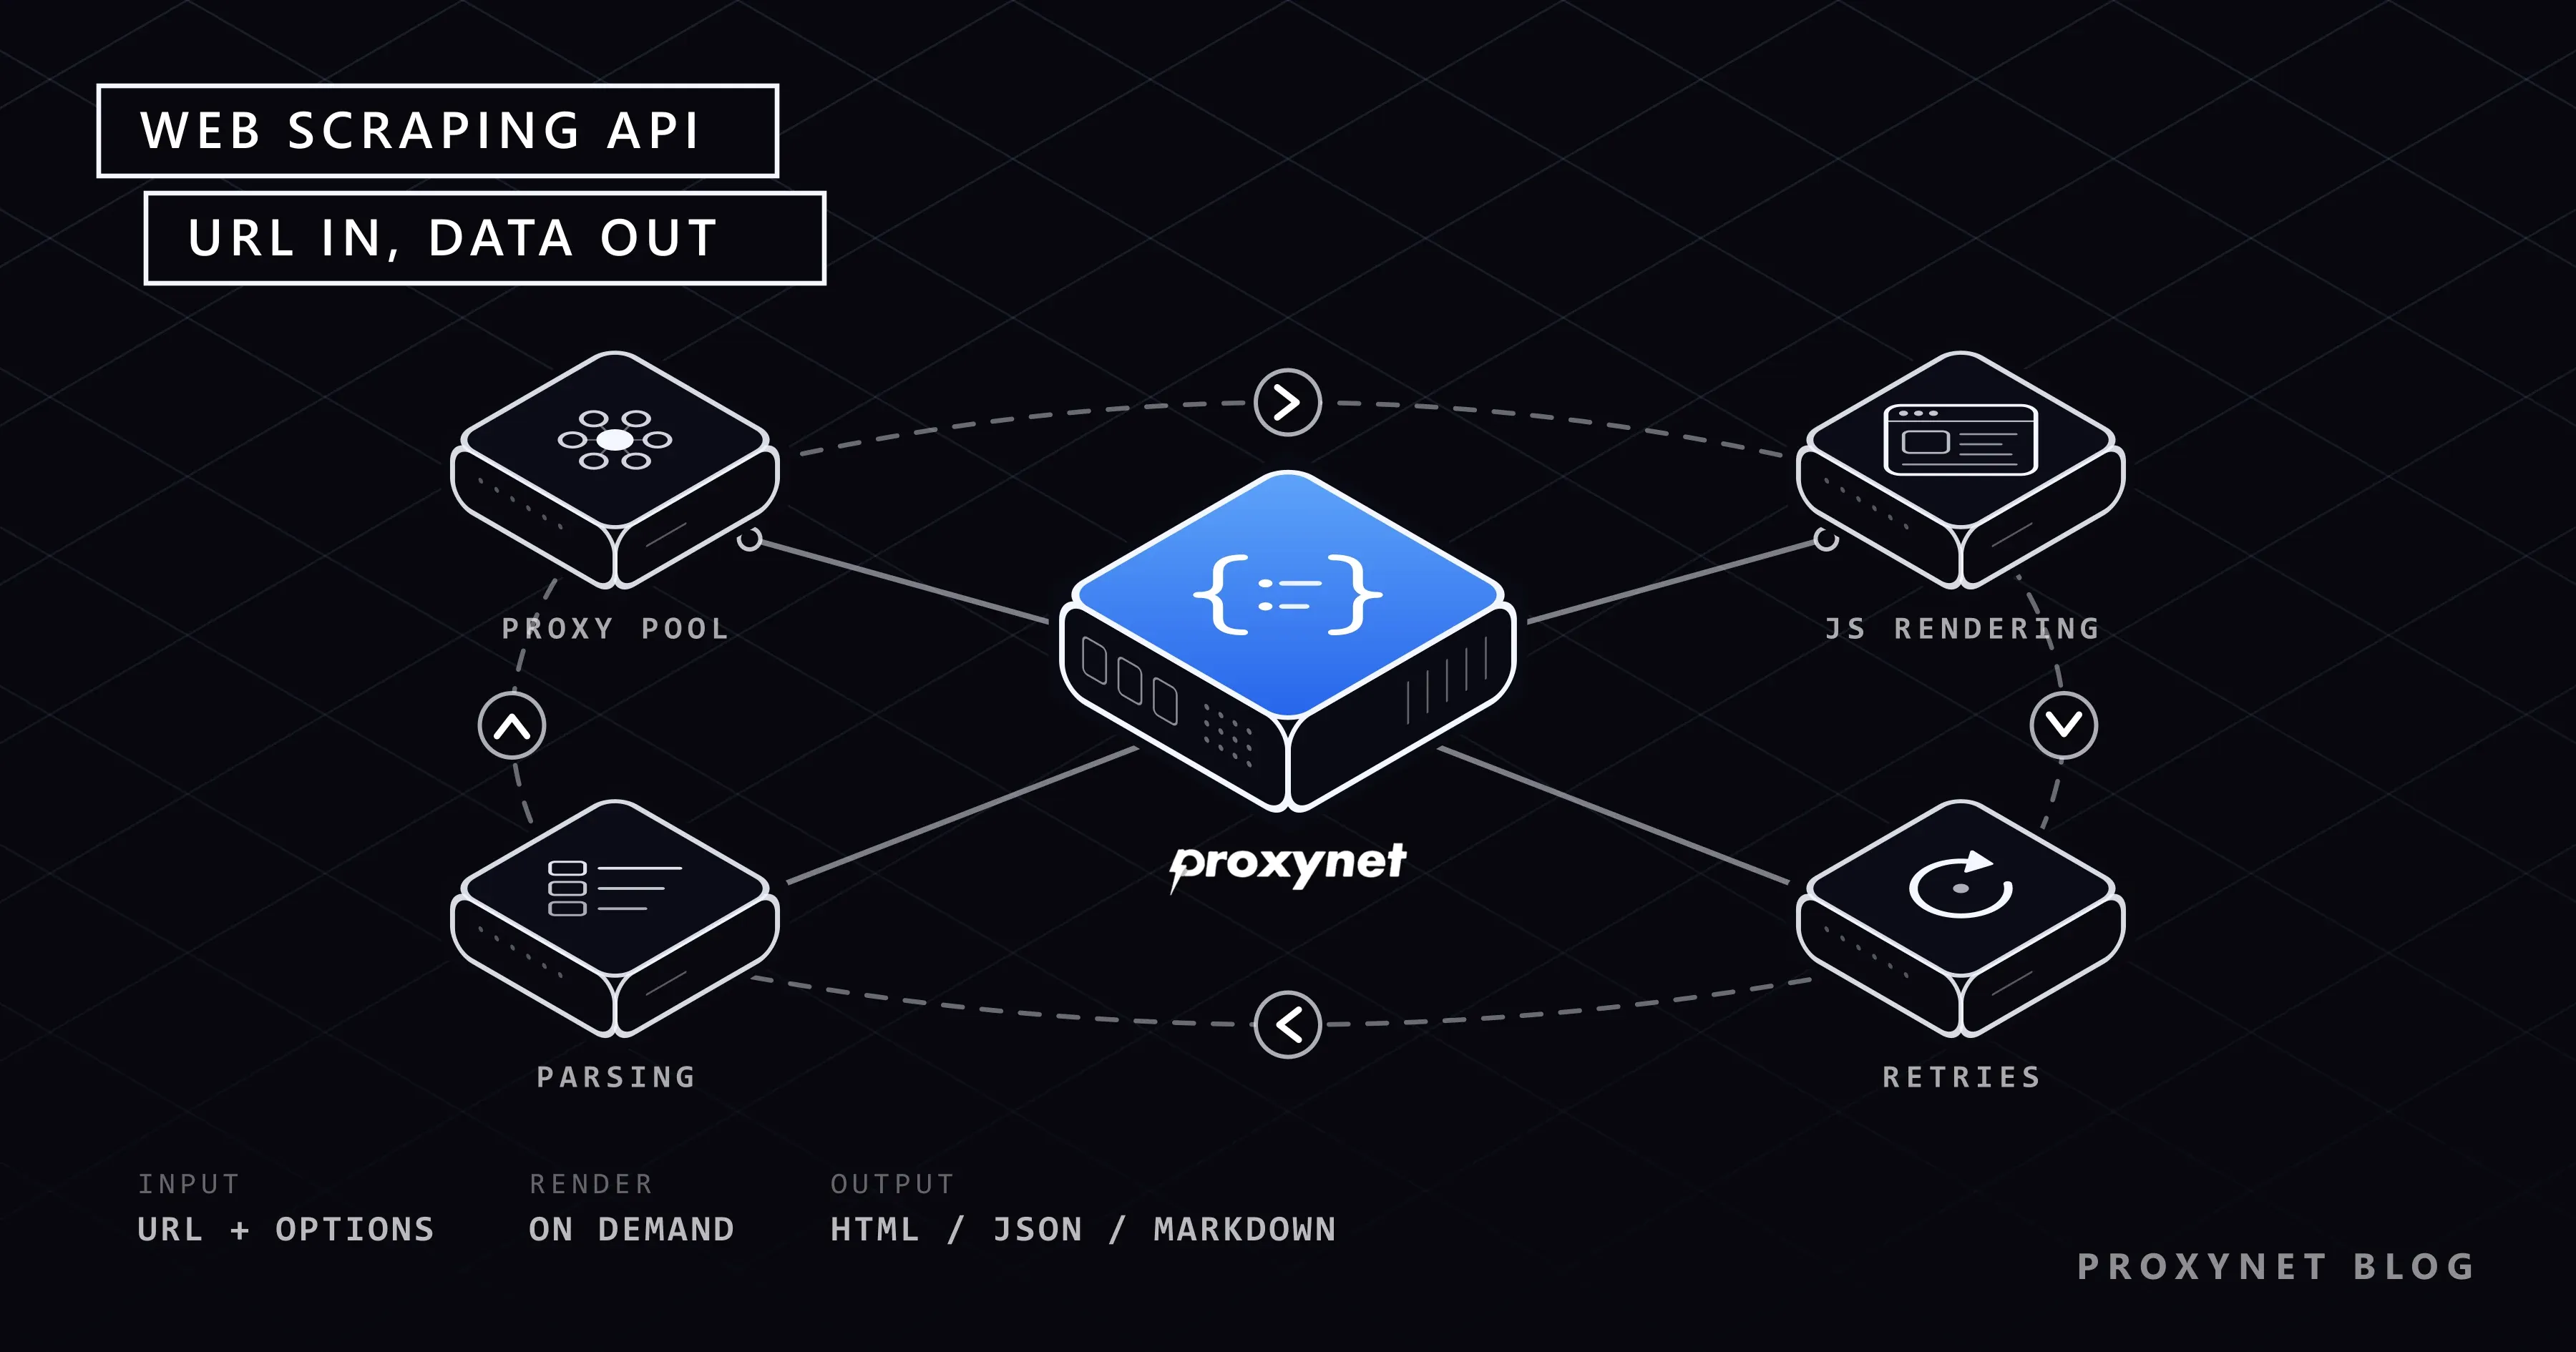
Una API de web scraping ejecuta en su propia infraestructura el mismo proceso que un scraper hecho en casa:
- Envías el trabajo: la URL de destino más opciones como país, renderizado y formato de salida, a veces un ID de sesión que mantiene la misma IP durante varias páginas.
- El servicio elige una IP de salida de su pool de proxies en el país que pediste.
- Obtiene la página con una solicitud HTTP simple o en un navegador headless que ejecuta el JavaScript de la página.
- Revisa la respuesta: el código de estado, un cuerpo vacío o una página de bloqueo donde debería estar el contenido.
- Reintenta los fallos con otra IP o tras una pausa, dentro de un número fijo de intentos.
- Convierte el resultado en HTML sin procesar, Markdown limpio o campos con nombre en JSON.
- Devuelve el resultado con metadatos, como el código de estado del destino y los intentos, y factura la solicitud.
¿Qué hace por ti una API de web scraping?
Una API de web scraping se encarga de las cinco tareas que más tiempo consumen en el scraping: las direcciones IP, el renderizado, los reintentos, la gestión de bloqueos y el parsing.
Rotación de proxies y segmentación geográfica. Cada solicitud sale por una IP del pool del proveedor, en el país (a veces la ciudad) que eliges, con una dirección nueva por solicitud o una que se mantiene durante una sesión. Los pools mezclan IP de centro de datos baratas con IP residenciales y móviles de conexiones domésticas y móviles, que cuestan más.
Renderizado de JavaScript. Muchas páginas llegan como un esqueleto HTML casi vacío que JavaScript rellena después. En ese caso, el servicio abre la página en un navegador headless; la documentación de Chrome describe este modo como ejecutar el navegador "en un entorno desatendido, sin ninguna interfaz visible" (modo headless de Chrome). El renderizado es la opción más lenta y más cara, así que lo activas solicitud por solicitud.
Reintentos. Las conexiones se cortan, los proxies agotan el tiempo de espera y los servidores responden 503 durante un momento; el servicio reintenta esos fallos hasta un límite. Una página que no existe (404) no merece otro intento, y un servicio bien hecho trata 429 Too Many Requests como una señal para ir más despacio.
Detección de bloqueos y CAPTCHA. Un sitio que rechaza una solicitud suele enviar una página de "Access denied" de aspecto normal o un CAPTCHA, una prueba pensada para distinguir a las personas de los programas. Un buen servicio informa de esa página como un fallo en lugar de devolverla como datos. El rechazo es una decisión del sitio, así que pregunta cómo responde un proveedor cuando ocurre.
Parsing y salida estructurada. Muchas API devuelven campos con nombre, a partir de parsers ya hechos o de selectores que tú indicas; otras devuelven el texto principal en Markdown, que los modelos de lenguaje leen con más facilidad que el HTML. Te ahorras escribir un parser, pero el parser de otro decide qué significa "precio".
API de web scraping frente a API oficial, proxies, herramientas y conjuntos de datos
Las cinco vías terminan con los datos en tu sistema. Se diferencian en lo que recibes y en quién hace el trabajo.
| Vía | Qué recibes | Quién hace el trabajo duro | Mejor cuando |
|---|---|---|---|
| API de web scraping | Páginas o campos de cualquier URL | El proveedor | Muchos sitios, poco tiempo |
| API oficial | Los datos del propio sitio, documentados | El sitio | Existe y tiene tus campos |
| Servicio de proxies | Direcciones IP para tus solicitudes | Tú | Volumen alto, control total |
| Biblioteca de scraping | Código que ejecutas tú | Tú | Tienes desarrolladores y servidores |
| Compra de un conjunto de datos | Datos listos en archivos | El proveedor de datos | Los datos existen como producto |
Frente a una API oficial. El sitio dueño de los datos publica una API oficial; una API de scraping es un tercero que lee las páginas públicas de ese sitio. Web scraping vs. API compara ambas opciones con un ejemplo probado. Para quien compra, la diferencia clave es el acuerdo: una API oficial viene con unos términos que aceptas y, a menudo, con campos que ninguna página muestra, como los ID internos. Una API de scraping no tiene ningún acuerdo con el sitio de destino, y sus campos pueden romperse cuando el sitio se rediseña. Si una API oficial trae tus campos, úsala.
Frente a un servicio de proxies. Un servicio de proxies vende direcciones IP para tus propias solicitudes; el scraper, el navegador, los reintentos y el parser siguen siendo cosa tuya. Una API de scraping cobra por página terminada, y la mayoría funciona a su vez sobre pools de proxies.
Frente a una biblioteca de scraping. Scrapy, Playwright o Beautiful Soup no cuestan nada en licencias, pero tu equipo escribe el código y mantiene los servidores. Una vía intermedia habitual deja el parsing en la biblioteca y envía a una API solo las descargas más difíciles.
Frente a un conjunto de datos. Un proveedor de datos vende datos ya recopilados y limpios, entregados en archivos: es lo más rápido cuando los datos existen como producto, y lo más débil cuando necesitas campos concretos o actualizaciones diarias.
¿Qué tipos de API de web scraping hay?
Los proveedores empaquetan la misma maquinaria para distintos destinos, y un mismo proveedor suele vender varias:
- Las API de uso general obtienen cualquier URL y devuelven HTML, HTML renderizado o Markdown.
- Las API de SERP devuelven las páginas de resultados de búsqueda como campos: posición, título, URL y fragmento. Los términos de los buscadores restringen las consultas automatizadas; para las posiciones de tu propio sitio, la API de Google Search Console da datos de primera mano.
- Las API de e-commerce convierten las páginas de producto de los marketplaces en campos como precio, disponibilidad, vendedor y valoración.
- Las API de redes sociales devuelven perfiles, publicaciones y comentarios públicos. Casi todo son datos personales y los términos de las plataformas son estrictos, así que aquí el margen legal es el más estrecho.
- Las API de extracción preparadas para IA devuelven el contenido principal de una página como Markdown o texto limpio, sin menús ni pies de página, para modelos de lenguaje y agentes de IA.
¿Cómo se cobran las API de web scraping?
Casi todas las API de scraping cobran por solicitud; lo que cambia es qué solicitudes cuentan. Hay cuatro modelos habituales, a menudo combinados:
- Por solicitud. Se factura cada llamada, tenga éxito o no.
- Por solicitud exitosa. Solo se facturan los éxitos, así que la definición de éxito pasa a ser la condición clave del contrato.
- Créditos con multiplicadores. Una solicitud simple cuesta un crédito; el renderizado, las IP residenciales o móviles y los destinos difíciles cuestan varios. Un precio por crédito dice poco hasta que conoces tu multiplicador.
- Planes mensuales. Una cuota fija de solicitudes o créditos, a menudo con un tope de solicitudes simultáneas y una tarifa para el exceso.
¿Qué cuenta como solicitud exitosa?
El estándar HTTP dice que un código de estado 2xx significa que la solicitud "se recibió, se entendió y se aceptó correctamente" (RFC 9110). Esa es la visión del servidor, no la tuya: una página de bloqueo puede llegar con el estado 200, y un 404 Not Found es una respuesta correcta sin datos dentro.
Así que, antes de comprar, pregunta si se facturan un 404, un 200 con una página vacía o de bloqueo y un tiempo de espera agotado tras el último intento. Después, mide el costo por cada 1.000 páginas útiles en tus destinos reales.
¿Te conviene una API de scraping o tus propios proxies?
Una API de scraping compensa cuando el trabajo es amplio y tienes poco tiempo; tu propio scraper con proxies compensa cuando el trabajo es acotado, grande y de largo plazo.
Elige una API de scraping cuando:
- necesitas páginas de muchos sitios distintos, cada uno con su propio diseño;
- muchos destinos construyen su contenido con JavaScript;
- el equipo es pequeño y nadie quiere mantener navegadores, proxies y parsers;
- el tiempo hasta el primer conjunto de datos importa más que el costo por página.
Elige tu propio scraper y proxies cuando:
- el volumen es muy alto en un puñado de sitios, así que un precio por página se acumula;
- el parser y la lógica de rastreo son tuyos, o quieres que lo sean;
- necesitas control total sobre la frecuencia de solicitudes, las sesiones y qué IP envía qué.
Muchos equipos usan las dos cosas: una API para la larga cola de sitios difíciles y su propio scraper para los pocos que concentran la mayor parte del volumen.
Para la vía de los proxies propios, Proxynet vende proxies en autoservicio. Nuestros Proxies residenciales ofrecen sesiones rotativas o fijas con segmentación por país y ciudad, y se facturan por GB. Los proxies ISP estáticos y de centro de datos se facturan por IP, con tráfico sin cuota; vienen por defecto con una restricción de sitios de destino, y el acceso a todos los sitios web es un complemento de pago.
Nuestra Web Scraper API está disponible por ahora a través del equipo de ventas, no en autoservicio. La página de extracción de datos cubre la parte de los proxies; para la API, indica a ventas tus sitios, tus países y el formato de salida.
¿Es legal usar una API de web scraping?
Una API no cambia lo que puedes recopilar: el robots.txt del sitio de destino, sus términos y la ley de protección de datos se aplican igual que si descargaras las páginas tú mismo, porque eres tú quien elige las URL y la finalidad.
robots.txt. Este archivo indica a los rastreadores qué rutas pueden obtener. Su estándar, el RFC 9309, dice que "estas reglas no son una forma de autorización de acceso" (RFC 9309): el archivo no bloquea nada, así que cumplirlo depende del rastreador. Pregunta si un proveedor lo respeta o te deja esa comprobación a ti.
Términos de uso. Los términos del sitio de destino rigen para ti, no solo para el proveedor. Las páginas detrás de un inicio de sesión, sobre todo con la cuenta de otra persona, son un asunto distinto de las páginas públicas.
Datos personales. Los nombres, los enlaces a perfiles, las direcciones de correo electrónico y las reseñas con el nombre del autor son datos personales según el RGPD, aunque sean públicos. El borrador de directrices del Comité Europeo de Protección de Datos (CEPD), adoptado para consulta pública el 7 de julio de 2026, afirma que "la organización que realiza el scraping no es necesariamente el responsable del tratamiento en virtud del RGPD" (Directrices 03/2026 del CEPD). Un contratista que hace scraping siguiendo instrucciones documentadas de un cliente puede ser encargado del tratamiento; el cliente, que fija la finalidad, es por lo general el responsable.
Las directrices tratan el scraping para entrenar IA generativa, pero el reparto de papeles sigue las reglas generales del RGPD. También citan los archivos robots.txt y los CAPTCHA entre las señales de que un sitio se opone al scraping.
Así que recopila solo los campos que necesitas y firma un contrato de encargo del tratamiento si el proveedor trata datos personales por ti. Cómo tratar datos personales (PII) en datos de scraping explica cómo reducir esos datos y enmascararlos.
Casos de uso
- Seguimiento de precios y stock en muchas tiendas y países.
- Seguimiento de resultados de búsqueda para una lista de palabras clave, dentro de los términos del buscador.
- Investigación de mercado: surtidos, catálogos y textos de reseñas sin datos de autor.
- Agregación de anuncios de portales inmobiliarios, de viajes o de clasificados.
- Pipelines de IA: documentación convertida a Markdown para la recuperación de información (retrieval).
- Verificación de anuncios y contenidos: cómo se ve una página en otro país.
Errores frecuentes
- Pagar por un renderizado que no necesitas. Prueba primero cada destino sin renderizado; muchas páginas traen los datos en el HTML.
- Comparar precios sin la definición de éxito. Un precio bajo por solicitud dice poco si se facturan las páginas de bloqueo y las respuestas
404. - Fiarse del JSON devuelto sin validar el esquema. Tras un rediseño, un campo extraído puede convertirse en
nullsin avisar. Valida cada respuesta con un esquema; JSON Schema es el formato habitual. - Reintentar encima de los reintentos del proveedor. Tres intentos de la API por tres tuyos son nueve descargas de una página que falla.
- Dar por hecho que la API se ocupa del consentimiento y la legalidad. El proveedor descarga; tú decides qué y para qué.
- Usar una API de scraping cuando existe una API oficial. Pagas por extraer datos que el propietario ya ofrece.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Datos de 50 sitios distintos, equipo pequeño | Una API de scraping |
| Muchos destinos construyen las páginas con JavaScript | Una API de scraping, con renderizado solo donde haga falta |
| Millones de páginas al mes de tres sitios | Tu propio scraper con proxies |
| Control total de frecuencia, sesiones y parsing | Tu propio scraper con proxies |
| El sitio tiene una API oficial con tus campos | La API oficial |
| Precios tal como los ven los compradores de cinco países | Una API de scraping o proxies residenciales |
| Los datos existen como producto, la frescura es opcional | Comprar un conjunto de datos |
| Perfiles públicos o reseñas con nombre de autor | Reduce los campos y aclara antes la base legal |
Preguntas frecuentes
¿Para qué se usa una API de web scraping?
Una API de web scraping se usa para recopilar datos de sitios web sin mantener tu propia infraestructura de scraping. Los trabajos típicos son el seguimiento de precios, el de resultados de búsqueda, la investigación de mercado, la agregación de anuncios y el envío de páginas web a sistemas de IA en forma de texto limpio.
¿Una API de web scraping es lo mismo que un proxy?
No. Un proxy solo reenvía tus solicitudes a través de otra dirección IP, y tu código sigue descargando, renderizando, reintentando y haciendo el parsing. Una API de web scraping hace todo eso y devuelve la página terminada o los campos.
¿Es mejor una scraper API que crear tu propio scraper?
Para muchos sitios y un equipo pequeño, normalmente sí: arranca más rápido y no necesita infraestructura. Para un volumen muy alto en pocos sitios, tu propio scraper con proxies suele costar menos por página y te da control total.
¿Puede una API de web scraping extraer datos de sitios con JavaScript?
Sí, si ofrece renderizado: abre la página en un navegador headless y devuelve el contenido terminado. Las solicitudes renderizadas son más lentas y a menudo cuestan más, así que comprueba primero si los datos ya están en el HTML simple.
¿Cuánto cuesta una API de web scraping?
El modelo de precios decide más que el precio anunciado. Los servicios cobran por solicitud, por solicitud exitosa o en créditos, y el renderizado o las IP residenciales suelen multiplicar el costo de una página. Compara el costo por cada 1.000 páginas útiles en tus propios destinos.
¿Es legal usar una API de web scraping?
La cuestión legal no es usar el servicio, sino lo que recopilas con él. Los términos del sitio de destino, su robots.txt y la ley de protección de datos rigen para ti como si hicieras el scraping de las páginas tú mismo. Para un proyecto concreto, consulta a un abogado de tu jurisdicción.
En resumen
Una API de web scraping es scraping vendido como servicio: se ocupa de las direcciones IP, el renderizado, los reintentos, la detección de bloqueos y el parsing, y devuelve HTML, JSON o Markdown. Es la vía rápida para muchos sitios y equipos pequeños; tu propio scraper con proxies sale más barato con un volumen grande y estable en pocos sitios. Comprueba qué cuenta como éxito facturable y valida lo que te llega. Para hablar de nuestra Web Scraper API, contacta con nuestro equipo de ventas.