

































Web scraping · Blog de Proxynet – Página 6

Publicado
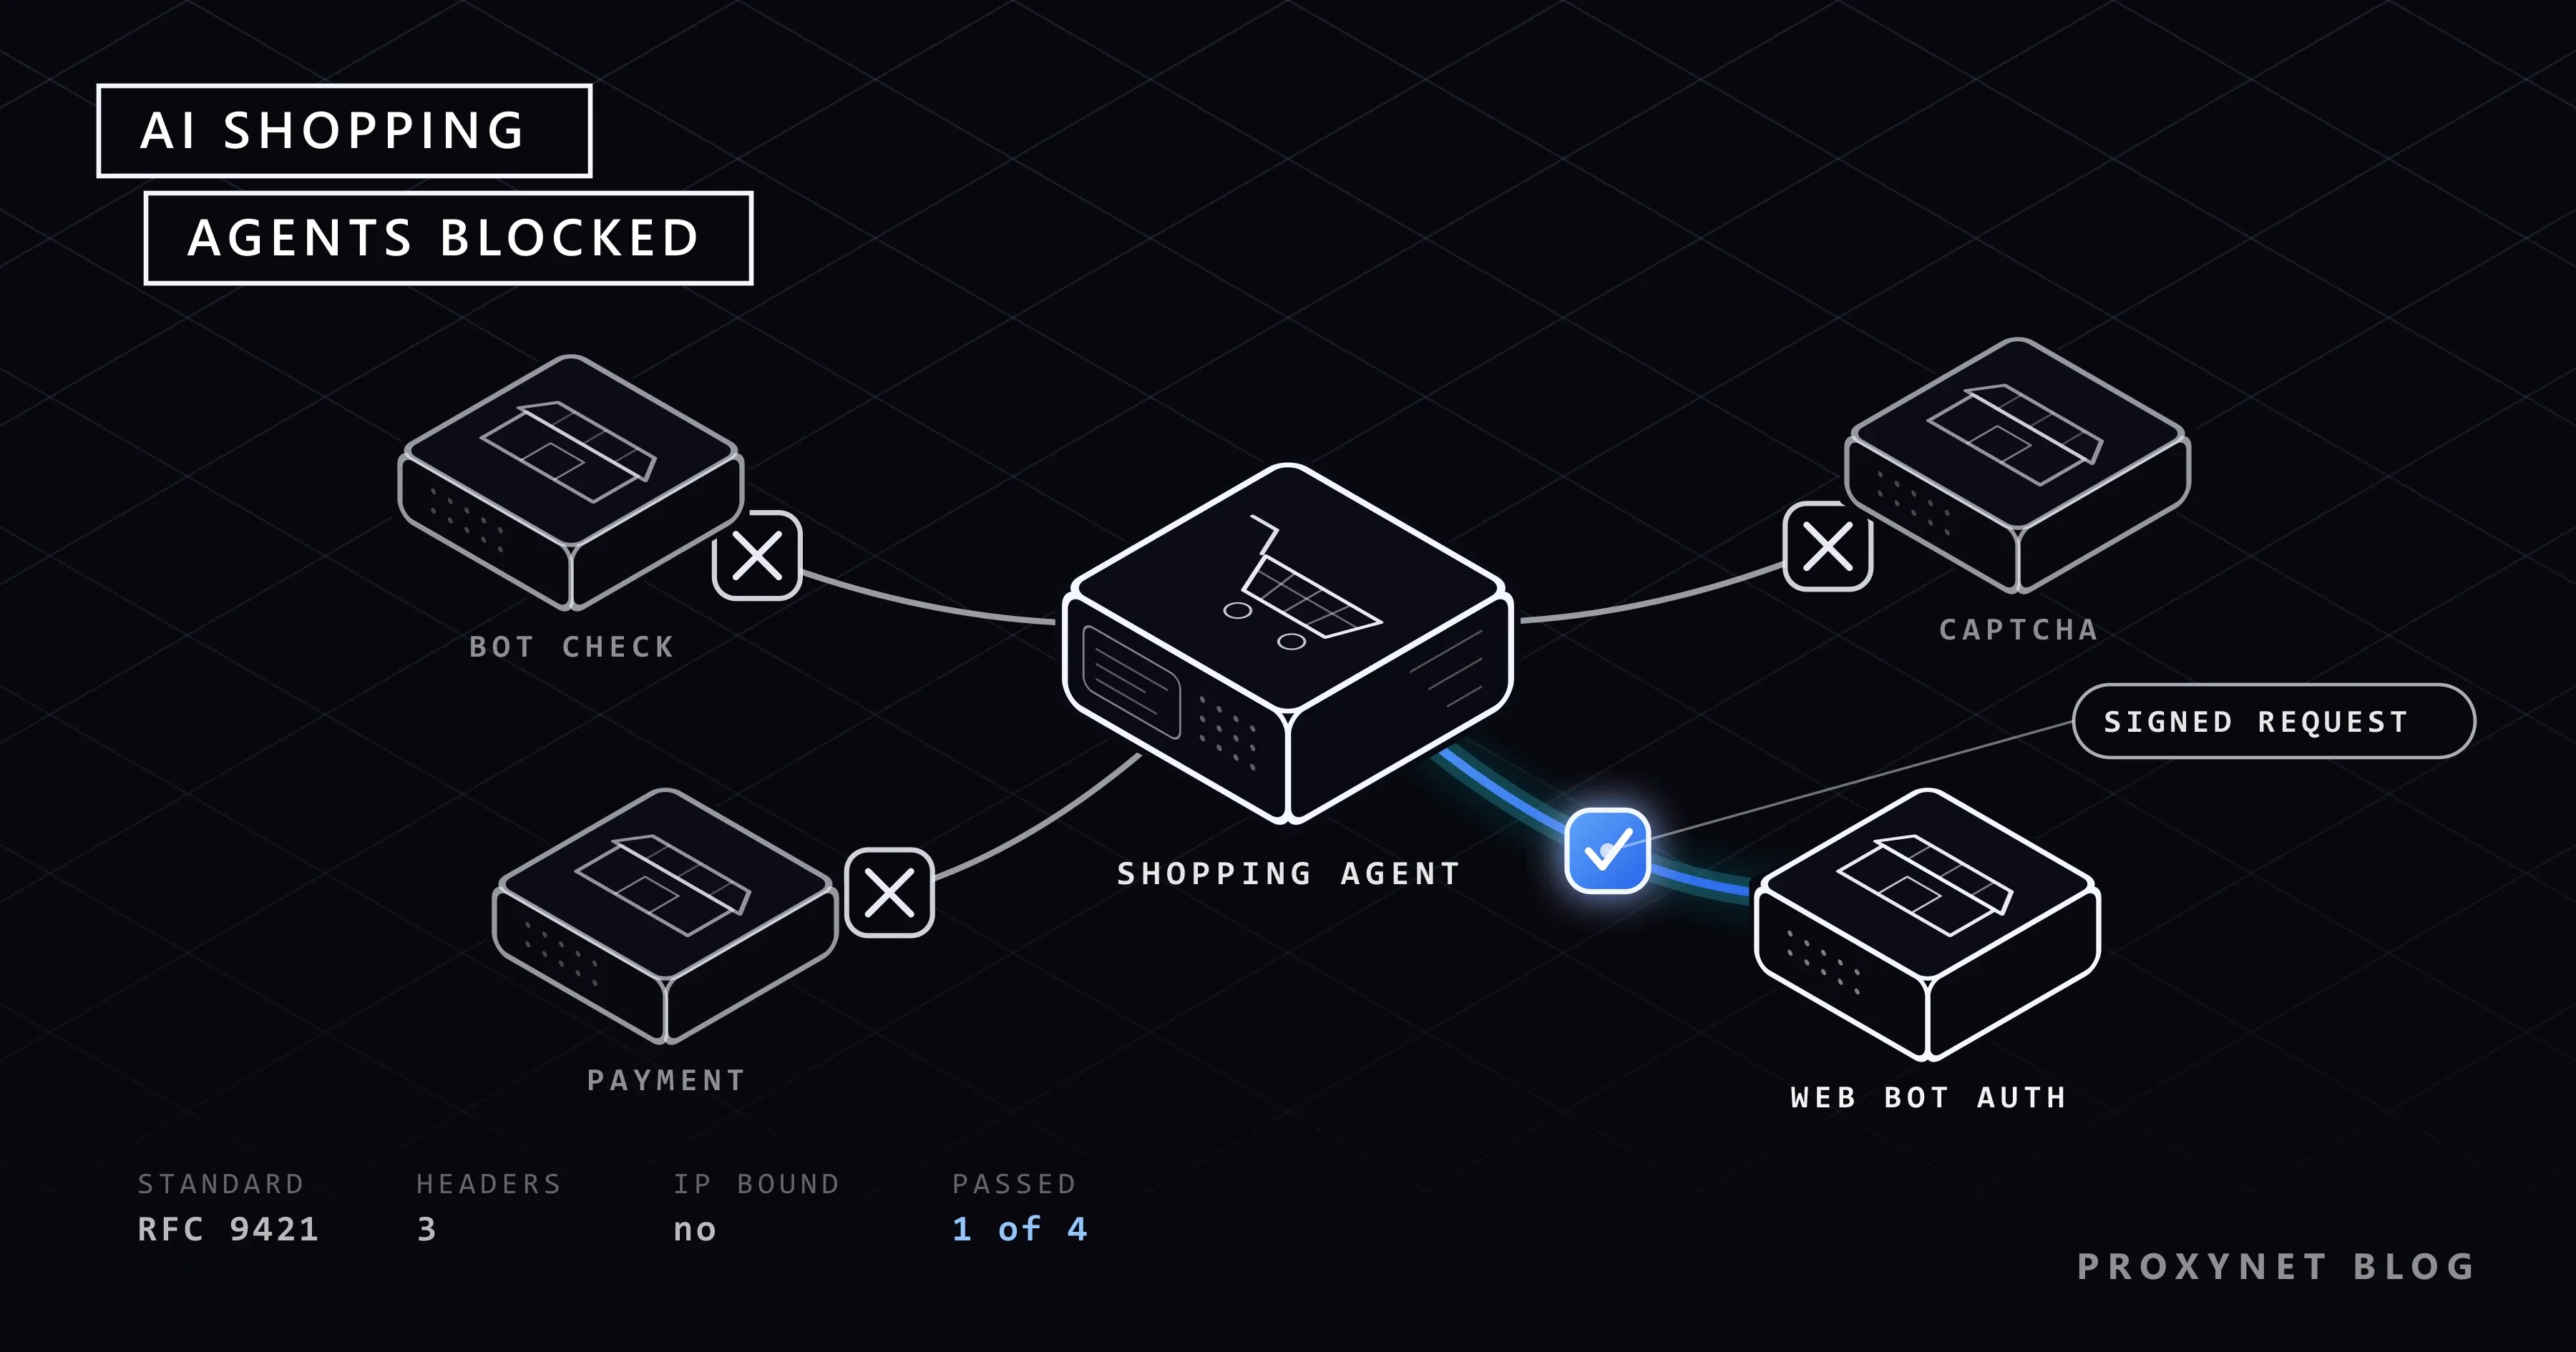
¿Por qué los sitios bloquean a los agentes de compra con IA?
Los agentes de compra con IA chocan con la protección de bots porque el sitio no distingue un agente autorizado. Explicamos por qué y las nuevas soluciones.
Autor: Acar Diveroli
Publicado
Concurrencia y paralelismo en web scraping
La concurrencia aprovecha el tiempo de espera y el paralelismo, la potencia de CPU. Explicamos cuál acelera el scraping, con ejemplos en Python y Node.js.
Autor:Acar Diveroli
Publicado
Selector CSS o XPath: ¿cuál usar en web scraping?
Los selectores CSS son cortos y legibles; XPath también selecciona por texto y por elemento padre. Comparamos sintaxis, velocidad y ejemplos en Python.
Autor:Acar Diveroli
Publicado
Web scraping con GPT-6 Astra: qué ha cambiado
GPT-6 Astra mejora la lectura de páginas y el control del navegador, pero no resuelve bloqueos, CAPTCHA ni límites de solicitud en el scraping.
Autor:Acar Diveroli
Publicado
Qué son las trampas honeypot y cómo afectan al scraping
Los honeypots son enlaces ocultos que los visitantes no ven pero en los que caen los bots. Explicamos cómo funcionan, sin enseñar a esquivarlos.
Autor:Acar Diveroli
Publicado
Códigos de estado HTTP en web scraping: 403, 407, 429, 503
Las respuestas 403, 407, 429 y 503 indican problemas distintos en el scraping. Explicamos cada código, sus causas y cómo reintentar con Retry-After.
Autor:Acar Diveroli
Publicado
HTTPX, Requests y AIOHTTP: comparativa
Requests es simple y síncrono, AIOHTTP es asíncrono y HTTPX ofrece los dos modos. Uso de proxy, rendimiento y cuál elegir en cada proyecto, con código.
Autor:Acar Diveroli
Publicado
Puppeteer y CAPTCHA: por qué aparece y cómo reducirlo
En Puppeteer el CAPTCHA suele activarse por la reputación de la IP, la velocidad y las huellas del modo headless. Causas y soluciones legítimas.
Autor:Acar Diveroli
Publicado
Qué es robots.txt y cómo leerlo
robots.txt es el archivo donde un sitio indica a los bots qué rutas no rastrear. Explicamos Disallow, Allow, Crawl-delay y cómo leerlo con Python.
Autor:Acar Diveroli
Publicado
Cómo automatizar el seguimiento de posiciones SEO
Revisar posiciones a mano no escala. Explicamos el seguimiento automático de rankings con la API de Search Console, datos SERP y consultas por ubicación.
Autor:Acar Diveroli
Publicado
Páginas estáticas y dinámicas en web scraping
Las páginas dinámicas cargan el contenido con JavaScript, así que una petición simple vuelve vacía. Explicamos cuándo hace falta un navegador headless.
Autor:Acar Diveroli
Publicado
Web scraping: ¿JavaScript o Python?
Python destaca por sus librerías de análisis de datos; JavaScript, por páginas dinámicas y automatización de navegador. Comparamos cuál conviene a tu proyecto.
Autor:Acar Diveroli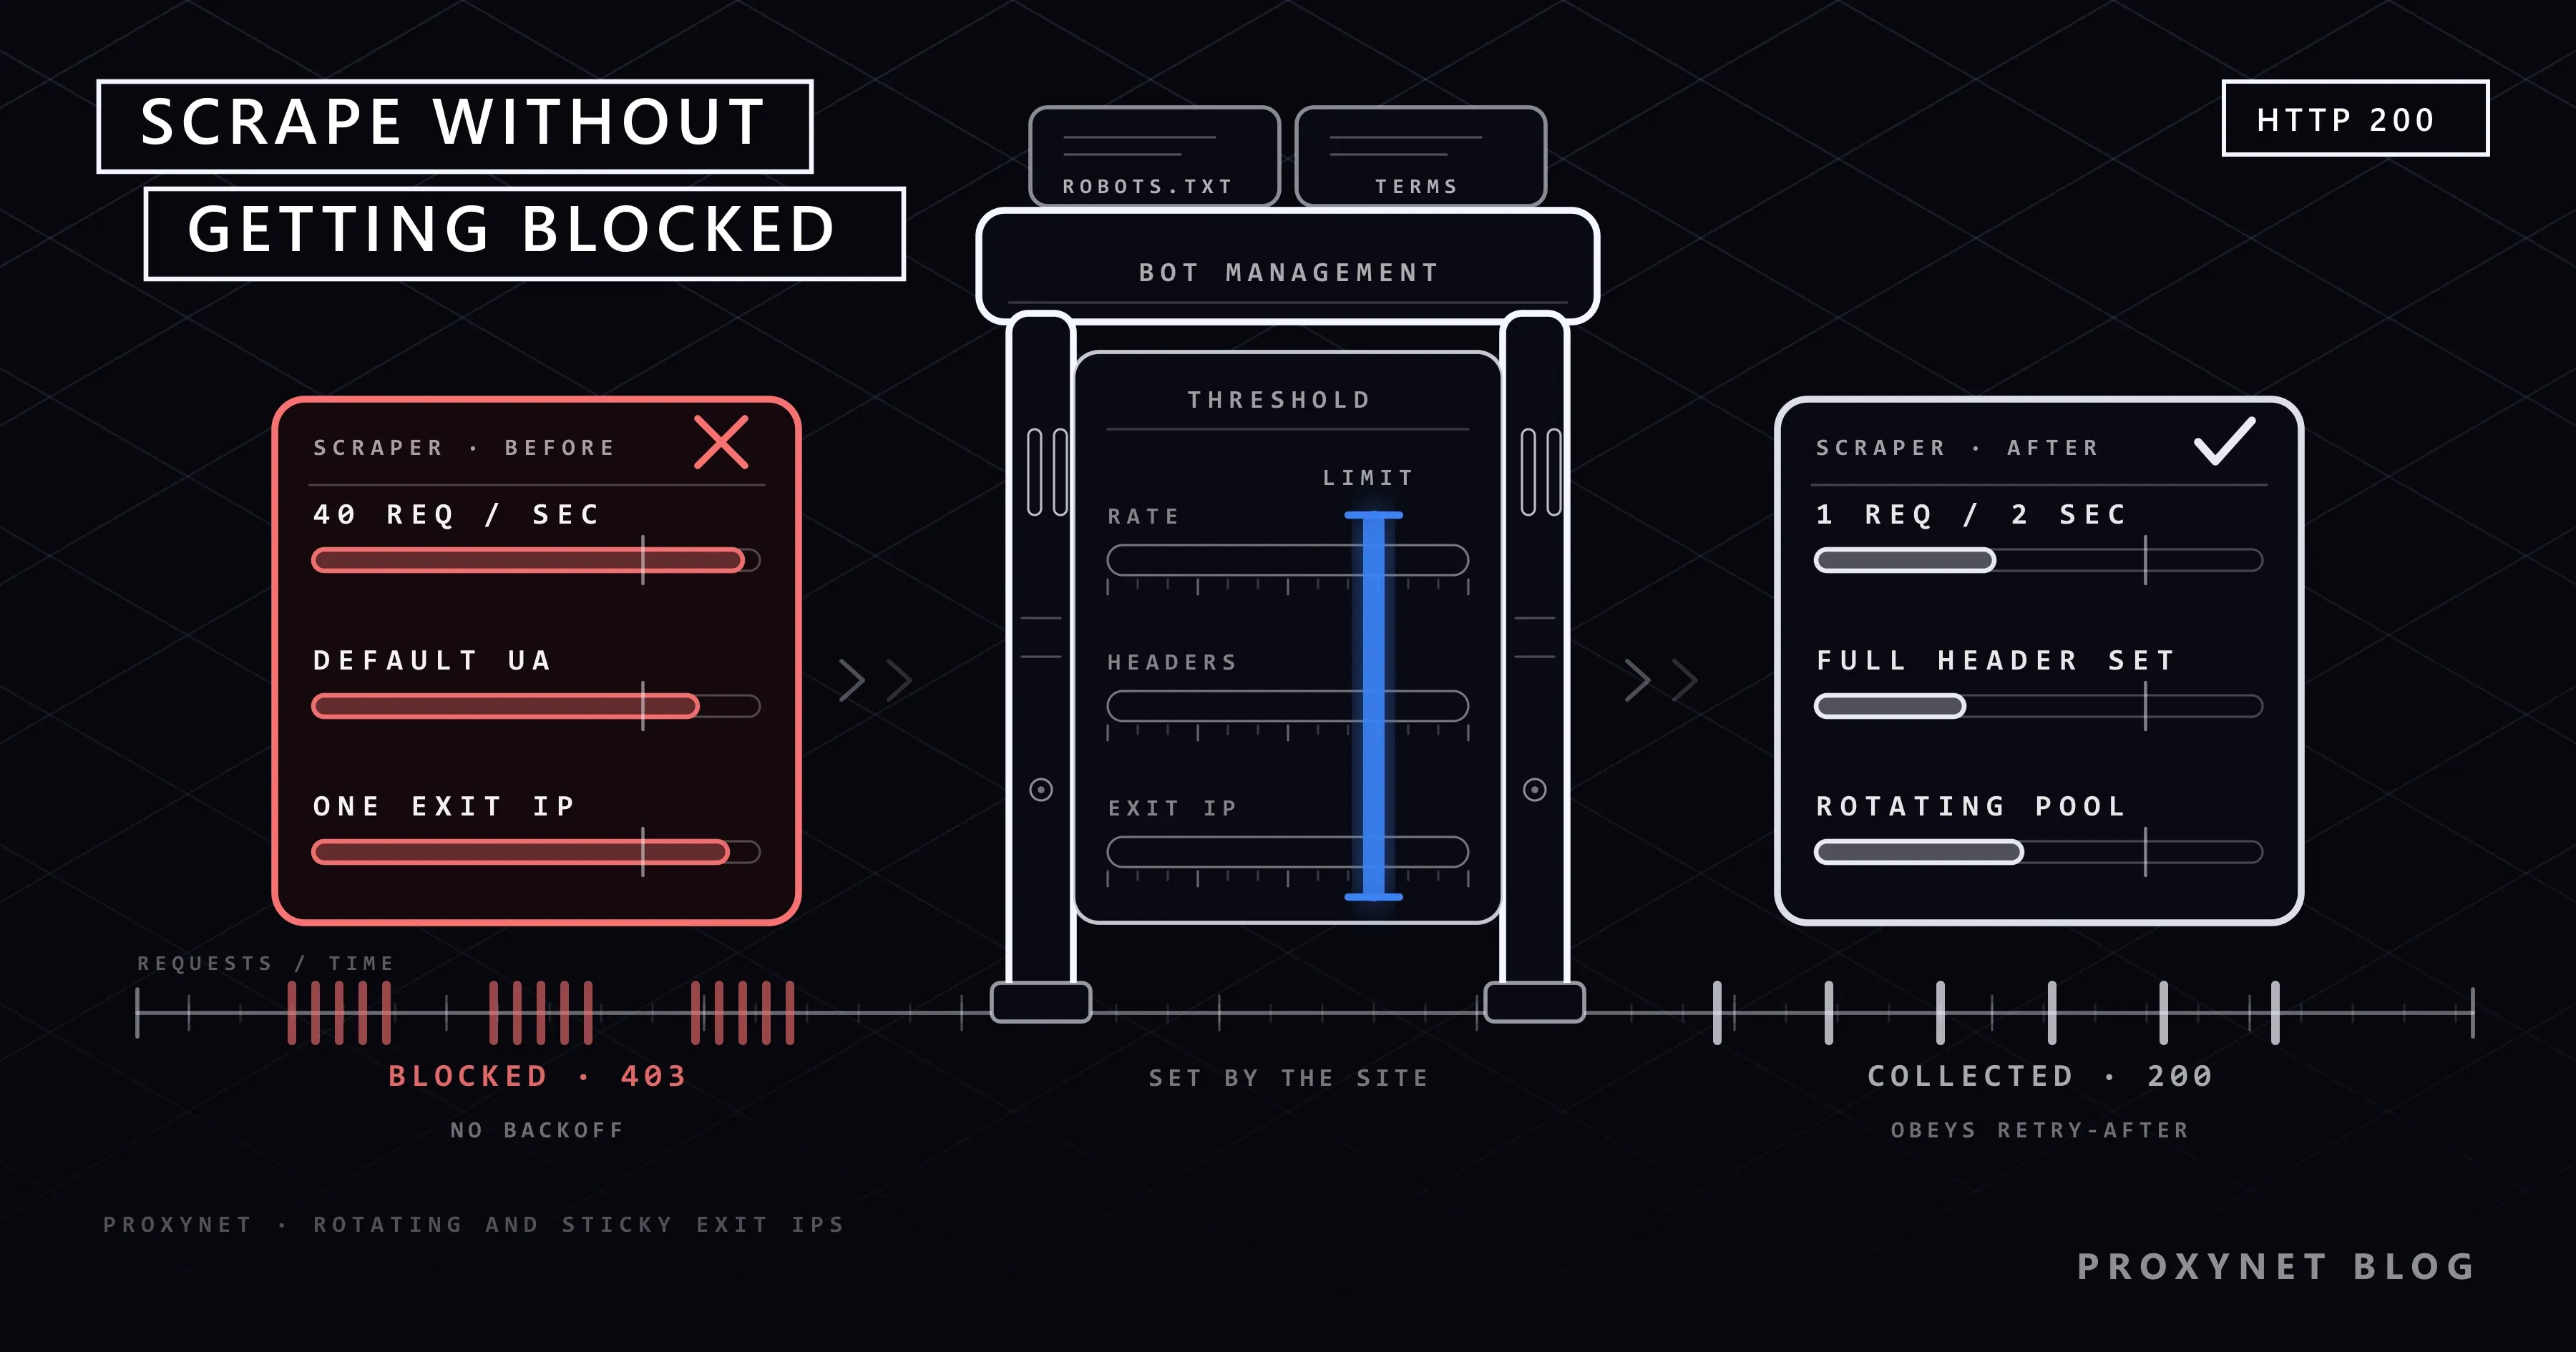
Publicado
Cómo hacer web scraping sin que te bloqueen
Los scrapers se bloquean sobre todo por límites de velocidad, cabeceras y una sola IP. Explicamos cómo recoger datos según las reglas sin saturar el sitio.
Autor:Acar Diveroli
¿Por qué los sitios bloquean a los agentes de compra con IA?
Autor: Acar DiveroliIAPublicado
Concurrencia y paralelismo en web scraping
Autor: Acar DiveroliComparativasPublicado
Selector CSS o XPath: ¿cuál usar en web scraping?
Autor: Acar DiveroliComparativasPublicado
Web scraping con GPT-6 Astra: qué ha cambiado
Autor: Acar DiveroliIAPublicado
Qué son las trampas honeypot y cómo afectan al scraping
Autor: Acar DiveroliWeb scrapingPublicado
Códigos de estado HTTP en web scraping: 403, 407, 429, 503
Autor: Acar DiveroliWeb scrapingPublicado
HTTPX, Requests y AIOHTTP: comparativa
Autor: Acar DiveroliComparativasPublicado
Puppeteer y CAPTCHA: por qué aparece y cómo reducirlo
Autor: Acar DiveroliTutorialesPublicado
Qué es robots.txt y cómo leerlo
Autor: Acar DiveroliWeb scrapingPublicado
Cómo automatizar el seguimiento de posiciones SEO
Autor: Acar DiveroliCasos de usoPublicado
Páginas estáticas y dinámicas en web scraping
Autor: Acar DiveroliComparativasPublicado
Web scraping: ¿JavaScript o Python?
Autor: Acar DiveroliComparativasPublicado
Cómo hacer web scraping sin que te bloqueen
Autor: Acar DiveroliWeb scrapingPublicado
Ningún artículo coincide
Publicado
Publicado