Tu comprobación de precios funciona en tu equipo. La pasas a un servidor, la envías a través de un proxy y, al cabo de medio minuto, el log muestra TimeoutError: page.goto: Timeout 30000ms exceeded. En la siguiente ejecución la página se abre y el script se detiene una línea después con locator.click: Timeout 30000ms exceeded. Cambias el número a 60000 y ahora el script falla tras un minuto entero, porque el número nunca fue el problema.
Esta guía repasa los cuatro tipos de tiempo de espera, el call log, waitUntil, dónde fijar los límites, los proxies lentos y las páginas de bloqueo que acaban como «elemento no encontrado», y después un script de reintentos probado en Python y Node.js y su equivalente en Puppeteer. Todos los mensajes que verás salen de nuestras ejecuciones con Playwright 1.63 y Puppeteer 25.12 contra un sitio de prueba local y un proxy de prueba.
¿Qué significa «Timeout 30000ms exceeded» en Playwright?
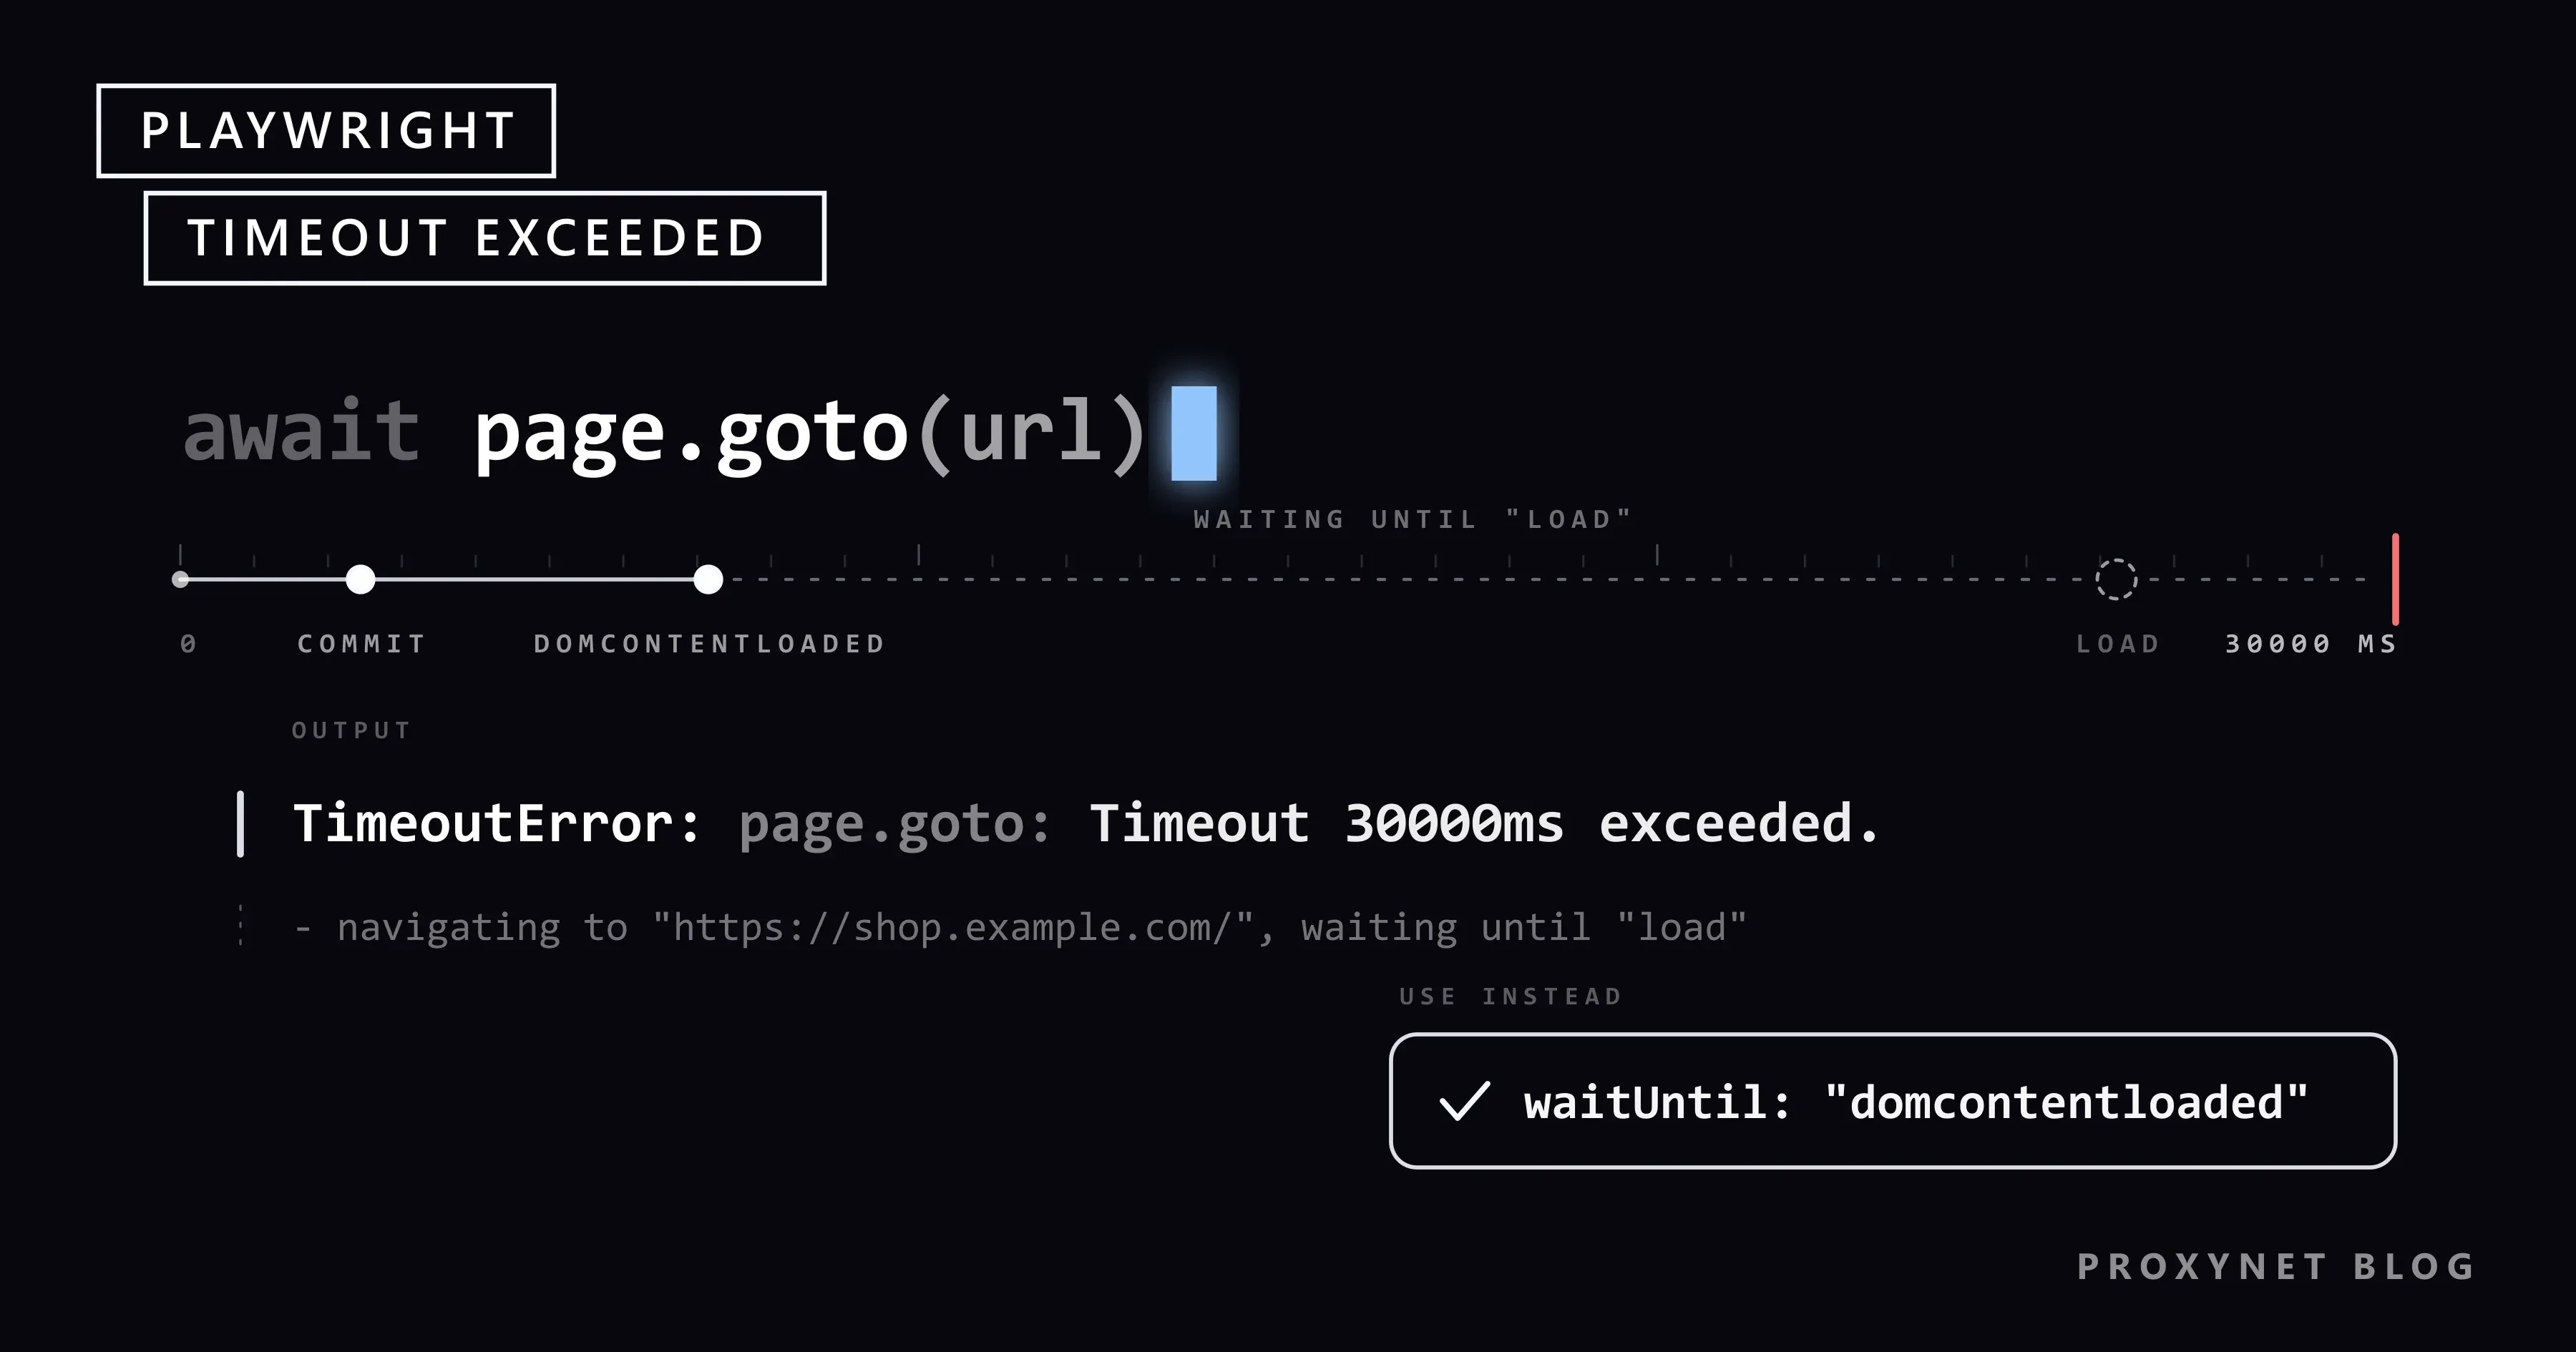
Playwright espera por sí solo: page.goto() hasta que la página alcanza un estado de carga, y cada acción de un locator hasta que el elemento existe y puede recibir la acción. Cuando una espera llega a su límite, Playwright lanza un TimeoutError. En la biblioteca ese límite es de 30.000 ms, es decir, 30 segundos; nuestras ejecuciones en Python y en Node.js se detuvieron exactamente a los 30,0 segundos.
El mensaje nombra el método que esperaba, el límite y, en un call log, lo que Playwright estaba haciendo. Este salió de una página de prueba cuyo servidor nunca respondió:
TimeoutError: page.goto: Timeout 30000ms exceeded.
Call log:
  - navigating to "http://127.0.0.1:8090/slow", waiting until "load"
Python escribe Page.goto y Locator.click con mayúscula; Node.js, page.goto y locator.click. En Python, importa la clase con otro nombre, porque TimeoutError de playwright.sync_api ocultaría el TimeoutError integrado de Python. En Node.js es errors.TimeoutError del paquete playwright.
¿Qué tiempo de espera se agotó? Los cuatro tipos
La biblioteca, que es lo que usan los scrapers, da 30 segundos a cada navegación y a cada acción. El ejecutor de pruebas Playwright Test no les da un límite propio y, en cambio, da 30 segundos a la prueba completa, como recoge la documentación de Playwright sobre tiempos de espera; por eso la referencia de la API de JavaScript indica 0 como valor por defecto de goto.
| El mensaje empieza por | Tipo | Valor por defecto | Se cambia con |
|---|---|---|---|
page.goto: Timeout … | Navegación | 30 s (biblioteca), ninguno (Test) | timeout en la llamada, set_default_navigation_timeout(), navigationTimeout |
locator.click: Timeout … | Acción o locator | 30 s (biblioteca), ninguno (Test) | timeout en la llamada, set_default_timeout(), actionTimeout |
expect(locator)… failed con Timeout: 5000ms | Aserción | 5 s | expect: { timeout }, en Python expect.set_options(timeout=…) |
Test timeout of 30000ms exceeded. | Prueba completa (Playwright Test) | 30 s | timeout en la configuración, test.setTimeout(), test.slow() |
Dos detalles de nuestras ejecuciones. En Python, un expect() fallido lanza un AssertionError normal, que except PlaywrightTimeoutError no captura. Y cuando el tiempo de espera de la prueba se agota durante page.goto, Playwright Test añade page.goto: net::ERR_ABORTED; maybe frame was detached? debajo de la línea del tiempo de espera. No es un error de red: el ejecutor cerró la página mientras la llamada seguía esperando.
¿Cómo se lee el call log?
El call log, el registro de llamadas que aparece bajo la línea del error, es la parte más útil del mensaje. Aquí tienes un clic en un botón tapado por un aviso de cookies, abreviado de nuestra ejecución:
Locator.click: Timeout 5000ms exceeded.
Call log:
  - waiting for locator("#buy")
    - locator resolved to <button id="buy">Add to cart</button>
  - attempting click action
    2 × waiting for element to be visible, enabled and stable
      - element is visible, enabled and stable
      - scrolling into view if needed
      - done scrolling
      - <div id="cookie-banner">We use cookies</div> intercepts pointer events
    - retrying click action
Léelo en cuatro pasos:
- El método de la primera línea nombra la espera:
goto,click,fill,textContent. - El último paso del log dice dónde se detuvo.
waiting for locator("#price")sin nada debajo significa que nada coincidió;locator resolved to …significa que el elemento se encontró, pero la acción no pudo ejecutarse. - La línea del motivo, si la hay:
intercepts pointer events(algo está encima),element is not visible,element is not enabled. - El tiempo transcurrido. Un fallo justo en tu límite es una espera real. Un error anterior, como
net::ERR_PROXY_CONNECTION_FAILED, es otro problema, que tratamos en Qué es Playwright y cómo usarlo con un proxy.
Tiempos de espera de navegación: page.goto y waitUntil
page.goto() espera a un evento del ciclo de vida, que eliges con waitUntil (wait_until en Python):
commit: la respuesta ha llegado y el documento ha empezado a cargarse.domcontentloaded: el HTML ya está analizado; las imágenes, las fuentes y los iframes pueden seguir cargándose.load(el valor por defecto): la página y los recursos que trae, imágenes y hojas de estilo incluidas, han terminado de cargarse.networkidle: ninguna conexión de red durante al menos 500 ms. La referencia de page.goto lo marca como desaconsejado (discouraged) y recomienda apoyarse en aserciones.
El load por defecto provoca muchos tiempos de espera agotados en la navegación: una imagen lenta, un píxel de seguimiento o un widget impiden que el evento se dispare aunque el texto que buscas ya esté en la página. En nuestra página de prueba el precio estaba en el HTML y una imagen nunca terminaba de cargar. Con load, goto agotó el tiempo de espera a los 10 segundos; con domcontentloaded, volvió en 0,1 segundos con el precio legible. networkidle falló en una página que llama a un endpoint cada 300 ms, como hacen los widgets de chat y los precios en directo.
El patrón que funciona: navega con domcontentloaded y después espera al elemento concreto que necesitas.
response = page.goto(url, wait_until="domcontentloaded")
price = page.locator("#price").inner_text() # espera al elemento, como máximo el tiempo de espera de las accionesconst response = await page.goto(url, { waitUntil: "domcontentloaded" });
const price = await page.locator("#price").innerText();Si goto sigue agotando el tiempo de espera con domcontentloaded, es que el propio HTML llegó demasiado tarde, y eso es una cuestión de red (mira la sección sobre proxies). Si los datos están en el HTML o en un endpoint JSON, puede que ni siquiera necesites un navegador; Páginas estáticas y dinámicas en web scraping explica cómo comprobarlo.
Tiempos de espera de locators y acciones: la espera automática y lo que la bloquea
Antes de un clic, Playwright comprueba que el elemento sea visible, esté estable (que no se mueva), esté habilitado y reciba de verdad el clic en ese punto, y repite las comprobaciones hasta que se agota el límite. Un tiempo de espera agotado en un locator se reduce a una lista corta de causas:
- El selector no coincide con nada. Una errata, un nombre de clase que cambia en cada build o un texto que varía según el idioma. Los atributos estables (
id,data-*) oget_by_role()duran más. - El elemento aparece demasiado tarde. Un precio que se renderiza 12 segundos después de la carga falla siempre con un límite de 10 segundos.
- Algo lo tapa. Los avisos de cookies y las ventanas modales aparecen como
intercepts pointer events. Cierra la capa superpuesta como lo haría un visitante;force=Truese salta la comprobación y el clic cae donde ningún usuario podría hacer clic. - Está dentro de un iframe.
page.locator("#price")no mira dentro de los frames; en nuestra prueba agotó el tiempo de espera, mientras quepage.frame_locator("iframe").locator("#price")devolvió el precio al instante. - Estás en una página distinta de la que crees. Una página de bloqueo o un muro de inicio de sesión no tiene
#price(lo vemos más abajo).
page.wait_for_selector() sigue funcionando, pero la referencia de la API de Playwright lo marca como desaconsejado y prefiere los locators, que vuelven a buscar el elemento en cada intento y por eso sobreviven a un nuevo renderizado. En qué se diferencia esto de las esperas explícitas de Selenium lo explicamos en Playwright o Selenium: ¿cuál elegir en tu proyecto?.
Fijar los tiempos de espera a propósito: por llamada, por contexto, en la configuración
Un timeout pasado a una llamada concreta se impone a todo lo demás. Por debajo, los valores por defecto de la página se imponen a los del contexto, y un valor por defecto de navegación se impone al general. En Python, fija los valores por defecto en el contexto para que todas sus páginas los hereden:
context = browser.new_context()
context.set_default_navigation_timeout(15_000)  # goto, reload, wait_for_url
context.set_default_timeout(10_000)             # locators, clics, esperas
page = context.new_page()
page.goto(slow_report_url, timeout=45_000)      # una página que ya sabemos lenta recibe más
En Playwright Test los límites van en la configuración. Con esta configuración, en nuestra ejecución un elemento inexistente falló con locator.click: Timeout 10000ms exceeded. y una página que nunca respondió, con page.goto: Timeout 15000ms exceeded.:
import { defineConfig } from "@playwright/test";

export default defineConfig({
  timeout: 60_000,              // la prueba completa, incluidos hooks y fixtures
  expect: { timeout: 10_000 },  // cada aserción expect(...)
  use: {
    actionTimeout: 10_000,      // click, fill, textContent ...
    navigationTimeout: 15_000,  // goto, reload, waitForURL ...
  },
});
test.slow() triplica el límite de una prueba lenta. Evita timeout=0 en producción: una página que nunca responde retiene entonces un contexto para siempre. Poner límites de dos minutos en todas partes no es mucho mejor; una cola con cien URL muertas tarda entonces más de tres horas.
Proxies lentos: primero mide, después fija el tiempo de espera
Un proxy añade un salto a cada petición, y un navegador hace muchas peticiones por página. Las IP residenciales van por conexiones domésticas y suelen sumar más latencia que las de centro de datos, así que un límite que nunca salta en la línea de tu oficina puede saltar a través de una IP de salida lejana. Mide antes de elegir un número. Este script abre la misma página cinco veces en contextos nuevos, con el límite desactivado solo durante la medición:
import statistics
import time

from playwright.sync_api import sync_playwright

PROXY = {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"}
URL = "https://shop.example.com/product/42"

with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    times = []
    for _ in range(5):
        context = browser.new_context()  # sesión nueva, sin caché entre ejecuciones
        page = context.new_page()
        start = time.monotonic()
        page.goto(URL, wait_until="domcontentloaded", timeout=0)  # sin límite mientras medimos
        page.locator("#price").wait_for(timeout=0)
        times.append(time.monotonic() - start)
        context.close()
    browser.close()

print("runs:", " ".join(f"{t:.2f}s" for t in times))
print(f"median {statistics.median(times):.2f}s, slowest {max(times):.2f}s")
A través de nuestro proxy local de prueba, que añade 2 segundos a cada petición, imprimió:
runs: 3.42s 3.38s 3.37s 3.38s 3.38s
median 3.38s, slowest 3.42s
Basa el límite en la ejecución más lenta, con margen por encima; nosotros elegimos 15 segundos. Con un destino real toma más muestras y vuelve a medir cuando cambien el país, el tipo de proxy o el sitio. Tres puntos más:
- Carga menos. Bloquear imágenes, medios y fuentes con
page.route()reduce las peticiones por página; el código está en nuestra guía de Playwright con proxy. - Elige la salida según el trabajo. Las IP de salida de los Proxies de centro de datos son más rápidas cuando el destino acepta IP de centro de datos. Si un sitio necesita IP domésticas o una ciudad concreta, usa los Proxies residenciales, con su propio límite medido.
- Revisa las credenciales. Con una contraseña de proxy incorrecta en un sitio HTTPS, nuestro listener de
requestfailedimprimiónet::ERR_TUNNEL_CONNECTION_FAILEDal instante, peropage.gotono falló hasta que se agotó su límite de 10 segundos. Un problema de credenciales puede parecer un proxy lento, así que añade este listener mientras depuras:
page.on("requestfailed", lambda r: print("FAILED:", r.url, r.failure))Fuera del navegador, Requests de Python informa de los fallos del proxy como «Max retries exceeded»; Max Retries Exceeded With URL: qué es y cómo solucionarlo explica cómo leer ese mensaje.
Cuando una página de bloqueo se convierte en «elemento no encontrado»
Este caso es el que más tiempo hace perder. El sitio rechaza la petición y sirve una página de bloqueo con estado 403 o 429. page.goto() no lanza ninguna excepción por los estados de error HTTP; nuestro goto volvió con normalidad con un 403. Después, el script espera el límite completo a un elemento que la página de bloqueo nunca va a contener. El log habla de tiempo de espera; la respuesta real era un rechazo.
Nuestra página de bloqueo de prueba tenía el título «Access denied», y el error de expect() en Python llegó a imprimir su instantánea de accesibilidad con heading "Access denied" dentro. Mira antes de esperar:
- Guarda la respuesta que devuelve
gotoy lee su estado. - Lee
page.title(); las páginas de bloqueo y de verificación tienen sus propios títulos. - Si cualquiera de los dos indica un bloqueo, detente: ni reintento ni espera del elemento.
- Averigua el motivo: tu ritmo de peticiones, el
robots.txty las condiciones del sitio, o si ofrece una API.
Reintentar una página de bloqueo lo empeora, y cambiar de IP para saltarse un rechazo no es una solución: el sitio ha dicho que no. Un 429 significa demasiadas peticiones; baja el ritmo y respeta Retry-After (429 Too Many Requests: qué es el error de rate limit). Por qué los sitios marcan a los visitantes automatizados lo contamos en Cómo funciona la detección de bots: la lógica anti-bot. No tratamos formas de esquivar estas páginas; lo que funciona a largo plazo es un rastreo más lento, un permiso o la API oficial (Web scraping vs. API: ¿cuál deberías usar?).
Ejemplo completo: tiempos de espera medidos, comprobación de bloqueo y reintentos
El script abre páginas de producto a través de un proxy. Cada intento recibe un contexto nuevo con límites elegidos a propósito. Comprueba el estado y el título antes de esperar el contenido, se detiene ante una página de bloqueo y solo reintenta los tiempos de espera agotados, con una espera que crece de forma exponencial (exponential backoff) más un componente aleatorio (jitter), para que los workers en paralelo no reintenten al mismo compás.
"""Abre páginas de producto a través de un proxy con tiempos de espera medidos, comprobación de bloqueo y reintentos."""
import random
import time

from playwright.sync_api import TimeoutError as PlaywrightTimeoutError
from playwright.sync_api import sync_playwright

PROXY = {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"}
URLS = [f"https://shop.example.com/product/{n}" for n in (42, 43, 44)]

NAV_TIMEOUT = 15_000     # ms: unas 4 veces la página más lenta que medimos a través del proxy
ACTION_TIMEOUT = 10_000  # ms: locators, clics y esperas
ATTEMPTS = 3
STOP_STATUS = {403, 429}  # un rechazo o un límite de solicitudes: reintentar lo empeora
STOP_WORDS = ("access denied", "blocked", "captcha", "verify you are human")  # ajústalo para cada sitio


class Blocked(Exception):
    """El sitio respondió con una página de bloqueo o de límite de solicitudes: detente y averigua por qué."""


def fetch_price(browser, url):
    for attempt in range(1, ATTEMPTS + 1):
        context = browser.new_context()  # cookies y caché limpias en cada intento
        context.set_default_navigation_timeout(NAV_TIMEOUT)
        context.set_default_timeout(ACTION_TIMEOUT)
        page = context.new_page()
        start = time.monotonic()
        try:
            response = page.goto(url, wait_until="domcontentloaded")
            status = response.status if response else None
            title = page.title()
            if status in STOP_STATUS or any(word in title.lower() for word in STOP_WORDS):
                raise Blocked(f"HTTP {status}, title {title!r}")
            return page.locator("#price").inner_text()  # espera automáticamente hasta ACTION_TIMEOUT
        except PlaywrightTimeoutError as exc:
            print(f"  attempt {attempt}: {str(exc).splitlines()[0]} ({time.monotonic() - start:.1f}s)")
            if attempt == ATTEMPTS:
                raise
            time.sleep(2**attempt + random.random())  # 2-3 s, luego 4-5 s
        finally:
            context.close()


with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    for url in URLS:
        print(url)
        try:
            print("  price:", fetch_price(browser, url))
        except Blocked as exc:
            print("  stopped, not retrying:", exc)
        except PlaywrightTimeoutError:
            print(f"  gave up after {ATTEMPTS} attempts")
    browser.close()
Lo ejecutamos con el host cambiado por nuestro sitio de prueba local (shop.test), a través del proxy que añade 2 segundos por petición; la tercera página estaba configurada para quedarse colgada en sus dos primeras peticiones:
http://shop.test/product/42
  price: $19.90
http://shop.test/product/43
  stopped, not retrying: HTTP 403, title 'Access denied'
http://shop.test/product/44
  attempt 1: Page.goto: Timeout 15000ms exceeded. (15.0s)
  attempt 2: Page.goto: Timeout 15000ms exceeded. (15.0s)
  price: $19.90
La página de bloqueo costó una petición y ninguna espera; la página colgada costó dos tiempos de espera agotados y después funcionó. Los reintentos guiados por códigos de estado, como un 503 con Retry-After, van en una capa aparte; Códigos de estado HTTP en web scraping: 403, 407, 429, 503 tiene ese código. El mismo núcleo en Node.js:
import { chromium, errors } from "playwright";

const PROXY = { server: "http://pr.proxynet.io:8000", username: "user", password: "pass" };
const URLS = ["https://shop.example.com/product/42", "https://shop.example.com/product/45"];

const browser = await chromium.launch({ proxy: PROXY });
for (const url of URLS) {
  const context = await browser.newContext();
  context.setDefaultNavigationTimeout(15_000); // goto, reload, waitForURL
  context.setDefaultTimeout(10_000);           // locators, clics, esperas
  const page = await context.newPage();
  try {
    const response = await page.goto(url, { waitUntil: "domcontentloaded" });
    console.log(url, "status", response?.status(), "title", await page.title());
    console.log("  price:", await page.locator("#price").innerText());
  } catch (err) {
    if (!(err instanceof errors.TimeoutError)) throw err;
    console.log("  timeout:", err.message.split("\n")[0]);
  } finally {
    await context.close();
  }
}
await browser.close();
En nuestro sitio de prueba, la segunda página renderiza su precio a los 12 segundos:
http://shop.test/product/42 status 200 title Product
  price: $19.90
http://shop.test/product/45 status 200 title Product
  timeout: locator.innerText: Timeout 10000ms exceeded.
Puppeteer: «Navigation timeout of 30000 ms exceeded»
Puppeteer usa el mismo modelo con otros nombres. Su valor por defecto también es de 30 segundos, page.setDefaultNavigationTimeout() y page.setDefaultTimeout() lo cambian, y waitUntil acepta load, domcontentloaded, networkidle0 y networkidle2. La referencia de eventos del ciclo de vida de Puppeteer define los dos últimos como un máximo de 0 o 2 conexiones abiertas durante 500 ms, así que fallan en páginas con mucha actividad igual que networkidle.
import puppeteer, { TimeoutError } from "puppeteer";

const browser = await puppeteer.launch({ args: ["--proxy-server=http://pr.proxynet.io:8000"] });
const page = await browser.newPage();
await page.authenticate({ username: "user", password: "pass" });
page.setDefaultNavigationTimeout(15_000); // goto, reload, waitForNavigation
page.setDefaultTimeout(10_000);           // waitForSelector y otras esperas

try {
  const response = await page.goto("https://shop.example.com/product/45", { waitUntil: "domcontentloaded" });
  console.log("status", response?.status(), "title", await page.title());
  await page.waitForSelector("#price");
} catch (err) {
  if (!(err instanceof TimeoutError)) throw err;
  console.log(`${err.name}: ${err.message} (${err.cause?.message})`);
} finally {
  await browser.close();
}
Nuestras ejecuciones con Puppeteer 25.12 imprimieron estos mensajes; el primero viene de una página que nunca respondió, con el límite por defecto:
TimeoutError: Navigation timeout of 30000 ms exceeded
TimeoutError: Waiting for selector `#price` failed (Waiting failed: 10000ms exceeded)
El mensaje del selector omite el límite; está en err.cause. El proxy se pasa como flag de Chromium y las credenciales con page.authenticate(), que activa la interceptación de peticiones en segundo plano. Las causas y soluciones anteriores valen sin cambios.
Dónde aparece este error
- Scraping de tiendas que se renderizan con JavaScript: los precios cargan después del HTML, así que espera al elemento (extracción de datos).
- Rastreo de una cola larga: una página atascada debe costar un tiempo de espera, no la ejecución entera (rastreador web).
- Probar tu propia aplicación desde otros países: cada IP de salida tiene su propia latencia, así que fija los límites por país (pruebas de aplicaciones).
- Agentes de IA que manejan un navegador: un agente que llama a
gotochoca con los mismos límites (Playwright MCP). - Rastreos programados: lee las reglas de rastreo del sitio antes de ajustar la velocidad (Qué es robots.txt y cómo leerlo).
Errores comunes
- Subir el valor por defecto a 60 o 120 segundos. Una espera que no puede salir bien solo falla más tarde.
- Tratar
networkidlecomo «listo». Las páginas con mucha actividad nunca se quedan quietas. - Pausas fijas antes de cada paso.
time.sleep()ywaitForTimeout()se quedan largas en las páginas rápidas y cortas en las lentas. - Capturar solo
TimeoutErroralrededor deexpect()en Python. LanzaAssertionError. - Saltarse el estado y el título. Una página de bloqueo se convierte entonces en un «elemento no encontrado» de 30 segundos.
- Reintentar peticiones bloqueadas. Los reintentos son para tiempos de espera agotados y cortes de red, no para
403y429. - Silenciar las capas superpuestas con
force=True. El clic cae donde un usuario no podría hacer clic.
Guía de decisión
| Lo que ves | Qué hacer |
|---|---|
page.goto: Timeout con waiting until "load" | domcontentloaded y después espera al elemento |
page.goto: Timeout con waiting until "networkidle" | Quita networkidle; espera a un elemento |
page.goto: Timeout con domcontentloaded | Mide el tiempo de carga a través del proxy y fija el límite a partir de él |
waiting for locator(...) sin nada debajo | Revisa el selector, los frames y en qué página estás |
intercepts pointer events | Cierra la capa superpuesta como lo haría un usuario |
Estado 403 o 429, o un título de bloqueo | Detente; baja el ritmo, revisa robots.txt, pide permiso o usa una API |
Test timeout of 30000ms exceeded. | Busca el paso que se colgó; sube el límite solo en las pruebas lentas |
requestfailed muestra ERR_TUNNEL_CONNECTION_FAILED | Corrige las credenciales del proxy antes de tocar los tiempos de espera |
Preguntas frecuentes
¿Cuál es el tiempo de espera por defecto en Playwright?
En la biblioteca, 30 segundos para navegaciones y acciones. En Playwright Test, una prueba completa tiene 30 segundos y cada expect(), 5 segundos; las acciones y las navegaciones no tienen un límite propio.
¿Cómo aumento el tiempo de espera de page.goto?
Pásalo en la llamada (page.goto(url, timeout=60_000) en Python, { timeout: 60_000 } en Node.js), fija set_default_navigation_timeout() en el contexto o navigationTimeout en la configuración de Playwright Test. Súbelo solo después de medir.
¿Por qué page.goto agota el tiempo de espera si la página ya se ve en pantalla?
goto espera por defecto al evento load, y una sola imagen o widget que nunca termina lo retiene. Usa domcontentloaded y espera al elemento que necesitas.
¿Debo usar networkidle?
No. La referencia de Playwright lo marca como desaconsejado, y las páginas con sondeo periódico o chat en directo pueden no alcanzarlo nunca. Espera a un elemento concreto.
¿Cómo capturo un TimeoutError de Playwright en Python?
Impórtalo como from playwright.sync_api import TimeoutError as PlaywrightTimeoutError y captura ese nombre. Un expect() fallido lanza AssertionError.
¿Puede un proxy causar tiempos de espera agotados en Playwright?
Sí. Una IP de salida lenta puede llevar las páginas por encima del límite, y unas credenciales incorrectas en un sitio HTTPS pueden aparecer como un tiempo de espera agotado. Mide a través del proxy, fija los límites según los resultados y escucha requestfailed. Una página de bloqueo no se arregla con otro proxy.
En resumen
«Timeout 30000ms exceeded» nombra la espera que se agotó, no la causa. Lee el método y el final del call log y corrige lo que señalan: una espera a load o networkidle, un selector, una capa superpuesta, un frame, una página de bloqueo o una IP de salida lenta. Fija los límites en el contexto a partir de tiempos de carga medidos, da a la página lenta ocasional su propio límite, reintenta solo los tiempos de espera agotados con backoff y detente ante los bloqueos. Para elegir proxies que encajen con tus destinos, compara nuestros servicios de proxy.