

































Web scraping · Blog de Proxynet – Página 3

Publicado
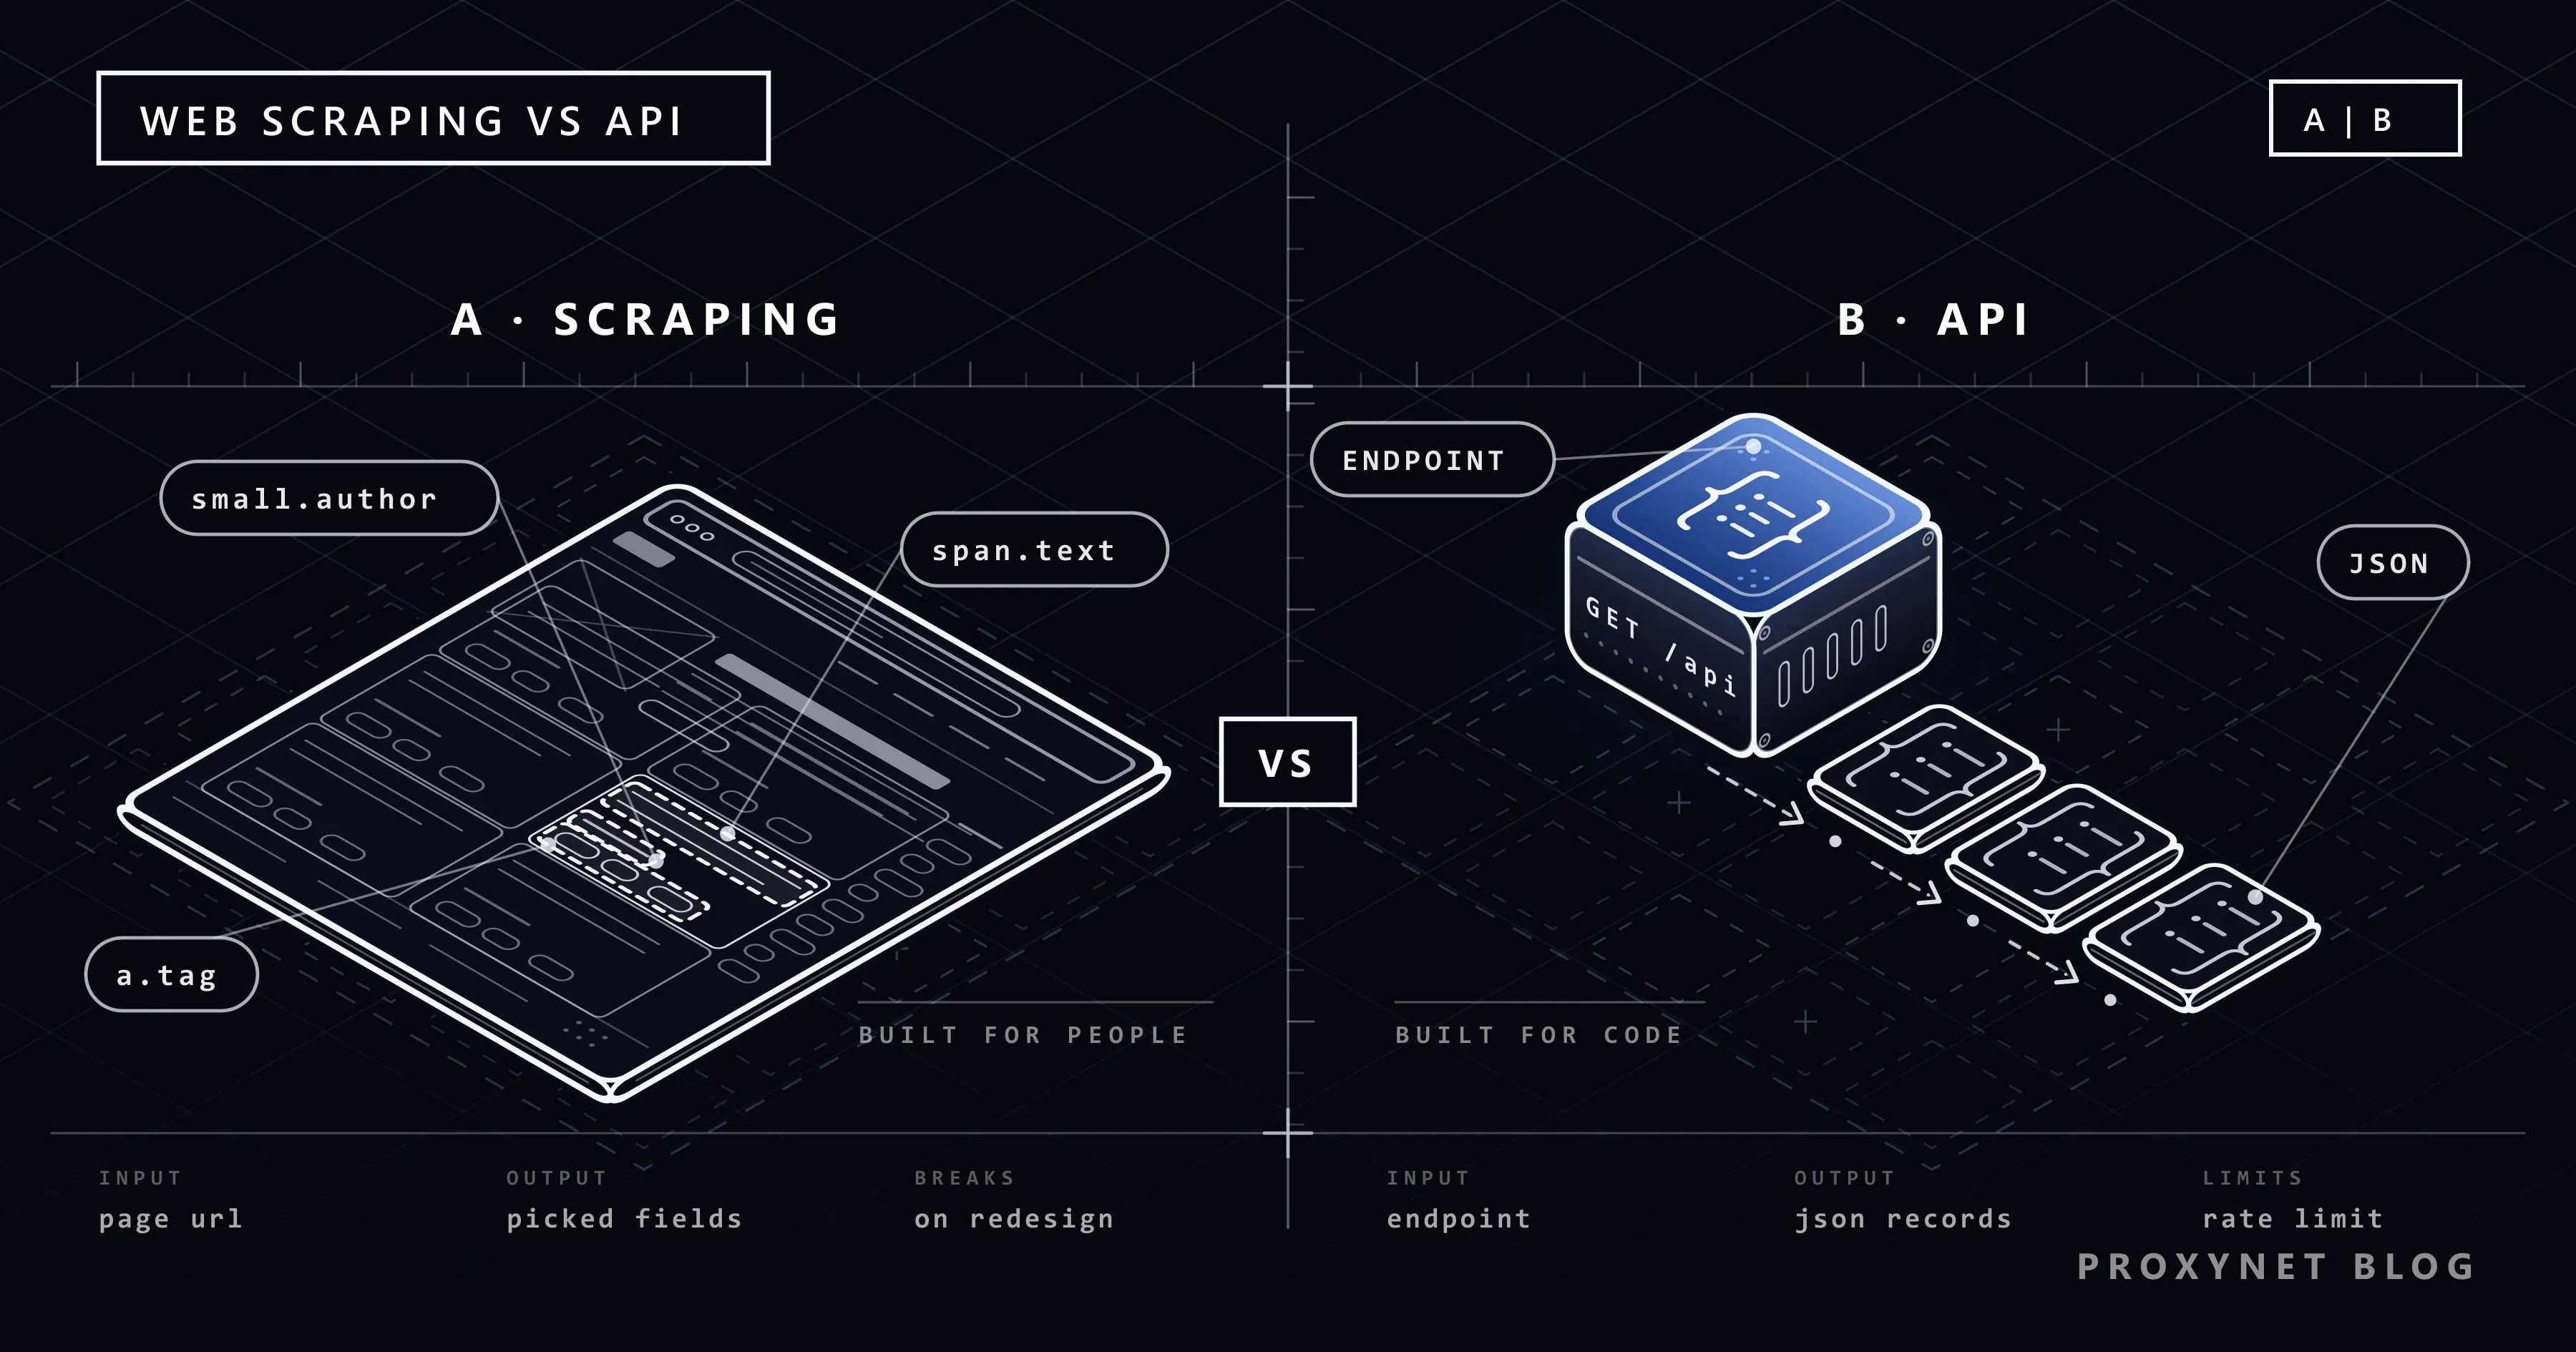
Web scraping vs. API: ¿cuál deberías usar?
Una API entrega los datos que el proveedor decide compartir, en formato fijo; el web scraping lee la propia página. Comparamos ambos y probamos las dos vías.
Autor: Acar Diveroli
Publicado
¿Qué es el web scraping y cómo funciona?
El web scraping es la recogida automática de datos de páginas web: un programa descarga el HTML, extrae campos y los guarda. Cómo funciona y para qué sirve.
Autor:Acar Diveroli
Publicado
Web scraping con Cheerio en Node.js: tutorial paso a paso
Cheerio analiza HTML en Node.js con selectores al estilo jQuery. Crea un scraper probado con fetch, paginación, límite de concurrencia, reintentos y proxy.
Autor:Acar Diveroli
Publicado
Cómo limpiar datos de scraping con pandas en Python
Limpia datos de scraping con pandas: primero el texto, luego tipos, duplicados, valores faltantes y atípicos, y valida antes de guardar. Con script probado.
Autor:Acar Diveroli
Publicado
Cómo extraer datos de un PDF: tablas, texto y OCR
Comprueba primero si el PDF tiene capa de texto. Si la tiene, Excel o pdfplumber leen las tablas; las páginas escaneadas necesitan OCR. Con código probado.
Autor:Acar Diveroli
Publicado
Cómo tratar datos personales (PII) en datos de scraping
Los datos de scraping suelen traer datos personales: nombres, perfiles, emails y teléfonos. Cómo detectarlos, reducirlos, enmascararlos y protegerlos.
Autor:Acar Diveroli
Publicado
Cómo guardar datos de scraping en CSV, JSON y SQLite
Guarda los datos extraídos en CSV para hojas de cálculo, JSON Lines para registros que crecen y SQLite para ejecuciones sin duplicados. Código Python probado.
Autor:Acar Diveroli
Publicado
¿Qué es el parsing de datos? Tipos, errores y ejemplos
El parsing de datos convierte HTML, JSON, CSV o logs en registros estructurados que tu código puede usar. Cómo funciona un parser, sus tipos y errores comunes.
Autor:Acar Diveroli
Publicado
¿Qué es ETL? Extracción, transformación y carga con Python
ETL es extraer datos de una fuente, limpiarlos en una forma fija y cargarlos en una base de datos. Cómo funciona, ETL vs. ELT y un job de Python probado.
Autor:Acar Diveroli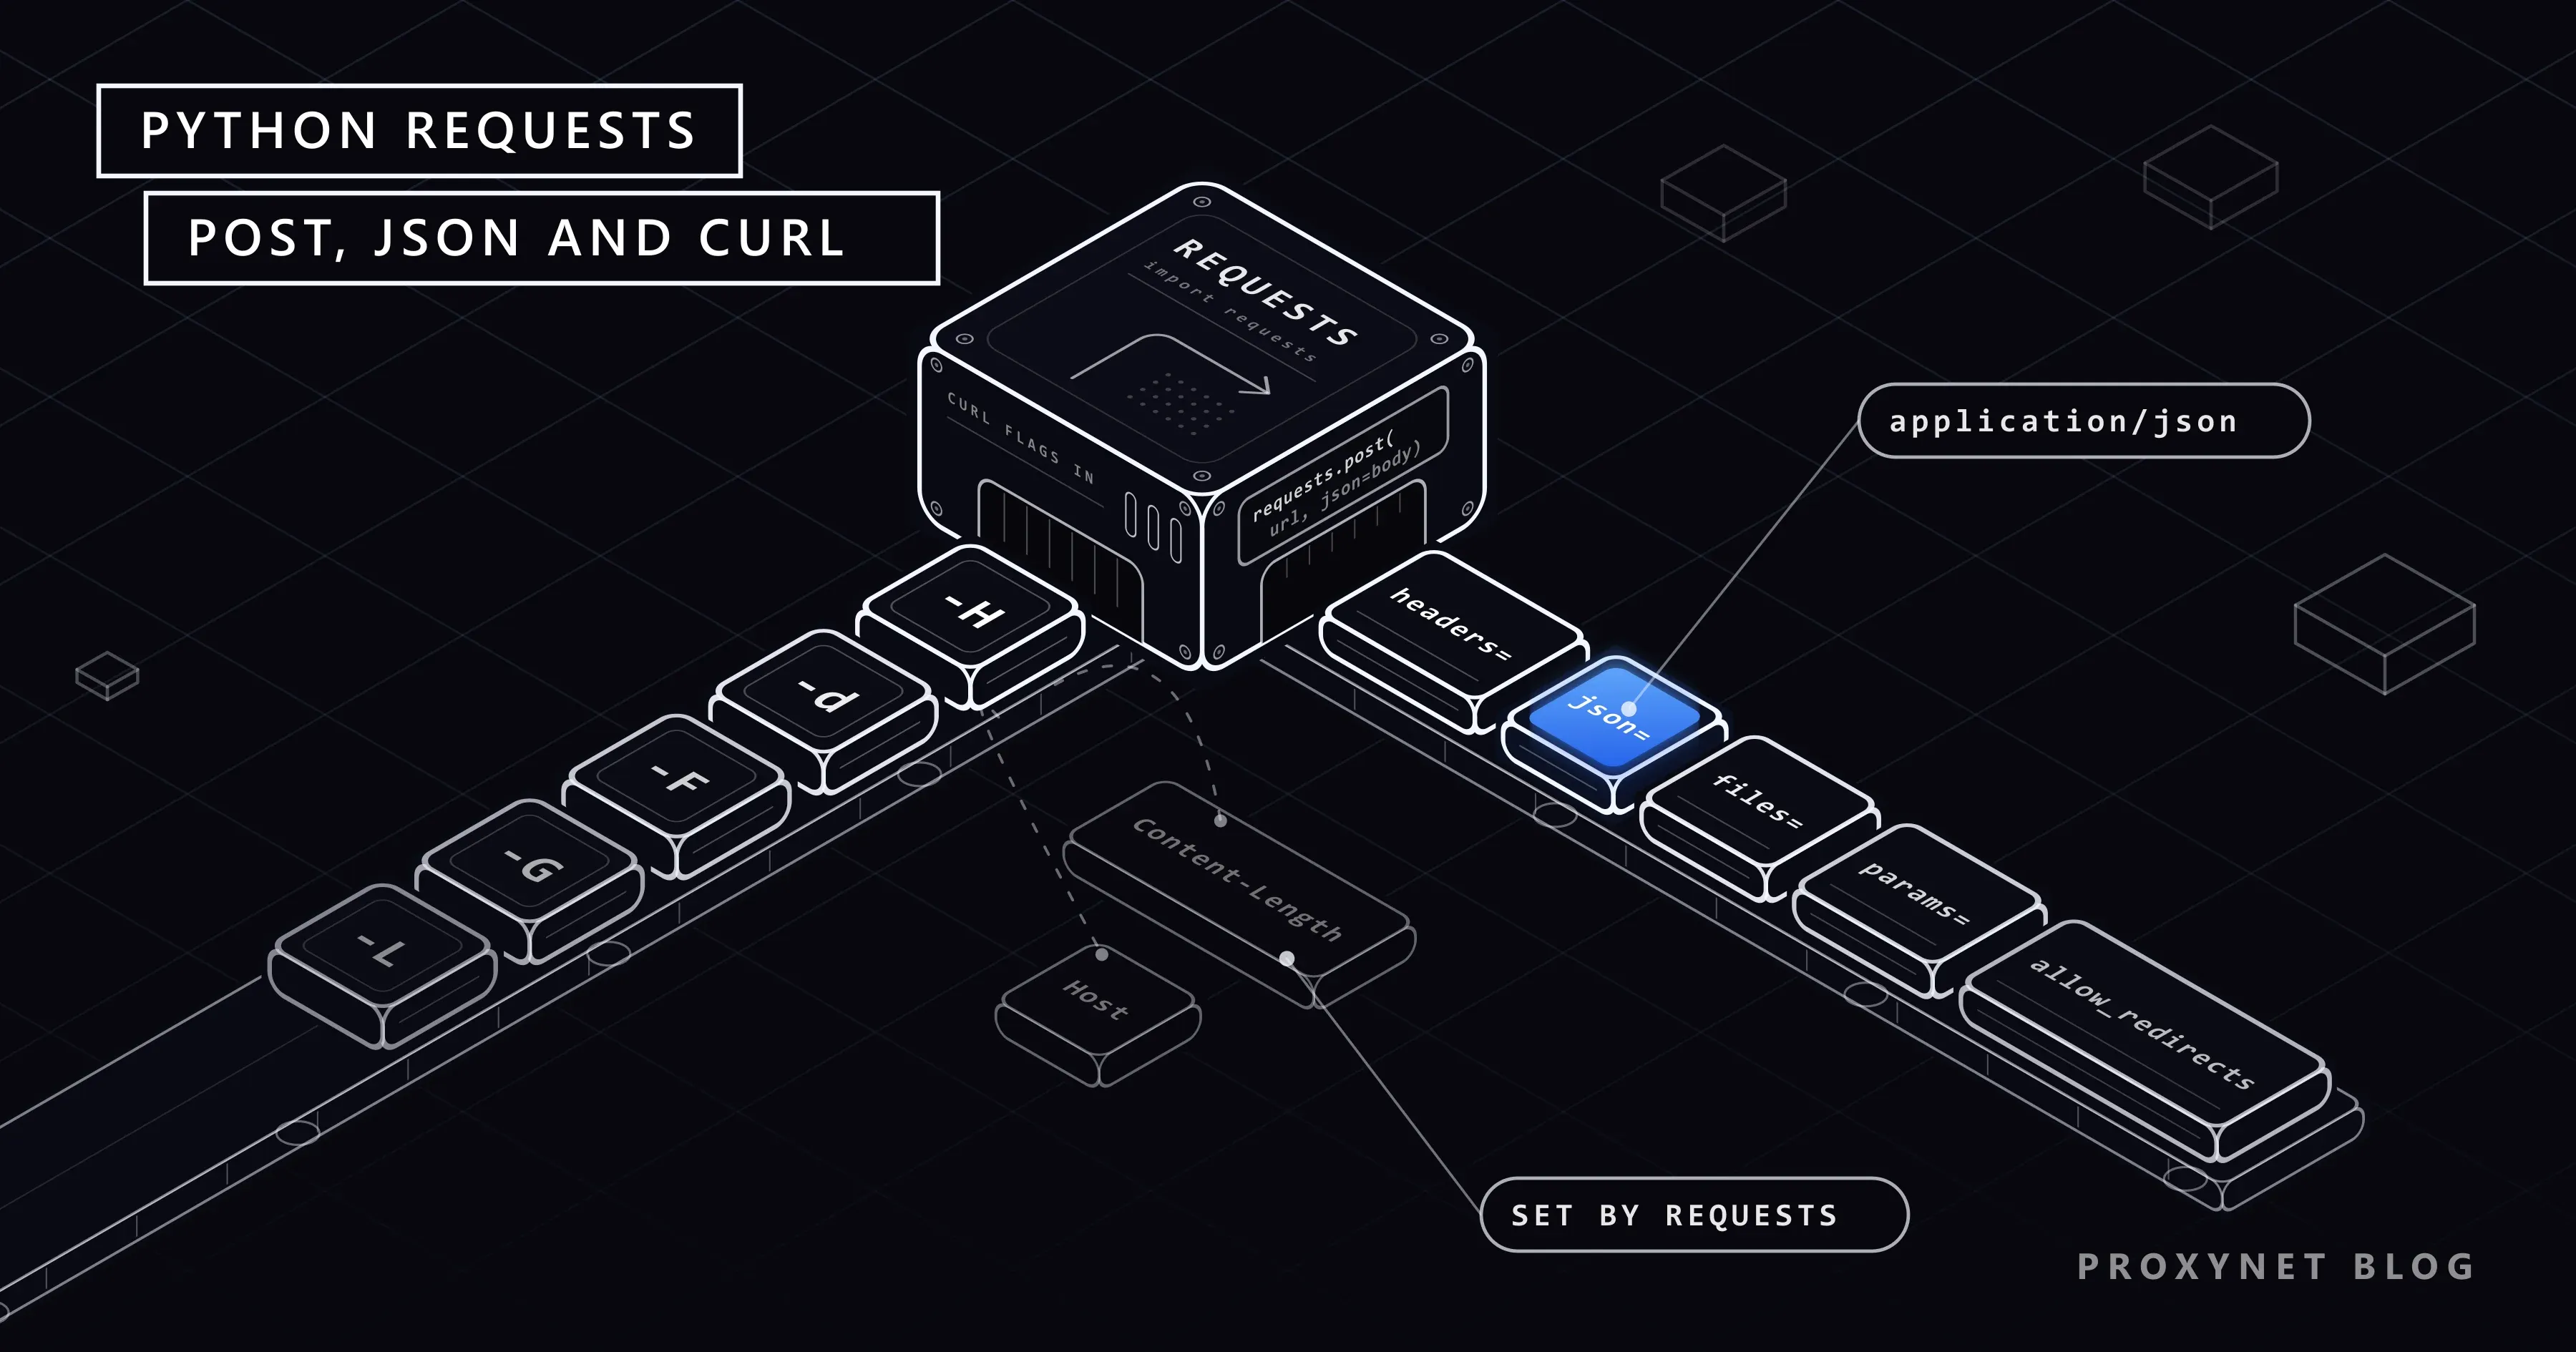
Publicado
POST con JSON en Python Requests: equivalencias de cURL
Para enviar JSON por POST con Python Requests, usa requests.post(url, json=data) y el Content-Type se pone solo. Así encajan data=, params=, cabeceras y cURL.
Autor:Acar Diveroli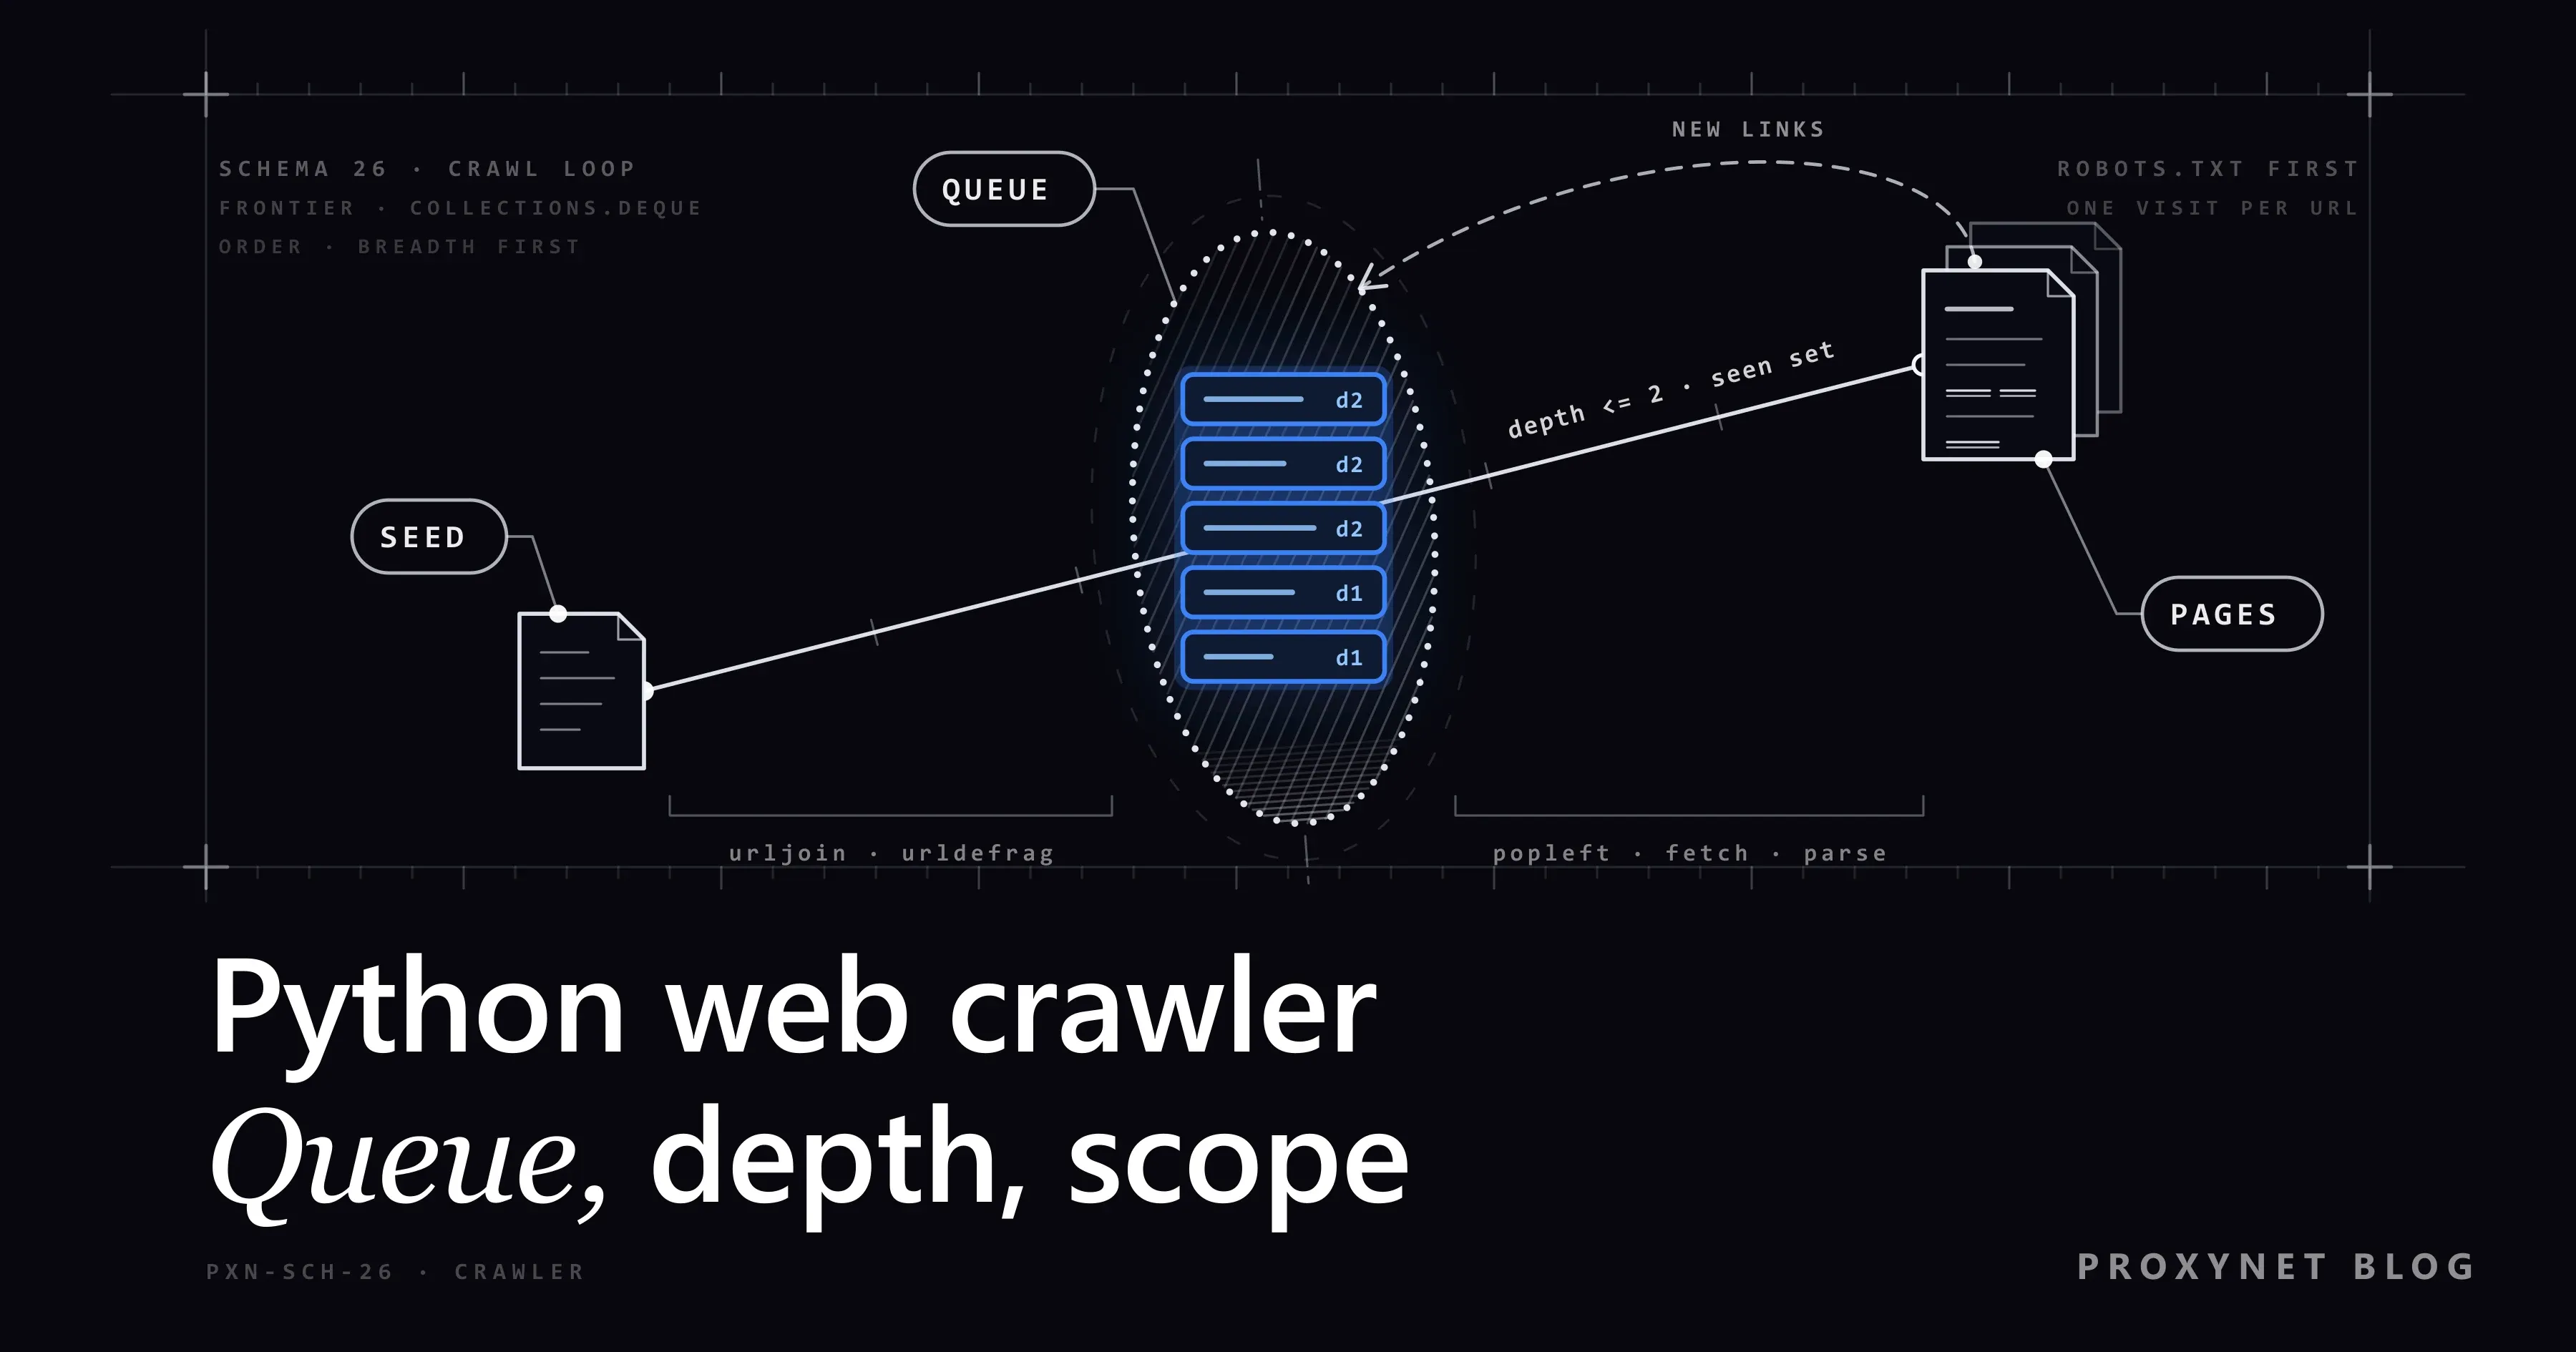
Publicado
Cómo crear un web crawler en Python paso a paso
Un web crawler en Python encola los enlaces de una URL inicial y visita cada página una sola vez. Programamos cola, normalización, profundidad y alcance.
Autor:Acar Diveroli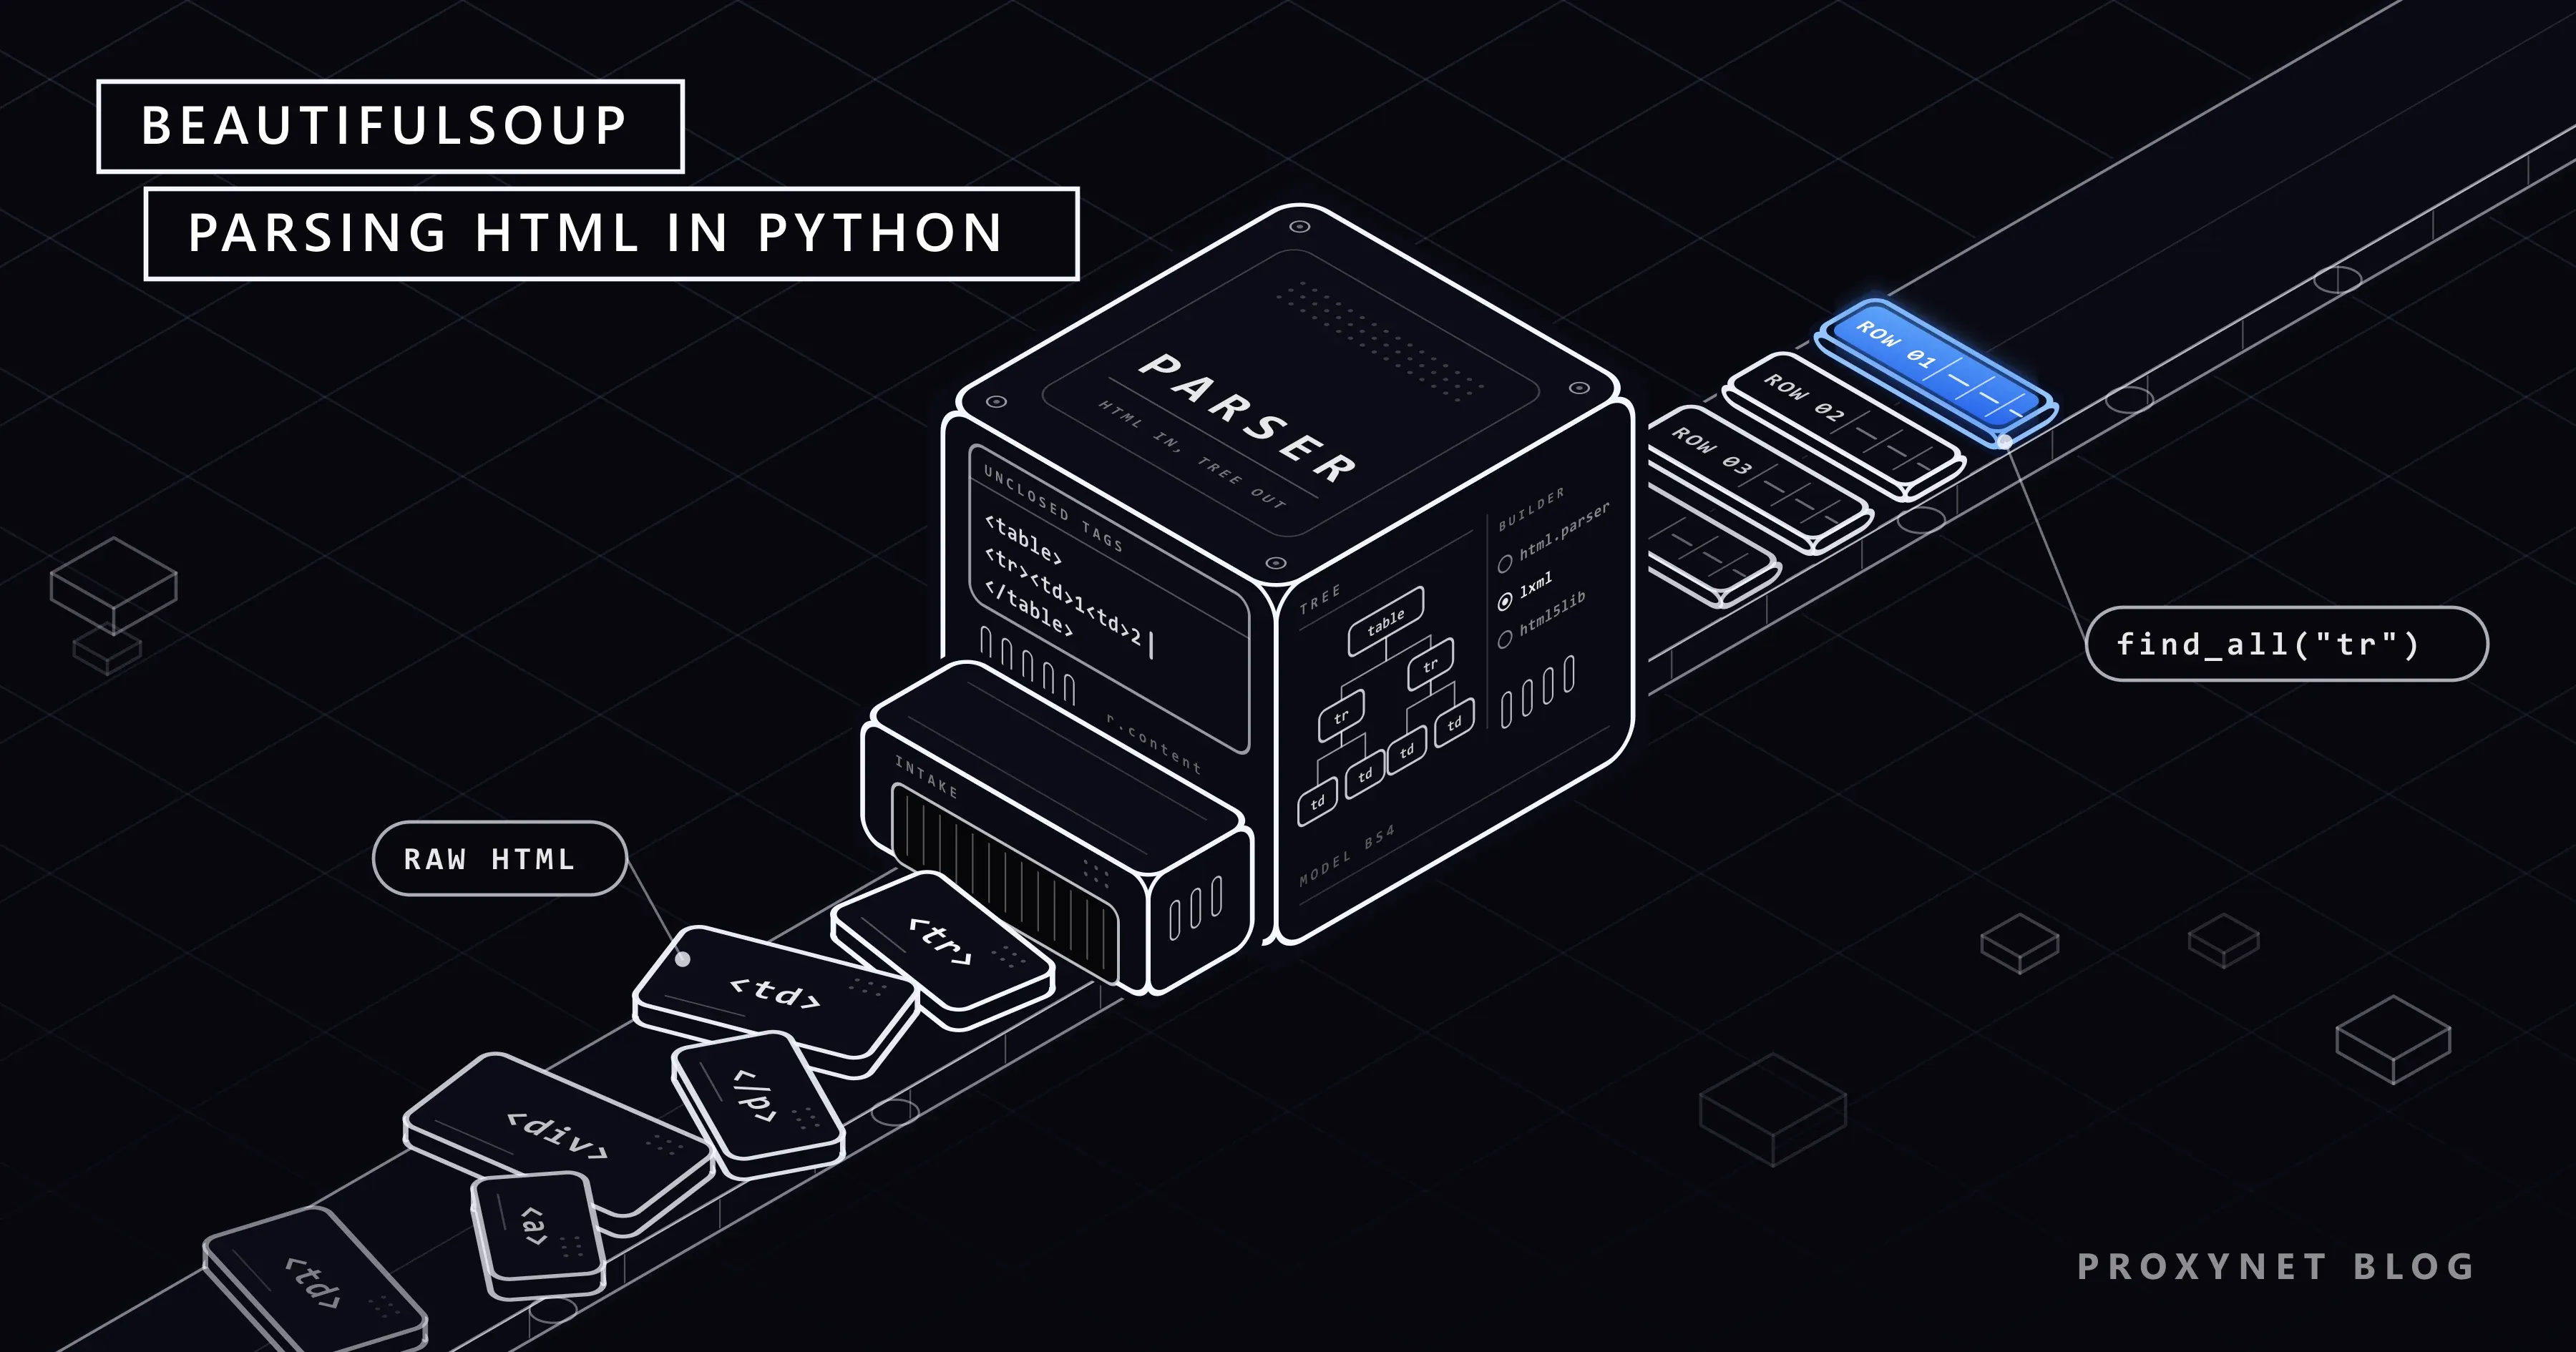
Publicado
¿Qué es BeautifulSoup y cómo se usa en Python?
BeautifulSoup es una biblioteca de Python que convierte el HTML descargado en un árbol consultable. Cómo elegir parser, find_all o select y leer tablas HTML.
Autor:Acar Diveroli
Web scraping vs. API: ¿cuál deberías usar?
Autor: Acar DiveroliComparativasPublicado
¿Qué es el web scraping y cómo funciona?
Autor: Acar DiveroliWeb scrapingPublicado
Web scraping con Cheerio en Node.js: tutorial paso a paso
Autor: Acar DiveroliTutorialesPublicado
Cómo limpiar datos de scraping con pandas en Python
Autor: Acar DiveroliTutorialesPublicado
Cómo extraer datos de un PDF: tablas, texto y OCR
Autor: Acar DiveroliTutorialesPublicado
Cómo tratar datos personales (PII) en datos de scraping
Autor: Acar DiveroliWeb scrapingPublicado
Cómo guardar datos de scraping en CSV, JSON y SQLite
Autor: Acar DiveroliTutorialesPublicado
¿Qué es el parsing de datos? Tipos, errores y ejemplos
Autor: Acar DiveroliWeb scrapingPublicado
¿Qué es ETL? Extracción, transformación y carga con Python
Autor: Acar DiveroliWeb scrapingPublicado
POST con JSON en Python Requests: equivalencias de cURL
Autor: Acar DiveroliTutorialesPublicado
Cómo crear un web crawler en Python paso a paso
Autor: Acar DiveroliWeb scrapingPublicado
¿Qué es BeautifulSoup y cómo se usa en Python?
Autor: Acar DiveroliWeb scrapingPublicado
Ningún artículo coincide
Publicado
Publicado