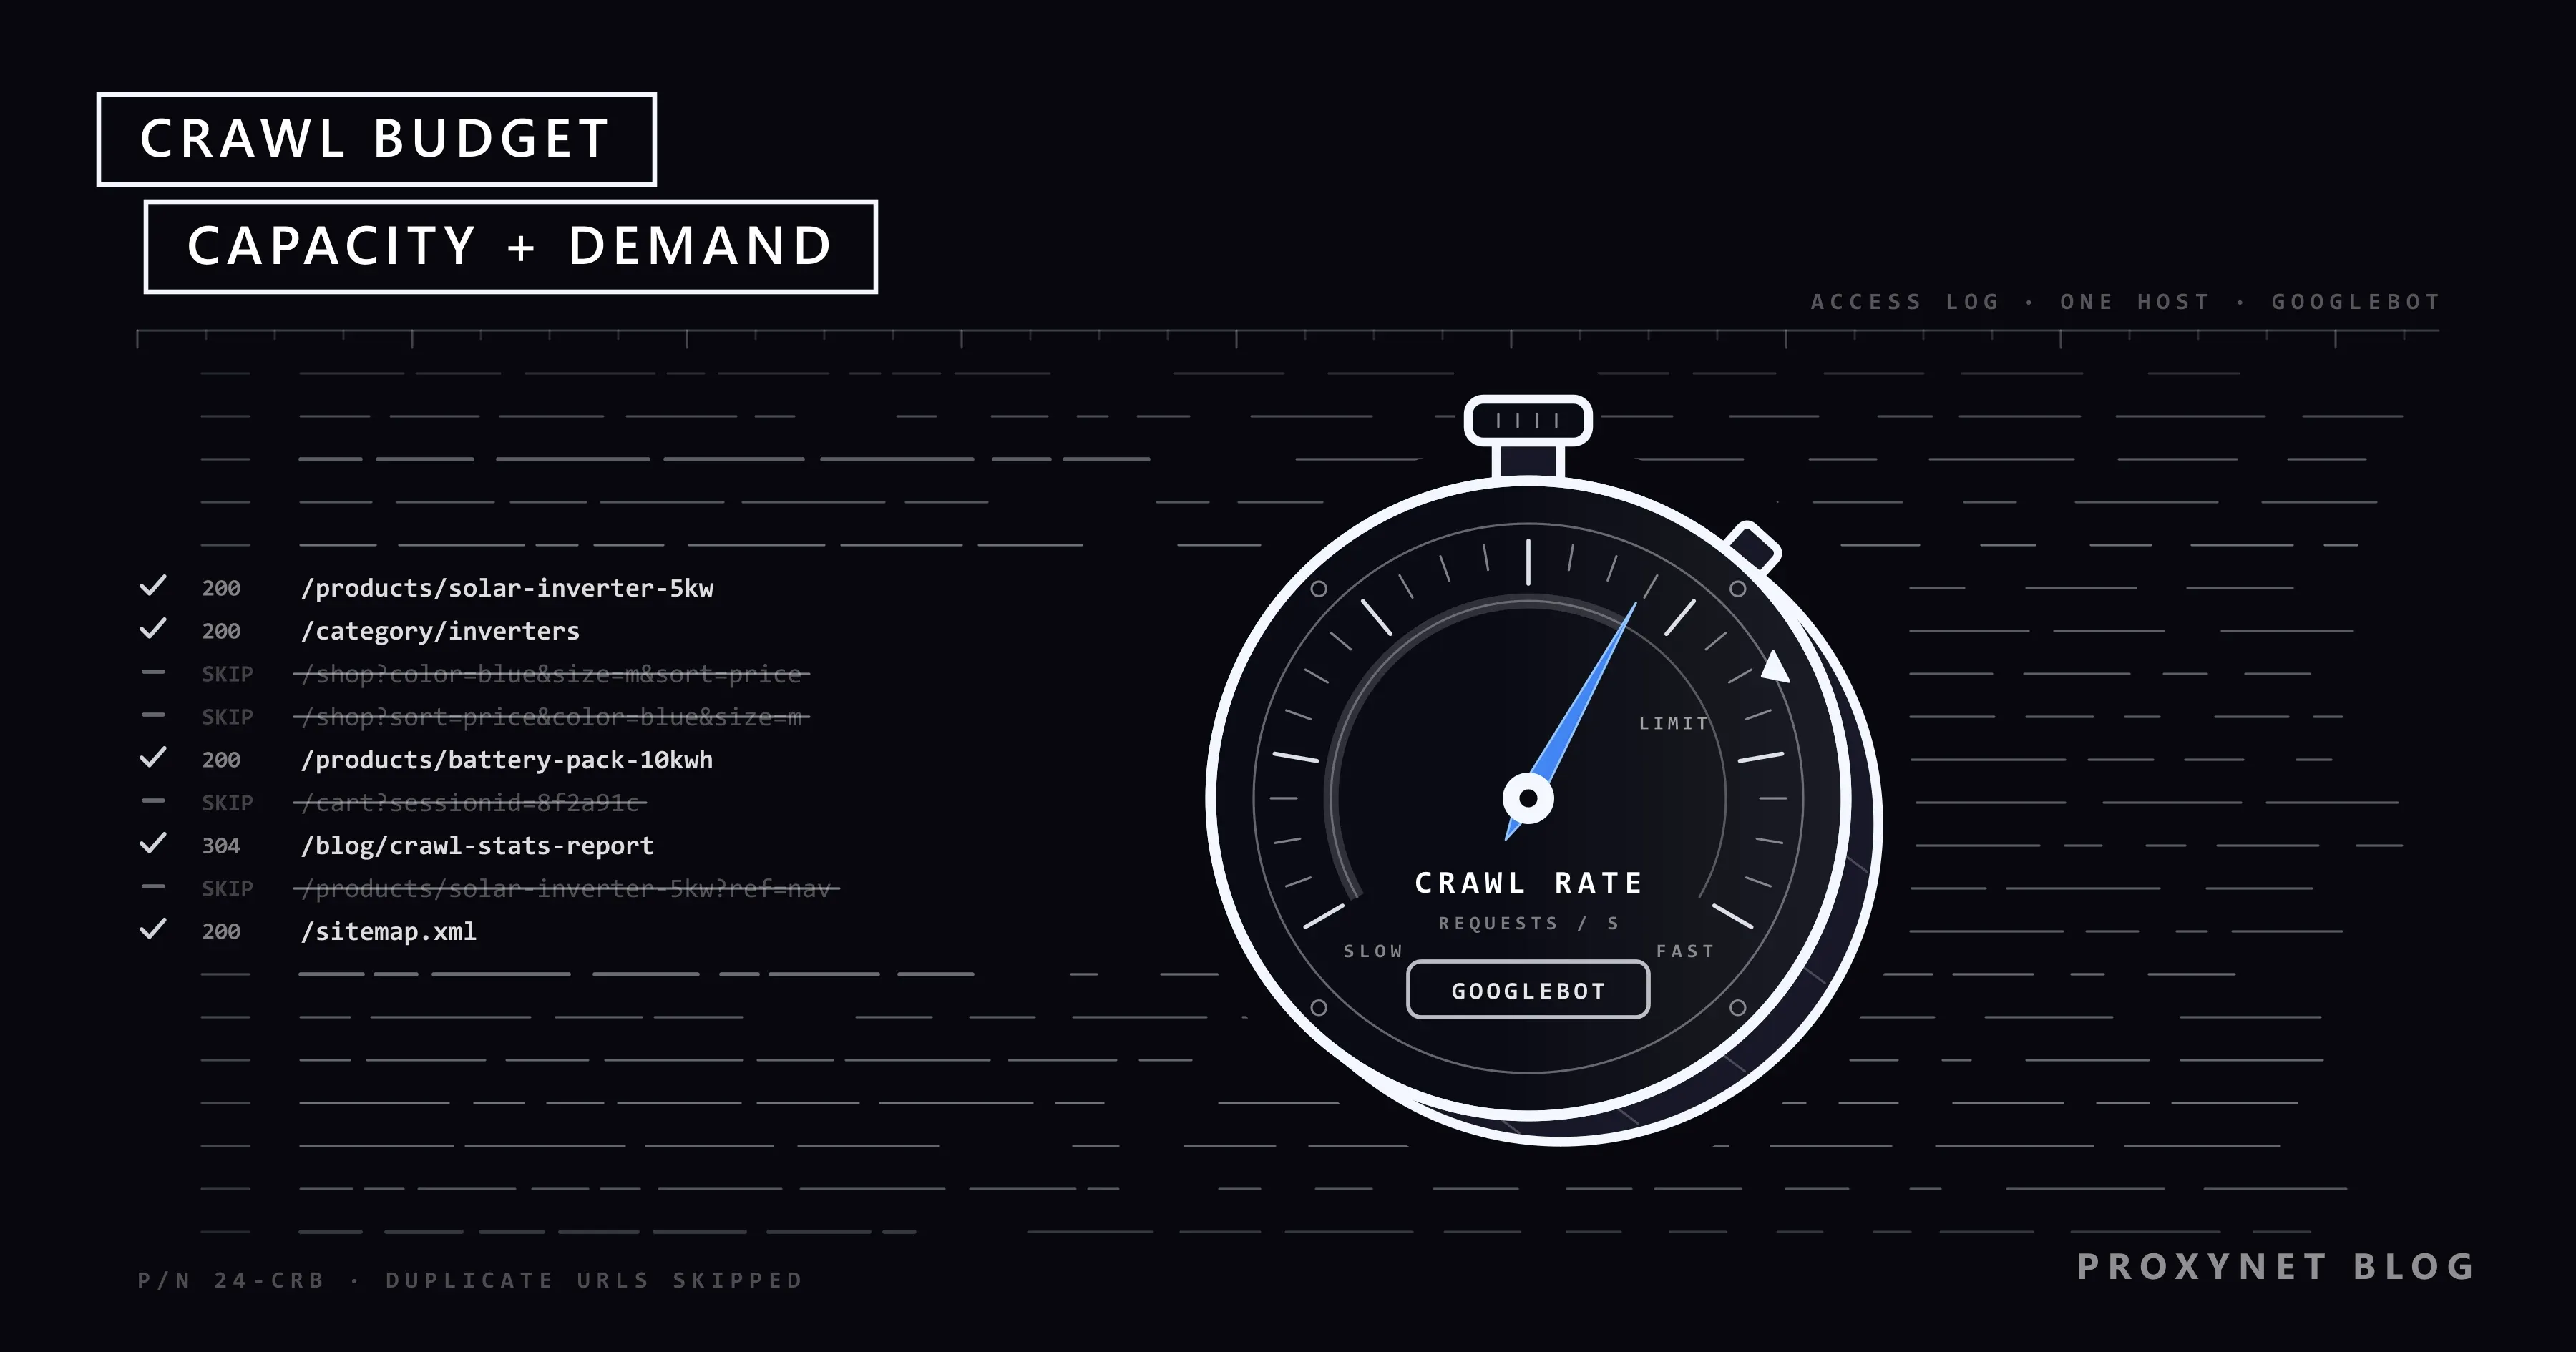
Añades 20.000 páginas de producto a una tienda online, envías el sitemap y, tres semanas después, Search Console muestra la mayoría como "Descubierta: actualmente sin indexar". Los registros de tu servidor cuentan la otra mitad de la historia: Googlebot ha estado ocupado, pero sobre todo en direcciones de filtros como ?color=blue&size=m&sort=price. Las páginas que te importan esperan en una cola que avanza a una velocidad limitada. En SEO, ese límite se llama presupuesto de rastreo (crawl budget).
Este artículo explica el presupuesto de rastreo con los términos del propio Google, qué sitios deben preocuparse por él y cómo pasa Googlebot de encontrar una URL a indexarla. Después vemos qué desperdicia rastreos, cómo revisarlos, qué significan los dos estados "actualmente sin indexar" y cómo detectar un Googlebot falso.
¿Qué es el presupuesto de rastreo?
El presupuesto de rastreo es el número de URL que Google puede y quiere rastrear en tu sitio, y el término es del propio Google: su guía Optimizar el presupuesto de rastreo lo define como "el conjunto de URLs que Google puede y quiere rastrear". Rastrear significa que un programa, en este caso Googlebot, solicita una URL y descarga lo que devuelve el servidor. Nada llega al índice de Google sin haberse rastreado antes.
El presupuesto se fija por nombre de host, así que www.example.com y shop.example.com tienen cada uno el suyo. No hay ninguna cifra que puedas consultar ni subir desde un ajuste; el presupuesto es el resultado de dos cosas que Google mide constantemente.
¿Qué son el límite de capacidad de rastreo y la demanda de rastreo?
El límite de capacidad de rastreo es cuánto puede rastrear Googlebot sin sobrecargar tu servidor, y la demanda de rastreo es cuánto quiere rastrear. En la práctica, el menor de los dos fija tu presupuesto.
El límite de capacidad de rastreo, que Google también llama carga del host, limita el tiempo que tu servidor pasa con conexiones abiertas para Google, contando tanto cuántas funcionan en paralelo como cuánto dura cada una. Todos los sitios empiezan con el mismo límite conservador. Si tu servidor responde rápido y de forma constante, Google lo sube con el tiempo; las respuestas lentas, los errores 5xx o 429 Too Many Requests lo bajan. El límite lo comparten todos los crawlers de Google, así que el rastreo intenso de un crawler de imágenes o de anuncios deja menos margen a Googlebot.
La demanda de rastreo depende de tres factores que Google nombra. El inventario detectado es cada URL que Google conoce de tu sitio; Google intenta rastrear la mayoría, así que miles de URL inútiles inflan la cola. Las URL populares se rastrean más a menudo, y las que se quedan desactualizadas se vuelven a rastrear para detectar cambios. Un traslado del sitio eleva la demanda durante un tiempo. Aunque haya capacidad de sobra, una demanda baja significa menos rastreo, así que un servidor rápido por sí solo no hace que se rastreen más las páginas pobres en contenido.
¿Te afecta el presupuesto de rastreo?
A la mayoría de los sitios, no. La guía de Google está pensada para tres tipos de sitio:
- Sitios con aproximadamente 1 millón de páginas únicas o más cuyo contenido cambia más o menos una vez por semana.
- Sitios con aproximadamente 10.000 o más páginas únicas cuyo contenido cambia a diario.
- Sitios en los que una gran parte de las URL está en "Descubierta: actualmente sin indexar".
Google presenta estas cifras como estimaciones aproximadas. Si tus páginas nuevas suelen rastrearse el mismo día en que las publicas, basta con un sitemap actualizado y un vistazo de vez en cuando al informe "Indexación de páginas". Un sitio de 300 páginas con una entrada de blog sin indexar tiene otro problema, normalmente de calidad, duplicación o enlaces internos débiles.
¿Cómo rastrea Googlebot un sitio, paso a paso?
Googlebot trabaja con una cola: encuentra URL, las programa, las descarga dentro de los límites de tu servidor, las renderiza y las pasa a la decisión de indexación.
- Descubrir. Google conoce URL a partir de páginas rastreadas, sus enlaces y los sitemaps.
- Programar. Un algoritmo decide qué URL descargar, con qué frecuencia y cuántas en cada visita.
- Consultar robots.txt. Googlebot lee robots.txt, el archivo de texto en la raíz del sitio que enumera las rutas que los crawlers deben evitar; Qué es robots.txt y cómo leerlo explica cómo coinciden sus reglas.
- Descargar al ritmo que permite el servidor. Las respuestas lentas, los errores 5xx y los 429 hacen que Googlebot frene.
- Renderizar. Google ejecuta el JavaScript de la página en una versión reciente de Chrome; los scripts, las hojas de estilo y las imágenes también son solicitudes de rastreo.
- Decidir la indexación. Google agrupa las páginas casi idénticas, elige una URL canónica por grupo (la versión que puede mostrar en los resultados) y decide si la indexa.
- Volver a rastrear. Las páginas conocidas vuelven a la cola para un rastreo de actualización.
El presupuesto de rastreo actúa en los pasos 2 a 4. Las URL inútiles del paso 1 o un paso 4 lento reducen lo que queda para las páginas que te importan.
¿Qué desperdicia el presupuesto de rastreo?
Las URL que no producen contenido único e indexable desperdician presupuesto de rastreo, y también un servidor que obliga a Googlebot a ir más despacio.
| Causa | Ejemplo típico | Solución |
|---|---|---|
| Filtros facetados | ?color=red&size=m&sort=price | Bloquear parámetros de filtro con Disallow |
| Calendarios infinitos | /events?month=2031-07 y siguientes | No enlazar más allá de fechas reales |
| ID de sesión en la URL | ?sessionid=8f3a9c | Guardar la sesión en cookies |
| Cadenas de redirecciones | De A a B, a C, a D | Enlazar directamente a la URL final |
| Soft 404 | Página "Sin resultados" con estado 200 | Devolver 404 o 410 |
| Parámetros de seguimiento | ?utm_source= en enlaces internos | Usar enlaces internos limpios |
| Servidor lento, 5xx, 429 | Tiempos de espera en horas de mayor tráfico | Añadir capacidad, corregir errores |
La navegación facetada, es decir, las opciones de filtro de las páginas de categoría, es la mayor de estas causas en las tiendas: tres colores, cinco tallas y cuatro órdenes de clasificación ya suman 60 URL para una sola categoría. Google aconseja bloquear en robots.txt las URL de filtros que no quieres y devolver 404 en las combinaciones de filtros vacías, porque rel="canonical" y nofollow lo resuelven de forma menos fiable. Bastan unas líneas; * equivale a cualquier secuencia de caracteres:
User-agent: *
Disallow: /*?*sort=
Disallow: /*?*color=
Disallow: /*?*sessionid=
¿Cómo revisar tu presupuesto de rastreo?
Google no muestra ninguna cifra de presupuesto, así que lo que revisas es cómo gasta Googlebot sus visitas en realidad, en el informe "Estadísticas de rastreo" de Search Console y en los registros de tu servidor.
El informe está en Ajustes > Estadísticas de rastreo y solo funciona en una propiedad de nivel raíz: una propiedad de dominio o una propiedad de prefijo de URL de la raíz del sitio. Sus gráficos muestran Total de solicitudes de rastreo, Tamaño total de la descarga y Tiempo medio de respuesta, con desgloses por respuesta, tipo de archivo, objetivo (Descubrimiento para URL nuevas, Actualización para los nuevos rastreos) y tipo de robot de Google. La página de ayuda del informe "Estadísticas de rastreo" explica cada parte e indica que los sitios con menos de 1.000 páginas rara vez lo necesitan.
Qué mirar:
- Estado del host: disponibilidad de robots.txt, resolución de DNS y conectividad del servidor en los últimos 90 días. Los problemas aquí son los primeros en limitar el rastreo.
- Tiempo medio de respuesta: una línea que sube empuja el límite de capacidad hacia abajo.
- Respuestas del rastreo: muchas respuestas 3xx, 404 o 5xx significan visitas desperdiciadas.
- Objetivo del rastreo: pocas solicitudes de descubrimiento en un sitio que publica a diario indican que las URL nuevas se encuentran despacio.
Los registros del servidor muestran cada solicitud con su hora, URL, código de estado y user agent. Quédate solo con las solicitudes verificadas de Googlebot, agrupa las URL por patrón (productos, filtros, campañas antiguas) y compara las cifras con las páginas que quieres que se rastreen. Con, por ejemplo, 5.000 solicitudes de Googlebot al día y 600.000 URL que actualizar, una pasada completa tarda unos 120 días.
¿Cómo mejorar el presupuesto de rastreo?
Mejoras el presupuesto de rastreo sacando las URL inútiles de la vista de Google y haciendo tu servidor más rápido y fiable.
- Bloquea en robots.txt los espacios de URL inútiles. Los filtros, la búsqueda interna y los órdenes de clasificación son lo típico. No uses
noindex: Google tiene que descargar la página para ver la etiqueta. - Consolida los duplicados. Las redirecciones y
rel="canonical"son señales fuertes de cuál es la URL principal. - Devuelve 404 o 410 en las páginas eliminadas. Un 404 es una señal fuerte para no volver a rastrear la URL. Corrige los soft 404, páginas de "no encontrado" enviadas con estado 200, que Google sigue rastreando.
- Mantén los sitemaps al día, con fechas
lastmodhonestas. Cambialastmodsolo cuando cambie el contenido; Cómo encontrar el sitemap de una web y listar sus páginas muestra cómo son los archivos de sitemap. - Acorta las rutas de redirección. Haz que los enlaces internos apunten a las URL finales.
- Acelera el servidor. Los tiempos de respuesta bajos elevan el límite de capacidad, y las respuestas
304 Not Modifiedevitan reenviar páginas que no han cambiado. - Usa 503 o 429 solo en una emergencia. Google advierte que las URL que los devuelven durante más de uno o dos días pueden salir del índice.
Bloquear secciones en robots.txt no traslada su presupuesto a otras páginas, salvo que el sitio ya estuviera en su límite de capacidad. Y si la prueba en vivo de la herramienta de inspección de URLs indica Carga del host superada, la solución es más capacidad de servidor.
¿Qué significan "Rastreada: actualmente sin indexar" y "Descubierta: actualmente sin indexar"?
"Descubierta: actualmente sin indexar" significa que Google conoce la URL pero aún no la ha descargado; "Rastreada: actualmente sin indexar" significa que Google la descargó y decidió no indexarla por ahora. Ambos estados aparecen en el informe "Indexación de páginas" de Search Console, y normalmente solo el primero apunta al presupuesto de rastreo.
| Estado | Qué pasó | Qué hacer |
|---|---|---|
| Descubierta: actualmente sin indexar | Encontrada, rastreo aplazado | Acelerar el servidor, reducir URL inútiles |
| Rastreada: actualmente sin indexar | Descargada, sin indexar | Mejorar o fusionar la página |
Para "Descubierta", la ayuda del informe "Indexación de páginas" da el motivo habitual: Google previó que la visita sobrecargaría el sitio, así que aplazó el rastreo. Revisa primero el estado del host y los tiempos de respuesta, y después asegúrate de que las páginas reciben enlaces desde páginas rastreadas y no solo aparecen en el sitemap.
"Rastreada" es frecuente y, según Google, no requiere necesariamente atención, porque Google indexa páginas canónicas que vale la pena mostrar, no todas las URL. Revisa una muestra con la herramienta de inspección de URLs, mejora o fusiona las páginas importantes y deja el resto. Después de una corrección, Validar corrección inicia una nueva comprobación que puede tardar unas dos semanas.
¿Cómo verificar que un visitante es de verdad Googlebot?
Verificas Googlebot por su dirección IP, nunca por su user agent. Cualquier cliente puede escribir "Googlebot" en su cabecera User-Agent, y esas entradas falsas distorsionan cualquier análisis de rastreo.
La página de Google sobre la verificación de sus crawlers ofrece dos métodos. El manual requiere dos consultas DNS: una búsqueda inversa de la IP debe devolver un nombre que termine en googlebot.com, google.com o googleusercontent.com, y una búsqueda directa de ese nombre debe devolver la misma IP. Lo comprobamos el 17 de noviembre de 2026 con la dirección del propio ejemplo de Google (salida recortada; host hace lo mismo en Linux y macOS):
> nslookup 66.249.66.1
Name:    crawl-66-249-66-1.googlebot.com
Address:  66.249.66.1

> nslookup crawl-66-249-66-1.googlebot.com
Name:    crawl-66-249-66-1.googlebot.com
Address:  66.249.66.1
El método automático compara la IP con los archivos JSON de rangos de direcciones que publica Google; common-crawlers.json cubre Googlebot. Nuestra copia, generada el 16 de noviembre de 2026, contenía 66.249.66.0/27, el rango que incluye la dirección anterior.
Los sistemas de gestión de bots hacen esta misma comprobación para dejar pasar a los crawlers reales de los buscadores y frenar a los impostores; Cómo funciona la detección de bots: la lógica anti-bot muestra dónde encaja entre sus otras capas.
¿Cómo deben comportarse tus propios crawlers de SEO?
Tus propios crawlers de auditoría y tus herramientas de seguimiento deben rastrear con la misma cortesía que Googlebot, porque en tu sitio consumen la misma capacidad del servidor. Una auditoría a toda velocidad en horas de mayor tráfico puede subir los tiempos de respuesta y provocar errores 5xx, justo las señales que hacen que Googlebot baje su límite. Fija un ritmo que el servidor aguante con holgura, haz las auditorías grandes fuera de las horas de más tráfico, respeta robots.txt y envía un user agent identificable con una URL de contacto; nuestra página de solución de web crawler trata el rastreo a gran escala.
Nunca envíes un user agent de Googlebot desde tu propio crawler. Los sitios verifican Googlebot por DNS y bloquean a los impostores, y hacerse pasar por el crawler de otra empresa es un engaño, no un truco de pruebas.
Un proxy tiene una sola tarea honesta en una auditoría de rastreo: mostrar la página que reciben los visitantes de otro país. Google señala que las direcciones IP predeterminadas de Googlebot parecen estar en Estados Unidos, una de las razones por las que recomienda URL separadas por idioma o región con hreflang en lugar de páginas que cambian según la ubicación del visitante. Los Proxies residenciales en el país y la ciudad de destino solicitan esas versiones como lo haría un visitante local; no sirven para saltarse los límites de solicitudes de un sitio.
¿Dónde aparece el presupuesto de rastreo?
- Tiendas online: las páginas de categoría se multiplican en miles de combinaciones de filtros y órdenes.
- Sitios de noticias: los artículos nuevos deben rastrearse en pocas horas mientras el archivo no deja de crecer.
- Clasificados y marketplaces: los anuncios caducan cada día, así que las páginas eliminadas necesitan respuestas 404 o 410 reales.
- Migraciones de sitios: cada URL se vuelve a rastrear en su nueva dirección, y las cadenas de redirecciones lo ralentizan.
- Sitios con mucho JavaScript: cada página necesita varias solicitudes de scripts y datos antes de que Google vea su contenido.
Errores frecuentes
- Usar
noindexpara ahorrar presupuesto de rastreo. Google tiene que descargar la página para leer la etiqueta. - Tratar cada URL en "Rastreada: actualmente sin indexar" como un problema de presupuesto. Suele ser cuestión de calidad o duplicación.
- Poner en
lastmodla hora de compilación en todas las URL. Google solo usa la fecha cuando es exacta de forma constante. - Servir 503 durante días en una caída o una migración. Las páginas pueden salir del índice.
- Fiarte del user agent de tus registros. Cuenta solo las solicitudes verificadas de Googlebot.
- Enlazar internamente a URL redirigidas o con parámetros. Cada enlace interno es una solicitud de rastreo que decides gastar.
Guía de decisión
| Tu situación | Qué hacer |
|---|---|
| Las páginas nuevas se rastrean el día que se publican | Mantener el sitemap al día; nada más |
| Muchas URL en "Descubierta: actualmente sin indexar" | Revisar estado del host y tiempos de respuesta; reducir URL inútiles |
| Muchas URL en "Rastreada: actualmente sin indexar" | Mejorar, fusionar o eliminar páginas pobres |
| Estadísticas de rastreo llenas de URL con parámetros | Bloquear esos patrones en robots.txt |
| Muchas respuestas 3xx en Estadísticas de rastreo | Enlazar directamente a las URL finales |
| La inspección de URLs indica "Carga del host superada" | Añadir capacidad de servidor |
| Solicitudes de "Googlebot" desde IP desconocidas | Verificar por DNS o rangos de IP; bloquear impostores |
| Googlebot está sobrecargando el servidor ahora | Devolver 503 o 429 durante horas, no días |
Preguntas frecuentes
¿Cómo reviso mi presupuesto de rastreo en Google Search Console?
Abre Ajustes > Estadísticas de rastreo en una propiedad de nivel raíz y entra en el informe. No hay ninguna cifra de presupuesto, pero el informe muestra el total de solicitudes de rastreo, el tamaño de la descarga, el tiempo medio de respuesta y el estado del host. Compara las solicitudes de rastreo diarias con el número de URL que quieres que se rastreen.
¿El presupuesto de rastreo afecta al posicionamiento?
No de forma directa. Google escribió en 2017 que una mayor frecuencia de rastreo no conlleva necesariamente mejores posiciones y que el rastreo no es una señal de posicionamiento. De forma indirecta sí importa: una página que nunca se rastrea no puede posicionarse.
¿El presupuesto de rastreo es un problema para los sitios pequeños?
Normalmente no. La guía de Google se dirige a sitios con alrededor de un millón de páginas, o con más de 10.000 páginas que cambian a diario. En un sitio pequeño, una página sin indexar casi siempre se debe a la calidad, la duplicación o los enlaces internos.
¿Cómo puedo aumentar mi presupuesto de rastreo?
Trabaja en los dos lados. La capacidad crece cuando el servidor responde rápido y sin errores. La demanda crece cuando Google encuentra menos URL inútiles y más páginas que vale la pena descargar, así que bloquea los espacios de parámetros, fusiona los duplicados y enlaza internamente las páginas importantes.
¿Dónde encuentro los rangos de IP de Googlebot?
Google los publica como archivos JSON enlazados desde su página de verificación de crawlers; common-crawlers.json cubre Googlebot. Los rangos cambian, así que vuelve a cargar el archivo con regularidad en lugar de copiar las direcciones una sola vez en una regla del firewall.
¿Los archivos CSS, JavaScript e imágenes consumen presupuesto de rastreo?
Sí. Cuenta cada URL que descarga Googlebot, incluidas las hojas de estilo, los scripts, las imágenes y las respuestas de API que una página necesita para renderizarse. El desglose por tipo de archivo en Estadísticas de rastreo muestra esa proporción en tu sitio.
En resumen
El presupuesto de rastreo es el conjunto de URL que Googlebot puede y quiere rastrear en un nombre de host: el límite de capacidad sigue la salud de tu servidor, y la demanda sigue cuántas URL conoce Google, lo populares que son y con qué frecuencia cambian. Importa en sitios muy grandes o que cambian rápido. Mantén las URL inútiles fuera de la vista de Google, responde rápido y bien, y trata "Descubierta" y "Rastreada: actualmente sin indexar" como problemas distintos. Para ver cómo se ven tus páginas desde otros países durante una auditoría, echa un vistazo a nuestra solución de proxy para SEO.