

































Web scraping · Blog da Proxynet – Página 3

Publicado
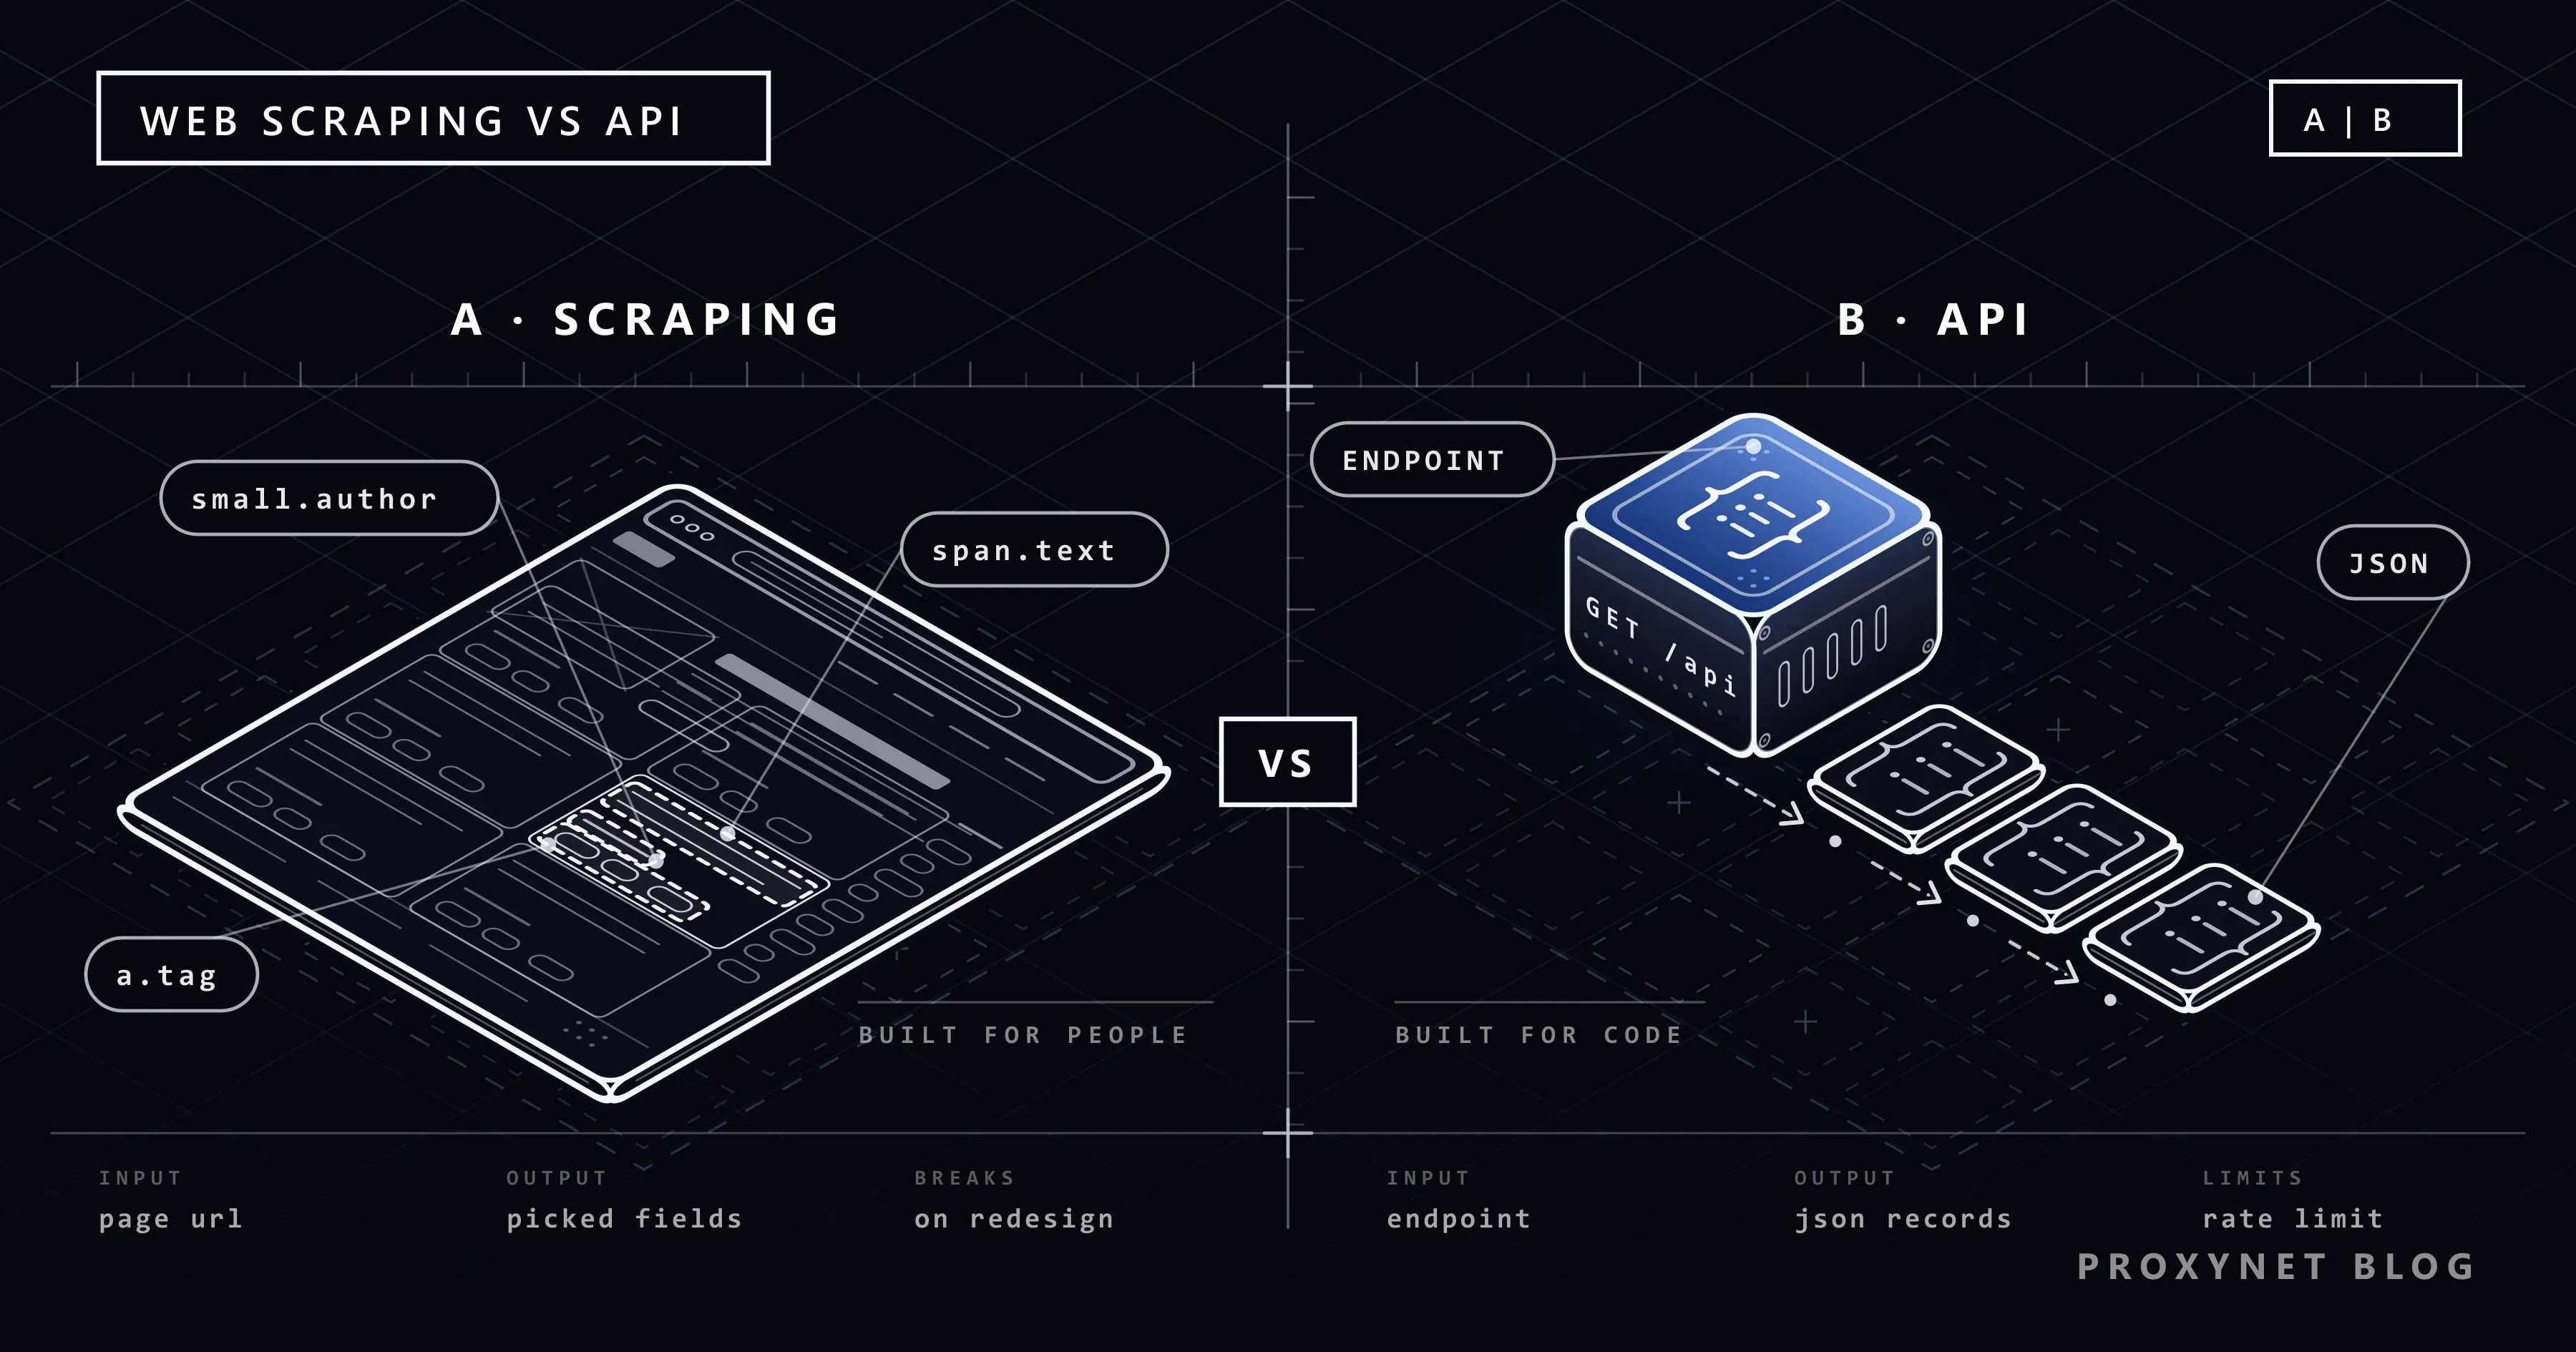
Web scraping vs. API: qual você deve usar?
Uma API entrega os dados que o provedor decide compartilhar, em formato fixo; o web scraping lê a própria página. Comparamos e testamos os dois caminhos.
Autor: Acar Diveroli
Publicado
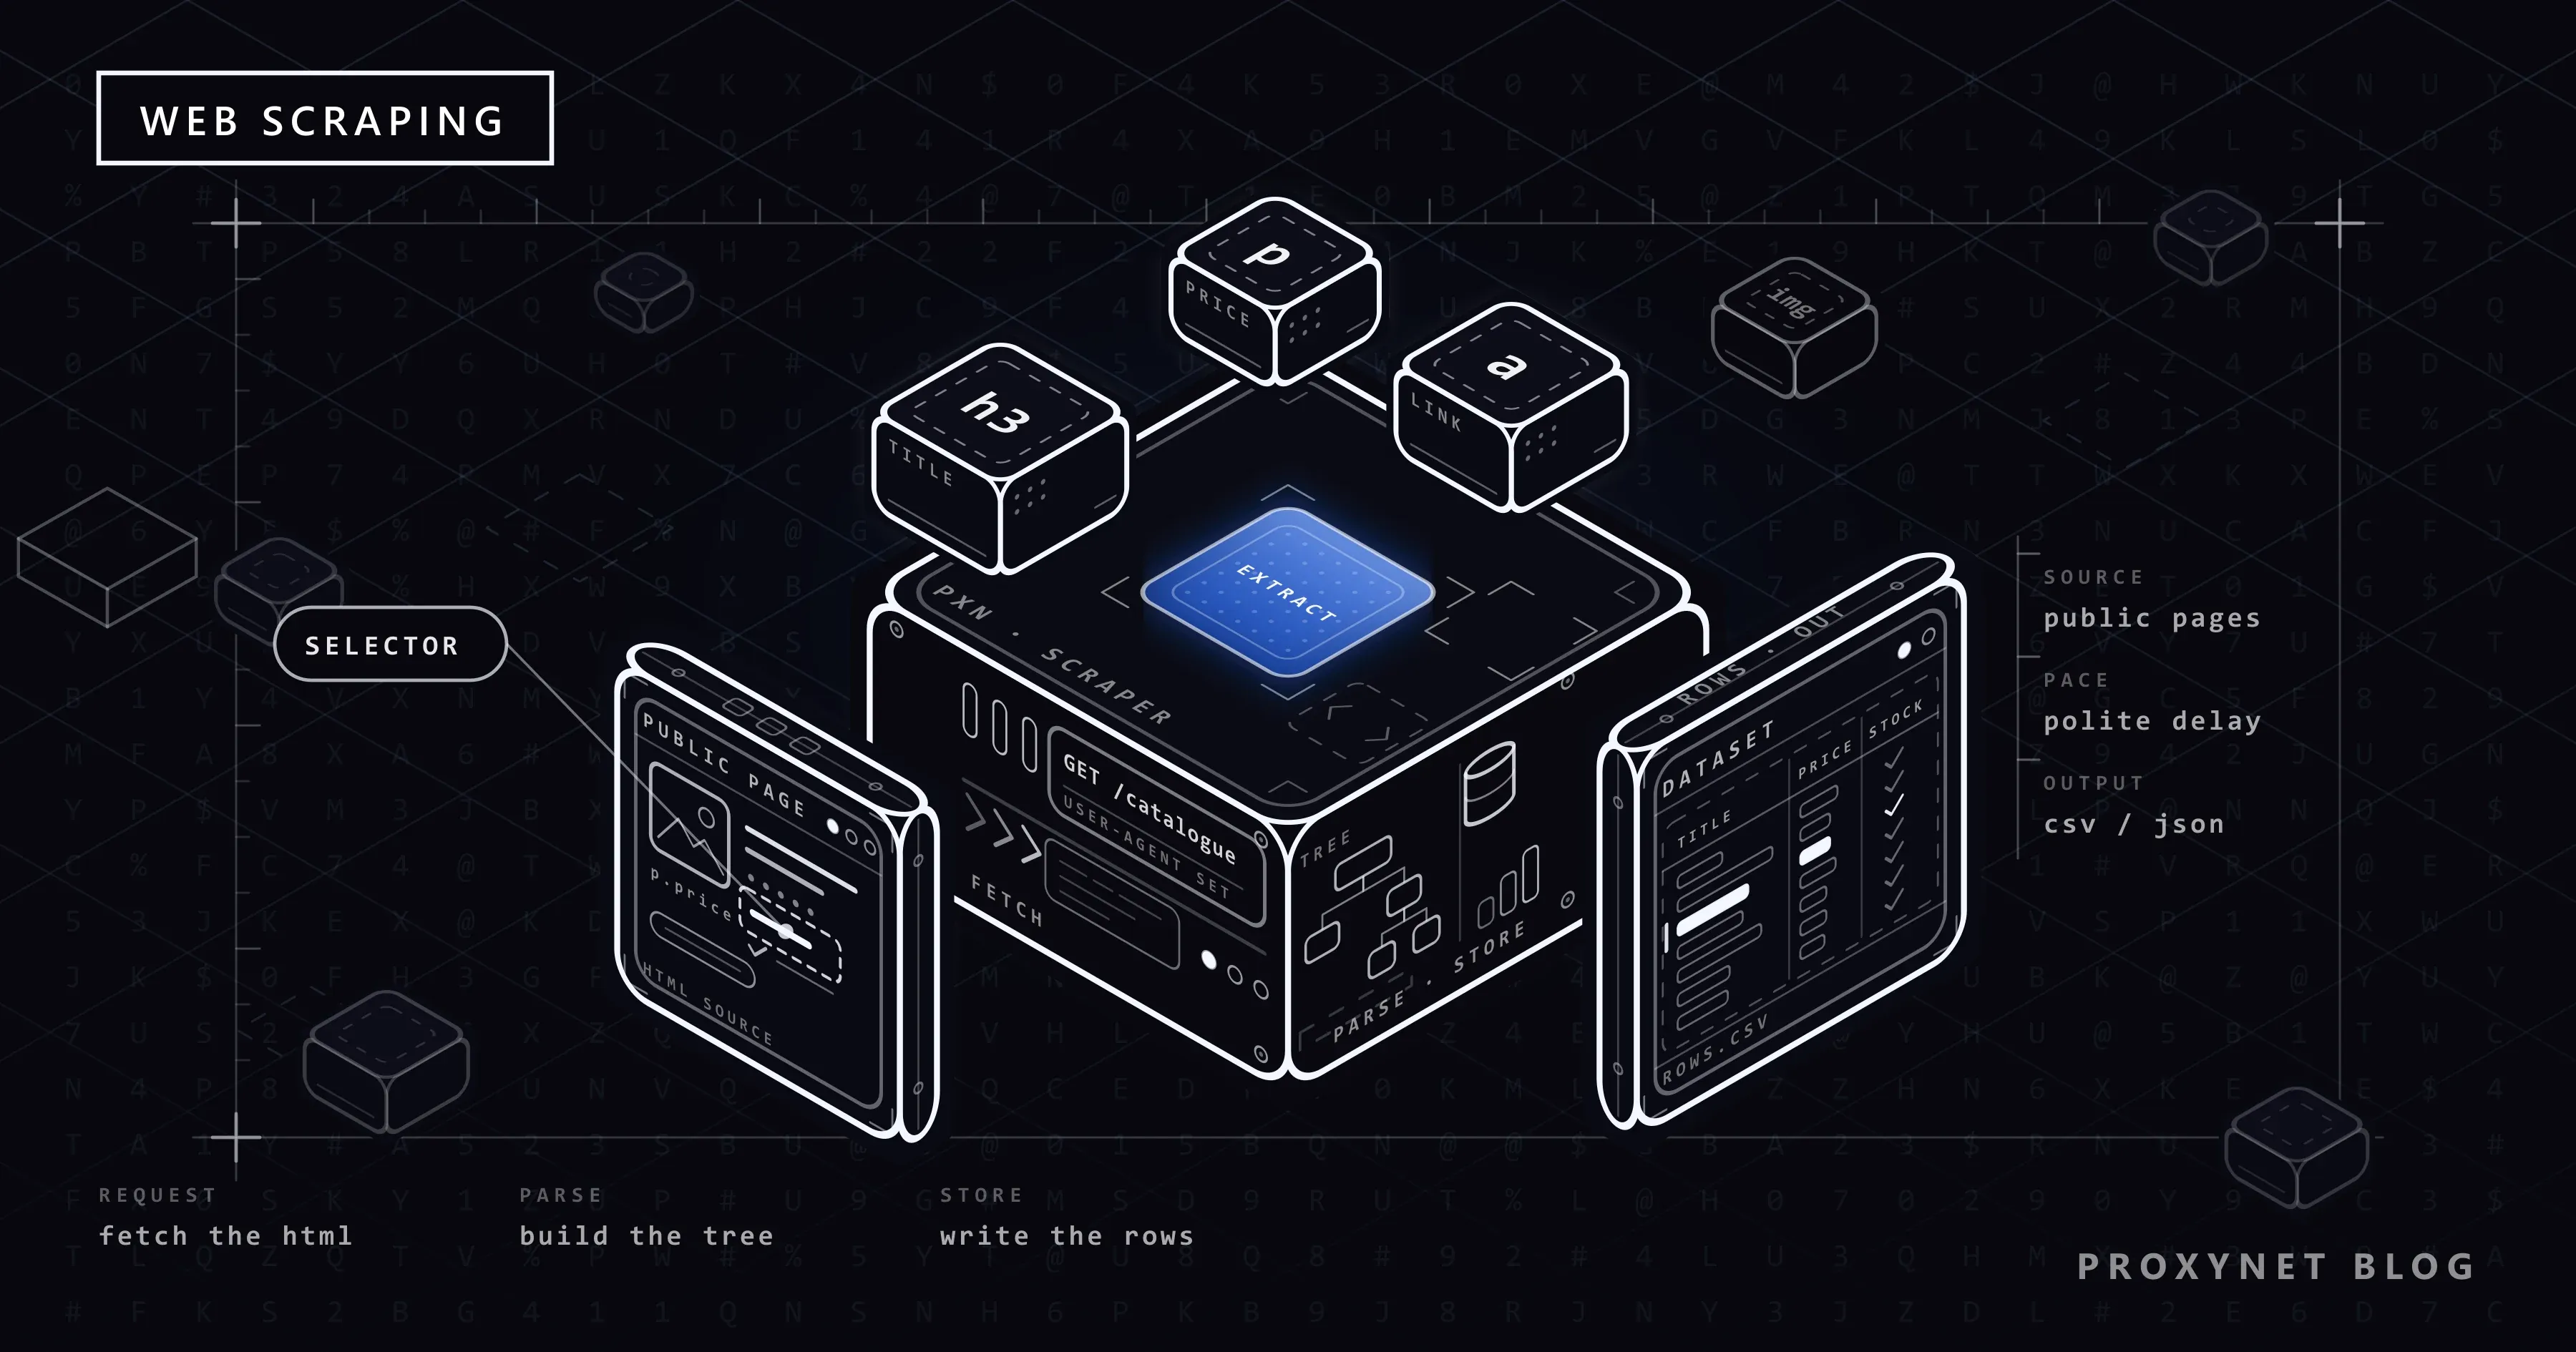
O que é web scraping e como funciona?
Web scraping é a coleta automática de dados de páginas web: um programa baixa o HTML, extrai campos e os salva. Veja como funciona e para que serve.
Autor:Acar Diveroli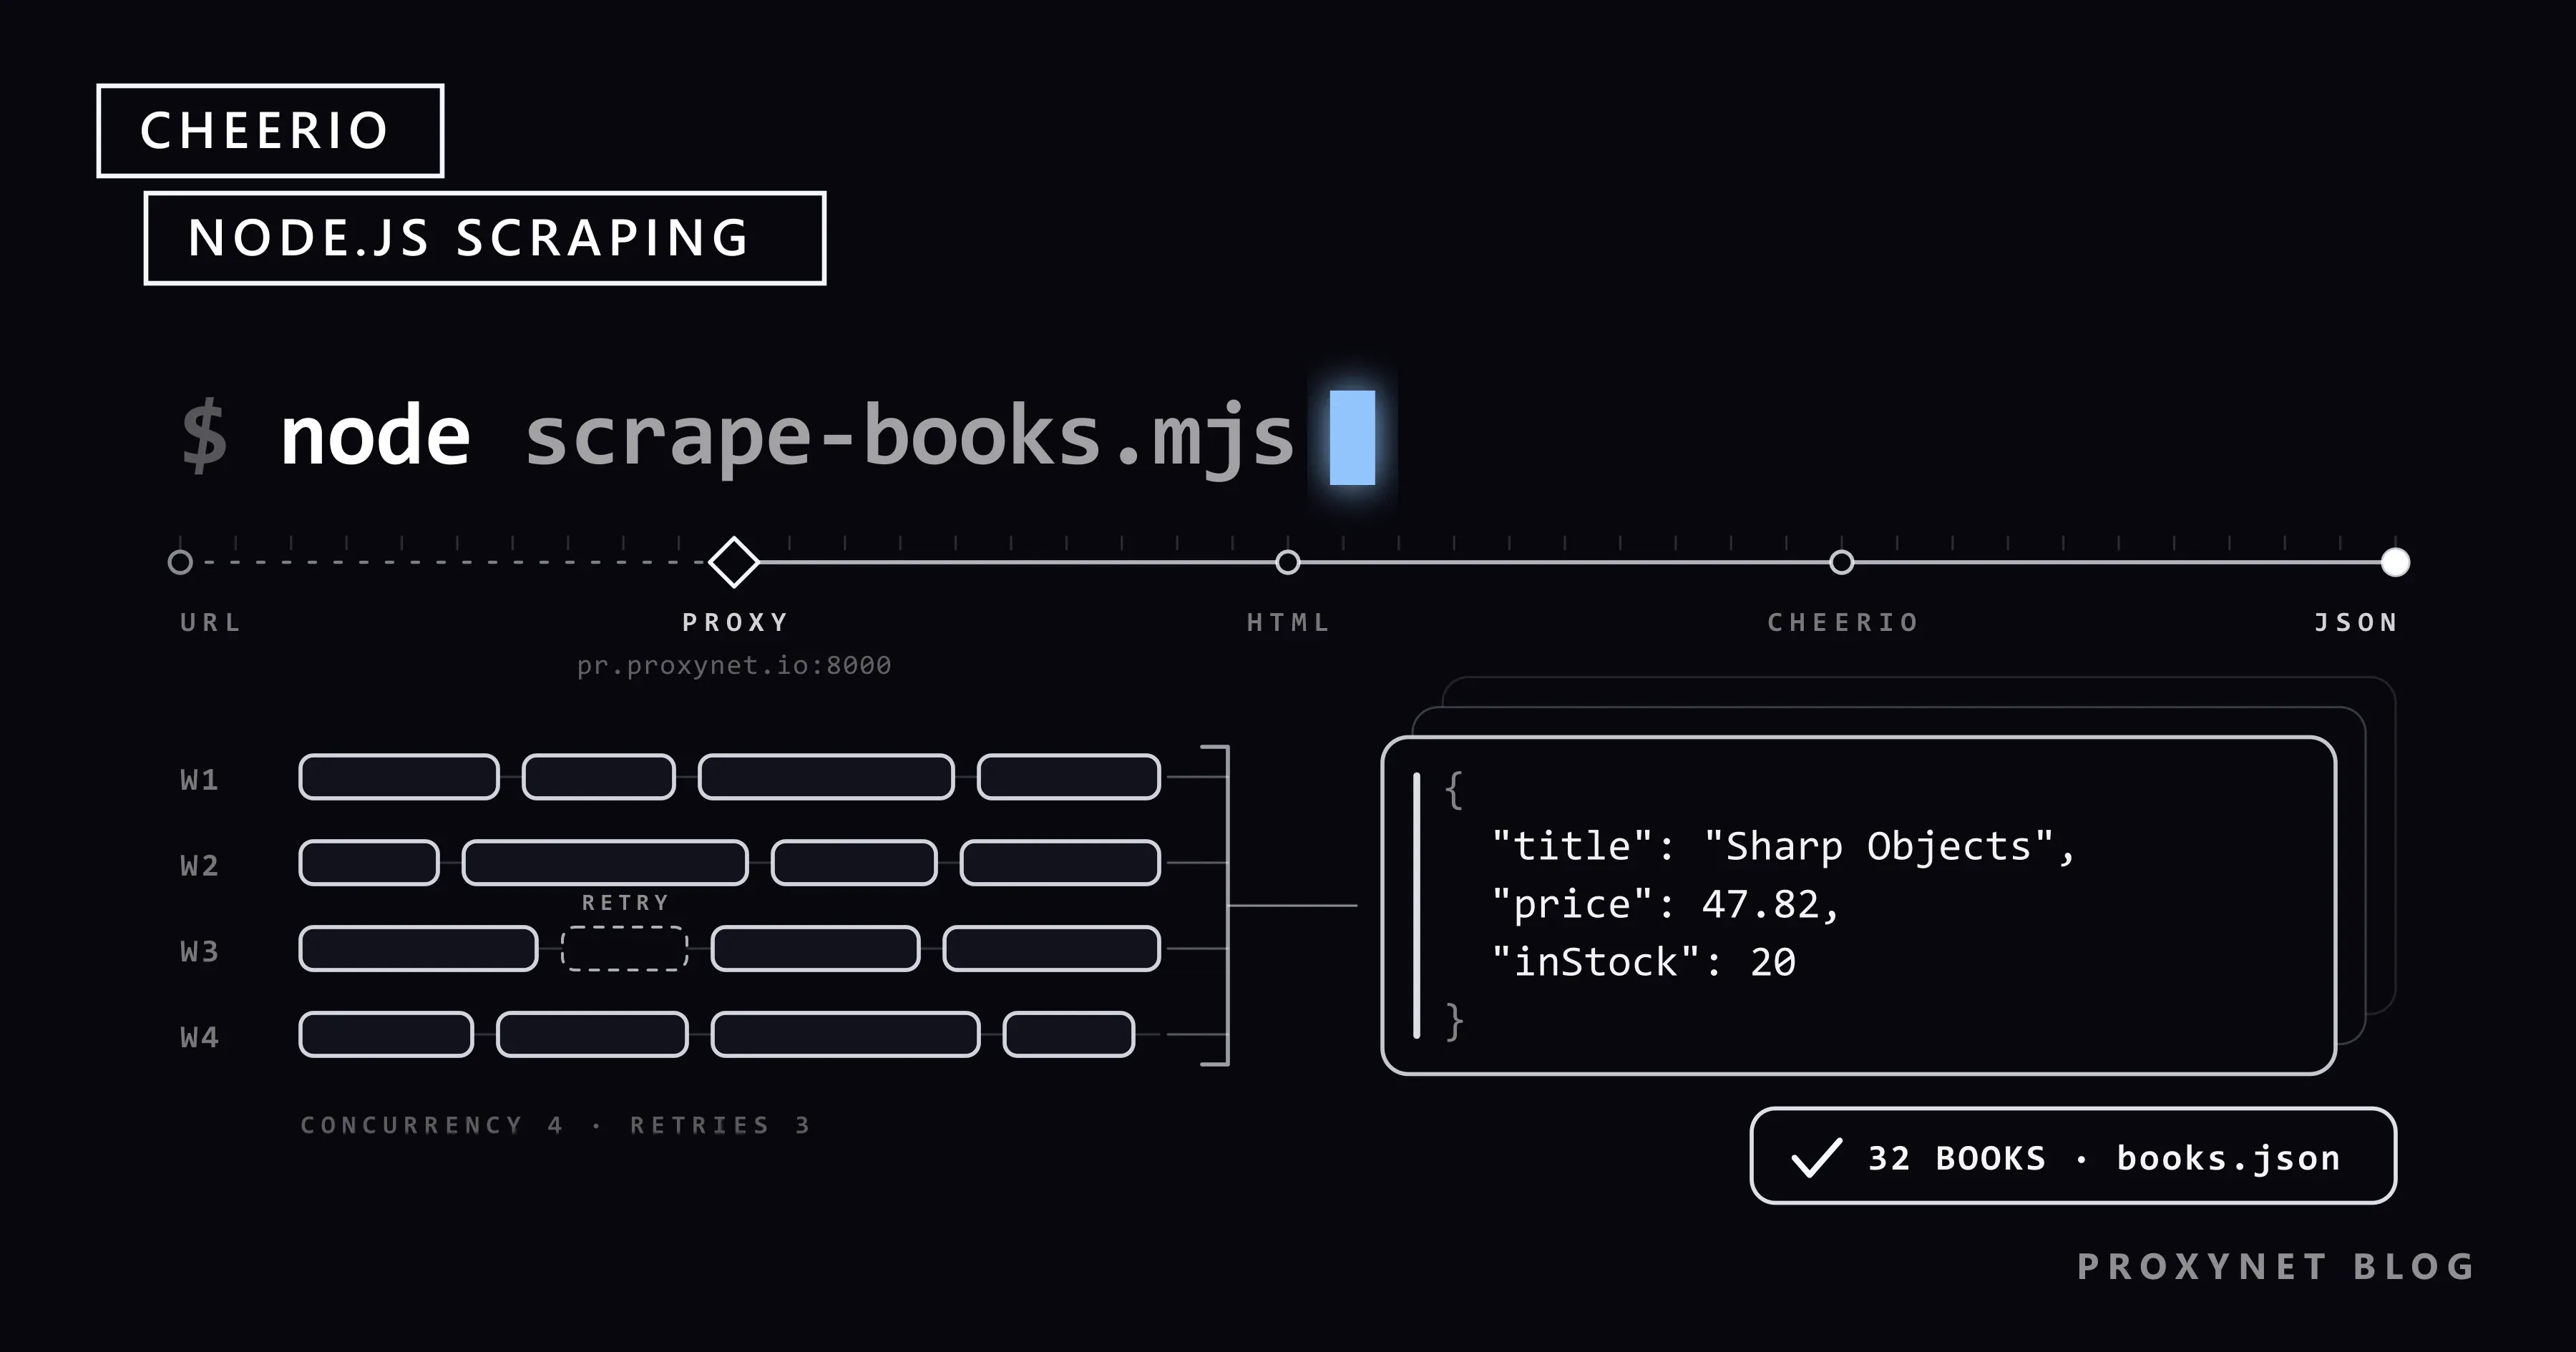
Publicado
Web scraping com Cheerio no Node.js: tutorial passo a passo
O Cheerio analisa HTML no Node.js com seletores no estilo jQuery. Crie um scraper testado com fetch, paginação, limite de concorrência, retentativas e proxy.
Autor:Acar Diveroli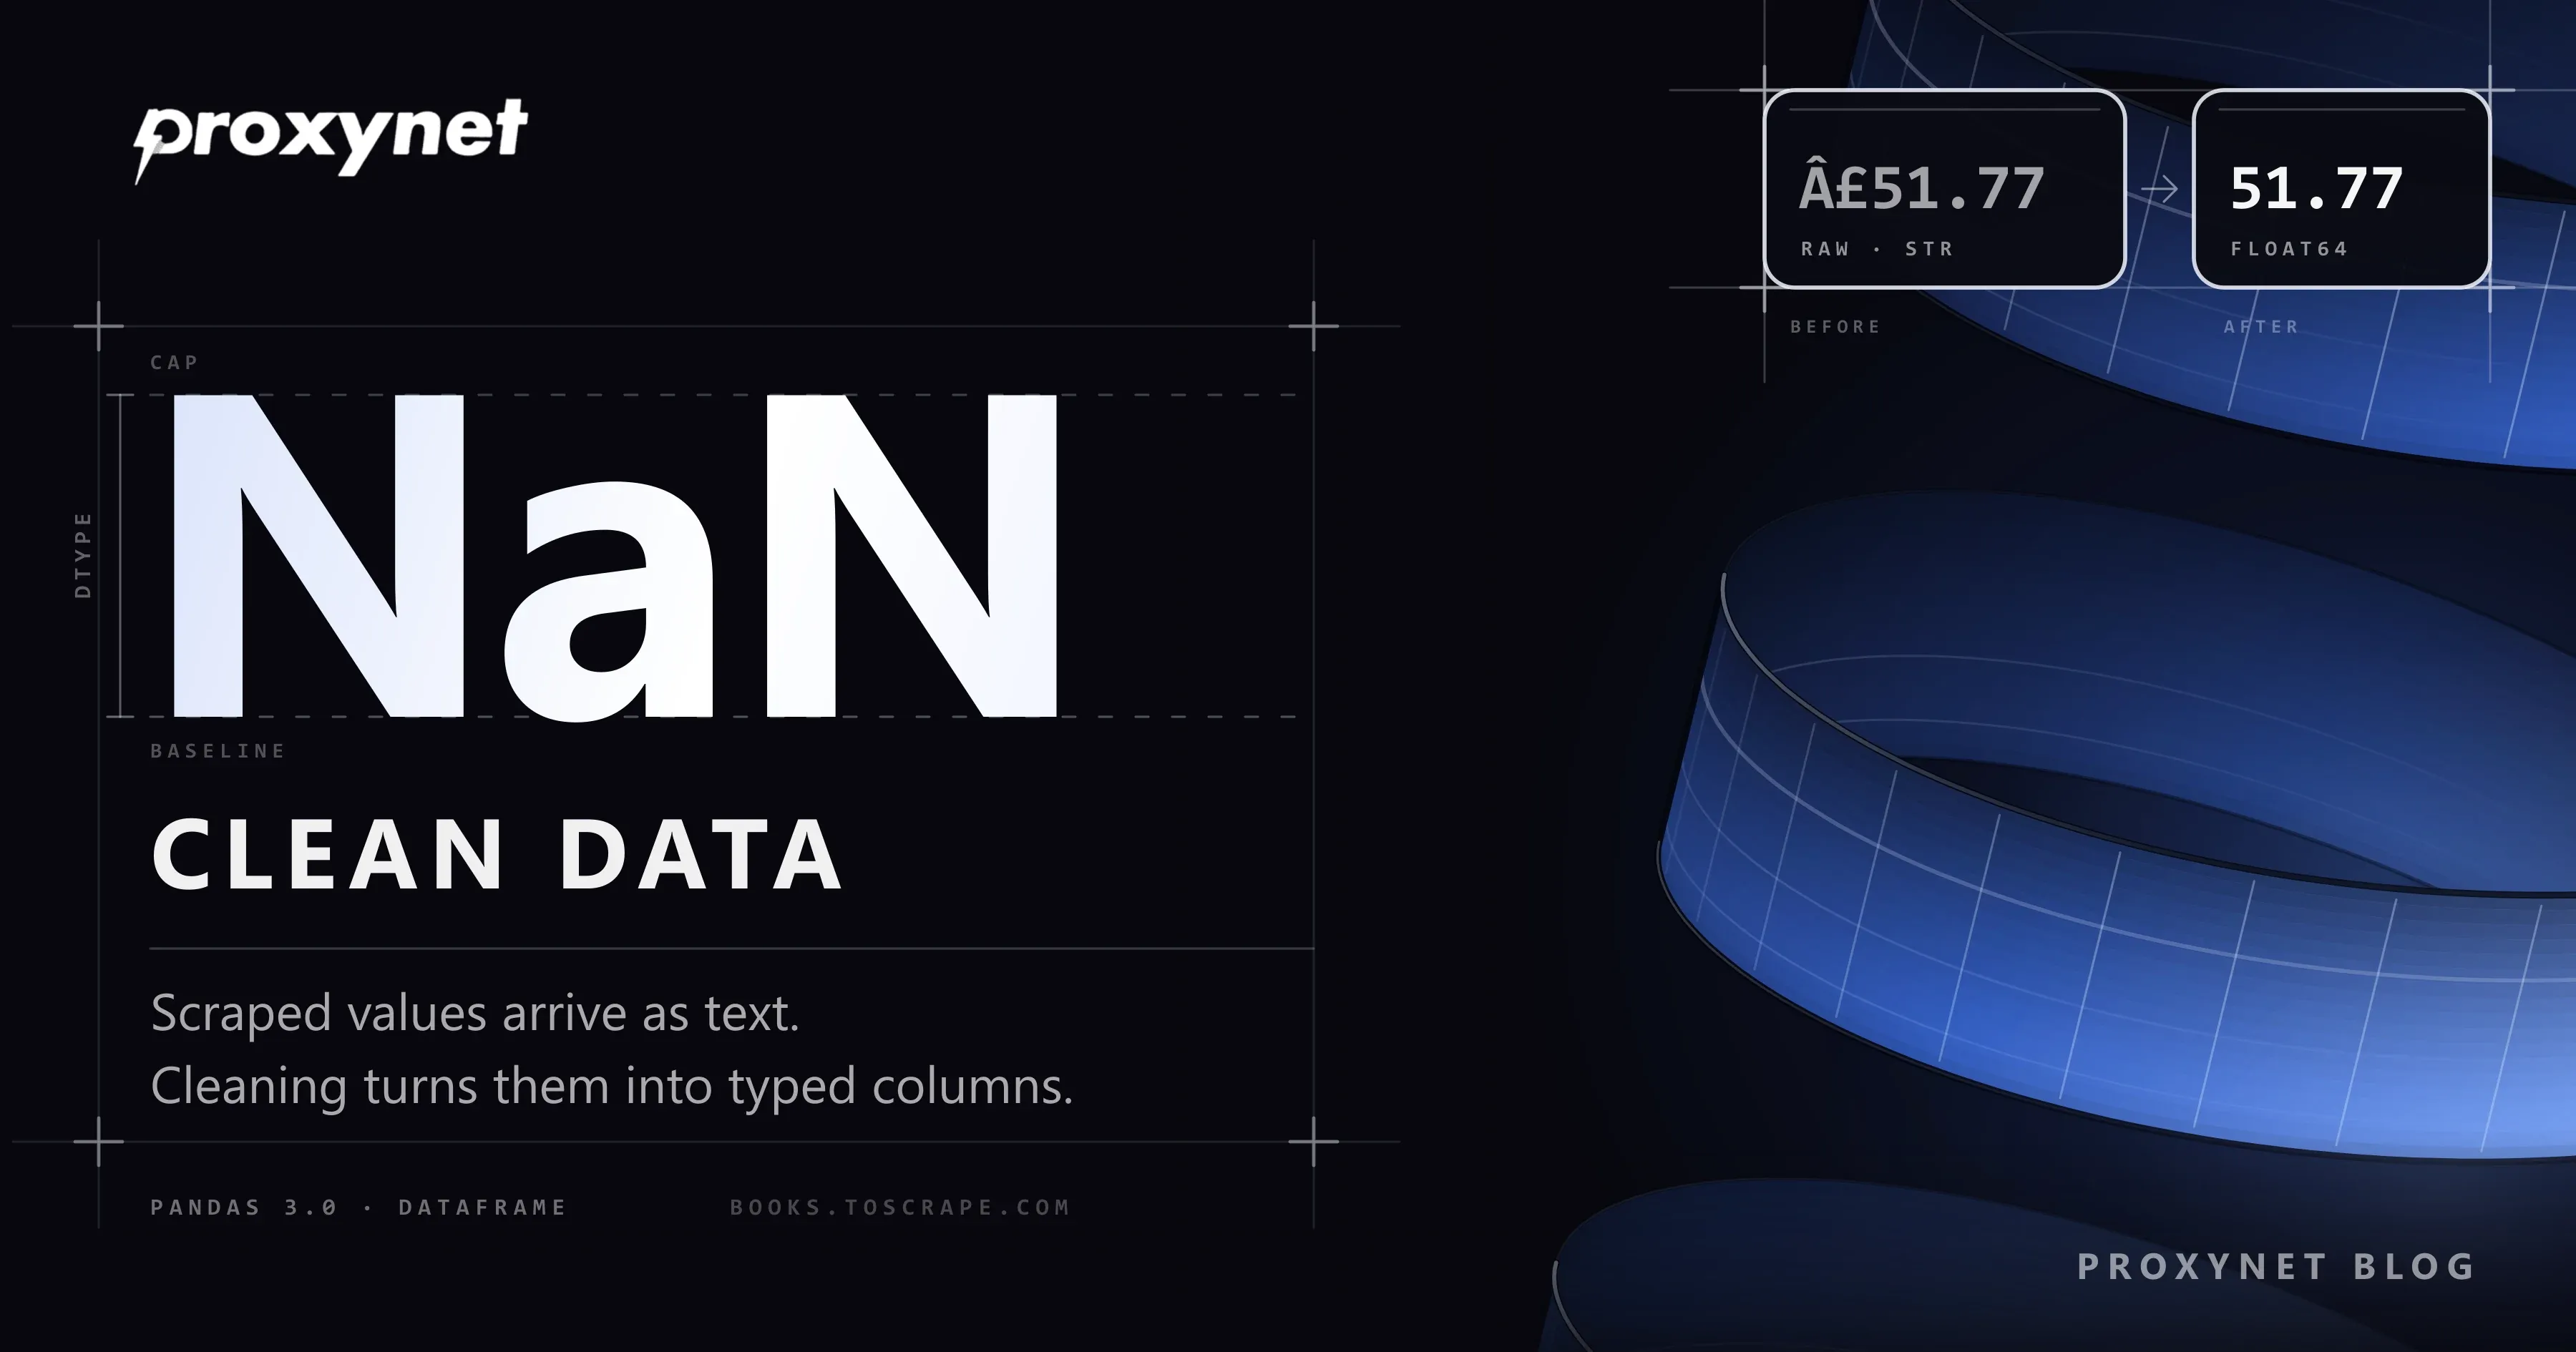
Publicado
Como limpar dados de scraping com pandas em Python
Limpe dados de scraping com pandas: primeiro o texto, depois tipos, duplicatas, valores ausentes e outliers, e valide antes de salvar. Com script testado.
Autor:Acar Diveroli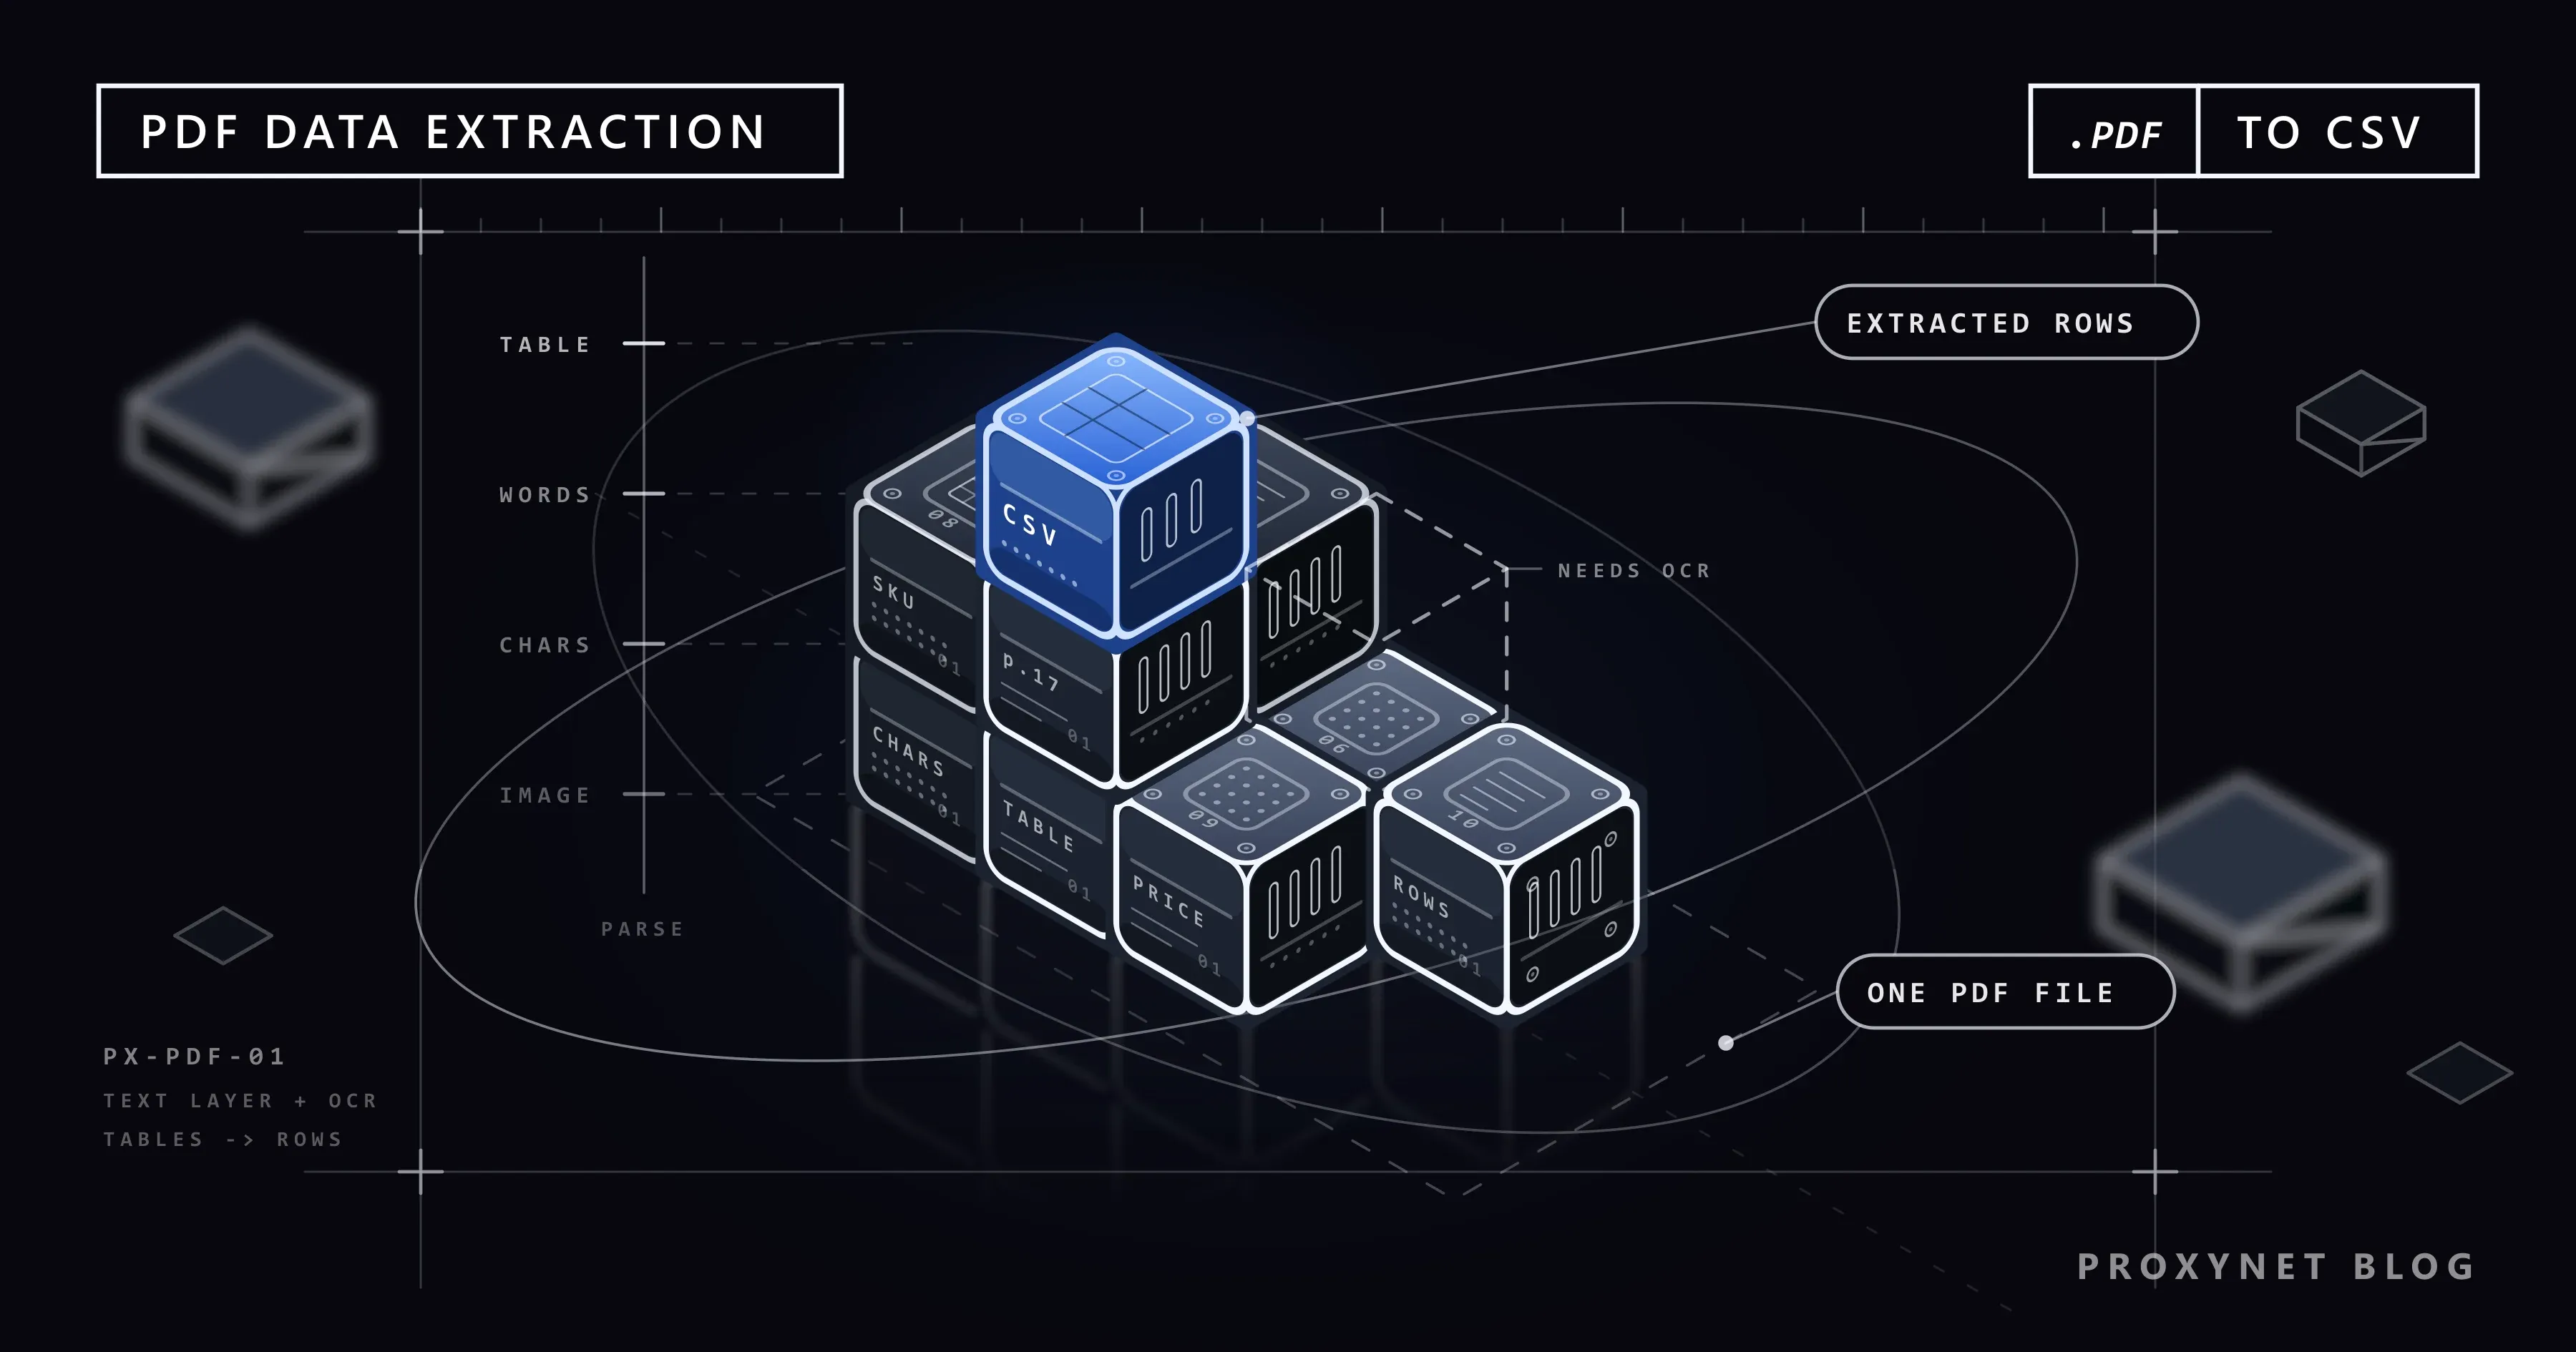
Publicado
Como extrair dados de PDF: tabelas, texto e OCR
Verifique primeiro se o PDF tem camada de texto. Se tiver, o Excel ou o pdfplumber leem as tabelas; páginas digitalizadas precisam de OCR. Com código testado.
Autor:Acar Diveroli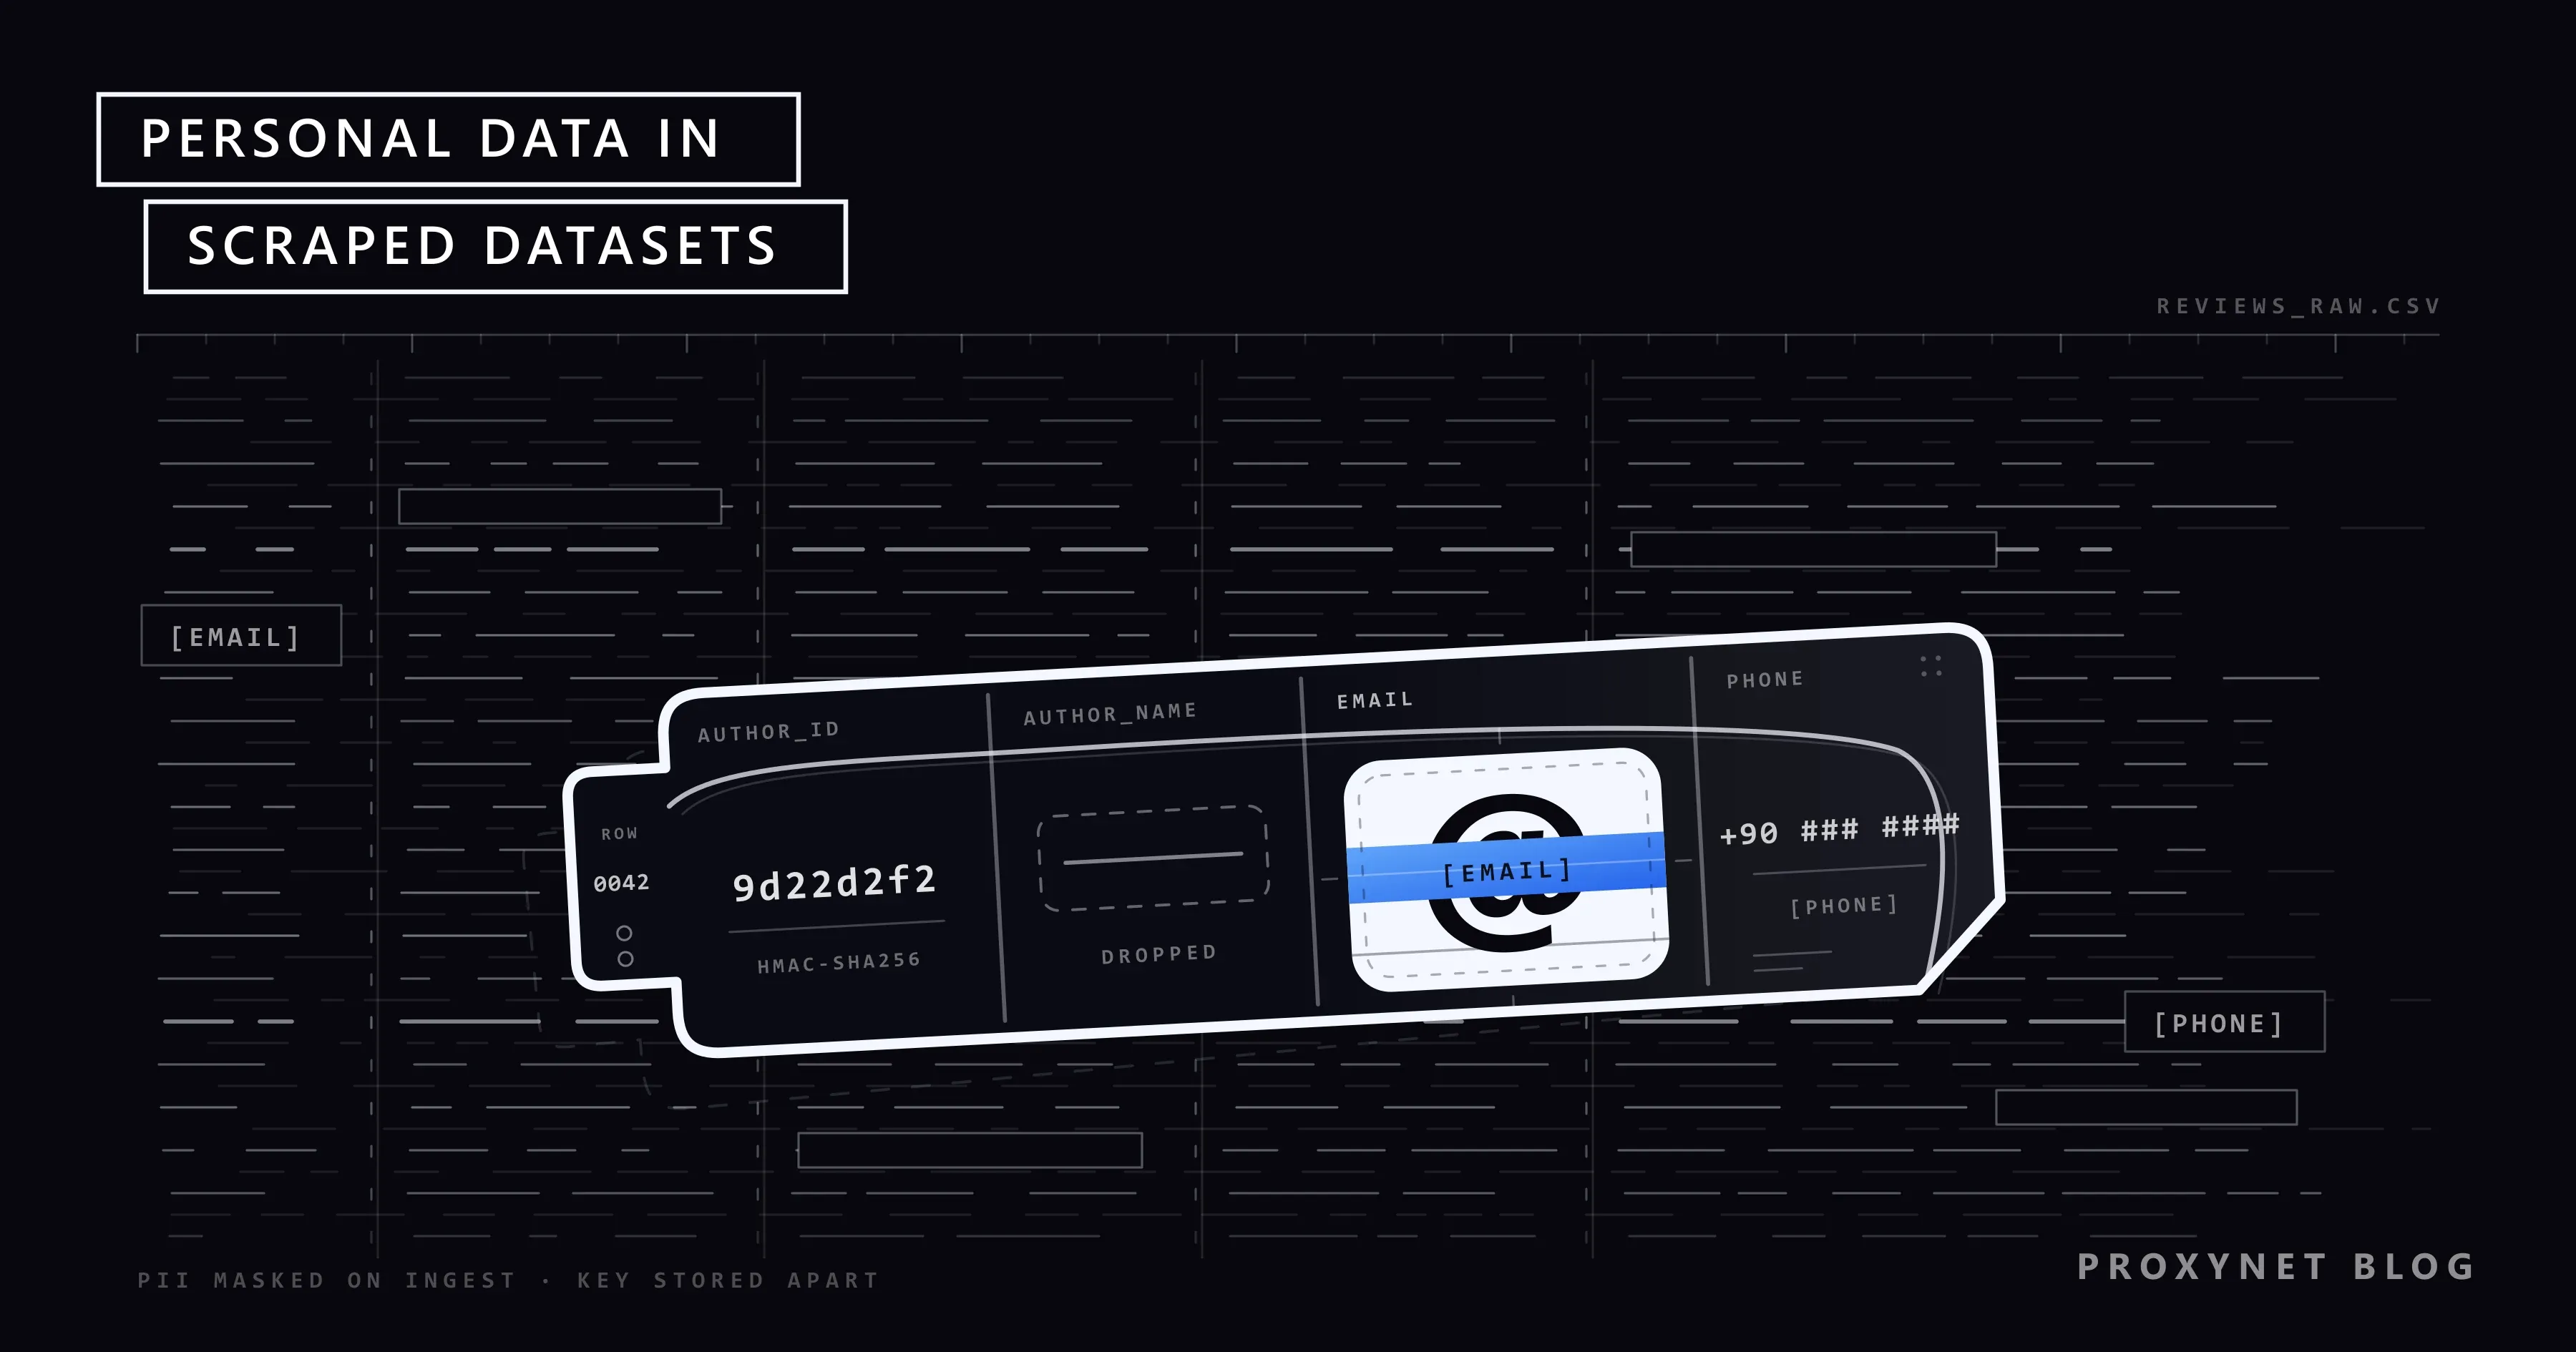
Publicado
Como tratar dados pessoais (PII) em dados de scraping
Dados de scraping costumam trazer dados pessoais: nomes, perfis, e-mails e telefones. Como encontrá-los, reduzi-los, mascará-los e armazená-los com segurança.
Autor:Acar Diveroli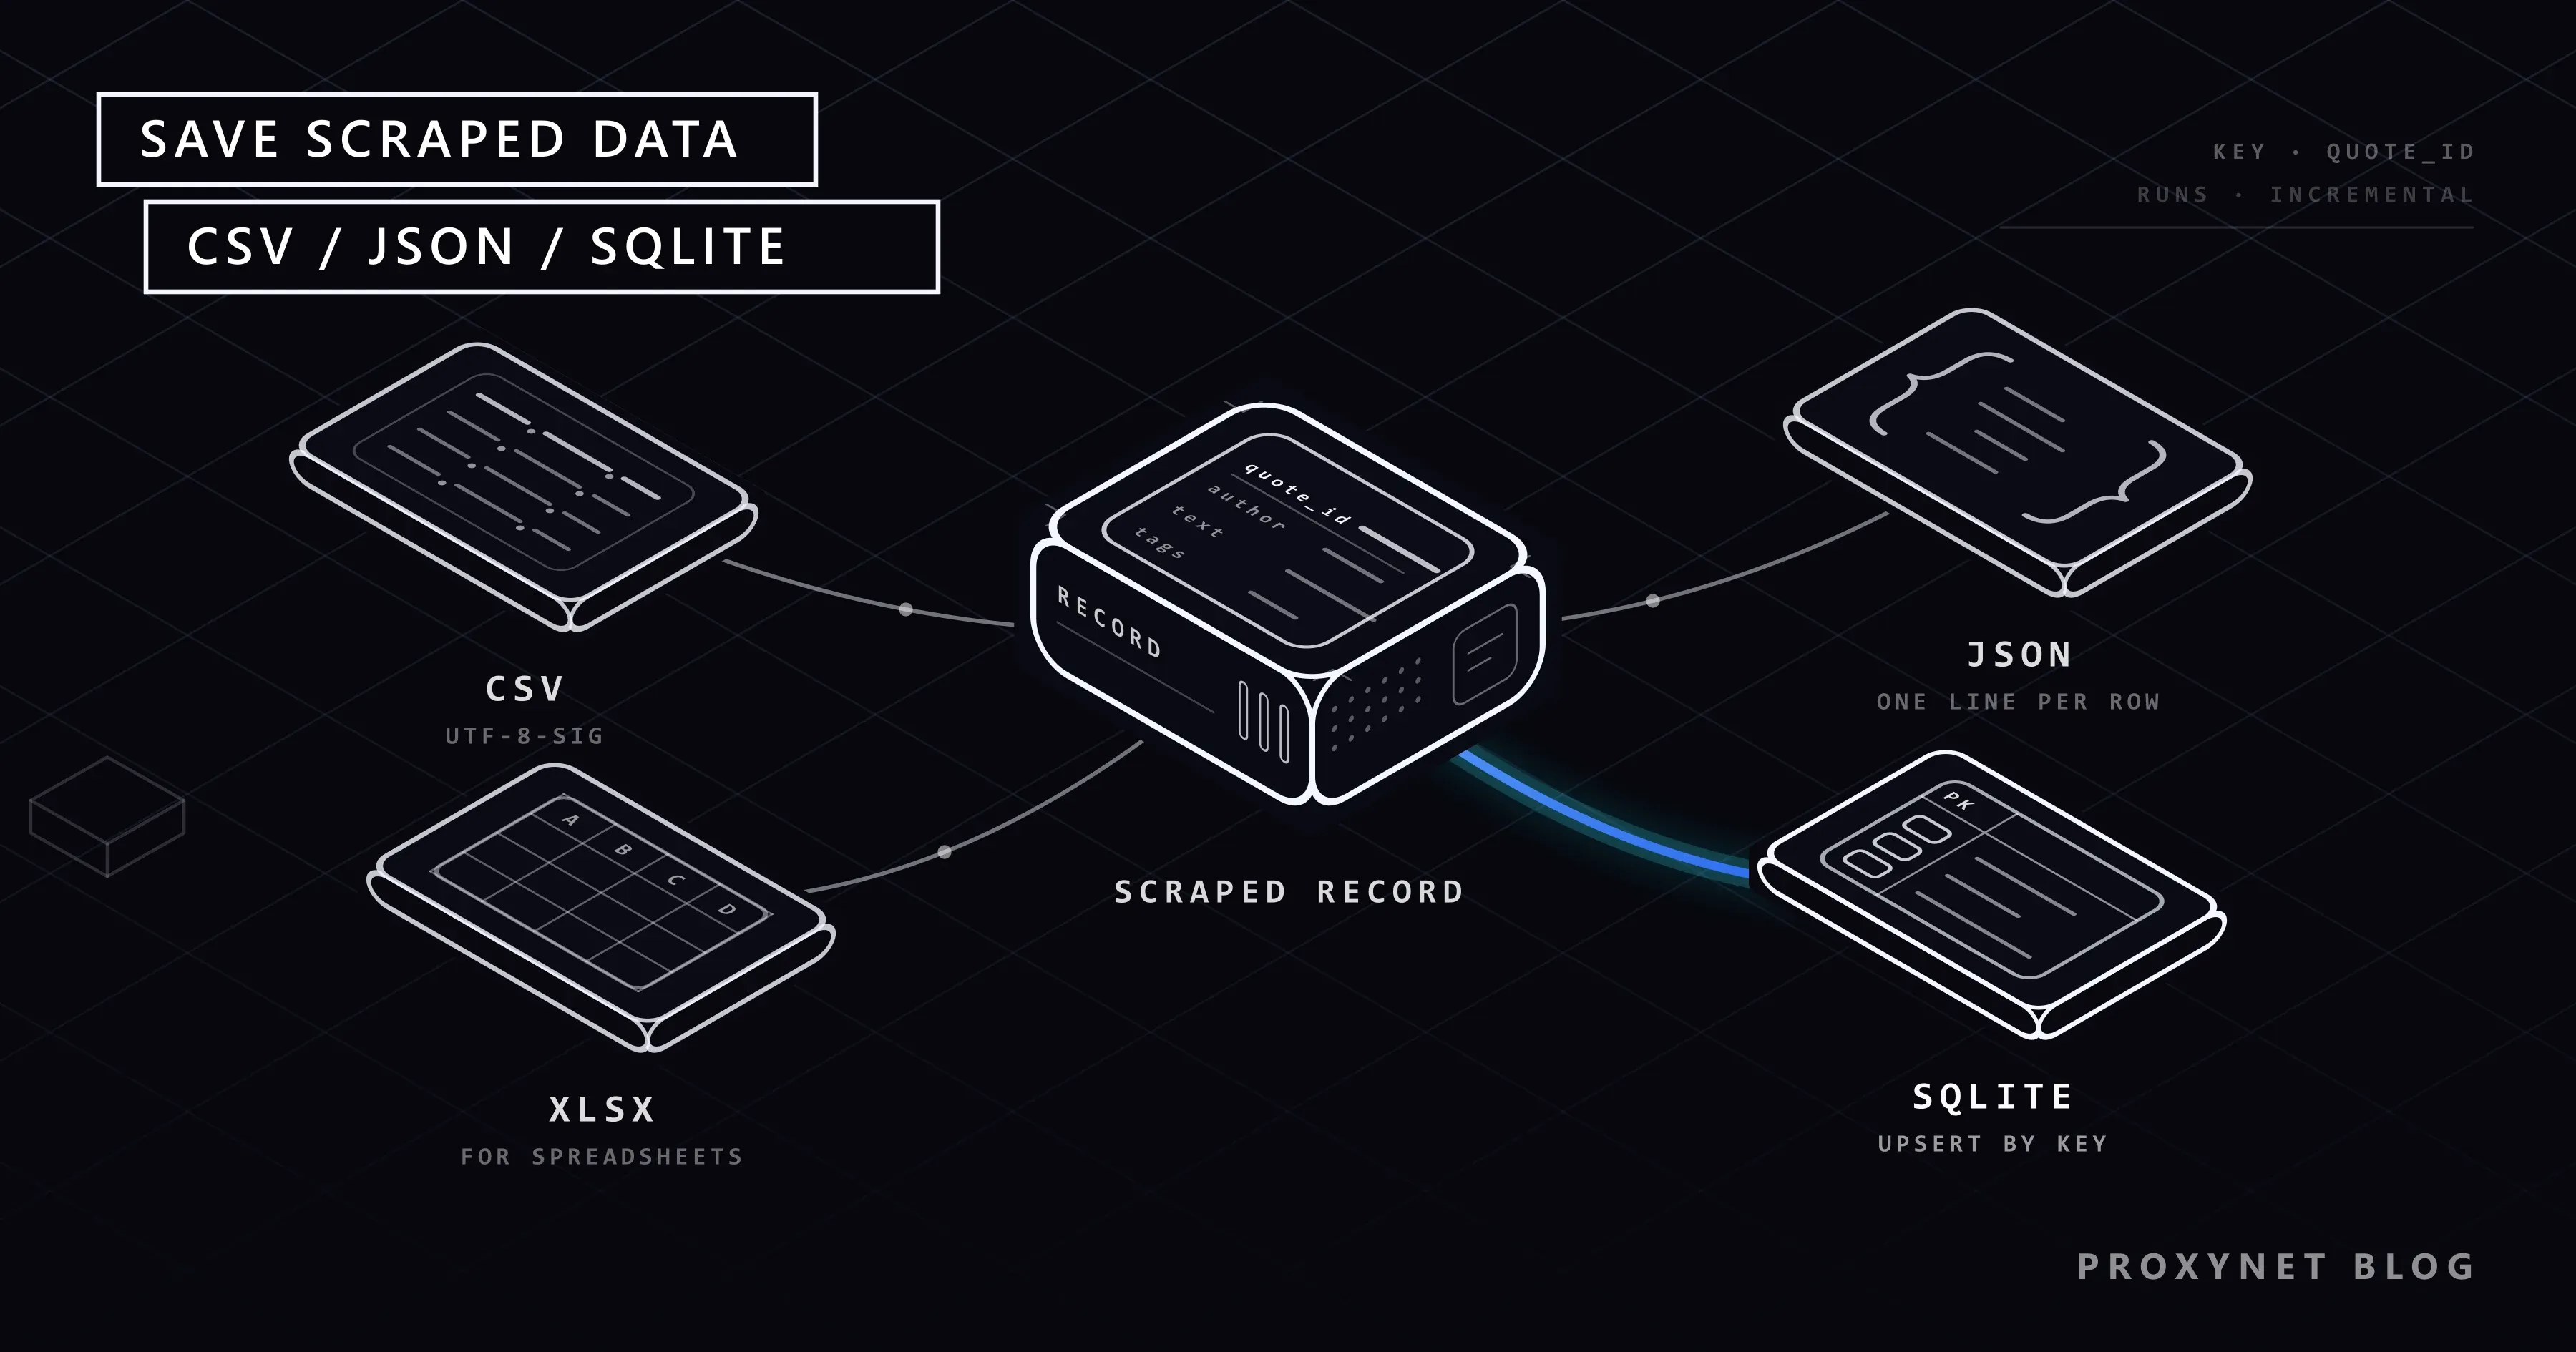
Publicado
Como salvar dados de scraping em CSV, JSON e SQLite
Salve os dados coletados em CSV para planilhas, JSON Lines para logs que só crescem e SQLite para execuções sem duplicatas. Com código Python testado.
Autor:Acar Diveroli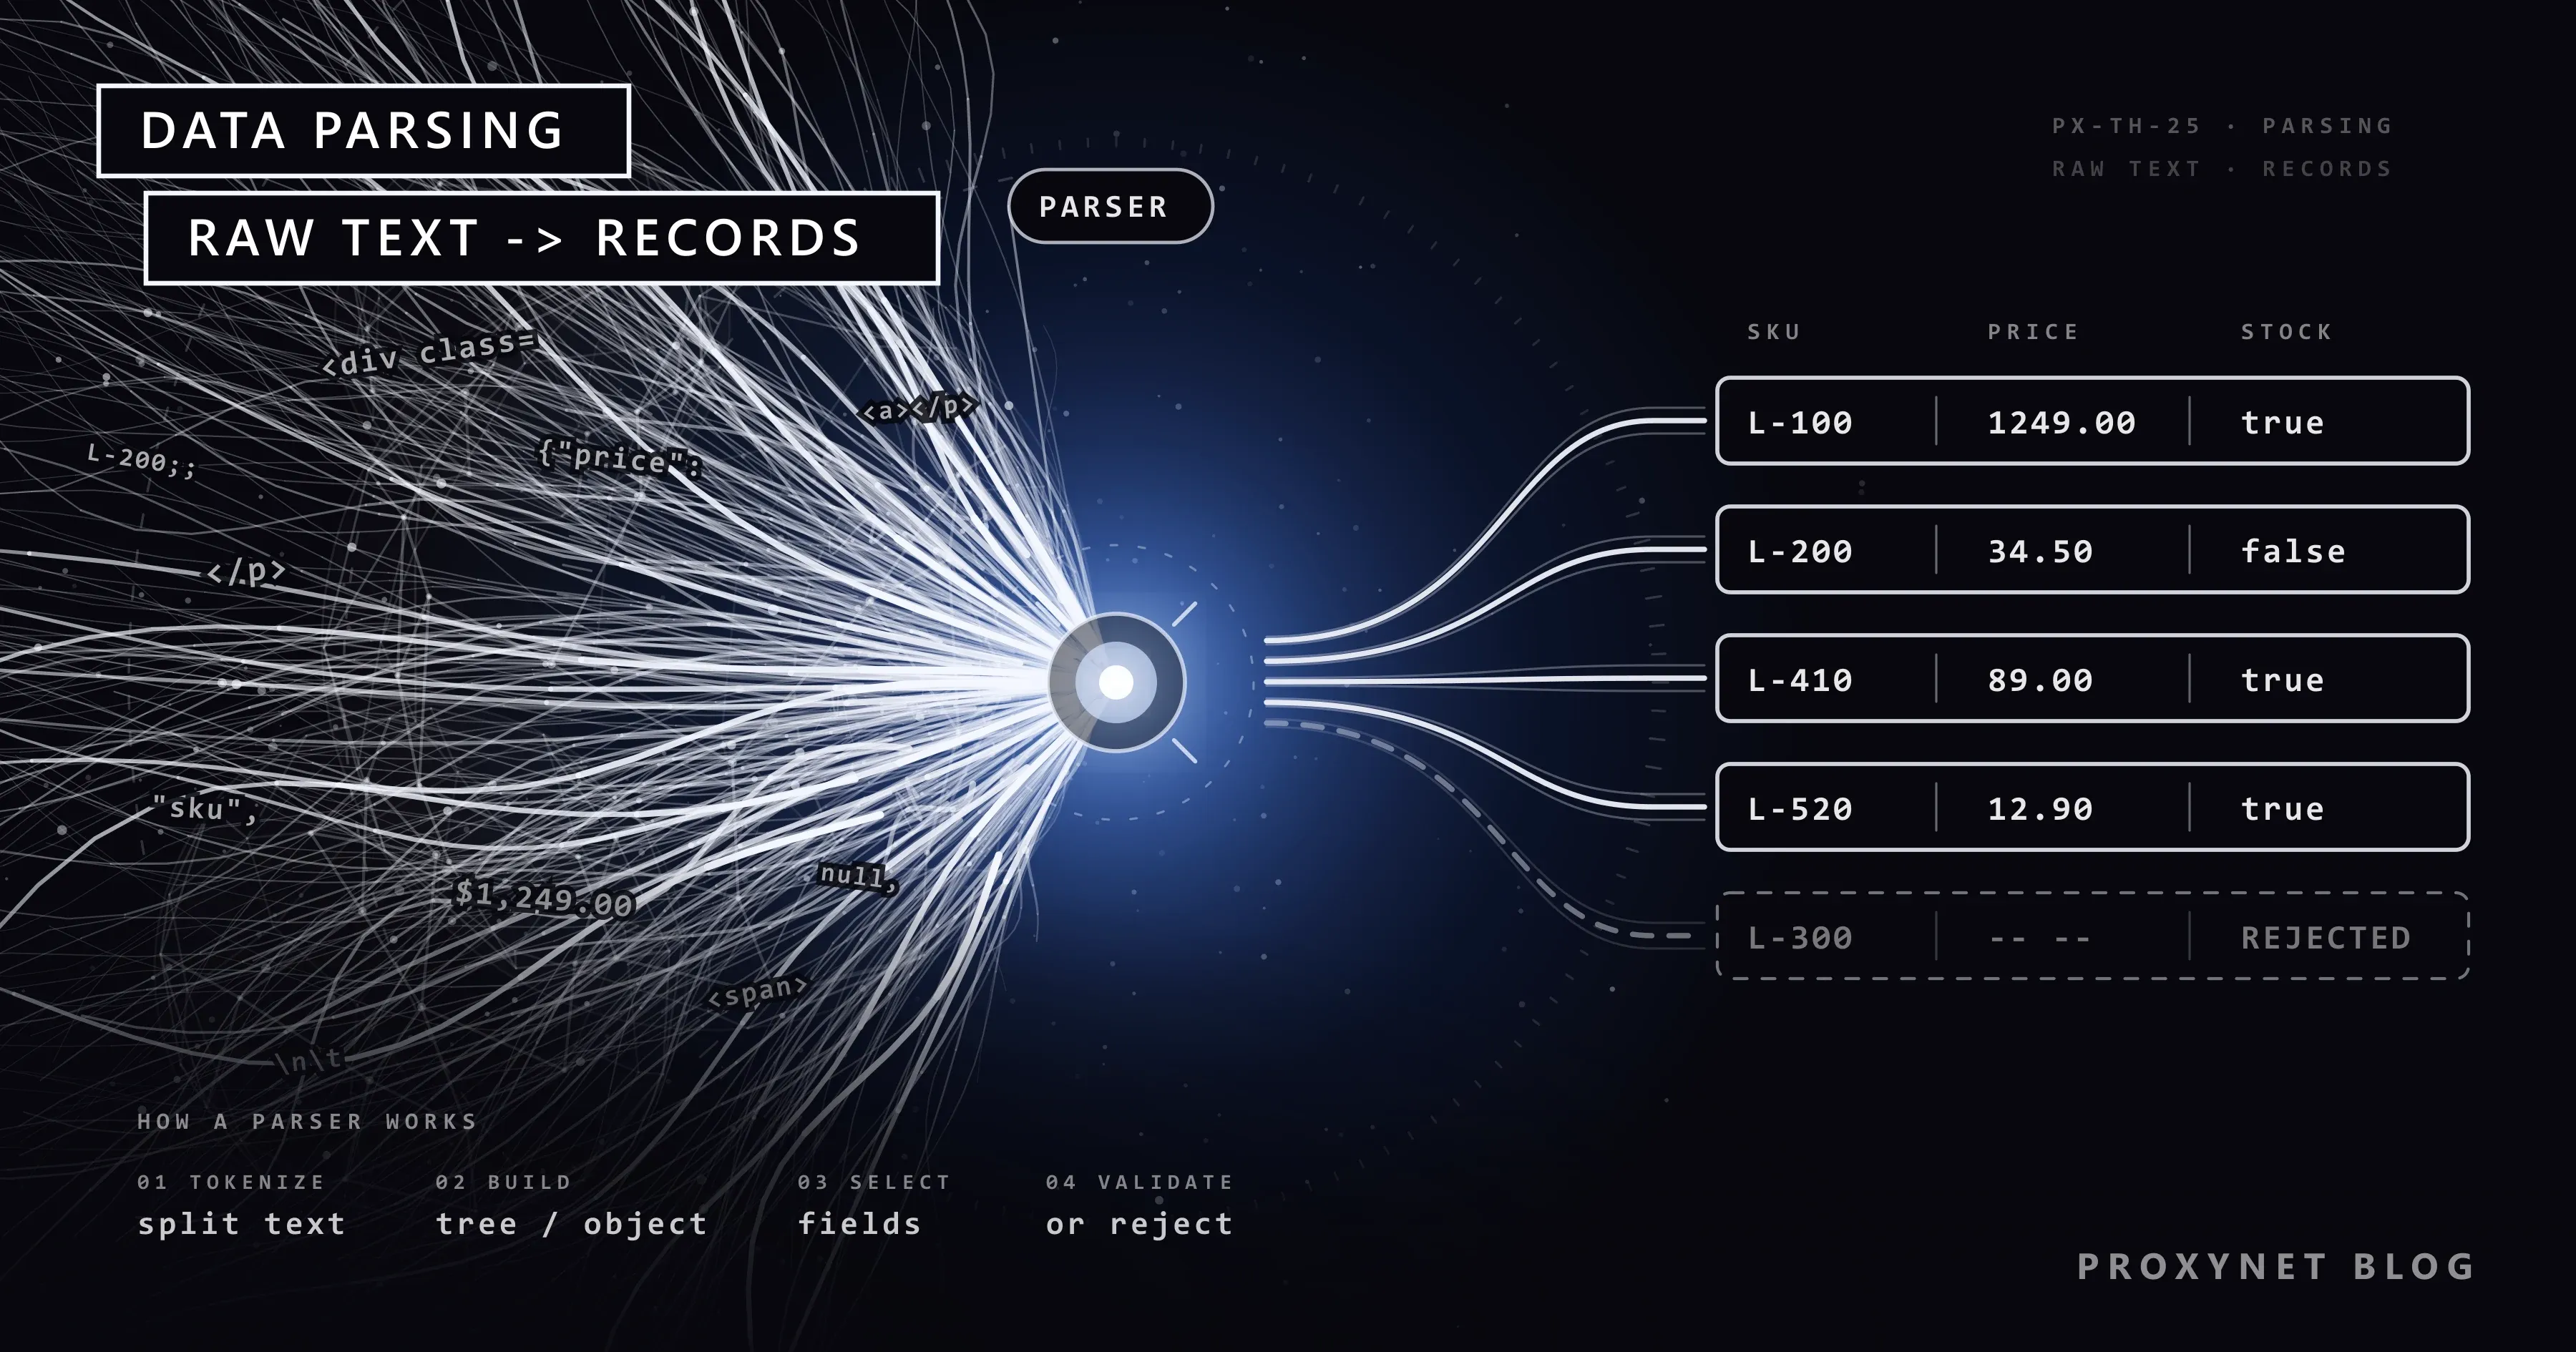
Publicado
O que é parsing de dados? Tipos, erros e exemplos
O parsing de dados transforma HTML, JSON, CSV ou logs em registros estruturados para o seu código. Como um parser funciona, os tipos e os erros mais comuns.
Autor:Acar Diveroli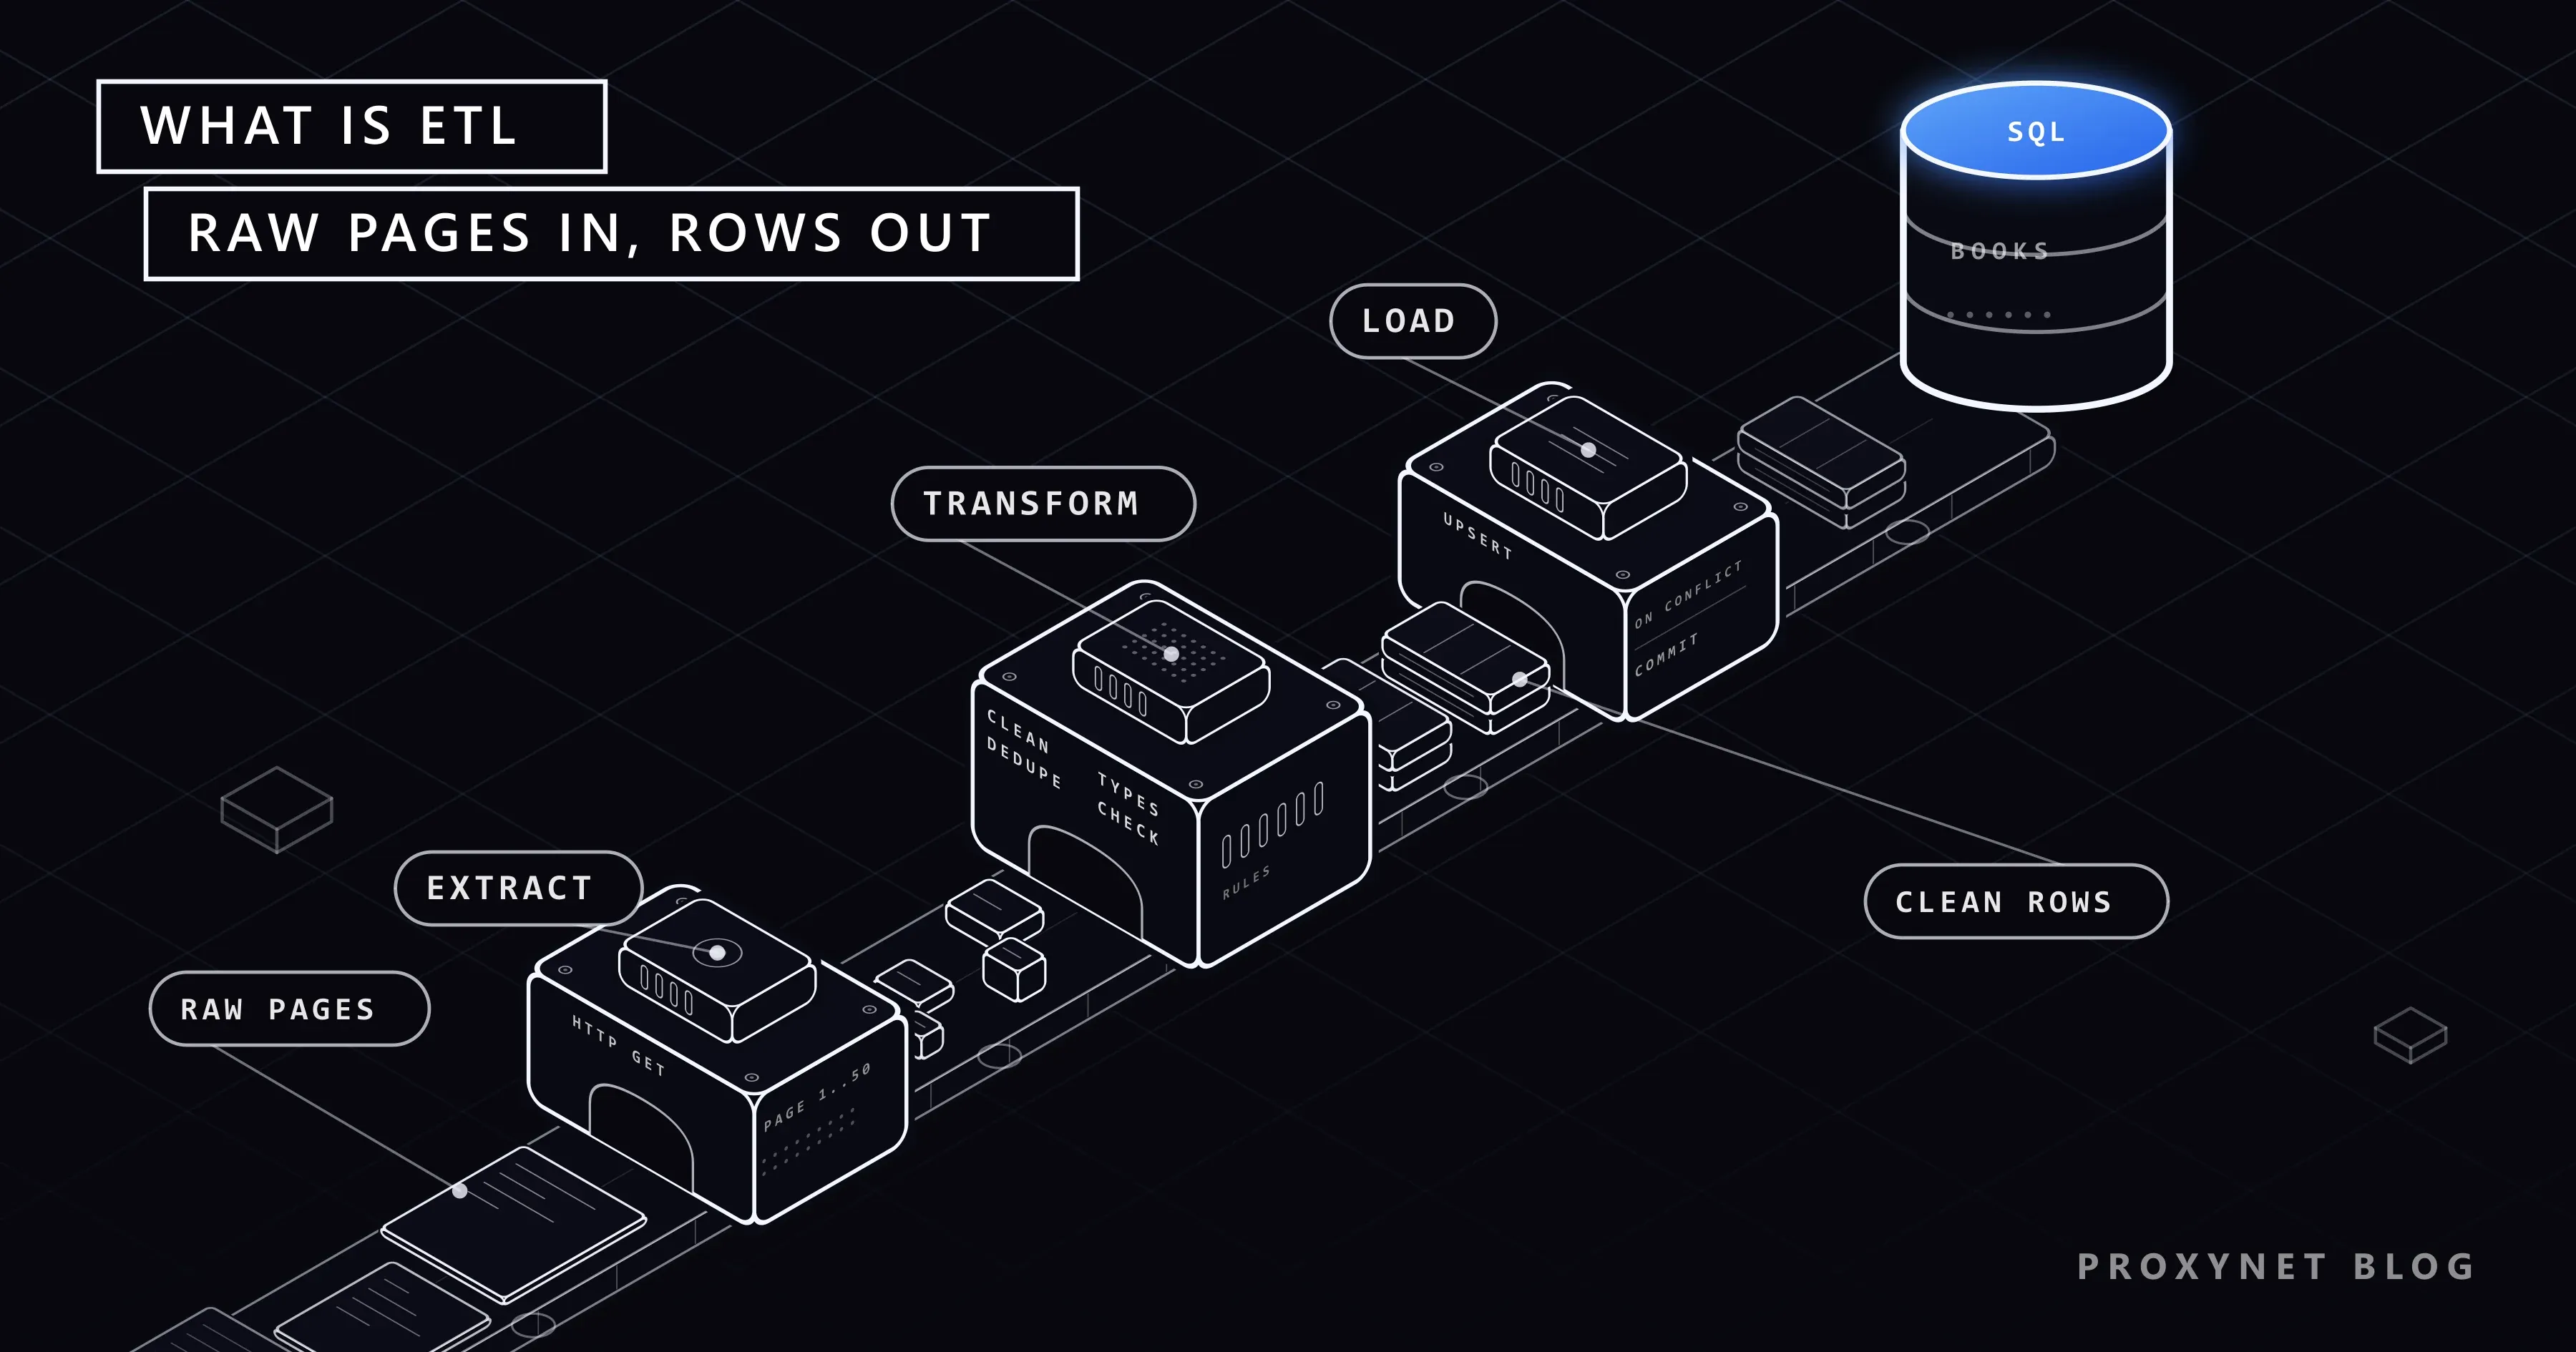
Publicado
O que é ETL? Extração, transformação e carga com Python
ETL é extrair dados de uma fonte, limpá-los em um formato fixo e carregá-los em um banco de dados. Como funciona, ETL vs. ELT e um job em Python testado.
Autor:Acar Diveroli
Publicado
POST com JSON no Python Requests: equivalentes do cURL
Para enviar JSON via POST no Python Requests, chame requests.post(url, json=data) e o Content-Type é definido para você. Veja data=, params=, headers e o cURL.
Autor:Acar Diveroli
Publicado
Como criar um web crawler em Python, passo a passo
Um web crawler em Python enfileira os links que acha a partir da URL inicial e visita cada página uma vez. Montamos fila, normalização, profundidade e escopo.
Autor:Acar Diveroli
Publicado
O que é o BeautifulSoup e como usá-lo em Python?
O BeautifulSoup é uma biblioteca Python que transforma o HTML baixado em uma árvore pesquisável. Veja a escolha do parser, find_all ou select e tabelas HTML.
Autor:Acar Diveroli
Web scraping vs. API: qual você deve usar?
Autor: Acar DiveroliComparativosPublicado
O que é web scraping e como funciona?
Autor: Acar DiveroliWeb scrapingPublicado
Web scraping com Cheerio no Node.js: tutorial passo a passo
Autor: Acar DiveroliTutoriaisPublicado
Como limpar dados de scraping com pandas em Python
Autor: Acar DiveroliTutoriaisPublicado
Como extrair dados de PDF: tabelas, texto e OCR
Autor: Acar DiveroliTutoriaisPublicado
Como tratar dados pessoais (PII) em dados de scraping
Autor: Acar DiveroliWeb scrapingPublicado
Como salvar dados de scraping em CSV, JSON e SQLite
Autor: Acar DiveroliTutoriaisPublicado
O que é parsing de dados? Tipos, erros e exemplos
Autor: Acar DiveroliWeb scrapingPublicado
O que é ETL? Extração, transformação e carga com Python
Autor: Acar DiveroliWeb scrapingPublicado
POST com JSON no Python Requests: equivalentes do cURL
Autor: Acar DiveroliTutoriaisPublicado
Como criar um web crawler em Python, passo a passo
Autor: Acar DiveroliWeb scrapingPublicado
O que é o BeautifulSoup e como usá-lo em Python?
Autor: Acar DiveroliWeb scrapingPublicado
Nenhum artigo encontrado
Publicado
Publicado