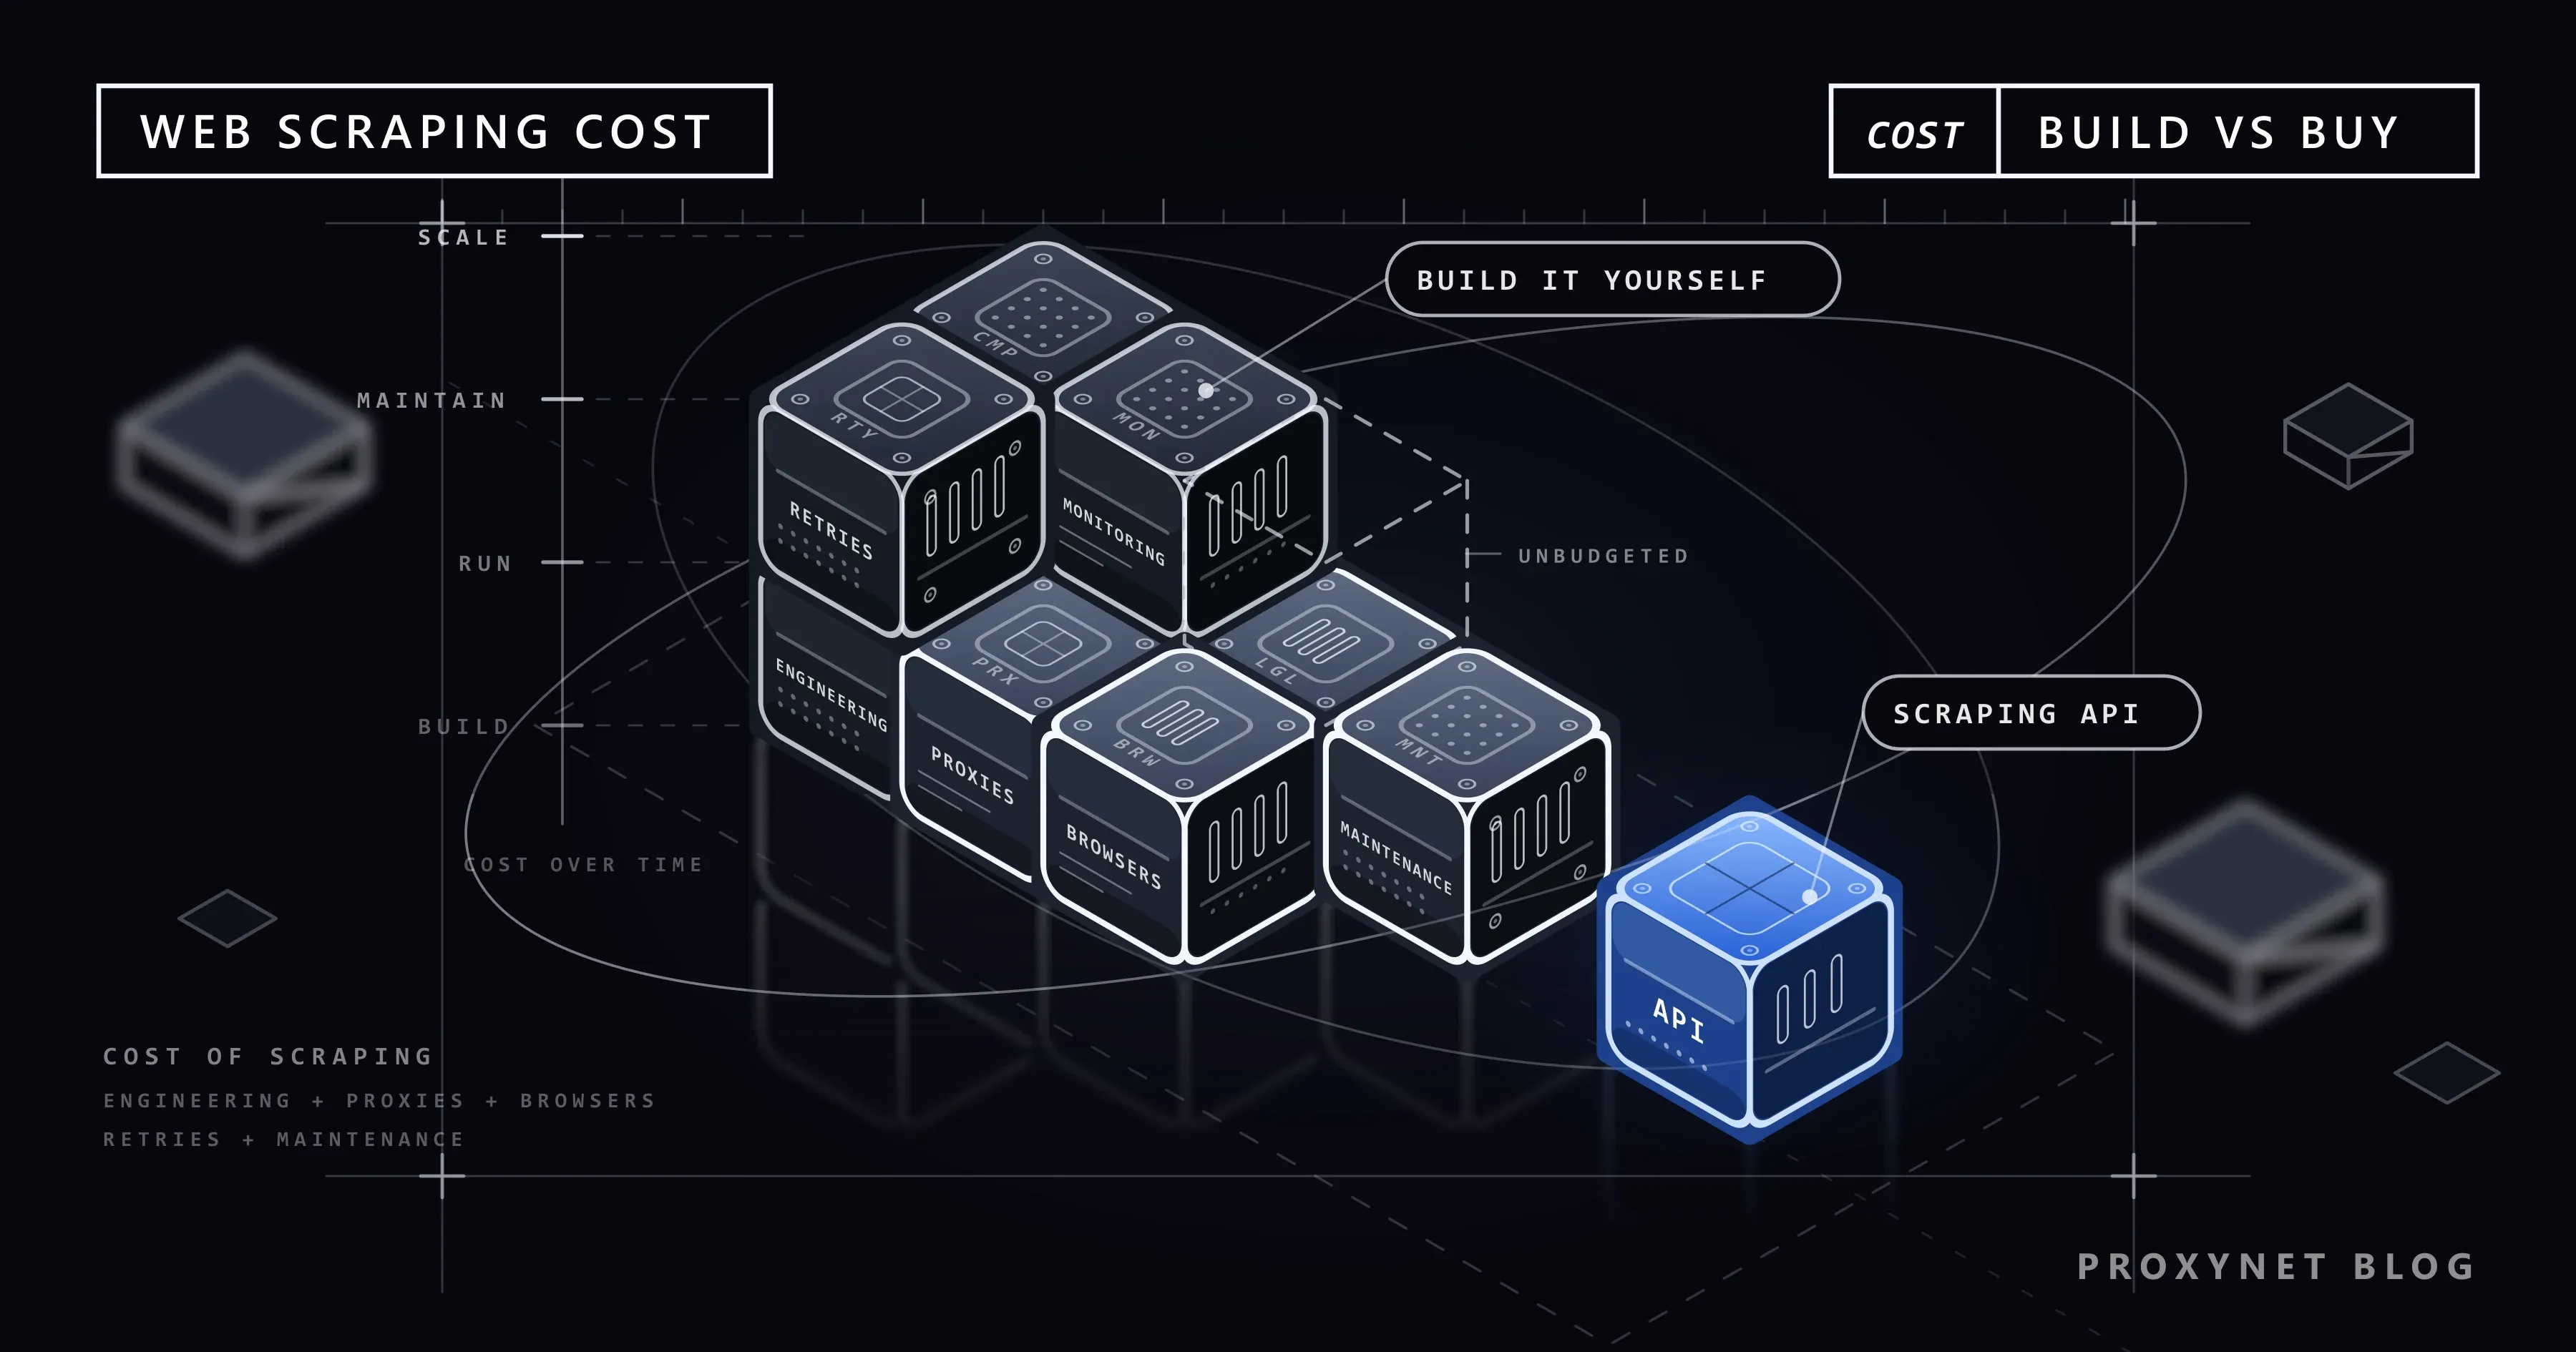
Un gerente de producto pregunta cuánto costaría recopilar cada mañana los precios de 60 tiendas online. El desarrollador responde que Scrapy y Playwright son gratis, así que «unos días de trabajo». Seis meses después, la factura llega por donde nadie la presupuestó: reparaciones del parser cada semana, una factura de proxies que crece con cada reintento y un servidor lleno de navegadores headless.
Este artículo enumera los ocho costos de un scraper propio y cómo crece cada uno, mide lo que una descarga de HTML simple y una carga completa en navegador transfieren de verdad en una página pública, desarrolla una estimación ilustrativa y la contrasta con la forma en que cobran las API de scraping.
¿El web scraping cuesta dinero?
Sí: el software es gratis, la operación no. Scrapy, Beautiful Soup, Playwright y Puppeteer no cuestan nada en licencias, y un primer script corre en tu propio equipo. El costo empieza cuando debe ejecutarse cada día, en muchas páginas, desde el país correcto, y sobrevivir al próximo rediseño del sitio de destino. Pagas por un proceso, no por una herramienta.
Una API de scraping cambia quién paga cada partida: el proveedor opera los navegadores, los proxies y los reintentos, y cobra por página entregada. Cómo funciona un servicio así se explica en ¿Qué es una API de web scraping?; este artículo trata del dinero.
¿Cuánto cuesta construir y operar tu propio scraper?
Un scraper propio tiene ocho partidas de costo, y solo la primera se paga una vez.
Tiempo de ingeniería para construirlo. Descargador (fetcher), un parser por sitio, programador de tareas, almacenamiento, pruebas; crece con el número de sitios distintos, porque cada diseño necesita su propio parser.
Mantenimiento cuando los sitios cambian. El costo que la gente olvida. Un rediseño, una clase CSS renombrada, un nuevo aviso de cookies o una protección anti-bots más estricta rompen un parser de la noche a la mañana, y los datos dejan de llegar en silencio o llegan mal. Crece con el número de sitios por su ritmo de cambio; presupuéstalo como una fracción mensual recurrente del costo de construcción.
Cómputo: solicitudes HTTP o navegadores headless. Una solicitud simple descarga el HTML y nada más; un navegador headless descarga scripts, estilos, fuentes e imágenes como lo haría un visitante, ejecuta el JavaScript y renderiza muchas menos páginas por hora y por servidor. La siguiente sección mide la diferencia.
Tráfico de proxies. Muchos destinos muestran precios distintos según el país, y un flujo constante desde una sola dirección es lo primero que atrapa un límite de frecuencia, así que los scrapers en producción envían sus solicitudes a través de proxies. Los proxies residenciales se facturan por gigabyte (los nuestros empiezan en 1,4 €), así que su costo crece con los bytes: peso de página × páginas × reintentos. Los proxies ISP estáticos y de centro de datos se facturan por IP con tráfico sin cuota, así que su costo crece con el número de direcciones.
Los reintentos como multiplicador. Los tiempos de espera agotados, las respuestas
5xxy las páginas de bloqueo implican descargar una página más de una vez, y cada repetición vuelve a costar cómputo y tráfico: con una tasa de fallos del 30 % mueves 1,3 veces el tráfico para las mismas páginas útiles. Un429o un CAPTCHA es una señal para ir más despacio, no para reintentar con más fuerza; Cómo hacer web scraping sin que te bloqueen explica las reglas de espera (backoff) que mantienen baja la tasa de reintentos.Almacenamiento, parsing y controles de calidad. El HTML sin procesar que guardas para volver a analizarlo se acumula, y los registros extraídos necesitan validación de esquema, eliminación de duplicados y revisiones por muestreo. Los precios vacíos tras un rediseño cuestan más que no tener datos, porque alguien actúa a partir de ellos.
Seguimiento y alertas. Alguien tiene que saber en cuestión de horas que un sitio empezó a devolver páginas de bloqueo o que la tasa de éxito cayó del 97 % al 60 %. Los paneles, las alertas y el tiempo de reacción cuestan dinero incluso cuando nada se rompe.
Revisión legal y cumplimiento. Leer los términos de cada destino, revisar el robots.txt, decidir si hay datos personales de por medio y documentar la base legal consume horas de personas que no son desarrolladores. El estándar de robots.txt dice que sus reglas «no son una forma de autorización de acceso» (RFC 9309): el archivo no impone nada, así que el cumplimiento sigue siendo cosa tuya. Para un proyecto concreto, consulta a un abogado.
¿Cuánto más transfiere un navegador headless?
En la página que medimos, una carga completa en navegador headless transfirió 18,7 veces los bytes de una descarga de HTML simple.
El 9 de noviembre de 2026 descargamos una página pública, la página de referencia de MDN para el estado HTTP 429 Too Many Requests (su robots.txt permite la ruta), de tres formas: un único GET HTTPS comprimido del HTML, una carga completa en Chromium headless a través de Playwright con la caché vacía, y la misma carga con las solicitudes de imágenes, fuentes y medios abortadas. Los bytes son cabeceras más cuerpos codificados según request.sizes() de Playwright, cuyo responseBodySize es el tamaño comprimido en la red (Playwright: request.sizes()).
| Método | Solicitudes | Transferido | Tiempo |
|---|---|---|---|
| Descarga de HTML simple | 1 | 23,4 KB | 47 ms |
| Navegador headless, carga completa | 81 | 436,6 KB | 4,2 s |
| Navegador headless, imágenes, fuentes y medios bloqueados | 64 | 209,3 KB | 1,5 s |
El HTML también pesó 23,3 KB en el navegador; los otros 413 KB fueron 39 scripts (155,5 KB), dos fuentes (133,3 KB), 15 imágenes (78 KB), 17 hojas de estilo y algunos pings de analítica. Abortar imágenes, fuentes y medios con page.route() (Playwright: abortar solicitudes) redujo el tráfico a la mitad y el tiempo de carga a un tercio.
Esta página de documentación es ligera: el Web Almanac 2025 sitúa la página de inicio mediana en 2,86 MB en escritorio y 2,56 MB en dispositivos móviles, de los cuales 22 KB son HTML (Web Almanac 2025: peso de página). Ahí una carga en navegador mueve megabytes por página, y con proxies facturados por gigabyte el renderizado se convierte en la partida más grande de la factura.
Mide primero tus propios destinos: el panel Network de Chrome DevTools muestra el número de solicitudes y el tamaño transferido de una carga, con Disable cache (desactivar caché) para ver lo que recibe un visitante nuevo (Chrome DevTools: referencia de Network). Si los campos que necesitas ya están en el HTML o en una respuesta JSON, no necesitas un navegador.
¿Cómo comparas el precio de una API con tus propios costos?
Convierte ambos al costo por cada 1.000 páginas útiles en tus propios destinos; nada más es comparable.
Las API de scraping cobran por página recibida, en unidades que varían según el proveedor (por solicitud, créditos con multiplicadores por renderizado y salidas residenciales, mínimos mensuales, una definición de éxito); el artículo hermano explica esos modelos. Calcula la misma cifra para tu propia vía: horas a tu tarifa más servidores, tarifas de proxy o de IP, almacenamiento y seguimiento, dividido entre páginas útiles.
| Partida | Construirlo tú | API de scraping | Crece con |
|---|---|---|---|
| Construcción | Tus horas por sitio | Una integración | Número de sitios |
| Mantenimiento | Tus horas, con cada cambio | Trabajo del proveedor | Sitios × ritmo de cambio |
| Cómputo | Servidores y navegadores | En el precio (nivel de renderizado) | Páginas, proporción renderizada |
| Tráfico de proxies | Por GB o por IP | En el precio (nivel de salida) | Bytes o número de IP |
| Reintentos | Pagas cada intento | Normalmente solo se facturan los éxitos | Tasa de fallos |
| Almacenamiento, QA, seguimiento | Tuyos | Tuyos, más su disponibilidad | Páginas, sitios |
| Revisión legal | Tuya | Tuya | Destinos, datos personales |
Un ejemplo con variables
Los números de abajo son redondos e inventados para mostrar la aritmética; sustitúyelos por tus propias mediciones.
| Variable | Significado | Valor ilustrativo |
|---|---|---|
| P | Páginas útiles al mes | 1.000.000 |
| r | Factor de reintento (1 + proporción de intentos fallidos) | 1,3 |
| s | Bytes transferidos por intento | 60 KB simple, 1,5 MB renderizado |
| h | Horas de ingeniería y mantenimiento al mes | 40 |
El renderizado multiplica el tráfico por 25 para las mismas páginas:
| Línea | Fórmula | HTTP simple | Renderizado |
|---|---|---|---|
| Tráfico de proxies | P × r × s | 78 GB | 1.950 GB |
| Proxies residenciales | tráfico × precio por GB | 78 × G | 1.950 × G |
| Proxies ISP o de centro de datos | direcciones × precio por IP | n × I | n × I |
| Personas | h × tarifa por hora | 40 × R | 40 × R, más el mantenimiento de navegadores |
Con proxies residenciales medidos por GB, el multiplicador del renderizado cae en la factura; con direcciones sin cuota, en tus servidores. El factor de reintento está en todas las filas: bajar los fallos del 30 % al 10 % elimina alrededor del 15 % del tráfico. El lado de la API es P por su precio por cada 1.000 páginas útiles, más tus horas de integración y comprobaciones.
¿Cuándo compensa construir y cuándo una API?
Construir compensa cuando el trabajo es acotado, estable y largo; una API, cuando es amplio, cambiante o corto.
Construye con proxies para un puñado de sitios estables, un volumen con el que un precio por página se acumularía y un equipo que ya opera scrapers. Usa una API de scraping cuando la lista de sitios es larga o cambia cada trimestre, la mayoría de los destinos renderizan con JavaScript o el proyecto termina en tres meses. Opta por un modelo híbrido cuando unos pocos sitios concentran el volumen y una larga cola concentra la complejidad.
¿Qué costos ocultos pasan por alto las estimaciones?
Cuatro costos rara vez aparecen en la hoja de cálculo. Costo de oportunidad: el desarrollador que mantiene parsers no está construyendo el producto que esos datos alimentan. Calidad de los datos: un scraper que devuelve campos desactualizados en silencio es más barato de operar que uno correcto, hasta que se toma una decisión con ellos. Cumplimiento: la revisión de términos, las comprobaciones de robots.txt, la minimización de datos y un contrato de encargo del tratamiento con cualquier proveedor que maneje datos personales llevan tiempo con cada nuevo destino. Factor de dependencia (bus factor): una canalización que solo entiende una persona es un pasivo el día en que esa persona se va.
¿Cuándo basta con comprar solo proxies?
Comprar solo proxies es lo correcto cuando ya operas un scraper que funciona y solo te faltan las salidas: el país correcto, suficientes direcciones distintas o una IP estable para una sesión.
Para sitios cuyo contenido varía según la ubicación, los Proxies residenciales ofrecen sesiones rotativas o fijas con segmentación por país y ciudad, facturadas por gigabyte, así que descarga HTML simple donde puedas y bloquea imágenes y fuentes donde no.
Para alto volumen en destinos estables, los Proxies ISP se facturan por IP con tráfico sin cuota; los proxies de centro de datos siguen el mismo modelo y son los más baratos por dirección. Ambos vienen por defecto con una restricción de sitios de destino, y el acceso a todos los sitios web es un complemento de pago. El pago es un saldo que nunca caduca, sin suscripción y sin prueba gratuita.
¿Cuándo es la compra correcta una API de scraping gestionada?
Una API gestionada es la compra correcta cuando la lista de sitios es larga o cambia a menudo, la mayoría de las páginas necesitan renderizado o el proyecto es demasiado corto para amortizar una construcción propia: envías URL y recibes páginas o campos, y el proveedor carga con los navegadores, las salidas, los reintentos y el mantenimiento. Antes de firmar, pregunta por la unidad de facturación, la definición de éxito, si se respeta el robots.txt y cómo se cobra el renderizado. Nuestra Web Scraping API, extracción gestionada de páginas, está disponible a través del equipo de ventas; la página de extracción de datos describe la parte de los proxies y cómo contactar con ellos.
Errores frecuentes
- Contar solo la construcción. A dos años vista, la ingeniería del primer mes es la partida más pequeña.
- Ignorar los reintentos. Una tasa de fallos del 30 % es un recargo del 30 % en cómputo y tráfico.
- Proxies residenciales para todos los destinos. Los sitios que no varían según la ubicación salen más baratos con IP sin cuota.
- No medir el peso de página. Elegir proxies medidos por GB sin saber si una página pesa 25 KB o 2,5 MB.
- Renderizarlo todo. Muchas páginas llevan sus datos en el HTML o en una respuesta JSON.
- Sin límite de gasto. Un scraper, una cuenta de proxies y una clave de API necesitan cada uno un límite mensual y una alerta.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Tres sitios estables, millones de páginas, equipo propio | Construir; IP ISP o de centro de datos sin cuota |
| Precios tal como los ven los visitantes de diez países | Salidas residenciales, solicitudes simples |
| Sesenta sitios con diseños distintos, equipo pequeño o un proyecto de tres meses | API de scraping |
| La mayoría de los destinos renderizan con JavaScript | API con renderizado por destino |
| Volumen constante en pocos sitios más una larga cola | Híbrido: scraper propio, API para la cola |
| El sitio ofrece una API oficial con tus campos | La API oficial |
Preguntas frecuentes
¿El web scraping cuesta dinero?
Sí. Las bibliotecas son gratis, pero operar un scraper cuesta tiempo de ingeniería, mantenimiento, servidores, tráfico de proxies, almacenamiento, seguimiento y revisión legal. Un script de una sola vez es casi gratis; una canalización diaria sobre muchos sitios es un costo recurrente.
¿Cuánto cuesta un web scraper?
No hay una cifra única: depende del número de sitios, de las páginas al mes, de la proporción renderizada y de la frecuencia con que cambian los destinos. Estímalo cada mes como horas a tu tarifa más servidores, tarifas de proxy, almacenamiento y seguimiento, dividido entre páginas útiles.
¿Una API de scraping es más barata que los proxies?
Para muchos sitios distintos o cargados de JavaScript y un equipo pequeño, normalmente sí, porque su precio incluye navegadores, reintentos y mantenimiento. Para alto volumen en pocos sitios estables, tu propio scraper con proxies sin cuota suele ser más barato por página.
¿Cómo estimo el ancho de banda de proxy para scraping?
Multiplica las páginas al mes por el factor de reintento y por los bytes transferidos por página, medidos en tus destinos reales; una descarga simple suele ser de decenas de kilobytes y una carga en navegador, de megabytes.
¿Por qué los costos del web scraping crecen con el tiempo?
Porque los destinos cambian y el volumen crece: los rediseños cuestan horas de mantenimiento, los sitios nuevos añaden parsers, los reintentos aumentan a medida que la protección se endurece y las páginas sin procesar almacenadas se acumulan.
¿Las herramientas de scraping gratuitas son realmente gratis?
La licencia es gratis; la operación no. Los scrapers de código abierto eliminan el costo del software; los servidores, los proxies, el mantenimiento y la responsabilidad por lo que recopilan son tuyos.
En resumen
El web scraping cuesta dinero porque es una operación, no una descarga, y los reintentos y el renderizado multiplican todas las demás partidas. Mide el peso de página y la tasa de fallos en tus destinos reales, convierte cada opción al costo por cada 1.000 páginas útiles y después elige: tu propio scraper sobre proxies sin cuota para pocos sitios estables, una API de scraping para muchos sitios o sitios cambiantes, un híbrido para volumen constante con una larga cola. Si lo que te falta son las salidas y no el scraper, empieza por nuestros servicios de proxy.