Un desarrollador necesita diez mil registros de clientes para probar un nuevo sistema de facturación, pero los registros reales no pueden salir de la base de datos de producción. Un equipo de aprendizaje automático solo tiene unas pocas decenas de ejemplos del patrón de fraude que quiere detectar. Un equipo de IA se pregunta si todavía tiene que recopilar páginas web cuando un modelo de lenguaje puede escribir ejemplos de entrenamiento a demanda. Los tres están mirando la misma opción: los datos sintéticos, es decir, datos que produce un programa en lugar de datos que alguien recopiló.
Este artículo explica qué son los datos sintéticos, cómo se generan y se comprueban, sus tipos y usos principales, lo que no pueden hacer (incluido el colapso del modelo), cómo se comparan con los datos web reales y qué implican para la privacidad.
¿Qué son los datos sintéticos?
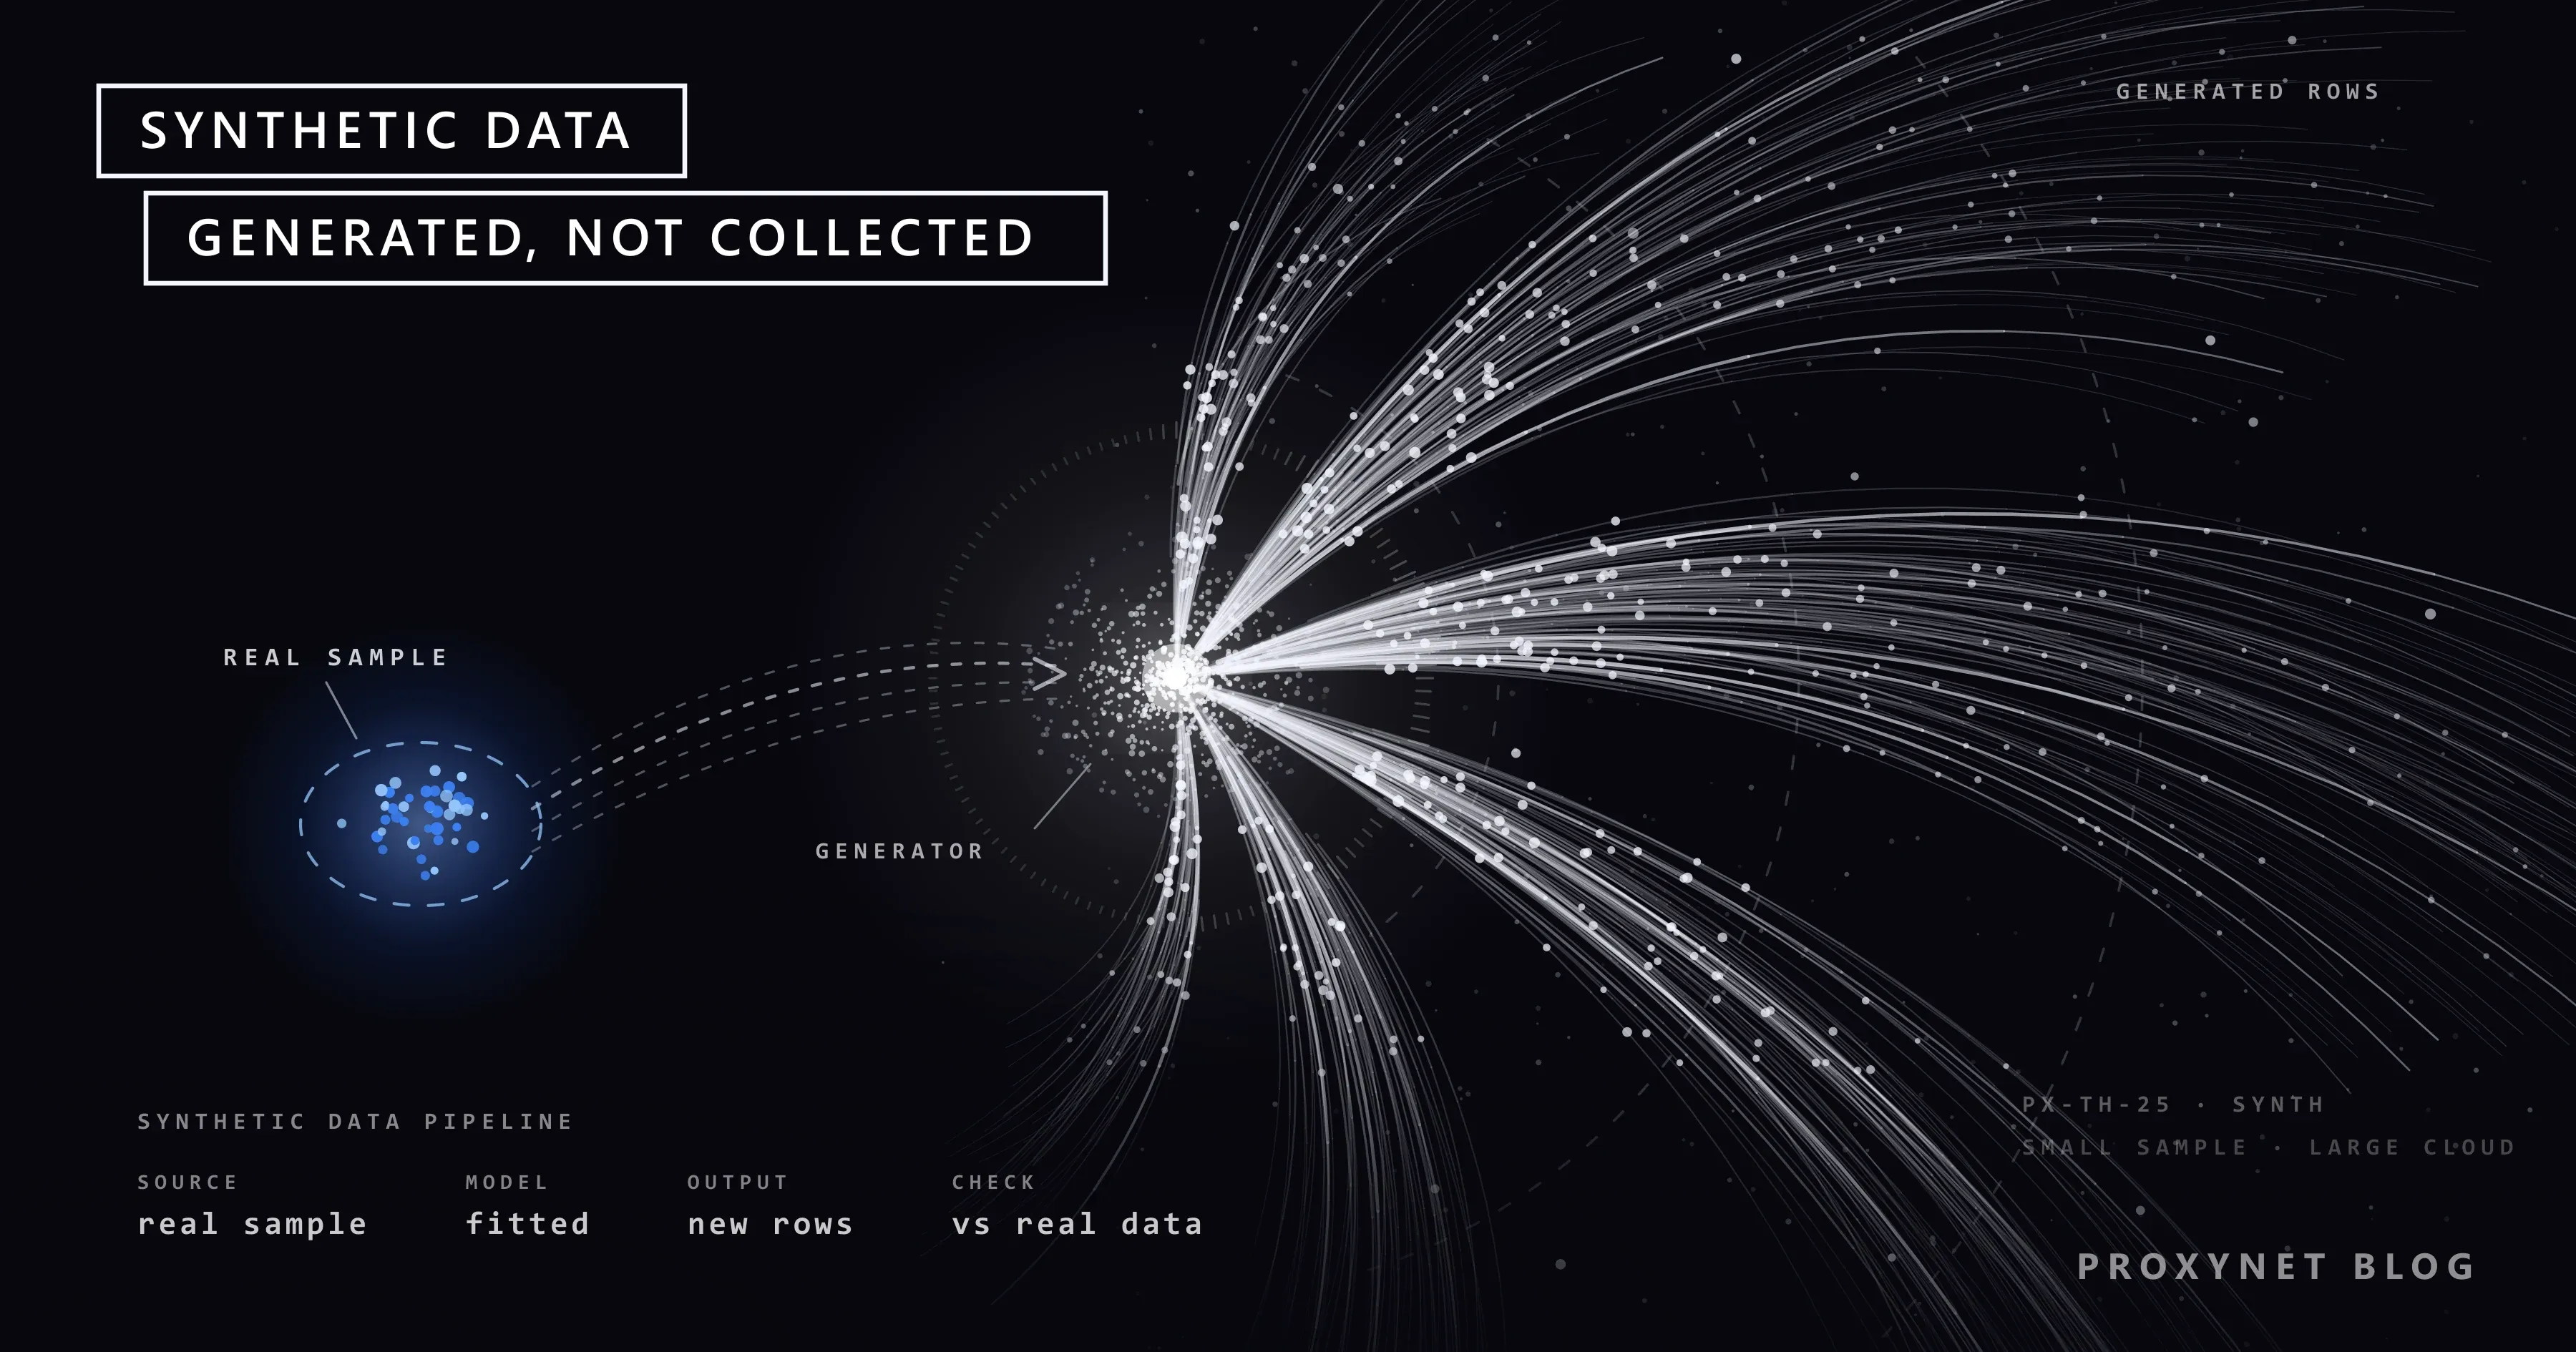
Los datos sintéticos son datos que genera un programa para que se parezcan a los reales, en lugar de capturarlos de transacciones, sensores, personas o páginas web reales. El NIST, el instituto de normas de Estados Unidos, describe el proceso en su guía de desidentificación SP 800-188: a partir de datos semilla (seed data) se crean datos artificiales que conservan algunas características estadísticas de esos datos semilla.
No existe una definición única aceptada por todos. Una revisión encargada por la Royal Society propone una definición amplia: datos generados con un modelo matemático o un algoritmo creado a propósito para resolver una tarea de ciencia de datos. Eso abarca tablas de clientes inventados, reseñas escritas por un modelo de lenguaje y escenas urbanas renderizadas por un simulador 3D. La idea se remonta a la simulación de Monte Carlo de los años cuarenta; la IA generativa la ha vuelto mucho más común.
La guía del NIST también distingue grados de «sintético»:
- Los datos parcialmente sintéticos conservan los registros reales, pero sustituyen las celdas de riesgo, como un ingreso poco habitual, por valores modelados o ruido.
- Los datos totalmente sintéticos se generan por completo a partir de un modelo, de modo que ninguna fila corresponde uno a uno con un registro real.
- Los datos de prueba copian solo la estructura y los rangos de valores de un conjunto de datos. Sirven para probar software y no intentan reproducir su estadística.
¿Cómo se generan los datos sintéticos?
Los datos sintéticos se generan ajustando un modelo, escribiendo reglas o construyendo una simulación, muestreando registros nuevos a partir de ellos y comprobando después esos registros con datos reales. Un proyecto típico sigue siete pasos:
- Define la tarea. Decide para qué tienen que servir los datos: probar un formulario, entrenar un clasificador, compartir una tabla con un socio. Eso determina qué propiedades deben sobrevivir y cuáles se pueden descartar.
- Elige el punto de partida. Puede ser una muestra real (los datos semilla), un conjunto de reglas del dominio, como códigos postales válidos y rangos de precios, o una simulación del propio proceso, que no necesita ningún registro real.
- Elige el generador. Las opciones van desde reglas simples y valores aleatorios, pasando por modelos estadísticos que aprenden distribuciones y correlaciones, hasta generadores de aprendizaje automático: redes generativas antagónicas (GAN), autoencoders variacionales (VAE), modelos de difusión para imágenes y grandes modelos de lenguaje (LLM) para texto.
- Genera. Muestrea tantas filas, textos o imágenes como necesites y márcalos como sintéticos dentro de los propios datos. El NIST sugiere valores claramente artificiales como «FIRSTNAME1 LASTNAME1», para que nadie confunda un archivo de prueba con datos reales de clientes.
- Valida con datos reales. Compara distribuciones y correlaciones con la fuente (fidelidad) y comprueba si un modelo entrenado con el conjunto sintético sigue funcionando con datos reales reservados aparte (utilidad).
- Revisa la privacidad. Busca registros generados que queden demasiado cerca de los reales y comprueba si los valores atípicos permiten llegar hasta una persona.
- Documenta y guarda un conjunto de prueba real. Registra cómo se crearon los datos y reserva datos reales para la evaluación final.
La validación es el paso que decide si se puede confiar en los datos. La Oficina del Censo de Estados Unidos (Census Bureau) publica SIPP Synthetic Beta, una versión sintética de una encuesta de hogares vinculada con registros fiscales y de prestaciones sociales. Los investigadores desarrollan su análisis con el archivo sintético; luego, el personal de la Oficina del Censo ejecuta los mismos programas sobre los datos confidenciales y revisa los resultados antes de publicarlos.
¿Qué tipos de datos sintéticos hay?
Los tipos principales se distinguen por la forma de los datos y por cómo se generan:
| Tipo | Cómo se crea | Uso típico | Qué vigilar |
|---|---|---|---|
| Registros tabulares | Modelo estadístico, GAN o VAE ajustado a una tabla | Compartir datos, analítica, modelos de fraude | Correlaciones rotas, valores atípicos copiados |
| Texto | Un modelo de lenguaje escribe ejemplos a partir de prompts | Entrenar y probar chatbots, clasificadores | Errores factuales, redacción repetitiva |
| Imágenes y vídeo | Simulación 3D o generadores de imágenes | Conducción autónoma, robótica, detección de defectos | Brecha entre escenas simuladas y reales |
| Datos de prueba de software | Reglas y generadores de valores ficticios | Control de calidad, demos, pruebas de carga | Confundirlos con datos reales |
La pregunta «¿puede sustituir a los datos web reales?» surge sobre todo con el texto. En los trabajos publicados, el texto generado suele añadirse a texto real filtrado, no usarse en su lugar. En el artículo «Textbooks Are All You Need» de Microsoft Research (2023), un pequeño modelo de código, phi-1, se entrenó con unos 6.000 millones de tokens (fragmentos de palabras) de datos web con «calidad de libro de texto», más unos 1.000 millones de tokens de libros de texto y ejercicios generados con GPT-3.5.
¿Por qué las empresas usan datos sintéticos?
Las empresas recurren a los datos sintéticos cuando los datos reales escasean, son sensibles, cuesta mucho etiquetarlos o todavía no existen:
- Privacidad. Un banco o un hospital puede dar a desarrolladores y proveedores una copia sintética de una tabla en lugar de registros de clientes o pacientes, con las salvedades que se explican más abajo.
- Casos raros. El fraude, las averías de máquinas y las situaciones peligrosas en carretera son escasos en los datos reales; generar más ejemplos ayuda a que un modelo los aprenda.
- Pruebas de software. Una aplicación nueva necesita cuentas y pedidos de aspecto realista antes de tener usuarios. Los datos de prueba solo tienen que ser válidos, con los formatos y rangos correctos, no estadísticamente fieles.
- Costo de etiquetado. Un simulador ya sabe dónde está cada vehículo y cada peatón de su escena, así que las etiquetas salen gratis; etiquetar fotos reales a mano es lento.
- Equilibrio. Los ejemplos generados pueden completar clases poco representadas, lo que solo ayuda si el propio generador no está sesgado.
¿Cuáles son los límites de los datos sintéticos?
Los datos sintéticos no pueden añadir información que su fuente nunca tuvo: un generador reproduce patrones de sus datos de entrenamiento, sus reglas o su simulación, y nada más allá. La guía del NIST lo dice sin rodeos: los datos totalmente sintéticos no pueden dar al usuario más información que el modelo del que salieron.
Esto se nota de varias formas:
- Sin hechos nuevos. Un generador entrenado con los precios del año pasado produce precios verosímiles del año pasado; no sabe nada de la rebaja de esta semana ni del producto que salió ayer.
- Valores atípicos perdidos. Un generador o bien suaviza los valores raros y extremos hasta borrarlos, de modo que los datos parecen más promedio que la realidad, o bien los copia con tanto detalle que deja expuesto el registro real.
- Sesgo copiado. Si un grupo está poco representado o recibe un trato injusto en la fuente, los datos sintéticos lo heredan y pueden hacerlo pasar por datos neutrales.
- Errores fluidos. Los ejemplos generados por un LLM pueden sonar seguros y estar equivocados. Un texto que se lee bien sigue necesitando verificación de datos.
- Falsos descubrimientos. Un patrón hallado en datos sintéticos puede ser un artefacto del generador; por eso el NIST aconseja a los analistas confirmar los hallazgos con los datos originales.
¿Qué es el colapso del modelo?
El colapso del modelo (model collapse) es la pérdida de calidad que aparece cuando los modelos generativos se entrenan, generación tras generación, con contenido producido por modelos anteriores. Shumailov y sus colegas lo describieron en un artículo de Nature de 2024. Según el artículo, usar sin criterio contenido generado por modelos en el entrenamiento causa defectos irreversibles en los modelos resultantes: las colas de la distribución original del contenido desaparecen. Los autores mostraron el efecto en modelos de lenguaje y en otros dos tipos de modelos generativos.
En su experimento con modelos de lenguaje, cada generación de un modelo pequeño se ajustó (fine-tuning) con texto escrito por la generación anterior. Sin conservar datos originales, el rendimiento en la tarea original cayó; en una configuración que mantenía el 10 % de los datos originales escritos por personas, la degradación fue leve. La lección no es que todo ejemplo sintético sea dañino, sino que los casos raros, las colas, son lo primero que desaparece cuando los modelos se alimentan solo de su propia producción.
Los autores también advierten que entrenar modelos nuevos puede volverse más difícil sin acceso a datos rastreados de internet antes de que el contenido generado por IA se extendiera de forma masiva. Los archivos abiertos de rastreo como Common Crawl guardan copias fechadas de páginas públicas, y esa es una de las razones por las que importan.
¿Cómo se comparan los datos sintéticos con los datos web reales?
Los datos web reales registran lo que una página pública mostraba de verdad en un momento dado; los datos sintéticos registran lo que un modelo espera. La diferencia pesa sobre todo en la actualidad y en la verdad de referencia (ground truth), es decir, los valores reales verificados con los que se mide un modelo:
| Pregunta | Datos sintéticos | Datos web públicos reales |
|---|---|---|
| ¿Cuán recientes son? | Tan antiguos como su fuente | Tan recientes como la última recopilación |
| ¿Son verdad de referencia? | No, reflejan un modelo | Sí, para lo que mostraba la página |
| Precios, productos y hechos nuevos | No incluidos | Incluidos una vez publicados |
| Casos raros a demanda | Sí | Solo si ocurrieron |
| Riesgo de datos personales | Menor si se hace bien, no nulo | Presente; minimízalo al recopilar |
| Detalle según la ubicación | Solo si la fuente lo tenía | Depende de desde dónde recopiles |
¿Por qué los equipos de IA siguen recopilando datos web reales?
Los equipos de IA siguen recopilando datos web públicos reales porque la evaluación, el grounding y la actualidad necesitan hechos que un generador no puede inventar.
Evaluación. La revisión encargada por la Royal Society recomienda evaluar con datos reales las herramientas pensadas para el mundo real y, si hace falta, ajustarlas también con ellos. Un conjunto de prueba sintético mide sobre todo lo bien que un modelo imita al generador.
Grounding. Muchos productos de IA basan sus respuestas en fuentes (grounding) mediante RAG (generación aumentada por recuperación): buscan documentos actuales en el momento de la pregunta y dejan que el modelo responda a partir de ellos. Eso solo funciona si los documentos son reales y recientes, que es el pipeline que se describe en Web scraping para RAG: de HTML a fragmentos Markdown limpios.
Actualidad y datos semilla. Los productos, precios y normas nuevos aparecen primero en la web, e incluso los pipelines de texto sintético suelen partir de ejemplos reales. La investigación sobre el colapso del modelo muestra por qué una parte de datos reales tiene que seguir en la mezcla.
¿Los datos sintéticos son anónimos?
Los datos sintéticos no son anónimos de forma automática: si se generaron a partir de datos personales, todavía pueden revelar información sobre las personas de esos datos. La revisión encargada por la Royal Society califica de «un error común» la creencia de que los datos sintéticos son privados por naturaleza y señala que los generadores pueden memorizar y reproducir sus registros de entrenamiento.
El NIST insiste en lo mismo: tanto los modelos como los datos sintéticos que producen pueden filtrar información personal que permita volver a identificar a alguien. Un remedio habitual es la privacidad diferencial, un método matemático que limita cuánto puede cambiar el resultado el registro de una sola persona, a costa de algo de precisión.
La visión legal sigue la misma lógica. Según el RGPD en la UE y la KVKK en Türkiye, los datos solo cuentan como anónimos cuando ya no pueden vincularse a una persona identificable, y construir un generador a partir de registros de clientes ya es en sí un tratamiento de datos personales. Si tus datos de origen vienen de páginas obtenidas con web scraping, Cómo tratar datos personales (PII) en datos de scraping explica la diferencia entre enmascaramiento, seudonimización y anonimización.
¿Qué papel tienen los proxies cuando necesitas datos reales?
Cuando un modelo tiene que apoyarse en datos públicos reales y actuales que cambian según la ubicación, como precios, listados u ofertas de empleo, o probarse con ellos, los datos sintéticos no pueden aportarlos y hay que recopilarlos desde el lugar correcto. Muchos sitios muestran precios, monedas, existencias e idiomas distintos según el país de la dirección IP del visitante, así que una recopilación hecha desde una sola oficina solo ve una versión.
Con los Proxies residenciales, cada solicitud sale por una conexión doméstica del país y la ciudad que elijas, así que la página devuelve lo que ven los visitantes locales. Recopila solo páginas públicas, respeta robots.txt y los términos del sitio, mantén un ritmo de solicitudes bajo, usa una API oficial cuando exista y deja fuera los datos personales que no necesites.
Si prefieres no encargarte tú de la recopilación, puedes hablar con nuestro equipo de ventas sobre la extracción gestionada de páginas de nuestra Web Scraping API.
Errores frecuentes
- Dar por hecho que los datos sintéticos son anónimos. Comprueba si filtran datos o usa un método con garantía formal.
- Validar a ojo. «Parece real» no dice nada sobre correlaciones, casos raros ni utilidad.
- Probar el modelo final solo con datos sintéticos. Guarda un conjunto de prueba real y reservado.
- No marcar los registros. Las filas sintéticas que parecen reales acaban en informes como si lo fueran.
- Entrenar en bucle con la salida del modelo. Cada generación sin datos reales nuevos pierde más casos raros.
- Esperar que un generador conozca hechos recientes. Falta todo lo que pasó después de recopilar la fuente.
- Ignorar el sesgo de la fuente. El generador lo copia y luego lo presenta como datos limpios.
Guía de decisión
| Necesidad | Qué usar |
|---|---|
| Probar una app antes del lanzamiento | Datos de prueba basados en reglas, bien marcados |
| Compartir una tabla de clientes con un proveedor | Datos sintéticos con pruebas de privacidad, más revisión legal |
| Más ejemplos de casos raros | Aumento sintético, evaluado con casos reales |
| Enseñar a un chatbot el formato de una tarea | Ejemplos generados por un LLM y revisados por personas |
| Precios, listados u ofertas de empleo actuales | Datos web públicos reales, recopilados con moderación |
| Respuestas sobre hechos recientes | Recuperación desde fuentes reales actuales |
| Evaluación final del modelo | Un conjunto de prueba real y reservado |
Preguntas frecuentes
¿Cuál es un ejemplo de datos sintéticos?
Una tabla de 10.000 clientes inventados cuyas edades, ciudades e importes de compra siguen los mismos patrones que una base de clientes real es un conjunto de datos sintéticos. También lo son las reseñas de productos escritas por un modelo de lenguaje para entrenar un clasificador y las escenas de carretera que renderiza un simulador de conducción con cada vehículo ya etiquetado.
¿Los datos sintéticos son fiables?
Son fiables para la tarea con la que se validaron, y no más allá. Unos datos que superan las pruebas de fidelidad y utilidad para una tarea, como entrenar un modelo de fraude, pueden inducir a error en otra, como estimar eventos raros. Trata los hallazgos obtenidos con datos sintéticos como hipótesis y confírmalos con datos reales.
¿Qué diferencia hay entre datos sintéticos y datos ficticios?
Los datos ficticios (mock o dummy) solo tienen que parecer válidos: formatos correctos, rangos verosímiles, ninguna persona real. Los datos sintéticos en sentido estricto conservan además los patrones estadísticos de un conjunto de datos real, de modo que un análisis o un entrenamiento hecho con ellos da resultados parecidos. Los datos ficticios sirven para probar software; los datos sintéticos estadísticamente fieles, para analítica y aprendizaje automático.
¿Se pueden entrenar modelos de IA solo con datos sintéticos?
Algunos modelos de alcance limitado sí, sobre todo en campos que dependen mucho de la simulación, como la robótica, pero los grandes modelos de lenguaje siguen dependiendo de texto real. Los trabajos publicados combinan ambos, como hizo phi-1, y la investigación sobre el colapso del modelo muestra que entrenar solo con texto generado, generación tras generación, degrada la calidad.
¿Qué son los datos sintéticos en la investigación de mercado?
En investigación de mercado, los datos sintéticos suelen ser «encuestados sintéticos»: un modelo de lenguaje responde preguntas de encuesta como predice que lo haría un tipo de cliente. Puede ayudar a redactar y probar un cuestionario, pero no puede decir qué piensa hoy la gente real ni cómo reacciona ante algo nuevo, así que las decisiones siguen apoyándose en encuestas reales y en datos de mercado reales, como los precios y los listados de la competencia.
¿Cómo se mide la calidad de los datos sintéticos?
La calidad se mide en tres ejes: fidelidad (cuánto se parecen las distribuciones y correlaciones a las de los datos reales), utilidad (si un modelo entrenado con ellos funciona bien con datos reales) y privacidad (si se pueden deducir registros reales a partir de ellos). Un buen resultado en un eje suele costar algo en otro, así que fija los objetivos según el caso de uso.
En resumen
Los datos sintéticos los genera un modelo, un conjunto de reglas o una simulación para que se parezcan a datos reales sin registrar hechos ni personas reales. Sirven para probar software, compartir datos con más seguridad, cubrir casos raros y crear ejemplos de entrenamiento, siempre que se validen con datos reales y se compruebe que no filtran información privada. No pueden sustituir a los datos reales: no contienen nada que faltara en su fuente, no ven nada de lo que pasó después, copian sesgos y degradan los modelos que se alimentan de su propia producción. Para hechos actuales y ligados a una ubicación, como precios, listados y ofertas de empleo, la fuente sigue siendo la web pública real, recopilada a un ritmo moderado y desde el país correcto.