En el registro de tu servidor aparece una línea con CCBot/2.0 (https://commoncrawl.org/faq/). O la sección de datos del artículo de un modelo de IA dice que la mayor parte de su texto de entrenamiento salió de «Common Crawl filtrado». Las dos pistas llevan al mismo sitio: una organización sin ánimo de lucro que copia la web pública desde 2008 y entrega esas copias a quien las quiera.
En este artículo vemos qué contiene un rastreo, cómo se comporta el crawler, qué tamaño y qué actualidad tienen los datos (con la lista oficial de rastreos tal como la leímos el 17 de noviembre de 2026), quién los usa, dónde se quedan cortos, cómo pueden excluirse los propietarios de sitios y en qué se diferencia de la Wayback Machine.
¿Qué es Common Crawl?
Common Crawl es una organización sin ánimo de lucro 501(c)(3), una categoría fiscal de Estados Unidos, que rastrea la web y publica las páginas que recoge como un conjunto de datos abierto. Su sitio web describe un corpus de más de 300.000 millones de páginas, libre y abierto desde 2007 y citado en más de 10.000 trabajos de investigación (consultado el 17 de noviembre de 2026).
El motivo es práctico: rastrear miles de millones de páginas exige servidores e ingenieros que solo las grandes empresas pueden pagar, así que un grupo hace el trabajo y comparte el resultado. Los datos están en Amazon S3, en la región US East (N. Virginia), y también se pueden descargar por HTTPS desde data.commoncrawl.org. No es un buscador: no hay resultados ordenados por relevancia, solo un índice que localiza direcciones.
¿Qué contiene un rastreo de Common Crawl?
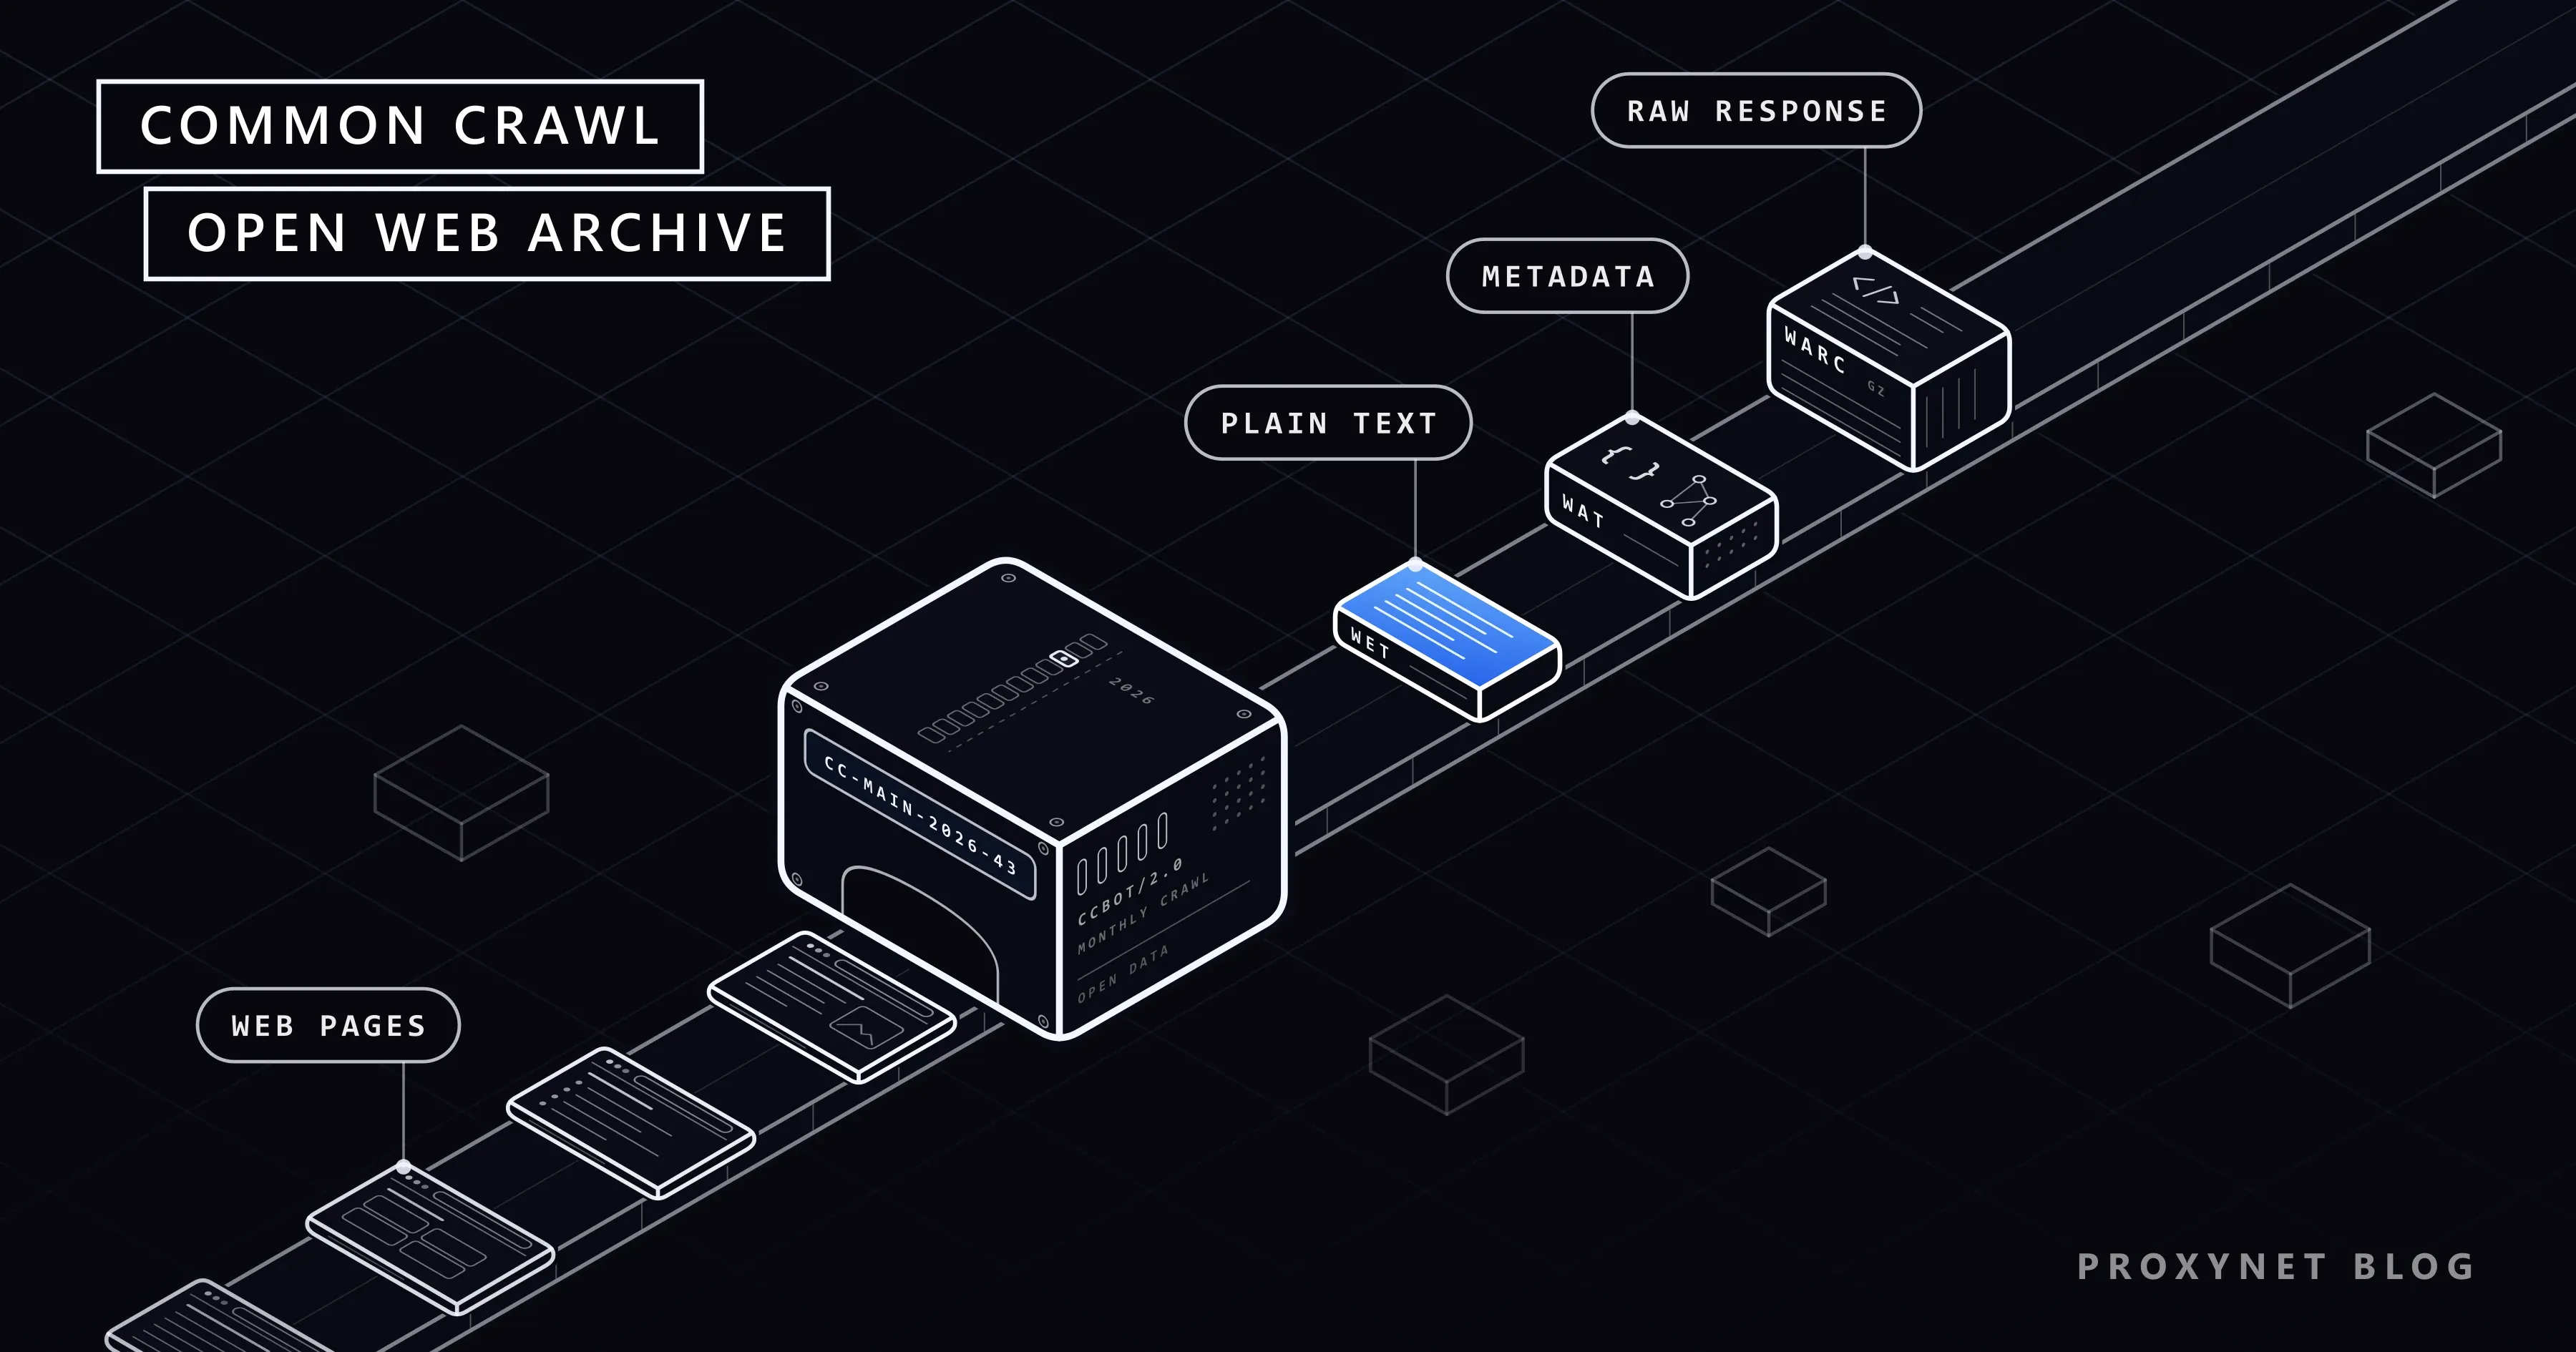
Cada rastreo se publica como archivos en tres formatos, más unos índices que indican dónde está guardada cada página.
- WARC (Web ARChive) es el registro en bruto: para cada página, la solicitud HTTP que envió CCBot y la respuesta completa, con cabeceras y HTML incluidos.
- Los archivos WAT guardan metadatos calculados a partir de cada registro WARC, en formato JSON: cabeceras de respuesta, los enlaces encontrados en la página y otros detalles.
- Los archivos WET (WARC Encapsulated Text) guardan solo el texto plano extraído de cada página.
- El índice de URL responde a «¿se capturó esta dirección y dónde está?». Una consulta devuelve la hora de captura, el estado HTTP y el archivo, el desplazamiento (offset) y la longitud del registro. Una segunda forma, el URL Index en formato Parquet, sirve para filtrar millones de filas con herramientas de bases de datos.
Los archivos robots.txt y las respuestas distintas de 200, como redirecciones y errores, se publican en conjuntos aparte. Las partes principales del rastreo de octubre de 2026, con los tamaños comprimidos que da el anuncio de Common Crawl:
| Archivo | Qué contiene | Tamaño (comprimido) | Uso habitual |
|---|---|---|---|
| WARC | Solicitudes, respuestas, HTML en bruto | 86,19 TiB | Volver a leer las páginas a tu manera |
| WAT | Cabeceras y enlaces en JSON | 14,06 TiB | Grafos de enlaces, estudio de sitios |
| WET | Texto plano extraído | 5,85 TiB | Datos lingüísticos, análisis de texto |
| Índice de URL | Direcciones capturadas y su ubicación | 0,43 TiB | Encontrar páginas antes de descargar |
Un tebibyte (TiB) equivale a unos 1,1 terabytes. El texto es unas quince veces más pequeño que el archivo en bruto, así que un equipo que solo necesita palabras empieza por los archivos WET, y uno que necesita la estructura de la página o un mejor extractor de texto empieza por WARC.
¿Cómo recoge CCBot las páginas?
El crawler de Common Crawl, CCBot, lee primero robots.txt, descarga HTML sin más y frena cuando un servidor tiene problemas. Los detalles siguientes vienen de las preguntas frecuentes (FAQ) de Common Crawl, consultadas el 17 de noviembre de 2026.
- Comprueba robots.txt. Si el archivo no permite el acceso a CCBot, la página no se descarga; Common Crawl vuelve a revisar el archivo cada cierto tiempo.
- Se identifica. Las solicitudes llevan el user agent
CCBot/2.0 (https://commoncrawl.org/faq/)y salen de unos pocos rangos de IP propios que figuran en las FAQ. Una búsqueda de DNS inverso sobre una dirección IPv4 real de CCBot devuelve un nombre que termina encrawl.commoncrawl.org, lo que lo distingue de los bots que solo toman prestado el nombre. - Encuentra páginas mediante enlaces y sitemaps. CCBot sigue enlaces desde otros sitios, así que puede llegar a páginas que tú nunca enlazaste, y lee cualquier sitemap indicado en robots.txt. Respeta los enlaces
nofollow. - Descarga HTML sin ejecutar scripts. Sin JavaScript ni cookies: una página cuyo contenido se construye en el navegador puede quedar casi vacía en el archivo.
- Regula su ritmo. Espera unos segundos entre solicitudes al mismo sitio, se retira ante errores 429 (demasiadas solicitudes) y 5xx, y obedece
Crawl-delay. - Toma muestras. Common Crawl no archiva sitios web completos; conserva un subconjunto de páginas de cada sitio elegido al azar.
- Publica. Las capturas se escriben en archivos WARC; WAT, WET y los índices se derivan de ellos, y el rastreo se publica con un identificador como
CC-MAIN-2026-43.
¿Qué tamaño tiene Common Crawl y cada cuánto se actualiza?
Common Crawl publica un rastreo nuevo cada mes; en 2025 y 2026 apareció uno por cada mes. La lista oficial de rastreos es un archivo JSON en https://index.commoncrawl.org/collinfo.json. La leímos una vez, el 17 de noviembre de 2026 a las 02:02 UTC; estas son sus dos primeras entradas, sin cambios:
[
  {
    "id": "CC-MAIN-2026-43",
    "name": "October 2026 Index",
    "timegate": "https://index.commoncrawl.org/CC-MAIN-2026-43/",
    "cdx-api": "https://index.commoncrawl.org/CC-MAIN-2026-43-index",
    "from": "2026-10-05T10:56:23",
    "to": "2026-10-18T05:34:47"
  },
  {
    "id": "CC-MAIN-2026-39",
    "name": "September 2026 Index",
    "timegate": "https://index.commoncrawl.org/CC-MAIN-2026-39/",
    "cdx-api": "https://index.commoncrawl.org/CC-MAIN-2026-39-index",
    "from": "2026-09-04T13:16:03",
    "to": "2026-09-17T05:59:21"
  },
La lista tenía 129 entradas. La más reciente, CC-MAIN-2026-43, se rastreó entre el 5 y el 18 de octubre de 2026; la más antigua cubre de 2008 a 2009 en ARC, el formato que se usaba antes de WARC. Cada entrada tiene una dirección cdx-api, el índice de ese rastreo, y las fechas muestran el ritmo: unas dos semanas de rastreo y después una pausa hasta el mes siguiente.
El anuncio del rastreo de octubre de 2026, que Common Crawl publicó el 21 de octubre, da su tamaño: 2.160 millones de páginas, o 371,19 TiB sin comprimir, de 41,4 millones de hosts y 34,3 millones de dominios registrados. Entre ellas, había 830,1 millones de páginas en direcciones que ningún rastreo anterior había visitado; el resto permite a los investigadores comparar la misma URL a lo largo de los meses.
Un conjunto de datos de noticias aparte, CC-NEWS, se lanzó en 2016 para publicar artículos de sitios de noticias poco después de capturarlos, sin esperar a la publicación mensual.
¿Quién usa Common Crawl?
Common Crawl lo usan sobre todo quienes necesitan páginas web en grandes cantidades y no pueden rastrear miles de millones de páginas por su cuenta:
- Entrenamiento de modelos de lenguaje. Un gran modelo de lenguaje (LLM) aprende prediciendo texto y necesita cientos de miles de millones de palabras; Common Crawl es la mayor fuente gratuita.
- Investigación académica. Lingüistas e investigadores de la web estudian cómo está construida la web, qué idiomas usa y cómo cambian las páginas.
- SEO y análisis de enlaces. Los archivos WAT enumeran los enlaces de cada página, y Common Crawl construye a partir de ellos grafos de la web a nivel de host y de dominio, con puntuaciones como harmonic centrality y PageRank; el grafo de hosts de mayo a julio de 2026 tenía 240,4 millones de nodos y 3.700 millones de aristas.
El uso mejor documentado está en los artículos sobre modelos. El artículo de GPT-3 de OpenAI describe 41 lotes mensuales (shards) de Common Crawl de 2016 a 2019: 45 TB de texto plano comprimido antes del filtrado y 570 GB después, que suponían el 60 % de la mezcla de entrenamiento. Los autores conservaron las páginas parecidas a textos de mayor calidad y eliminaron los documentos casi duplicados.
El artículo de T5 de Google creó C4, el Colossal Clean Crawled Corpus, a partir de un solo mes de Common Crawl, abril de 2019, y conservó unos 750 GB de texto en inglés tras la limpieza. Los conjuntos limpios como C4 permiten a los equipos usar texto de Common Crawl sin procesar ellos mismos un rastreo en bruto.
Entrenar es un trabajo distinto de responder preguntas sobre el presente. Un modelo entrenado con una instantánea de 2019 no sabe nada más reciente, así que muchas herramientas de IA descargan páginas actuales en el momento de la pregunta, un patrón llamado RAG (generación aumentada por recuperación). Nuestra guía de web scraping para RAG muestra cómo esas páginas se convierten en texto limpio.
¿Cuáles son los límites de Common Crawl?
Common Crawl es una gran muestra de la web pública, tomada una vez al mes desde un mismo lugar, y cada parte de esa frase marca un límite.
- Una muestra, no la web. Cada sitio está representado por un subconjunto aleatorio de sus páginas. Faltan los sitios que bloquean a CCBot, las páginas detrás de un inicio de sesión nunca se descargan y el contenido construido con JavaScript queda pobre.
- Instantáneas, no datos en vivo. Una página que cambió ayer muestra su versión antigua, o ninguna, hasta el siguiente rastreo. Lo que ocurre entre dos rastreos no está en el conjunto de datos principal.
- Idiomas desiguales. Common Crawl detecta el idioma de cada página con CLD2, un detector de código abierto. Sus estadísticas de idiomas del rastreo de octubre de 2026 muestran un 42,56 % de inglés, seguido del ruso (6,30 %) y el alemán (5,77 %); el turco fue un 1,14 %.
- Ruido y duplicados. Los autores de T5 escribieron que la mayor parte del texto extraído de Common Crawl no es lenguaje natural, sino menús, mensajes de error y texto repetido. Los usos serios filtran y deduplican primero.
- Un solo punto de vista. CCBot trabaja desde un puñado de rangos de IP. Un sitio que cambia precios, idioma o contenido según la ubicación del visitante responde a CCBot con la versión pensada para esas direcciones.
¿Se pueden usar libremente los datos de Common Crawl?
Los datos de Common Crawl se descargan gratis, pero las páginas que contienen siguen perteneciendo a quienes las publicaron. Sus condiciones de uso (actualizadas por última vez el 7 de marzo de 2024) dicen que Common Crawl no es dueño del contenido rastreado, que los usuarios deben respetar los derechos de autor de terceros y que asumen el riesgo de su propio uso. Las condiciones no prohíben el entrenamiento de IA, pero los usuarios deben indemnizar a Common Crawl frente a las reclamaciones que se deriven de él.
Usar páginas rastreadas para entrenar IA es un tema en disputa. En abril de 2026, la News/Media Alliance, una asociación de editores de Estados Unidos, escribió a Common Crawl para pedirle que retirara el contenido de los editores cuando estos lo solicitaran y que prohibiera el uso para IA en sus condiciones. Si entrenar con páginas copiadas es legal se sigue debatiendo en tribunales y parlamentos, y la respuesta varía según el país; para un proyecto comercial, consulta a un abogado de tu mercado.
Las páginas también pueden contener datos personales, como nombres y direcciones de correo electrónico. Su tratamiento está sujeto a leyes de privacidad como el RGPD en la UE o la KVKK en Türkiye, sin importar quién capturó la página primero.
¿Cómo pueden los propietarios de sitios excluirse de Common Crawl?
Para mantener a CCBot fuera de tu sitio, añade un grupo para él en robots.txt. Las FAQ de Common Crawl dan estas dos líneas:
User-agent: CCBot
Disallow: /
Si en cambio prefieres frenarlo, indícale una espera en segundos entre solicitudes:
User-agent: CCBot
Crawl-delay: 2
Nuestra guía de robots.txt explica cómo se leen los grupos y las reglas. Bloquear a CCBot no detiene a GPTBot, ClaudeBot ni a ningún otro bot; cada uno necesita su propio grupo.
Una regla de robots.txt rige las visitas futuras; las páginas capturadas antes de añadirla ya están en rastreos publicados. Para las solicitudes legales de retirada, Common Crawl mantiene una lista pública llamada Opt-Out Ledger.
Common Crawl, Wayback Machine o tu propio rastreo
Common Crawl, la Wayback Machine y un rastreo propio guardan copias de páginas web, pero responden a preguntas distintas.
| Common Crawl | Wayback Machine | Tu propio rastreo | |
|---|---|---|---|
| Pensado para | Análisis masivo con programas | Ver páginas antiguas | Tu pregunta concreta |
| Cómo se usa | Descargar archivos, consultar el índice | Escribir una dirección, elegir una fecha | Recoger las páginas que elijas |
| Actualidad | Instantáneas mensuales | Cuando se guardó la página | Tan a menudo como lo programes |
| Cobertura | Una muestra de muchos sitios | Páginas que se guardaron | Solo tus sitios objetivo |
| Costo | Datos gratis, cómputo a tu cargo | Consulta gratuita | Tu infraestructura y su mantenimiento |
La Wayback Machine, gestionada por Internet Archive, está hecha para personas: escribes una dirección, eliges una captura en un calendario y ves la página como era, y cualquiera puede pedirle que guarde una página concreta con Save Page Now. Nuestra guía de la Wayback Machine cubre esa parte. Common Crawl no tiene un visor así; sus archivos están pensados para código que lee millones de páginas a la vez.
Por qué Common Crawl no puede darte datos actuales y locales
Common Crawl no puede mostrarte el precio de hoy de un producto en Madrid ni cómo ven una página los visitantes en Seúl, porque se rastrea una vez al mes desde unos pocos rangos de IP. Ese tipo de datos hay que recogerlos para tu pregunta, en el momento y desde el lugar que importan.
Los equipos que siguen precios o revisan páginas localizadas recogen ellos mismos esas páginas públicas: según un calendario, a un ritmo respetuoso, dentro de robots.txt y de las condiciones del sitio. Para ver una página como la ve un visitante de un país o una ciudad concretos, la solicitud tiene que salir de allí; los Proxies residenciales con segmentación por país y ciudad la envían a través de una conexión doméstica en ese lugar.
Nuestra página de solución de web crawler muestra dónde encajan los proxies en un crawler así. No tienen sitio delante del propio Common Crawl: sus FAQ piden no consultar el índice a través de redes de proxies, enviar una solicitud cada vez con un user agent claro y frenar ante los errores 503.
Errores comunes
- Tomarlo por la web entera. Es una muestra; que una página falte en un rastreo no demuestra nada.
- Entrenar con texto WET en bruto. La mayor parte son menús, avisos y duplicados; filtra y deduplica primero.
- Saturar el servidor del índice. Tiene un límite de solicitudes estricto, y una IP que envía demasiadas puede quedar bloqueada 24 horas. Para filtrados amplios, usa el URL Index en Parquet con una herramienta como Amazon Athena o Apache Spark.
- Esperar que robots.txt limpie los rastreos antiguos. Una regla nueva solo afecta a las visitas futuras.
Guía de decisión
| Lo que necesitas | Opción recomendada |
|---|---|
| Texto web amplio para investigación o entrenamiento de modelos | Archivos WET o un conjunto filtrado como C4 |
| Cómo era una página en una fecha pasada | La Wayback Machine |
| Qué sitios enlazan a cuáles | Archivos WAT o los grafos de la web de Common Crawl |
| Si tu sitio está en Common Crawl | Una consulta pausada en el índice de URL |
| Dejar tu sitio fuera de futuros rastreos | Un grupo CCBot en robots.txt |
| Precios de hoy, o páginas vistas desde un país | Tu propio rastreo respetuoso o un servicio gestionado |
Preguntas frecuentes
¿Common Crawl es gratis?
Sí. Cualquiera puede descargar los datos por HTTPS o desde Amazon S3 sin pagar a Common Crawl; solo pagas tu propio almacenamiento y cómputo, y Common Crawl recomienda procesarlos en us-east-1, la región de AWS donde están guardados. Las páginas conservan sus derechos de autor.
¿Common Crawl respeta robots.txt?
Sí. CCBot lee robots.txt antes de descargar, se salta lo que está prohibido para CCBot, obedece Crawl-delay y respeta los enlaces nofollow. Las FAQ enumeran sus rangos de IP, así que puedes comprobar si un visitante que dice ser CCBot es real.
¿Common Crawl incluye imágenes?
Prácticamente no. En el rastreo de octubre de 2026, el 98,31 % de las capturas eran páginas HTML y el 1,00 %, archivos PDF, mientras que las imágenes rondaban el 0,001 %. El HTML sí contiene las direcciones de las imágenes, pero no los archivos de imagen.
¿Qué diferencia hay entre Common Crawl y C4?
Common Crawl es el rastreo mensual en bruto. C4 es un conjunto de datos limpio en inglés que investigadores de Google construyeron a partir de un mes de él, abril de 2019, eliminando líneas de relleno (boilerplate), páginas muy cortas, código, palabras ofensivas y texto repetido, lo que dejó unos 750 GB.
¿Se puede buscar en Common Crawl como en un buscador?
No. No hay búsqueda de texto completo ni ordenación por relevancia; el índice solo encuentra capturas por dirección o por patrón de dirección. Para buscar en el texto hay que procesar los archivos WET con tus propias herramientas.
¿Cómo puedo comprobar si mi sitio web está en Common Crawl?
Abre index.commoncrawl.org, elige un rastreo y busca tu dominio con un comodín, como example.com/*. Los resultados listan cada URL capturada con su hora de captura y su estado HTTP. Envía una sola consulta cada vez, porque el servidor tiene un límite de solicitudes.
En resumen
Common Crawl es una copia gratuita y abierta de una gran muestra de la web pública, capturada aproximadamente una vez al mes por CCBot y publicada como páginas en bruto (WARC), metadatos (WAT), texto plano (WET) e índices de URL. Está detrás de buena parte del entrenamiento de IA y de la investigación web, pero es una muestra periódica desde un solo punto de vista, necesita mucho filtrado y sus páginas conservan sus derechos de autor. Los propietarios de sitios controlan a CCBot con robots.txt. Cuando tus datos tienen que ser actuales o locales, recógelos a un ritmo respetuoso o pregunta a nuestro equipo de ventas por la extracción gestionada de páginas.