A una analista de RR. HH. le preguntan si la empresa paga a sus ingenieros de datos en línea con el mercado. La encuesta salarial que tiene es de hace un año y mete el puesto en una familia profesional amplia; los portales de empleo, en cambio, tienen cientos de rangos anunciados para ese título exacto, publicados este mes. Qué competidores contratan las mismas habilidades se responde en el mismo lugar: en ofertas de empleo repartidas por páginas de empleo corporativas, portales y agregadores.
Este artículo explica qué son los datos de ofertas de empleo, quién los construye o los compra y de dónde salen, ordenados desde las estadísticas oficiales y los endpoints públicos de las páginas de empleo hasta las páginas de portales obtenidas por scraping; después trata la normalización, las trampas de calidad, el marco legal, dónde encajan los proxies y seis respuestas breves.
¿Qué son los datos de ofertas de empleo?
Los datos de ofertas de empleo son el contenido de los anuncios de empleo online capturado como campos estructurados. Una oferta se escribe para un candidato; el conjunto de datos la reescribe para una consulta, de modo que «ingeniero de datos sénior, Berlín, híbrido» se convierte en una fila que se puede contar, comparar y seguir en el tiempo.
Los campos básicos son los mismos sea cual sea la fuente:
- Título tal como está escrito, más una ocupación normalizada
- Empresa: nombre, y si quien publica es la empresa o una agencia
- Ubicación: ciudad, país y una marca de remoto o híbrido
- Salario: mínimo, máximo, moneda y periodo, cuando se indica
- Nivel de experiencia y tipo de contrato
- Habilidades y requisitos extraídos de la descripción
- Fechas: primera vez visto, última vez visto, cierre o retirada
- Fuente: portal o página de empleo, y una URL estable
Dos campos concentran la mayor parte del valor y son los más difíciles de acertar: las fechas, que convierten un montón de ofertas en una serie temporal, y el título normalizado, que cuenta «Growth Hacker» y «Digital Marketing Specialist» como una sola ocupación.
¿Quién usa los datos de ofertas de empleo y para qué?
Cuatro grupos los construyen o los compran, cada uno con una pregunta distinta.
Equipos de compensación y RR. HH. comparan salarios. Donde las empresas publican rangos, los salarios anunciados dan una lectura actual de las tarifas de mercado por título, ciudad y nivel de experiencia, y muestran qué habilidades piden los competidores.
Investigadores del mercado laboral leen las ofertas como indicador de demanda. Hiring Lab, el área de investigación del portal Indeed, publica análisis construidos sobre las propias ofertas de Indeed; Lightcast vende inteligencia de mercado laboral construida sobre un archivo de ofertas muy grande.
Equipos de estrategia y ventas tratan la contratación como una señal de hoja de ruta. Un competidor que abre veinte puestos que mencionan una nueva plataforma en la nube, un mercado o un idioma anuncia un plan sin nota de prensa, y un equipo de ventas lee la misma señal para encontrar empresas que contratan en una función a la que vende.
Reclutadores, agregadores e inversores. Los agregadores recopilan ofertas para listarlas, las firmas de selección vigilan dónde se abren vacantes y los analistas de inversión cuentan los volúmenes de contratación como uno de los tipos web de datos alternativos.
¿De dónde salen los datos de ofertas de empleo?
Las fuentes se ordenan por fiabilidad y permisibilidad, el orden inverso al que sigue la mayoría de los equipos al empezar.
1. Estadísticas oficiales de vacantes. Las oficinas nacionales de estadística miden la demanda laboral de forma directa. En Estados Unidos, la encuesta JOLTS de la Oficina de Estadísticas Laborales (BLS) produce estimaciones mensuales de vacantes, contrataciones y bajas; su publicación del 3 de noviembre de 2026 situó las vacantes de septiembre en 7,5 millones. Las estadísticas de vacantes de Eurostat informan cada trimestre de la proporción de puestos vacantes (2,1 % en la zona del euro en el segundo trimestre de 2026). En Türkiye, TurkStat publica estadísticas mensuales de fuerza laboral, y el boletín mensual de ISKUR, la agencia pública de empleo, cuenta las vacantes que las empresas registran en ella, por ocupación y sector. Son gratuitas y citables, pero agregadas: sin títulos, habilidades ni empresas.
2. Páginas de empleo de las empresas a través de su ATS. Muchas empresas alojan su página de empleo en un sistema de seguimiento de candidatos (ATS), que publica sus ofertas como JSON público. Greenhouse documenta una Job Board API cuyos endpoints GET no necesitan autenticación: https://boards-api.greenhouse.io/v1/boards/{board_token}/jobs?content=true devuelve todas las vacantes abiertas con título, ubicación, updated_at, descripción, departamentos y oficinas, y pay_transparency=true añade los rangos salariales declarados.
La Postings API de Lever funciona igual: https://api.lever.co/v0/postings/{site}?mode=json lista las ofertas publicadas con categories (ubicación, equipo, dedicación), workplaceType, descriptionPlain y un salaryRange opcional. Para empresas concretas, estos endpoints son la fuente más limpia que existe.
3. API de agregadores. La API de Adzuna, por ejemplo, expone búsqueda de empleo, categorías e histogramas salariales por país detrás de un app_id y un app_key que obtienes al registrarte. Los datos de un agregador cubren muchas empresas a la vez, pero heredan su cobertura, su deduplicación y sus condiciones de licencia. LinkedIn es la excepción por la que más se pregunta: su Acuerdo de usuario (sección 8.2, «Don'ts», lo que no debes hacer) prohíbe hacer scraping o copiar el servicio, incluso con rastreadores y complementos de navegador, así que sus ofertas se leen a través de su propio buscador de empleo, no se recopilan.
4. Páginas públicas de portales. Todo lo demás es una página web sin feed. Recopilarlas es web scraping, limitado por las condiciones de uso del sitio y su robots.txt; donde ambos lo permiten, los datos son actuales y detallados pero no estructurados, así que el trabajo de normalización que sigue recae en ti.
¿Cómo se recopilan y normalizan los datos de ofertas de empleo?
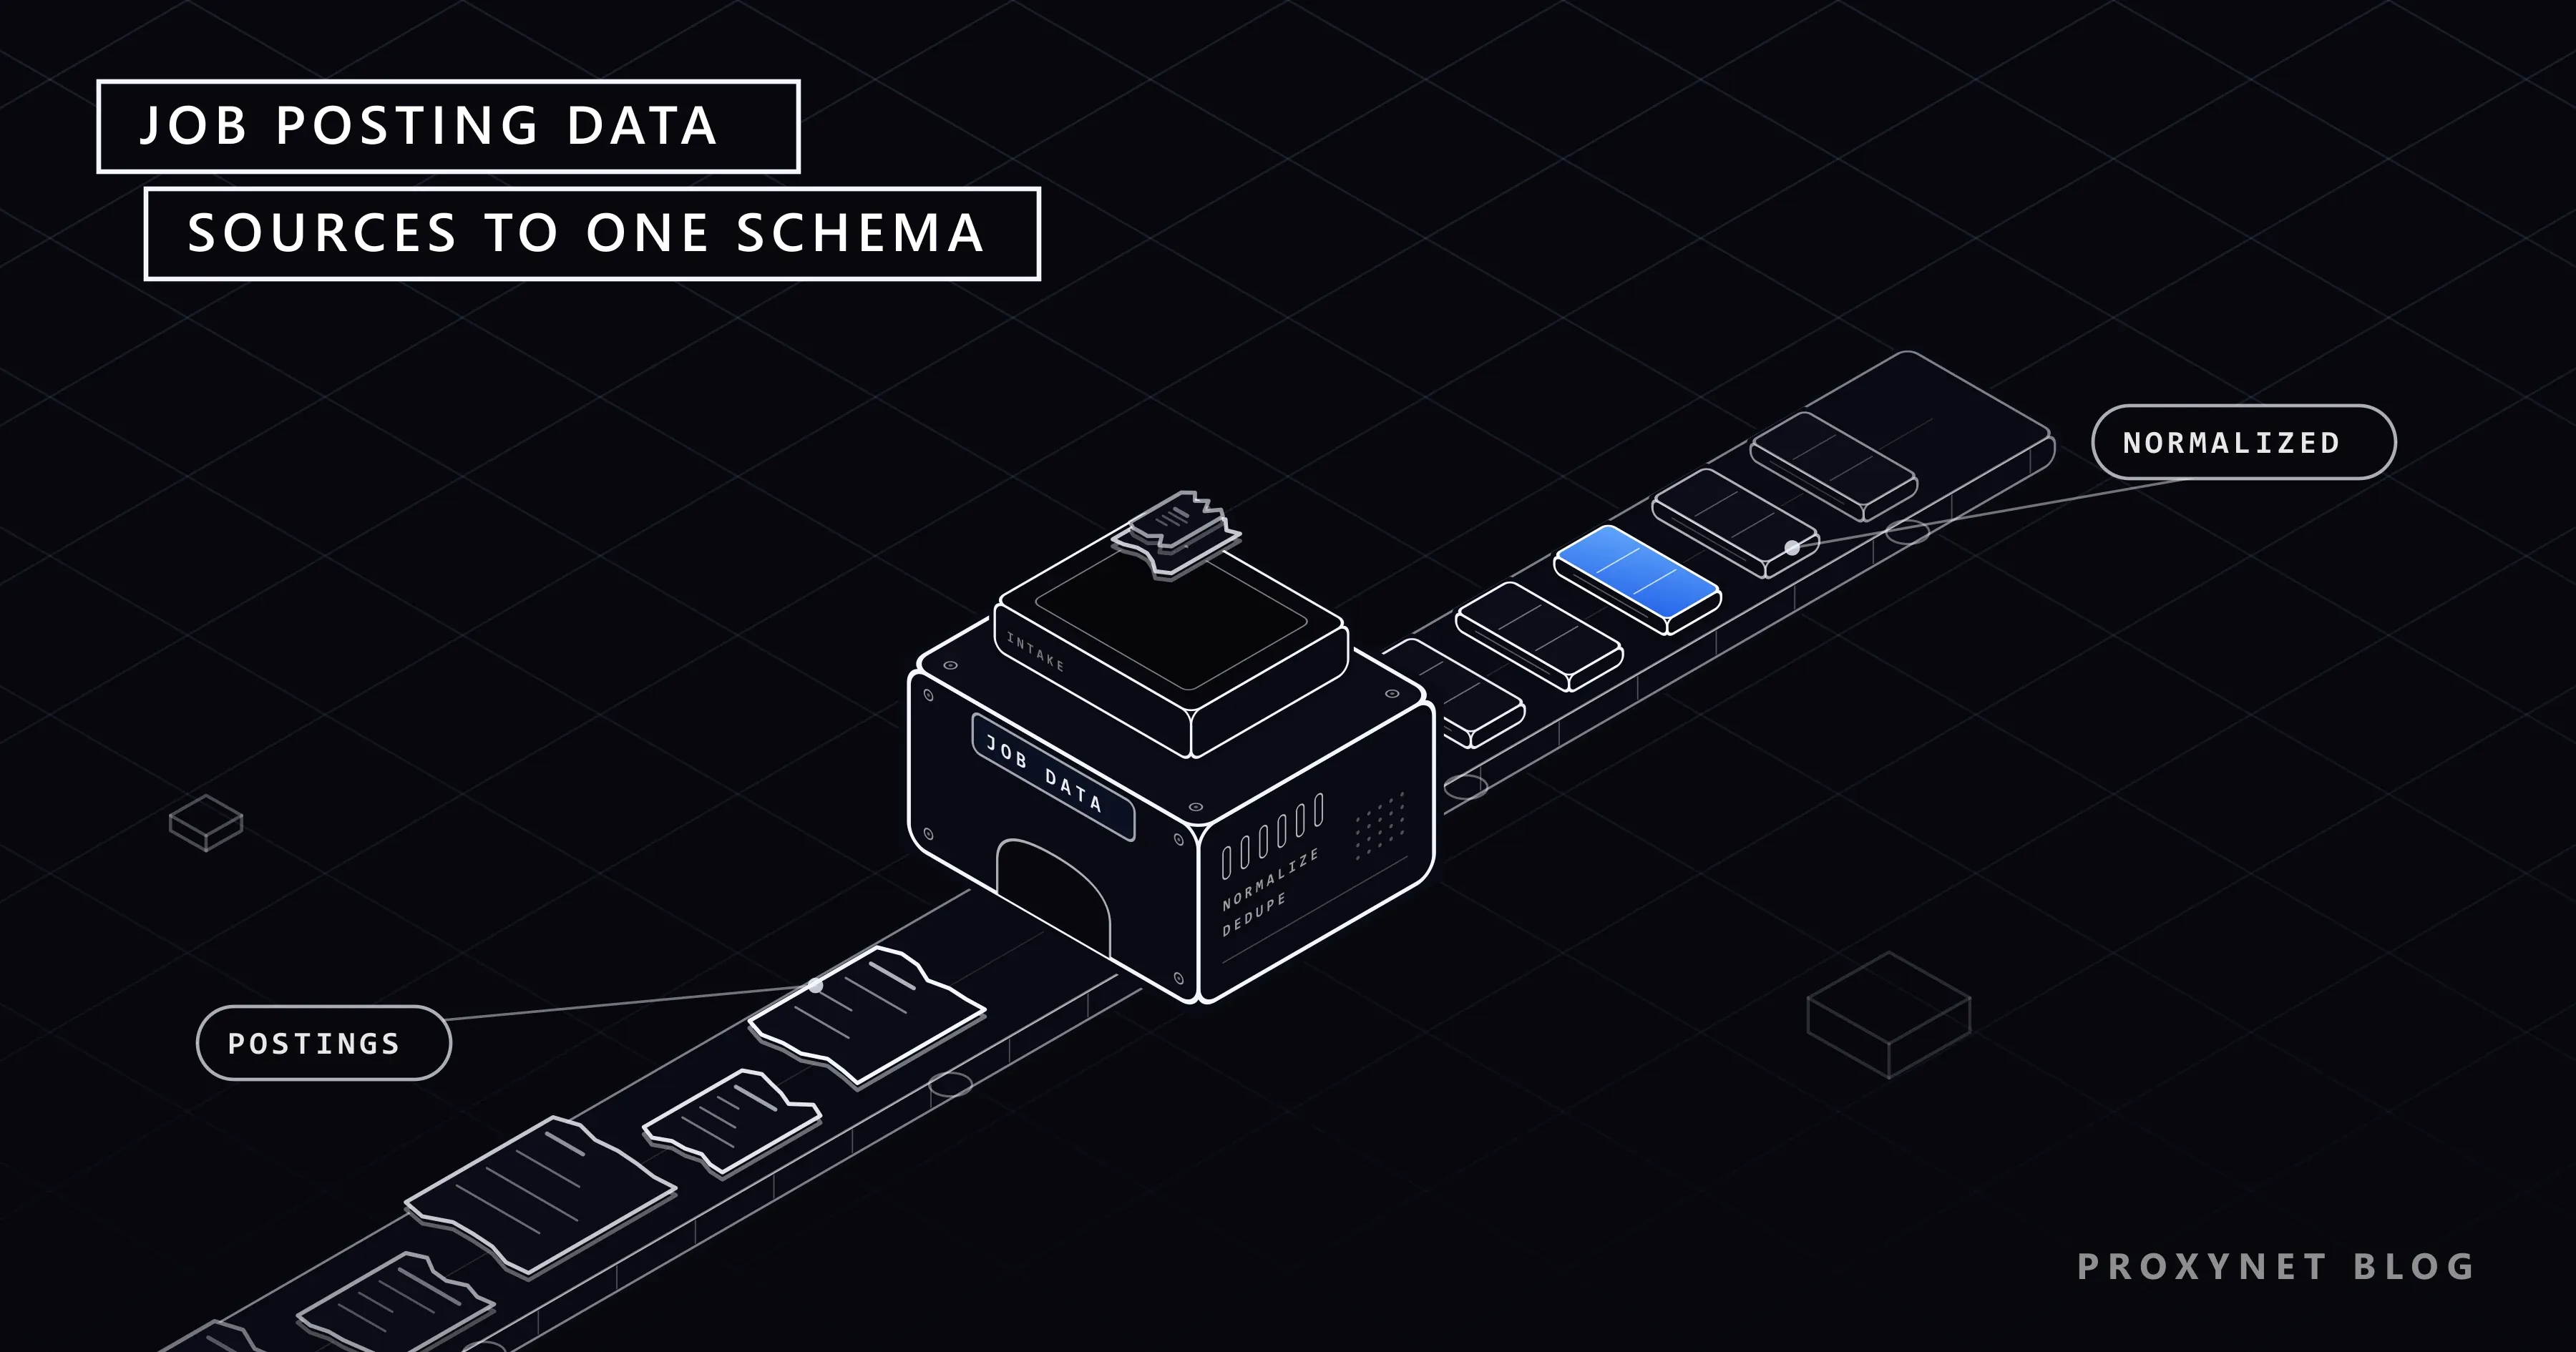
Un pipeline que funciona tiene ocho pasos; la recopilación es el más pequeño.
- Define primero el esquema. Fija los campos y los tipos antes de tocar una fuente; añade
source,source_url,first_seenylast_seena cada registro. - Lista las fuentes y su vía de acceso. Serie oficial, endpoint de ATS, API con licencia o página pública; las condiciones que aplican y la frecuencia de consulta.
- Fija la cadencia. Las ofertas siguen online durante semanas, algunas se renuevan, unas pocas desaparecen en días; una pasada diaria captura las fechas, una semanal basta para las tendencias de volumen.
- Normaliza los títulos a una clasificación de ocupaciones. Asigna los títulos en texto libre a ESCO, la clasificación de la Comisión Europea con 3.039 ocupaciones y 13.939 habilidades en 28 idiomas, gratuita y con API; a O*NET, la base de datos del Departamento de Trabajo de Estados Unidos con más de 900 ocupaciones; o a la ISCO-08 de la OIT, con sus diez grandes grupos. Un diccionario de títulos conocidos resuelve la primera pasada; un clasificador de texto, el resto.
- Desglosa el salario. Extrae mínimo, máximo, moneda y periodo, convierte las cifras por hora y por mes a un rango anual, y guarda «no indicado» como valor, porque su frecuencia es en sí una señal.
- Deduplica. La misma vacante aparece en la página de empleo, en dos portales y en un agregador, a menudo con títulos distintos; cruza por empresa, título normalizado, ubicación y una huella de la descripción, y conserva un registro con todas las URL de origen.
- Deriva señales. Nuevas ofertas por semana por empresa y ocupación, mediana de días online (un sustituto del tiempo de cobertura), proporción con salario indicado, frecuencia de habilidades.
- Controla la calidad en cada ejecución. Filas por fuente, proporción de registros sin salario o ubicación, diez registros al azar comparados con la página en vivo.
Un registro normalizado de una empresa ficticia tiene este aspecto:
{
  "posting_id": "example-ltd-2026-11-0417",
  "title_raw": "Sr. Data Engineer (Hybrid)",
  "occupation": "Data engineer",
  "employer": "Example Ltd",
  "poster_type": "employer",
  "location": { "city": "Berlin", "country": "DE", "workplace": "hybrid" },
  "salary": { "min": 85000, "max": 100000, "currency": "EUR", "period": "year", "disclosed": true },
  "seniority": "senior",
  "contract": "full-time",
  "skills": ["Spark", "Airflow", "SQL", "Python"],
  "first_seen": "2026-11-02",
  "last_seen": "2026-11-09",
  "closed_at": null,
  "sources": ["https://example.com/careers/417", "https://jobs.example.net/view/88213"]
}
Fuentes de datos de ofertas de empleo comparadas
| Fuente | Cobertura | Actualidad | Limitación |
|---|---|---|---|
| Estadísticas oficiales (JOLTS, Eurostat, ISKUR) | Toda la economía, agregada | Mensual o trimestral | Sin títulos, habilidades ni empresas |
| Endpoints públicos de ATS (Greenhouse, Lever) | Empresas concretas, todas sus vacantes | En vivo | Un portal por empresa; la lista la construyes tú |
| API de agregadores | Muchas empresas por país | De horas a días | Condiciones de licencia, deduplicación del proveedor |
| Páginas públicas de portales | Todo lo publicado | Tan a menudo como consultes | Condiciones de uso, robots.txt, trabajo de parsing |
¿Qué sale mal con los datos de ofertas de empleo?
Las ofertas son anuncios, no vacantes; el análisis falla en el hueco entre ambos.
Ofertas fantasma y permanentes. Un informe de 2025 del Servicio de Investigación del Congreso de Estados Unidos define las ofertas de empleo «fantasma» como anuncios de puestos que no existen o que la empresa no planea cubrir de inmediato, señala que ninguna estadística oficial las mide y advierte de que las encuestas que citan porcentajes proceden sobre todo de firmas que venden herramientas de contratación. En los datos son ofertas abiertas durante meses, que reaparecen en un ciclo fijo o que se anuncian en todas partes a la vez.
Republicaciones y duplicados de agencias. Los portales reinician la fecha cuando una empresa renueva un anuncio, así que «publicado hace 2 días» puede ser una vacante de tres meses; las agencias publican el mismo puesto del cliente con su propio nombre, a veces varias a la vez. Mantén tu propio first_seen, marca a los anunciantes que son agencias y cuenta cada vacante una vez.
Salario ausente. Muchas ofertas no indican el salario, y las que lo hacen no son una muestra aleatoria. Informa de la tasa de divulgación junto a cada estadística salarial.
Inflación y deriva de títulos. El mismo trabajo se anuncia como ingeniero, desarrollador, arquitecto o consultor según el mercado y el año; sin una clasificación, una empresa que renombró a sus desarrolladores parece una que dejó de contratarlos.
¿Es legal recopilar datos de ofertas de empleo?
Aplican tres capas: datos personales, condiciones de uso y la ley del país en el que operas. Nada de esto es asesoramiento jurídico.
Datos personales. Una oferta trata de un puesto, pero a menudo incluye el nombre, el correo o el teléfono de un reclutador. Son datos personales, y tanto el RGPD (artículo 6) como la KVKK de Türkiye solo permiten tratarlos con una base jurídica; un conjunto de datos del mercado laboral no los necesita, así que nunca los recopiles y elimínalos de las descripciones en la ingesta. Cómo tratar datos personales (PII) en datos de scraping explica cómo enmascarar lo que se cuela.
Condiciones de uso. Muchos portales prohíben el acceso automatizado en sus condiciones, LinkedIn de forma explícita. La sentencia hiQ Labs contra LinkedIn (Tribunal de Apelaciones del Noveno Circuito de Estados Unidos, 2022) concluyó que el concepto de acceso «sin autorización» de la Computer Fraud and Abuse Act no se aplica a los sitios web públicos; trataba de una ley penal estadounidense, no de las condiciones de un sitio, que siguen siendo una cuestión aparte.
Legislación local. Los derechos sobre bases de datos, las normas de competencia desleal y la regulación de los anuncios de empleo varían según el país. Antes de lanzar un producto de datos de empleo, pide a un abogado que revise las fuentes y las condiciones que aplican a cada una.
¿Dónde encaja un proxy en la recopilación de datos de empleo?
Un proxy decide desde qué dirección de red sale una solicitud; en los datos de empleo hay dos situaciones en las que eso importa.
Primero, los portales se localizan: muchos muestran por defecto el país del visitante, y algunos cambian la moneda, el idioma o la visualización del salario según la ubicación. Para registrar lo que ve un candidato en cada mercado, la solicitud tiene que salir desde ese mercado; las direcciones de Proxies residenciales te permiten elegir país y ciudad en cada solicitud, de modo que una serie de Alemania no se mezcla con una de Türkiye.
Segundo, el volumen está muy repartido: mil páginas de empleo son mil trabajos pequeños y respetuosos, no uno pesado. Los endpoints JSON estáticos, como los feeds de ATS de arriba, encajan con las direcciones de Proxies de centro de datos, con tráfico sin cuota; los sitios que varían según el país del visitante van en direcciones residenciales. Un proxy no cambia qué fuentes puedes leer, con qué frecuencia te deja consultar un sitio ni lo que dicen sus condiciones.
Si prefieres recibir filas normalizadas en lugar de operar el pipeline, un servicio de extracción gestionado hace el parsing y la deduplicación por ti.
Errores comunes con los datos de ofertas de empleo
- Contar ofertas como contrataciones o vacantes; calibra los volúmenes con las series oficiales.
- Empezar por el scraping cuando los endpoints de ATS y las API con licencia cubren a las mismas empresas.
- Fiarse de la fecha de publicación del portal en lugar de tus propios
first_seenylast_seen. - Saltarse la deduplicación, de modo que una vacante cuenta tres veces.
- Guardar solo los títulos en bruto, de modo que las tendencias se pierden en los cambios de nombre.
- Recopilar los datos de contacto de los reclutadores porque estaban en la página.
Guía de decisión
| Necesidad | Vía |
|---|---|
| Demanda laboral de un país o sector | Estadísticas oficiales (JOLTS, Eurostat, ISKUR) |
| Planes de contratación de cincuenta competidores concretos | Sus endpoints de ATS, consultados a diario |
| Rangos salariales por título y ciudad | API de agregador con licencia más campos salariales de ATS |
| Un portal tal como lo ven los candidatos en cada país | Proxies residenciales por país, dentro de sus condiciones |
| Miles de páginas de empleo pequeñas sin feed | Proxies de centro de datos a un ritmo moderado, o un feed gestionado |
| Filas hoy, sin equipo de pipeline | Extracción gestionada con un esquema normalizado |
Preguntas frecuentes
¿Es legal hacer scraping de ofertas de empleo?
Recopilar ofertas de empleo públicas no es ilegal en sí en la mayoría de los países, pero un proyecto pasa a serlo cuando trata datos personales sin base jurídica, incumple las condiciones de uso de un sitio o ignora normas locales como los derechos sobre bases de datos. Las estadísticas oficiales y los endpoints públicos de ATS no conllevan ninguno de esos riesgos.
¿Dónde puedo conseguir datos de ofertas de empleo gratis?
En las estadísticas oficiales (BLS JOLTS, las estadísticas de vacantes de Eurostat, el boletín mensual de ISKUR) para los agregados, y en los endpoints públicos de ATS de las empresas, como la Job Board API de Greenhouse y la Postings API de Lever, para ofertas individuales; ninguno necesita clave de API. Los conjuntos de datos gratuitos de las plataformas de ciencia de datos son instantáneas: valen para practicar, no para una serie temporal.
¿Cómo se detectan las ofertas fantasma?
Por el comportamiento a lo largo del tiempo y no por el texto: una oferta abierta durante meses, la misma oferta recreada en un ciclo fijo, un puesto anunciado en todas las ubicaciones a la vez y empresas cuyo número de ofertas nunca se mueve mientras su plantilla sí. Ninguna es prueba por sí sola; combínalas en una puntuación e infórmala junto a los recuentos.
¿Con qué frecuencia cambian las ofertas de empleo?
A diario, si cuentas ofertas individuales: cada día aparecen nuevas y otras se cierran o se renuevan. La recopilación semanal basta para los volúmenes por ocupación o empresa; la consulta diaria hace falta para fechas precisas de primera y última aparición, que alimentan la señal del tiempo de cobertura.
¿Puedo hacer scraping de las ofertas de LinkedIn?
No. El Acuerdo de usuario de LinkedIn prohíbe hacer scraping o copiar el servicio, incluso con rastreadores y extensiones de navegador, así que un conjunto de datos construido así incumple las condiciones desde la primera solicitud. Para ver cómo cambian las ofertas según el país, usa sus propios filtros de búsqueda; Cómo buscar empleo en LinkedIn en otro país muestra cómo.
¿Conjunto de datos de ofertas de empleo o scraping en vivo: qué es mejor?
Un conjunto de datos comprado te da historial y la deduplicación de un proveedor desde el primer día; la recopilación en vivo te da los campos, las fuentes y la cadencia que eliges, desde hoy. Los equipos que necesitan historial retroactivo compran; los que necesitan un esquema o un país concretos construyen.
En resumen
Los datos de ofertas de empleo convierten anuncios en un registro estructurado y fechado de la demanda laboral: quién contrata, para qué ocupación, dónde, con qué salario y desde cuándo. Sus mejores fuentes son también las más legítimas: las estadísticas oficiales de vacantes para la foto agregada y los endpoints públicos de ATS de las empresas para el detalle. Cuando la recopilación tiene que ver cada mercado como lo ve un candidato local, la página de proxies para investigación de mercado de Proxynet cubre las salidas residenciales y de centro de datos, y la Web Scraping API, disponible a través del equipo de ventas, es la vía gestionada para los equipos que quieren las filas y no el pipeline.