Jeden Montag prüft die Inhaberin einer kleinen Online-Buchhandlung, was 150 ihrer Titel in drei anderen Shops kosten. Von Hand sind das 450 Seitenaufrufe und der größte Teil eines Vormittags, und bis Mittwoch sind einige Zahlen schon wieder veraltet. Ein kurzes Programm kann dieselben Seiten öffnen, den Preis neben jedem Titel lesen und die Tabelle selbstständig füllen. Dieses Programm ist ein Web Scraper, und die Arbeit, die es erledigt, heißt Web Scraping.
Dieser Beitrag verfolgt einen echten Preis von der ersten Anfrage bis zur fertigen Tabelle. Unterwegs vergleicht er Scraping mit Crawling und APIs, ordnet die Werkzeuge nach dem nötigen Können, behandelt die Rechtslage, erklärt, warum Websites Scraper sperren und wo ein Proxy hineinpasst, und endet mit einem kurzen Python-Beispiel, das wir auf einer Übungsseite ausgeführt haben.
Was ist Web Scraping?
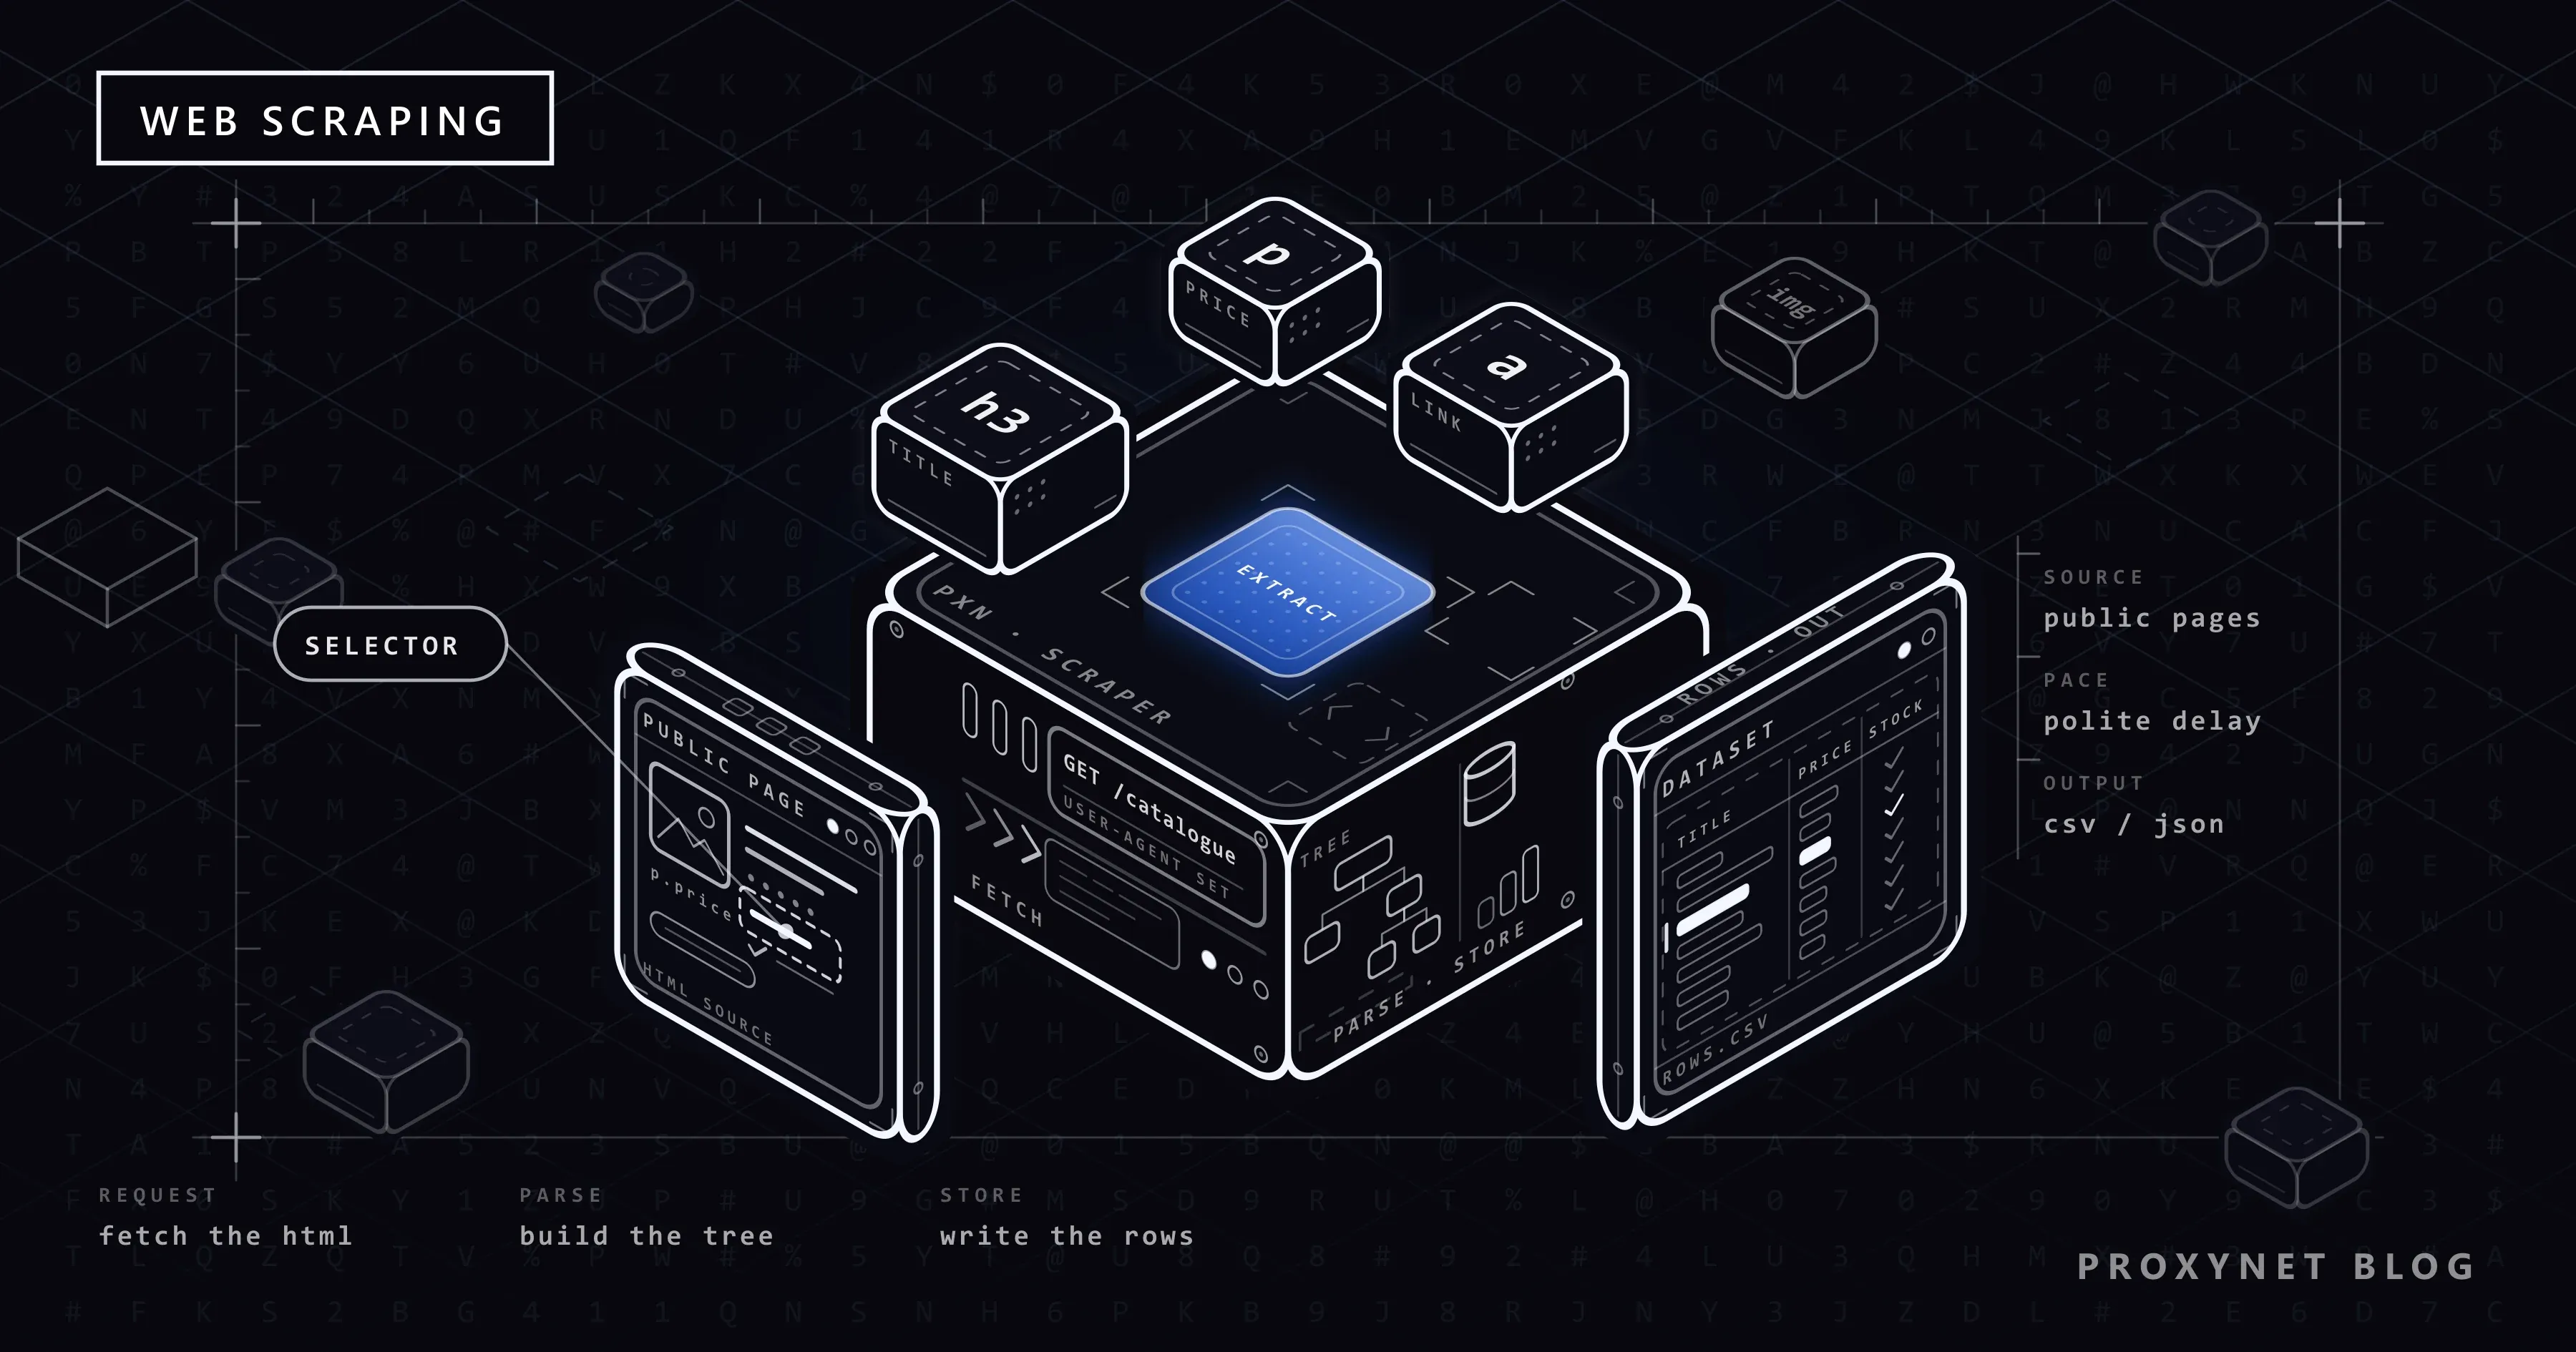
Web Scraping bedeutet, Webseiten mit Software zu lesen und bestimmte Informationen daraus in eine strukturierte Form zu übertragen. Wer eine Produktseite ansieht, sieht ein Bild, einen Titel und einen Preis. Ein Scraper sieht den Text hinter der Seite, den HTML-Code, und nimmt nur die Teile heraus, die er finden soll: Produktnamen, Preise, Daten, Tabellenzellen, Links.
Data Scraping ist der weitere Begriff und umfasst auch das Herausziehen von Daten aus Dateien, PDFs oder alten Programmoberflächen; Web Scraping ist der Teil, der mit Websites arbeitet. Datenextraktion ist der Schritt innerhalb des Scrapings, in dem die Felder herausgegriffen werden. Ein Scraper ist auch kein Hacking-Werkzeug. Er liest dieselben Seiten, die jeder Besucher öffnen kann, nur schneller, und genau diese Geschwindigkeit ist der Grund, warum für Scraping Regeln gelten.
Legen Sie fest, welche Felder Sie brauchen, bevor Sie Code schreiben. Der Scraper füllt dann pro Produkt oder Artikel eine Zeile. Wer „für alle Fälle alles auf der Seite“ sammelt, bekommt Daten, die schwerer zu bereinigen sind und eher personenbezogene Informationen enthalten, die Sie nicht speichern sollten.
Wie funktioniert Web Scraping?
Jeder Scraper, von der Browsererweiterung bis zum System, das Millionen Seiten besucht, durchläuft dieselbe Schleife. Wir verfolgen darin einen echten Preis: das erste Buch auf der Kategorieseite Travel von books.toscrape.com, einer Website, die sich selbst als Demo-Website für Web Scraping bezeichnet und deren Preise zufällig sind.
- Seiten auswählen. Der Scraper beginnt mit einer Liste von Adressen, die Sie selbst schreiben oder die ein Crawler erstellt, der Links folgt. Unsere Liste hat einen einzigen Eintrag, die Kategorieseite Travel.
- Regeln prüfen. Suchen Sie nach einer offiziellen API oder einem Download-Link, lesen Sie die Nutzungsbedingungen und rufen Sie die robots.txt der Website ab. Auf der Übungsseite liefert diese Adresse einen 404-Fehler; die Seite existiert, um gescrapt zu werden.
- Anfrage senden. Das Programm fordert die Seite mit einer HTTP-Anfrage beim Server an, also mit derselben Nachricht, die ein Browser sendet. Ein Scraper mit guten Manieren fügt einen User-Agent-Header hinzu, der sagt, was er ist.
- HTML empfangen. Der Server antwortet mit einem Statuscode (200 bedeutet, dass die Seite ausgeliefert wurde) und dem HTML. Unser Preis kommt als
<p class="price_color">£45.17</p>an: Text in Tags, noch keine Zahl. - HTML parsen. Ein Parser verwandelt den Text in einen Baum verschachtelter Elemente, den das Programm durchsuchen kann. Diesen Schritt haben wir in unserem Beitrag über Data Parsing erklärt.
- Felder extrahieren. Ein CSS-Selektor zeigt auf genau das richtige Element: in jeder Produktkarte den Absatz mit der Klasse
price_color. Das Ergebnis ist ein kleiner Datensatz: „It's Only the Himalayas“,£45.17, „In stock“. - Bereinigen und speichern. Leerzeichen werden entfernt, das Währungszeichen wird abgetrennt, wenn Sie rechnen wollen, und der Datensatz wird zur Zeile in einer Datei oder Datenbank; die Formate vergleicht der Beitrag Gescrapte Daten als CSV, JSON und in SQLite speichern.
- Nach Zeitplan wiederholen. Der Scraper geht zur nächsten Seite oder läuft morgen erneut. Erst der Vergleich der heutigen Zeile mit der gestrigen macht eine Preisänderung sichtbar.
Die Schritte 3 bis 7 dauern pro Seite deutlich weniger als eine Sekunde. Die sorgfältige Arbeit steckt in den Schritten 1, 2 und 8.
Web Scraping vs. Web Crawling vs. API
| Web Scraping | Web Crawling | Offizielle API | |
|---|---|---|---|
| Was es tut | Holt Felder aus bekannten Seiten | Findet Seiten, indem es Links folgt | Liefert Daten, die die Website bereits strukturiert hat |
| Was Sie bekommen | Zeilen: Titel, Preis, Datum | Eine Liste von Seitenadressen | JSON oder CSV in einem dokumentierten Format |
| Wer das Format festlegt | Sie, mit Selektoren | Niemand; es ist eine Liste von URLs | Die Website |
| Wann es bricht | Wenn sich das Seitendesign ändert | Wenn sich die Links der Website ändern | Selten; neue Versionen werden angekündigt |
| Welche Regeln gelten | robots.txt, Nutzungsbedingungen, das Gesetz | robots.txt und Crawl-Rate | Ein API-Schlüssel und die Bedingungen der API |
In der Praxis arbeiten die ersten beiden zusammen: Ein Crawler findet die Produktseiten, ein Scraper liest jede davon. Mit Scrapy-Code verglichen haben wir beide in Web Scraping vs. Web Crawling, und unsere Seite Web-Crawler behandelt Proxy-Setups für große Crawls. Bietet eine Website eine API mit den Feldern, die Sie brauchen, ist das fast immer der bessere Weg, weil eine API nicht bricht, wenn ein Designer eine Klasse umbenennt; unser Vergleich von Web Scraping und APIs geht diese Entscheidung durch.
Web-Scraping-Tools: Welcher Typ passt zu wem?
Werkzeugtypen unterscheiden sich vor allem darin, wie viel von der Schleife sie Ihnen abnehmen und wie viel Kontrolle sie Ihnen lassen.
| Werkzeugtyp | Nötiges Können | Gut für | Wo es an Grenzen stößt |
|---|---|---|---|
| Browsererweiterung | Keines | Einige Hundert Zeilen von einer Website, einmalig | Bricht unbemerkt, wenn sich das Layout ändert |
| No-Code-Tool für Desktop oder Cloud | Gering | Geplante Jobs ohne Programmierung | Ihre Daten laufen über einen Dritten; kostenlose Stufen sind begrenzt |
| Python- oder Node.js-Bibliotheken | Mittel | Regelmäßige Jobs, Tausende Seiten, Ihr eigenes Format | Sie schreiben und pflegen den Code selbst |
| Headless-Browser | Mittel bis hoch | Seiten, die ihren Inhalt per JavaScript einfüllen | Langsam und speicherhungrig |
| AI Scraper | Gering bis mittel | Layouts, die sich oft ändern | Kosten pro Seite; ein falscher Wert kann richtig aussehen |
| Gehostete Scraping-API | Gering bis mittel | URL hinein, HTML oder JSON heraus, ohne eigene Server | Monatliche Kosten; die Regeln der Website gelten trotzdem für Sie |
Ein Headless-Browser ist ein echter Browser ohne Fenster, der das JavaScript der Seite für Ihren Code ausführt; wann Sie einen brauchen, steht in Statische und dynamische Seiten beim Web Scraping. Ein AI Scraper überlässt den Schritt „Feld finden“ einem Sprachmodell; die Vor- und Nachteile beschreibt unser Beitrag zum AI Web Scraper. Ohne Code beginnen Sie am besten mit unserem Leitfaden Daten von Websites extrahieren; mit Code geht das BeautifulSoup-Tutorial weiter als das Beispiel unten.
Ist Web Scraping legal?
Öffentliche, nicht personenbezogene Daten in vernünftigem Tempo zu sammeln, ist in den meisten Rechtsordnungen nicht an sich verboten. Was die Antwort ändert, ist, was Sie sammeln und wie: Personenbezogene Daten fallen unter Gesetze wie die DSGVO der EU, auch wenn sie offen sichtbar sind, urheberrechtlich geschützte Texte und Datenbanken genießen eigenen Schutz, und Nutzungsbedingungen können das automatisierte Sammeln verbieten. Scraping hinter einem Login oder an einer technischen Sperre vorbei bringt Sie auf deutlich unsichereren Boden. Die Regeln nach Ländern finden Sie in Ist Web Scraping legal?; dieser Beitrag ist keine Rechtsberatung.
Warum sperren Websites Scraper?
Ein Mensch liest eine Seite eine Minute lang; ein unachtsames Skript kann in derselben Minute hundert Seiten anfordern und die Website für alle verlangsamen. Drei Mechanismen entscheiden, ob ein Scraper weiterhin Antworten bekommt.
- Rate Limits. Der Server zählt die Anfragen pro Adresse oder Konto innerhalb eines Zeitfensters. Über dem Limit antwortet er mit
429 Too Many Requests, definiert in RFC 6585, optional mit einemRetry-After-Header, der angibt, wie lange zu warten ist. Der RFC legt nicht fest, wie der Server zählt, deshalb setzt jede Website ihre eigene Schwelle; mehr dazu in unserem Beitrag zu 429 Too Many Requests. - IP-Reputation. Adressen haben eine Vorgeschichte. IP-Bereiche von Rechenzentren, Adressen, die in Spam aufgetaucht sind, und Adressen, die Tausende Anfragen pro Stunde senden, genießen weniger Vertrauen als ein Heimanschluss.
- Bot-Scores. Bot-Schutzdienste verrechnen Anfragerate, Header, den TLS-Handshake und die Frage, ob JavaScript ausgeführt wird, zu einem Score; unterhalb einer Schwelle bekommt der Besucher eine Prüfung oder eine Sperre. Die einzelnen Ebenen erklärt Bot-Erkennung: So funktionieren Anti-Bot-Systeme.
Wo kommt ein Proxy ins Spiel?
Ein Proxy-Server leitet Ihre Anfragen weiter, und die Website sieht die IP-Adresse des Proxys statt Ihrer eigenen. Das zählt in zwei legitimen Situationen. Die erste ist der Standort: Ein Shop, der in Deutschland einen Preis zeigt und in Türkiye einen anderen, lässt sich nur aus dem jeweiligen Land prüfen, und mit einem Residential-Proxy mit Standort-Targeting wählen Sie Land und Stadt. Die zweite ist das Volumen: Ein großer Job sollte sich nicht auf einer einzigen Adresse ballen, und ein Rotierender Proxy gibt jeder Anfrage oder jeder Sitzung von einigen Minuten eine andere IP aus einem Pool. Unsere Seite Data Scraping ordnet Proxy-Typen den passenden Aufgaben zu.
Ein Proxy ist kein Mittel, ein Rate Limit oder eine Sperre zu umgehen. Antwortet eine Website mit 429 oder bittet sie Sie aufzuhören, dann werden Sie langsamer, wechseln zur API oder fragen um Erlaubnis; die IP zu wechseln, um das Tempo zu halten, ist genau das, was das Limit verhindern soll. Die Diagnoseliste finden Sie in Web Scraping ohne Sperren: Daten regelkonform erfassen.
Checkliste für verantwortungsvolles Web Scraping
- Zuerst die API. Suchen Sie nach einer offiziellen API, einem Download oder einem Feed, bevor Sie eine Seite parsen.
- robots.txt befolgen. RFC 9309 legt die Datei unter
/robots.txtim obersten Pfad ab und stellt klar, dass ihre Regeln keine Form der Zugriffsautorisierung sind. Sie ist eine Bitte, kein Schloss: Nichts hindert einen Scraper daran, sie zu ignorieren, und deshalb liegt es an Ihnen, sie einzuhalten. Wie man die Datei liest, erklärt unser Leitfaden zu robots.txt. - Nutzungsbedingungen lesen. Eine Website, die automatisiertes Sammeln verbietet, ist kein Ziel.
- Nur öffentliche Seiten, niemals Inhalte hinter dem Login einer anderen Person.
- Personenbezogene Daten weglassen. Was zu tun ist, wenn sie doch hineinrutschen, steht in Personenbezogene Daten (PII) in Scraping-Datensätzen.
- Langsames, gleichmäßiges Tempo halten: Sekunden zwischen den Anfragen an eine kleine Website und ein vollständiger Stopp bei
429oder503. - Sagen Sie, wer Sie sind, mit einem ehrlichen User-Agent statt einer vorgetäuschten Browser-Identität.
Ein kurzes Web-Scraping-Beispiel in Python
Python ist ein verbreiteter Einstieg, weil zwei Bibliotheken die schwierigen Teile übernehmen. Requests sendet die HTTP-Anfrage. Beautiful Soup ist laut der eigenen Dokumentation eine Python-Bibliothek, mit der man Daten aus HTML- und XML-Dateien herausholt; selbst lädt sie nichts herunter.
pip install requests beautifulsoup4Das Skript liest die Kategorie Travel der Übungsseite, nimmt von jedem Buch Titel, Preis und Lagerstatus und schreibt sie in eine CSV-Datei. Die nummerierten Kommentare entsprechen den Schritten 3 bis 7 oben.
import csv
import os

import requests
from bs4 import BeautifulSoup

URL = "https://books.toscrape.com/catalogue/category/books/travel_2/index.html"

# Optional: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")
proxies = {"http": proxy, "https": proxy} if proxy else None

# 1. Anfrage: die Seite herunterladen
response = requests.get(
    URL,
    headers={"User-Agent": "scraping-intro/1.0 (contact: you@example.com)"},
    proxies=proxies,
    timeout=20,
)
response.raise_for_status()
response.encoding = "utf-8"

# 2. Parsen: den HTML-Text in einen durchsuchbaren Baum umwandeln
soup = BeautifulSoup(response.text, "html.parser")

# 3. Extrahieren: dieselben drei Felder aus jeder Produktkarte
rows = []
for card in soup.select("article.product_pod"):
    rows.append({
        "title": card.h3.a["title"],
        "price": card.select_one("p.price_color").get_text(strip=True),
        "stock": card.select_one("p.availability").get_text(strip=True),
    })

# 4. Speichern: die Zeilen in eine CSV-Datei schreiben
with open("travel_books.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(f, fieldnames=["title", "price", "stock"])
    writer.writeheader()
    writer.writerows(rows)

print(len(rows), "Bücher in travel_books.csv gespeichert")
for row in rows[:3]:
    print(row["price"], "|", row["stock"], "|", row["title"])
Mit Python 3.13, Requests 2.34 und Beautiful Soup 4.15 ausgeführt, gab das Skript Folgendes aus:
11 Bücher in travel_books.csv gespeichert
£45.17 | In stock | It's Only the Himalayas
£49.43 | In stock | Full Moon over Noah’s Ark: An Odyssey to Mount Ararat and Beyond
£48.87 | In stock | See America: A Celebration of Our National Parks & Treasured Sites
Drei Zeilen stehen aus gutem Grund im Skript. Ohne timeout=20 gibt Requests bei einem Server, der nicht antwortet, nie auf, wie seine Dokumentation warnt, und das Skript hängt. Die Übungsseite sendet Content-Type: text/html ohne Zeichensatz, also greift Requests auf ISO-8859-1 zurück; als wir response.encoding = "utf-8" entfernten, kam jeder Preis als £45.17 heraus. Und raise_for_status() bricht bei einer 4xx- oder 5xx-Antwort ab, sodass nie eine Fehlerseite als Daten gespeichert wird.
Um über einen Proxy zu gehen, setzen Sie vor dem Start PROXY_URL auf http://user:pass@pr.proxynet.io:8000; sonst ändert sich nichts. Wir haben das mit einem lokalen Test-Proxy geprüft: Mit den richtigen Zugangsdaten kamen dieselben 11 Zeilen zurück, ein falsches Passwort löste einen ProxyError mit 407 Proxy Authentication Required aus. Für Paginierung, Wiederholungsversuche und einen rotierenden Pool geht es weiter mit Web Scraping in Python mit rotierenden Proxys.
Wofür wird Web Scraping verwendet?
- Preis- und Bestandsüberwachung: die öffentlichen Preise und Lagerbestände von Wettbewerbern verfolgen. Das Setup beschreibt unsere Seite Preisüberwachung.
- Marktforschung: Produktanzahl, Preisspannen und Markenmix über mehrere Shops hinweg zeigen, wie sich ein Markt bewegt. Siehe unsere Seite Marktforschung.
- SEO-Daten: Ihre eigenen Rankings kommen aus der offiziellen Search Console API, lizenzierte SERP-Daten füllen die Lücken. Googles Spam-Richtlinien werten das Scraping von Suchergebnissen zur Ranking-Prüfung ohne ausdrückliche Erlaubnis als Verstoß; den offiziellen Weg zeigt So automatisieren Sie das SEO-Rank-Tracking.
- Forschung und Data Science: Öffentliche Einträge und Statistiken, über längere Zeit gesammelt, werden zu einem Datensatz für die Analyse, dem Thema von Data Mining: Verfahren, Anwendung und Datenbeschaffung.
- KI-Tools und RAG: Bei Retrieval-Augmented Generation (RAG) schlägt ein KI-Modell aktuelle Dokumente nach, bevor es antwortet, und diese Dokumente holen oft Scraper. Die Grenzen beschreibt Sicherer Webzugriff für LLMs.
- Prüfung der eigenen Website: fehlende Beschreibungen, falsche Preise und defekte Links über Tausende Seiten. Unser Beitrag zu HTTP-Statuscodes beim Web Scraping hilft, die Antworten zu lesen.
Häufige Fehler
- Scrapen, obwohl es eine API gibt. Der Job bricht dann bei jedem Redesign.
- Kein Timeout. Ein einziger Server, der nicht antwortet, kann ein Skript die ganze Nacht blockieren.
- Die Kodierung ignorieren.
£statt£oder kaputte Umlaute bedeuten, dass der Zeichensatz falsch geraten wurde. - Ein leeres Ergebnis für Daten halten. Ein Selektor, der nicht mehr passt, liefert meist eine leere Spalte statt eines Fehlers. Prüfen Sie bei jedem Lauf die Zeilenzahl.
- Einen Proxy nutzen, um über ein Limit hinwegzugehen. Ein
429bittet Sie, langsamer zu werden; IPs zu rotieren, um das Tempo zu halten, verschärft das Problem nur. - Mit einem Headless-Browser anfangen. Stehen die Daten schon im HTML, kostet ein echter Browser nur Zeit und Speicher.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Die Website bietet eine API mit Ihren Feldern | Die API statt Scraping nutzen |
| Eine Tabelle von einer Seite, einmalig | Import in eine Tabellenkalkulation oder eine Browsererweiterung |
| Dieselben Seiten jeden Tag | Ein Python-Skript mit Pause, Timeout und Prüfung der Zeilenzahl |
| Inhalt erscheint erst, wenn JavaScript läuft | Zuerst die JSON-Quelle der Seite, dann ein Headless-Browser |
| Preise unterscheiden sich je nach Land | Residential-Proxys mit Targeting auf dieses Land |
| Tausende Seiten in höflichem Tempo | Ein Crawler mit rotierenden Proxys, die die Last verteilen |
| Die Website antwortet mit 429 | Langsamer werden und Retry-After beachten |
| Personenbezogene Daten oder der Login einer anderen Person | Nicht scrapen; beim Website-Betreiber nachfragen |
Häufige Fragen
Wofür wird Web Scraping in der Data Science genutzt?
Für Datensätze, die es nicht fertig gibt: Preise über mehrere Shops im Zeitverlauf, Stellenanzeigen nach Stadt, Bewertungen für Textanalysen. Der Wert entsteht meist dadurch, dass die Erhebung wochenlang wiederholt wird; ein stabiler Zeitplan zählt daher mehr als Geschwindigkeit.
Kann man Web Scraping ohne Programmierkenntnisse betreiben?
Ja. Tabellenimporte, Browsererweiterungen und No-Code-Tools erledigen einmalige Jobs und einfache Layouts. Bei großen Mengen, täglichen Wiederholungen und Seiten, die sich oft ändern, macht ein kurzes Skript mit Fehlerprüfungen am Ende weniger Arbeit.
Warum wird Python so oft für Web Scraping verwendet?
Weil die Bausteine fertig sind: Requests zum Herunterladen, Beautiful Soup zum Parsen, Scrapy für große Crawls und Playwright für Seiten, die einen Browser brauchen. Node.js ist eine verbreitete Alternative; beide haben wir in Web Scraping: JavaScript oder Python? verglichen.
Kann eine Website erkennen, dass sie gescrapt wird?
Oft ja. Anfragerate, User-Agent, fehlende JavaScript-Ausführung und IP-Reputation deuten alle auf Automatisierung hin. Ein Scraper, der sich zu erkennen gibt und ein niedriges Tempo hält, wird meist geduldet; einer, der sich als Browser ausgibt und Hunderte Anfragen pro Minute sendet, wird meist gesperrt.
Funktioniert Web Scraping auf jeder Website?
Nein. Seiten hinter einem Login, Text, der in Bilder gezeichnet ist, und Daten, die nur in einer mobilen App existieren, sind für einen einfachen Scraper außer Reichweite, und vieles davon sollte es auch bleiben. Seiten, die Inhalte per JavaScript laden, lassen sich lesen, brauchen aber einen Headless-Browser oder die eigene Datenquelle der Seite.
Braucht man für Web Scraping einen Proxy?
Nicht für einen kleinen, langsamen Job aus einem Land. Sie brauchen einen, wenn sich Inhalte je nach Land ändern, wenn ein großer Job seine Last auf viele Adressen verteilen muss oder wenn eine Sitzung mit Ihrem eigenen Konto dieselbe IP behalten muss. Ein Proxy hebt weder das Rate Limit noch die Nutzungsbedingungen einer Website auf.
Fazit
Web Scraping ist die automatisierte Form davon, eine Seite zu lesen und das Nötige in eine Tabelle zu übertragen: Seite anfordern, HTML parsen, Felder extrahieren, Zeilen speichern, nach Zeitplan wiederholen. Crawling findet die Seiten, Scraping liest sie, und eine offizielle API macht beides überflüssig, wenn es sie gibt. Wählen Sie das einfachste Werkzeug, das die Aufgabe erfüllt, prüfen Sie zuerst robots.txt und die Nutzungsbedingungen, lassen Sie personenbezogene Daten weg und halten Sie das Tempo niedrig. Braucht ein Job länderspezifische Ergebnisse oder muss er seine Last auf viele Adressen verteilen, finden Sie den passenden Proxy-Typ unter unseren Proxy-Diensten.