Ihr Python-Skript sammelt jeden Morgen Produktseiten von einigen Dutzend Shops. Es funktioniert bei allen außer einem. Dieser Shop antwortet mit einem 403 und einer kurzen HTML-Seite, die JavaScript und Cookies verlangt. Auch ein erneuter Lauf liefert dieselbe Seite. Der Shop steht hinter Cloudflare, und Cloudflare hat geantwortet, bevor der eigene Server des Shops Ihre Anfrage überhaupt gesehen hat.
Früher oder später bekommt jeder Cloudflare-Scraper eine solche Antwort. Dieser Beitrag zeigt, wie Sie sie lesen, welche legitimen Wege zu den Daten führen und was ein Proxy ändern kann und was nicht. Am Ende steht ein getesteter Python-Scraper, der jede Cloudflare-Antwort einordnet und aufhört, sobald die Website ablehnt. Eine Prüfung zu umgehen, versucht er dabei nicht.
Was bedeutet der Begriff Cloudflare-Scraper?
Ein Cloudflare-Scraper ist kein besonderes Werkzeug, sondern jeder Scraper, dessen Ziel-Website ihren Datenverkehr über Cloudflare leitet. (Einige Python-Pakete, die Prüfungen lösen, tragen denselben Namen; warum wir sie auslassen, erklären wir weiter unten.) Bei einer solchen Website liefert DNS die Adressen von Cloudflare, Ihre Anfrage erreicht also zuerst einen Cloudflare-Server. Dort wendet Cloudflare die Sicherheitseinstellungen des Betreibers an und leitet nur die Anfragen, die durchkommen, an den Ursprungsserver (den eigenen Server der Website) weiter. Dieser Aufbau ist ein Reverse-Proxy: Er arbeitet für die Website, während ein Forward-Proxy, den Sie in Ihrem Scraper eintragen, für Sie arbeitet (Forward-Proxy und Reverse-Proxy).
Wie entscheidet Cloudflare, ob eine Anfrage von einem Bot kommt?
Cloudflare wendet die Einstellungen des Betreibers nacheinander an. Die erste, die die Anfrage blockiert oder ihr eine Prüfung vorlegt, beendet den Durchlauf. Vereinfacht:
- IP- und Header-Prüfung. IP Access Rules prüfen die IP-Adresse, ihr Netz (ASN) oder ihr Land. Browser Integrity Check ist standardmäßig aktiv und legt Anfragen mit fehlendem oder ungewöhnlichem
User-Agenteine Prüfung vor. - Eigene Regeln (Custom Rules). Die eigenen Regeln des Betreibers können Pfad, Land,
User-Agent, Bot-Score und mehr auswerten. - Rate-Limiting-Regeln. In den meisten Tarifen werden Anfragen pro IP gezählt. Advanced Rate Limiting im Enterprise-Tarif kann auch pro Cookie, Header, ASN oder, zusammen mit Bot Management, pro TLS-Fingerabdruck (JA3/JA4) zählen.
- Managed Rules und Bot-Produkte. Bekannte Angriffsmuster werden geprüft, danach greift je nach Tarif Bot Fight Mode, Super Bot Fight Mode oder Bot Management.
- Die Antwort. Die Anfrage erreicht den Ursprungsserver, erhält eine Fehlerseite oder eine Prüfung, die im Browser Tests ausführt und bei Erfolg ein
cf_clearance-Cookie setzt.
Die Signale hinter jedem Schritt beschreibt Bot-Erkennung: So funktionieren Anti-Bot-Systeme, die Sitzungsebene Cloudflare Precursor.
Auf welche Cloudflare-Sperre ist Ihr Scraper gestoßen?
Ein 403 von einer Cloudflare-Website kann eine Prüfung, eine Firewall-Regel, ein gesperrtes Netz oder eine Ablehnung durch den Ursprungsserver selbst bedeuten. Sehen Sie sich zuerst die Header an, dann den Statuscode, dann den Body und zuletzt das Ergebnis Ihrer eigenen Inhaltsprüfung. Die Header cf-ray und server: cloudflare allein sagen nichts, denn jede Antwort, die durch Cloudflare läuft, enthält sie.
| Was Sie sehen | Status | Signal | Bedeutung | Nächster Schritt |
|---|---|---|---|---|
| Eine kurze Seite, die JavaScript verlangt | Oft 403 | cf-mitigated: challenge | Eine Prüfseite | Aufhören; nicht versuchen, sie zu lösen |
| Eine normale Seite mit Turnstile-Formular | 200 | Ein cf-turnstile-Element | Turnstile schützt dieses Formular | Formular nicht absenden |
| „Sorry, you have been blocked“ | Standardmäßig 403 | Cloudflare-Seite mit Ray ID, ohne 1xxx-Code | Eine WAF-Regel des Betreibers | Aufhören; dem Betreiber die Ray ID senden |
| Error 1020, „Access denied“ | 403 | Ein 1xxx-Code von Cloudflare | Eine ältere Firewall-Regel | Aufhören; dem Betreiber die Ray ID senden |
| Error 1010 | 403 | Wie oben | Browser Integrity Check hat Sie blockiert | Den Betreiber fragen |
| Error 1005, 1006-1008, 1106 oder 1009 | 403 | Wie oben | Ihr Netz (ASN), Ihre IP oder Ihr Land ist gesperrt | Aufhören; nicht das Netz wechseln |
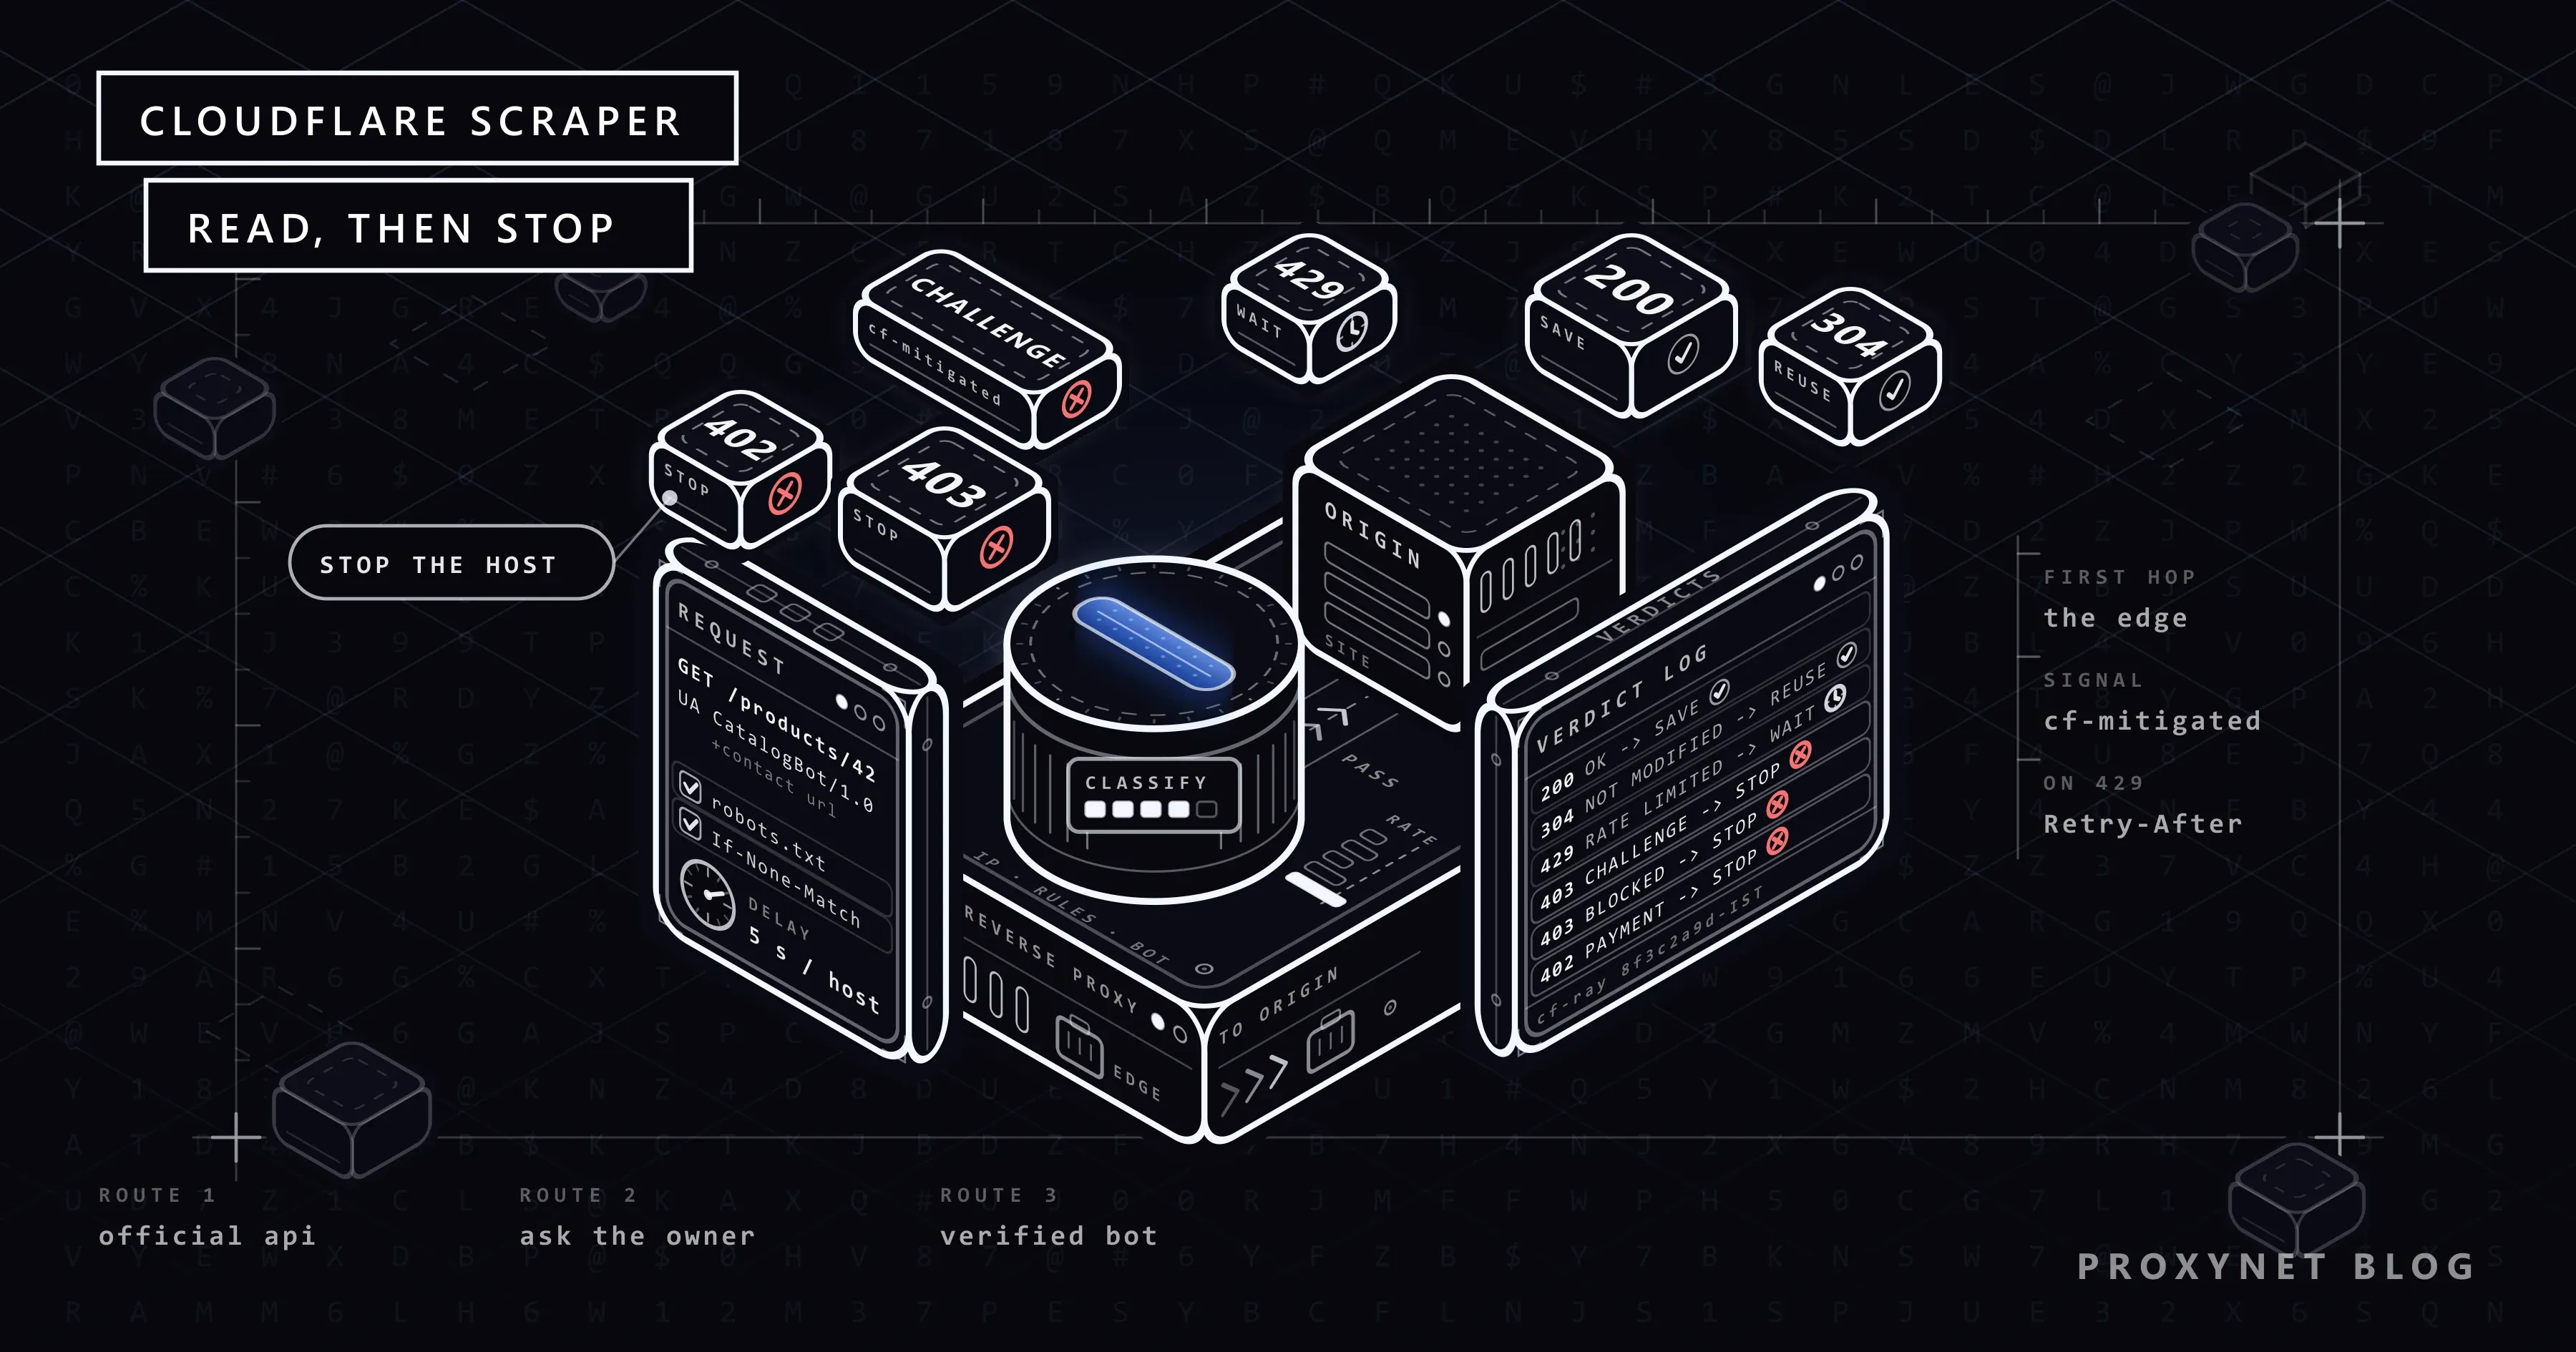
| Error 1015 | Standardmäßig 429 oder ein 4xx nach Wahl des Betreibers | 1015 im Body oder der 429 | Ein Rate Limit, je nach Tarif von 10 Sekunden bis zu einem Tag | Warten, Retry-After beachten, Tempo senken |
| Ein Zahlungshinweis | 402 | Header crawler-price | Pay per Crawl für KI-Crawler | Aufhören, außer Sie nehmen teil |
| Eine schlichte Fehlerseite | 403 | Kein Cloudflare-Fehlercode, keine Ray ID | Der Ursprungsserver hat abgelehnt | Aufhören; den Betreiber fragen |
| Eine Seite ohne Ihre Daten | 200 | Ihre Inhaltsprüfung schlägt fehl | Eine per JavaScript aufgebaute Seite oder eine Fallenseite | Nicht speichern; siehe Statische und dynamische Seiten und Honeypot-Fallen |
| Ein Serverfehler | 5xx, auch 520-526 | Statuscode | Ein Problem am Ursprungsserver, keine Sperre | Pausieren, einige Male wiederholen |
Vier Details sind hier wichtig:
- Verlassen Sie sich auf den Header, nicht auf den Text. Cloudflare dokumentiert
cf-mitigated: challengeals Weg, eine Antwort mit Prüfseite zu erkennen: Jede Art von Prüfung setzt diesen Header, undchallengeist sein einziger Wert. Der Text der Prüfseite ändert sich mit der Sprache des Browsers, und/cdn-cgi/challenge-platform/erscheint auch auf normalen Seiten. Wie dieselbe Seite für Besucher aussieht, zeigt Cloudflare-Prüfung „Verifying you are human“. - Fehlercodes gibt es in zwei Formen. Cloudflare sendet entweder eine HTML-Seite im Cloudflare-Design („Error 1020“) oder einen kurzen Text-Body wie
error code: 1003. Die Kurzform haben wir erhalten, als wir eine Cloudflare-IP-Adresse direkt aufgerufen haben, auch mit einem Browser-User-Agent. - Nicht jeder 1xxx-Code ist eine Sperre. Error 1016 zum Beispiel ist ein DNS-Fehler beim Ursprungsserver, das Problem liegt also bei der Website.
- Sperren kommen ohne
cf-mitigated-Header. Nur der Body unterscheidet eine Cloudflare-Sperre vom eigenen403des Ursprungsservers: ein Fehlercode oder eine Cloudflare-Seite mit Ray ID. Die Codes einzeln erklärt „Sorry, You Have Been Blocked“, die Rate Limits der Beitrag zu Error 1015.
Warum blockiert Cloudflare Python Requests, obwohl ein Browser durchkommt?
Chrome lädt die Seite nach kurzer Wartezeit, Python Requests bekommt die Prüfseite. Drei Dinge unterscheiden sich.
Kein JavaScript. Laut Cloudflare braucht ein Besucher für jede Art von Prüfung JavaScript und Cookies. Requests, httpx und curl laden HTML herunter, führen den Code darin aber nie aus.
Kein Freigabe-Cookie. Ein Browser, der die Prüfung besteht, speichert ein cf_clearance-Cookie und sendet es mit jeder weiteren Anfrage. Ein einfacher HTTP-Client bekommt nie eines.
Eine widersprüchliche Client-Identität. Python-Bibliotheken bauen eine TLS-Verbindung anders auf als Chrome. Eine Anfrage, die im User-Agent „Chrome“ angibt, aber den TLS-Handshake von Python zeigt, fällt deshalb leicht auf (TLS-Fingerprinting und JA3). Auch ein ehrlicher Bot-Name kann den Browser Integrity Check auslösen, der ungewöhnlichen User-Agent-Werten eine Prüfung vorlegt; eine Ausnahme kann nur der Betreiber einrichten.
Manche Werkzeuge geben ein Skript als Browser aus: Stealth-Plugins, Bibliotheken zur TLS-Imitation, gepatchte Treiber und Dienste zum Lösen von Prüfungen. Diese behandeln wir nicht. Sie geben Ihren Client als etwas aus, das er nicht ist, verstoßen meist gegen die Nutzungsbedingungen der Website und funktionieren nicht mehr, sobald sich die Erkennung ändert.
Welche legitimen Wege führen zu den Daten einer Website hinter Cloudflare?
Wir würden die Wege in dieser Reihenfolge versuchen.
1. Eine offizielle API, ein Feed oder eine Sitemap
Viele Websites veröffentlichen Daten für Maschinen: eine API, einen RSS- oder Produktfeed oder eine Sitemap, die in der robots.txt steht. Eine API gibt Ihnen einen Schlüssel, ein dokumentiertes Limit und ein stabiles Format, und Ihr Code läuft weiter, wenn sich das HTML ändert. Sehen Sie sich den Footer, die Entwicklerseiten und die Sitemap:-Zeilen in der robots.txt an, bevor Sie einen Scraper schreiben.
2. Den Website-Betreiber fragen
Nur der Betreiber kann eine Prüfung oder Sperre aufheben, die Mitarbeiter von Cloudflare können es nicht. Schreiben Sie eine kurze Nachricht mit dem Namen Ihres Bots, einer Kontaktadresse, den Pfaden, die Sie brauchen, der Häufigkeit Ihrer Besuche und Ihrer IP-Adresse. Der Betreiber kann Ihre IP dann mit einer IP Access Rule freigeben. Eine solche Regel überspringt Custom Rules, Rate Limiting und Managed Rules, und auch Bot Fight Mode greift dann nicht. In den kostenpflichtigen Tarifen kann eine Skip-Regel Sie außerdem von Super Bot Fight Mode ausnehmen; auch sie richtet sich meist nach einer festen IP oder nach einem vereinbarten Token im Header. Für eine feste Adresse lesen Sie Statische IP für APIs oder nutzen Sie einen ISP-Proxy.
3. An Cloudflares Programm für verifizierte Bots teilnehmen
Für einen Crawler, der der Öffentlichkeit dient, ist Cloudflares Programm für verifizierte Bots der formelle Weg. Ein verifizierter Bot weist nach, wer er ist: mit einer Signatur per Web Bot Auth, einer veröffentlichten IP-Liste mit gleichbleibendem User-Agent oder per Reverse DNS. Er muss die robots.txt beachten und ein angemessenes Tempo einhalten. Der Antrag läuft über ein Formular im Cloudflare-Dashboard; allgemeine Namen wie python-requests werden für die IP-Validierung nicht akzeptiert. Seit dem 1. Juli 2026 umfasst das Programm auch signierte Agenten, die im Auftrag von Nutzern handeln, und zu seinen Kategorien gehören SEO, Monitoring und Preis-Scraping.
Bei Web Bot Auth signiert der Bot jede Anfrage mit seinem privaten Schlüssel nach RFC 9421 HTTP Message Signatures, seit Februar 2024 ein Standard, und veröffentlicht den öffentlichen Schlüssel auf seiner eigenen Domain. Die IETF-Arbeitsgruppe hat die Regeln für Bots am 1. September 2026 als Entwurf übernommen (draft-ietf-webbotauth-httpsig-protocol); den vollständigen Ablauf beschreibt Warum werden KI-Shopping-Agenten blockiert?. Die Verifizierung belegt, wer Sie sind, doch ob verifizierte Bots hereinkommen, entscheidet weiterhin der Betreiber.
4. Für KI-Crawler: Standardeinstellungen und Pay per Crawl
Seit Juli 2025 blockieren neue Cloudflare-Domains KI-Crawler standardmäßig. Ab dem 15. September 2026 blockieren neue Domains auf Seiten mit Werbung außerdem Bots der Kategorien Training und Agent, während Search erlaubt bleibt. Manche Websites ergänzen ihre robots.txt um Content-Signal-Zeilen wie ai-train=no; urllib.robotparser ignoriert sie (das haben wir geprüft), lesen Sie sie also selbst aus. Pay per Crawl startete im Juli 2025 als private Beta, und im September 2026 bezeichnet Cloudflares Dokumentation es noch als geschlossene Beta. Ein Crawler ohne Zahlungs-Header bekommt einen 402 mit dem Header crawler-price.
5. Ein echter Browser, nur wo nötig
Baut eine Seite ihre Daten per JavaScript auf und erlaubt die Website Automatisierung, liefert Playwright die gerenderte Seite (Playwright mit Proxy). Sehen Sie zuerst im Netzwerk-Tab nach: Oft kommen die Daten aus einer JSON-Anfrage, die auch ein einfacher Client aufrufen kann. Cloudflare stellt klar, dass es Automatisierungs-Frameworks wie Playwright zum Lösen seiner Prüfungen nicht unterstützt. Erscheint eine Prüfung, hören Sie also auf und gehen zurück zu Weg 2.
Wo helfen Proxys und wo nicht?
Ein Proxy ändert nur die IP-Adresse und das Netz Ihrer Anfrage. Er ändert nicht den TLS-Handshake, führt kein JavaScript aus und bringt kein cf_clearance mit. Wer die IP bei jeder Anfrage wechselt, lässt einen einzigen Client wie viele unbekannte Besucher ohne Vorgeschichte aussehen (wie IP-Rotation funktioniert).
In drei Fällen ist er das richtige Werkzeug:
- Inhalte für ein Land. Ein Residential-Proxy in diesem Land zeigt die Seite so, wie lokale Besucher sie sehen.
- Eine feste IP, die der Betreiber freigegeben hat. Ein ISP-Proxy sorgt dafür, dass diese Adresse gleich bleibt.
- Viele Websites, jede in einem rücksichtsvollen Tempo. Ein Rotierender Proxy kann jeder Website eine andere Ausgangsadresse geben, ein Sticky-Proxy behält für jede Website eine feste. Nutzen Sie Rotation nie, um einer Website mehr Anfragen zu schicken, als einer einzelnen IP erlaubt wären.
Eine Sperre zu umgehen gehört nicht dazu: Nach Error 1005 oder 1006 das Netz zu wechseln ist genau das, was diese Regeln verhindern sollen.
Ein Cloudflare-Scraper in Python, der weiß, wann Schluss ist
Das Skript ist für Aufgaben gedacht, die Sie ausführen dürfen, etwa öffentliche Kataloge auf Websites, die Crawling erlauben, oder eine Website, deren Betreiber Ihre IP freigegeben hat. Ohne zu versuchen, eine Prüfung zu bestehen, macht es Folgendes:
- Es sendet einen ehrlichen
User-Agentmit Bot-Namen und Kontakt-URL. - Es liest die
robots.txteinmal pro Host über denselben Klassifizierer. Trifft es dort auf eine Prüfung oder Sperre, crawlt es diesen Host nicht weiter (eine eigene, vorsichtige Regel: Nach RFC 9309 gilt ein4xxals „keine Regeln“). - Es protokolliert den tatsächlichen Fehler, wenn die
robots.txtnicht abrufbar ist, etwa nach einem407wegen eines falschen Proxy-Passworts, damit ein Einrichtungsfehler nicht wie eine Ablehnung aussieht. - Es wartet zwischen zwei Anfragen an denselben Host
MIN_DELAYSekunden oder einen längerenCrawl-delay(nur ganze Sekunden:urllib.robotparserignoriert1.5). - Es sendet
If-None-MatchundIf-Modified-Since, sodass eine unveränderte Seite nur einen304kostet. - Bei einem
429oder5xxbeachtet esRetry-Afterin beiden Formen, die RFC 9110 erlaubt. Fehlt der Header, verdoppelt es seine Wartezeit, begrenzt sie aufMAX_WAITund gibt den Host nachMAX_RETRIESWiederholungen auf (HTTP-Statuscodes beim Web Scraping). - Bei einer Prüfung, einer Sperre oder einem
402protokolliert es die URL und dencf-ray-Wert und überspringt diesen Host.
Es nutzt das synchrone Requests (pip install requests), denn das Ziel ist pro Host eine rücksichtsvolle Anfrage nach der anderen (HTTPX, Requests und AIOHTTP im Vergleich).
"""Ein kleiner Scraper für Websites hinter Cloudflare: liest jede Antwort und hört bei einem Nein auf."""
import email.utils
import logging
import math
import re
import time
from datetime import datetime, timezone
from enum import Enum
from urllib.parse import urlsplit
from urllib.robotparser import RobotFileParser

import requests

BOT_NAME = "NorthwindCatalogBot"
USER_AGENT = f"{BOT_NAME}/1.0 (+https://example.com/bot)"
PROXY = "http://user:pass@pr.proxynet.io:8000"  # feste Ausgangs-IP, die der Betreiber freigegeben hat, oder None
EXPECT = 'data-sku="'  # eine Markierung, die jede echte Produktseite enthält
MIN_DELAY = 5.0        # Sekunden zwischen zwei Anfragen an denselben Host
MAX_WAIT = 300         # vor einer Wiederholung nie länger als so viele Sekunden warten
MAX_RETRIES = 3        # Wiederholungen nach 429 oder 5xx, bevor wir den Host aufgeben
BLOCK_CODES = {"1005", "1006", "1007", "1008", "1009", "1010", "1020", "1106"}

log = logging.getLogger(BOT_NAME)


class Verdict(Enum):
    OK = "ok"
    NOT_MODIFIED = "not_modified"
    CHALLENGE = "challenge"
    BLOCKED = "blocked"
    RATE_LIMITED = "rate_limited"
    PAYMENT_REQUIRED = "payment_required"
    SUSPICIOUS_200 = "suspicious_200"
    SERVER_ERROR = "server_error"
    OTHER = "other"


STOP = {Verdict.CHALLENGE, Verdict.BLOCKED, Verdict.PAYMENT_REQUIRED}
RETRY = {Verdict.RATE_LIMITED, Verdict.SERVER_ERROR}


class StopHost(Exception):
    """Die Website hat Nein gesagt. Wir lassen diesen Host für den Rest des Laufs in Ruhe."""


def page_text(resp):
    """Der Anfang des Bodys ohne HTML-Tags."""
    return re.sub(r"<[^>]+>", " ", resp.text[:20000])


def cloudflare_code(resp):
    """Der 1xxx-Code einer Cloudflare-Fehlerantwort oder None.

    Cloudflare sendet ihn als HTML-Seite im eigenen Design ("Error 1020") oder als
    kurzen Text-Body ("error code: 1020") zusammen mit dem Header "Server: cloudflare".
    """
    text = page_text(resp)
    from_cloudflare = resp.headers.get("Server", "").lower() == "cloudflare"
    short_form = from_cloudflare and text.lstrip().lower().startswith("error code:")
    if not short_form and "cloudflare" not in text.lower():
        return None
    match = re.search(r"(?i)\berror(?:\s+code)?:?\s+(1\d{3})\b", text)
    return match.group(1) if match else None


def classify(resp, expect=EXPECT):
    if resp.headers.get("cf-mitigated") == "challenge":
        return Verdict.CHALLENGE, "Cloudflare challenge page"
    status = resp.status_code
    if status == 304:
        return Verdict.NOT_MODIFIED, "unchanged since the last visit"
    if status == 402:
        return Verdict.PAYMENT_REQUIRED, "402 with crawler-price" if "crawler-price" in resp.headers else "402"
    code = cloudflare_code(resp) if status >= 400 else None
    if status == 429 or code == "1015":
        return Verdict.RATE_LIMITED, f"HTTP {status}, error {code}" if code else f"HTTP {status}"
    if code in BLOCK_CODES or status == 403:
        text = page_text(resp).lower()
        if code:
            why = f"Cloudflare error {code}"
        elif "cloudflare" in text and "ray id" in text:
            why = "Cloudflare block page without a code"  # eine WAF-Regel
        else:
            why = "403 from the origin server"
        return Verdict.BLOCKED, why
    if status >= 500:
        return Verdict.SERVER_ERROR, f"HTTP {status}"
    if status == 200 and expect and expect not in resp.text:
        why = "Turnstile form, no data" if "cf-turnstile" in resp.text else "expected content missing"
        return Verdict.SUSPICIOUS_200, why
    if status == 200:
        return Verdict.OK, "expected content found" if expect else "HTTP 200"
    return Verdict.OTHER, f"HTTP {status}"


def wait_seconds(resp, attempt):
    """Retry-After in einer der beiden Formen aus RFC 9110, sonst ein sich verdoppelndes Backoff. Ganze Sekunden, gedeckelt."""
    value = resp.headers.get("Retry-After", "").strip()
    wait = 30 * 2**attempt
    if value.isdigit():
        wait = int(value)
    elif value:
        try:
            when = email.utils.parsedate_to_datetime(value)
            if when.tzinfo is None:
                when = when.replace(tzinfo=timezone.utc)
            wait = (when - datetime.now(timezone.utc)).total_seconds()
        except (TypeError, ValueError):
            pass
    return min(max(math.ceil(wait), 1), MAX_WAIT)


class PoliteFetcher:
    def __init__(self, proxy=PROXY):
        self.session = requests.Session()
        self.session.headers["User-Agent"] = USER_AGENT
        if proxy:
            self.session.proxies = {"http": proxy, "https": proxy}
        self.robots, self.delay, self.last, self.cache = {}, {}, {}, {}

    def get(self, url, headers=None, expect=EXPECT):
        host = urlsplit(url).netloc
        for attempt in range(MAX_RETRIES + 1):
            pause = self.delay.get(host, MIN_DELAY) - (time.monotonic() - self.last.get(host, -1e9))
            if pause > 0:
                time.sleep(pause)
            resp = self.session.get(url, headers=headers, timeout=20)
            self.last[host] = time.monotonic()
            if resp.status_code == 407:
                raise requests.exceptions.ProxyError("the proxy rejected the credentials (407)")
            verdict, why = classify(resp, expect)
            if verdict in STOP:
                ray = resp.headers.get("cf-ray", "none")
                log.error("STOP %s: %s, %s (cf-ray %s)", url, verdict.value, why, ray)
                raise StopHost(host)
            if verdict not in RETRY:
                return resp, verdict, why
            if attempt < MAX_RETRIES:
                wait = wait_seconds(resp, attempt)
                log.warning("%s %s: %s, waiting at least %d s", verdict.value, url, why, wait)
                time.sleep(wait)
        log.error("STOP %s: still %s after %d retries", url, verdict.value, MAX_RETRIES)
        raise StopHost(host)

    def allowed(self, url):
        parts = urlsplit(url)
        host = parts.netloc
        if host not in self.robots:
            try:
                resp, _, _ = self.get(f"{parts.scheme}://{host}/robots.txt", expect=None)
            except requests.RequestException as exc:
                log.error("STOP %s: robots.txt unreachable (%s)", host, exc)
                raise StopHost(host) from exc
            parser = RobotFileParser()
            parser.parse(resp.text.splitlines() if resp.status_code == 200 else [])
            self.robots[host] = parser
            # urllib.robotparser liest nur ganze Sekunden: "Crawl-delay: 1.5" wird ignoriert
            self.delay[host] = max(MIN_DELAY, parser.crawl_delay(BOT_NAME) or 0)
        return self.robots[host].can_fetch(BOT_NAME, url)

    def fetch(self, url):
        """HTML der Seite oder None, wenn die Seite übersprungen werden soll."""
        if not self.allowed(url):
            log.info("skip %s: disallowed by robots.txt", url)
            return None
        validators, body = self.cache.get(url, ({}, None))
        resp, verdict, why = self.get(url, headers=validators)
        log.log(logging.INFO if verdict in (Verdict.OK, Verdict.NOT_MODIFIED) else logging.WARNING,
                "%s %s: %s", verdict.value, url, why)
        if verdict is Verdict.NOT_MODIFIED:
            return body
        if verdict is not Verdict.OK:
            return None
        saved = {}
        if "ETag" in resp.headers:
            saved["If-None-Match"] = resp.headers["ETag"]
        if "Last-Modified" in resp.headers:
            saved["If-Modified-Since"] = resp.headers["Last-Modified"]
        self.cache[url] = (saved, resp.text)
        return resp.text


def crawl(urls, proxy=PROXY):
    fetcher, stopped, pages = PoliteFetcher(proxy), set(), {}
    for url in urls:
        host = urlsplit(url).netloc
        if host in stopped:
            log.info("skip %s: host stopped earlier", url)
            continue
        try:
            html = fetcher.fetch(url)
        except StopHost:
            stopped.add(host)
            continue
        except requests.RequestException as exc:
            log.warning("network error %s: %s", url, exc)
            continue
        if html is not None:
            pages[url] = html
    return pages


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO, format="%(levelname)-7s %(message)s")
    found = crawl([
        "https://www.example.com/products/1001",
        "https://www.example.com/products/1002",
    ])
    print(f"{len(found)} pages saved")
classify() prüft zuerst cf-mitigated, dann 402 und 429 und sucht danach in beiden Formen nach einem 1xxx-Code. Ein 403 ohne Code gilt als Cloudflare-Sperrseite, wenn der Body Cloudflare nennt und eine Ray ID zeigt. Bei einem 200 lautet das Urteil nur dann ok, wenn die EXPECT-Markierung auf der Seite steht. Wählen Sie deshalb eine Markierung, die eine Prüfseite, ein leeres JavaScript-Gerüst oder eine Fallenseite nicht hätte, etwa ein Attribut mit der Produkt-ID.
So sieht die Ausgabe aus
Wir haben das Skript mit Python 3.13 und Requests 2.34.2 über einen lokalen HTTP-Proxy gegen acht lokale Test-Websites laufen lassen, eine für jede Art von Antwort. Für den Lauf haben wir die beiden Beispiel-URLs in __main__ durch Seiten dieser Test-Websites ersetzt. Die Test-Websites bilden nur die dokumentierten Signale nach, und die Ray IDs stammen von ihnen.
INFO    ok http://127.0.0.1:28150/products/1001: expected content found
INFO    not_modified http://127.0.0.1:28150/products/1001: unchanged since the last visit
INFO    skip http://127.0.0.1:28150/cart: disallowed by robots.txt
WARNING rate_limited http://127.0.0.1:28150/products/1002: HTTP 429, waiting at least 2 s
INFO    ok http://127.0.0.1:28150/products/1002: expected content found
WARNING rate_limited http://127.0.0.1:28150/products/1003: HTTP 429, waiting at least 3 s
INFO    ok http://127.0.0.1:28150/products/1003: expected content found
WARNING suspicious_200 http://127.0.0.1:28150/products/1004: expected content missing
WARNING suspicious_200 http://127.0.0.1:28150/products/1005: Turnstile form, no data
ERROR   STOP http://127.0.0.1:28151/products/1: challenge, Cloudflare challenge page (cf-ray 8f3c2a9d1b7e28151-IST)
INFO    skip http://127.0.0.1:28151/products/2: host stopped earlier
ERROR   STOP http://127.0.0.1:28152/products/1: blocked, Cloudflare error 1020 (cf-ray 8f3c2a9d1b7e28152-IST)
ERROR   STOP http://127.0.0.1:28153/products/1: blocked, Cloudflare block page without a code (cf-ray 8f3c2a9d1b7e28153-IST)
ERROR   STOP http://127.0.0.1:28154/products/1: blocked, Cloudflare error 1006 (cf-ray 8f3c2a9d1b7e28154-IST)
ERROR   STOP http://127.0.0.1:28155/products/1: payment_required, 402 with crawler-price (cf-ray 8f3c2a9d1b7e28155-IST)
ERROR   STOP http://127.0.0.1:28156/robots.txt: challenge, Cloudflare challenge page (cf-ray 8f3c2a9d1b7e28156-IST)
INFO    skip http://127.0.0.1:28156/products/2: host stopped earlier
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
ERROR   STOP http://127.0.0.1:28157/products/1: still rate_limited after 3 retries
3 pages saved
Die erste Seite ist ok, obwohl sie ein Skript von /cdn-cgi/challenge-platform/ lädt. Beim zweiten Besuch antwortet der Server mit 304, und die robots.txt hält das Skript von /cart fern. Die beiden 429-Antworten auf dem ersten Host enthielten Retry-After, einmal in Sekunden und einmal als Datum; im Log steht „at least“, weil die Mindestpause pro Host den tatsächlichen Abstand verlängern kann. Zwei 200-Seiten wurden nicht gespeichert, für die nächsten sechs Hosts war bei ihrer ersten Seite oder bei der robots.txt Schluss, und der letzte Host wurde nach drei Wiederholungen aufgegeben.
Eine Grenze hat das Skript: Ein Betreiber kann einem Rate Limit einen eigenen Status und einen eigenen Body ohne 1015 geben. Das Skript protokolliert dann blocked oder other, achten Sie also auf beide Urteile.
Anwendungsfälle
- Preisüberwachung: Bedingte Anfragen halten den Aufwand täglicher Abrufe gering, und
suspicious_200meldet eine geänderte Seitenvorlage (Preisüberwachung). - Marktforschung: Sortiments- und Bestandsdaten aus vielen Shops, jeder in seinem eigenen Tempo besucht (Marktforschung).
- SEO-Kontrollen: Finden Sie heraus, ob Ihre eigenen Cloudflare-Einstellungen erwünschte Crawler mit einer Prüfung aufhalten (SEO-Proxy).
- Markenschutz: Marktplätze nach gefälschten Angeboten durchsuchen, mit einem Job, der bei jeder Prüfung aufhört (Markenschutz).
- Öffentliche Crawler: ein Index oder Archiv, das vor dem ersten Crawl den Status als verifizierter Bot beantragt (Web-Crawler).
- Allgemeine Datenerfassung: saubere Daten und dazu ein Protokoll dessen, was der Job nicht erreichen konnte (Data Scraping).
Häufige Fehler
- Einen
403in einer Schleife wiederholen. Die Antwort bleibt dieselbe, und schon die Häufung der Anfragen wirkt wie ein Bot. - Error 1015 schnell wiederholen oder
Retry-Afterignorieren. Cloudflare warnt, dass wiederholte Versuche in kurzer Zeit die Sperre verlängern können (429 Too Many Requests). - Bei jeder Anfrage an eine Website die IP wechseln. Neue Adressen im selben Tempo übergehen das Limit, das der Betreiber gesetzt hat, und Limits pro Cookie oder Fingerabdruck setzen sich dadurch nicht zurück (Web Scraping ohne Sperren).
- Googlebot vortäuschen. Google rät Website-Betreibern, Googlebot zu verifizieren, per Reverse- und Forward-DNS-Abfrage oder anhand der von Google veröffentlichten IP-Bereiche. Eine Googlebot-Kennung von einer fremden IP fällt bei beidem durch.
- Jedem
200vertrauen. Leere JavaScript-Gerüste, Turnstile-Formulare und Fallenseiten liefern alle einen200. Cloudflares AI Labyrinth führt Crawler, die seinen versteckten Links folgen, in ein Labyrinth aus Seiten, ohne sie zu blockieren. cf_clearancein ein Skript kopieren. Das Cookie ist an das Gerät gebunden, für das es ausgestellt wurde.- Hinter einem fremden Login scrapen. Ihr eigenes Konto und Ihre eigenen Daten sind das eine (Sitzungen und Cookies in Python), Seiten, die die Website Ihnen nicht geöffnet hat, etwas anderes.
- Einen CAPTCHA-Lösungsdienst bezahlen. Cloudflares Prüfungen sind keine Bilderrätsel; die Tests laufen im Browser, und ein Lösungsdienst umgeht die Entscheidung des Betreibers.
Entscheidungshilfe
| Ihre Situation | Was tun? |
|---|---|
| Die Website hat eine API oder einen Feed | Nutzen Sie diese, auch wenn HTML-Scraping einfacher wirkt |
| Sie brauchen ein paar Seiten einer Website | Schreiben Sie dem Betreiber: Bot-Name, Pfade, Tempo |
| Der Betreiber hat einer Freigabe zugestimmt | Senden Sie den gesamten Verkehr von einer festen IP |
| Sie betreiben einen öffentlichen Crawler | Beantragen Sie den Status als verifizierter Bot |
| Sie bauen einen KI-Crawler oder -Agenten | Lesen Sie Content-Signal-Zeilen; behandeln Sie einen 402 als Preis |
| Die Daten werden per JavaScript aufgebaut | Suchen Sie die JSON-Anfrage; Playwright nur, wo es erlaubt ist |
| Sie brauchen die Preise eines Landes | Nutzen Sie einen Proxy in diesem Land, im selben Tempo |
Ihr Job bekommt jeden Tag einen 429 | Senken Sie das Tempo, statt IPs hinzuzufügen |
| Ihr Job trifft auf eine Prüf- oder Sperrseite | Lassen Sie diesen Host aus; wählen Sie einen der Wege oben |
| Sie überwachen Ihre eigene Cloudflare-Website | Geben Sie die IP des Monitors mit einer IP Access Rule frei |
Häufige Fragen
Kann Python Requests eine Website hinter Cloudflare scrapen?
Ja, solange die Einstellungen des Betreibers die Anfrage durchlassen. Antwortet die Website mit einer Prüfung, kann Requests sie nicht bestehen, weil jede Cloudflare-Prüfung JavaScript und Cookies braucht. Nutzen Sie dann die API der Website, bitten Sie den Betreiber um Zugang oder hören Sie auf.
Ist es legal, eine durch Cloudflare geschützte Website zu scrapen?
Dies ist keine Rechtsberatung. Die Antwort hängt vom Land ab, von den Nutzungsbedingungen der Website, davon, ob es sich um personenbezogene Daten handelt, und davon, wie Sie sie verwenden. Eine Prüfung ist ein klares Signal für den Willen des Betreibers; wer sie umgeht, übergeht dieses Signal und verstößt meist gegen die Nutzungsbedingungen. Die Lage nach Ländern beschreibt Ist Web Scraping legal?.
Was ist das cf_clearance-Cookie?
cf_clearance ist das Cookie, das ein Browser nach einer bestandenen Cloudflare-Prüfung erhält, damit die nächsten Anfragen ohne neue Prüfung den Ursprungsserver erreichen. Es gilt so lange, wie die Einstellung Challenge Passage des Betreibers vorgibt (standardmäßig 30 Minuten), und ist an Besucher und Gerät gebunden. Precursor kann es vorzeitig ungültig machen, wenn die Sitzung verdächtig zu wirken beginnt.
Komme ich mit einem Residential-Proxy an Cloudflare vorbei?
Nein, und dafür ist er auch nicht da. Ein Proxy ändert Ihre IP-Adresse und Ihr Netz, aber eine Prüfung braucht weiterhin JavaScript, Ihr TLS-Handshake bleibt gleich, und eine Sperre gegen Ihren Client gilt weiter. Nutzen Sie einen Residential-Proxy, um eine Seite so zu sehen, wie Besucher in einem Land sie sehen, und zwar in einem Tempo, das die Website akzeptiert.
Wie lasse ich meinen Crawler von Cloudflare verifizieren?
Geben Sie dem Crawler einen eigenen Namen und einen der Nachweise aus Weg 3: Signaturen per Web Bot Auth oder eine veröffentlichte Liste von IP-Adressen, die nur der Crawler nutzt. Sorgen Sie dafür, dass er robots.txt und crawl-delay beachtet, und stellen Sie dann den Antrag über das Formular für verifizierte Bots im Cloudflare-Dashboard.
Warum funktioniert mein Scraper auf dem Laptop, aber nicht auf einem Server?
Ihr Laptop nutzt einen Heim- oder Büroanschluss, der Server das Netz eines Hosting-Anbieters. Betreiber können ein ganzes Netz über seine ASN sperren (Error 1005), und die Reputation der Adresse fließt in die Bot-Bewertung ein. Deshalb kann dasselbe Skript über den einen Anschluss durchkommen und über den anderen eine Prüfung bekommen. Bitten Sie den Betreiber, die feste IP des Servers freizugeben, oder nutzen Sie die offizielle API.
Fazit
Ein Cloudflare-Scraper wird blockiert, wenn die Einstellungen des Betreibers eine Anfrage stoppen, bevor sie den Ursprungsserver erreicht. Lesen Sie die Antwort, bevor Sie etwas ändern. Ein Header cf-mitigated: challenge steht für eine Prüfung, die meisten Cloudflare-Fehlercodes und die Sperrseite für Regeln des Betreibers, ein 429 oder Error 1015 für ein Rate Limit, ein 402 für einen Preis, und ein 200 zählt nur, wenn Ihr Inhalt darin steht. Wählen Sie dann einen Weg, der Bestand hat: eine offizielle API, die Erlaubnis des Betreibers für eine feste IP, den Status als verifizierter Bot oder einen echten Browser nur dort, wo Rendering nötig ist. Für Aufgaben, bei denen das Land oder eine feste Adresse eine Rolle spielt, vergleichen Sie die Optionen auf der Seite unserer Proxy-Dienste.