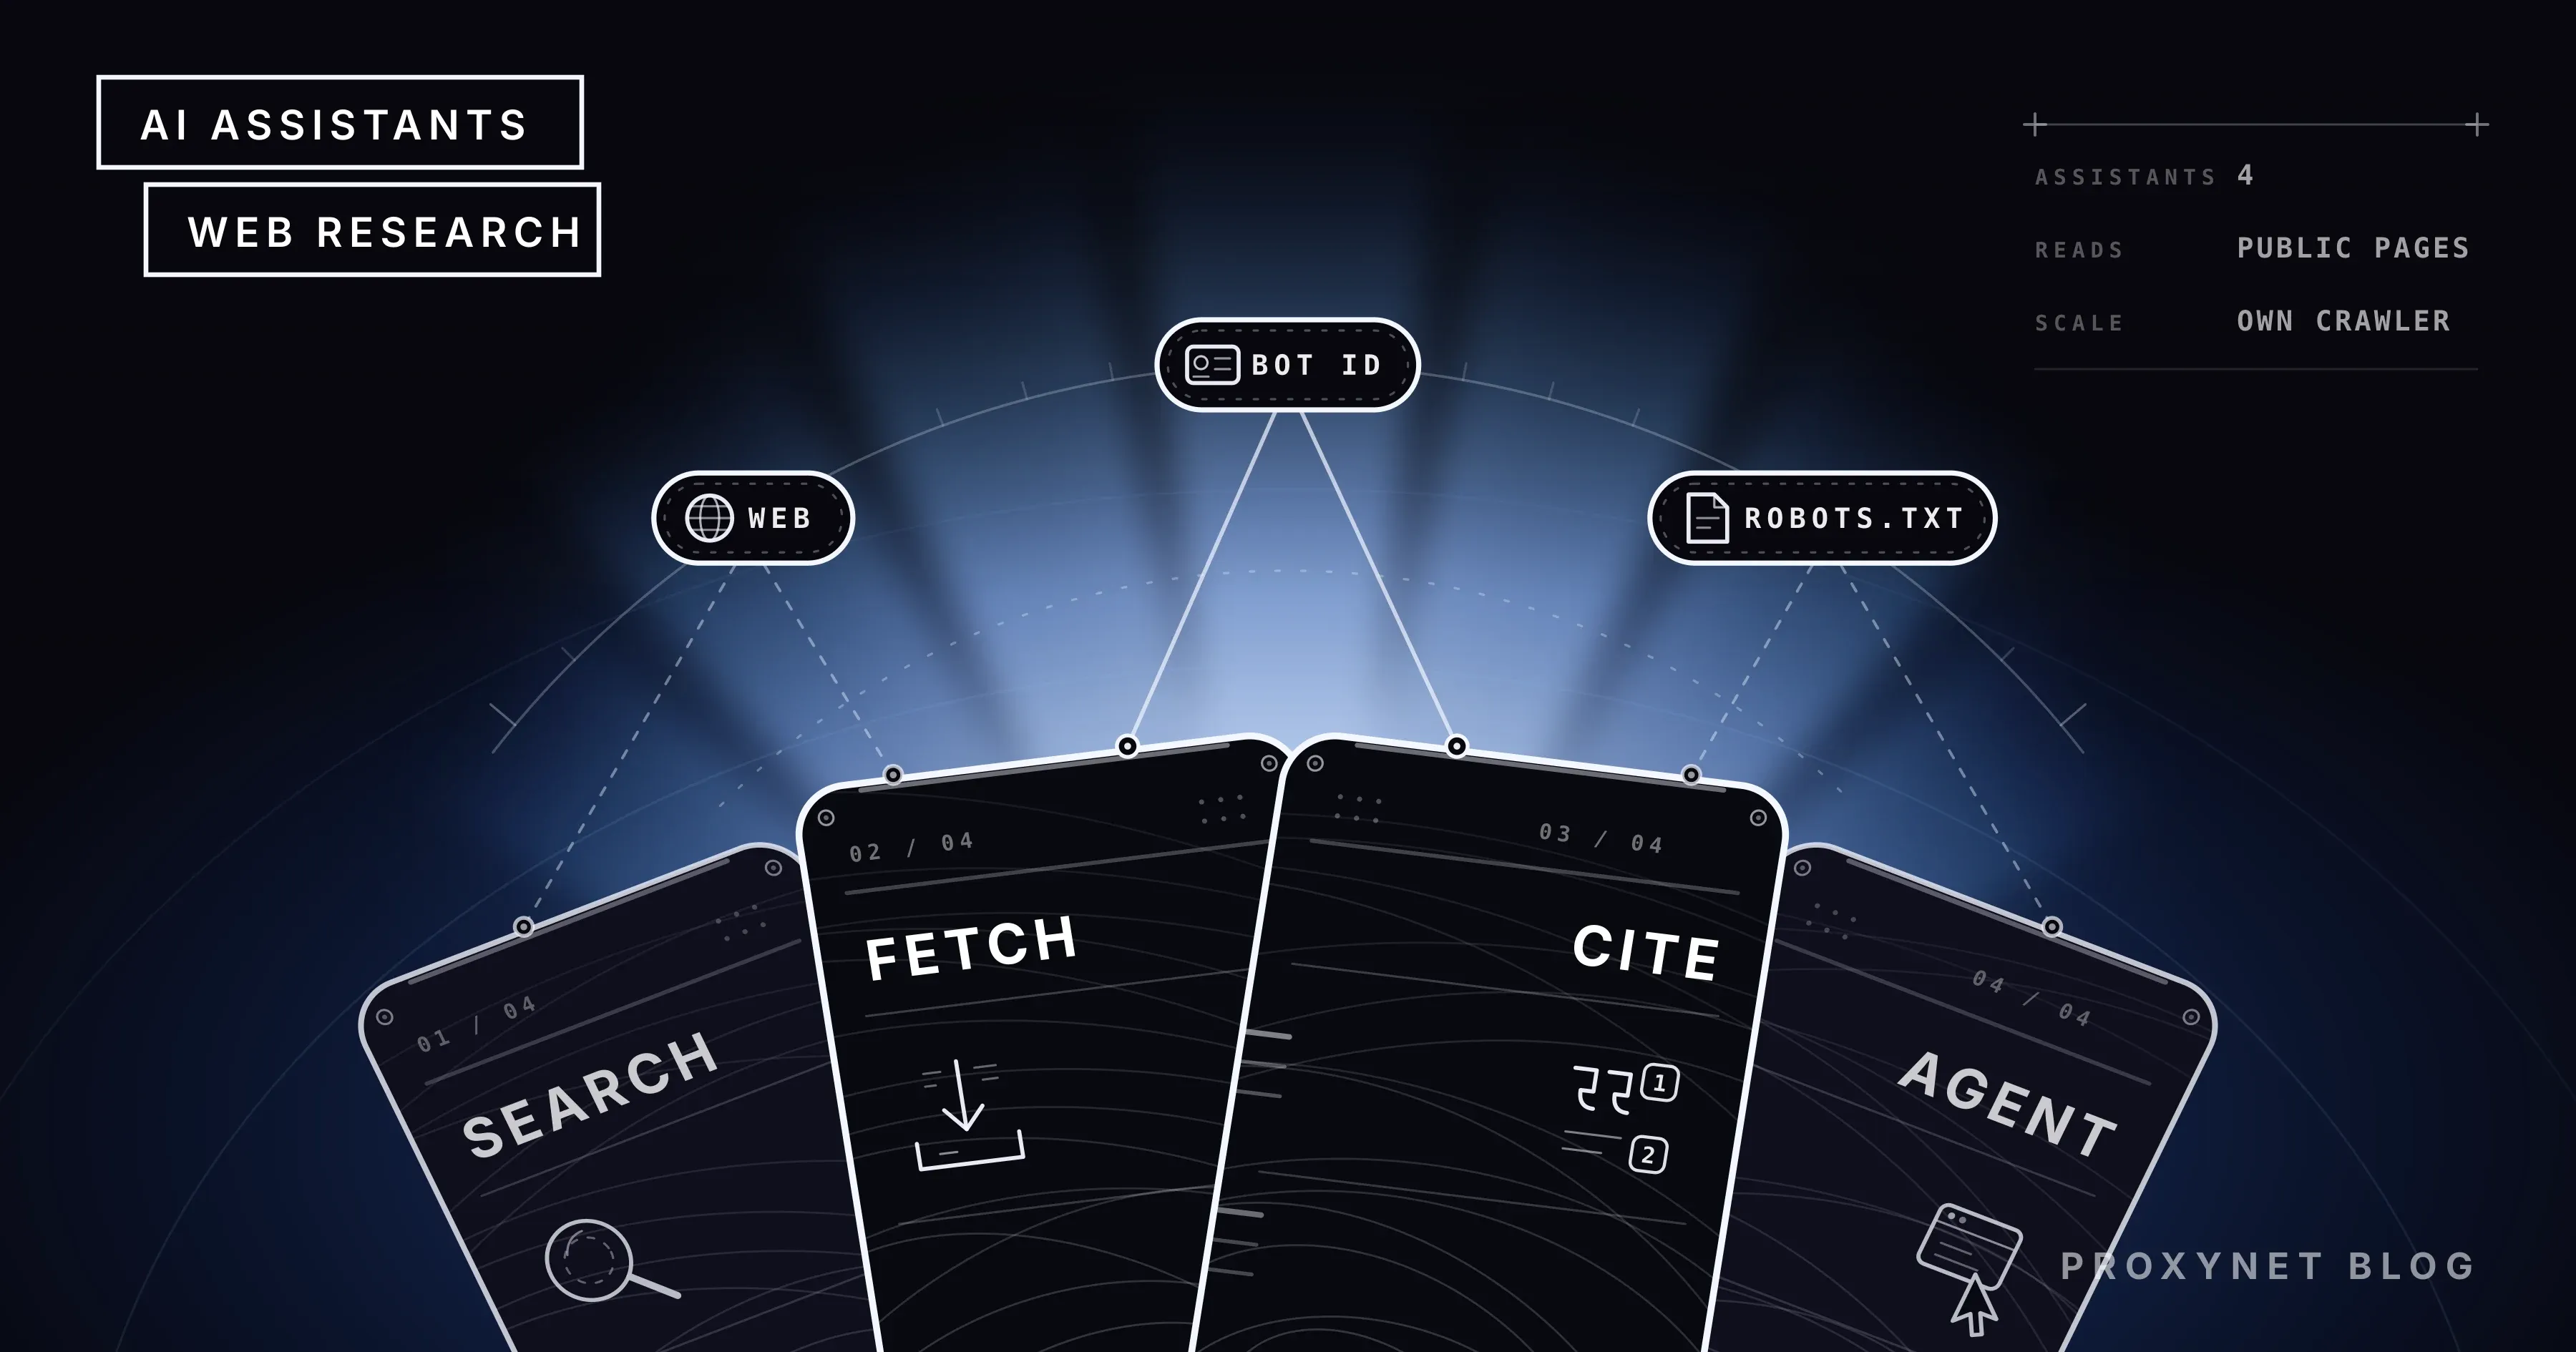
Ein Marktforschungsteam stellt vier Assistenten dieselbe Frage: „Was kostet dieses Produkt heute in diesem Shop in Türkiye?“ Einer nennt einen Preis mit nummerierten Quellen, einer liest die Seite, sagt aber nicht, von wann sie ist, einer gibt eine Spanne auf Basis von Google-Ergebnissen an, und einer sagt, er könne die Seite nicht erreichen. Alle vier werden als „mit dem Web verbunden“ verkauft; was sie unterscheidet, ist nicht die Klugheit des Modells, sondern das Verhältnis, das jedes Produkt zum Web hat.
Dieser Beitrag vergleicht ChatGPT, Claude, Gemini und Perplexity aus genau diesem Blickwinkel: wie die Live-Suche funktioniert, wie Quellen angezeigt werden, ob eine URL, die Sie angeben, gelesen werden kann und wo die Grenzen liegen, was die Modi „Deep Research“ und Agent tun und wie die Web-Tools auf der API-Seite aussehen. Danach wechseln wir zum Website-Betreiber: Bot-Identitäten, robots.txt-Verhalten und der Streit zwischen Cloudflare und Perplexity vom August 2025. Der letzte Abschnitt richtet sich an Datenteams: warum diese Assistenten keine Scraping-Tools sind und wo ein Proxy hingehört. Die Angaben der Anbieter haben wir am 7. Oktober 2026 auf deren eigenen Seiten geprüft; Namen von Modellversionen lassen wir weg.
Wie erreichen die vier Assistenten das Web?
Alle vier haben eine Live-Suche; der Unterschied liegt darin, wann sie läuft und auf welcher Infrastruktur. Das Modell selbst ist nicht mit dem Web verbunden: In jedem Produkt sitzt eine Suchschicht davor, die die Frage in Suchanfragen übersetzt, Ergebnisse abruft und sie dem Modell übergibt. Alles Aktuelle in der Antwort stammt aus dieser Schicht.
ChatGPT durchsucht laut OpenAIs Hilfeseite das Web bei Bedarf, arbeitet dafür zeitweise mit anderen Suchanbietern zusammen und formuliert Ihre Frage in gezielte Suchanfragen um. Die Suche ist in jedem Tarif verfügbar; Quellen erscheinen als klickbare Zitate im Text, und eine Ansicht „Quellen“ listet verwandte Links auf.
Claude hat die Websuche im März 2025 erhalten und bietet sie seit Mai 2025 weltweit in allen Tarifen an. Sie schalten „Web search“ im Chat über das Menü „+“ ein, und Claude sucht, wenn die Frage von aktuellen Informationen abhängt: jüngste Ereignisse, Preise, Angaben zu Organisationen und Produkten, die sich geändert haben könnten, oder eine ausdrückliche Bitte, etwas nachzuschlagen. Für gesichertes Wissen, Mathematik oder kreatives Schreiben sucht es nicht.
Gemini stützt seine Antworten auf die Google-Suche. Laut Googles Hilfeseite erscheint, wenn Quellen vorliegen, unter oder in der Antwort eine Schaltfläche „Quellen“, die die Links in einer Seitenleiste öffnet; fehlt die Schaltfläche, wurden für diese Antwort keine Links bereitgestellt. Nicht jede Antwort beruht auf einer Suche.
Perplexity setzt an einem anderen Punkt an. Das Produkt ist eine Antwortmaschine: Jede Frage geht zuerst an die Suche, und das Modell schreibt danach eine Antwort mit nummerierten Quellen aus den gefundenen Seiten. Eine Option „Web ausschalten“ gibt es nicht; das Web ist die Voraussetzung für die Antwort.
Wie unterscheiden sich die Zitierformate?
Alle vier nennen Quellen, aber das Verhältnis zwischen Quelle und Antwort ist verschieden. Perplexity setzt neben jeden Satz eine Nummer und behandelt die Quellenliste als Teil der Antwort. Claude zitiert auf Satzebene: Welche Passage von welcher URL stammt, reist zusammen mit einem Auszug von 150 Zeichen in der Antwort mit. ChatGPT platziert Zitate als Links im Text und ergänzt eine Quellenliste. Gemini sammelt Quellen in einer separaten Leiste und behandelt eine Antwort ohne Quellen als normal.
| Assistent | Wann er sucht | Wie Quellen erscheinen | Standorteffekt |
|---|---|---|---|
| ChatGPT | Wenn die Frage aktuelle Daten braucht | Links im Text + Quellenliste | Ungefährer, aus der IP abgeleiteter Standort geht an den Suchpartner |
| Claude | Wenn aktiviert und die Frage es braucht | Zitat auf Satzebene mit URL und Auszug | In der App nicht dokumentiert; Parameter auf der API |
| Gemini | Wenn die Google-Suche die Antwort verbessern würde | Schaltfläche „Quellen“, Seitenleiste | Nicht dokumentiert |
| Perplexity | Bei jeder Frage | Nummerierte Quellen als Teil der Antwort | Parameter auf der API |
Die Spalte zum Standort ist wichtig. OpenAIs Hilfeseite sagt, dass ChatGPT einen aus Ihrer IP-Adresse abgeleiteten ungefähren Standort an seine Suchpartner weitergibt, nicht aber die IP selbst. Eine Preisfrage aus Istanbul liefert möglicherweise nicht dieselben Ergebnisse wie dieselbe Frage aus Berlin. Für die anderen drei Produkte haben wir keine Seite gefunden, die das dokumentiert, deshalb behaupten wir dazu nichts.
Was passiert, wenn Sie eine URL einfügen?
Das Lesen einer Seite (Fetch) ist eine andere Fähigkeit als die Suche: Die Suche liefert Zusammenfassungen aus einem Index, der Fetch geht zu einer bestimmten Adresse und holt die Seite selbst. Alle vier Produkte verwenden dafür eine eigene Bot-Identität, wenn sie im Auftrag eines Nutzers handeln; der Mechanismus ist überall derselbe:
- Die Adresse muss im Gespräch vorkommen. Claudes API-Tool macht daraus eine Regel: Nur URLs, die in einer Nutzernachricht, in Suchergebnissen oder in Tool-Ergebnissen aufgetaucht sind, dürfen abgerufen werden; eine Adresse, die das Modell selbst geschrieben hat, nicht. Als Grund wird das Risiko eines Datenabflusses genannt.
- Domain und robots.txt werden geprüft. Claudes Tool gibt
url_not_allowedzurück für einen Pfad, den die robots.txt sperrt, für eine Adresse in einem privaten Netz oder für eine URL mit Zugangsdaten. Geminis URL-Context-Tool schließt lokale Netzwerkadressen und Tunneldienste aus. - Die Seite wird abgerufen. Text, HTML und PDF werden gelesen. Claudes Dokumentation hält fest, dass per JavaScript gerenderte Seiten nicht unterstützt werden; Geminis sagt, dass Inhalte hinter einem Login oder einer Paywall nicht gelesen werden.
- Der Inhalt wird gekürzt. Claude hat eine Grenze
max_content_tokens; Gemini erlaubt 34 MB pro URL und 20 URLs pro Anfrage. Das Modell liest den Teil, der hineinpasst, nicht die ganze Seite. - Die Antwort wird geschrieben und belegt. Bei Claudes Fetch sind Zitate optional; Gemini gibt neben der Antwort zurück, welche URLs erfolgreich gelesen wurden.
Dazu kommt der Cache. Claudes Dokumentation sagt, dass abgerufene Inhalte zwischengespeichert werden und nicht unbedingt die neueste Version unter der URL widerspiegeln; für frische Inhalte lässt sich use_cache abschalten. Gemini sieht zuerst in seinem eigenen Index-Cache nach und ruft nur dann live ab, wenn die Seite dort fehlt. Bei Daten, die sich stündlich ändern, etwa Preisen, entscheidet das über das Alter der Antwort.
| Assistent | Wie er eine URL liest | Dokumentierte Grenzen | robots.txt-Haltung des nutzerausgelösten Bots |
|---|---|---|---|
| ChatGPT | Seitenbesuch durch ChatGPT-User | Kein automatisches Crawling | „Gilt möglicherweise nicht“ |
| Claude | Claude-User; Web-Fetch-Tool auf der API | Kein JavaScript; URL muss im Chat vorkommen; Cache | Beachtet sie |
| Gemini | Googles nutzerausgelöste Fetcher; URL Context auf der API | 20 URLs, 34 MB; kein Login, keine Paywall | Ignoriert sie in der Regel |
| Perplexity | Perplexity-User | Seite wird sofort zur Beantwortung der Frage genutzt | Ignoriert sie in der Regel |
Was tun Deep Research und Agentenmodi?
Alle vier Produkte haben einen Modus für lange Recherchen, und alle durchlaufen dieselbe Schleife: planen, suchen, lesen, das Fehlende erneut suchen, den Bericht schreiben. Gemini hat diesen Modus im Dezember 2024 als „Deep Research“ eröffnet; OpenAI startete „deep research“ im Februar 2025, Perplexity sein „Deep Research“ im selben Monat und Anthropic seine Funktion „Research“ im April 2025. Der Unterschied liegt in der Zahl der gelesenen Seiten, aber auch darin, wie Quellen mitreisen: Perplexity und Claude binden das Zitat an den Satz, ChatGPT und Gemini sammeln sie unter dem Bericht. Die Form dieser Schleife haben wir in Wie funktionieren KI-Agenten? beschrieben.
Agentenmodi gehen einen Schritt weiter: Der Assistent surft, füllt Formulare aus und klickt. Perplexity hat dafür einen eigenen Browser namens Comet herausgebracht; Google führt eine eigene Bot-Identität (Google-Agent) für Agenten, die im Auftrag eines Nutzers surfen; OpenAIs Agentenmodus lebt in ChatGPT. Für einen Website-Betreiber ähnelt ein solcher Besuch einem menschlichen, doch die Anfrage kommt weiterhin von einem Programm und trägt ihre Identität im User-Agent-Header.
Wie sehen die Web-Tools auf der API-Seite aus?
Auf allen vier APIs ist die Websuche ein Server-Tool: Die Infrastruktur des Anbieters führt die Suche aus und reicht die Ergebnisse an das Modell weiter. Der Entwickler steuert drei Dinge: die Zahl der Suchen, einen Domainfilter und den Standort.
| Assistent | API-Tool | Standortparameter | Domainfilter |
|---|---|---|---|
| OpenAI | Responses API web_search; Annotationen url_citation | user_location: Stadt, Land, Region, Zeitzone | Ja |
| Anthropic | Tools web_search und web_fetch; Zitate bei der Suche Pflicht | user_location: Stadt, Region, Ländercode, Zeitzone | allowed_domains oder blocked_domains |
Grounding mit google_search; url_context | Nicht dokumentiert | Nicht dokumentiert | |
| Perplexity | Sonar-Modelle; search_results und Zitate standardmäßig | web_search_options.user_location: Breiten- und Längengrad plus Land, Stadt, Region | search_domain_filter, bis zu 20 Domains |
Dieselbe Anfrage mit und ohne country: "TR" kann unterschiedliche Seiten liefern. Claudes Dokumentation verlangt mindestens ein Feld und nimmt das Land als zweibuchstabigen ISO-Code entgegen:
{
  "type": "web_search_20250305",
  "name": "web_search",
  "max_uses": 5,
  "user_location": {
    "type": "approximate",
    "city": "Istanbul",
    "country": "TR",
    "timezone": "Europe/Istanbul"
  }
}
In Googles Grounding-Tool trägt das mit der Antwort zurückgegebene groundingMetadata die Suchanfragen, die Quellenabschnitte und einen searchEntryPoint, und Google verlangt, dass diese „Search Suggestions“ dem Nutzer angezeigt werden. Bei Perplexity lässt sich die Suche nicht abschalten, aber search_recency_filter begrenzt, wie alt die Quellen sein dürfen.
Welche Bot-Identitäten sind für Website-Betreiber wichtig?
Jeder Anbieter verwendet drei Identitäten für drei Aufgaben: Crawling für das Training, Crawling für einen Suchindex und das Öffnen einer Seite im Auftrag eines Nutzers. Jede wird in der robots.txt getrennt verwaltet; den Trainings-Bot zu sperren sperrt nicht den Such-Bot. Wie die Datei geschrieben wird, erklärt unser robots.txt-Leitfaden; hier stehen nur die Namen und die Haltungen.
| Anbieter | Training | Suche | Nutzerausgelöst |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Google-Extended (nur Token) | Googlebot | Nutzerausgelöste Fetcher, Google-Agent | |
| Perplexity | Keiner (crawlt nicht für das Training) | PerplexityBot | Perplexity-User |
OpenAI definiert seine drei Identitäten in seiner Bot-Dokumentation. GPTBot crawlt für das Training; OAI-SearchBot findet und verlinkt Websites in der ChatGPT-Suche und wird nicht für das Training genutzt; ChatGPT-User besucht eine Seite, wenn ein Nutzer eine Frage stellt, und crawlt nicht automatisch. Weil ein Nutzer diese Besuche auslöst, gelten die robots.txt-Regeln für ChatGPT-User laut dem Dokument „möglicherweise nicht“. Eine Website, die OAI-SearchBot sperrt, erscheint nicht in den Antworten der ChatGPT-Suche; eine Änderung wird nach etwa 24 Stunden übernommen. Die IP-Bereiche werden in separaten JSON-Dateien veröffentlicht.
Anthropic definiert alle drei Bots auf seiner Hilfeseite und sagt, dass alle drei die robots.txt beachten; es ist der einzige Anbieter, der für seinen nutzerausgelösten Bot „beachtet sie“ sagt. Die Seite sagt außerdem, dass die Bots die Direktive Crawl-delay unterstützen, und veröffentlicht die IP-Bereiche in einer einzigen JSON-Liste.
Bei Google crawlt Gemini nicht mit einem eigenen Crawler. Googlebot baut den Index; Google-Extended ist ein robots.txt-Token ohne eigenen User-Agent-String und regelt, ob gecrawlte Inhalte zum Training von Gemini-Modellen und für das Grounding mit der Google-Suche in Gemini Apps und auf Vertex AI verwendet werden dürfen. Die Dokumentation sagt zwei Dinge klar: Google-Extended beeinflusst die Position einer Website in der Suche nicht, und nutzerausgelöste Fetcher ignorieren robots.txt-Regeln in der Regel, weil ein Nutzer den Abruf angefordert hat. Google-Extended zu sperren berührt weder Googlebot noch Besuche im Auftrag eines Nutzers.
Perplexity schreibt in seiner Crawler-Dokumentation, dass PerplexityBot crawlt, um Websites in Suchergebnissen anzuzeigen, nicht für das Training genutzt wird und die robots.txt respektiert. Der Satz zu Perplexity-User lautet anders: „Da ein Nutzer den Abruf angefordert hat, ignoriert dieser Fetcher die robots.txt-Regeln in der Regel.“ Die IP-Bereiche beider Bots werden in separaten JSON-Dateien veröffentlicht.
Die praktische Schlussfolgerung: Die robots.txt regelt automatisiertes Crawling, und drei der vier Anbieter betrachten einen einzelnen Besuch im Auftrag eines Nutzers als außerhalb dieser Datei. Der Weg, solche Besuche zu begrenzen, ist eine serverseitige Regel auf Basis des User Agents und der veröffentlichten IP-Listen. Eine verbreitete Konfiguration sperrt die Trainings-Bots und lässt die Such-Bots offen:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
Was ist zwischen Cloudflare und Perplexity passiert?
Am 4. August 2025 veröffentlichte Cloudflare einen Beitrag, in dem es Perplexity vorwarf, nicht deklarierte Crawler zu verwenden. Nach dieser Darstellung meldeten Websites, die PerplexityBot gesperrt hatten, dass ihre Inhalte weiterhin in Perplexitys Antworten auftauchten, und neue Testdomains, die Cloudflare für alle Bots gesperrt hatte, wurden von Perplexity trotzdem abgerufen. Der Beitrag sagte, dass nach der Sperrung des deklarierten User Agents Anfragen mit einem generischen, Chrome-ähnlichen User Agent und aus wechselnden Netzen (ASNs) eintrafen und dass die robots.txt manchmal gar nicht abgerufen wurde; am selben Tag entfernte Cloudflare Perplexity aus seiner Liste verifizierter Bots.
Perplexity antwortete am nächsten Tag mit einem Beitrag unter dem Titel „Agents or Bots? Making Sense of AI on the Open Web“: Bei dem fraglichen Verkehr habe es sich nicht um automatisiertes Crawling gehandelt, sondern um Anfragen „nutzergesteuerter Agenten“, die eine Seite für die unmittelbare Frage eines Nutzers öffnen, nichts sei indexiert worden, und Cloudflare habe einen Teil des Verkehrs mit einem Cloud-Browser-Dienst eines Drittanbieters verwechselt. Die beiden Darstellungen stimmen nicht überein, und dieser Beitrag ist nicht der Schiedsrichter. Das bleibende Ergebnis ist, dass sich die Identitätsfrage auf eine technische Antwort zubewegt hat: Im selben Monat eröffnete Cloudflare ein Programm „Signed Agents“, in dem Agenten ihre Anfragen mit Web Bot Auth, einem IETF-Entwurf, signieren. Ein Bot, der einen User-Agent-String kopiert, kann diese Signatur nicht erzeugen.
Sind diese Assistenten Werkzeuge zur Datensammlung?
Nein. Die oben genannten Grenzen sind Designentscheidungen: Die Zahl der Suchen pro Anfrage, der Cache, das Lesen nur solcher URLs, die im Chat vorkommen, das Nichtausführen von JavaScript und die Ablehnung von Pfaden, die die robots.txt sperrt, dimensionieren diese Tools auf die unmittelbare Frage eines einzelnen Nutzers. Hundert Seiten brauchen hundert Fragen, und Sie können nicht steuern, welche Version einer Seite gelesen wurde. Unser Beitrag zu sicherem Webzugriff für LLMs beschreibt, worauf ein Modell beim Lesen von Live-Seiten achten sollte.
Für regelmäßige Sammlung in großem Umfang gibt es drei Wege: eine Quelle, die es ausdrücklich erlaubt, die offizielle API der Quelle oder Ihren eigenen Crawler. Auf dem dritten Weg sind das Lesen der robots.txt, das Einhalten der Rate-Limits der Website und eine ehrliche Identifikation per User Agent Ihre Aufgabe. Den Crawler über einen Datacenter-Proxy laufen zu lassen, trennt Ihre Ausgangsadressen von Ihren Anwendungsservern und erleichtert es, sich mit einer festen IP-Liste zu identifizieren; die Zahl der Anfragen, die eine Website pro Minute zulässt, erhöht es nicht.
Der eigentliche Platz eines Proxys ist die Geografie. Ein Shop kann je nach Land des Besuchers andere Preise, Währungen und Aktionen zeigen. Die Assistenten rufen eine Seite von dort ab, wo ihre eigene Infrastruktur steht; sie veröffentlichen ihre IP-Bereiche, versprechen aber nichts zum Land. In Ihrem eigenen Crawler liegt diese Kontrolle bei Ihnen: Ein Residential-Proxy mit Ausgang in Türkiye liefert die Seite so, wie ein Käufer in diesem Land sie sieht, und lässt Sie zu den Daten festhalten, aus welchem Land sie gesehen wurden. Dass die Antwort eines Assistenten, im Fall von ChatGPT, davon abhängen kann, wo die Frage gestellt wurde, ist eine andere Sache.
Häufige Fehler
- Den Preis eines Assistenten ohne Datum festhalten. Die Antwort kann aus einem Cache oder von einer vor Tagen indexierten Seite stammen; speichern Sie die Quell-URL und den Zeitpunkt der Antwort zusammen.
- Eine Antwort ohne Quellen für eine mit Quellen halten. Bei Gemini bedeutet eine fehlende Schaltfläche „Quellen“, dass die Antwort nicht auf einer Suche beruhte; bei Claude kommt die Antwort mit ausgeschalteter Websuche aus den Trainingsdaten.
- Versuchen, einem Assistenten Hunderte URLs zu geben. Die Tools begrenzen URLs und Tokens pro Anfrage; sobald die Aufgabe wächst, wechseln Sie zur offiziellen API oder zu Ihrem eigenen Crawler.
- Eine per JavaScript gerenderte Seite als „der Assistent konnte sie nicht lesen“ melden. Die Seite kommt als leere Hülle zurück; das Problem liegt im Aufbau der Seite.
- Nur den Trainings-Bot sperren und die Sache für erledigt halten. Such-Bots und nutzerausgelöste Bots sind getrennte Identitäten, und die meisten der Letzteren lesen die robots.txt gar nicht.
- Dem User-Agent-String vertrauen. Jeder kann ihn schreiben; eine Prüfung braucht eine IP-Liste oder eine signierte Anfrage.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Eine schnelle Antwort mit einer Quelle zu jedem Satz | Perplexity |
| Ein langes Dokument oder eine von Ihnen gelieferte URL mit Zitaten auf Satzebene lesen | Claude |
| Aktuelle Antworten auf Basis der Google-Suche, innerhalb des Google-Ökosystems | Gemini |
| Alltägliche Recherche mit Prüfung per Klick | ChatGPT |
| Websuche mit Quellen in die eigene Anwendung einbauen | Tools von OpenAI oder Anthropic; Perplexity Sonar |
| Als Website-Betreiber Trainings-Crawls sperren und in der Suche sichtbar bleiben | GPTBot, ClaudeBot und Google-Extended gesperrt; Such-Bots erlaubt |
| Regelmäßige Datensammlung in großem Umfang | Eine erlaubende Quelle, eine offizielle API oder Ihr eigener Crawler |
Häufige Fragen
Ist ChatGPT mit dem Internet verbunden?
Ja. ChatGPT durchsucht das Web bei Bedarf, in jedem Tarif, und hängt klickbare Quellen an die Antwort. Dafür arbeitet es zeitweise mit anderen Suchanbietern zusammen und formuliert Ihre Frage in gezielte Suchanfragen um.
Kann Claude das Web durchsuchen?
Ja. Die Websuche ist seit März 2025 in Claude und seit Mai 2025 in allen Tarifen und allen Ländern verfügbar. Sie schalten sie im Chat über das Menü „+“ ein; Claude sucht, wenn eine Frage aktuelle Informationen braucht, und bindet jedes Zitat an seine Quelle.
Was ist der Unterschied zwischen Perplexity und ChatGPT?
Perplexity beginnt jede Antwort mit einer Suche und macht die nummerierten Quellen zum Teil der Antwort; ChatGPT sucht nur bei Bedarf und gibt Quellen als Links im Text an. Perplexity passt zu einer schnellen Antwort mit Quellen, ChatGPT zu einem langen Gespräch und einem breiteren Werkzeugsatz.
Können KI-Assistenten Seiten hinter einer Paywall lesen?
Nein. Geminis Dokumentation zu URL Context hält fest, dass Inhalte hinter einem Login oder einer Paywall nicht gelesen werden, und auch die anderen Tools fordern die Seite ohne Sitzung an. Der Assistent sieht die Version der Seite, die die Website jedem zeigt.
Beeinflusst das Sperren von Google-Extended das Ranking in der Google-Suche?
Nein. Googles Dokumentation sagt, dass Google-Extended keinen eigenen User-Agent-String hat und die Position einer Website in der Google-Suche nicht beeinflusst. Das Token regelt nur, ob gecrawlte Inhalte für das Training und das Grounding von Gemini verwendet werden.
Kann ich KI-Bots mit der robots.txt vollständig sperren?
Teilweise. Trainings- und Such-Bots beachten die robots.txt; die meisten Bots, die eine Seite im Auftrag eines Nutzers öffnen, tun das nicht, mit Anthropics Claude-User als Ausnahme. Um nutzerausgelöste Besuche zu begrenzen, brauchen Sie serverseitige Regeln auf Basis des User Agents und der veröffentlichten IP-Listen.
Fazit
Alle vier Assistenten erreichen das Web: Perplexity macht die Suche zur Voraussetzung jeder Antwort, ChatGPT und Claude suchen bei Bedarf, und Gemini stützt sich auf die Google-Suche und behandelt eine Antwort ohne Quellen als normal. Beim Lesen von URLs teilen sie dokumentierte Grenzen: kein JavaScript, kein Login, keine Pfade, die die robots.txt sperrt, und ein Cache. Für Website-Betreiber liegt der eigentliche Bruch bei den nutzerausgelösten Bots; jeder Anbieter außer Anthropic betrachtet diese Besuche als außerhalb der robots.txt, sodass die Kontrolle zu User Agents und IP-Listen wandert. Für Datenteams sind diese Tools Rechercheassistenten, keine Sammler; regelmäßige Sammlung braucht eine erlaubende Quelle, eine offizielle API oder Ihren eigenen Crawler, und um eine Seite aus dem richtigen Land zu sehen, können Sie sich unsere Infrastruktur für Data Scraping ansehen.