A equipe de operações de um distribuidor começa toda manhã do mesmo jeito: alguém entra no portal de um fornecedor, baixa a lista de preços de ontem e digita as mudanças em um sistema ERP que não tem API. No fim do corredor, a equipe de análise quer os preços dos mesmos produtos em vinte sites de varejo públicos, todo dia, em uma única tabela. Os dois trabalhos são "automação", mas pedem ferramentas diferentes: um robô de software que opera o portal tela por tela e um scraper que lê páginas públicas como respostas HTTP.
Este artigo explica o que são RPA e web scraping, como cada um funciona, em que diferem, onde se sobrepõem, quando cada um vence, quem deve ser responsável por eles, onde um proxy se encaixa e o que os agentes de IA mudam. As informações dos fornecedores vêm da documentação da UiPath, da Automation Anywhere e da Microsoft, lida em 9 de novembro de 2026.
O que é RPA?
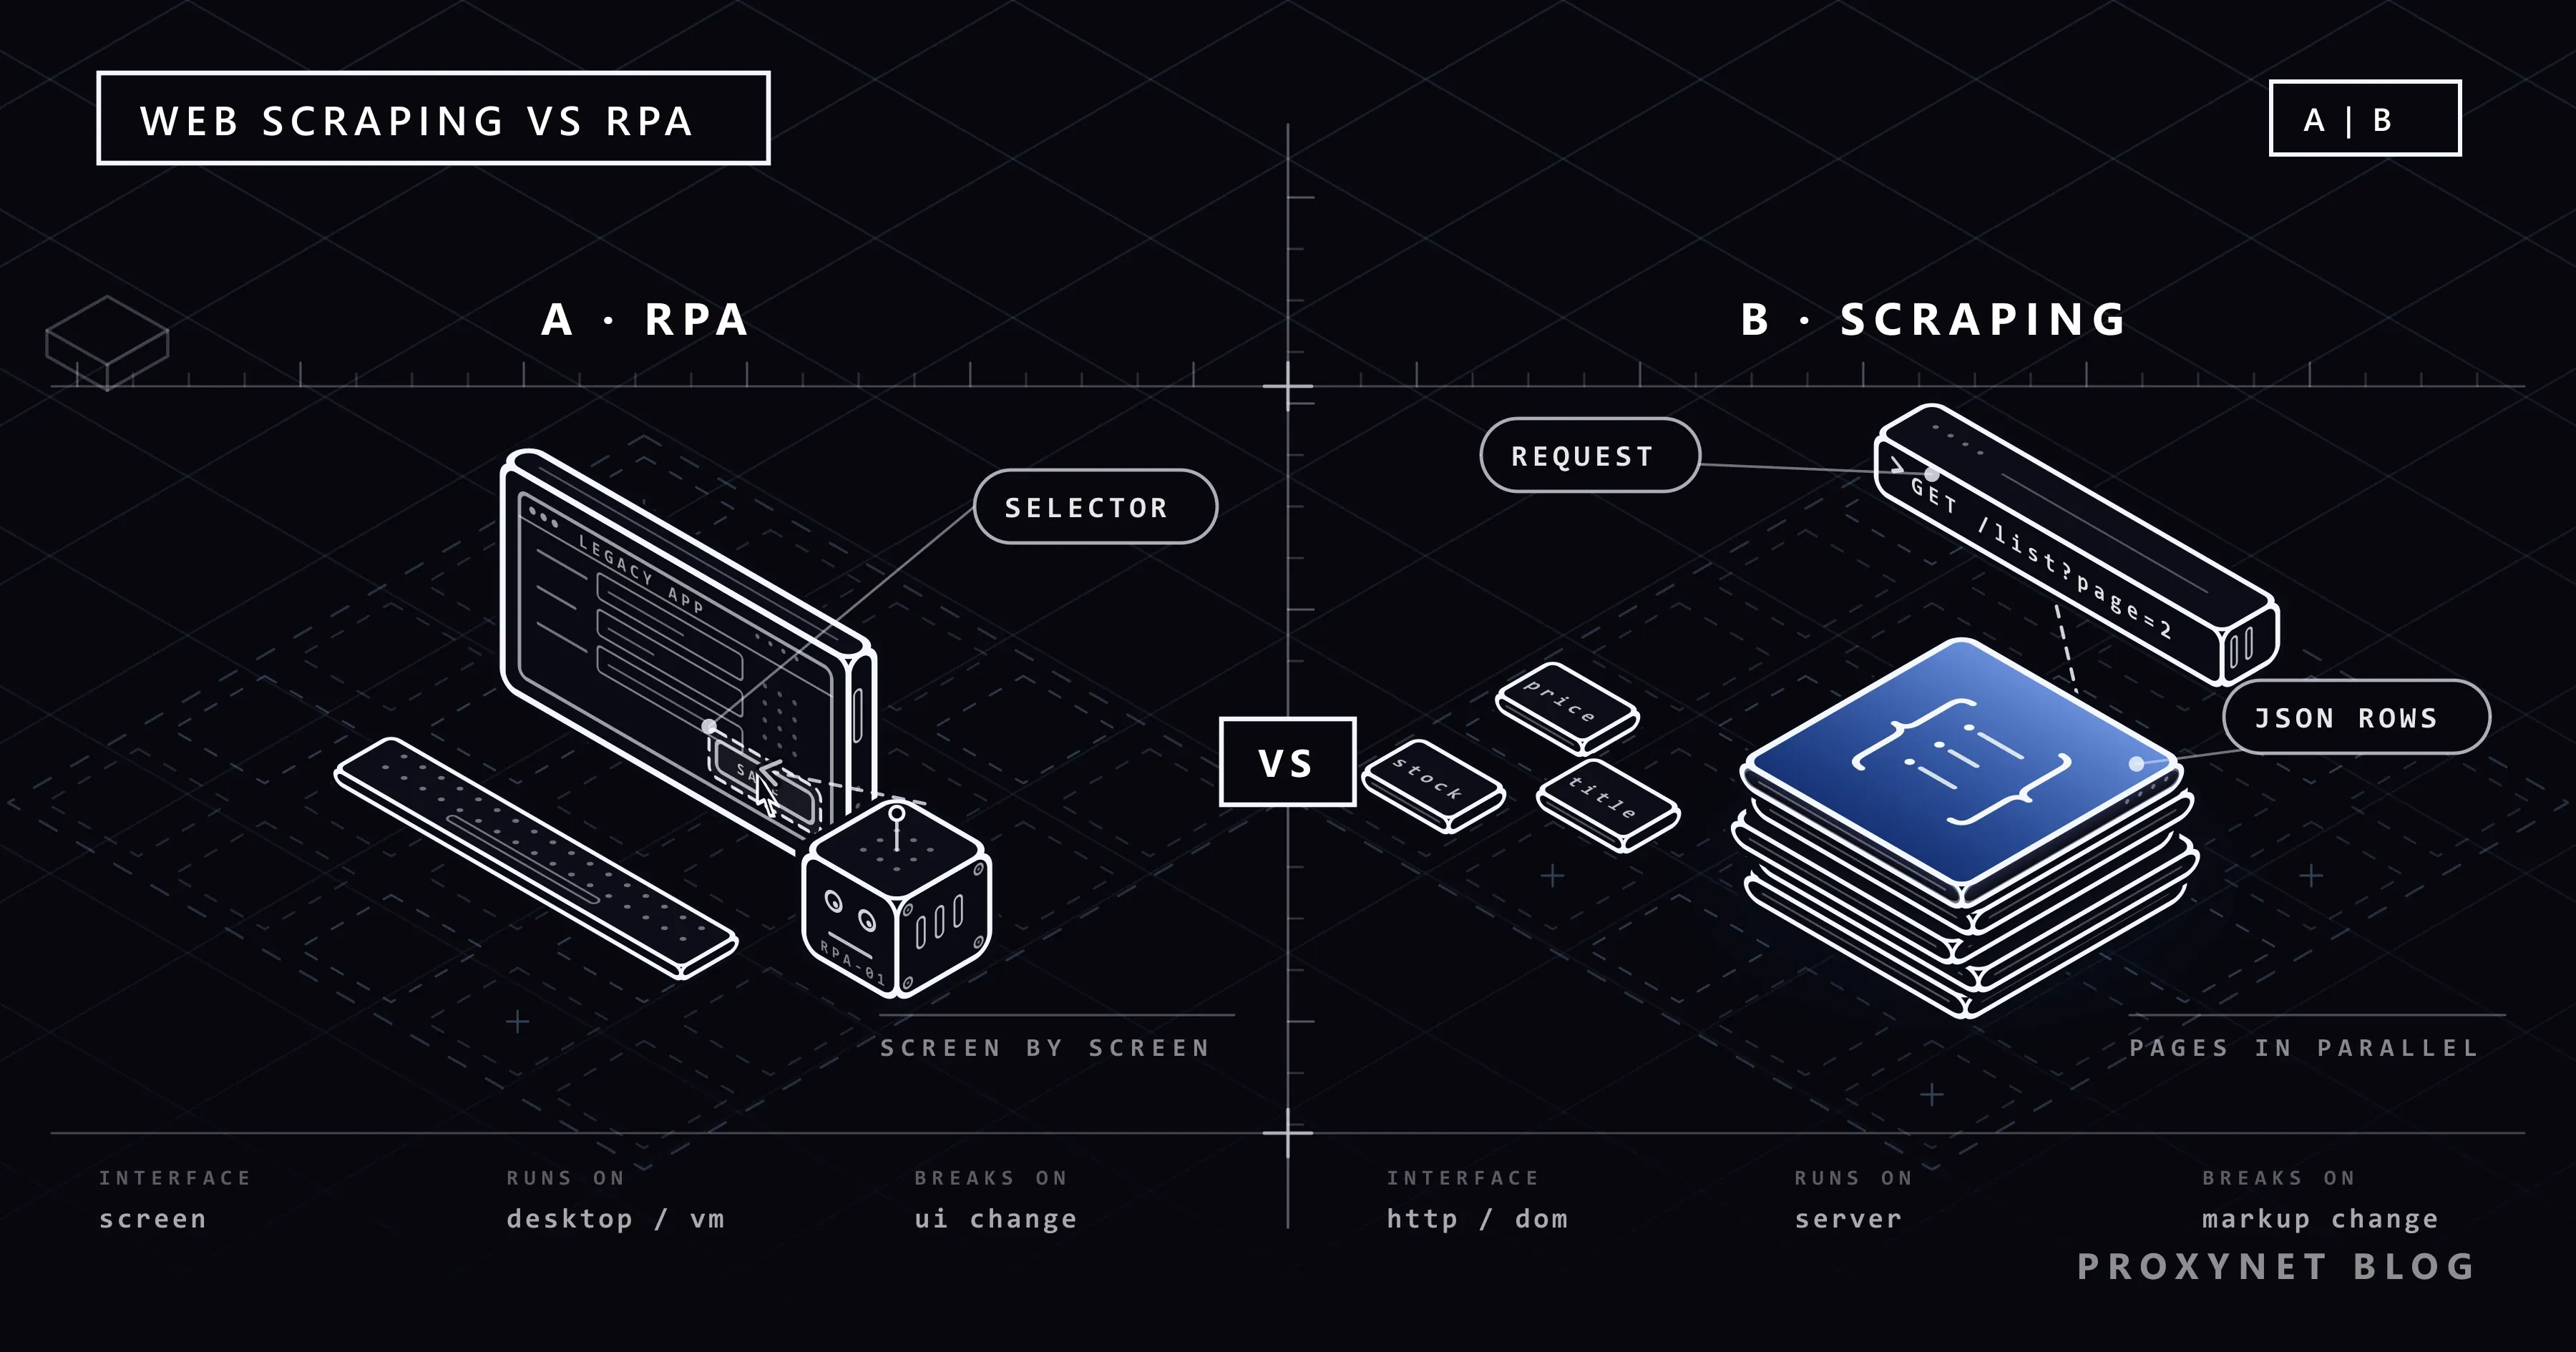
RPA, sigla de robotic process automation (automação robótica de processos), é um software que automatiza trabalho repetitivo e baseado em regras operando outros softwares do jeito que uma pessoa faria. O "robô" é um programa: ele abre um aplicativo, encontra um botão ou um campo, clica, digita, copia um valor e o cola em outro lugar. Trabalhar na interface do usuário permite que ele conecte sistemas que nunca foram feitos para conversar entre si.
Até o vocabulário tem um padrão. A IEEE 2755-2017, o IEEE Guide for Terms and Concepts in Intelligent Process Automation, foi publicada em 28 de setembro de 2017 para manter coerente a terminologia da automação inteligente de processos baseada em software, e continua listada como ativa. A definição da própria UiPath é parecida: RPA "usa robôs de software para automatizar tarefas repetitivas e baseadas em regras, como entrada de dados e integração de sistemas" e "imita ações humanas em sistemas digitais". A Automation Anywhere o chama de "inerentemente baseado em regras" e o faz remontar às macros de teclado dos anos 1990.
Há dois tipos de robô. Um robô attended (assistido) trabalha com uma pessoa na mesma máquina: o usuário o inicia com um botão ou um atalho de teclado, fornece as entradas e trata as exceções, como descreve a documentação do Automation 360 da Automation Anywhere. Um robô unattended (não assistido) roda sozinho, geralmente em uma máquina dedicada, iniciado por um agendamento, uma chamada de API ou um evento; a UiPath descreve esses processos como "controlados pelo Orchestrator", seu servidor de gerenciamento, sob uma licença separada.
O que é web scraping?
Web scraping é a obtenção programática de páginas web e a extração de dados estruturados a partir delas. Um scraper envia a requisição HTTP que um navegador enviaria, recebe o HTML ou o JSON que a página carrega em segundo plano, seleciona os campos que foi instruído a encontrar e os armazena como linhas. Nenhuma tela entra na história: o programa lê o código da página, não os pixels dela. O processo completo está em O que é web scraping e como funciona?
Como cada um funciona?
Um processo de RPA:
- Desenhar o fluxo. Um desenvolvedor ou um usuário de negócio grava os cliques uma vez, ou monta ações prontas em um designer visual, e acrescenta regras como "enviar para aprovação as notas acima de um limite".
- Vincular cada etapa a um elemento da interface por meio de um seletor. A documentação da UiPath define um seletor como um fragmento XML que armazena "os atributos de um elemento da interface gráfica do usuário e de seus elementos pais"; o Power Automate o monta a partir da posição do elemento na hierarquia do aplicativo e tenta o próximo seletor quando o primeiro falha.
- Executar o robô em um desktop ou em uma máquina virtual. Uma execução assistida usa a sessão do usuário. Uma execução não assistida precisa da própria máquina: o Power Automate entra com uma conexão salva, abre uma sessão de área de trabalho remota, mantém a tela bloqueada e sai no fim; no Windows 10 e 11 ele não inicia enquanto houver qualquer sessão de usuário ativa, mesmo bloqueada (Microsoft Learn).
- Entregar as exceções a uma pessoa. Quando um seletor não encontra nada ou um valor não passa em uma verificação, o robô deixa o item em uma fila para um humano.
Um trabalho de web scraping:
- Requisitar. Requisições HTTP para uma lista de URLs em ritmo moderado, com timeout e um User-Agent honesto, depois de conferir o robots.txt e os termos de uso.
- Analisar. O HTML vira uma árvore e os campos são selecionados com seletores CSS ou XPath, ou lidos do endpoint JSON que a própria página chama.
- Normalizar. Preços viram números em uma só moeda, datas ganham um único formato, duplicatas viram um registro só.
- Armazenar e repetir. As linhas vão para um arquivo ou banco de dados, e o trabalho roda de novo conforme um agendamento.
Web scraping vs RPA: tabela comparativa
| Aspecto | RPA | Web scraping |
|---|---|---|
| Propósito | Automatizar um processo de negócio entre aplicativos | Coletar dados de páginas web |
| Trabalha em | Interface do usuário: janelas, botões, campos | Respostas HTTP: HTML, JSON |
| Precisa de tela | Sim, uma sessão de desktop ou VM | Não |
| Escala | Uma tela por vez por robô | Muitas requisições em paralelo a partir de um servidor |
| Quebra quando | Uma janela, um rótulo, o layout ou a resolução mudam | O HTML muda; o site limita as requisições |
| Modelo de custo | Licença por robô ou runtime, máquinas, um desenvolvedor | Tempo de engenharia, servidores, proxies, manutenção |
| Responsável típico | Operações, financeiro ou automação de TI | Equipe de dados ou de engenharia |
| Resultado | Um processo concluído | Um conjunto de dados em linhas |
Onde RPA e web scraping se sobrepõem?
A maioria das suítes de RPA traz um pequeno scraper, e a maioria das equipes de dados acaba precisando de um bot.
Um bot de RPA que lê um site público. A ação Extract data from web page (extrair dados de página da web) do Power Automate, segundo sua página de referência, extrai "dados de partes específicas de uma página da web como valores únicos, listas, linhas ou tabelas", segue a paginação até um número definido de páginas e guarda o resultado em uma variável ou em uma planilha do Excel. Isso é scraping por meio de um navegador controlado pelo robô: bom para algumas páginas dentro de um processo maior, errado para dez mil páginas por dia, porque cada página é renderizada uma de cada vez.
Um scraper que alimenta um processo de RPA. Um scraper coleta os preços dos concorrentes, um analista decide e um bot digita os novos preços em uma ferramenta de precificação sem função de importação: o scraper faz o volume, o bot faz a última etapa.
Uma API oficial que dispensa os dois. Se o portal do fornecedor oferece uma API, o bot que clica é peso morto; se um site publica um feed de dados, fazer scraping dele também. Nossa comparação entre web scraping e API trata dessa decisão.
Quando cada um vence?
RPA vence quando o trabalho mora dentro de sistemas que você não alcança de nenhum outro jeito:
- Aplicativos legados sem API: emuladores de terminal, aplicativos publicados via Citrix, um programa Windows de 2004; a Microsoft cita os emuladores de terminal entre os aplicativos legados que os fluxos de área de trabalho automatizam.
- Software de desktop licenciado que um usuário pode operar, mas que não oferece acesso programático.
- Aprovações com uma pessoa no circuito, em que um robô assistido prepara o trabalho e alguém dá o aval.
- Processos, não conjuntos de dados: a meta é "a nota foi lançada", não "aqui está uma tabela".
Web scraping vence quando os dados são públicos, o volume é grande e as fontes são muitas:
- Escala: milhares de páginas de produto por dia são um trabalho comum de scraping e um trabalho impossível de RPA.
- Monitoramento: verificações de hora em hora precisam de um programa em um servidor, não de um robô que depende de uma sessão de desktop.
- Conjuntos de dados coletados ao longo de semanas; o resultado já é uma tabela.
- Visões de vários países: um scraper pode enviar cada requisição por uma saída no país certo; um robô de desktop em um escritório não.
Quanto custam, e o que os quebra?
Os custos de RPA começam pelas licenças, vendidas por robô, por usuário ou por runtime, com as execuções não assistidas geralmente em um nível mais alto; o Power Automate exige o plano Process para fluxos de área de trabalho não assistidos. Depois vêm as máquinas, um desenvolvedor e os usuários que tratam as exceções. Os custos de scraping são o tempo de engenharia dos parsers, servidores, tráfego de proxy onde os alvos exigem e um monitoramento que perceba quando um seletor passa a não retornar nada, em silêncio.
O que quebra o RPA é a tela: um botão renomeado, um campo novo, uma caixa de diálogo inesperada ou uma resolução diferente na máquina não assistida, que, como a Microsoft avisa, pode esconder um elemento de destino ou fazer o robô agir sobre o elemento errado. O guia de seletores da UiPath diz que, quando o valor de um atributo muda entre execuções, "o seletor não conseguirá identificar o elemento corretamente". O que quebra o scraping é a marcação e o porteiro: um redesign renomeia as classes de que o seu parser depende, e um site que vê requisições demais de um mesmo endereço responde 429 Too Many Requests ou mostra uma página de proteção contra bots.
Quem é o dono do bot?
Um bot de RPA age dentro dos seus sistemas com as credenciais de um funcionário ou de uma conta de serviço: as execuções não assistidas do Power Automate entram com as credenciais salvas em uma conexão de fluxo de área de trabalho, e os bots não assistidos da Automation Anywhere são iniciados pelo agendador do Control Room, por chamadas de API ou por eventos. Dê a ele o mínimo de privilégios, registre cada execução e avise alguém quando as exceções se acumularem.
Um scraper age como visitante do site de outra pessoa, sob os termos de uso, o robots.txt e a lei de proteção de dados. Preços e estoque são dados comerciais públicos; nomes, telefones e e-mails de pessoas são dados pessoais sob o GDPR e a KVKK da Türkiye, e nossos exemplos nunca os coletam. Mantenha um ritmo moderado, identifique o scraper com honestidade e pare quando pedirem. Este artigo descreve as regras; para um projeto específico, consulte um advogado.
Onde um proxy se encaixa?
Um proxy só importa no lado de qualquer uma das duas ferramentas que olha para a web. Um robô ou scraper rodando em um datacenter chega aos sites públicos pelo endereço IP desse datacenter e vê os preços e o idioma que aquela localização recebe; quando o processo precisa ver a versão local de um mercado, dê a ele uma saída nesse mercado.
Para um robô ou scraper que entra em um portal de parceiro ou chama uma API de parceiro que libera endereços por whitelist, com os Proxies ISP ele tem um único IP estável; esses produtos por IP vêm com o acesso limitado aos sites de destino que você indicar, e o acesso a todos os sites é um complemento pago.
Para ler como um site aparece para os clientes de um país ou cidade, os Proxies residenciais direcionados a essa localização mostram os preços locais. Um proxy muda de onde a requisição vem, não o que o site permite.
RPA e agentes de IA: o que muda?
Um agente de IA planeja as próprias etapas; um bot de RPA segue as etapas que recebeu. Um agente construído em torno de um modelo de linguagem olha para um objetivo, escolhe a próxima ferramenta, lê o resultado e se adapta, então consegue lidar com uma janela que nunca viu, ao custo de uma chamada ao modelo por etapa e de um caminho que amanhã pode ser outro. Um fluxo de RPA faz a mesma coisa toda vez. Como o loop do agente funciona, e por que trabalhos previsíveis ainda pertencem a um fluxo de trabalho fixo, está explicado em Agentes de IA: planejamento, ferramentas e memória.
Os fornecedores estão juntando os dois (a UiPath lista visão computacional e compreensão de documentos entre as capacidades de IA que estendem seus robôs); o padrão que se sustenta é um fluxo fixo com um modelo em uma etapa, não um agente clicando livremente por um sistema de produção.
Erros comuns
- Fazer scraping de dez mil páginas com um bot de RPA. Cada página custa um navegador renderizado em uma máquina ocupada; mova o volume para um scraper.
- Construir um scraper para um sistema interno que tem API. Você assume manutenção à toa, e a API é o caminho que os termos permitem.
- Rodar um robô com uma conta pessoal. Quando essa pessoa sai, o processo para, e a trilha de auditoria fica turva.
- Tratar um scraper como isento das regras do site. Termos de uso, robots.txt e limites de requisições valem para um programa como valem para um visitante.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Mover dados entre dois sistemas internos sem API | RPA |
| O provedor oferece uma API ou um feed de dados | Use a API |
| Preços públicos de centenas de sites todo dia | Web scraping, com saídas por país |
| Uma pessoa precisa aprovar cada item | RPA assistido |
| Documentos não estruturados em uma etapa de um processo fixo | RPA mais um modelo nessa etapa |
| Etapas que não dá para desenhar de antemão | Um agente de IA com limites e aprovação |
| Muitos sites e nenhuma equipe para manter os parsers | Uma API de scraping gerenciada |
Perguntas frequentes
O que é RPA e para que serve?
RPA é automação robótica de processos: robôs de software que executam tarefas baseadas em regras operando outros programas pela interface do usuário, como uma pessoa faria. Ele move dados entre sistemas que não têm API, lança notas fiscais e roda outros processos repetitivos de back office.
Web scraping é um tipo de RPA?
Não. Web scraping lê páginas web por HTTP e extrai campos da resposta; RPA automatiza processos de negócio agindo sobre as telas dos aplicativos. São ferramentas diferentes, com responsáveis e custos diferentes.
Ferramentas de RPA conseguem fazer scraping de sites?
Sim, em pequena escala. A ação Extract data from web page do Power Automate puxa valores únicos, listas ou tabelas de uma página; para milhares de páginas por dia, um scraper dedicado é mais rápido e mais barato, porque não renderiza uma tela para cada uma.
RPA vs API: qual você deve escolher?
A API, sempre que o sistema oferecer uma com os dados de que você precisa: ela é um contrato que o provedor mantém, enquanto um robô depende de uma tela que pode mudar a qualquer momento. RPA é a alternativa para sistemas sem API, como software de desktop legado ou licenciado.
Os agentes de IA vão substituir o RPA?
Não em processos previsíveis. Um agente decide as próprias etapas, o que ajuda quando um trabalho não pode ser roteirizado de antemão, mas acrescenta custo por etapa e torna o resultado menos repetível; um processo fixo e auditável ainda pertence a um fluxo definido, muitas vezes com um modelo em uma etapa.
O que é mais barato, RPA ou web scraping?
Depende do trabalho. RPA carrega custos de licença, máquina e desenvolvedor e serve para processos com dezenas ou centenas de itens por dia; scraping carrega custos de engenharia, servidor e proxy e fica mais barato por página conforme o volume cresce.
Em resumo
RPA automatiza um processo de negócio operando o software pela tela, o que alcança sistemas sem API ao custo de depender dessa tela. Web scraping coleta dados de páginas públicas por HTTP, o que escala para milhares de páginas e países ao custo de manter parsers e seguir as regras de cada site. Verifique primeiro se existe uma API; depois use RPA para processos internos e scraping para dados públicos da web. Se você prefere receber registros já extraídos a manter parsers, nossa API de web scraping oferece extração gerenciada de páginas por meio da nossa equipe de vendas.