Uma equipe de suporte quer um assistente que responda a partir da documentação pública dos produtos que ela atende. A primeira versão baixa as páginas com Requests e entrega o HTML ao modelo. As respostas citam o banner de cookies, o menu ocupa mais espaço no prompt do que o artigo, as páginas que carregam o texto com JavaScript voltam vazias e uma página que mudou na semana passada ainda é respondida a partir da cópia antiga. Não há nada de errado com o modelo. Os dados nunca foram preparados.
Este post trata dessa preparação: o que é RAG, por que as páginas web são a fonte mais difícil de preparar, por que Markdown supera tanto o HTML quanto o texto simples, o pipeline da busca até a atualização, um exemplo medido em uma página real com um script Python de 58 linhas e onde entram as APIs de scraping e os proxies. O script rodou em 9 de novembro de 2026 com trafilatura 2.3.1, tiktoken 0.14.0 e Python 3.13.
O que é RAG e para que ele serve?
RAG, abreviação de retrieval-augmented generation (geração aumentada por recuperação), é uma forma de responder com um modelo de linguagem em que os fatos vêm de documentos recuperados na hora da pergunta, e não apenas do treinamento do modelo. Um retriever, o componente de busca, pesquisa um índice de trechos, as melhores correspondências entram no prompt e o modelo escreve a resposta a partir delas. O índice pode guardar qualquer coisa que tenha virado texto: PDFs, tickets, linhas de banco de dados e páginas web.
O nome vem de um artigo de 2020 de Patrick Lewis, Ethan Perez, Aleksandra Piktus e colegas, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Ele combina um modelo sequência a sequência pré-treinado, cujo conhecimento fica nos parâmetros, com um índice vetorial denso da Wikipédia lido por um retriever neural, o que os autores chamam de memória não paramétrica. Dois problemas que o artigo aponta são exatamente os que o conteúdo web levanta: atualizar o que o modelo sabe e mostrar de onde uma resposta veio. O ajuste fino (fine-tuning) grava o conhecimento nos pesos, então cada mudança em uma página significa outra rodada de treinamento e nenhuma fonte para citar; com RAG, uma página alterada é buscada de novo e reindexada, e cada resposta pode carregar a URL e a seção dela.
Por que as páginas web são a fonte mais difícil para RAG?
As páginas web são difíceis porque o conteúdo que você quer é uma minoria do que o servidor envia. Uma página de documentação carrega uma árvore de navegação, um cabeçalho, um rodapé, um aviso de cookies, botões de compartilhar e "artigos relacionados", tudo como texto que um pipeline ingênuo indexa ao lado do artigo. Quando um usuário pergunta sobre limites de requisições, o retriever devolve o banner de cookies porque ele contém a palavra "limite".
Outros três problemas são próprios da web. Muitas páginas carregam o texto com JavaScript, então o HTML que você baixa tem um título e uma div vazia. Um mesmo artigo costuma viver em várias URLs, com parâmetros de rastreamento, uma versão para impressão, http e https ou uma barra no final, de modo que o mesmo trecho entra três vezes no índice e enche os primeiros resultados com cópias de si mesmo. E as páginas mudam em silêncio: um PDF que você indexou em março continua sendo aquele PDF, uma página de preços não. Some a paginação que divide um documento em várias páginas e os erros de codificação que transformam — em —, e você tem o estado normal de um site público.
Por que Markdown, e não HTML ou texto simples?
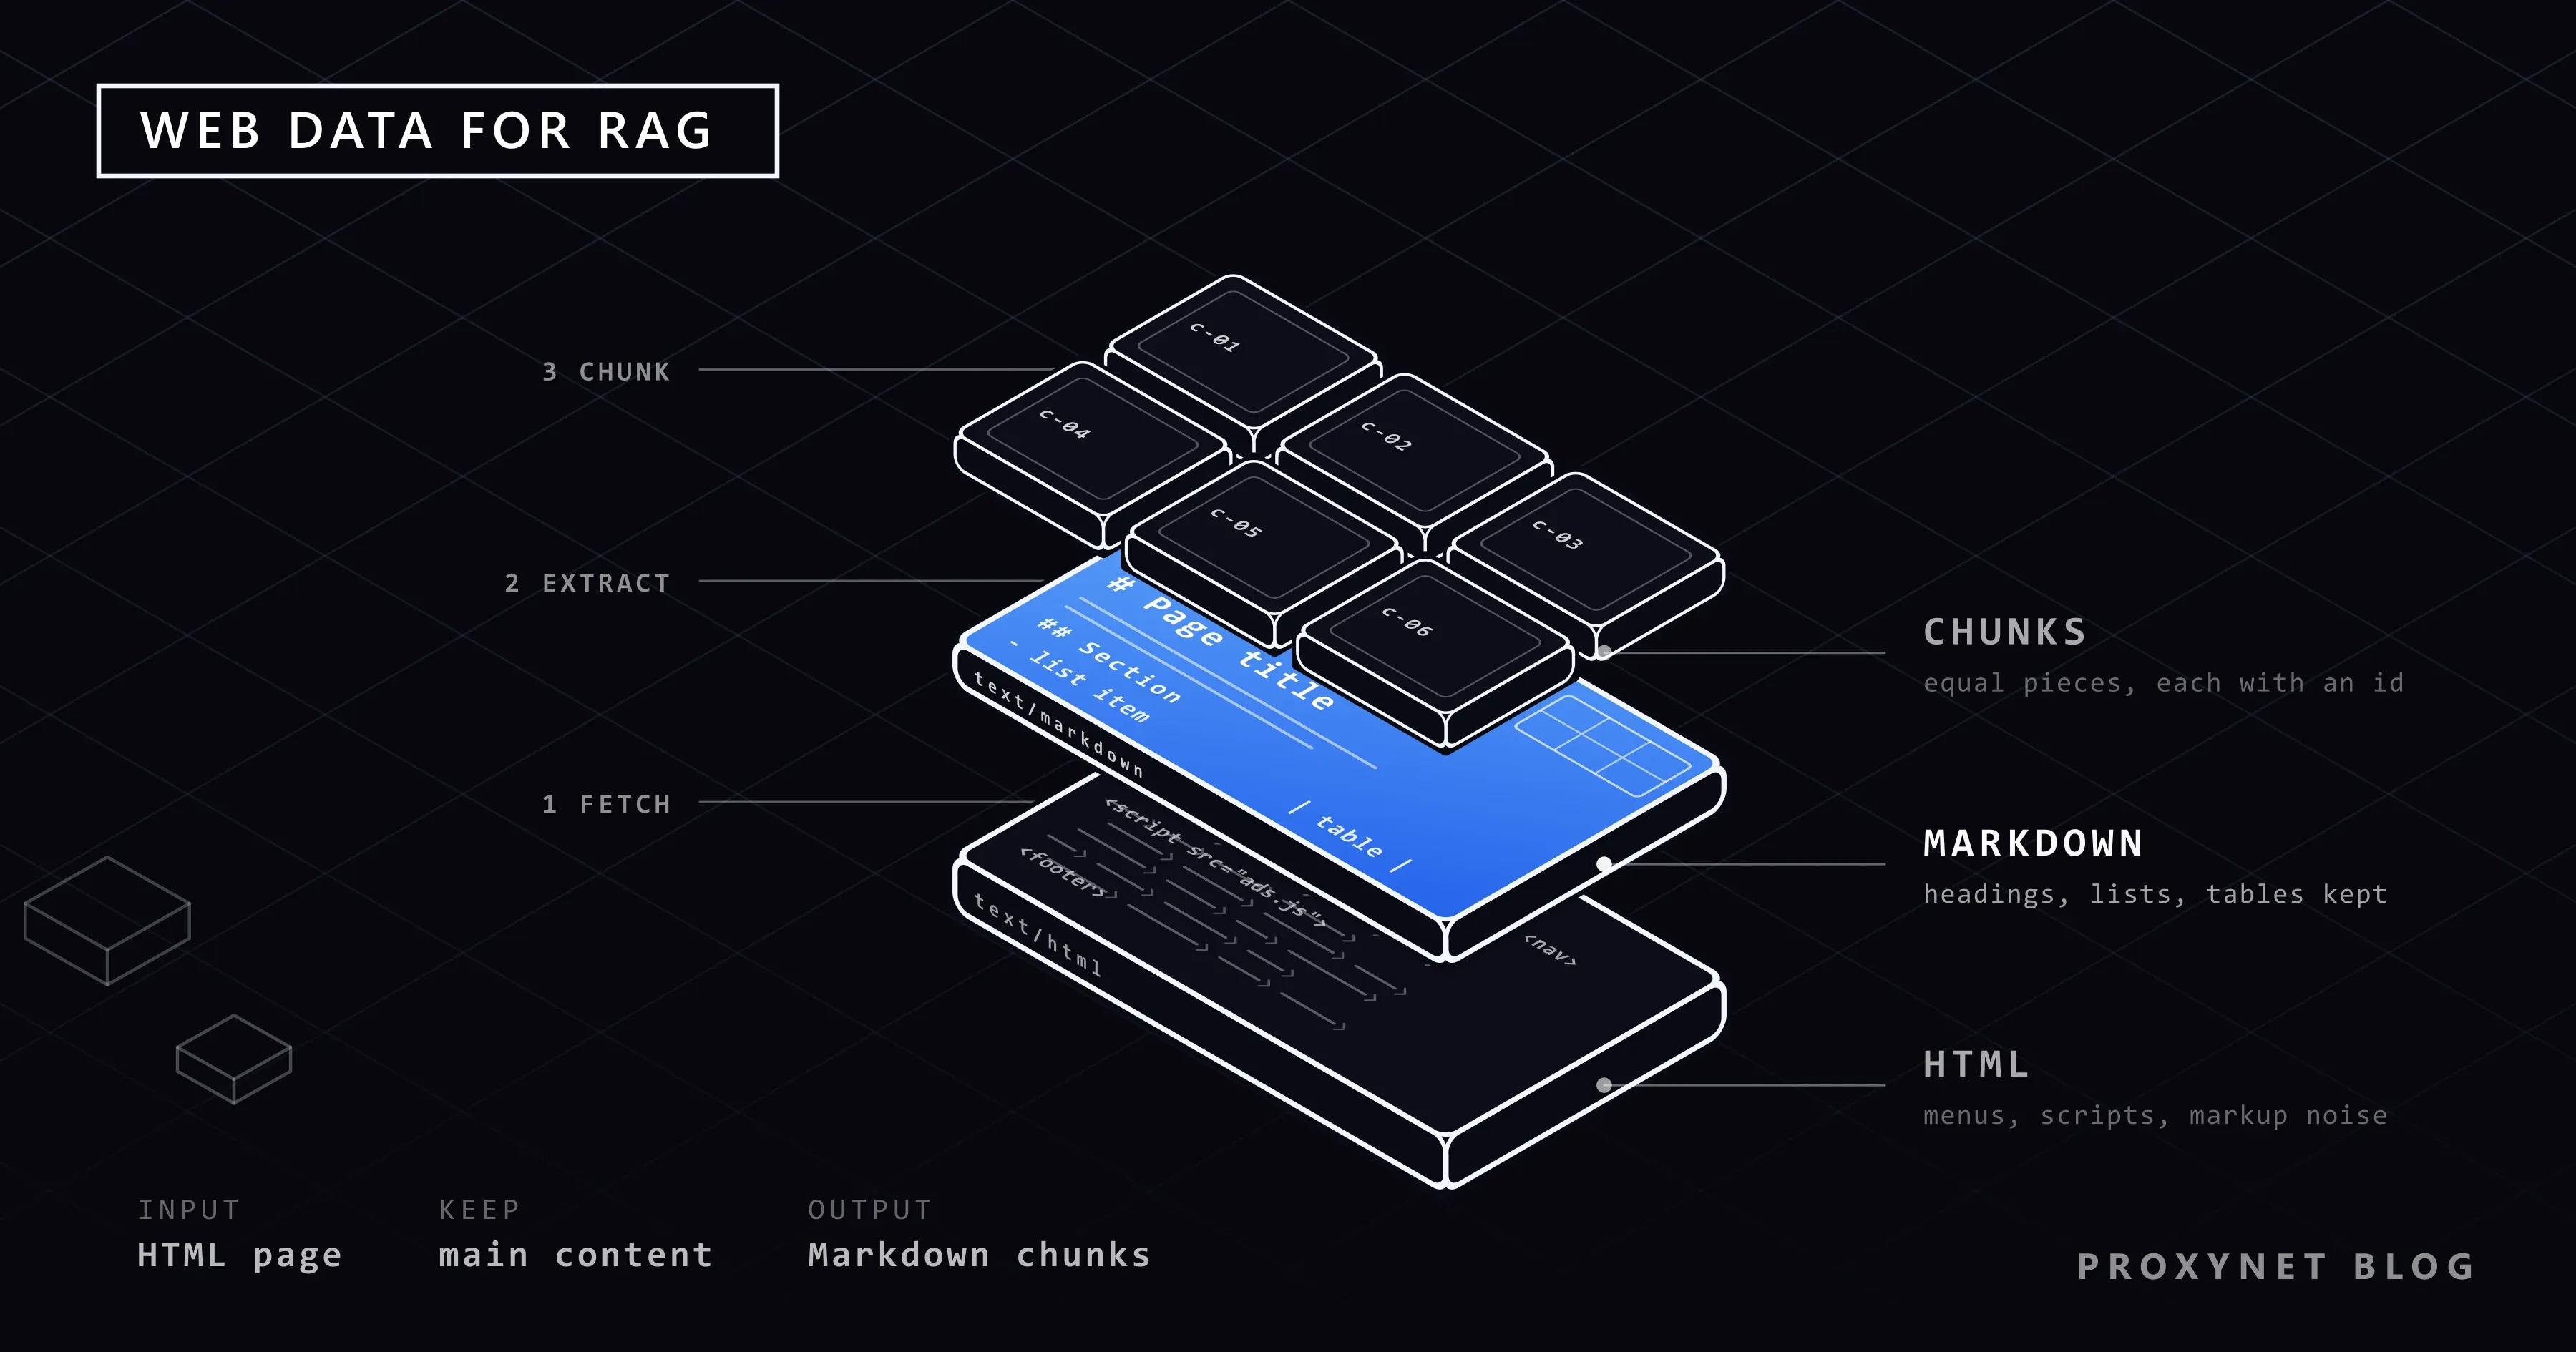
O Markdown é o formato intermediário certo porque mantém a estrutura de que um retriever e um modelo precisam, como títulos, listas, tabelas, blocos de código e links, enquanto descarta a marcação, os scripts e os estilos que não carregam significado. O HTML gasta a maior parte dos tokens em tags e atributos. O texto simples vai longe demais na outra direção: uma tabela vira uma fileira de palavras, um título vira uma linha como qualquer outra, e não sobra um lugar confiável para cortar um chunk. A proposta llms.txt, que pede aos sites que publiquem versões em Markdown das páginas, diz sem rodeios: "At the moment the most widely and easily understood format for language models is Markdown" (no momento, o formato mais difundido e mais fácil de entender para os modelos de linguagem é o Markdown).
Medimos a diferença em uma página real, o HOWTO da documentação do Python sobre buscar recursos da internet com urllib, com o tokenizador o200k_base do tiktoken. Os números descrevem esta página, não a web em geral.
| Formato | O que sobrevive | Tokens na página de teste | Onde os chunks podem ser cortados |
|---|---|---|---|
| HTML bruto | Tudo, inclusive menus, scripts e marcação | 21.044 | Nas tags, que não dizem nada sobre o significado |
| Texto simples | Só palavras; títulos e tabelas se achatam | 4.133 | Nas linhas em branco, na melhor das hipóteses |
| Markdown | Títulos, listas, tabelas, código e links | 4.405 | Nas linhas de título |
O Markdown custou 272 tokens a mais do que o texto simples nesta página, cerca de 7%, e em troca cada título de seção continua sendo um título. Em relação ao HTML bruto, ele é 4,8 vezes menor. Uma ressalva: o Markdown tem uma especificação para o seu núcleo, a CommonMark (versão 0.31.2, janeiro de 2024), mas as tabelas com barras verticais e os blocos de código cercados (fenced code blocks) são extensões popularizadas pelo GitHub, então confira se o seu conversor os escreve em vez de descartá-los.
Como funciona o pipeline da web para o RAG?
O pipeline tem dez etapas, e a ordem importa porque cada uma depende da anterior.
- Busque apenas o que você pode buscar. Leia o robots.txt do site antes da primeira requisição e pule os caminhos proibidos; as regras estão explicadas no nosso guia de robots.txt. Leia os termos de uso, envie um
User-Agentque nomeie o seu bot e um endereço de contato, e mantenha um ritmo respeitoso por domínio. Se o site publica versões em Markdown das páginas, use-as em vez de fazer o parsing do HTML. - Extraia o conteúdo principal. O trafilatura é um pacote Python e uma ferramenta de linha de comando sob a licença Apache 2.0 que transforma HTML bruto em texto, Markdown, XML ou JSON e também extrai o título, o autor e a data. O Mozilla Readability é a biblioteca JavaScript por trás da Reader View (modo de leitura) do Firefox;
new Readability(document).parse()devolve o título, o conteúdo limpo e a linha de autoria. Os dois trabalham a partir da estrutura e da densidade de texto, sem um parser por site. - Converta em Markdown. O trafilatura escreve Markdown diretamente com
output_format="markdown". Se você já tem HTML limpo, o markdownify em Python ou o Turndown em JavaScript fazem a conversão; escolha títulos#no estilo ATX, porque o chunker divide neles. Páginas que montam o conteúdo com JavaScript precisam de um navegador: o Crawl4AI as renderiza no Chromium e devolve um Markdown "fit" sem menus, como mostra o nosso guia do Crawl4AI. - Limpe. Remova o que o extrator deixou: símbolos de âncora depois dos títulos, links de "Editar esta página", trilhas de navegação (breadcrumbs), espaços duplicados. Corrija a codificação na origem, não no texto. Deixe os blocos de código e as tabelas exatamente como estão.
- Divida em chunks nos títulos dentro de um orçamento de tokens. Corte onde uma linha de título começa, guarde o caminho de títulos como metadado (
Fetching URLs > Data) e divida as seções acima do orçamento nos limites de parágrafo. Conte os tokens com o tokenizador do modelo com que você gera os embeddings; o tiktoken é o tokenizador BPE rápido dos modelos da OpenAI, eo200k_baseé a codificação que o README dele usa. Caracteres não substituem tokens: 500 caracteres são cerca de 100 tokens em prosa inglesa e muito mais em código. - Remova as duplicatas. Calcule o hash do texto normalizado do chunk; dois chunks com o mesmo hash são o mesmo trecho, venham da URL que vierem. Quase duplicatas, como a mesma página com uma linha de "última atualização" diferente, precisam de um teste de similaridade sobre shingles de palavras ou sobre os embeddings.
- Anexe a proveniência. Cada chunk carrega a URL, a hora da busca, o título da página, o caminho da seção, o hash do conteúdo e a contagem de tokens. Sem isso você não consegue citar, atualizar nem apagar.
- Gere os embeddings e indexe. Cada chunk vira um vetor em um índice vetorial; muitas equipes acrescentam um índice de palavras-chave e mesclam as duas listas de resultados. O modelo e o banco de dados que você escolher não mudam as etapas acima.
- Atualize. Guarde os cabeçalhos
ETageLast-Modifiede envieIf-None-MatchouIf-Modified-Sincena próxima vez; um304 Not Modifiedcusta quase nada, e a nossa página de teste enviou os dois cabeçalhos. Use as dataslastmoddo sitemap para decidir o que revisitar primeiro, substitua os chunks por URL e seção e descarte os chunks das páginas que agora devolvem 404 ou 410. - Avalie a recuperação. Anote 30 ou 50 perguntas reais com o trecho que responde a cada uma e meça com que frequência o chunk certo aparece entre os primeiros resultados. Ajuste o tamanho do chunk, a sobreposição e o orçamento com base nesse número, não em uma sensação.
Um exemplo testado: uma página de HTML a chunks de Markdown
O script executa as sete primeiras etapas em uma página e imprime o que encontrou. Escolhemos uma página da documentação do Python, cujo robots.txt proíbe /dev, /release e versões antigas como /3.10/, mas permite /3/, conferido em 9 de novembro de 2026; o script confere isso de novo com urllib.robotparser antes de buscar.
python -m venv .venv
.venv/bin/pip install trafilatura tiktoken requests   # Windows: .venv\Scripts\pip
Dois detalhes explicam duas linhas do código. O docs.python.org envia Content-Type: text/html sem charset, então o resp.text do Requests decodificaria a página como ISO-8859-1 e cada título terminaria em um  perdido; a página declara UTF-8 no <meta charset>, então o script decodifica os bytes por conta própria. E o gerador da documentação deixa um sinal de parágrafo (¶) depois de cada título como link de âncora, que o trafilatura mantém como texto, então a etapa de limpeza o remove. Um terceiro detalhe importa para a divisão em chunks: a página contém 17 blocos de código cercados cujos comentários Python começam com # , então um chunker que dividisse em toda linha # cortaria dentro do código e trataria os comentários como títulos. O script mantém cada bloco cercado inteiro.
"""Busca uma página pública, mantém o conteúdo principal como Markdown, divide em chunks por título e conta tokens."""
import hashlib, json, re, sys
from datetime import datetime, timezone
from urllib.parse import urlsplit
from urllib.robotparser import RobotFileParser
import requests
import tiktoken
import trafilatura

URL = sys.argv[1] if len(sys.argv) > 1 else "https://docs.python.org/3/howto/urllib2.html"
UA = "rag-prep-demo/1.0 (+https://example.com/bot)"
BUDGET = 512                                  # máximo de tokens por chunk; seções mais longas são divididas por parágrafo
enc = tiktoken.get_encoding("o200k_base")     # o tokenizador dos modelos atuais da OpenAI
tokens = lambda s: len(enc.encode(s))

# 1. robots.txt primeiro: pare se o caminho for proibido para o nosso user agent
robots = RobotFileParser(urlsplit(URL)._replace(path="/robots.txt", query="", fragment="").geturl())
robots.read()
if not robots.can_fetch(UA, URL):
    sys.exit(f"robots.txt disallows {URL}")

# 2. uma busca, três visões da mesma página: HTML bruto, conteúdo principal como Markdown, texto simples
resp = requests.get(URL, headers={"User-Agent": UA}, timeout=30)
resp.raise_for_status()
html = resp.content.decode("utf-8")           # a página declara UTF-8; resp.text chutaria ISO-8859-1
fetched_at = datetime.now(timezone.utc).isoformat(timespec="seconds")
md = trafilatura.extract(html, url=URL, output_format="markdown", include_tables=True, include_formatting=True)
md = md.replace("¶", "")                 # limpeza: o Sphinx deixa um sinal de parágrafo de âncora depois de cada título
txt = trafilatura.extract(html, url=URL, output_format="txt", include_tables=True)
title = trafilatura.extract_metadata(html, default_url=URL).title

# 3. dividir em blocos (parágrafos, linhas de título, blocos de código inteiros), depois cortar nos títulos e no orçamento
blocks = []
for seg in re.split(r"(```[\s\S]*?```)", md.strip()):           # um bloco de código cercado é um único bloco, nunca é cortado
    blocks += [seg] if seg.startswith("```") else [p.strip() for p in re.split(r"\n\s*\n|\n(?=#{1,6} )", seg) if p.strip()]
chunks, path, piece = [], [], ""
for block in blocks + ["# end"]:                                 # o título sentinela descarrega o último chunk
    head = re.match(r"(#{1,6}) (.+)", block)
    if head or (piece and tokens(piece + "\n\n" + block) > BUDGET):
        if piece:
            chunks.append((list(path), piece))                   # um título sem texto embaixo não gera chunk
        piece = "" if head else block
    else:
        piece = f"{piece}\n\n{block}".strip()
    if head:
        path = path[:len(head.group(1)) - 1] + [head.group(2).strip()]

# 4. proveniência: cada chunk carrega de onde veio, quando, e um hash para a deduplicação
records = [{"url": URL, "fetched_at": fetched_at, "title": title, "section": " > ".join(p[1:]) or "(top)",
            "content_hash": hashlib.sha256(text.encode()).hexdigest()[:16], "tokens": tokens(text), "text": text}
           for p, text in chunks]

print(f"page: {title}\nfetched: {fetched_at}")
print(f"tokens (o200k_base): html={tokens(html)}  markdown={tokens(md)}  text={tokens(txt)}")
sizes = sorted(r["tokens"] for r in records)
print(f"chunks: {len(records)}  min={sizes[0]}  median={sizes[len(sizes) // 2]}  max={sizes[-1]}  budget={BUDGET}")
print("\n".join(f"  {r['tokens']:>4} tok  {r['content_hash']}  {r['section'][:60]}" for r in records[:6]))
print(json.dumps({k: v for k, v in records[1].items() if k != "text"}, indent=2))
Ele imprimiu:
page: HOWTO Fetch Internet Resources Using The urllib Package
fetched: 2026-11-09T12:32:13+00:00
tokens (o200k_base): html=21044  markdown=4405  text=4133
chunks: 19  min=10  median=183  max=495  budget=512
   276 tok  e21a9bc9bc9dc71b  Introduction
   460 tok  30fc2c8722d53c1a  Fetching URLs
   434 tok  51aca2bdee7780e4  Fetching URLs > Data
   144 tok  f8e6254387670d87  Fetching URLs > Data
   329 tok  3b49bcc1ef1326f3  Fetching URLs > Headers
    79 tok  3928e9cb23c19eee  Handling Exceptions
{
  "url": "https://docs.python.org/3/howto/urllib2.html",
  "fetched_at": "2026-11-09T12:32:13+00:00",
  "title": "HOWTO Fetch Internet Resources Using The urllib Package",
  "section": "Fetching URLs",
  "content_hash": "30fc2c8722d53c1a",
  "tokens": 460
}
A página virou 19 chunks com mediana de 183 tokens, e nenhum passou do orçamento de 512 tokens. "Fetching URLs > Data" aparece duas vezes porque essa seção era mais longa do que o orçamento e foi cortada em um limite de parágrafo em 434 e 144 tokens; as duas partes compartilham o caminho de seção, mas têm hashes diferentes, que é o que uma etapa de deduplicação precisa. O menor chunk tem 10 tokens, a seção "Footnotes" de uma frase só da página; um pipeline em produção o juntaria ao vizinho. A barra lateral, os links de página anterior e seguinte e o rodapé da página original não aparecem no Markdown, e isso é o extrator fazendo o trabalho dele. O registro JSON é a proveniência que viaja com o chunk até o índice; muitas equipes também colocam o caminho da seção na frente do texto antes de gerar o embedding.
Onde entram as APIs de scraping?
Uma API de scraping entra quando renderização, extração e boas maneiras devem ser problema de outra pessoa. Muitas delas devolvem Markdown diretamente, renderizam páginas em JavaScript em um navegador e controlam a taxa de requisições por domínio, então o seu pipeline começa na etapa de divisão em chunks. Quatro verificações dizem se um serviço serve para um corpus de RAG: busque dez páginas que você conhece e procure menus no Markdown e tabelas que chegaram inteiras; confira se o título, a URL canônica e, quando houver, a data da última modificação vêm junto com o conteúdo, porque eles viram proveniência; busque a mesma página inalterada duas vezes e compare a saída, ou os seus hashes marcarão toda página como alterada; e pergunte como o serviço trata o robots.txt e os limites de requisições, porque as requisições são feitas em seu nome.
Onde entra um proxy?
Um proxy entra aqui em duas situações, e nenhuma delas é buscar mais rápido de um único site. A primeira é a amplitude: um corpus de RAG costuma abranger centenas de domínios, e um crawler que respeita o ritmo de cada domínio ainda pode percorrer muitos domínios ao mesmo tempo. Espalhar essas buscas por mais de um endereço de saída, por exemplo por meio dos Proxies rotativos, faz com que cada domínio continue vendo um cliente lento e educado enquanto o trabalho inteiro termina em horas, e não em dias.
A segunda é a localização. Páginas de documentação, ajuda e preços muitas vezes mudam conforme o país ou o idioma do visitante, e um índice montado a partir da versão errada responde aos usuários com um conteúdo que eles nunca veem. Buscar a partir do país em que os seus usuários estão, com os Proxies residenciais e segmentação por país, indexa a página que eles vão ler de fato. O robots.txt, os termos e o ritmo continuam os mesmos, saia a requisição do endereço que sair.
Erros comuns
- Dividir por contagem de caracteres ignorando os títulos. Uma janela de 1.000 caracteres que atravessa duas seções não responde a nenhuma das duas perguntas. Corte nos títulos e depois nos parágrafos.
- Indexar conteúdo repetitivo (boilerplate). Avisos de cookies, menus e rodapés viram chunks que combinam um pouco com tudo e bem com nada.
- Sem proveniência. Sem URL, hora da busca e seção, você não consegue citar uma fonte, atualizar uma página alterada nem remover uma que saiu do ar.
- Nunca atualizar. Um corpus montado uma vez é um retrato do momento; requisições condicionais com
ETageLast-Modifieddeixam uma atualização semanal barata. - Gerar embeddings da mesma página várias vezes. Parâmetros de rastreamento, versões para impressão e barras finais criam cópias que lotam os primeiros resultados; calcule o hash do conteúdo, não da URL.
- Contar caracteres em vez de tokens, ou contar com um tokenizador diferente do que o modelo de embeddings usa.
- Dividir dentro de blocos de código e tabelas. Um comentário
#dentro do código não é título, e meia tabela não responde a nada. - Indexar uma página vazia. Se o conteúdo é montado com JavaScript, o HTML baixado não tem artigo; confira a contagem de tokens extraídos antes de indexar.
- Buscar o que o robots.txt ou os termos excluem, ou mais rápido do que uma pessoa leria. A situação jurídica (veja a última pergunta frequente) não melhora com o volume.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Algumas centenas de páginas de documentação | trafilatura para Markdown, chunks por título de 200 a 500 tokens, atualização semanal |
| Páginas renderizadas com JavaScript | Um extrator baseado em navegador, como o Crawl4AI, ou uma API de scraping que devolva Markdown |
| O site oferece versões em Markdown ou llms.txt | Busque os gêmeos .md e pule a extração |
| As respostas precisam citar a fonte | Proveniência em cada chunk: URL, hora da busca, título, caminho da seção, hash |
| O mesmo trecho aparece repetidamente nos resultados | Hashes de conteúdo, normalização de URL, um teste de quase duplicatas |
| Centenas de domínios, cada um em ritmo respeitoso | Domínios em paralelo por várias saídas com um proxy rotativo |
| Documentação ou preços específicos de um país | Um proxy residencial com segmentação por país |
| Nenhuma equipe para operar o pipeline | Uma API de scraping gerenciada que entregue Markdown com metadados |
Perguntas frequentes
O que significa RAG e qual é a diferença para o ajuste fino?
RAG significa retrieval-augmented generation, geração aumentada por recuperação: o modelo responde a partir de trechos recuperados na hora da pergunta. O ajuste fino (fine-tuning) muda os pesos do modelo com dados de treinamento, então uma informação nova exige uma nova rodada de treinamento e o modelo não consegue dizer de qual documento uma resposta veio. O RAG se atualiza reindexando uma página e pode citar a URL e a seção que usou.
Por que Markdown é melhor do que HTML para LLMs?
O Markdown mantém a estrutura que importa, como títulos, listas, tabelas e código, em poucos caracteres, enquanto o HTML gasta a maior parte dos tokens em tags, atributos e scripts. Na nossa página de teste, o Markdown tinha 4.405 tokens contra 21.044 do HTML, e os chunks ainda puderam ser cortados nos títulos.
Qual é o tamanho ideal de chunk para RAG?
Não existe um número único; uma faixa que funciona para documentação é de 200 a 500 tokens com cortes nos títulos, e o valor certo é o que pontua melhor no seu próprio teste de recuperação. Chunks menores combinam com mais precisão, mas perdem contexto; chunks maiores carregam contexto, mas diluem a correspondência.
Com que frequência devo refazer o crawling das páginas para RAG?
Com a frequência com que as páginas mudam, e as requisições condicionais dizem isso por quase nada: envie o valor guardado de ETag ou Last-Modified, e uma resposta 304 Not Modified significa que nada mudou. Para documentação, costuma bastar uma vez por semana; páginas de preços e de status pedem uma vez por dia; e as datas lastmod do sitemap dizem onde olhar primeiro.
O llms.txt substitui o scraping?
Não. O llms.txt é um índice selecionado das páginas importantes de um site para ferramentas de IA, e a mesma proposta pede aos sites que ofereçam versões em Markdown das páginas; onde os dois existem, busque o Markdown e pule a extração. A maioria dos sites não publica nenhum dos dois, e o arquivo não controla nada sobre o acesso, como explica o nosso guia de llms.txt, então o robots.txt e os termos continuam decidindo o que você pode buscar.
É legal usar páginas web obtidas por scraping em RAG?
Depende do site e da jurisdição, e isto é uma descrição, não uma orientação jurídica. Quatro coisas costumam ser examinadas: o robots.txt, que a RFC 9309 descreve como um pedido aos crawlers e não como uma autorização de acesso; os termos de uso do site, que muitas vezes proíbem o acesso automatizado; os direitos autorais, que dizem respeito à reprodução de texto e dependem de quanto de uma página uma resposta repete e de se ela cita a fonte; e os dados pessoais nas páginas, que o GDPR e a KVKK da Türkiye regulam e que um corpus de RAG não deveria coletar de forma alguma. A proveniência em cada chunk permite remover uma fonte quando alguém pedir. Consulte um advogado antes de montar um corpus a partir de sites de terceiros.
Em resumo
O RAG responde a partir de trechos recuperados, então a qualidade das respostas é definida pela qualidade dos trechos. Para fontes web, isso significa buscar apenas o permitido, extrair o conteúdo principal, converter em Markdown em vez de HTML ou texto simples, dividir em chunks nos títulos dentro de um orçamento de tokens, anexar a proveniência, remover as duplicatas e atualizar com requisições condicionais. Na nossa página de teste, esse pipeline transformou 21.044 tokens de HTML em 19 chunks limpos a partir de um Markdown de 4.405 tokens, com um script curto o bastante para ser lido de uma vez. Se você prefere receber Markdown a montar o pipeline, a nossa Web Scraping API, um serviço gerenciado de extração de páginas disponível pela equipe de vendas, está descrita na página de extração de dados.