Você precisa de um navegador de verdade a partir do Node.js: a página que você quer ler monta o conteúdo com JavaScript, ou um relatório HTML precisa virar PDF. Dois nomes aparecem primeiro, Puppeteer e Playwright. Os dois são gratuitos e as APIs se parecem (page.goto(), page.click(), page.pdf()), então não é a sintaxe que decide. A escolha depende dos navegadores e das linguagens de que você precisa, de como o proxy é configurado e do que você espera das ferramentas de teste e de agentes de IA.
Este artigo compara os dois em navegadores e protocolo, linguagens, espera, configuração de proxy, ferramentas de teste e servidores MCP. Rodamos o mesmo trabalho nos dois, com Puppeteer 25.12.0 (Chrome for Testing 154) e Playwright 1.63.0 (Chromium 153) no Node.js 24 e no Windows 11, por um proxy local que pede usuário e senha. Qual ferramenta os sites notam menos não é assunto deste artigo: as duas controlam um navegador real e, em qualquer uma delas, seguir as regras do site é tarefa sua.
O que são Puppeteer e Playwright?
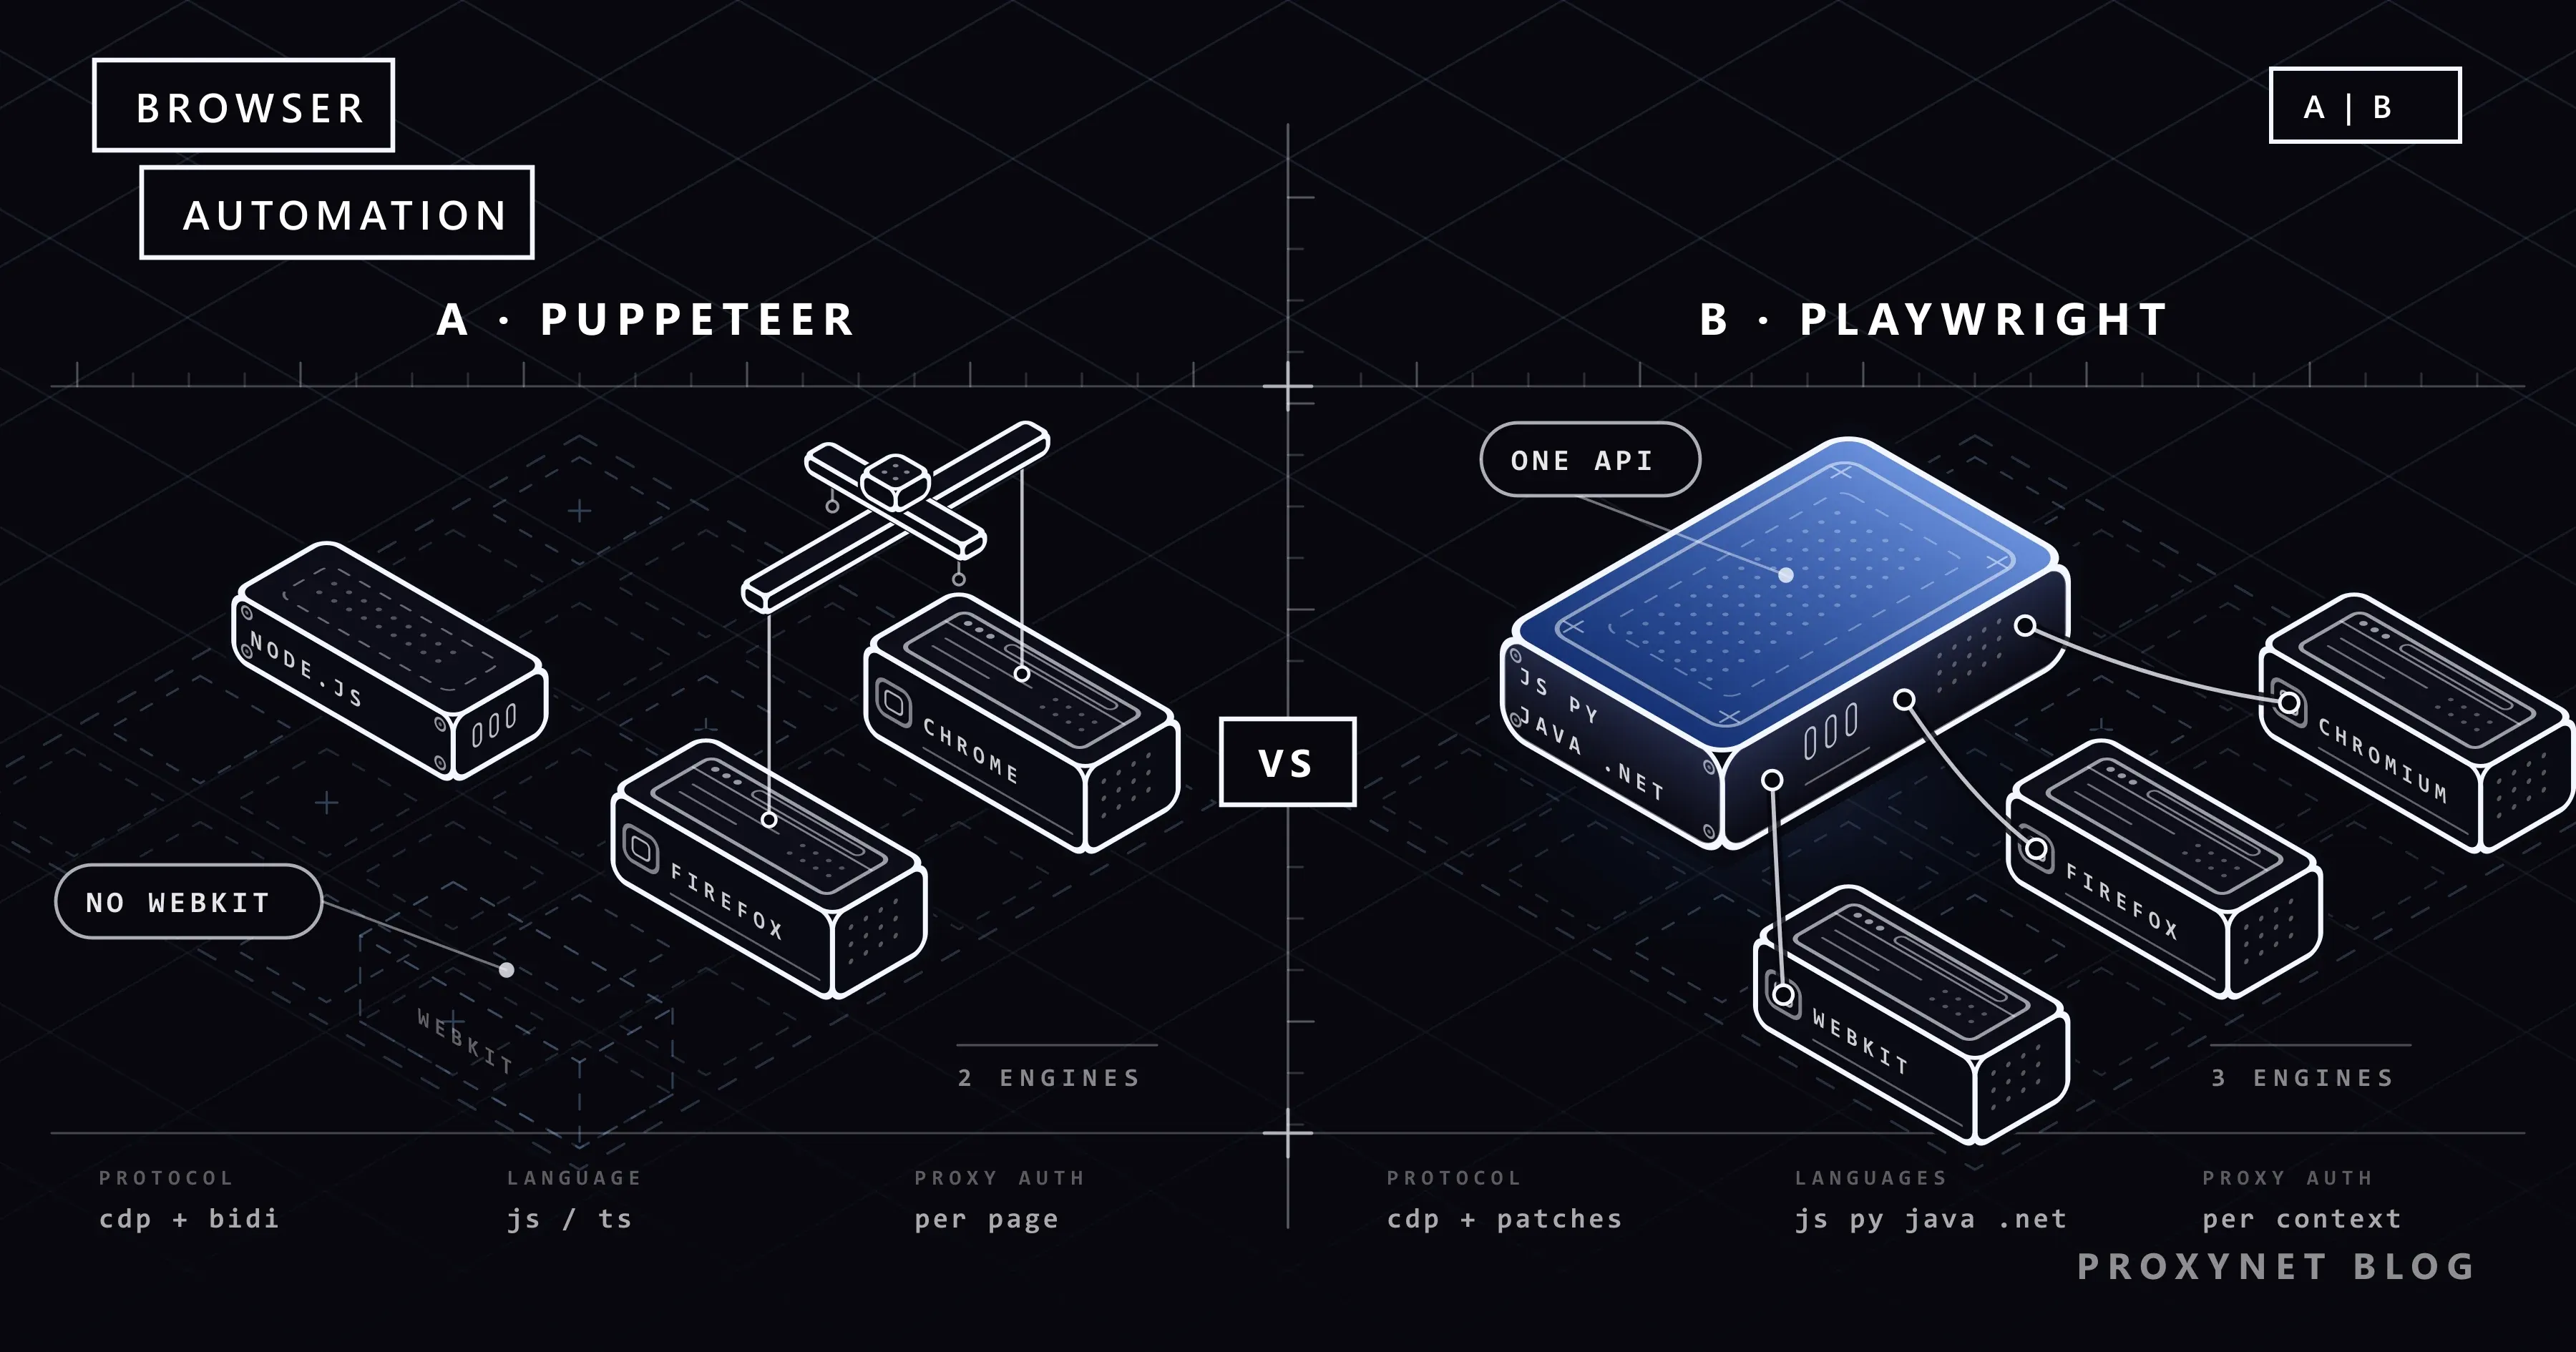
O Puppeteer é uma biblioteca JavaScript com uma API de alto nível para controlar o Chrome ou o Firefox. Ele roda no Node.js e não tem biblioteca oficial em outra linguagem; existem versões para Python, mas são projetos de terceiros. O npm i puppeteer também baixa uma compilação compatível do Chrome for Testing e o binário menor chrome-headless-shell para ~/.cache/puppeteer, enquanto o puppeteer-core é a mesma biblioteca sem esse download.
O Playwright é a biblioteca de automação de código aberto da Microsoft. Ele controla Chromium, Firefox e WebKit, o motor por trás do Safari, com uma única API, e tem bibliotecas oficiais para JavaScript e TypeScript, Python, Java e .NET. Ao lado dele fica o Playwright Test, um executor de testes com asserções e execuções em paralelo. Os navegadores são um passo à parte: npx playwright install chromium baixa a compilação presa à sua versão do Playwright.
Os dois servem para páginas cujo conteúdo só aparece depois que o JavaScript roda. Se o dado já está no código-fonte da página ou em um endpoint JSON, um cliente HTTP simples precisa de muito menos memória.
Como eles conversam com o navegador?
O protocolo por baixo de cada ferramenta explica a maior parte do comportamento dela. Um script do Puppeteer roda assim:
puppeteer.launch()inicia o Chrome for Testing a partir do cache, ou o Firefox se você passarbrowser: "firefox".- O Puppeteer se conecta pelo Chrome DevTools Protocol (CDP), o protocolo de depuração do próprio Chrome, ou pelo WebDriver BiDi, o padrão do W3C para automação bidirecional de navegadores.
- Cada chamada como
page.goto()vira uma série de mensagens do protocolo. - Os eventos voltam sem você pedir: requisições, respostas, mensagens de console, diálogos.
A página de WebDriver BiDi do Puppeteer explica a divisão: o BiDi é o padrão para o Firefox, enquanto o Chrome continua no CDP porque nem todo recurso do CDP existe ainda no BiDi. Desde a versão 23, o Puppeteer trabalha com a versão estável do Firefox, e não com uma compilação especial.
O Playwright também fala CDP com o Chromium. Para Firefox e WebKit ele traz compilações com patch, e a documentação dele afirma que ele não funciona com o Firefox nem com o Safari de marca, porque depende desses patches; o Google Chrome e o Microsoft Edge ficam disponíveis pela opção channel. Em Python, Java e .NET, cada chamada passa por um driver Node.js embutido no pacote, então o lado do navegador se comporta igual em todas as linguagens. Para automatizar o Firefox que seus usuários instalam, o Puppeteer está mais perto; WebKit, só o Playwright tem.
Puppeteer vs Playwright: tabela comparativa
| Puppeteer | Playwright | |
|---|---|---|
| Navegadores | Chrome, Firefox estável | Chromium, Firefox com patch, WebKit; Chrome e Edge via channel |
| Protocolo | CDP para o Chrome, WebDriver BiDi para o Firefox | CDP para o Chromium; Firefox e WebKit por compilações com patch |
| Linguagens oficiais | JavaScript e TypeScript | JavaScript e TypeScript, Python, Java, .NET |
| Espera | Os locators esperam antes das ações | Os locators esperam antes das ações; as asserções de teste tentam de novo |
| Executor de testes | Nenhum embutido | Playwright Test |
| Gravação | Exportação do Recorder do Chrome DevTools | playwright codegen |
| Rever uma execução | Trace de desempenho para o DevTools | Trace Viewer |
| Proxy por navegador | Argumento de inicialização --proxy-server | proxy em launch() |
| Proxy por contexto | proxyServer em createBrowserContext() | proxy em newContext() |
| Usuário e senha do proxy | page.authenticate() em uma página, em cache por contexto | Campos username e password |
| Servidor MCP | Chrome DevTools MCP (construído sobre o Puppeteer) | Playwright MCP |
Como fica o mesmo trabalho nas duas ferramentas?
Nossa página de teste, shop.test, é uma pequena página local que imprime seis cartões de produto com JavaScript um segundo e meio depois de carregar e então mostra um link "Next". O trabalho: abri-la por um proxy que exige usuário e senha, ler os nomes dos produtos, clicar em "Next" e confirmar o novo endereço. No seu próprio código, coloque o seu alvo no lugar de shop.test.
Com o Puppeteer:
import puppeteer from "puppeteer";

const URL = "http://shop.test/"; // nossa página de teste local; coloque aqui o seu alvo

const browser = await puppeteer.launch({
  args: ["--proxy-server=http://pr.proxynet.io:8000"],
});
try {
  const page = await browser.newPage();
  await page.authenticate({ username: "user", password: "pass" });
  const response = await page.goto(URL);
  console.log("status:", response.status());
  await page.waitForSelector("div.product"); // a lista é desenhada pelo JavaScript
  const names = await page.$$eval("div.product h2", (els) => els.map((el) => el.textContent));
  console.log(names.length, "products, first:", names[0]);
  await Promise.all([
    page.waitForNavigation(),
    page.locator("a.next").click(), // o locator espera até o link poder ser clicado
  ]);
  console.log(page.url());
} finally {
  await browser.close();
}
Com o Playwright:
import { chromium } from "playwright";

const URL = "http://shop.test/"; // nossa página de teste local; coloque aqui o seu alvo

const browser = await chromium.launch({
  proxy: { server: "http://pr.proxynet.io:8000", username: "user", password: "pass" },
});
try {
  const page = await browser.newPage();
  const response = await page.goto(URL);
  console.log("status:", response.status());
  const products = page.locator("div.product h2");
  await products.first().waitFor(); // count() e allTextContents() não esperam
  const names = await products.allTextContents();
  console.log(names.length, "products, first:", names[0]);
  await page.getByRole("link", { name: "Next" }).click(); // espera sozinho
  await page.waitForURL("**/page/2/");
  console.log(page.url());
} finally {
  await browser.close();
}
Os dois scripts imprimiram as mesmas três linhas pelo nosso proxy de teste local:
status: 200
6 products, first: Desk lamp
http://shop.test/page/2/
O Puppeteer recebe o endereço do proxy como argumento do Chrome e as credenciais numa chamada separada; o Playwright recebe os três dados num único objeto. O Puppeteer junta o clique com page.waitForNavigation() para que a URL não seja lida cedo demais, enquanto o Playwright encontra o link pelo nome acessível e espera o padrão da URL.
O registro do proxy mostrou mais uma diferença. O modo headless padrão do Puppeteer roda a compilação completa do Chrome for Testing, que também mandou requisições para serviços do Google (update.googleapis.com, accounts.google.com e outros) pelo proxy. Com headless: "shell", o binário mais leve chrome-headless-shell, elas sumiram; o headless shell que o Playwright usa por padrão mandou só as requisições da própria página. Se você paga o tráfego por gigabyte, como nos Proxies residenciais, vale conferir esse tráfego de fundo no seu painel.
Como funciona a espera automática em cada um?
A maioria dos erros em páginas dinâmicas vem do tempo: o código procura um elemento que o JavaScript ainda não desenhou. Nas ações, as duas ferramentas lidam com isso de forma parecida.
No Puppeteer o caminho recomendado é o locator. Antes de um clique, o locator garante que o elemento está na viewport, visível, habilitado e com uma caixa delimitadora estável ao longo de dois quadros de animação; se isso não acontecer dentro do tempo limite da página, ele lança um TimeoutError. O código antigo baseado em page.$() e page.click(selector) não espera o elemento aparecer, por isso esse estilo chama page.waitForSelector() antes.
O Playwright verifica se o elemento está visível, estável, apto a receber eventos e habilitado. Ele acrescenta duas coisas: locators que encontram um elemento por papel, rótulo ou texto, e que sobrevivem a uma classe CSS renomeada, e, no Playwright Test, asserções como expect(locator).toHaveText() que tentam de novo até a condição ser satisfeita.
Nenhum dos dois espera quando você lê uma lista: page.$$eval() e allTextContents() devolvem o que está na página naquele momento. É por isso que os dois scripts esperam o primeiro produto.
Como diferem as configurações de proxy?
No trabalho de scraping, é aqui que as duas ferramentas mais se separam.
No Puppeteer o argumento --proxy-server vale para o navegador inteiro. Para um proxy separado por sessão, a referência de BrowserContextOptions descreve proxyServer e proxyBypassList e deixa o usuário e a senha para o Page.authenticate:
const context = await browser.createBrowserContext({
  proxyServer: "http://pr.proxynet.io:8000",
});
const page = await context.newPage();
await page.authenticate({ username: "user", password: "pass" }); // o Chrome guarda as credenciais por contexto
A referência acrescenta que o page.authenticate() liga a interceptação de requisições (request interception) por baixo dos panos, o que pode afetar o desempenho. A chamada é feita em uma página, mas o Chrome guarda as credenciais em cache para o contexto de navegador inteiro: nos nossos testes, um contexto em que nenhuma página tinha feito a chamada falhou com net::ERR_INVALID_AUTH_CREDENTIALS, enquanto as páginas seguintes de um contexto já autenticado passaram. Sessões e a verificação do IP de saída estão no nosso guia de configuração de proxy no Puppeteer.
No Playwright o objeto proxy vai em launch() para o navegador inteiro ou em newContext() para um contexto, com o usuário e a senha como campos:
const context = await browser.newContext({
  proxy: { server: "http://pr.proxynet.io:8000", username: "user", password: "pass" },
});
O guia de rede do Playwright mostra as duas formas e aceita servidores HTTP(S) e SOCKSv5. Como cada contexto leva as próprias credenciais, não existe uma chamada por página para esquecer.
Um comportamento que vale conhecer: quando deixamos as credenciais de fora, o Playwright não lançou erro nenhum e o page.goto() devolveu uma resposta com status 407. Confira o response.status() em vez de tomar um goto silencioso como prova de que a página carregou. A configuração completa está em O que é Playwright e como usá-lo com proxy.
Três regras do Chromium valem para as duas ferramentas. O documento de proxy do Chromium diz que o Chrome não suporta nenhum método de autenticação para SOCKS5, então SOCKS5 com senha não funciona no Chromium em nenhuma das duas; use uma whitelist de IP, que no nosso serviço aceita até 10 endereços. O Chrome também recusa credenciais escritas no endereço do proxy: no nosso teste com o Puppeteer, user:pass@ em --proxy-server fez o Chrome 154 falhar com net::ERR_NO_SUPPORTED_PROXIES, então isso não é atalho. E o Chrome ignora o proxy para endereços de loopback, os da própria máquina: no nosso teste o Puppeteer abriu 127.0.0.1 direto, enquanto o Playwright mandou a requisição pelo proxy, e com --proxy-bypass-list=<-loopback> o Puppeteer também usou o proxy.
Se cada contexto deve sair por um IP diferente, você não precisa de uma lista de endereços no código. Um único gateway com os Proxies rotativos troca o IP de saída por você, e uma sessão fixa mantém um IP de 1 a 60 minutos.
Qual servidor MCP escolher: Playwright MCP ou Chrome DevTools MCP?
Essa comparação aparece muito hoje quando alguém quer dar um navegador a um assistente de programação com IA, como o Claude Code ou o Cursor. O MCP (Model Context Protocol) é a forma padrão de esses assistentes chamarem ferramentas externas, e cada biblioteca tem um servidor construído sobre ele.
O Playwright MCP é o servidor da Microsoft. Ele entrega a página ao modelo como texto da árvore de acessibilidade, e não como capturas de tela, inicia com npx @playwright/mcp@latest e aceita as flags --proxy-server e --proxy-bypass. O README dele observa que, para agentes de programação, um caminho pela linha de comando gasta menos tokens, porque não carrega grandes esquemas de ferramentas no contexto do modelo. A instalação e as credenciais do proxy estão em O que é Playwright MCP?.
O Chrome DevTools MCP permite que um agente de programação controle e inspecione um Chrome em execução, usando o Puppeteer para as ações e o DevTools para os traces de desempenho; ele inicia com npx -y chrome-devtools-mcp@latest. Na versão 1.10.1, o --proxyServer é repassado ao Chrome como --proxy-server sem campo para credenciais, então a whitelist de IP é o caminho prático. Por padrão ele abre o Chrome estável instalado e envia estatísticas de uso ao Google, a menos que você acrescente --no-usage-statistics.
Para um agente que clica pelas páginas e preenche formulários, use o Playwright MCP; para um que lê erros de console, requisições de rede e traces de desempenho do seu próprio site, o Chrome DevTools MCP. Em qualquer caso, limite aonde o agente pode ir (--allowed-origins ou --allowedUrlPattern), mantenha senhas fora do prompt e aprove as ações que mudam alguma coisa.
Executor de testes, geração de código e traces
É aqui que a vantagem do Playwright é maior. O Playwright Test traz o executor, as asserções, as execuções em paralelo, as novas tentativas e um relatório HTML; o Python usa o plugin do pytest, e Java e .NET os frameworks de teste de costume. npx playwright codegen <url> escreve código enquanto você clica. O Trace Viewer (npx playwright show-trace trace.zip) reproduz uma execução gravada com snapshots do DOM, requisições de rede e mensagens de console numa linha do tempo, para você ver por que um trabalho da madrugada voltou vazio.
O Puppeteer deixa os testes por sua conta: combine-o com Jest, Mocha ou o executor de testes do Node.js. Para gravar, o painel Recorder (gravador) do Chrome DevTools exporta uma sessão como script do Puppeteer, como script do Puppeteer para Firefox ou como um script com análise do Lighthouse. page.tracing.start() grava um trace de desempenho do Chrome para o DevTools, que responde por que uma página está lenta, mas não é uma reprodução passo a passo do seu script.
Velocidade: por que não damos números
Números publicados do tipo "X por cento mais rápido" foram medidos na máquina e na página de outra pessoa. No Chromium as duas ferramentas falam CDP e, numa varredura por proxy, a maior parte do tempo vai para a rede e para o site de destino. Escolhas de configuração, como o Chrome completo contra o headless shell, pesam mais do que a biblioteca. Se você precisa de um número, meça no seu próprio alvo com o mesmo proxy e a mesma concorrência.
Casos de uso
- PDFs e capturas de tela a partir de um serviço Node.js: os dois têm
page.pdf(), e os dois geraram um PDF a partir do Chromium no nosso teste; o Puppeteer é a dependência mais leve. - Testes de ponta a ponta em vários motores: o Playwright Test roda o mesmo teste no Chromium, no Firefox e no WebKit.
- Coleta de dados em Python, Java ou .NET: Playwright, já que o Puppeteer é só para JavaScript.
- Automatizar a versão estável do Firefox: Puppeteer pelo WebDriver BiDi.
Seja qual for a ferramenta, siga o robots.txt e os termos de uso do site, use a API oficial quando houver uma e mantenha o ritmo de requisições num nível que o site aguente.
Erros comuns
- Abrir um contexto do Puppeteer sem
page.authenticate(). O Chrome guarda as credenciais em cache por contexto; um contexto em que nenhuma página fez a chamada falha comnet::ERR_INVALID_AUTH_CREDENTIALS. - Esperar que o Playwright lance erro quando o proxy pede credenciais. No nosso teste ele devolveu uma resposta 407; confira o
response.status(). - Escrever
user:pass@no endereço do proxy. O Chrome não pega credenciais do endereço; passe-as compage.authenticate()no Puppeteer ou pelos camposusernameepasswordno Playwright. - Usar SOCKS5 com senha no Chromium. O Chrome não tem autenticação SOCKS5; use uma whitelist de IP.
- Testar um proxy contra
localhostno Puppeteer. O Chrome ignora o proxy para endereços de loopback, a menos que você acrescente<-loopback>. - Esperar que o Firefox do Playwright seja o Firefox instalado. É uma compilação com patch, e o WebKit não é o Safari.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Um script Node.js que só precisa do Chrome | Qualquer um; o Puppeteer basta |
| Python, Java ou .NET | Playwright |
| Testes no motor WebKit | Playwright |
| Automatizar a versão estável do Firefox | Puppeteer |
| Credenciais do proxy definidas uma vez por contexto | Playwright |
| IPs separados por sessão em um navegador | Qualquer um, um contexto por sessão |
| Uma suíte de testes com asserções e relatórios | Playwright Test |
| Um agente que preenche formulários | Playwright MCP |
| Um agente que depura o desempenho no Chrome | Chrome DevTools MCP |
Perguntas frequentes
O Playwright é melhor que o Puppeteer?
Não em tudo. O Playwright cobre mais motores, linguagens e ferramentas de teste; o Puppeteer é menor e funciona com a versão estável do Firefox. Se um script do Puppeteer que já funciona faz o que você precisa, não há motivo para reescrevê-lo.
Posso usar o Puppeteer com Python?
Não oficialmente. A única biblioteca oficial do Puppeteer é para JavaScript e TypeScript no Node.js; existem versões para Python, mas são projetos de terceiros fora do repositório do Puppeteer. Para um pipeline em Python, o Playwright tem uma biblioteca oficial com os mesmos recursos de automação de navegador da versão Node.js.
O Puppeteer funciona com o Firefox?
Sim. Desde a versão 23 ele funciona com a versão estável do Firefox pelo WebDriver BiDi; você o inicia com browser: "firefox". O Firefox não é baixado com o pacote a menos que você o ative na configuração de download, e alguns recursos que só existem no CDP não estão disponíveis pelo BiDi.
É difícil migrar do Puppeteer para o Playwright?
Um script pequeno migra rápido, porque muitas chamadas têm o mesmo nome: goto, click, evaluate, pdf. O trabalho fica em três pontos: as credenciais do proxy passam para o objeto proxy, os pares com waitForNavigation() dão lugar a waitForURL() e aos locators, e os contextos de navegador viram a unidade de isolamento.
Qual devo usar com o Claude Code ou outro agente de IA?
Depende da tarefa. O Playwright MCP foi feito para controlar páginas pela árvore de acessibilidade; o Chrome DevTools MCP, construído sobre o Puppeteer, é mais forte na inspeção de mensagens de console, requisições de rede e traces de desempenho. Você pode instalar os dois e dar a cada tarefa só o servidor de que ela precisa.
Alguma das duas ferramentas usa proxy SOCKS5 com usuário e senha?
No Chromium não, porque o Chrome não suporta autenticação SOCKS5. Use SOCKS5 com uma whitelist de IP, ou um proxy HTTP com usuário e senha. O Gerador de endpoints do nosso painel mostra a porta SOCKS5 de cada produto.
Em resumo
Puppeteer e Playwright controlam o mesmo Chromium de um jeito muito parecido; a diferença está no que fica em volta. O Puppeteer é uma biblioteca de Node.js para o Chrome e o Firefox estável; as credenciais do proxy passam pelo page.authenticate() e o Chrome as guarda em cache por contexto de navegador. O Playwright soma WebKit, mais três linguagens oficiais, um executor de testes com traces e uma opção proxy que leva as credenciais por contexto. Para um trabalho em Node.js só com Chrome, o Puppeteer basta; para várias linguagens, motores ou uma suíte de testes, o Playwright se encaixa melhor. Os tipos de proxy que funcionam com os dois estão nos nossos serviços de proxy.