


































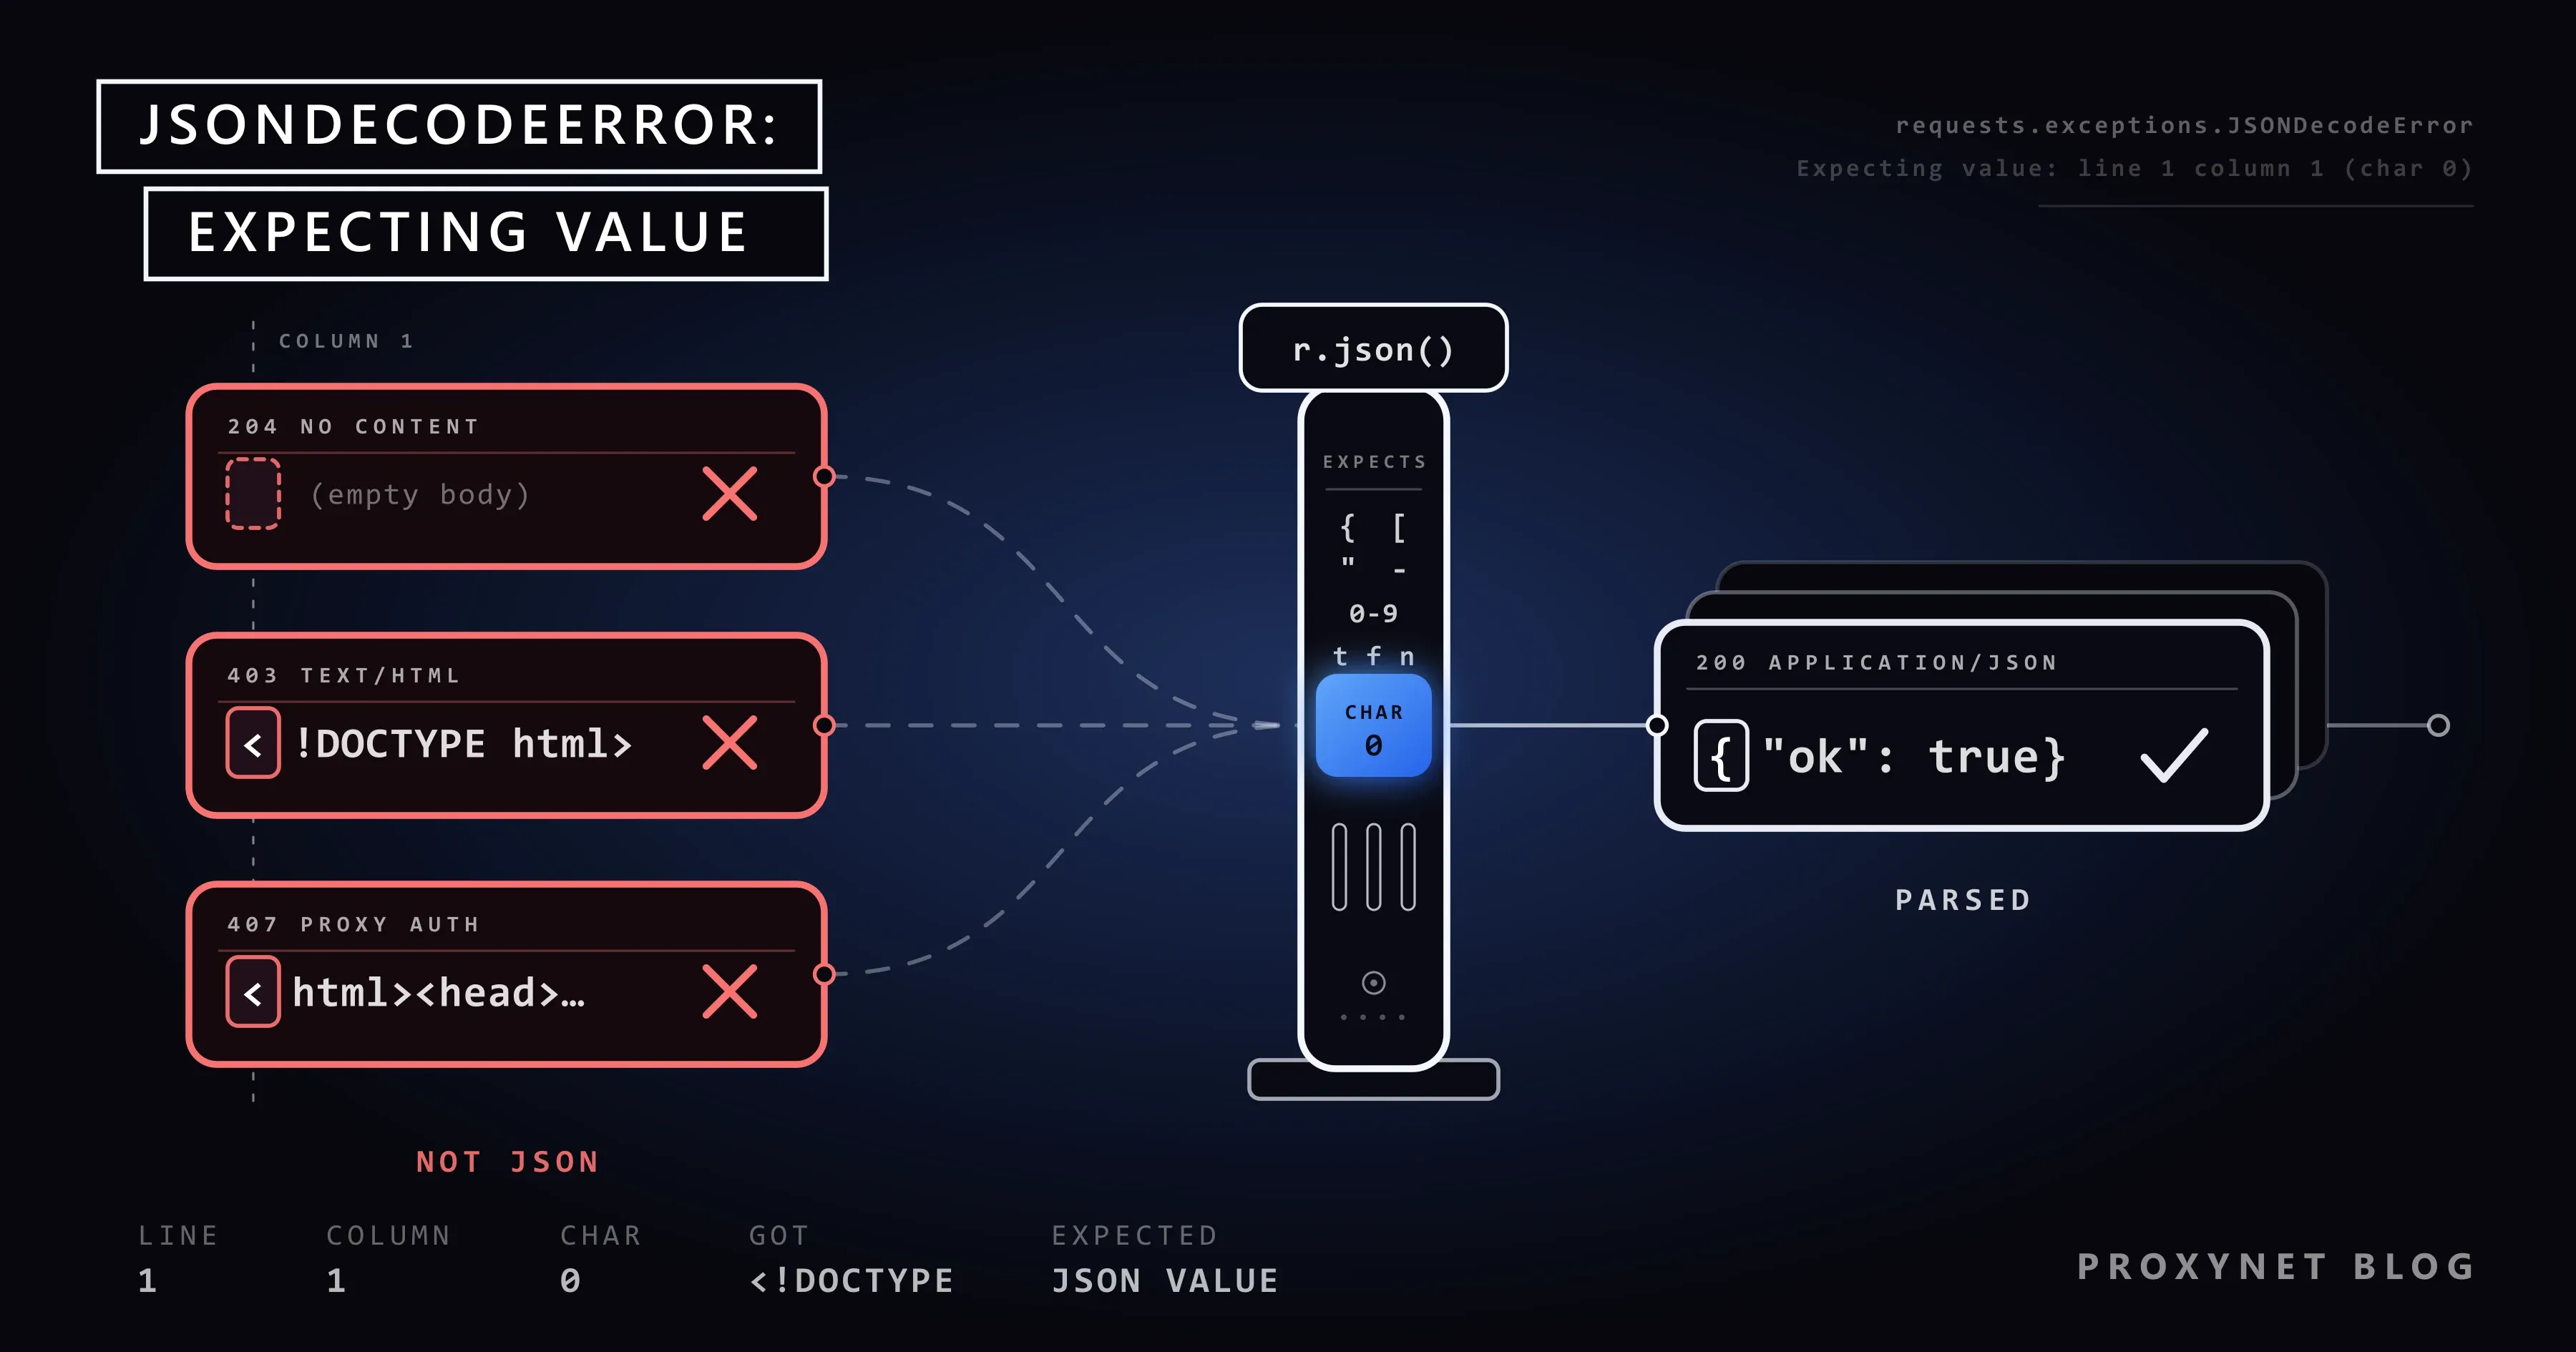
Recoges la lista de productos de una tienda desde /api/products?page=1, una dirección que encontraste en la pestaña Red (Network) del navegador. El script recorre las primeras 300 páginas y luego se detiene en data = r.json() con requests.exceptions.JSONDecodeError: Expecting value: line 1 column 1 (char 0). Misma dirección, mismo código. Añades una línea, print(r.status_code, r.headers.get("Content-Type"), r.text[:200]), y el panorama cambia: 403, text/html y una página que empieza por <!DOCTYPE html>. El servidor envió una página web en lugar de JSON, y el parser se rindió en el primer carácter, <.
Esta guía explica qué significan el mensaje y su posición, qué excepción lanza cada biblioteca de Python y una comprobación de tres líneas que encuentra la causa. Después repasa las respuestas vacías, las páginas HTML, la respuesta 407 de un proxy y los cuerpos que solo parecen JSON, y termina con una función auxiliar parse_json() probada.
¿Qué significa JSONDecodeError: Expecting value?
Significa que el parser esperaba el comienzo de un valor JSON y encontró otra cosa. Un texto JSON es un único valor, tal como lo define RFC 8259: un objeto, un array, una cadena entre comillas dobles, un número, true, false o null. Por eso un texto válido solo puede empezar por {, [, ", un dígito, -, t, f o n, tras espacios en blanco opcionales. Cuando el parser se topa con el < de una página HTML, la T de Too Many Requests o el final de una cadena vacía, se detiene con «Expecting value».
No es un error de conexión. Una petición que nunca llegó al servidor falla antes, dentro de requests.get(), con errores como ConnectionError o ProxyError (Max Retries Exceeded With URL). Cuando ves JSONDecodeError, sí llegó una respuesta; lo que no se pudo leer como JSON es su contenido.
¿Qué te dice «line 1 column 1 (char 0)»?
Los números señalan dónde falló el análisis. json.JSONDecodeError los lleva como atributos: msg (el motivo), doc (el texto completo), pos (el índice del carácter que falla), lineno y colno (documentación de json en Python). char 0 es el primer carácter del cuerpo, así que ningún JSON llegó a empezar.
Otras posiciones dicen más:
line 1 column 4 (char 3): el cuerpo eran tres espacios y nada más. Los espacios en blanco se saltan y luego el texto termina.line 2 column 1 (char 1): el cuerpo empieza con un salto de línea seguido de algo que no es JSON, a menudo una página HTML.- Una posición muy dentro del texto: el JSON sí empezó, pero se rompió más adelante, por ejemplo en una descarga cortada.
Dentro de un bloque except, e.doc[:200] muestra el comienzo de ese texto.
¿Qué excepción lanzan requests, json, httpx y aiohttp?
Comprobamos cada biblioteca con Python 3.13, Requests 2.34.2, HTTPX 0.28.1 y AIOHTTP 3.14.3:
- json:
json.loads()lanzajson.JSONDecodeError, una subclase deValueError. - Requests: desde la versión 2.27.0 (enero de 2022),
r.json()lanzarequests.exceptions.JSONDecodeError. Según el historial de cambios de Requests, hereda de las excepciones que se lanzaban antes y además es unaRequestException. - Requests con simplejson instalado: la clase padre pasa a ser
simplejson.errors.JSONDecodeError. En nuestra prueba,except json.JSONDecodeErrorno la capturó;except ValueErrorsí. - HTTPX:
Response.json()lanza eljson.decoder.JSONDecodeErrorestándar. - AIOHTTP:
await resp.json()comprueba primero el Content-Type y lanzaContentTypeError(Attempt to decode JSON with unexpected mimetype: text/html) sin analizar nada. Concontent_type=Nonelanzajson.JSONDecodeError.
Con Requests, captura requests.exceptions.JSONDecodeError: funciona en los dos casos. Las demás diferencias entre clientes están en HTTPX, Requests y AIOHTTP.
¿Cómo encontrar la causa en tres líneas?
Imprime lo que llegó antes de analizarlo:
print(r.status_code, r.history, r.url)
print(r.headers.get("Content-Type"), len(r.content))
print(r.text[:200])
Luego lee la salida en este orden:
- Estado e historial. ¿El estado es
2xx? ¿Hubo un301o un302por el camino? Tras una redirección,r.status_codemuestra el200final, y solor.historymuestra[<Response [302]>]. - URL final.
r.urles la dirección después de las redirecciones. Si termina en/logino/consent, no llegaste a la API. - Content-Type. Buscas
application/jsono un tipo que termine en+json. Cualquier otra cosa apunta a una de las causas de abajo. - Longitud y primeros caracteres.
0significa vacío,<significa HTML,{'un dict de Python impreso como texto,cb(JSONP. - Busca el resultado en la tabla de abajo.
Registra solo los primeros 200 caracteres: un cuerpo completo puede contener tokens o datos personales.
¿Qué te dicen los primeros caracteres del cuerpo?
Todos los mensajes de abajo salen de nuestra ejecución con Python 3.13.9 y Requests 2.34.2 contra un servidor de prueba local; otras versiones de Python pueden redactarlos de otra forma.
| Comienzo del cuerpo | Estado y Content-Type habituales | Mensaje de r.json() | Causa probable | Qué hacer |
|---|---|---|---|---|
| (nada) | 204, 304, HEAD o un 200 vacío | Expecting value: line 1 column 1 (char 0) | El endpoint no devuelve contenido | Comprueba el estado y len(r.content) antes de analizar |
<!DOCTYPE html> | 403, 429, 503, o 200 tras un 302; text/html | Expecting value: line 1 column 1 (char 0) | Página de bloqueo, redirección al inicio de sesión, página de error | Corrige primero el estado |
<html>...407... o nada | 407 y Proxy-Authenticate, destino http:// | Expecting value: line 1 column 1 (char 0) | Credenciales o IP del proxy incorrectas | Revisa user:pass y la lista de IP autorizadas |
Too Many Requests | 429, text/plain | Expecting value: line 1 column 1 (char 0) | Un límite de peticiones en texto plano | Reduce el ritmo; lee Retry-After |
cb({"items": ...}); | 200, application/javascript | Expecting value: line 1 column 1 (char 0) | JSONP | Usa el endpoint sin callback |
{"id":1}, un salto de línea y {"id":2} | 200, application/x-ndjson | Extra data: line 2 column 1 (char 9) | NDJSON | Analiza línea por línea |
{'id': 1, ...} | 200, a menudo text/plain | Expecting property name enclosed in double quotes: line 1 column 2 (char 1) | Un dict escrito con str() | json.dumps() en el código que genera los datos |
Un BOM invisible y luego { | 200, application/json | Unexpected UTF-8 BOM (decode using utf-8-sig): line 1 column 1 (char 0) | Una marca de orden de bytes | Decodifica con utf-8-sig |
Las cinco primeras filas comparten el mismo mensaje, así que el mensaje por sí solo nunca nombra la causa; el estado y el Content-Type sí.
Respuestas vacías: 204, HEAD y 304
Algunas respuestas no tienen cuerpo por definición. RFC 9110 establece que una respuesta 204 No Content no puede llevar contenido, que un 304 Not Modified tampoco lo lleva y que la respuesta a una petición HEAD solo trae cabeceras. Muchas API responden a DELETE y PUT con 204: la acción salió bien y no hay nada que analizar, pero r.json() lanza Expecting value.
Trata estas respuestas como «sin datos», no como errores, y comprueba r.status_code antes de analizar. Un 200 vacío es distinto: suele indicar un fallo del servidor o un endpoint equivocado, y merece una línea en el log.
HTML en lugar de JSON: páginas de bloqueo, de inicio de sesión y de error
Donde se esperaba JSON llegan tres tipos de página HTML, y el código de estado las distingue.
Una página de bloqueo o de verificación. Un 403, 429 o 503 con text/html suele ser la respuesta de una protección contra bots. Su <title>, como «Just a moment...» o «Access denied», basta para reconocerla. No la analices ni la reintentes en bucle. Qué significa cada código lo explicamos en Códigos de estado HTTP en web scraping, las páginas de Cloudflare en Cloudflare y scraping y la puntuación de bots en Cómo funciona la detección de bots. Las vías legítimas son una API oficial, un ritmo más bajo que respete robots.txt o el permiso del propietario.
Una página de inicio de sesión tras una redirección. El estado es 200, así que este caso se pasa por alto con facilidad. r.history muestra [<Response [302]>] y r.url termina en /login: tu sesión caducó. Si se trata de tu propia cuenta, la solución es gestionar la sesión (Sesiones y cookies en Python).
Una página de error del servidor. Un 500, 502 o 504 con HTML viene del servidor o de una pasarela que tiene delante: la que tiene problemas es la API, no tu parser.
También llega HTML cuando la URL apunta a la página y no a la API. El JSON viene de una petición aparte que hace la página, y esa petición la encuentras en la pestaña Red (encontrar primero la petición a la API).
A través de un proxy: la respuesta 407
Envía una petición http:// normal a través de un proxy con una contraseña incorrecta y el propio proxy responde 407 Proxy Authentication Required. Requests entrega esa respuesta a tu código como una respuesta normal, con el cuerpo que envíe el proxy: una página HTML, un texto corto o nada. Con dos proxies de prueba locales, uno que enviaba HTML y otro un cuerpo vacío, r.json() dio Expecting value las dos veces.
Con un destino https://, el 407 llega mientras se establece el túnel, así que requests.get() lanza ProxyError: Tunnel connection failed: 407 y nunca se llega a r.json() (Max Retries Exceeded With URL).
Un 407 con una cabecera Proxy-Authenticate apunta al proxy, no al destino. Revisa el usuario y la contraseña, codifica los caracteres especiales en la URL del proxy (@ pasa a ser %40) o confirma que tu IP está en la lista de IP autorizadas (Autenticación de proxy).
Cuerpos que parecen JSON pero no lo son: JSONP, NDJSON y comillas simples
Algunos cuerpos contienen JSON, pero no como un único valor limpio.
JSONP
JSONP envuelve el JSON en una llamada a función, cb({"items": [1]});, que suele enviarse como application/javascript. El parser ve la c e informa Expecting value en char 0. Usa el endpoint sin su parámetro callback, o toma el texto entre el primer ( y el último ).
NDJSON y JSON Lines
Los endpoints de exportación y de streaming suelen enviar un valor JSON por línea, un formato descrito en jsonlines.org. La primera línea se analiza sin problema, luego el parser encuentra más texto y se detiene con Extra data: line 2 column 1. Lee esos cuerpos línea por línea con r.iter_lines().
Comillas simples y valores de Python
Un cuerpo como {'id': 1} se escribió con str() de Python en lugar de json.dumps(), y el parser se detiene en char 1 con Expecting property name enclosed in double quotes. Un cuerpo None o True, tal como los escribe Python, falla con Expecting value, porque JSON escribe null y true. Corrige el código que escribe los datos: text.replace("'", '"') rompe cualquier valor que lleve un apóstrofo, y ast.literal_eval() solo es seguro con datos que generaste tú.
Una marca de orden de bytes al principio da Unexpected UTF-8 BOM; la parte de codificación está en errores de codificación Unicode en Python.
Ejemplo completo: parse_json(), que comprueba el cuerpo antes de leer JSON
La función auxiliar lleva la comprobación de tres líneas al código. Devuelve los datos analizados, None para las respuestas que por definición no tienen cuerpo, o lanza un único error NotJSON que nombra el estado, las redirecciones, el Content-Type, la URL final y el comienzo del cuerpo. Instala Requests con pip install requests.
"""Lee una respuesta JSON o explica en una línea por qué el cuerpo no es JSON."""
import json

import requests

PROXY = "http://user:pass@pr.proxynet.io:8000"
PROXIES = {"http": PROXY, "https": PROXY}


class NotJSON(ValueError):
    """El servidor respondió, pero no con el JSON que pedimos."""


def describe(r):
    """Estado, redirecciones, Content-Type, URL final y los primeros 200 caracteres."""
    hops = "".join(f"{h.status_code} -> " for h in r.history)
    ctype = r.headers.get("Content-Type", "none")
    start = r.text[:200].replace("\n", " ")
    return f"HTTP {hops}{r.status_code}, {ctype}, {r.url}, body {start!r}"


def media_type(r):
    return r.headers.get("Content-Type", "").split(";")[0].strip().lower()


def is_json_type(mtype):
    return mtype == "application/json" or mtype.endswith("+json")


def parse_json(r):
    """Devuelve el cuerpo analizado, None si no hay contenido, o lanza NotJSON con el motivo."""
    if r.status_code in (204, 304) or r.request.method == "HEAD":
        return None  # estas respuestas no llevan cuerpo por definición
    mtype = media_type(r)
    if not r.ok and not is_json_type(mtype):
        raise NotJSON(f"error response, not JSON: {describe(r)}")
    if not r.content:
        raise NotJSON(f"empty body: {describe(r)}")
    if mtype == "application/x-ndjson":
        return [json.loads(line) for line in r.iter_lines() if line.strip()]
    if r.text.lstrip().startswith("<"):
        raise NotJSON(f"HTML instead of JSON: {describe(r)}")
    try:
        return r.json()
    except requests.exceptions.JSONDecodeError as e:
        raise NotJSON(f"{e.msg} at char {e.pos}: {describe(r)}") from e


if __name__ == "__main__":
    url = "https://example.com/api/products?page=1"
    r = requests.get(url, proxies=PROXIES, timeout=(5, 30))
    try:
        data = parse_json(r)
    except NotJSON as e:
        print("stop:", e)
    else:
        if not r.ok:
            print("API error:", r.status_code, data)
        elif data is None:
            print("no content")
        else:
            print("ok:", type(data).__name__, len(data))
Un estado de error con un cuerpo que no es JSON se detiene primero, así que una página 403 o el 407 de un proxy nunca se analizan. Un estado de error con un cuerpo JSON, como un 400 con {"error": ...}, se devuelve, porque muchas API explican así sus errores; quien llama a la función comprueba r.ok. PROXIES es opcional, y timeout=(5, 30) da 5 segundos a la conexión y 30 a la respuesta.
La función auxiliar no reintenta, no rota IP ni trabaja en paralelo, y es a propósito. Qué estados merecen un reintento lo explicamos en Códigos de estado HTTP en web scraping, la rotación en Cómo rotar proxies en Python y las peticiones en paralelo en Concurrencia y paralelismo.
Cómo se ve la salida
Ejecutamos parse_json() contra un servidor de prueba local que responde a cada ruta con uno de los cuerpos de la tabla; la última línea pasó por un proxy de prueba que respondía 407 con HTML.
/api/products -> {'items': [1, 2, 3]}
/api/items/7 -> None
/api/empty -> NotJSON: empty body: HTTP 200, application/json, http://127.0.0.1:8111/api/empty, body ''
/api/blocked -> NotJSON: error response, not JSON: HTTP 403, text/html; charset=utf-8, http://127.0.0.1:8111/api/blocked, body '<!DOCTYPE html><html><head><title>Just a moment...</title></head></html>'
/api/private -> NotJSON: HTML instead of JSON: HTTP 302 -> 200, text/html; charset=utf-8, http://127.0.0.1:8111/login, body '<!DOCTYPE html> <html><head><title>Sign in</title></head></html>'
/api/slow -> NotJSON: error response, not JSON: HTTP 429, text/plain, http://127.0.0.1:8111/api/slow, body 'Too Many Requests'
/api/jsonp -> NotJSON: Expecting value at char 0: HTTP 200, application/javascript, http://127.0.0.1:8111/api/jsonp, body 'cb({"items": [1]});'
/api/export -> [{'id': 1}, {'id': 2}]
/api/dict -> NotJSON: Expecting property name enclosed in double quotes at char 1: HTTP 200, text/plain, http://127.0.0.1:8111/api/dict, body "{'id': 1, 'name': 'Lamp'}"
/api/bad-request -> {'error': 'page must be a number'} (status 400)
proxy, wrong password -> NotJSON: error response, not JSON: HTTP 407, text/html, http://example.com/api/products, body '<html><head><title>407 Proxy Authentication Required</title></head><body><h1>407</h1></body></html>'
/api/items/7 respondió 204 y /api/export envió NDJSON, así que ninguno de los dos es un error. La línea de /api/private muestra la redirección que se le escapa a una comprobación de estado: 302 -> 200, que termina en /login.
Casos de uso: ¿qué scripts que esperan JSON se topan con este error?
- Llamar a la API propia de un sitio: la petición que copiaste de la pestaña Red deja de funcionar cuando caduca la sesión o el token que hay detrás (páginas estáticas y dinámicas).
- Seguimiento de precios: un trabajo diario que lee el JSON de los productos recibe una página de bloqueo el día que va demasiado rápido (seguimiento de precios de la competencia).
- Paginación de API: la página siguiente a la última puede devolver
204o un cuerpo vacío en lugar de una lista vacía (paginación en web scraping). - Herramientas de automatización: un nodo HTTP Request de n8n espera JSON y recibe una página de error HTML (configurar un proxy en n8n).
- Pipelines de datos: una respuesta HTML entre miles de respuestas JSON debería detener un lote, no acabar en la base de datos (extracción de datos).
- Rastreadores: un rastreador que lee endpoints JSON en muchos hosts necesita un mensaje claro por cada host que falla (rastreador web).
Errores comunes
- Tragarse el error.
except JSONDecodeError: passno guarda nada y oculta la causa. - Fiarse del estado 200. Una página de inicio de sesión tras un
302también llega como200. Compruebar.historyyr.url. - Cambiar comillas simples por dobles con
replace(). Rompe cualquier valor que contenga un apóstrofo. - Usar
eval()sobre el cuerpo de una respuesta. Ejecuta cualquier código que haya enviado el servidor. - Reintentar una página de bloqueo al mismo ritmo. Las mismas peticiones al mismo ritmo reciben el mismo
429o403; baja primero el ritmo (429 Too Many Requests). - Registrar el cuerpo entero. Los primeros 200 caracteres nombran la causa; el resto puede contener tokens y datos personales.
- Un solo
except RequestExceptionalrededor deget()y dejson(). Desde la 2.27.0 captura los dos, así que un error de red y un error de análisis se ven iguales. - Buscar el fallo en el módulo json. El parser tiene razón; el cuerpo no es JSON.
Guía de decisión
| Lo que ves | Qué hacer |
|---|---|
Estado 204, o el cuerpo está vacío | No llames a r.json(); trátalo como «sin datos» |
403, 429 o 503 con text/html | Deja de analizar y corrige el estado (Códigos de estado HTTP en web scraping) |
200, pero r.history muestra un 302 a una página de inicio de sesión | Renueva tu sesión (Sesiones y cookies en Python) |
407 con un cuerpo HTML o vacío | Revisa las credenciales del proxy y la lista de IP autorizadas |
ProxyError: Tunnel connection failed: 407 | La misma causa con destinos https:// (Max Retries Exceeded With URL) |
Extra data | Analiza línea por línea con r.iter_lines() |
El cuerpo empieza por callback( | Usa el endpoint sin callback o quita el envoltorio |
Unexpected UTF-8 BOM | Decodifica con utf-8-sig (errores de codificación Unicode en Python) |
Preguntas frecuentes
¿Por qué falla r.json() si el código de estado es 200?
Un 200 no dice nada sobre el formato del cuerpo. Una página de inicio de sesión tras una redirección, una respuesta JSONP o un cuerpo vacío pueden llegar con 200. Comprueba el Content-Type, r.history y el comienzo de r.text.
¿Qué diferencia hay entre requests.exceptions.JSONDecodeError y json.JSONDecodeError?
r.json() lanza requests.exceptions.JSONDecodeError desde Requests 2.27.0. Es una subclase del JSONDecodeError de la biblioteca JSON y de la propia RequestException de Requests, así que las dos la capturan. La salvedad es simplejson: si está instalado, except json.JSONDecodeError no captura el error, así que captura la clase de Requests.
¿Por qué recibo JSONDecodeError: Extra data?
El parser leyó un valor JSON completo y luego encontró más texto: normalmente NDJSON, o dos objetos escritos uno detrás de otro. Analiza línea por línea, o usa json.JSONDecoder().raw_decode() para leer un valor cada vez.
¿Qué significa «Expecting property name enclosed in double quotes»?
Una clave dentro de un objeto no está entre comillas dobles. La causa habitual es un dict de Python escrito con str(), que usa comillas simples. En Python 3.12 y anteriores, una coma final antes de } también da este mensaje; Python 3.13 lo informa como Illegal trailing comma before end of object.
Me sale este error en yfinance o spotdl. ¿Qué hago?
La biblioteca pidió JSON a un servicio remoto y recibió otra cosa. Actualiza la biblioteca, llámala con menos frecuencia y busca el mismo mensaje en el gestor de incidencias (issue tracker) del proyecto.
¿Cómo se ve el mismo error en JavaScript?
En Node.js 24, JSON.parse() sobre una página HTML lanza SyntaxError: Unexpected token '<', "<!DOCTYPE "... is not valid JSON, y sobre una cadena vacía, SyntaxError: Unexpected end of JSON input. Ahí también conviene comprobar el estado y el Content-Type antes de response.json() (cURL en JavaScript). El aviso del editor de WordPress «The response is not a valid JSON response» es otro problema.
En resumen
JSONDecodeError: Expecting value es un síntoma, no la causa. La conexión funcionó y el servidor respondió, pero el cuerpo estaba vacío o no era JSON. Tres comprobaciones encuentran la causa: el código de estado junto con r.history, el Content-Type y los primeros 200 caracteres del cuerpo. Un 204 vacío es normal, una página HTML significa una página de bloqueo, de inicio de sesión o de error, un 407 apunta al proxy, y Extra data o las comillas simples significan que el cuerpo solo parece JSON. Los tipos de proxy que puedes poner delante de un trabajo así están en nuestra página de servicios de proxy.


