


































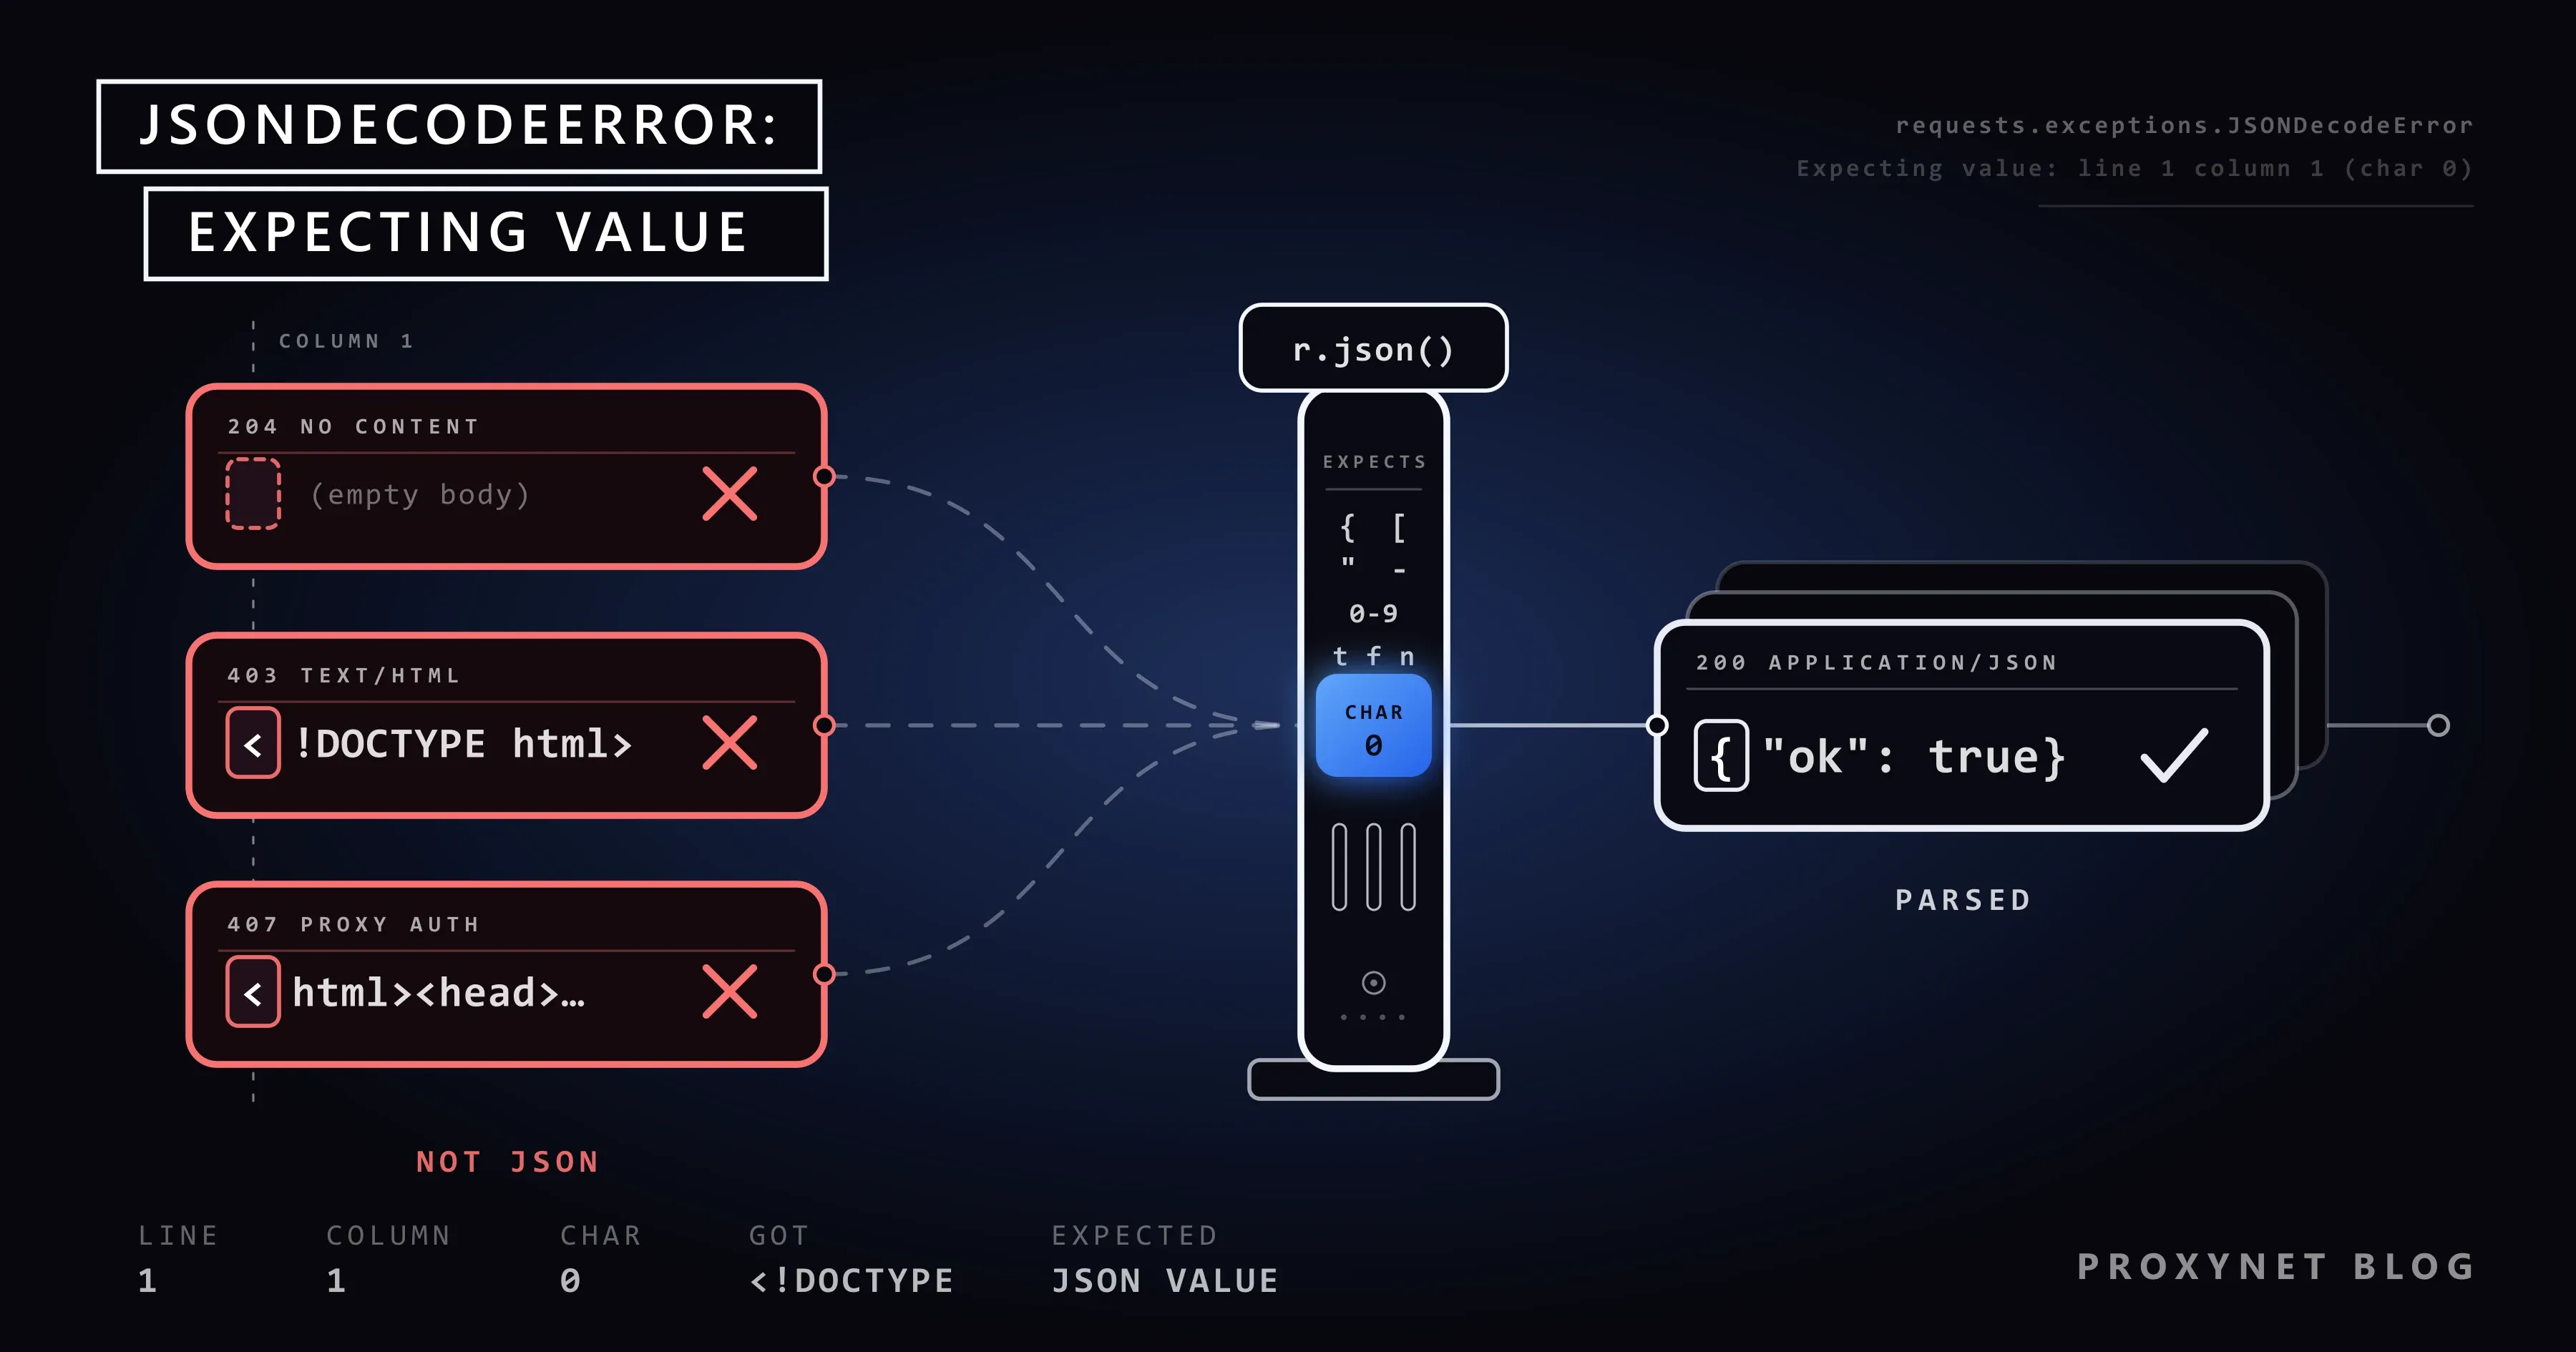
Sie holen die Produktliste eines Shops von /api/products?page=1, einer Adresse, die Sie im Network-Panel des Browsers gefunden haben. Das Skript läuft durch die ersten 300 Seiten und bricht dann bei data = r.json() mit requests.exceptions.JSONDecodeError: Expecting value: line 1 column 1 (char 0) ab. Dieselbe Adresse, derselbe Code. Sie fügen eine Zeile ein, print(r.status_code, r.headers.get("Content-Type"), r.text[:200]), und das Bild ändert sich: 403, text/html und eine Seite, die mit <!DOCTYPE html> beginnt. Der Server hat statt JSON eine Webseite geschickt, und der Parser hat beim ersten Zeichen aufgegeben, bei <.
Dieser Leitfaden erklärt, was die Meldung und ihre Positionsangabe bedeuten, welche Ausnahme jede Python-Bibliothek wirft und wie eine Prüfung aus drei Zeilen die Ursache findet. Danach geht er leere Antworten, HTML-Seiten, die 407-Antwort eines Proxys und Bodys durch, die nur wie JSON aussehen, und endet mit einer getesteten Hilfsfunktion parse_json().
Was bedeutet JSONDecodeError: Expecting value?
Der Parser hat den Anfang eines JSON-Werts erwartet und etwas anderes gefunden. Ein JSON-Text ist nach der Definition in RFC 8259 ein einzelner Wert: ein Objekt, ein Array, ein String in doppelten Anführungszeichen, eine Zahl, true, false oder null. Ein gültiger Text kann daher, nach optionalem Leerraum, nur mit {, [, ", einer Ziffer, -, t, f oder n beginnen. Trifft der Parser auf das < einer HTML-Seite, das T von Too Many Requests oder das Ende eines leeren Strings, bricht er mit „Expecting value“ ab.
Das ist kein Verbindungsfehler. Eine Anfrage, die den Server nie erreicht hat, scheitert früher, schon in requests.get(), mit Fehlern wie ConnectionError oder ProxyError (Max Retries Exceeded With URL). Wenn Sie JSONDecodeError sehen, ist eine Antwort angekommen; nur ihr Inhalt ließ sich nicht als JSON lesen.
Was sagt „line 1 column 1 (char 0)“ aus?
Die Zahlen zeigen, wo das Parsen gescheitert ist. json.JSONDecodeError führt sie als Attribute: msg (der Grund), doc (der ganze Text), pos (der Index des Zeichens, an dem es scheiterte), lineno und colno (Python-Dokumentation zu json). char 0 ist das erste Zeichen des Bodys, es hat also gar kein JSON begonnen.
Andere Positionen verraten mehr:
line 1 column 4 (char 3): Der Body bestand aus drei Leerzeichen und sonst nichts. Leerraum wird übersprungen, dann endet der Text.line 2 column 1 (char 1): Der Body beginnt mit einem Zeilenumbruch, danach folgt etwas, das kein JSON ist, oft eine HTML-Seite.- Eine Position tief im Text: Das JSON hat begonnen, ist aber später abgebrochen, zum Beispiel bei einem abgeschnittenen Download.
In einem except-Block zeigt e.doc[:200] den Anfang dieses Textes.
Welche Ausnahme werfen requests, json, httpx und aiohttp?
Wir haben jede Bibliothek mit Python 3.13, Requests 2.34.2, HTTPX 0.28.1 und AIOHTTP 3.14.3 geprüft:
- json:
json.loads()wirftjson.JSONDecodeError, eine Unterklasse vonValueError. - Requests: Seit Version 2.27.0 (Januar 2022) wirft
r.json()die Ausnahmerequests.exceptions.JSONDecodeError. Laut Changelog von Requests erbt sie von den Ausnahmen, die vorher geworfen wurden, und ist zugleich eineRequestException. - Requests mit installiertem simplejson: Die Elternklasse wird zu
simplejson.errors.JSONDecodeError. In unserem Test hatexcept json.JSONDecodeErrorden Fehler dann verfehlt;except ValueErrorhat ihn weiterhin abgefangen. - HTTPX:
Response.json()wirft dasjson.decoder.JSONDecodeErrorder Standardbibliothek. - AIOHTTP:
await resp.json()prüft zuerst den Content-Type und wirftContentTypeError(Attempt to decode JSON with unexpected mimetype: text/html), ohne zu parsen. Mitcontent_type=Nonewirft esjson.JSONDecodeError.
Fangen Sie bei Requests requests.exceptions.JSONDecodeError ab: Das funktioniert in beiden Fällen. Weitere Unterschiede zwischen den Clients stehen in HTTPX, Requests und AIOHTTP im Vergleich.
Wie finden Sie die Ursache in drei Zeilen?
Geben Sie aus, was angekommen ist, bevor Sie es parsen:
print(r.status_code, r.history, r.url)
print(r.headers.get("Content-Type"), len(r.content))
print(r.text[:200])
Lesen Sie die Ausgabe dann in dieser Reihenfolge:
- Status und Verlauf. Ist der Status
2xx? Gab es unterwegs ein301oder302? Nach einer Weiterleitung zeigtr.status_codedas abschließende200, und nurr.historyzeigt[<Response [302]>]. - Endgültige URL.
r.urlist die Adresse nach den Weiterleitungen. Endet sie auf/loginoder/consent, haben Sie die API nicht erreicht. - Content-Type. Sie wollen
application/jsonoder einen Typ, der auf+jsonendet. Alles andere deutet auf eine der Ursachen weiter unten. - Länge und erste Zeichen.
0heißt leer,<heißt HTML,{'ein als Text ausgegebenes Python-Dict,cb(JSONP. - Ordnen Sie das Ergebnis der Tabelle unten zu.
Protokollieren Sie nur die ersten 200 Zeichen: Ein vollständiger Body kann Tokens oder personenbezogene Daten enthalten.
Was verraten die ersten Zeichen des Bodys?
Jede Meldung unten stammt aus unserem Lauf mit Python 3.13.9 und Requests 2.34.2 gegen einen lokalen Testserver; andere Python-Versionen können sie anders formulieren.
| Anfang des Bodys | Typischer Status und Content-Type | Meldung von r.json() | Wahrscheinliche Ursache | Was zu tun ist |
|---|---|---|---|---|
| (nichts) | 204, 304, HEAD oder ein leeres 200 | Expecting value: line 1 column 1 (char 0) | Der Endpunkt liefert keinen Inhalt | Status und len(r.content) vor dem Parsen prüfen |
<!DOCTYPE html> | 403, 429, 503 oder 200 nach einem 302; text/html | Expecting value: line 1 column 1 (char 0) | Sperrseite, Weiterleitung zur Anmeldung, Fehlerseite | Zuerst den Status klären |
<html>...407... oder nichts | 407 und Proxy-Authenticate, Ziel mit http:// | Expecting value: line 1 column 1 (char 0) | Falsche Proxy-Zugangsdaten oder IP | user:pass und IP-Whitelist prüfen |
Too Many Requests | 429, text/plain | Expecting value: line 1 column 1 (char 0) | Ein Rate-Limit als reiner Text | Langsamer werden; Retry-After lesen |
cb({"items": ...}); | 200, application/javascript | Expecting value: line 1 column 1 (char 0) | JSONP | Den Endpunkt ohne Callback nutzen |
{"id":1}, dann eine neue Zeile und {"id":2} | 200, application/x-ndjson | Extra data: line 2 column 1 (char 9) | NDJSON | Zeile für Zeile parsen |
{'id': 1, ...} | 200, oft text/plain | Expecting property name enclosed in double quotes: line 1 column 2 (char 1) | Ein mit str() geschriebenes Dict | json.dumps() beim Erzeuger der Daten |
Ein unsichtbares BOM, dann { | 200, application/json | Unexpected UTF-8 BOM (decode using utf-8-sig): line 1 column 1 (char 0) | Eine Byte-Order-Mark | Mit utf-8-sig dekodieren |
Die ersten fünf Zeilen teilen sich eine Meldung. Die Meldung allein nennt die Ursache also nie; Status und Content-Type tun es.
Leere Antworten: 204, HEAD und 304
Manche Antworten haben per Definition keinen Body. RFC 9110 legt fest, dass eine Antwort 204 No Content keinen Inhalt enthalten darf, dass auch ein 304 Not Modified keinen hat und dass die Antwort auf eine HEAD-Anfrage nur Header trägt. Viele APIs beantworten DELETE und PUT mit 204: Die Aktion war erfolgreich, und es gibt nichts zu parsen, trotzdem wirft r.json() „Expecting value“.
Behandeln Sie diese Antworten als „keine Daten“, nicht als Fehler, und prüfen Sie r.status_code vor dem Parsen. Ein leeres 200 ist etwas anderes: Es bedeutet meist einen Serverfehler oder einen falschen Endpunkt und verdient eine Zeile im Log.
HTML statt JSON: Sperr-, Anmelde- und Fehlerseiten
Drei Arten von HTML-Seiten kommen dort an, wo JSON erwartet wurde, und der Statuscode unterscheidet sie.
Eine Sperr- oder Prüfseite. Ein 403, 429 oder 503 mit text/html ist oft die Antwort eines Bot-Schutzes. Ihr <title>, etwa „Just a moment...“ oder „Access denied“, reicht, um sie zu erkennen. Parsen Sie sie nicht, und senden Sie die Anfrage nicht in einer Schleife erneut. Was jeder Code bedeutet, steht in HTTP-Statuscodes beim Web Scraping, Cloudflare-Seiten behandelt Cloudflare Scraper, die Bewertung von Bots Bot-Erkennung: So funktionieren Anti-Bot-Systeme. Die legitimen Wege sind eine offizielle API, eine niedrigere Rate, die robots.txt beachtet, oder die Erlaubnis des Betreibers.
Eine Anmeldeseite nach einer Weiterleitung. Der Status ist 200, deshalb übersieht man diesen Fall leicht. r.history zeigt [<Response [302]>], und r.url endet auf /login: Ihre Sitzung ist abgelaufen. Für Ihr eigenes Konto ist die Lösung eine saubere Sitzungsverwaltung (Sitzungen und Cookies in Python).
Eine Fehlerseite des Servers. Ein 500, 502 oder 504 mit HTML kommt vom Server oder von einem vorgeschalteten Gateway: Die API hat ein Problem, nicht Ihr Parser.
HTML kommt auch an, wenn die URL auf die Seite zeigt statt auf die API. Das JSON stammt aus einer eigenen Anfrage, die die Seite stellt und die Sie im Network-Panel finden (zuerst die API-Anfrage finden).
Über einen Proxy: die 407-Antwort
Senden Sie eine einfache http://-Anfrage mit falschem Passwort über einen Proxy, antwortet der Proxy selbst mit 407 Proxy Authentication Required. Requests reicht diese Antwort als normale Response an Ihren Code weiter, mit dem Body, den der Proxy schickt: einer HTML-Seite, einem kurzen Text oder nichts. Mit zwei lokalen Test-Proxys, von denen einer HTML und der andere einen leeren Body schickte, ergab r.json() beide Male „Expecting value“.
Bei einem https://-Ziel kommt das 407 schon beim Aufbau des Tunnels. Deshalb wirft requests.get() die Ausnahme ProxyError: Tunnel connection failed: 407, und r.json() wird nie erreicht (Max Retries Exceeded With URL).
Ein 407 mit dem Header Proxy-Authenticate weist auf den Proxy hin, nicht auf das Ziel. Prüfen Sie Benutzername und Passwort, kodieren Sie Sonderzeichen in der Proxy-URL (@ wird zu %40), oder stellen Sie sicher, dass Ihre IP auf der Whitelist steht (Proxy-Authentifizierung: User:Pass oder IP-Whitelist).
Bodys, die wie JSON aussehen, es aber nicht sind: JSONP, NDJSON und einfache Anführungszeichen
Manche Bodys enthalten JSON, aber nicht als einen einzigen sauberen Wert.
JSONP
JSONP verpackt das JSON in einen Funktionsaufruf, cb({"items": [1]});, meist als application/javascript gesendet. Der Parser sieht c und meldet „Expecting value“ bei char 0. Nutzen Sie den Endpunkt ohne seinen Parameter callback, oder nehmen Sie den Text zwischen der ersten Klammer ( und der letzten ).
NDJSON und JSON Lines
Export- und Streaming-Endpunkte senden oft einen JSON-Wert pro Zeile, ein Format, das jsonlines.org beschreibt. Die erste Zeile lässt sich parsen, dann findet der Parser weiteren Text und bricht mit Extra data: line 2 column 1 ab. Lesen Sie solche Bodys mit r.iter_lines() Zeile für Zeile.
Einfache Anführungszeichen und Python-Werte
Ein Body wie {'id': 1} wurde mit Pythons str() statt mit json.dumps() geschrieben, und der Parser bricht bei char 1 mit Expecting property name enclosed in double quotes ab. Ein Body aus None oder True, also in Python-Schreibweise, scheitert mit „Expecting value“, weil JSON null und true schreibt. Korrigieren Sie den Code, der die Daten schreibt: text.replace("'", '"') zerstört jeden Wert mit einem Apostroph, und ast.literal_eval() ist nur für Daten sicher, die Sie selbst erzeugt haben.
Eine Byte-Order-Mark am Anfang führt zu Unexpected UTF-8 BOM; um die Kodierung geht es in Encoding-Fehler in Python.
Vollständiges Beispiel: parse_json() prüft den Body, bevor es JSON liest
Die Hilfsfunktion setzt die Prüfung aus drei Zeilen in Code um. Sie gibt die geparsten Daten zurück, None für Antworten, die per Definition keinen Body haben, oder wirft einen einzigen Fehler NotJSON, der Status, Weiterleitungen, Content-Type, endgültige URL und den Anfang des Bodys nennt. Installieren Sie Requests mit pip install requests.
"""Liest eine JSON-Antwort oder sagt in einer Zeile, warum der Body kein JSON ist."""
import json

import requests

PROXY = "http://user:pass@pr.proxynet.io:8000"
PROXIES = {"http": PROXY, "https": PROXY}


class NotJSON(ValueError):
    """Der Server hat geantwortet, aber nicht mit dem angefragten JSON."""


def describe(r):
    """Status, Weiterleitungen, Content-Type, endgültige URL und die ersten 200 Zeichen."""
    hops = "".join(f"{h.status_code} -> " for h in r.history)
    ctype = r.headers.get("Content-Type", "none")
    start = r.text[:200].replace("\n", " ")
    return f"HTTP {hops}{r.status_code}, {ctype}, {r.url}, body {start!r}"


def media_type(r):
    return r.headers.get("Content-Type", "").split(";")[0].strip().lower()


def is_json_type(mtype):
    return mtype == "application/json" or mtype.endswith("+json")


def parse_json(r):
    """Gibt den geparsten Body zurück, None für "kein Inhalt", oder wirft NotJSON mit dem Grund."""
    if r.status_code in (204, 304) or r.request.method == "HEAD":
        return None  # diese Antworten haben per Definition keinen Body
    mtype = media_type(r)
    if not r.ok and not is_json_type(mtype):
        raise NotJSON(f"error response, not JSON: {describe(r)}")
    if not r.content:
        raise NotJSON(f"empty body: {describe(r)}")
    if mtype == "application/x-ndjson":
        return [json.loads(line) for line in r.iter_lines() if line.strip()]
    if r.text.lstrip().startswith("<"):
        raise NotJSON(f"HTML instead of JSON: {describe(r)}")
    try:
        return r.json()
    except requests.exceptions.JSONDecodeError as e:
        raise NotJSON(f"{e.msg} at char {e.pos}: {describe(r)}") from e


if __name__ == "__main__":
    url = "https://example.com/api/products?page=1"
    r = requests.get(url, proxies=PROXIES, timeout=(5, 30))
    try:
        data = parse_json(r)
    except NotJSON as e:
        print("stop:", e)
    else:
        if not r.ok:
            print("API error:", r.status_code, data)
        elif data is None:
            print("no content")
        else:
            print("ok:", type(data).__name__, len(data))
Ein Fehlerstatus mit einem Body, der kein JSON ist, stoppt zuerst; eine 403-Seite oder die 407-Antwort eines Proxys wird also nie geparst. Ein Fehlerstatus mit JSON-Body, etwa 400 mit {"error": ...}, wird zurückgegeben, weil viele APIs Fehler so erklären; der Aufrufer prüft r.ok. PROXIES ist optional, und timeout=(5, 30) gibt dem Verbindungsaufbau 5 Sekunden und der Antwort 30.
Die Hilfsfunktion wiederholt absichtlich keine Anfragen, rotiert keine IPs und läuft nicht parallel. Welche Statuscodes eine Wiederholung verdienen, steht in HTTP-Statuscodes beim Web Scraping, die Rotation in Proxys in Python rotieren und parallele Anfragen in Concurrency und Parallelism.
So sieht die Ausgabe aus
Wir haben parse_json() gegen einen lokalen Testserver laufen lassen, der jeden Pfad mit einem Body aus der Tabelle beantwortet; die letzte Zeile lief über einen Test-Proxy, der mit 407 und HTML antwortete.
/api/products -> {'items': [1, 2, 3]}
/api/items/7 -> None
/api/empty -> NotJSON: empty body: HTTP 200, application/json, http://127.0.0.1:8111/api/empty, body ''
/api/blocked -> NotJSON: error response, not JSON: HTTP 403, text/html; charset=utf-8, http://127.0.0.1:8111/api/blocked, body '<!DOCTYPE html><html><head><title>Just a moment...</title></head></html>'
/api/private -> NotJSON: HTML instead of JSON: HTTP 302 -> 200, text/html; charset=utf-8, http://127.0.0.1:8111/login, body '<!DOCTYPE html> <html><head><title>Sign in</title></head></html>'
/api/slow -> NotJSON: error response, not JSON: HTTP 429, text/plain, http://127.0.0.1:8111/api/slow, body 'Too Many Requests'
/api/jsonp -> NotJSON: Expecting value at char 0: HTTP 200, application/javascript, http://127.0.0.1:8111/api/jsonp, body 'cb({"items": [1]});'
/api/export -> [{'id': 1}, {'id': 2}]
/api/dict -> NotJSON: Expecting property name enclosed in double quotes at char 1: HTTP 200, text/plain, http://127.0.0.1:8111/api/dict, body "{'id': 1, 'name': 'Lamp'}"
/api/bad-request -> {'error': 'page must be a number'} (status 400)
proxy, wrong password -> NotJSON: error response, not JSON: HTTP 407, text/html, http://example.com/api/products, body '<html><head><title>407 Proxy Authentication Required</title></head><body><h1>407</h1></body></html>'
/api/items/7 antwortete mit 204, und /api/export schickte NDJSON; beides ist also kein Fehler. Die Zeile /api/private zeigt die Weiterleitung, die eine reine Statusprüfung übersieht: 302 -> 200, mit dem Ziel /login.
Anwendungsfälle: In welchen Skripten, die JSON erwarten, tritt der Fehler auf?
- Die eigene API einer Website aufrufen: Die Anfrage, die Sie aus dem Network-Panel kopiert haben, funktioniert nicht mehr, sobald die Sitzung oder das Token dahinter abläuft (statische und dynamische Seiten).
- Preisbeobachtung: Ein täglicher Job, der Produkt-JSON liest, bekommt an dem Tag eine Sperrseite, an dem er zu schnell läuft (Wettbewerberpreise überwachen).
- Paginierung über eine API: Die Seite nach der letzten kann
204oder einen leeren Body statt einer leeren Liste liefern (Paginierung beim Web Scraping). - Automatisierungswerkzeuge: Ein HTTP-Request-Node in n8n erwartet JSON und bekommt eine HTML-Fehlerseite (Proxy in n8n einrichten).
- Datenpipelines: Eine einzige HTML-Antwort unter Tausenden JSON-Antworten soll einen Batch stoppen und nicht in der Datenbank landen (Data Scraping).
- Crawler: Ein Crawler, der JSON-Endpunkte auf vielen Hosts liest, braucht pro gescheitertem Host eine klare Meldung (Web Crawler).
Häufige Fehler
- Den Fehler verschlucken.
except JSONDecodeError: passspeichert nichts und verdeckt die Ursache. - Dem Status 200 vertrauen. Auch eine Anmeldeseite nach einem
302kommt als200an. Prüfen Sier.historyundr.url. - Einfache Anführungszeichen mit
replace()in doppelte verwandeln. Das zerstört jeden Wert, der einen Apostroph enthält. eval()auf einen Response-Body anwenden. Es führt jeden Code aus, den der Server geschickt hat.- Eine Sperrseite im gleichen Tempo erneut anfragen. Dieselben Anfragen in derselben Rate bekommen dasselbe
429oder403; senken Sie zuerst die Rate (429 Too Many Requests). - Den ganzen Body protokollieren. Die ersten 200 Zeichen nennen die Ursache; der Rest kann Tokens und personenbezogene Daten enthalten.
- Ein einziges
except RequestExceptionumget()undjson()zugleich. Seit 2.27.0 fängt es beides ab, ein Netzwerkfehler und ein Parse-Fehler sehen dann gleich aus. - Den Fehler im json-Modul suchen. Der Parser hat recht; der Body ist kein JSON.
Entscheidungshilfe
| Was Sie sehen | Was zu tun ist |
|---|---|
Status 204, oder der Body ist leer | r.json() nicht aufrufen; als „keine Daten“ behandeln |
403, 429 oder 503 mit text/html | Nicht parsen, zuerst den Status klären (HTTP-Statuscodes beim Web Scraping) |
200, aber r.history zeigt ein 302 auf eine Anmeldeseite | Sitzung erneuern (Sitzungen und Cookies in Python) |
407 mit HTML- oder leerem Body | Proxy-Zugangsdaten und IP-Whitelist prüfen |
ProxyError: Tunnel connection failed: 407 | Dieselbe Ursache bei https://-Zielen (Max Retries Exceeded With URL) |
Extra data | Mit r.iter_lines() Zeile für Zeile parsen |
Der Body beginnt mit callback( | Den Endpunkt ohne Callback nutzen oder die Hülle entfernen |
Unexpected UTF-8 BOM | Mit utf-8-sig dekodieren (Encoding-Fehler in Python) |
Häufige Fragen
Warum scheitert r.json(), obwohl der Statuscode 200 ist?
Ein 200 sagt nichts über das Format des Bodys. Eine Anmeldeseite nach einer Weiterleitung, eine JSONP-Antwort oder ein leerer Body können alle mit 200 kommen. Prüfen Sie den Content-Type, r.history und den Anfang von r.text.
Was ist der Unterschied zwischen requests.exceptions.JSONDecodeError und json.JSONDecodeError?
r.json() wirft seit Requests 2.27.0 requests.exceptions.JSONDecodeError. Diese Klasse ist eine Unterklasse des JSONDecodeError der JSON-Bibliothek und der Requests-eigenen RequestException, beide fangen sie also ab. Die Ausnahme ist simplejson: Ist es installiert, verfehlt except json.JSONDecodeError den Fehler; fangen Sie deshalb die Klasse von Requests ab.
Warum erhalte ich JSONDecodeError: Extra data?
Der Parser hat einen vollständigen JSON-Wert gelesen und dann weiteren Text gefunden: meist NDJSON oder zwei direkt hintereinander geschriebene Objekte. Parsen Sie Zeile für Zeile, oder lesen Sie mit json.JSONDecoder().raw_decode() einen Wert nach dem anderen.
Was bedeutet „Expecting property name enclosed in double quotes“?
Ein Schlüssel in einem Objekt steht nicht in doppelten Anführungszeichen. Die übliche Ursache ist ein mit str() geschriebenes Python-Dict, das einfache Anführungszeichen verwendet. In Python 3.12 und älter führt auch ein überzähliges Komma vor } zu dieser Meldung; Python 3.13 meldet es als Illegal trailing comma before end of object.
Ich bekomme diesen Fehler in yfinance oder spotdl. Was soll ich tun?
Die Bibliothek hat bei einem entfernten Dienst JSON angefragt und etwas anderes erhalten. Aktualisieren Sie die Bibliothek, rufen Sie sie seltener auf und suchen Sie im Issue-Tracker des Projekts nach derselben Meldung.
Wie sieht derselbe Fehler in JavaScript aus?
In Node.js 24 wirft JSON.parse() bei einer HTML-Seite SyntaxError: Unexpected token '<', "<!DOCTYPE "... is not valid JSON und bei einem leeren String SyntaxError: Unexpected end of JSON input. Prüfen Sie auch dort Status und Content-Type vor response.json() (cURL in JavaScript). Der Hinweis im WordPress-Editor „The response is not a valid JSON response“ (im deutschen WordPress „Die Antwort ist keine gültige JSON-Antwort“) ist ein anderes Problem.
Fazit
JSONDecodeError: Expecting value ist ein Symptom, nicht die Ursache. Die Verbindung hat funktioniert und der Server hat geantwortet, aber der Body war leer oder kein JSON. Drei Prüfungen finden die Ursache: der Statuscode zusammen mit r.history, der Content-Type und die ersten 200 Zeichen des Bodys. Ein leeres 204 ist normal, eine HTML-Seite bedeutet eine Sperr-, Anmelde- oder Fehlerseite, ein 407 weist auf den Proxy, und Extra data oder einfache Anführungszeichen bedeuten, dass der Body nur wie JSON aussieht. Die Proxy-Typen, die Sie vor einen solchen Job schalten können, finden Sie auf unserer Seite zu Proxy-Diensten.


