O seu script em Python coleta páginas de produtos de algumas dezenas de lojas toda manhã. Funciona em todas, menos em uma. Essa loja responde com um 403 e uma página HTML curta que pede JavaScript e cookies. Se você roda o script de novo, recebe a mesma página. A loja fica atrás da Cloudflare, e a Cloudflare respondeu antes de o servidor da própria loja ver a sua requisição.
Todo scraper que visita sites atrás da Cloudflare recebe uma resposta assim em algum momento. Este guia mostra como ler essa resposta, quais caminhos legítimos levam aos dados e o que um proxy pode e não pode mudar. No fim há um scraper em Python, testado, que classifica cada resposta da Cloudflare e para quando o site recusa, sem tentar contornar nenhum desafio.
O que significa o termo Cloudflare scraper?
Cloudflare scraper não é uma ferramenta especial: é qualquer scraper cujo site de destino passa o tráfego pela Cloudflare. (Alguns pacotes Python usam o mesmo nome para ferramentas que resolvem desafios; mais abaixo explicamos por que elas ficam de fora deste guia.) Em um site assim, o DNS devolve os endereços da Cloudflare, então a sua requisição chega primeiro a um servidor da Cloudflare. Ali a Cloudflare aplica as configurações de segurança do dono e encaminha ao servidor de origem (o servidor do próprio site) apenas as requisições que passam. Esse esquema é um reverse proxy: ele trabalha para o site, enquanto um forward proxy que você configura no seu scraper trabalha para você (Forward proxy e reverse proxy).
Como a Cloudflare decide que uma requisição vem de um bot?
A Cloudflare aplica as configurações do dono uma depois da outra, e a primeira que bloqueia a requisição ou mostra um desafio encerra a checagem. De forma simplificada:
- Checagens de IP e de cabeçalhos. As IP Access rules comparam o endereço IP, a rede dele (ASN) ou o país. O Browser Integrity Check, ativo por padrão, mostra um desafio quando o
User-Agentestá ausente ou fora do padrão. - Regras personalizadas. As regras do próprio dono (custom rules) podem verificar o caminho, o país, o
User-Agent, a pontuação de bot e outros campos. - Regras de rate limiting. A maioria dos planos conta requisições por IP. O Advanced Rate Limiting do plano Enterprise também pode contar por cookie, cabeçalho, ASN ou, com o Bot Management, por fingerprint TLS (JA3/JA4).
- Regras gerenciadas e produtos contra bots. Primeiro são verificados os padrões de ataque conhecidos; depois age o Bot Fight Mode, o Super Bot Fight Mode ou o Bot Management, conforme o plano.
- A resposta. A requisição chega à origem, recebe uma página de erro ou recebe um desafio, que roda verificações no navegador e, se elas passarem, grava um cookie
cf_clearance.
Os sinais por trás de cada passo estão em Como funciona a detecção de bots, e a camada de sessão em Cloudflare Precursor.
Qual bloqueio da Cloudflare o seu scraper encontrou?
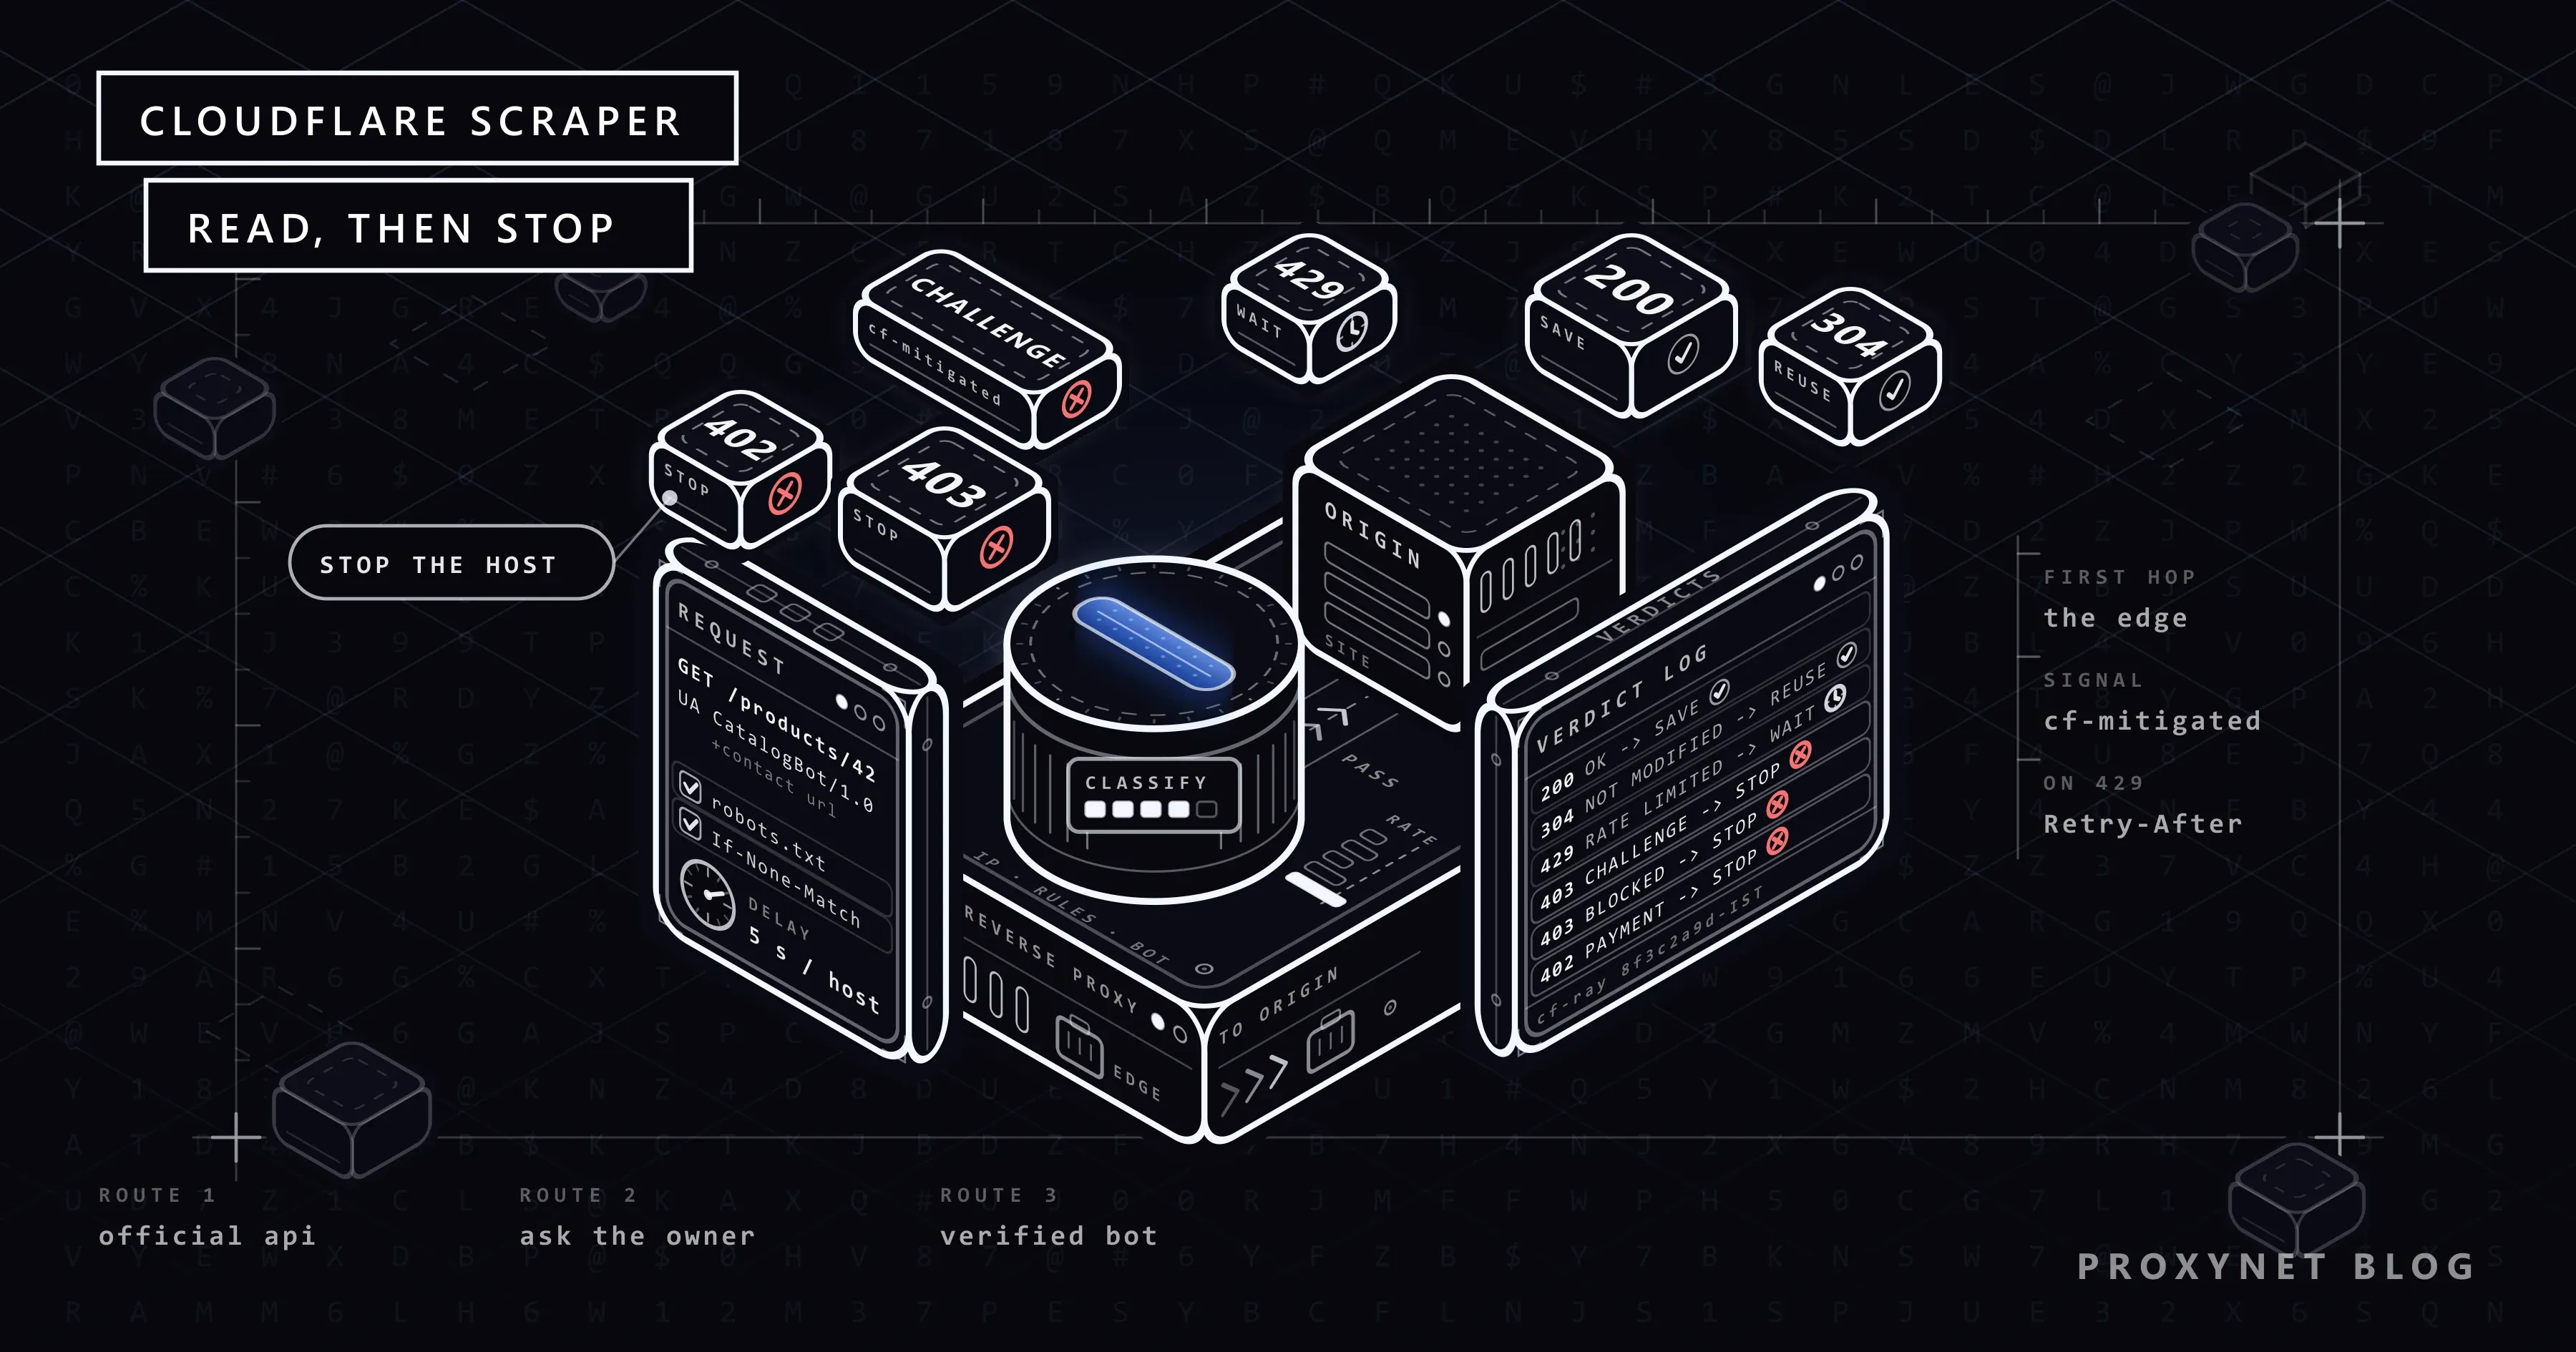
Um 403 vindo de um site com Cloudflare pode ser um desafio, uma regra de firewall, uma rede banida ou a recusa do próprio servidor de origem. Olhe os cabeçalhos, depois o código de status, depois o corpo e, por fim, a sua própria checagem de conteúdo. Os cabeçalhos cf-ray e server: cloudflare sozinhos não dizem nada, porque toda resposta que passa pela Cloudflare traz os dois.
| O que você vê | Status | Sinal | Significado | Próximo passo |
|---|---|---|---|---|
| Uma página curta que pede JavaScript | Muitas vezes 403 | cf-mitigated: challenge | Uma página de desafio | Pare; não tente resolver |
| Uma página normal com um formulário Turnstile | 200 | Um elemento cf-turnstile | O Turnstile protege esse formulário | Não envie o formulário |
| "Sorry, you have been blocked" | 403 por padrão | Uma página da Cloudflare, um Ray ID, nenhum código 1xxx | Uma regra de WAF definida pelo dono | Pare; envie o Ray ID ao dono |
| Error 1020, "Access denied" | 403 | Um código 1xxx da Cloudflare | Uma regra de firewall legada | Pare; envie o Ray ID ao dono |
| Error 1010 | 403 | Idem | O Browser Integrity Check bloqueou você | Fale com o dono |
| Error 1005, 1006-1008, 1106 ou 1009 | 403 | Idem | A sua rede (ASN), o seu IP ou o seu país está banido | Pare; não troque de rede |
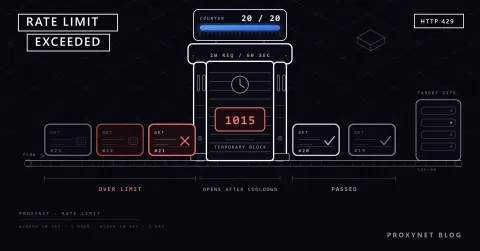
| Error 1015 | 429 por padrão, ou um 4xx escolhido pelo dono | 1015 no corpo, ou o 429 | Um limite de taxa, de 10 segundos a um dia conforme o plano | Espere, respeite o Retry-After, reduza o ritmo |
| Um aviso de pagamento | 402 | Cabeçalho crawler-price | Pay per crawl para crawlers de IA | Pare, a menos que você participe |
| Uma página de erro simples | 403 | Nenhum código de erro da Cloudflare nem Ray ID | O servidor de origem recusou | Pare; fale com o dono |
| Uma página sem os seus dados | 200 | A sua checagem de conteúdo falha | Uma página montada por JavaScript ou uma página-armadilha | Não salve; veja Páginas estáticas e dinâmicas e Armadilhas honeypot |
| Um erro de servidor | 5xx, incluindo 520-526 | Código de status | Problema na origem, não um bloqueio | Aumente a espera e tente de novo algumas vezes |
Quatro detalhes importam aqui:
- Confie no cabeçalho, não no texto. A Cloudflare documenta
cf-mitigated: challengecomo a forma de detectar uma resposta de página de desafio: todo tipo de desafio define esse cabeçalho, echallengeé o único valor dele. O texto do desafio muda com o idioma do navegador, e/cdn-cgi/challenge-platform/também aparece em páginas normais. A mesma página vista pelo visitante está em Cloudflare "Verifying you are human". - Os códigos de erro vêm em duas formas. A Cloudflare envia uma página HTML com a marca dela ("Error 1020") ou um corpo de texto curto como
error code: 1003. Recebemos a forma curta quando fizemos a requisição direto para um endereço IP da Cloudflare, mesmo com umUser-Agentde navegador. - Nem todo código 1xxx é bloqueio. O Error 1016, por exemplo, é um erro de DNS da origem, do lado do site.
- Bloqueios não trazem o cabeçalho
cf-mitigated. Só o corpo diferencia um bloqueio da Cloudflare do403da própria origem: um código de erro, ou uma página da Cloudflare com Ray ID. Os códigos um a um estão em "Sorry, you have been blocked", e os limites de taxa em Error 1015.
Por que o Python Requests é bloqueado pela Cloudflare e o navegador passa?
O Chrome carrega a página depois de uma espera curta, enquanto o Python Requests recebe o desafio. Há três diferenças.
Sem JavaScript. A Cloudflare diz que o visitante precisa de JavaScript e cookies para passar por qualquer tipo de desafio. Requests, httpx e curl baixam o HTML, mas nunca o executam.
Sem cookie de liberação. Um navegador que passa guarda um cookie cf_clearance e o envia em cada requisição seguinte. Um cliente HTTP simples nunca recebe esse cookie.
Uma identidade de cliente que não bate. As bibliotecas Python abrem a conexão TLS de um jeito diferente do Chrome. Por isso, uma requisição que diz "Chrome" no User-Agent, mas faz o handshake TLS do Python, é fácil de identificar (Fingerprint TLS e JA3). Um nome de bot honesto também pode acionar o Browser Integrity Check, que mostra um desafio para valores de User-Agent fora do padrão; só o dono pode abrir uma exceção.
Algumas ferramentas fazem um script se passar por navegador: plugins stealth, bibliotecas que imitam o TLS de navegadores, drivers modificados e serviços que resolvem desafios. Não tratamos delas aqui. Elas apresentam o seu cliente como algo que ele não é, em geral violam os termos do site e param de funcionar sempre que a detecção muda.
Quais são os caminhos legítimos até os dados de um site protegido pela Cloudflare?
Estes são os caminhos na ordem em que nós os tentaríamos.
1. Uma API oficial, um feed ou um sitemap
Muitos sites publicam dados para máquinas: uma API, um feed RSS ou de produtos, ou um sitemap indicado no robots.txt. Com uma API você recebe uma chave, um limite documentado e um formato estável, e nada quebra quando o HTML muda. Antes de escrever um scraper, confira o rodapé, as páginas para desenvolvedores e as linhas Sitemap: do robots.txt.
2. Peça ao dono do site
Só o dono pode remover um desafio ou um bloqueio; a equipe da Cloudflare não pode. Escreva uma mensagem curta com o nome do seu bot, um endereço de contato, os caminhos de que você precisa, a frequência das visitas e o seu endereço IP. O dono pode então liberar o seu IP com uma IP Access rule, que pula as regras personalizadas, o rate limiting e as regras gerenciadas; o Bot Fight Mode também não age sobre esse IP. Nos planos pagos, uma regra Skip pode ainda isentar você do Super Bot Fight Mode; em geral ela também se baseia em um IP fixo, ou em um token de cabeçalho combinado entre vocês. Para ter um endereço fixo, veja IP estático para API ou use Proxies ISP.
3. Entre no programa de bots verificados da Cloudflare
Para um crawler que presta um serviço público, o programa de bots verificados da Cloudflare é o caminho formal. Um bot verificado prova quem é com uma assinatura Web Bot Auth, com uma lista de IPs publicada junto de um User-Agent estável ou com DNS reverso. Ele precisa obedecer ao robots.txt e manter um ritmo razoável. O pedido é feito por um formulário no painel da Cloudflare; nomes genéricos como python-requests não são aceitos na validação por IP. Desde 1º de julho de 2026, o programa também cobre agentes assinados que agem em nome de usuários, e entre as categorias dele estão SEO, monitoramento e coleta de preços.
Com o Web Bot Auth, o bot assina cada requisição com a própria chave privada seguindo a RFC 9421 HTTP Message Signatures, um padrão desde fevereiro de 2024, e publica a chave pública no próprio domínio. O grupo de trabalho da IETF adotou as regras para bots como draft, o draft-ietf-webbotauth-httpsig-protocol, em 1º de setembro de 2026; o fluxo completo está em por que os sites bloqueiam agentes de compras com IA. A verificação prova quem você é, mas o dono continua decidindo se os bots verificados entram.
4. Para crawlers de IA: configurações padrão e pay per crawl
Desde julho de 2025, domínios novos na Cloudflare bloqueiam crawlers de IA por padrão. A partir de 15 de setembro de 2026, domínios novos também bloqueiam bots de Training e de Agent em páginas com anúncios, enquanto os de Search continuam liberados. Alguns sites acrescentam ao robots.txt linhas Content-Signal como ai-train=no; o urllib.robotparser ignora essas linhas (nós conferimos), então leia-as você mesmo. O Pay per crawl começou como beta privado em julho de 2025, e em setembro de 2026 a documentação da Cloudflare ainda o chama de beta fechado. Um crawler sem cabeçalhos de pagamento recebe um 402 com o cabeçalho crawler-price.
5. Um navegador real, só onde for preciso
Se uma página monta os dados com JavaScript e o site permite automação, o Playwright entrega a página renderizada (Playwright com proxy). Confira primeiro a aba de rede: muitas vezes os dados vêm de uma requisição JSON que um cliente simples consegue chamar. A Cloudflare afirma que frameworks de automação como o Playwright não têm suporte para resolver os desafios dela; por isso, se aparecer um desafio, pare e volte ao caminho 2.
Onde os proxies ajudam e onde não ajudam?
Um proxy muda apenas o endereço IP e a rede da sua requisição. Ele não muda o handshake TLS, não executa JavaScript e não leva o cookie cf_clearance. Trocar de IP a cada requisição faz um único cliente parecer muitos visitantes desconhecidos e sem histórico (como funciona a rotação de IP).
O proxy é a ferramenta certa em três casos:
- Conteúdo de um país. Com Proxies residenciais daquele país, você vê a página que os visitantes locais veem.
- Um IP fixo que o dono liberou. Com Proxies ISP, esse endereço fica estável.
- Muitos sites, cada um em ritmo moderado. Com Proxies rotativos, cada site pode receber uma saída diferente; com Proxies de sessão fixa, cada site fica sempre com a mesma saída. Nunca use a rotação para mandar a um site mais requisições do que um único IP teria permissão de mandar.
Passar por cima de um banimento não está entre esses casos: trocar de rede depois de um Error 1005 ou 1006 é exatamente o que essas regras querem impedir.
Um scraper em Python para sites com Cloudflare que sabe quando parar
O script é para coletas que você tem permissão de fazer, como catálogos públicos em sites que permitem crawling ou um site cujo dono liberou o seu IP. Sem tentar passar por nenhuma checagem, ele:
- envia um
User-Agenthonesto, com o nome do bot e uma URL de contato; - lê o
robots.txtuma vez por host, pelo mesmo classificador, e para de visitar aquele host se encontrar ali um desafio ou um bloqueio (uma regra cautelosa nossa, já que a RFC 9309 trata um4xxcomo "sem regras"); - registra o erro real quando não consegue baixar o
robots.txt, por exemplo depois de um407por senha de proxy errada, para que um erro de configuração não pareça uma recusa; - espera
MIN_DELAYsegundos, ou umCrawl-delaymaior, entre duas requisições ao mesmo host (só segundos inteiros: ourllib.robotparserignora1.5); - envia
If-None-MatcheIf-Modified-Since, para que uma página sem mudanças custe apenas um304; - em um
429ou5xx, respeita oRetry-Afternas duas formas que a RFC 9110 permite (sem esse cabeçalho, dobra a espera a cada vez), nunca espera mais queMAX_WAITe desiste do host depois deMAX_RETRIESnovas tentativas (Códigos de status HTTP no web scraping); - em um desafio, um bloqueio ou um
402, registra a URL e o valor decf-raye pula aquele host.
Ele usa o Requests síncrono (pip install requests), porque o objetivo é fazer uma requisição por vez em cada host, sem pressa (HTTPX, Requests e AIOHTTP).
"""Um scraper pequeno para sites atrás da Cloudflare, que lê cada resposta e para quando recebe um não."""
import email.utils
import logging
import math
import re
import time
from datetime import datetime, timezone
from enum import Enum
from urllib.parse import urlsplit
from urllib.robotparser import RobotFileParser

import requests

BOT_NAME = "NorthwindCatalogBot"
USER_AGENT = f"{BOT_NAME}/1.0 (+https://example.com/bot)"
PROXY = "http://user:pass@pr.proxynet.io:8000"  # um IP de saída fixo que o dono liberou, ou None
EXPECT = 'data-sku="'  # um marcador que toda página de produto real contém
MIN_DELAY = 5.0        # segundos entre duas requisições ao mesmo host
MAX_WAIT = 300         # nunca esperar mais do que isso antes de uma nova tentativa
MAX_RETRIES = 3        # novas tentativas após um 429 ou 5xx antes de desistir do host
BLOCK_CODES = {"1005", "1006", "1007", "1008", "1009", "1010", "1020", "1106"}

log = logging.getLogger(BOT_NAME)


class Verdict(Enum):
    OK = "ok"
    NOT_MODIFIED = "not_modified"
    CHALLENGE = "challenge"
    BLOCKED = "blocked"
    RATE_LIMITED = "rate_limited"
    PAYMENT_REQUIRED = "payment_required"
    SUSPICIOUS_200 = "suspicious_200"
    SERVER_ERROR = "server_error"
    OTHER = "other"


STOP = {Verdict.CHALLENGE, Verdict.BLOCKED, Verdict.PAYMENT_REQUIRED}
RETRY = {Verdict.RATE_LIMITED, Verdict.SERVER_ERROR}


class StopHost(Exception):
    """O site disse não. Deixamos este host em paz pelo resto da execução."""


def page_text(resp):
    """O início do corpo, sem as tags HTML."""
    return re.sub(r"<[^>]+>", " ", resp.text[:20000])


def cloudflare_code(resp):
    """O código 1xxx de uma resposta de erro da Cloudflare, ou None.

    A Cloudflare envia o código em uma página HTML com a marca dela ("Error 1020")
    ou em um corpo de texto curto ("error code: 1020"), junto com o cabeçalho "Server: cloudflare".
    """
    text = page_text(resp)
    from_cloudflare = resp.headers.get("Server", "").lower() == "cloudflare"
    short_form = from_cloudflare and text.lstrip().lower().startswith("error code:")
    if not short_form and "cloudflare" not in text.lower():
        return None
    match = re.search(r"(?i)\berror(?:\s+code)?:?\s+(1\d{3})\b", text)
    return match.group(1) if match else None


def classify(resp, expect=EXPECT):
    if resp.headers.get("cf-mitigated") == "challenge":
        return Verdict.CHALLENGE, "Cloudflare challenge page"
    status = resp.status_code
    if status == 304:
        return Verdict.NOT_MODIFIED, "unchanged since the last visit"
    if status == 402:
        return Verdict.PAYMENT_REQUIRED, "402 with crawler-price" if "crawler-price" in resp.headers else "402"
    code = cloudflare_code(resp) if status >= 400 else None
    if status == 429 or code == "1015":
        return Verdict.RATE_LIMITED, f"HTTP {status}, error {code}" if code else f"HTTP {status}"
    if code in BLOCK_CODES or status == 403:
        text = page_text(resp).lower()
        if code:
            why = f"Cloudflare error {code}"
        elif "cloudflare" in text and "ray id" in text:
            why = "Cloudflare block page without a code"  # uma regra de WAF
        else:
            why = "403 from the origin server"
        return Verdict.BLOCKED, why
    if status >= 500:
        return Verdict.SERVER_ERROR, f"HTTP {status}"
    if status == 200 and expect and expect not in resp.text:
        why = "Turnstile form, no data" if "cf-turnstile" in resp.text else "expected content missing"
        return Verdict.SUSPICIOUS_200, why
    if status == 200:
        return Verdict.OK, "expected content found" if expect else "HTTP 200"
    return Verdict.OTHER, f"HTTP {status}"


def wait_seconds(resp, attempt):
    """Retry-After em qualquer das duas formas da RFC 9110; sem ele, um backoff que dobra. Segundos inteiros, com teto."""
    value = resp.headers.get("Retry-After", "").strip()
    wait = 30 * 2**attempt
    if value.isdigit():
        wait = int(value)
    elif value:
        try:
            when = email.utils.parsedate_to_datetime(value)
            if when.tzinfo is None:
                when = when.replace(tzinfo=timezone.utc)
            wait = (when - datetime.now(timezone.utc)).total_seconds()
        except (TypeError, ValueError):
            pass
    return min(max(math.ceil(wait), 1), MAX_WAIT)


class PoliteFetcher:
    def __init__(self, proxy=PROXY):
        self.session = requests.Session()
        self.session.headers["User-Agent"] = USER_AGENT
        if proxy:
            self.session.proxies = {"http": proxy, "https": proxy}
        self.robots, self.delay, self.last, self.cache = {}, {}, {}, {}

    def get(self, url, headers=None, expect=EXPECT):
        host = urlsplit(url).netloc
        for attempt in range(MAX_RETRIES + 1):
            pause = self.delay.get(host, MIN_DELAY) - (time.monotonic() - self.last.get(host, -1e9))
            if pause > 0:
                time.sleep(pause)
            resp = self.session.get(url, headers=headers, timeout=20)
            self.last[host] = time.monotonic()
            if resp.status_code == 407:
                raise requests.exceptions.ProxyError("the proxy rejected the credentials (407)")
            verdict, why = classify(resp, expect)
            if verdict in STOP:
                ray = resp.headers.get("cf-ray", "none")
                log.error("STOP %s: %s, %s (cf-ray %s)", url, verdict.value, why, ray)
                raise StopHost(host)
            if verdict not in RETRY:
                return resp, verdict, why
            if attempt < MAX_RETRIES:
                wait = wait_seconds(resp, attempt)
                log.warning("%s %s: %s, waiting at least %d s", verdict.value, url, why, wait)
                time.sleep(wait)
        log.error("STOP %s: still %s after %d retries", url, verdict.value, MAX_RETRIES)
        raise StopHost(host)

    def allowed(self, url):
        parts = urlsplit(url)
        host = parts.netloc
        if host not in self.robots:
            try:
                resp, _, _ = self.get(f"{parts.scheme}://{host}/robots.txt", expect=None)
            except requests.RequestException as exc:
                log.error("STOP %s: robots.txt unreachable (%s)", host, exc)
                raise StopHost(host) from exc
            parser = RobotFileParser()
            parser.parse(resp.text.splitlines() if resp.status_code == 200 else [])
            self.robots[host] = parser
            # o urllib.robotparser só lê segundos inteiros: "Crawl-delay: 1.5" é ignorado
            self.delay[host] = max(MIN_DELAY, parser.crawl_delay(BOT_NAME) or 0)
        return self.robots[host].can_fetch(BOT_NAME, url)

    def fetch(self, url):
        """O HTML da página, ou None quando a página deve ser pulada."""
        if not self.allowed(url):
            log.info("skip %s: disallowed by robots.txt", url)
            return None
        validators, body = self.cache.get(url, ({}, None))
        resp, verdict, why = self.get(url, headers=validators)
        log.log(logging.INFO if verdict in (Verdict.OK, Verdict.NOT_MODIFIED) else logging.WARNING,
                "%s %s: %s", verdict.value, url, why)
        if verdict is Verdict.NOT_MODIFIED:
            return body
        if verdict is not Verdict.OK:
            return None
        saved = {}
        if "ETag" in resp.headers:
            saved["If-None-Match"] = resp.headers["ETag"]
        if "Last-Modified" in resp.headers:
            saved["If-Modified-Since"] = resp.headers["Last-Modified"]
        self.cache[url] = (saved, resp.text)
        return resp.text


def crawl(urls, proxy=PROXY):
    fetcher, stopped, pages = PoliteFetcher(proxy), set(), {}
    for url in urls:
        host = urlsplit(url).netloc
        if host in stopped:
            log.info("skip %s: host stopped earlier", url)
            continue
        try:
            html = fetcher.fetch(url)
        except StopHost:
            stopped.add(host)
            continue
        except requests.RequestException as exc:
            log.warning("network error %s: %s", url, exc)
            continue
        if html is not None:
            pages[url] = html
    return pages


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO, format="%(levelname)-7s %(message)s")
    found = crawl([
        "https://www.example.com/products/1001",
        "https://www.example.com/products/1002",
    ])
    print(f"{len(found)} pages saved")
classify() confere primeiro o cf-mitigated, depois 402 e 429, e então procura um código 1xxx em qualquer uma das duas formas. Um 403 sem código conta como página de bloqueio da Cloudflare quando o corpo cita a Cloudflare e mostra um Ray ID. Em um 200, o veredito só é ok se o marcador EXPECT estiver na página. Por isso, escolha um marcador que uma página de desafio, uma página vazia que depende de JavaScript ou uma página-armadilha não teriam, como um atributo de ID de produto.
Como fica a saída
Rodamos o script com Python 3.13 e Requests 2.34.2 por um proxy HTTP local, contra oito sites de teste locais, um para cada tipo de resposta. Para o teste, trocamos as duas URLs de exemplo do __main__ por páginas desses sites. Os sites de teste apenas reproduzem os sinais documentados, e os Ray IDs foram gerados por eles.
INFO    ok http://127.0.0.1:28150/products/1001: expected content found
INFO    not_modified http://127.0.0.1:28150/products/1001: unchanged since the last visit
INFO    skip http://127.0.0.1:28150/cart: disallowed by robots.txt
WARNING rate_limited http://127.0.0.1:28150/products/1002: HTTP 429, waiting at least 2 s
INFO    ok http://127.0.0.1:28150/products/1002: expected content found
WARNING rate_limited http://127.0.0.1:28150/products/1003: HTTP 429, waiting at least 3 s
INFO    ok http://127.0.0.1:28150/products/1003: expected content found
WARNING suspicious_200 http://127.0.0.1:28150/products/1004: expected content missing
WARNING suspicious_200 http://127.0.0.1:28150/products/1005: Turnstile form, no data
ERROR   STOP http://127.0.0.1:28151/products/1: challenge, Cloudflare challenge page (cf-ray 8f3c2a9d1b7e28151-IST)
INFO    skip http://127.0.0.1:28151/products/2: host stopped earlier
ERROR   STOP http://127.0.0.1:28152/products/1: blocked, Cloudflare error 1020 (cf-ray 8f3c2a9d1b7e28152-IST)
ERROR   STOP http://127.0.0.1:28153/products/1: blocked, Cloudflare block page without a code (cf-ray 8f3c2a9d1b7e28153-IST)
ERROR   STOP http://127.0.0.1:28154/products/1: blocked, Cloudflare error 1006 (cf-ray 8f3c2a9d1b7e28154-IST)
ERROR   STOP http://127.0.0.1:28155/products/1: payment_required, 402 with crawler-price (cf-ray 8f3c2a9d1b7e28155-IST)
ERROR   STOP http://127.0.0.1:28156/robots.txt: challenge, Cloudflare challenge page (cf-ray 8f3c2a9d1b7e28156-IST)
INFO    skip http://127.0.0.1:28156/products/2: host stopped earlier
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
ERROR   STOP http://127.0.0.1:28157/products/1: still rate_limited after 3 retries
3 pages saved
A primeira página é ok, embora carregue um script de /cdn-cgi/challenge-platform/. Na segunda visita o servidor responde 304, e o robots.txt mantém o script longe de /cart. As duas respostas 429 traziam Retry-After, uma vez em segundos e outra como data; o log diz "at least" (pelo menos) porque o intervalo por host pode deixar a espera real mais longa. Duas páginas 200 não foram salvas, os seis hosts seguintes pararam na primeira página ou no robots.txt, e o último host foi descartado depois de três novas tentativas.
Uma ressalva: o dono pode configurar um limite de taxa com status e corpo personalizados, sem o 1015. Nesse caso o script registra blocked ou other, então fique de olho nos dois vereditos.
Casos de uso
- Monitoramento de preços: as requisições condicionais deixam as checagens diárias baratas, e o
suspicious_200avisa quando um template mudou (monitoramento de preços). - Pesquisa de mercado: dados de sortimento e estoque de muitas lojas, cada uma visitada no próprio ritmo (pesquisa de mercado).
- Checagens de SEO: descubra se as configurações da Cloudflare do seu próprio site mostram desafios aos crawlers que você quer receber (proxy para SEO).
- Proteção de marca: varreduras de marketplaces em busca de anúncios falsos, feitas por uma rotina que para em cada desafio (proteção de marca).
- Crawlers públicos: um índice ou arquivo que pede o status de bot verificado antes do primeiro crawl (web crawler).
- Coleta de dados em geral: dados limpos e um registro do que a rotina não conseguiu acessar (extração de dados).
Erros comuns
- Tentar de novo em loop depois de um
403. A resposta continua a mesma, e a própria rajada de requisições parece coisa de bot. - Tentar de novo logo depois do Error 1015 ou ignorar o
Retry-After. A Cloudflare avisa que tentativas repetidas em pouco tempo podem prolongar o bloqueio (429 Too Many Requests). - Trocar de IP a cada requisição ao mesmo site. Endereços novos no mesmo ritmo ignoram o limite que o dono definiu, e os limites por cookie ou por fingerprint não zeram (Como fazer web scraping sem ser bloqueado).
- Fingir ser o Googlebot. O Google orienta os donos de sites a verificar o Googlebot com consultas de DNS reverso e direto ou pelas faixas de IP que ele publica, e uma string de Googlebot vinda de outro IP falha nas duas checagens.
- Confiar em todo
200. Páginas vazias que dependem de JavaScript, formulários Turnstile e páginas-armadilha retornam200. O AI Labyrinth da Cloudflare leva os crawlers que seguem os links ocultos dele a um labirinto de páginas, sem bloqueá-los. - Copiar o
cf_clearancepara um script. O cookie fica vinculado ao dispositivo para o qual foi emitido. - Fazer scraping atrás de um login que não é seu. A sua própria conta e os seus dados são uma coisa (Sessões e cookies em Python); páginas que o site não abriu para você são outra.
- Pagar um serviço de resolução de CAPTCHA. Os desafios da Cloudflare não são quebra-cabeças de imagem; as checagens rodam dentro do navegador, e um serviço desses contorna a decisão do dono.
Guia de decisão
| A sua situação | O que fazer |
|---|---|
| O site tem uma API ou um feed | Use esse caminho, mesmo que o scraping do HTML pareça mais fácil |
| Você precisa de poucas páginas de um site | Escreva ao dono: nome do bot, caminhos, ritmo |
| O dono concordou em liberar você | Envie todo o tráfego de um único IP fixo |
| Você opera um crawler público | Peça o status de bot verificado |
| Você cria um crawler ou agente de IA | Leia as linhas Content-Signal; trate um 402 como um preço |
| Os dados são montados com JavaScript | Encontre a requisição JSON; use o Playwright só onde for permitido |
| Você precisa dos preços de um país | Use um proxy naquele país, no mesmo ritmo |
A sua rotina recebe 429 todo dia | Reduza o ritmo; não acrescente IPs |
| A sua rotina cai em um desafio ou em uma página de bloqueio | Pare naquele host; escolha um dos caminhos acima |
| Você monitora o seu próprio site na Cloudflare | Libere o IP do monitor com uma IP Access rule |
Perguntas frequentes
O Python Requests consegue fazer scraping de um site atrás da Cloudflare?
Sim, desde que as configurações do dono deixem a requisição passar. Quando o site responde com um desafio, o Requests não consegue passar por ele, porque todo desafio da Cloudflare precisa de JavaScript e cookies. Nesse caso, use a API do site, peça acesso ao dono ou pare.
Fazer scraping de um site protegido pela Cloudflare é legal?
Isto não é aconselhamento jurídico. A resposta depende do país, dos termos do site, de os dados serem pessoais ou não e de como você os usa. Um desafio é um sinal claro da vontade do dono; contorná-lo ignora esse sinal e em geral viola os termos do site. O panorama por país está em Web scraping é legal?.
O que é o cookie cf_clearance?
cf_clearance é o cookie que o navegador recebe depois de passar por um desafio da Cloudflare, para que as próximas requisições cheguem à origem sem um novo desafio. Ele dura o tempo definido na configuração Challenge Passage do dono (30 minutos por padrão) e fica vinculado ao visitante e ao dispositivo. O Precursor pode invalidá-lo antes do prazo se a sessão começar a parecer suspeita.
Um proxy residencial faz o scraper passar pela Cloudflare?
Não, e esse não é o papel dele. Um proxy muda o seu endereço IP e a sua rede, mas o desafio continua exigindo JavaScript, o seu handshake TLS continua o mesmo e um banimento do seu cliente continua valendo. Use um proxy residencial para ver uma página como os visitantes de um país a veem, em um ritmo que o site aceita.
Como faço para a Cloudflare verificar o meu crawler?
Dê ao crawler um nome próprio e uma das provas do caminho 3: assinaturas Web Bot Auth ou uma lista publicada de endereços IP que só o crawler usa. Faça com que ele obedeça ao robots.txt e ao crawl-delay e, depois, envie o pedido pelo formulário de bots verificados no painel da Cloudflare.
Por que o meu scraper funciona no notebook, mas falha em um servidor?
O seu notebook usa uma conexão de casa ou do escritório; o servidor usa a rede de um provedor de hospedagem. Os donos podem banir uma rede inteira pelo ASN (Error 1005), e a reputação do endereço entra na pontuação de bot. Por isso, o mesmo script pode passar em um e receber um desafio no outro. Peça ao dono que libere o IP fixo do servidor ou use a API oficial.
Em resumo
Um scraper é bloqueado pela Cloudflare quando as configurações do dono param a requisição antes que ela chegue à origem. Leia a resposta antes de mudar qualquer coisa. Um cabeçalho cf-mitigated: challenge é um desafio; a maioria dos códigos de erro da Cloudflare e a página de bloqueio são regras do dono; um 429 ou o Error 1015 é um limite de taxa; um 402 é um preço; e um 200 só conta se o seu conteúdo estiver nele. Depois, escolha um caminho que dure: uma API oficial, a permissão do dono para um IP fixo, o status de bot verificado ou um navegador real só onde a renderização for necessária. Para coletas em que o país ou um endereço fixo importa, compare as opções na nossa página de serviços de proxy.