Python betiğiniz her sabah birkaç düzine mağazadan ürün sayfalarını topluyor. Biri dışında hepsinde sorunsuz çalışıyor. O mağaza bir 403 kodu ve JavaScript ile çerez isteyen kısa bir HTML sayfası döndürüyor. Betiği yeniden çalıştırdığınızda aynı sayfa geliyor. Mağaza Cloudflare arkasında: cevabı, mağazanın kendi sunucusu isteğinizi görmeden Cloudflare verdi.
Her Cloudflare scraper bir noktada böyle bir cevap alır. Bu yazıda o cevabı nasıl okuyacağınızı, veriye hangi meşru yolların götürdüğünü ve proxy'nin neyi değiştirip neyi değiştiremeyeceğini anlatıyoruz. Yazının sonunda test ettiğimiz bir Python scraper var: her Cloudflare yanıtını sınıflandırıyor, site reddettiğinde duruyor ve hiçbir challenge'ı (Cloudflare'in tarayıcıyı sınayan doğrulama sayfasını) atlatmaya çalışmıyor.
Cloudflare scraper ne demek?
Cloudflare scraper özel bir araç değildir: trafiği Cloudflare üzerinden geçen bir siteyi hedefleyen her web scraping (veri kazıma) betiğine bu ad verilir. (Bazı Python paketleri aynı adı challenge çözücüler için kullanıyor; onlara neden yer vermediğimizi aşağıda anlatıyoruz.) Böyle bir sitede DNS, Cloudflare'in adreslerini döndürür, yani isteğiniz önce bir Cloudflare sunucusuna ulaşır. Cloudflare site sahibinin güvenlik ayarlarını orada uygular ve yalnızca bu ayarlardan geçen istekleri origin'e, yani sitenin kendi sunucusuna iletir. Bu düzene reverse proxy denir: site için çalışır. Scraper'ınızda ayarladığınız forward proxy ise sizin için çalışır (Forward Proxy ve Reverse Proxy Arasındaki Fark).
Cloudflare bir isteğin bot olduğuna nasıl karar verir?
Cloudflare site sahibinin ayarlarını sırayla çalıştırır. İsteği engelleyen ya da challenge'a yönlendiren ilk ayar kontrolü bitirir. Basitleştirilmiş hâliyle:
- IP ve header kontrolleri. IP Access kuralları IP adresine, adresin bağlı olduğu ağa (ASN) ya da ülkesine bakar. Varsayılan olarak açık gelen Browser Integrity Check, eksik ya da standart dışı bir
User-Agentgördüğünde challenge gösterir. - Özel kurallar (custom rules). Site sahibinin kendi yazdığı kurallar URL yoluna, ülkeye,
User-Agentdeğerine, bot puanına ve başka pek çok özelliğe bakabilir. - Hız sınırlama kuralları. Çoğu plan istekleri IP başına sayar. Enterprise planındaki Advanced Rate Limiting sayımı çereze, header'a, ağa (ASN) ya da Bot Management ile birlikte TLS parmak izine (JA3/JA4) göre de yapabilir.
- Yönetilen kurallar ve bot ürünleri. Önce bilinen saldırı kalıpları kontrol edilir, ardından plana göre Bot Fight Mode, Super Bot Fight Mode ya da Bot Management devreye girer.
- Cevap. İstek ya origin'e ulaşır, ya bir hata sayfası alır ya da bir challenge ile karşılaşır. Challenge tarayıcıda birkaç kontrol çalıştırır ve tarayıcı bunları geçerse bir
cf_clearanceçerezi yazar.
Her adımın arkasındaki sinyalleri Bot Tespiti Nasıl Yapılır? yazımızda, oturum katmanını Cloudflare Precursor yazımızda anlattık.
Scraper'ınız hangi Cloudflare engeline takıldı?
Cloudflare arkasındaki bir siteden gelen 403 dört şeyden biri olabilir: bir challenge, bir güvenlik duvarı kuralı, yasaklanmış bir ağ ya da origin'in kendi reddi. Önce header'lara, sonra durum koduna, sonra gövdeye, en sonda da kendi içerik kontrolünüze bakın. cf-ray ve server: cloudflare header'ları tek başına bir şey söylemez, çünkü Cloudflare'den geçen her yanıtta bulunurlar.
| Gördüğünüz | Durum kodu | İşaret | Anlamı | Sonraki adım |
|---|---|---|---|---|
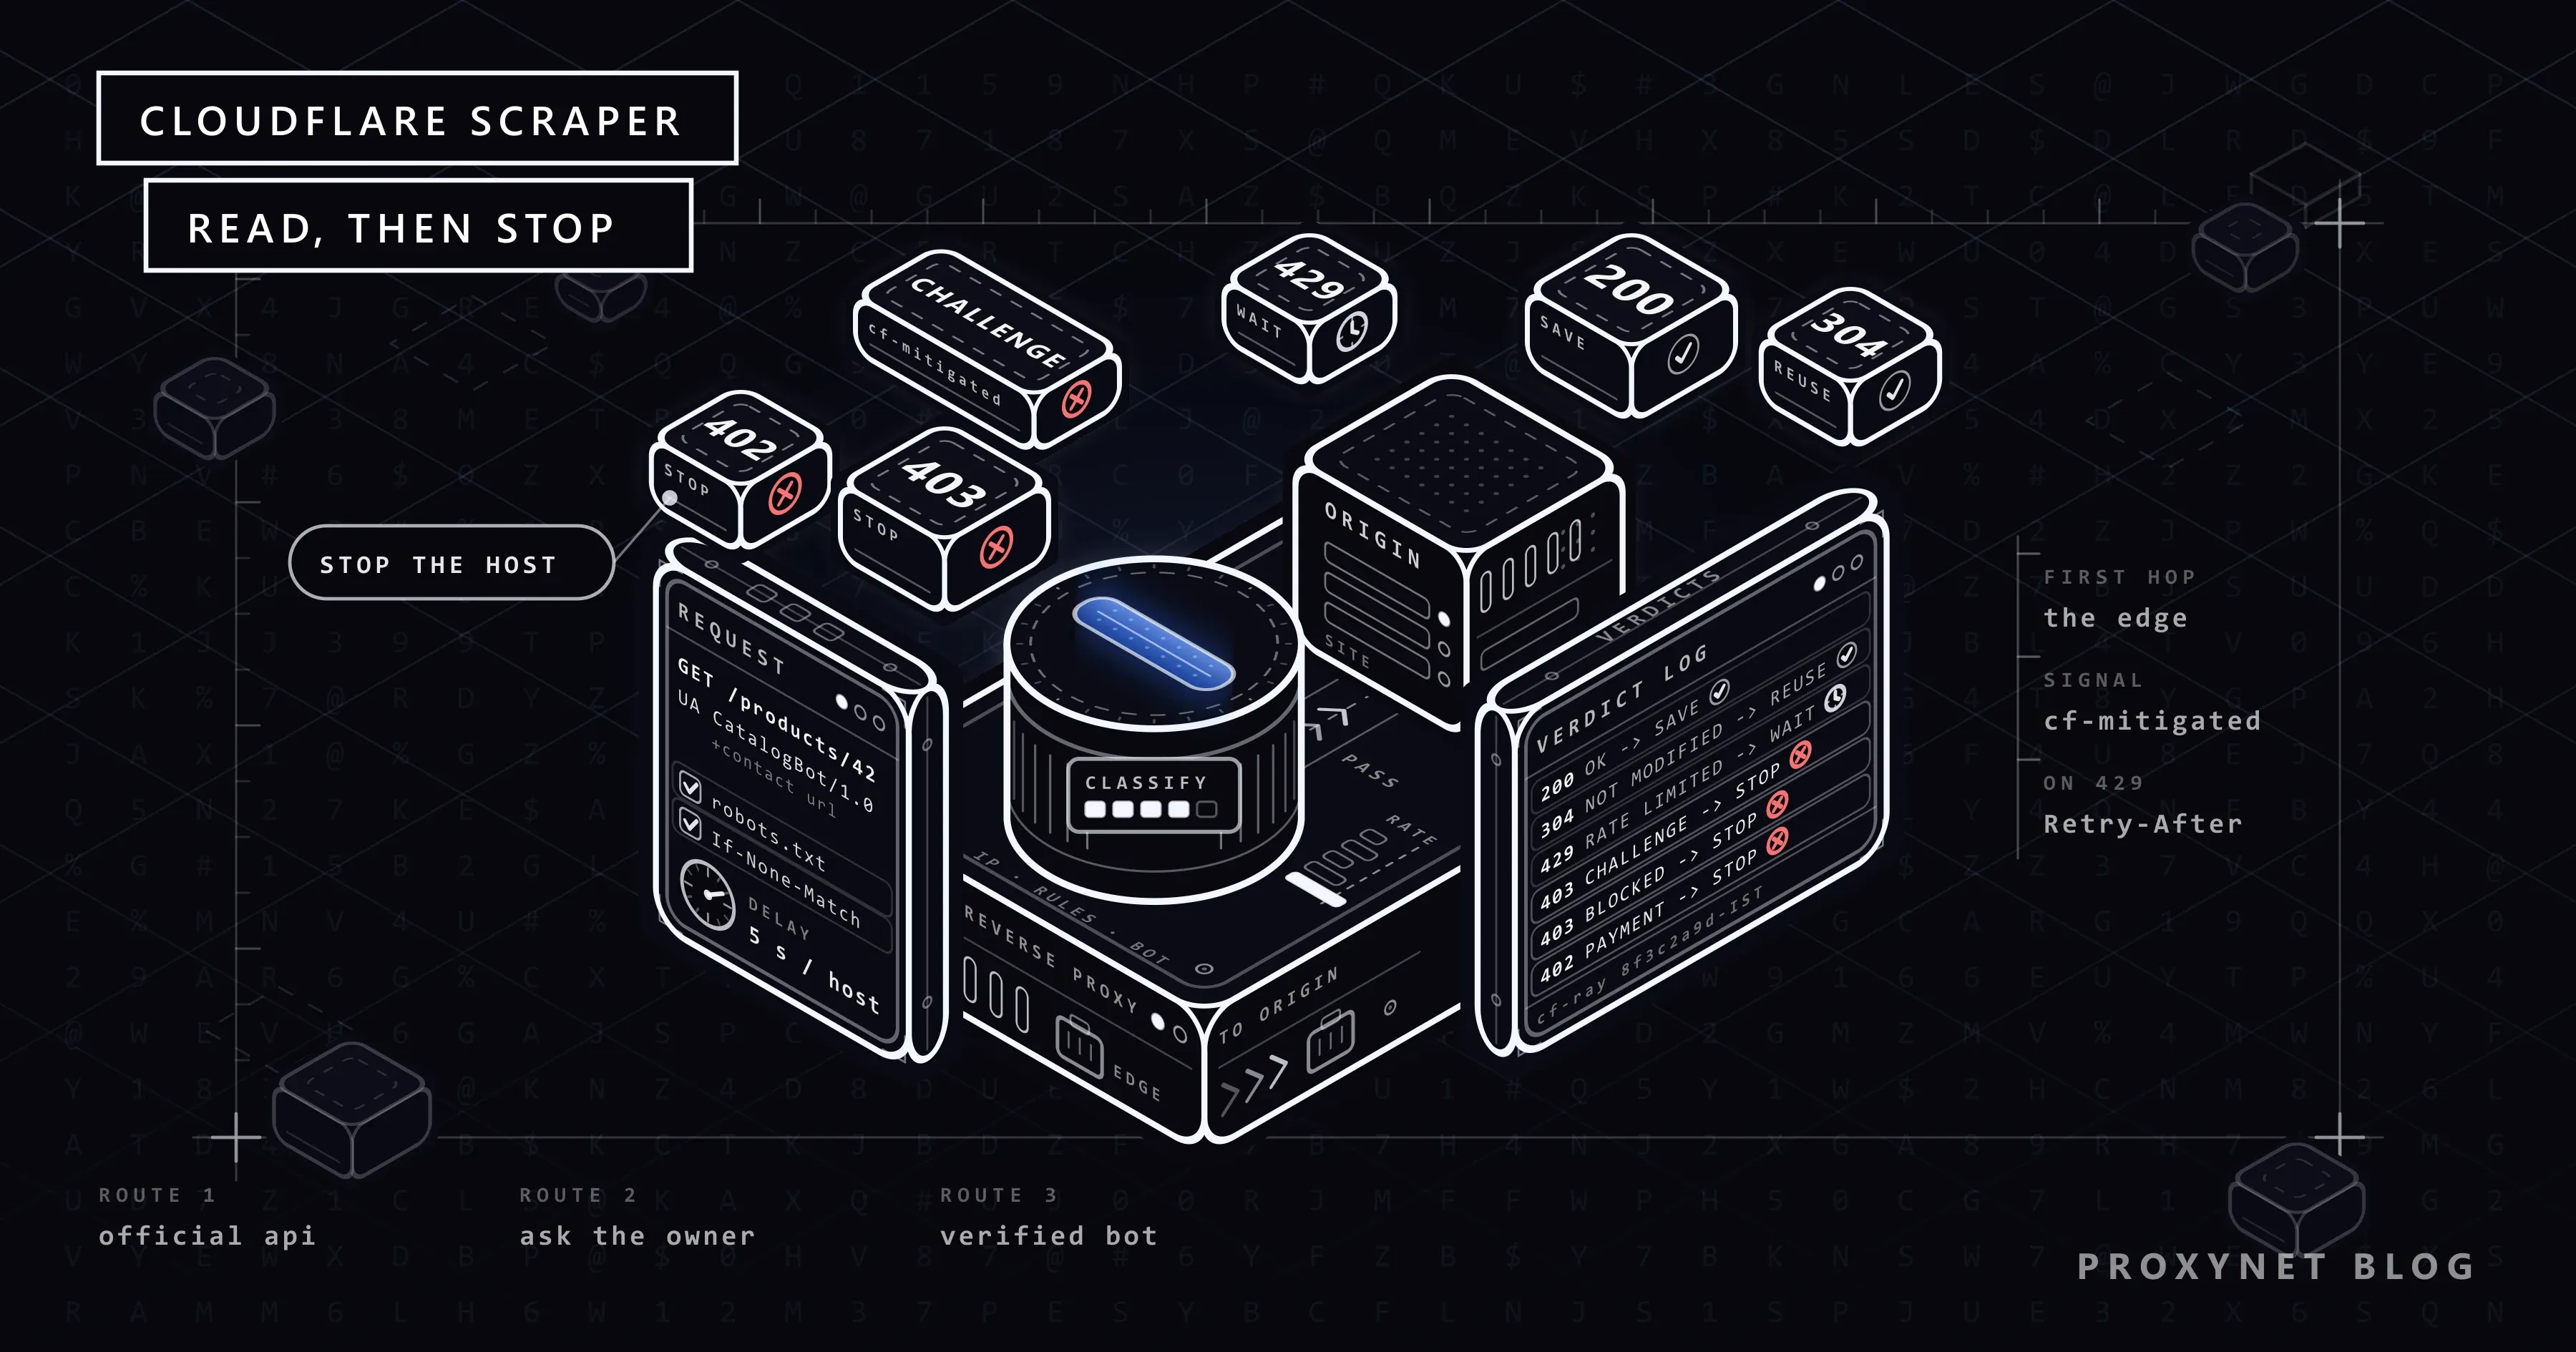
| JavaScript isteyen kısa bir sayfa | Çoğunlukla 403 | cf-mitigated: challenge | Challenge sayfası | Durun; çözmeye çalışmayın |
| Turnstile formu olan normal bir sayfa | 200 | Bir cf-turnstile öğesi | O formu Turnstile koruyor | Formu göndermeyin |
| "Sorry, you have been blocked" | Varsayılan olarak 403 | Cloudflare sayfası, Ray ID var, 1xxx kodu yok | Site sahibinin koyduğu bir WAF kuralı | Durun; Ray ID'yi site sahibine iletin |
| Error 1020, "Access denied" | 403 | Cloudflare'den gelen bir 1xxx kodu | Eski tip (legacy) bir güvenlik duvarı kuralı | Durun; Ray ID'yi site sahibine iletin |
| Error 1010 | 403 | Aynı | Browser Integrity Check sizi engelledi | Site sahibine sorun |
| Error 1005, 1006-1008, 1106 ya da 1009 | 403 | Aynı | Ağınız (ASN), IP'niz ya da ülkeniz yasaklı | Durun; ağ değiştirmeyin |
| Error 1015 | Varsayılan olarak 429 ya da site sahibinin seçtiği bir 4xx | Gövdede 1015 ya da 429 kodu | Plana göre 10 saniyeden bir güne kadar süren bir hız sınırı | Bekleyin, Retry-After değerine uyun, yavaşlayın |
| Ödeme bildirimi | 402 | crawler-price header'ı | AI crawler'ları için pay per crawl | Programa katılmıyorsanız durun |
| Sade bir hata sayfası | 403 | Cloudflare hata kodu ya da Ray ID yok | Origin sunucusu reddetti | Durun; site sahibine sorun |
| Verinizin olmadığı bir sayfa | 200 | İçerik kontrolünüz başarısız | JavaScript ile oluşturulan bir sayfa ya da tuzak sayfası | Kaydetmeyin; bkz. Statik ve Dinamik Sayfalar ve Honeypot Tuzakları |
| Sunucu hatası | 520-526 dahil 5xx | Durum kodu | Engel değil, origin tarafında bir sorun | Bekleme süresini artırarak birkaç kez yeniden deneyin |
Burada dört ayrıntı önemli:
- Metne değil header'a güvenin. Cloudflare, challenge sayfası yanıtını tespit etmenin yolu olarak
cf-mitigated: challengeheader'ını belgeler: her challenge türü bu header'ı ekler ve tek değerichallenge'dır. Challenge metni tarayıcının diline göre değişir,/cdn-cgi/challenge-platform/yolu ise normal sayfalarda da görünür. Aynı sayfanın ziyaretçiye nasıl göründüğünü Cloudflare İnsan Olduğunuz Doğrulanıyor yazımızda anlattık. - Hata kodları iki biçimde gelir. Cloudflare ya markalı bir HTML sayfası ("Error 1020") ya da
error code: 1003gibi kısa bir metin gövdesi gönderir. Bir Cloudflare IP adresine doğrudan istek gönderdiğimizde, tarayıcıUser-Agentdeğeri kullansak bile kısa biçimi aldık. - Her 1xxx kodu bir engel değildir. Örneğin Error 1016, site tarafındaki bir origin DNS hatasıdır.
- Engellerde
cf-mitigatedheader'ı olmaz. Bir Cloudflare engelini origin'in kendi403yanıtından yalnızca gövde ayırır: bir hata kodu ya da Ray ID taşıyan bir Cloudflare sayfası. Kodların tek tek açıklaması "Sorry, You Have Been Blocked" Hatası, hız sınırları Error 1015 yazımızda.
Tarayıcı geçerken Python Requests neden Cloudflare'e takılıyor?
Chrome sayfayı kısa bir beklemenin ardından açar, Python Requests ise challenge sayfasına takılır. Aradaki fark üç noktada toplanır.
JavaScript yok. Cloudflare'e göre bir ziyaretçinin herhangi bir challenge türünü geçebilmesi için JavaScript ve çerez gerekir. Requests, httpx ve curl HTML'i indirir ama içindeki kodu hiç çalıştırmaz.
Geçiş çerezi yok. Challenge'ı geçen tarayıcı bir cf_clearance çerezi saklar ve sonraki her istekte onu gönderir. Sade bir HTTP istemcisi bu çerezi hiç almaz.
Uyuşmayan istemci kimliği. Python kütüphaneleri TLS bağlantısını Chrome'dan farklı açar. Bu yüzden User-Agent değerinde "Chrome" yazan ama Python'un TLS el sıkışmasını taşıyan bir istek kolayca fark edilir (TLS Parmak İzi ve JA3 Nedir?). Dürüst bir bot adı da Browser Integrity Check'e takılabilir, çünkü bu kontrol standart dışı User-Agent değerlerine challenge gösterir. Bunun için istisnayı yalnızca site sahibi tanımlayabilir.
Bazı araçlar bir betiği tarayıcı gibi gösterir: stealth eklentileri, TLS taklit kütüphaneleri, yamalı sürücüler ve challenge çözdürme servisleri. Bunları anlatmıyoruz. İstemcinizi olduğundan farklı gösterirler, çoğu zaman sitenin kullanım şartlarını çiğnerler ve tespit yöntemi her değiştiğinde çalışmaz hâle gelirler.
Cloudflare korumalı bir sitede veriye götüren meşru yollar hangileri?
Yolları kendi deneme sıramıza göre dizdik.
1. Resmi API, feed ya da sitemap
Pek çok site verisini makineler için ayrıca yayımlar: bir API, bir RSS ya da ürün feed'i veya robots.txt içinde listelenen bir sitemap. API size bir anahtar, belgelenmiş bir sınır ve sabit bir veri biçimi verir; HTML değiştiğinde hiçbir şey bozulmaz. Scraper yazmadan önce sitenin footer alanına, geliştirici sayfalarına ve robots.txt dosyasındaki Sitemap: satırlarına bakın.
2. Site sahibine sorun
Bir challenge'ı ya da engeli yalnızca site sahibi kaldırabilir; Cloudflare çalışanları kaldıramaz. Botunuzun adını, bir iletişim adresini, ihtiyacınız olan URL yollarını, siteyi ne sıklıkla ziyaret edeceğinizi ve IP adresinizi içeren kısa bir mesaj yazın. Site sahibi IP'nize bir IP Access kuralıyla izin verebilir. Bu kurala uyan istekler özel kurallara, hız sınırlamaya ve yönetilen kurallara takılmaz; Bot Fight Mode da bu IP'ye dokunmaz. Ücretli planlarda bir Skip kuralı sizi Super Bot Fight Mode'dan da muaf tutabilir; bu kural da genellikle sabit bir IP'ye ya da üzerinde anlaştığınız bir header token'ına bakar. Sabit adres için API için Statik IP yazımıza bakabilir ya da bir ISP Proxy kullanabilirsiniz.
3. Cloudflare'in doğrulanmış botlar programına katılın
Kamuya hizmet veren bir crawler için resmi yol, Cloudflare'in doğrulanmış botlar programıdır. Doğrulanmış bir bot kimliğini üç yoldan biriyle kanıtlar: Web Bot Auth imzası, sabit bir User-Agent ile birlikte yayımlanmış bir IP listesi ya da ters DNS. Botun robots.txt kurallarına uyması ve makul bir hızda kalması gerekir. Başvuru Cloudflare panelindeki bir formdan yapılır; IP doğrulamasında python-requests gibi genel adlar kabul edilmez. 1 Temmuz 2026'dan beri program, kullanıcılar adına çalışan imzalı ajanları da kapsıyor; kategorileri arasında SEO, izleme ve fiyat toplama (price scraping) var.
Web Bot Auth'ta bot her isteği, Şubat 2024'ten beri standart olan RFC 9421 HTTP Message Signatures kurallarına göre kendi özel anahtarıyla imzalar ve açık anahtarını kendi alan adında yayımlar. IETF çalışma grubu, botlar için yazılan kuralları 1 Eylül 2026'da taslak olarak kabul etti: draft-ietf-webbotauth-httpsig-protocol. Akışın tamamını AI Alışveriş Ajanları Neden Sitelerde Engelleniyor? yazımızda anlattık. Doğrulama kim olduğunuzu kanıtlar, ama doğrulanmış botların içeri girip girmeyeceğine yine site sahibi karar verir.
4. AI crawler'ları için: varsayılan ayarlar ve pay per crawl
Temmuz 2025'ten beri yeni Cloudflare alan adları AI crawler'larını varsayılan olarak engelliyor. 15 Eylül 2026'dan itibaren yeni alan adları reklam içeren sayfalarda Training ve Agent botlarını da engelliyor; Search botları ise izinli kalıyor. Bazı siteler robots.txt dosyasına ai-train=no gibi Content-Signal satırları ekliyor. urllib.robotparser bu satırları yok sayıyor (kontrol ettik), bu yüzden onları kendiniz okumalısınız. Pay per crawl Temmuz 2025'te kapalı beta olarak başladı ve Eylül 2026 itibarıyla Cloudflare'in belgelerinde hâlâ bu aşamada görünüyor. Ödeme header'ları göndermeyen bir crawler, crawler-price header'ı taşıyan bir 402 yanıtı alır.
5. Gerçek tarayıcı, yalnızca gerektiğinde
Sayfa verisini JavaScript ile oluşturuyorsa ve site otomasyona izin veriyorsa Playwright size render edilmiş sayfayı getirir (Playwright Nedir ve Proxy ile Nasıl Kullanılır?). Önce tarayıcının ağ (Network) sekmesine bakın: veri çoğu zaman sade bir istemcinin de çağırabileceği bir JSON isteğinden gelir. Cloudflare, Playwright gibi otomasyon araçlarının challenge çözmek için desteklenmediğini belirtir. Bu yüzden bir challenge çıkarsa durun ve 2. yola dönün.
Proxy nerede işe yarar, nerede yaramaz?
Proxy, isteğinizin yalnızca IP adresini ve ağını değiştirir. TLS el sıkışmasını değiştirmez, JavaScript çalıştırmaz, cf_clearance taşımaz. Her istekte IP değiştirmek ise tek bir istemciyi geçmişi olmayan çok sayıda bilinmeyen ziyaretçi gibi gösterir (IP Rotasyonu Nedir ve Nasıl Çalışır?).
Proxy şu üç durumda doğru araçtır:
- Tek bir ülkeye özel içerik. O ülkedeki bir Residential Proxy, sayfayı yerel ziyaretçilerin gördüğü hâliyle gösterir.
- Site sahibinin izin verdiği sabit bir IP. Bir ISP Proxy bu adresi değiştirmeden korur.
- Çok sayıda site, her birinde ölçülü bir hız. Bir Rotating Proxy her siteye farklı bir çıkış IP'si verebilir, bir Sticky Proxy ise her site için aynı çıkış IP'sini korur. IP rotasyonunu hiçbir zaman bir siteye, tek bir IP'ye izin verilenden fazla istek göndermek için kullanmayın.
Bir yasağı aşmak bu durumlardan biri değildir: Error 1005 ya da 1006'dan sonra ağ değiştirmek, tam da bu kuralların durdurmak için yazıldığı davranıştır.
Ne zaman duracağını bilen bir Python Cloudflare scraper
Bu betik, çalıştırma izniniz olan işler içindir: taramaya izin veren sitelerdeki herkese açık kataloglar ya da sahibinin IP'nizi izin listesine eklediği bir site gibi. Hiçbir kontrolü geçmeye çalışmadan şunları yapar:
- bot adı ve iletişim URL'si içeren dürüst bir
User-Agentgönderir; robots.txtdosyasını her host için bir kez, aynı sınıflandırıcıdan geçirerek okur ve orada bir challenge ya da engel çıkarsa o host'u taramayı bırakır (bu bizim temkinli kuralımız; RFC 9309 bir4xxyanıtını "kural yok" diye yorumlar);robots.txtalınamadığında gerçek hatayı kaydeder (örneğin yanlış proxy şifresi yüzünden gelen bir407); böylece bir kurulum hatası sitenin reddi gibi görünmez;- aynı host'a giden iki istek arasında
MIN_DELAYsaniye,Crawl-delaydaha uzunsa o kadar bekler (yalnızca tam saniye:urllib.robotparser1.5değerini yok sayar); If-None-MatchveIf-Modified-Sinceheader'larını gönderir, böylece değişmemiş bir sayfa için yalnızca kısa bir304yanıtı gelir;429ya da5xxaldığındaRetry-Afterheader'ına RFC 9110'un izin verdiği iki biçimde de uyar; header yoksa bekleme süresini ikiye katlar,MAX_WAITile sınırlar veMAX_RETRIESkez yeniden denedikten sonra o host'tan vazgeçer (Scraping'de HTTP Hata Kodları);- challenge, engel ya da
402aldığında URL'yi vecf-raydeğerini kaydeder ve o host'u atlar.
Betik senkron Requests kullanır (pip install requests), çünkü amaç her host'a aynı anda tek bir ölçülü istek göndermektir (HTTPX, Requests ve AIOHTTP Karşılaştırması).
"""Cloudflare arkasındaki siteler için küçük bir scraper: her yanıtı okur, site hayır dediğinde durur."""
import email.utils
import logging
import math
import re
import time
from datetime import datetime, timezone
from enum import Enum
from urllib.parse import urlsplit
from urllib.robotparser import RobotFileParser

import requests

BOT_NAME = "NorthwindCatalogBot"
USER_AGENT = f"{BOT_NAME}/1.0 (+https://example.com/bot)"
PROXY = "http://user:pass@pr.proxynet.io:8000"  # site sahibinin izin listesine eklediği sabit çıkış IP'si ya da None
EXPECT = 'data-sku="'  # her gerçek ürün sayfasında bulunan bir işaret
MIN_DELAY = 5.0        # aynı host'a giden iki istek arasındaki saniye
MAX_WAIT = 300         # tek bir yeniden denemeden önce bundan uzun beklenmez
MAX_RETRIES = 3        # host'tan vazgeçmeden önce 429 ya da 5xx sonrası yeniden deneme sayısı
BLOCK_CODES = {"1005", "1006", "1007", "1008", "1009", "1010", "1020", "1106"}

log = logging.getLogger(BOT_NAME)


class Verdict(Enum):
    OK = "ok"
    NOT_MODIFIED = "not_modified"
    CHALLENGE = "challenge"
    BLOCKED = "blocked"
    RATE_LIMITED = "rate_limited"
    PAYMENT_REQUIRED = "payment_required"
    SUSPICIOUS_200 = "suspicious_200"
    SERVER_ERROR = "server_error"
    OTHER = "other"


STOP = {Verdict.CHALLENGE, Verdict.BLOCKED, Verdict.PAYMENT_REQUIRED}
RETRY = {Verdict.RATE_LIMITED, Verdict.SERVER_ERROR}


class StopHost(Exception):
    """Site hayır dedi. Çalışmanın geri kalanında bu host'a dokunmuyoruz."""


def page_text(resp):
    """Gövdenin başı, HTML etiketleri çıkarılmış hâlde."""
    return re.sub(r"<[^>]+>", " ", resp.text[:20000])


def cloudflare_code(resp):
    """Bir Cloudflare hata yanıtının 1xxx kodu ya da None.

    Cloudflare bu kodu markalı bir HTML sayfası ("Error 1020") olarak ya da
    "Server: cloudflare" header'ıyla birlikte kısa bir metin gövdesi
    ("error code: 1020") olarak gönderir.
    """
    text = page_text(resp)
    from_cloudflare = resp.headers.get("Server", "").lower() == "cloudflare"
    short_form = from_cloudflare and text.lstrip().lower().startswith("error code:")
    if not short_form and "cloudflare" not in text.lower():
        return None
    match = re.search(r"(?i)\berror(?:\s+code)?:?\s+(1\d{3})\b", text)
    return match.group(1) if match else None


def classify(resp, expect=EXPECT):
    if resp.headers.get("cf-mitigated") == "challenge":
        return Verdict.CHALLENGE, "Cloudflare challenge page"
    status = resp.status_code
    if status == 304:
        return Verdict.NOT_MODIFIED, "unchanged since the last visit"
    if status == 402:
        return Verdict.PAYMENT_REQUIRED, "402 with crawler-price" if "crawler-price" in resp.headers else "402"
    code = cloudflare_code(resp) if status >= 400 else None
    if status == 429 or code == "1015":
        return Verdict.RATE_LIMITED, f"HTTP {status}, error {code}" if code else f"HTTP {status}"
    if code in BLOCK_CODES or status == 403:
        text = page_text(resp).lower()
        if code:
            why = f"Cloudflare error {code}"
        elif "cloudflare" in text and "ray id" in text:
            why = "Cloudflare block page without a code"  # bir WAF kuralı
        else:
            why = "403 from the origin server"
        return Verdict.BLOCKED, why
    if status >= 500:
        return Verdict.SERVER_ERROR, f"HTTP {status}"
    if status == 200 and expect and expect not in resp.text:
        why = "Turnstile form, no data" if "cf-turnstile" in resp.text else "expected content missing"
        return Verdict.SUSPICIOUS_200, why
    if status == 200:
        return Verdict.OK, "expected content found" if expect else "HTTP 200"
    return Verdict.OTHER, f"HTTP {status}"


def wait_seconds(resp, attempt):
    """RFC 9110'un iki biçiminden birindeki Retry-After, yoksa ikiye katlanan bekleme. Tam saniye, üst sınırlı."""
    value = resp.headers.get("Retry-After", "").strip()
    wait = 30 * 2**attempt
    if value.isdigit():
        wait = int(value)
    elif value:
        try:
            when = email.utils.parsedate_to_datetime(value)
            if when.tzinfo is None:
                when = when.replace(tzinfo=timezone.utc)
            wait = (when - datetime.now(timezone.utc)).total_seconds()
        except (TypeError, ValueError):
            pass
    return min(max(math.ceil(wait), 1), MAX_WAIT)


class PoliteFetcher:
    def __init__(self, proxy=PROXY):
        self.session = requests.Session()
        self.session.headers["User-Agent"] = USER_AGENT
        if proxy:
            self.session.proxies = {"http": proxy, "https": proxy}
        self.robots, self.delay, self.last, self.cache = {}, {}, {}, {}

    def get(self, url, headers=None, expect=EXPECT):
        host = urlsplit(url).netloc
        for attempt in range(MAX_RETRIES + 1):
            pause = self.delay.get(host, MIN_DELAY) - (time.monotonic() - self.last.get(host, -1e9))
            if pause > 0:
                time.sleep(pause)
            resp = self.session.get(url, headers=headers, timeout=20)
            self.last[host] = time.monotonic()
            if resp.status_code == 407:
                raise requests.exceptions.ProxyError("the proxy rejected the credentials (407)")
            verdict, why = classify(resp, expect)
            if verdict in STOP:
                ray = resp.headers.get("cf-ray", "none")
                log.error("STOP %s: %s, %s (cf-ray %s)", url, verdict.value, why, ray)
                raise StopHost(host)
            if verdict not in RETRY:
                return resp, verdict, why
            if attempt < MAX_RETRIES:
                wait = wait_seconds(resp, attempt)
                log.warning("%s %s: %s, waiting at least %d s", verdict.value, url, why, wait)
                time.sleep(wait)
        log.error("STOP %s: still %s after %d retries", url, verdict.value, MAX_RETRIES)
        raise StopHost(host)

    def allowed(self, url):
        parts = urlsplit(url)
        host = parts.netloc
        if host not in self.robots:
            try:
                resp, _, _ = self.get(f"{parts.scheme}://{host}/robots.txt", expect=None)
            except requests.RequestException as exc:
                log.error("STOP %s: robots.txt unreachable (%s)", host, exc)
                raise StopHost(host) from exc
            parser = RobotFileParser()
            parser.parse(resp.text.splitlines() if resp.status_code == 200 else [])
            self.robots[host] = parser
            # urllib.robotparser yalnızca tam saniye okur: "Crawl-delay: 1.5" yok sayılır
            self.delay[host] = max(MIN_DELAY, parser.crawl_delay(BOT_NAME) or 0)
        return self.robots[host].can_fetch(BOT_NAME, url)

    def fetch(self, url):
        """Sayfanın HTML'i ya da sayfa atlanacaksa None."""
        if not self.allowed(url):
            log.info("skip %s: disallowed by robots.txt", url)
            return None
        validators, body = self.cache.get(url, ({}, None))
        resp, verdict, why = self.get(url, headers=validators)
        log.log(logging.INFO if verdict in (Verdict.OK, Verdict.NOT_MODIFIED) else logging.WARNING,
                "%s %s: %s", verdict.value, url, why)
        if verdict is Verdict.NOT_MODIFIED:
            return body
        if verdict is not Verdict.OK:
            return None
        saved = {}
        if "ETag" in resp.headers:
            saved["If-None-Match"] = resp.headers["ETag"]
        if "Last-Modified" in resp.headers:
            saved["If-Modified-Since"] = resp.headers["Last-Modified"]
        self.cache[url] = (saved, resp.text)
        return resp.text


def crawl(urls, proxy=PROXY):
    fetcher, stopped, pages = PoliteFetcher(proxy), set(), {}
    for url in urls:
        host = urlsplit(url).netloc
        if host in stopped:
            log.info("skip %s: host stopped earlier", url)
            continue
        try:
            html = fetcher.fetch(url)
        except StopHost:
            stopped.add(host)
            continue
        except requests.RequestException as exc:
            log.warning("network error %s: %s", url, exc)
            continue
        if html is not None:
            pages[url] = html
    return pages


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO, format="%(levelname)-7s %(message)s")
    found = crawl([
        "https://www.example.com/products/1001",
        "https://www.example.com/products/1002",
    ])
    print(f"{len(found)} pages saved")
classify() önce cf-mitigated header'ına, sonra 402 ve 429 kodlarına bakar, ardından iki biçimden birinde 1xxx kodu arar. Kodsuz bir 403, gövdesi Cloudflare adını ve bir Ray ID içeriyorsa Cloudflare engel sayfası sayılır. 200 yanıtında sonuç yalnızca EXPECT işareti sayfadaysa ok olur. Bu yüzden challenge sayfasında, JavaScript iskeletinde (shell) ya da tuzak sayfasında bulunmayacak bir işaret seçin, örneğin bir ürün kimliği özniteliği.
Çıktı nasıl görünüyor?
Betiği Python 3.13 ve Requests 2.34.2 ile, yerel bir HTTP proxy üzerinden sekiz yerel test sitesinde (her yanıt türü için bir site) çalıştırdık. Bu çalıştırma için __main__ içindeki iki örnek URL'yi o sitelerdeki sayfalarla değiştirdik. Test siteleri yalnızca belgelenmiş işaretleri taklit ediyor, Ray ID'leri de bu siteler üretti.
INFO    ok http://127.0.0.1:28150/products/1001: expected content found
INFO    not_modified http://127.0.0.1:28150/products/1001: unchanged since the last visit
INFO    skip http://127.0.0.1:28150/cart: disallowed by robots.txt
WARNING rate_limited http://127.0.0.1:28150/products/1002: HTTP 429, waiting at least 2 s
INFO    ok http://127.0.0.1:28150/products/1002: expected content found
WARNING rate_limited http://127.0.0.1:28150/products/1003: HTTP 429, waiting at least 3 s
INFO    ok http://127.0.0.1:28150/products/1003: expected content found
WARNING suspicious_200 http://127.0.0.1:28150/products/1004: expected content missing
WARNING suspicious_200 http://127.0.0.1:28150/products/1005: Turnstile form, no data
ERROR   STOP http://127.0.0.1:28151/products/1: challenge, Cloudflare challenge page (cf-ray 8f3c2a9d1b7e28151-IST)
INFO    skip http://127.0.0.1:28151/products/2: host stopped earlier
ERROR   STOP http://127.0.0.1:28152/products/1: blocked, Cloudflare error 1020 (cf-ray 8f3c2a9d1b7e28152-IST)
ERROR   STOP http://127.0.0.1:28153/products/1: blocked, Cloudflare block page without a code (cf-ray 8f3c2a9d1b7e28153-IST)
ERROR   STOP http://127.0.0.1:28154/products/1: blocked, Cloudflare error 1006 (cf-ray 8f3c2a9d1b7e28154-IST)
ERROR   STOP http://127.0.0.1:28155/products/1: payment_required, 402 with crawler-price (cf-ray 8f3c2a9d1b7e28155-IST)
ERROR   STOP http://127.0.0.1:28156/robots.txt: challenge, Cloudflare challenge page (cf-ray 8f3c2a9d1b7e28156-IST)
INFO    skip http://127.0.0.1:28156/products/2: host stopped earlier
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
ERROR   STOP http://127.0.0.1:28157/products/1: still rate_limited after 3 retries
3 pages saved
İlk sayfa, /cdn-cgi/challenge-platform/ yolundan bir JavaScript dosyası yüklemesine rağmen ok sonucunu alıyor. İkinci ziyarette sunucu 304 ile cevap veriyor, robots.txt de betiği /cart yolundan uzak tutuyor. İki 429 yanıtı da Retry-After taşıyordu, biri saniye, diğeri tarih biçiminde. Kayıtta "at least" yazmasının nedeni, host başına bekleme süresinin gerçek aralığı uzatabilmesi. İki 200 sayfası kaydedilmedi, sonraki altı host ilk sayfasında ya da robots.txt aşamasında durdu, son host ise üç yeniden denemenin ardından bırakıldı.
Betiğin bir eksiği var: site sahibi bir hız sınırı kuralına kendi seçtiği bir durum kodu ve içinde 1015 geçmeyen bir gövde verebilir. Betik o durumda blocked ya da other kaydeder, bu yüzden iki sonucu da izleyin.
Kullanım alanları
- Fiyat takibi: koşullu istekler günlük kontrolleri hafif tutar,
suspicious_200ise değişen bir sayfa şablonunu işaretler (fiyat takibi). - Pazar araştırması: her biri kendi hızında ziyaret edilen çok sayıda mağazadan ürün yelpazesi ve stok verisi (pazar araştırması).
- SEO kontrolleri: kendi Cloudflare ayarlarınızın, sitenize gelmesini istediğiniz crawler'lara challenge gösterip göstermediğini öğrenin (SEO proxy).
- Marka koruma: sahte ilanlar için pazaryeri taramaları, her challenge'da duran bir işle (marka koruma).
- Herkese açık crawler'lar: ilk taramasından önce doğrulanmış bot statüsüne başvuran bir dizin ya da arşiv (web crawler).
- Genel veri toplama: temiz veri ve işin ulaşamadığı sayfaların kaydı (veri kazıma).
Sık yapılan hatalar
- Bir
403yanıtını döngüde yeniden denemek. Cevap aynı kalır, art arda gelen istekler de kendi başına bot gibi görünür. - Error 1015'i hızla yeniden denemek ya da
Retry-Afterdeğerini yok saymak. Cloudflare, kısa sürede yapılan tekrar denemelerin engeli uzatabileceği konusunda uyarır (429 Too Many Requests). - Tek bir sitede her istekte IP değiştirmek. Aynı hızla gelen yeni adresler, site sahibinin koyduğu sınırı hiçe sayar; çereze ya da parmak izine bağlı sınırlar da sıfırlanmaz (Web Scraping'de Engellenmeden Veri Toplama Yöntemleri).
- Googlebot taklidi yapmak. Google, site sahiplerine Googlebot'u doğrulamak için ters ve ileri DNS sorgusu yapmalarını ya da yayımladığı IP aralıklarına bakmalarını söyler. Başka bir IP'den gelen Googlebot
User-Agent'ı iki kontrolden de geçemez. - Her
200yanıtına güvenmek. JavaScript iskeletleri, Turnstile formları ve tuzak sayfaları da200döner. Cloudflare'in AI Labyrinth özelliği, gizli linklerini izleyen crawler'ları engellemez, onları sayfalardan oluşan bir labirente sokar. cf_clearanceçerezini bir betiğe kopyalamak. Çerez, verildiği cihaza bağlıdır.- Size ait olmayan bir hesapla giriş yapıp scraping yapmak. Kendi hesabınız ve kendi verileriniz ayrı bir konudur (Python'da Oturum ve Çerez Yönetimi); sitenin size açmadığı sayfalar başka bir konu.
- CAPTCHA çözdürme servisine para ödemek. Cloudflare'in challenge'ları resimli bulmaca değildir; kontroller tarayıcının içinde çalışır ve bir çözücü, site sahibinin kararını dolanır.
Karar rehberi
| Durumunuz | Ne yapın |
|---|---|
| Sitenin bir API'si ya da feed'i var | HTML'i kazımak daha kolay görünse bile onu kullanın |
| Tek bir siteden birkaç sayfaya ihtiyacınız var | Site sahibine yazın: bot adı, URL yolları, hız |
| Site sahibi izin vermeyi kabul etti | Bütün trafiği tek bir sabit IP'den gönderin |
| Herkese açık bir crawler işletiyorsunuz | Doğrulanmış bot statüsüne başvurun |
| Bir AI crawler'ı ya da ajanı geliştiriyorsunuz | Content-Signal satırlarını okuyun; 402 yanıtını bir fiyat olarak değerlendirin |
| Veri JavaScript ile oluşturuluyor | JSON isteğini bulun; Playwright'ı yalnızca izin verilen yerde kullanın |
| Tek bir ülkenin fiyatlarına ihtiyacınız var | O ülkede bir proxy kullanın, hızı değiştirmeyin |
İşiniz her gün 429 alıyor | Hızı düşürün; IP eklemeyin |
| İşiniz challenge ya da engel sayfasına takılıyor | O host'u bırakın; yukarıdaki yollardan birini seçin |
| Kendi Cloudflare sitenizi izliyorsunuz | İzleme aracının IP'sine bir IP Access kuralıyla izin verin |
Sıkça sorulan sorular
Python Requests ile Cloudflare arkasındaki bir sitede scraping yapılabilir mi?
Evet, site sahibinin ayarları isteğin geçmesine izin verdiği sürece. Site bir challenge ile cevap veriyorsa Requests onu geçemez, çünkü her Cloudflare challenge'ı JavaScript ve çerez gerektirir. O durumda sitenin API'sini kullanın, site sahibinden erişim isteyin ya da durun.
Cloudflare korumalı bir sitede scraping yapmak yasal mı?
Bu bir hukuki tavsiye değildir. Cevap ülkeye, sitenin kullanım şartlarına, verinin kişisel olup olmadığına ve onu nasıl kullandığınıza bağlıdır. Challenge, site sahibinin isteğini açıkça gösteren bir işarettir; onu dolanmak bu işareti yok saymak demektir ve çoğu zaman sitenin şartlarını çiğner. Ülkelere göre durumu Web Scraping (Web Kazıma) Yasal mı? yazımızda anlattık.
cf_clearance çerezi nedir?
cf_clearance, bir tarayıcının Cloudflare challenge'ını geçtikten sonra aldığı çerezdir; sonraki istekler bu sayede yeni bir challenge görmeden origin'e ulaşır. Süresini site sahibinin Challenge Passage ayarı belirler (varsayılan 30 dakika), çerez de ziyaretçiye ve cihaza bağlıdır. Oturum şüpheli görünmeye başlarsa Precursor onu süresi dolmadan geçersiz kılabilir.
Residential proxy ile Cloudflare'i aşabilir miyim?
Hayır, zaten bu onun görevi değil. Proxy IP adresinizi ve ağınızı değiştirir; ama challenge yine JavaScript ister, TLS el sıkışmanız aynı kalır ve istemcinize konmuş bir ban geçerliliğini korur. Residential proxy'yi, bir sayfayı belirli bir ülkedeki ziyaretçilerin gördüğü gibi görmek için kullanın ve hızınızı sitenin kabul ettiği düzeyde tutun.
Crawler'ımı Cloudflare'e nasıl doğrulatırım?
Crawler'ınıza kendine özgü bir ad verin ve 3. yoldaki kanıtlardan birini kullanın: Web Bot Auth imzaları ya da yalnızca crawler'ınızın kullandığı IP adreslerinin yayımlanmış bir listesi. robots.txt ve crawl-delay kurallarına uymasını sağlayın, ardından Cloudflare panelindeki doğrulanmış botlar formundan başvurun.
Scraper'ım dizüstü bilgisayarımda çalışıyor, sunucuda neden çalışmıyor?
Dizüstü bilgisayarınız ev ya da ofis hattını kullanır, sunucu ise bir hosting sağlayıcısının ağını. Site sahipleri bir ağın tamamını ASN'siyle yasaklayabilir (Error 1005), adresin itibarı da bot puanını etkiler. Bu yüzden aynı betik birinden geçip diğerinden challenge alabilir. Site sahibinden sunucunun sabit IP'sine izin vermesini isteyin ya da resmi API'yi kullanın.
Özet
Cloudflare scraper, site sahibinin ayarları bir isteği origin'e ulaşmadan durdurduğunda engellenir. Herhangi bir şeyi değiştirmeden önce cevabı okuyun. cf-mitigated: challenge header'ı challenge demektir, Cloudflare hata kodlarının çoğu ve engel sayfası site sahibinin kurallarından gelir, 429 ya da Error 1015 bir hız sınırıdır, 402 bir fiyattır, 200 ise ancak beklediğiniz içerik sayfadaysa geçerlidir. Ardından kalıcı bir yol seçin: resmi API, site sahibinin sabit bir IP için verdiği izin, doğrulanmış bot statüsü ya da yalnızca render gereken yerde gerçek bir tarayıcı. Ülkenin ya da sabit bir adresin önemli olduğu işler için seçenekleri proxy hizmetlerimiz sayfasında karşılaştırabilirsiniz.